

什么是Milvus?
Milvus 是鹰科(Accipitridae)Milvus属的一种猛禽,以其飞行速度快、视力敏锐和非凡的适应能力而著称。
Zilliz 将其开源的高性能、高度可扩展的向量数据库命名为 Milvus,该数据库可在从笔记本电脑到大规模分布式系统等广泛环境中高效运行。它既作为开源软件提供,也作为云服务提供。
Milvus 由 Zilliz 开发,并即将捐赠给 Linux 基金会旗下的 LF AI & Data Foundation,现已成为全球领先的开源向量数据库项目之一。 该项目采用 Apache 2.0 许可证发布,大多数贡献者来自高性能计算(HPC)领域的专家,他们专长于构建大规模系统和优化硬件感知代码。核心贡献者包括来自 Zilliz、ARM、NVIDIA、AMD、Intel、Meta、IBM、Salesforce、阿里巴巴和微软的专业人士。
有趣的是,Zilliz 的每个开源项目都以鸟类命名,这一命名惯例象征着自由、远见以及技术的敏捷演进。
非结构化数据、Embeddings 与 Milvus
非结构化数据(如文本、图像和音频)格式各异且蕴含丰富的潜在语义,因此分析起来颇具挑战。为应对这种复杂性,通常采用Embeddings技术将非结构化数据转换为能够捕捉其本质特征的数值向量。这些向量随后存储在向量数据库中,从而实现快速且可扩展的搜索与分析。
Milvus 提供强大的数据建模能力,使您能够将非结构化或多模态数据组织成结构化 Collection。它支持多种数据类型以满足不同的属性建模需求,包括常见的数值型和字符型、各种向量类型、数组、集合以及 JSON,从而免去了您维护多个数据库系统的麻烦。
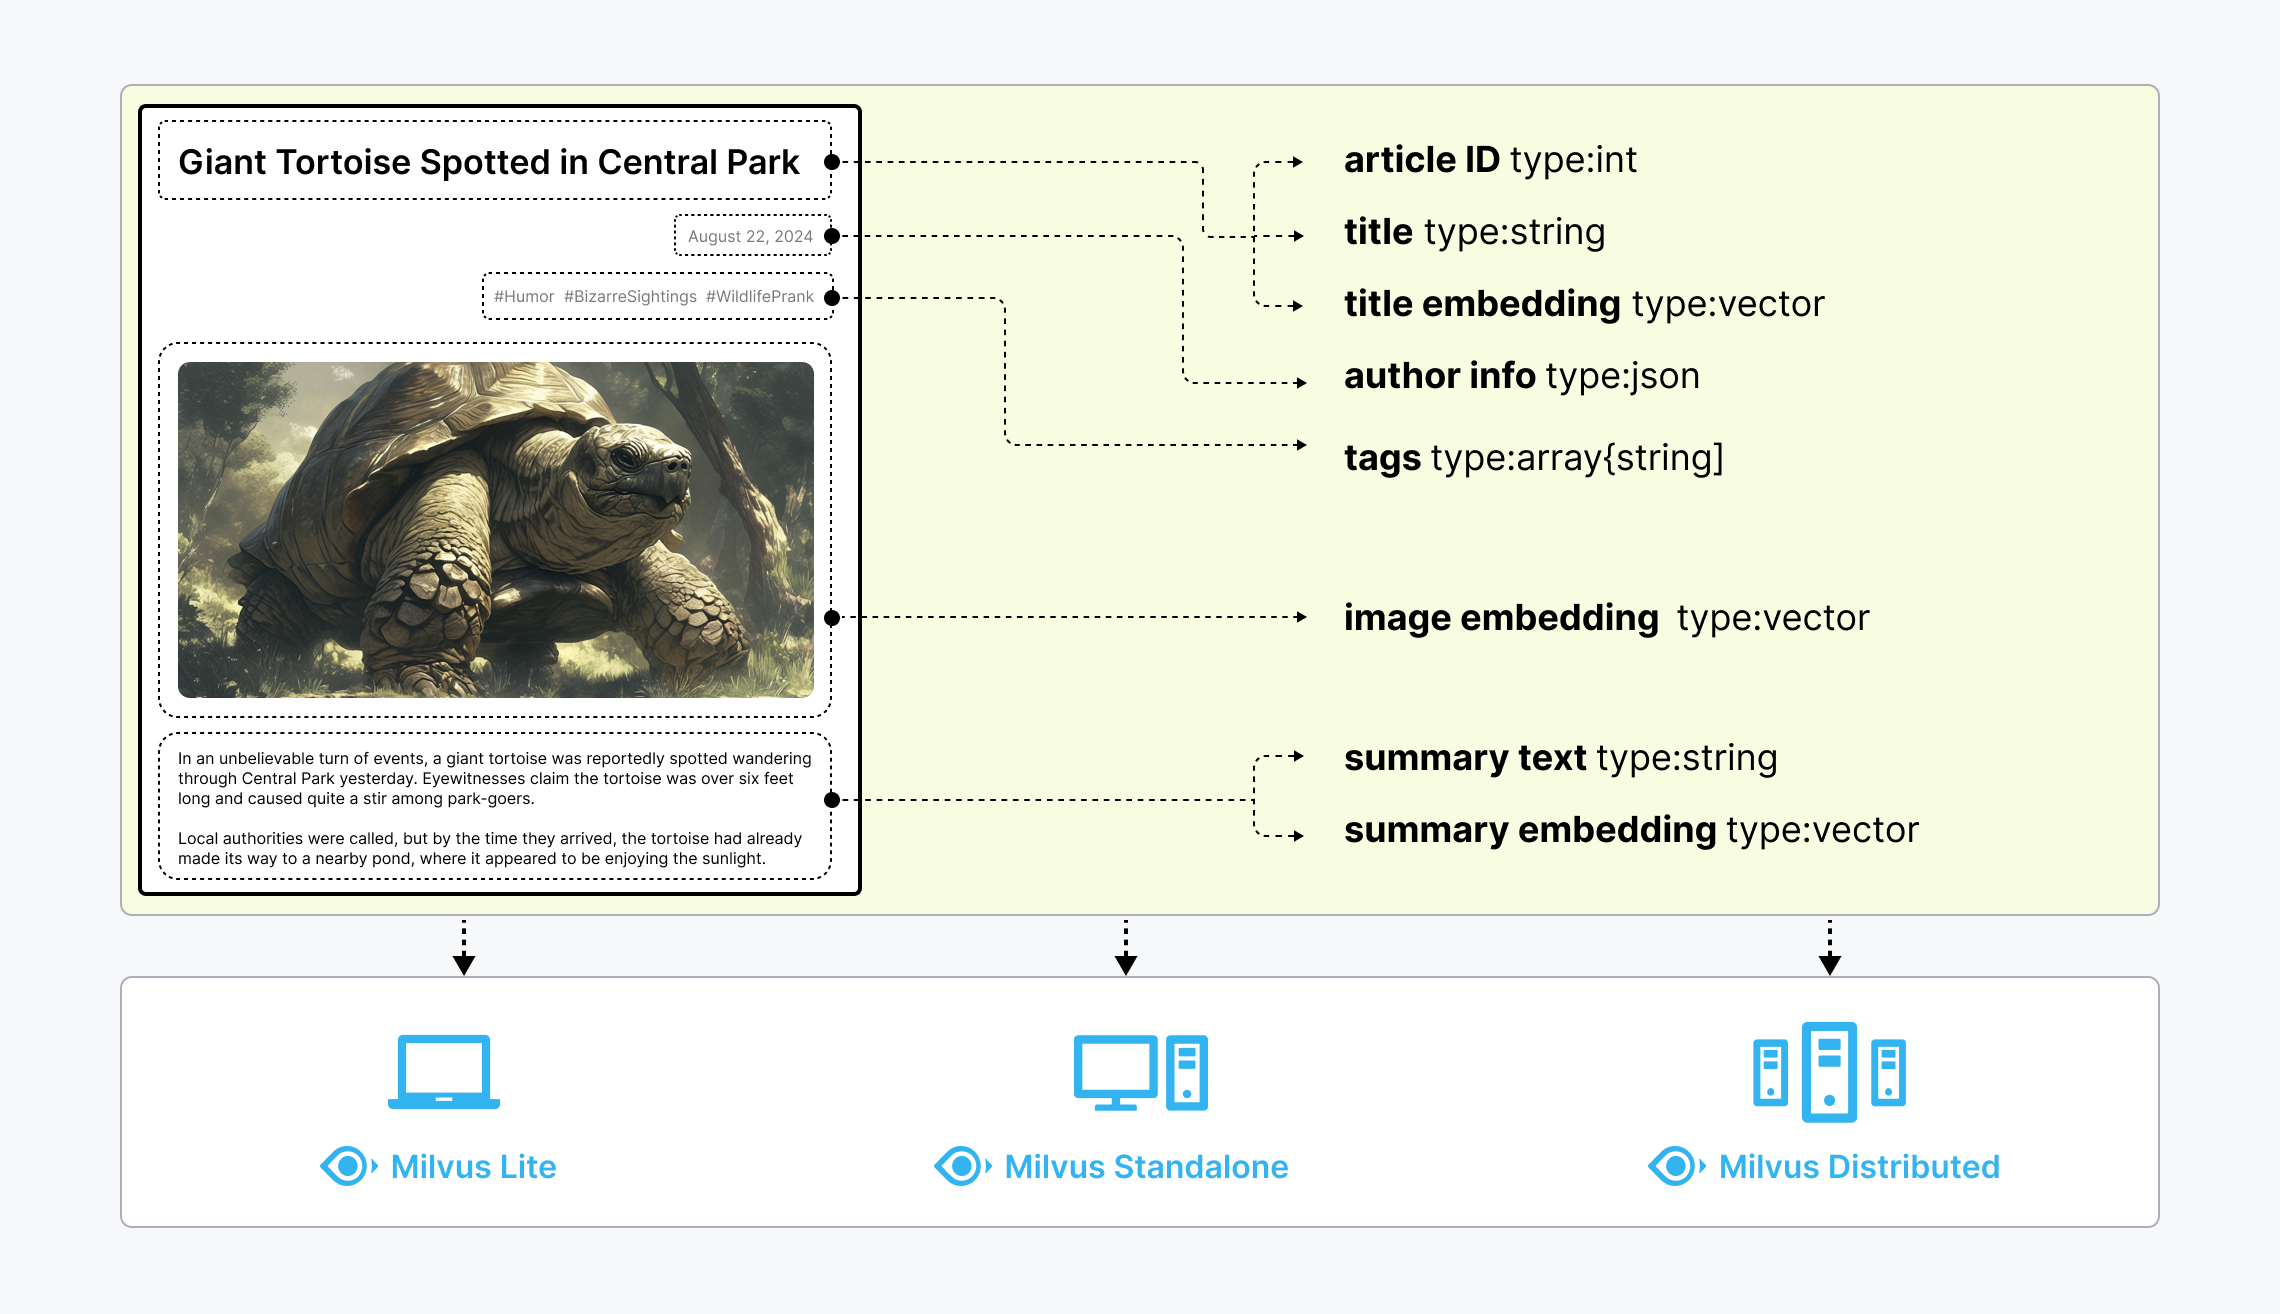 非结构化数据、Embeddings 与 Milvus
Milvus 提供三种部署模式,覆盖广泛的数据规模——从 Jupyter Notebook 中的本地原型设计,到管理数百亿向量的大型 Kubernetes 集群:
- Milvus Lite 是一个 Python 库,可轻松集成到您的应用程序中。作为 Milvus 的轻量级版本,它非常适合在 Jupyter Notebook 中进行快速原型设计,或在资源有限的边缘设备上运行。了解更多。
- Milvus Standalone 是一种单服务器部署方案,所有组件打包到单个 Docker 镜像中,便于部署。了解更多。
- Milvus Distributed 可部署在 Kubernetes 集群上,采用专为数十亿量级甚至更大规模场景设计的云原生架构。该架构确保了关键组件的冗余性。了解更多。
是什么让 Milvus 如此快速?
Milvus 从诞生之初就致力于打造一个高效能的向量数据库系统。在大多数情况下,Milvus 的性能比其他向量数据库高出 2 到 5 倍(参见 VectorDBBench 测试结果)。这种卓越的性能源于以下几项关键设计决策:
面向硬件的优化:为了使 Milvus 适应各种硬件环境,我们针对包括 AVX512、SIMD、GPU 和 NVMe SSD 在内的多种硬件架构和平台,对其性能进行了专门优化。
先进的搜索算法:Milvus 支持多种内存内和磁盘上的索引/搜索算法,包括 IVF、HNSW、DiskANN 等,所有这些算法都经过了深度优化。与 FAISS 和 HNSWLib 等流行实现相比,Milvus 的性能提升了 30% 至 70%。
基于 C++ 的搜索引擎:向量数据库超过 80% 的性能取决于其搜索引擎。Milvus 采用 C++ 开发这一关键组件,因为该语言具有高性能、低级优化和高效的资源管理特性。 最重要的是,Milvus 集成了大量面向硬件的代码优化,涵盖从汇编级向量化到多线程并行化和调度等各个方面,以充分利用硬件能力。
列式架构:Milvus 是一个列式向量数据库系统。 其主要优势源于数据访问模式。在执行查询时,列式数据库仅读取查询涉及的特定字段,而非整行数据,这大大减少了数据访问量。此外,针对列式数据的操作可轻松向量化,从而能够一次性对整列数据进行操作,进一步提升性能。
Milvus 为何具备如此强大的可扩展性
2022 年,Milvus 已支持数十亿量级的向量;2023 年,其规模扩展至数百亿量级,且始终保持稳定运行,为包括 Salesforce、PayPal、Shopee、Airbnb、eBay、NVIDIA、 IBM、AT&T、LINE、ROBLOX、Inflection等300多家大型企业的大规模应用场景。
Milvus 的云原生且高度解耦的系统架构,确保了系统能够随着数据量的增长而持续扩展:
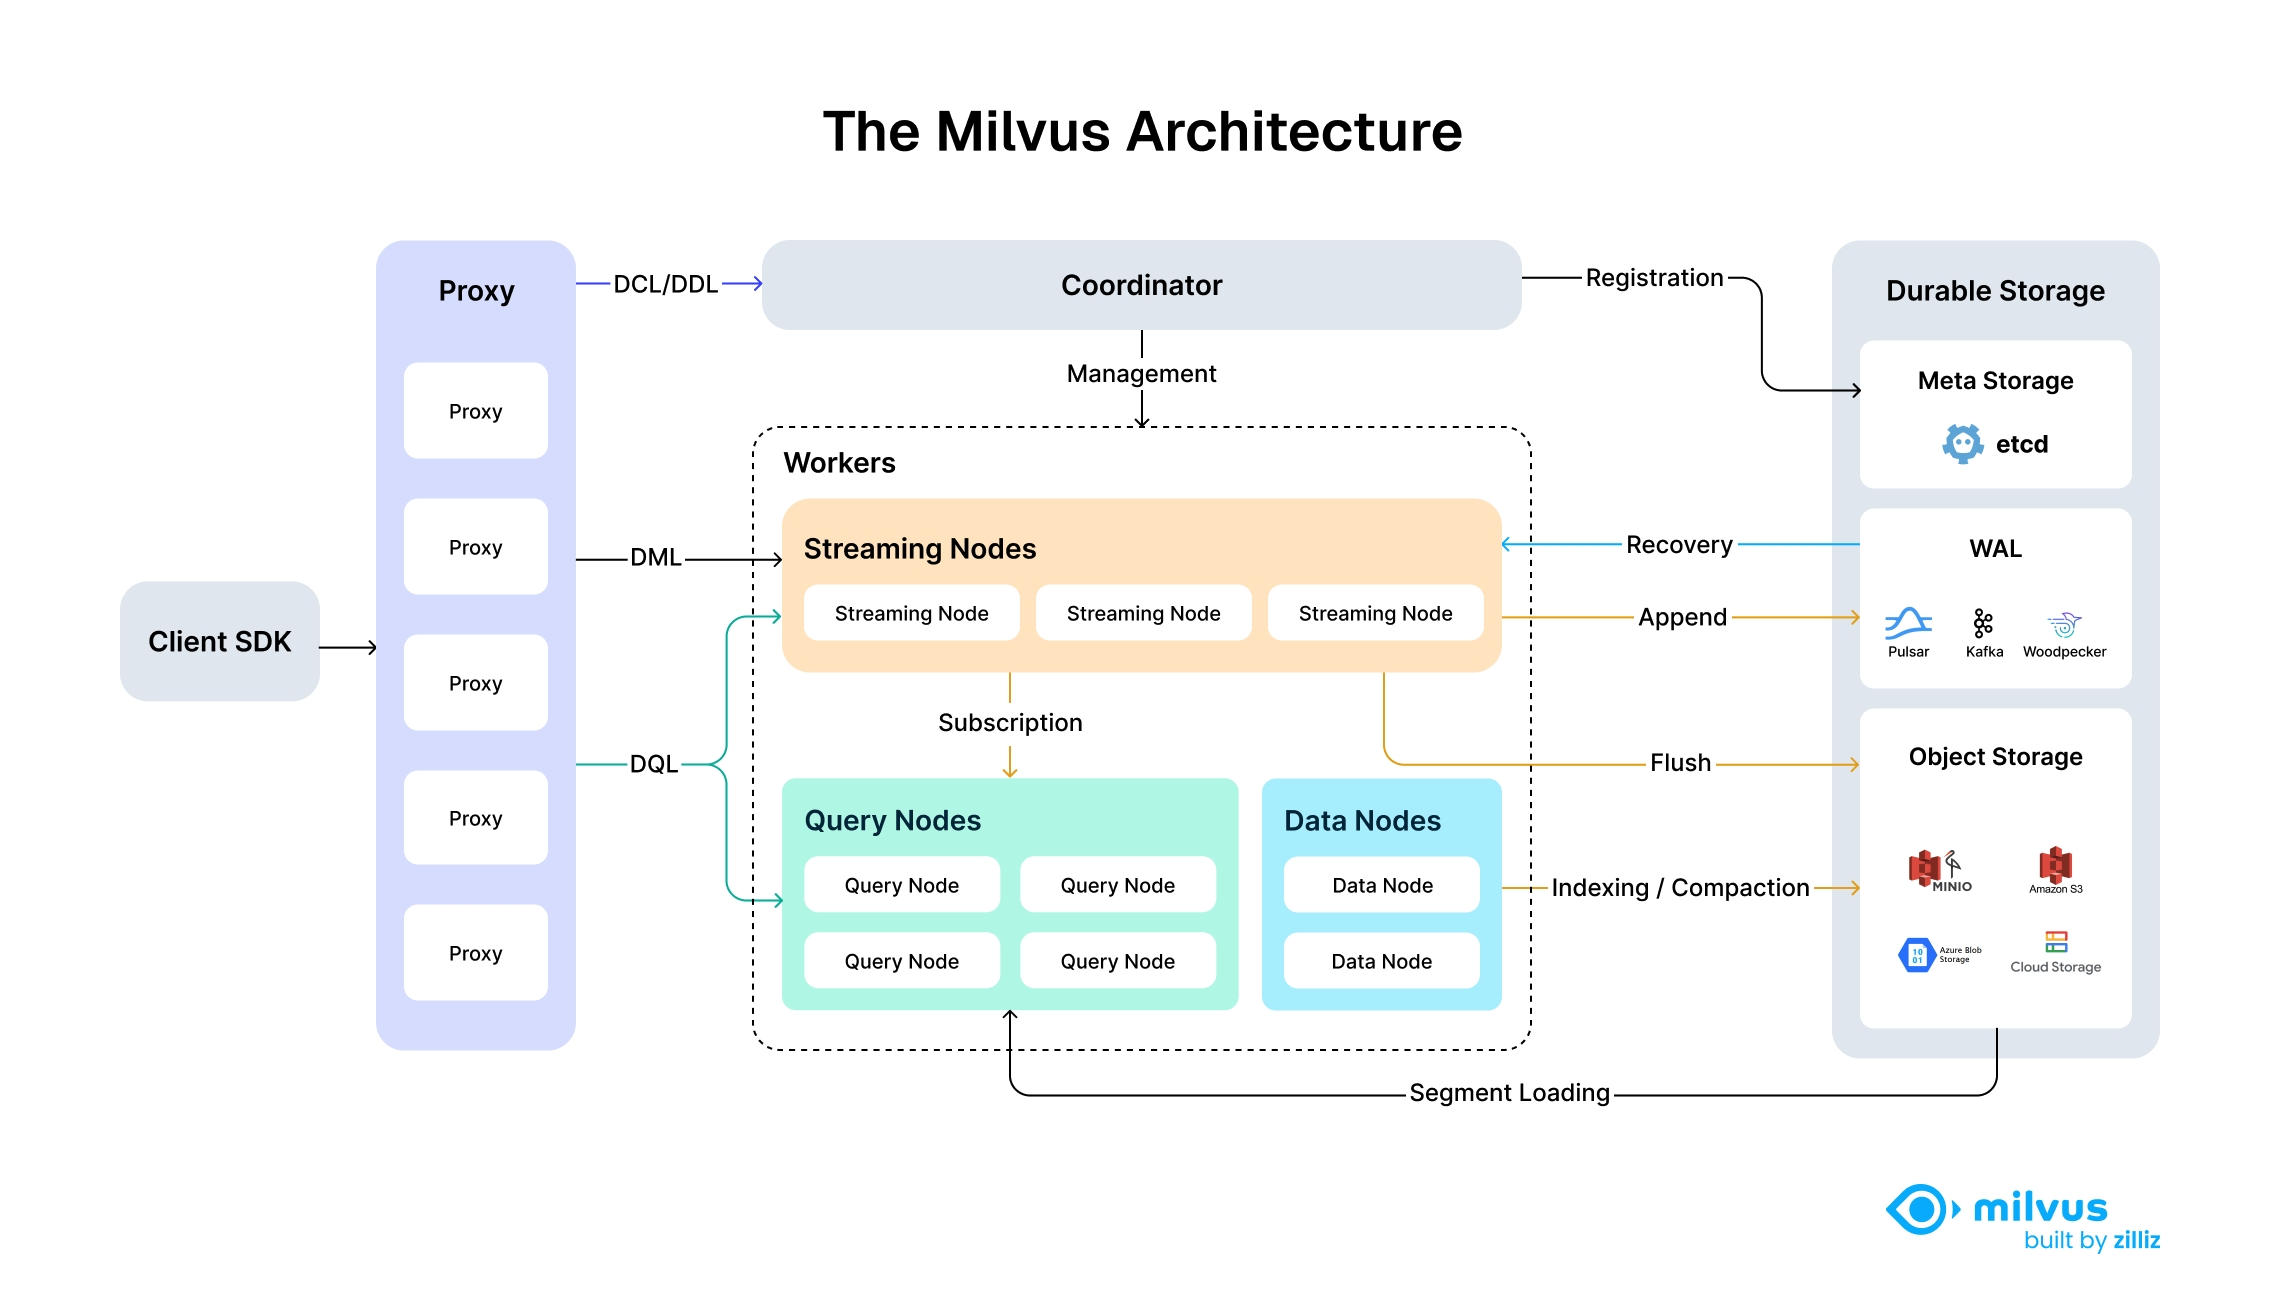 Milvus的高解耦系统架构
Milvus 本身完全无状态,因此借助 Kubernetes 或公有云即可轻松实现扩展。 此外,Milvus 的各组件之间解耦程度高,其中三项最关键的任务——搜索、数据插入以及索引/压缩——均被设计为易于并行化的进程,并将复杂逻辑分离出来。这确保了相应的查询节点、数据节点和索引节点能够独立地进行纵向和横向扩展,从而优化性能和成本效益。
Milvus 支持的搜索类型
Milvus 支持多种搜索功能,以满足不同用例的需求:
- ANN 搜索:查找与查询向量最接近的前 K 个向量。
- 过滤搜索:在指定的过滤条件下执行 ANN 搜索。
- 范围搜索:查找距离查询向量在指定半径范围内的向量。
- 混合搜索:基于多个向量字段进行 ANN 搜索。
- 全文检索:基于 BM25 的全文检索。
- 重新排序:根据附加条件或辅助算法调整搜索结果的顺序,从而优化初始的 ANN 搜索结果。
- 提取:按主键检索数据。
- 查询:使用特定表达式检索数据。
全面的功能集
除了上述关键搜索功能外,Milvus 还提供了一套围绕 ANN 搜索实现的功能,以便您能够充分利用其功能。
API 和 SDK
- RESTful API(官方)
- PyMilvus(Python SDK)(官方)
- Go SDK(官方)
- Java SDK(官方)
- Node.js(JavaScript)SDK(官方)
- C#(由微软提供)
- C++ SDK(官方)
- Rust SDK(开发中)
高级数据类型
除了基本数据类型外,Milvus 还支持各种高级数据类型及其各自适用的距离度量。
为何选择 Milvus?
大规模高性能与高可用性
Milvus 采用计算与存储分离的分布式架构。它能够进行水平扩展并适应多种流量模式,通过针对读取密集型工作负载独立增加查询节点、针对写入密集型工作负载独立增加数据节点,从而实现最佳性能。 基于K8s的无状态微服务可实现快速故障恢复,确保高可用性。对副本的支持通过将数据分段加载到多个查询节点上,进一步增强了容错能力和吞吐量。请参阅基准测试以了解性能对比。
支持多种向量索引类型和硬件加速
Milvus 将系统与核心向量搜索引擎分离,从而能够支持针对不同场景进行优化的所有主流向量索引类型,包括 HNSW、IVF、FLAT(暴力搜索)、SCANN 和 DiskANN,以及基于量化的变体和mmap。 Milvus针对元数据过滤和范围搜索等高级功能优化了向量搜索。此外,Milvus 实现了硬件加速以提升向量搜索性能,并支持 GPU 索引,例如 NVIDIA 的CAGRA。
灵活的多租户与热/冷存储
Milvus 通过在数据库、Collection、分区或 Partition Key 级别进行隔离来支持多租户。这些灵活的策略使单个集群能够处理数百至数百万个租户,同时确保了优化的搜索性能和灵活的访问控制。 Milvus 通过热/冷存储机制提升了成本效益。频繁访问的热数据可存储在内存或 SSD 中以获得更佳性能,而访问频率较低的冷数据则保存在速度较慢、成本更低的存储设备上。该机制可在保持关键任务高性能的同时,显著降低成本。
用于全文搜索和混合搜索的稀疏向量
除了通过稠密向量进行语义搜索外,Milvus 还原生支持基于 BM25的全文搜索,以及 SPLADE 和 BGE-M3 等学习型稀疏嵌入。用户可以在同一个 Collection 中存储稀疏向量和稠密向量,并定义函数来对来自多个搜索请求的结果进行重新排序。 参见语义搜索 + 全文搜索的混合搜索示例。
数据安全与精细化访问控制
Milvus 通过实施强制用户身份验证、TLS 加密以及基于角色的访问控制(RBAC)来确保数据安全。用户身份验证确保只有持有有效凭据的授权用户才能访问数据库,而 TLS 加密则保障了网络内所有通信的安全。 此外,RBAC 通过根据用户角色分配特定权限,实现精细的访问控制。这些特性使 Milvus 成为企业应用的可靠且安全的选择,能够保护敏感数据免受未经授权的访问和潜在数据泄露。
AI 集成
嵌入模型集成 嵌入模型将非结构化数据转换为高维数据空间中的数值表示形式,以便您将其存储在 Milvus 中。目前,Python SDK PyMilvus 集成了多种嵌入模型,可帮助您快速将数据转换为向量嵌入。详情请参阅《嵌入概述》。
重新排序模型集成 在信息检索和生成式 AI 领域,重新排序器是优化初始搜索结果排序的关键工具。PyMilvus 还集成了多种重新排序模型,用于优化初始搜索返回的结果排序。详情请参阅《Rerankers概述》。
LangChain 及其他 AI 工具集成 在生成式 AI 时代,LangChain 等工具受到了应用开发者的广泛关注。作为核心组件,Milvus 通常在这些工具中充当向量存储库。如需了解如何将 Milvus 集成到您常用的 AI 工具中,请参阅我们的《集成 与教程 》。
工具与生态系统
Attu Attu 是一个功能齐全且直观的图形用户界面(GUI),可帮助您管理 Milvus 及其存储的数据。详情请参阅Attu代码库。
Birdwatcher Birdwatcher 是 Milvus 的调试工具。通过它连接到 etcd,您可以检查 Milvus 系统的状态或进行动态配置。详情请参阅Birdwatcher。
Prometheus 与 Grafana 集成 Prometheus 是一款面向 Kubernetes 的开源系统监控和告警工具包。Grafana 是一个开源可视化平台,可连接所有数据源。您可以使用 Prometheus 和 Grafana 作为监控服务提供商,直观地监控 Milvus Distributed 系统的性能。详情请参阅《部署监控服务》。
Milvus Backup Milvus Backup 是一款允许用户备份和恢复 Milvus 数据的工具。它同时提供 CLI 和 API,以适应不同的应用场景。详情请参阅《Milvus Backup》。
Milvus 数据变更捕获(CDC) Milvus CDC 可将数据变更从一个 Milvus 集群复制到另一个集群,以实现主备灾难恢复。详情请参阅《Milvus CDC》。
Milvus 连接器 Milvus 已规划了一套连接器,供您将 Milvus 与 Apache Spark 等第三方工具无缝集成。目前,您可以使用我们的 Spark 连接器将 Milvus 数据导入 Apache Spark 进行机器学习处理。详情请参阅《Spark-Milvus 连接器》。
向量传输服务 (VTS) Milvus 提供了一套工具,供您在 Milvus 实例与多种数据源之间传输数据,包括 Zilliz 集群、Elasticsearch、Postgres (PgVector) 以及另一个 Milvus 实例。详情请参阅VTS。
