

O que é o Milvus?
O Milvus é uma ave de rapina do género Milvus, da família dos Accipitridae, conhecida pela sua velocidade em voo, visão apurada e notável capacidade de adaptação.
A Zilliz adotou o nome Milvus para a sua base de dados vetorial de código aberto, de alto desempenho e altamente escalável, que funciona de forma eficiente numa vasta gama de ambientes, desde um computador portátil até sistemas distribuídos em grande escala. Está disponível tanto como software de código aberto como serviço na nuvem.
Desenvolvido pela Zilliz e em breve doado à LF AI & Data Foundation, sob a égide da Linux Foundation, o Milvus tornou-se um dos principais projetos de bases de dados vetoriais de código aberto a nível mundial. É distribuído sob a licença Apache 2.0, e a maioria dos colaboradores são especialistas da comunidade de computação de alto desempenho (HPC), especializados na construção de sistemas de grande escala e na otimização de código sensível ao hardware. Entre os principais colaboradores contam-se profissionais da Zilliz, ARM, NVIDIA, AMD, Intel, Meta, IBM, Salesforce, Alibaba e Microsoft.
Curiosamente, todos os projetos de código aberto da Zilliz têm nomes de aves, uma convenção de nomenclatura que simboliza a liberdade, a visão de futuro e a evolução ágil da tecnologia.
Dados não estruturados, embeddings e Milvus
Os dados não estruturados, tais como texto, imagens e áudio, variam em formato e contêm uma rica semântica subjacente, o que torna a sua análise um desafio. Para gerir esta complexidade, utilizam-se embeddings para converter dados não estruturados em vetores numéricos que captam as suas características essenciais. Estes vetores são depois armazenados numa base de dados vetorial, permitindo pesquisas e análises rápidas e escaláveis.
O Milvus oferece capacidades robustas de modelação de dados, permitindo-lhe organizar os seus dados não estruturados ou multimodais em coleções estruturadas. Suporta uma vasta gama de tipos de dados para diferentes modelos de atributos, incluindo tipos numéricos e de caracteres comuns, vários tipos de vetores, matrizes, conjuntos e JSON, poupando-lhe o esforço de manter múltiplos sistemas de bases de dados.
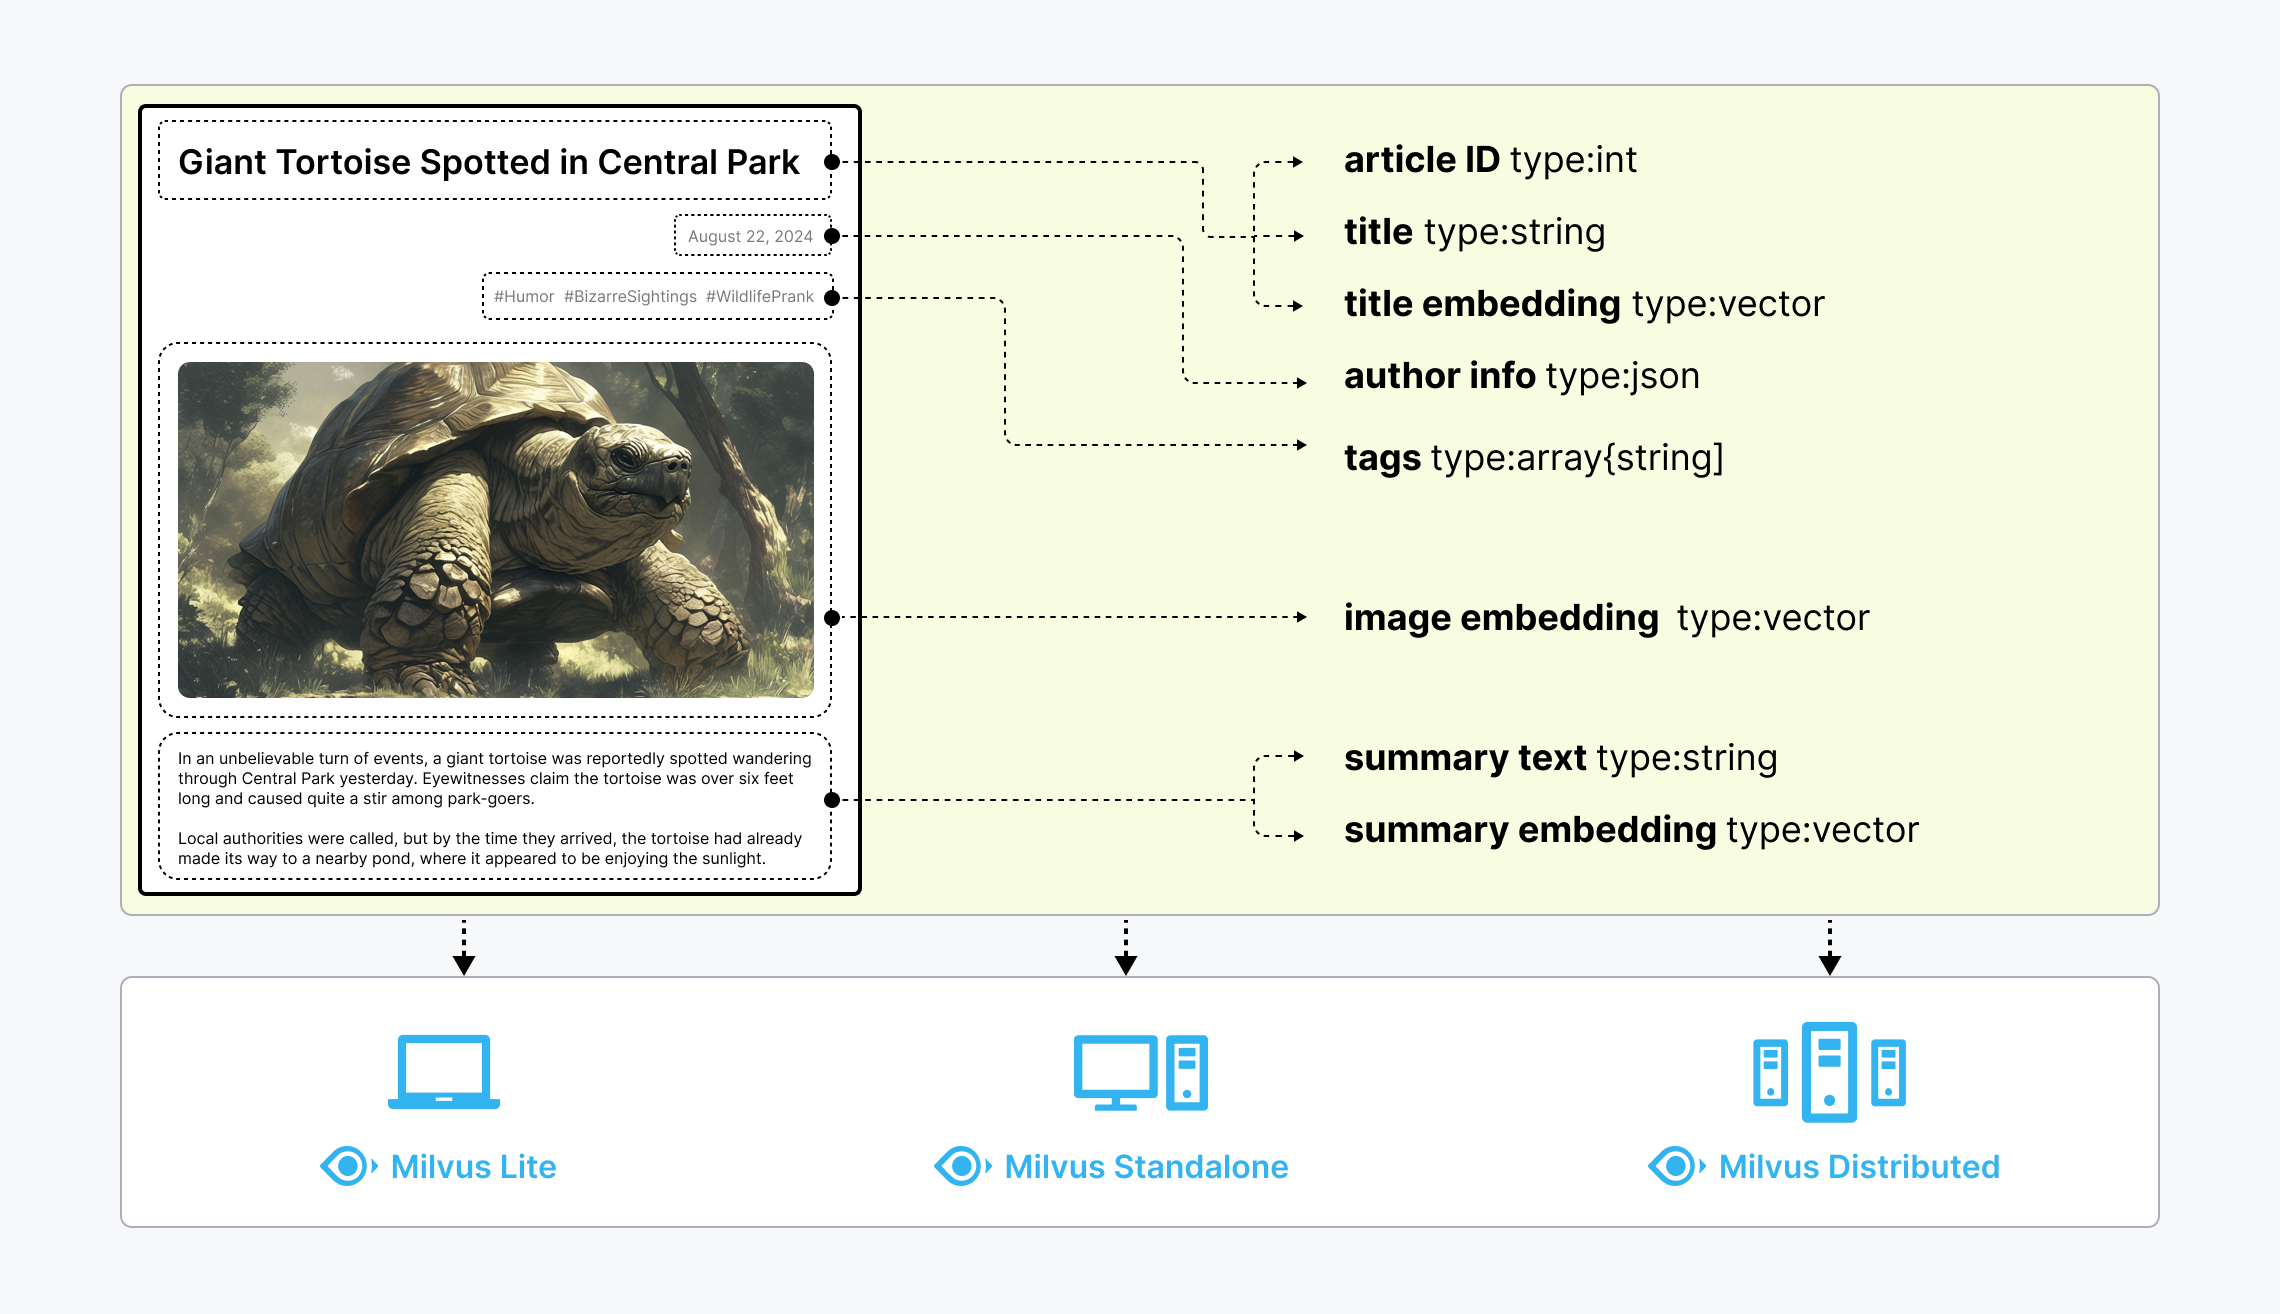 Dados não estruturados, embeddings e o Milvus
O Milvus oferece três modos de implementação, abrangendo uma vasta gama de escalas de dados — desde a prototipagem local em Jupyter Notebooks até a grandes clusters de Kubernetes que gerem dezenas de milhares de milhões de vetores:
- O Milvus Lite é uma biblioteca Python que pode ser facilmente integrada nas suas aplicações. Sendo uma versão leve do Milvus, é ideal para prototipagem rápida em Jupyter Notebooks ou para execução em dispositivos de borda com recursos limitados. Saiba mais.
- O Milvus Standalone é uma implementação de servidor numa única máquina, com todos os componentes agrupados numa única imagem Docker para uma implementação conveniente. Saiba mais.
- O Milvus Distributed pode ser implementado em clusters do Kubernetes, apresentando uma arquitetura nativa da nuvem concebida para cenários na escala de milhares de milhões ou ainda maiores. Esta arquitetura garante redundância nos componentes críticos. Saiba mais.
O que torna o Milvus tão rápido?
O Milvus foi concebido desde o início para ser um sistema de base de dados vetorial altamente eficiente. Na maioria dos casos, o Milvus supera outras bases de dados vetoriais em 2 a 5 vezes (consulte os resultados do VectorDBBench). Este elevado desempenho é o resultado de várias decisões-chave de conceção:
Otimização adaptada ao hardware: Para adaptar o Milvus a vários ambientes de hardware, otimizámos o seu desempenho especificamente para muitas arquiteturas e plataformas de hardware, incluindo AVX512, SIMD, GPUs e SSD NVMe.
Algoritmos de pesquisa avançados: O Milvus suporta uma vasta gama de algoritmos de indexação/pesquisa na memória e no disco, incluindo IVF, HNSW, DiskANN e outros, todos eles profundamente otimizados. Em comparação com implementações populares como o FAISS e o HNSWLib, o Milvus oferece um desempenho 30% a 70% superior.
Motor de pesquisa em C++: Mais de 80% do desempenho de uma base de dados vetorial é determinado pelo seu motor de pesquisa. O Milvus utiliza C++ para este componente crítico devido ao elevado desempenho da linguagem, à otimização de baixo nível e à gestão eficiente de recursos. Mais importante ainda, o Milvus integra inúmeras otimizações de código sensíveis ao hardware, que vão desde a vetorização ao nível da linguagem de montagem até à paralelização e agendamento multithread, para tirar pleno partido das capacidades do hardware.
Orientado para colunas: O Milvus é um sistema de base de dados vetorial orientado para colunas. As principais vantagens decorrem dos padrões de acesso aos dados. Ao realizar consultas, uma base de dados orientada para colunas lê apenas os campos específicos envolvidos na consulta, em vez de linhas inteiras, o que reduz significativamente a quantidade de dados acedidos. Além disso, as operações em dados baseados em colunas podem ser facilmente vetorizadas, permitindo que as operações sejam aplicadas em colunas inteiras de uma só vez, melhorando ainda mais o desempenho.
O que torna o Milvus tão escalável
Em 2022, o Milvus suportava vetores na ordem dos mil milhões e, em 2023, escalou para dezenas de mil milhões com estabilidade consistente, impulsionando cenários de grande escala para mais de 300 grandes empresas, incluindo a Salesforce, PayPal, Shopee, Airbnb, eBay, NVIDIA, IBM, AT&T, LINE, ROBLOX, Inflection, etc.
A arquitetura de sistema nativa da nuvem e altamente desacoplada do Milvus garante que o sistema possa expandir-se continuamente à medida que os dados crescem:
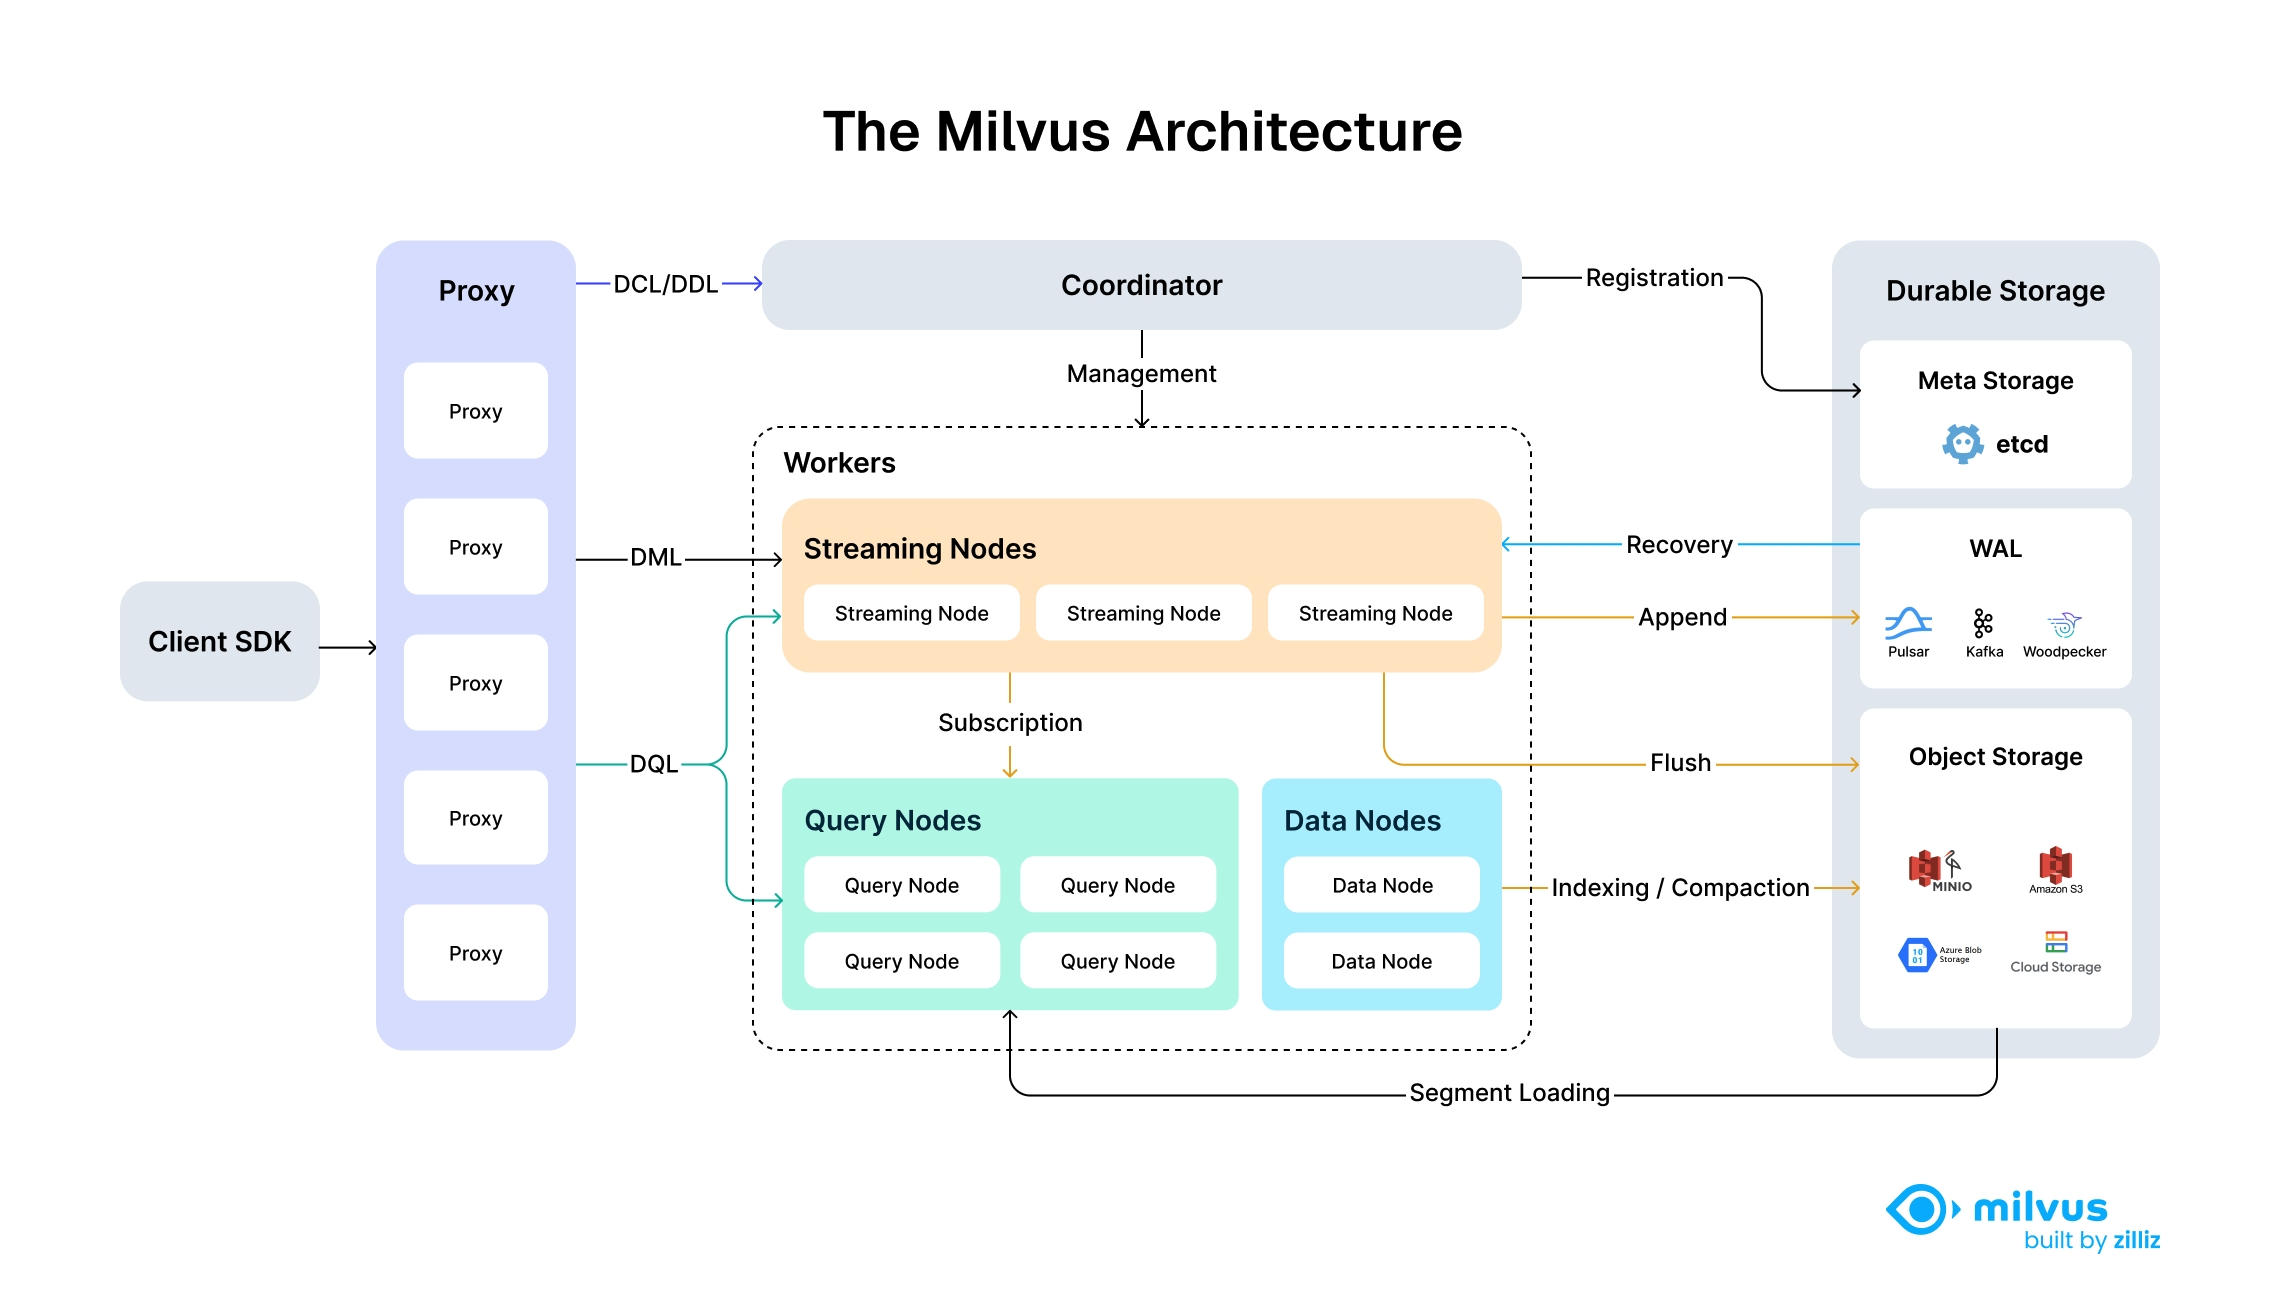 Arquitetura de sistema altamente desacoplada do Milvus
O próprio Milvus é totalmente sem estado, pelo que pode ser facilmente dimensionado com a ajuda do Kubernetes ou de nuvens públicas. Além disso, os componentes do Milvus estão bem desacoplados, sendo que as três tarefas mais críticas — pesquisa, inserção de dados e indexação/compactação — foram concebidas como processos facilmente paralelizáveis, com a lógica complexa separada. Isto garante que o nó de consulta, o nó de dados e o nó de índice correspondentes possam ser dimensionados tanto verticalmente como horizontalmente de forma independente, otimizando o desempenho e a eficiência de custos.
Tipos de pesquisas suportados pelo Milvus
O Milvus suporta vários tipos de funções de pesquisa para satisfazer as exigências de diferentes casos de utilização:
- Pesquisa ANN: Encontra os K vetores mais próximos do seu vetor de consulta.
- Pesquisa com filtragem: Realiza uma pesquisa ANN sob condições de filtragem especificadas.
- Pesquisa por intervalo: Encontra vetores dentro de um raio especificado a partir do seu vetor de consulta.
- Pesquisa híbrida: Realiza uma pesquisa ANN com base em vários campos vetoriais.
- Pesquisa de texto completo: Pesquisa de texto completo com base no BM25.
- Reordenação: Ajusta a ordem dos resultados da pesquisa com base em critérios adicionais ou num algoritmo secundário, refinando os resultados iniciais da pesquisa ANN.
- Recuperação: Recupera dados pelas suas chaves primárias.
- Consulta: Recupera dados utilizando expressões específicas.
Conjunto abrangente de funcionalidades
Para além das principais funcionalidades de pesquisa mencionadas acima, o Milvus também disponibiliza um conjunto de funcionalidades implementadas em torno das pesquisas ANN, para que possa tirar o máximo partido das suas capacidades.
API e SDK
- API RESTful (oficial)
- PyMilvus (SDK para Python) (oficial)
- SDK para Go (oficial)
- SDK para Java (oficial)
- SDK paraNode.js (JavaScript) (oficial)
- C# (contribuição da Microsoft)
- SDK em C++ (oficial)
- SDK Rust (em desenvolvimento)
Tipos de dados avançados
Para além dos tipos de dados primitivos, o Milvus suporta vários tipos de dados avançados e as respetivas métricas de distância aplicáveis.
- Vetores esparsos
- Vetores binários
- Suporte a JSON
- Suporte a matrizes
- Geolocalização
- Texto (em desenvolvimento)
Porquê o Milvus?
Alto desempenho em escala e alta disponibilidade
O Milvus apresenta uma arquitetura distribuída que separa a computação do armazenamento. O Milvus pode escalar horizontalmente e adaptar-se a diversos padrões de tráfego, alcançando um desempenho ideal ao aumentar de forma independente os nós de consulta para cargas de trabalho com grande volume de leituras e os nós de dados para cargas de trabalho com grande volume de gravações. Os microsserviços sem estado no K8s permitem uma recuperação rápida em caso de falha, garantindo alta disponibilidade. O suporte a réplicas melhora ainda mais a tolerância a falhas e a taxa de transferência, ao carregar segmentos de dados em vários nós de consulta. Consulte o benchmark para uma comparação de desempenho.
Suporte a vários tipos de índices vetoriais e aceleração por hardware
O Milvus separa o sistema do motor de pesquisa vetorial principal, permitindo-lhe suportar todos os principais tipos de índices vetoriais otimizados para diferentes cenários, incluindo HNSW, IVF, FLAT (força bruta), SCANN e DiskANN, com variações baseadas em quantização e mmap. O Milvus otimiza a pesquisa vetorial para funcionalidades avançadas, tais como a filtragem de metadados e a pesquisa por intervalo. Além disso, o Milvus implementa aceleração por hardware para melhorar o desempenho da pesquisa vetorial e suporta a indexação por GPU, como o CAGRA da NVIDIA.
Multilocação flexível e armazenamento «quente»/«frio»
O Milvus suporta a multilocação através do isolamento ao nível da base de dados, da coleção, da partição ou da chave de partição. As estratégias flexíveis permitem que um único cluster lide com centenas a milhões de locatários, garantindo também um desempenho de pesquisa otimizado e um controlo de acesso flexível. O Milvus melhora a relação custo-benefício com o armazenamento «quente» e «frio». Os dados «quentes», acedidos com frequência, podem ser armazenados na memória ou em SSDs para um melhor desempenho, enquanto os dados «frios», menos acedidos, são mantidos num armazenamento mais lento e económico. Este mecanismo pode reduzir significativamente os custos, mantendo ao mesmo tempo um elevado desempenho para tarefas críticas.
Vetor esparso para pesquisa de texto completo e pesquisa híbrida
Para além da pesquisa semântica através de vetores densos, o Milvus também suporta nativamente a pesquisa de texto completo com BM25, bem como incorporações esparsas aprendidas, tais como SPLADE e BGE-M3. Os utilizadores podem armazenar vetores esparsos e vetores densos na mesma coleção e definir funções para reclassificar os resultados de múltiplas solicitações de pesquisa. Veja exemplos de pesquisa híbrida com pesquisa semântica + pesquisa de texto completo.
Segurança de dados e controlo de acesso granular
O Milvus garante a segurança dos dados através da implementação de autenticação obrigatória de utilizadores, encriptação TLS e Controlo de Acesso Baseado em Funções (RBAC). A autenticação de utilizadores garante que apenas utilizadores autorizados com credenciais válidas possam aceder à base de dados, enquanto a encriptação TLS protege todas as comunicações dentro da rede. Além disso, o RBAC permite um controlo de acesso granular, atribuindo permissões específicas aos utilizadores com base nas suas funções. Estas funcionalidades tornam o Milvus uma escolha robusta e segura para aplicações empresariais, protegendo dados sensíveis contra o acesso não autorizado e potenciais violações.
Integrações de IA
Integrações de modelos de incorporação Os modelos de incorporação convertem dados não estruturados na sua representação numérica num espaço de dados de alta dimensão, para que possa armazená-los no Milvus. Atualmente, o PyMilvus, o SDK para Python, integra vários modelos de incorporação para que possa preparar rapidamente os seus dados em incorporações vetoriais. Para mais detalhes, consulte a Visão Geral da Incorporação.
Integrações de modelos de reclassificação No domínio da recuperação de informação e da IA generativa, um reclassificador é uma ferramenta essencial que otimiza a ordem dos resultados das pesquisas iniciais. O PyMilvus também integra vários modelos de reclassificação para otimizar a ordem dos resultados devolvidos pelas pesquisas iniciais. Para mais detalhes, consulte a Visão Geral dos Reclassificadores.
Integrações com o LangChain e outras ferramentas de IA Na era da IA gerativa (GenAI), ferramentas como o LangChain têm vindo a atrair muita atenção por parte dos programadores de aplicações. Como componente central, o Milvus funciona normalmente como armazenamento de vetores nessas ferramentas. Para saber como integrar o Milvus nas suas ferramentas de IA preferidas, consulte as nossas Integrações e Tutoriais.
Ferramentas e ecossistema
Attu O Attu é uma interface gráfica intuitiva e multifuncional que o ajuda a gerir o Milvus e os dados que este armazena. Para mais detalhes, consulte o repositório do Attu.
Birdwatcher O Birdwatcher é uma ferramenta de depuração para o Milvus. Ao utilizá-la para se ligar ao etcd, pode verificar o estado do seu sistema Milvus ou configurá-lo em tempo real. Para mais detalhes, consulte o BirdWatcher.
Integrações com o Prometheus e o Grafana O Prometheus é um conjunto de ferramentas de código aberto para monitorização e alertas do sistema no Kubernetes. O Grafana é uma plataforma de visualização de código aberto que se pode ligar a todas as fontes de dados. Pode utilizar o Prometheus e o Grafana como prestadores de serviços de monitorização para monitorizar visualmente o desempenho do Milvus distribuído. Para mais detalhes, consulte «Implementação de serviços de monitorização».
Milvus Backup O Milvus Backup é uma ferramenta que permite aos utilizadores efetuar cópias de segurança e restaurar dados do Milvus. Disponibiliza tanto a CLI como a API para se adaptar a diferentes cenários de aplicação. Para mais detalhes, consulte Milvus Backup.
Milvus Capture Data Change (CDC) O Milvus CDC pode replicar alterações de dados de um cluster do Milvus para outro, para recuperação de desastres em modo primário-de reserva. Para mais detalhes, consulte Milvus CDC.
Conectores do Milvus O Milvus disponibiliza um conjunto de conectores para que possa integrar o Milvus de forma transparente com ferramentas de terceiros, como o Apache Spark. Atualmente, pode utilizar o nosso Conector Spark para enviar os seus dados do Milvus para o Apache Spark, para processamento de aprendizagem automática. Para mais detalhes, consulte Conector Spark-Milvus.
Serviços de Transmissão de Vetores (VTS) O Milvus fornece um conjunto de ferramentas para transferir os seus dados entre uma instância do Milvus e várias fontes de dados, incluindo clusters Zilliz, Elasticsearch, Postgres (PgVector) e outra instância do Milvus. Para mais detalhes, consulte VTS.
