

Milvusとは?
ミルバス( )は、タカ科(Accipitridae)のMilvus属(Milvus)に属する猛禽類であり、その飛行速度、鋭い視力、そして驚くべき適応力によって知られています。
Zillizは、ノートパソコンから大規模な分散システムに至るまで、幅広い環境で効率的に動作する、オープンソースの高性能かつ高スケーラブルなベクトルデータベースに「Milvus」という名称を採用しました。これはオープンソースソフトウェアとしても、クラウドサービスとしても利用可能です。
Zillizによって開発され、まもなくLinux Foundation傘下のLF AI & Data Foundationに寄贈される予定のMilvusは、世界をリードするオープンソースベクトルデータベースプロジェクトの一つとなっています。 Apache 2.0ライセンスの下で配布されており、貢献者の多くは、大規模システムの構築やハードウェアを意識したコードの最適化を専門とする、ハイパフォーマンスコンピューティング(HPC)コミュニティの専門家です。主要な貢献者には、Zilliz、ARM、NVIDIA、AMD、Intel、Meta、IBM、Salesforce、Alibaba、Microsoftの専門家が名を連ねています。
興味深いことに、Zillizのすべてのオープンソースプロジェクトは鳥の名前にちなんで名付けられており、この命名規則は自由、先見性、そして技術の機敏な進化を象徴しています。
非構造化データ、埋め込み表現、およびMilvus
テキスト、画像、音声などの非構造化データは、形式が多様で、その背景には豊かな意味論が込められているため、分析が困難です。この複雑さに対処するため、埋め込み(エンベディング)を用いて非構造化データを、その本質的な特性を捉えた数値ベクトルに変換します。これらのベクトルはベクトルデータベースに格納され、高速かつスケーラブルな検索や分析を可能にします。
Milvusは堅牢なデータモデリング機能を提供し、非構造化データやマルチモーダルデータを構造化されたコレクションとして整理することを可能にします。一般的な数値型や文字型、各種ベクトル型、配列、集合、JSONなど、さまざまな属性モデリングに対応した幅広いデータ型をサポートしており、複数のデータベースシステムを維持管理する手間を省くことができます。
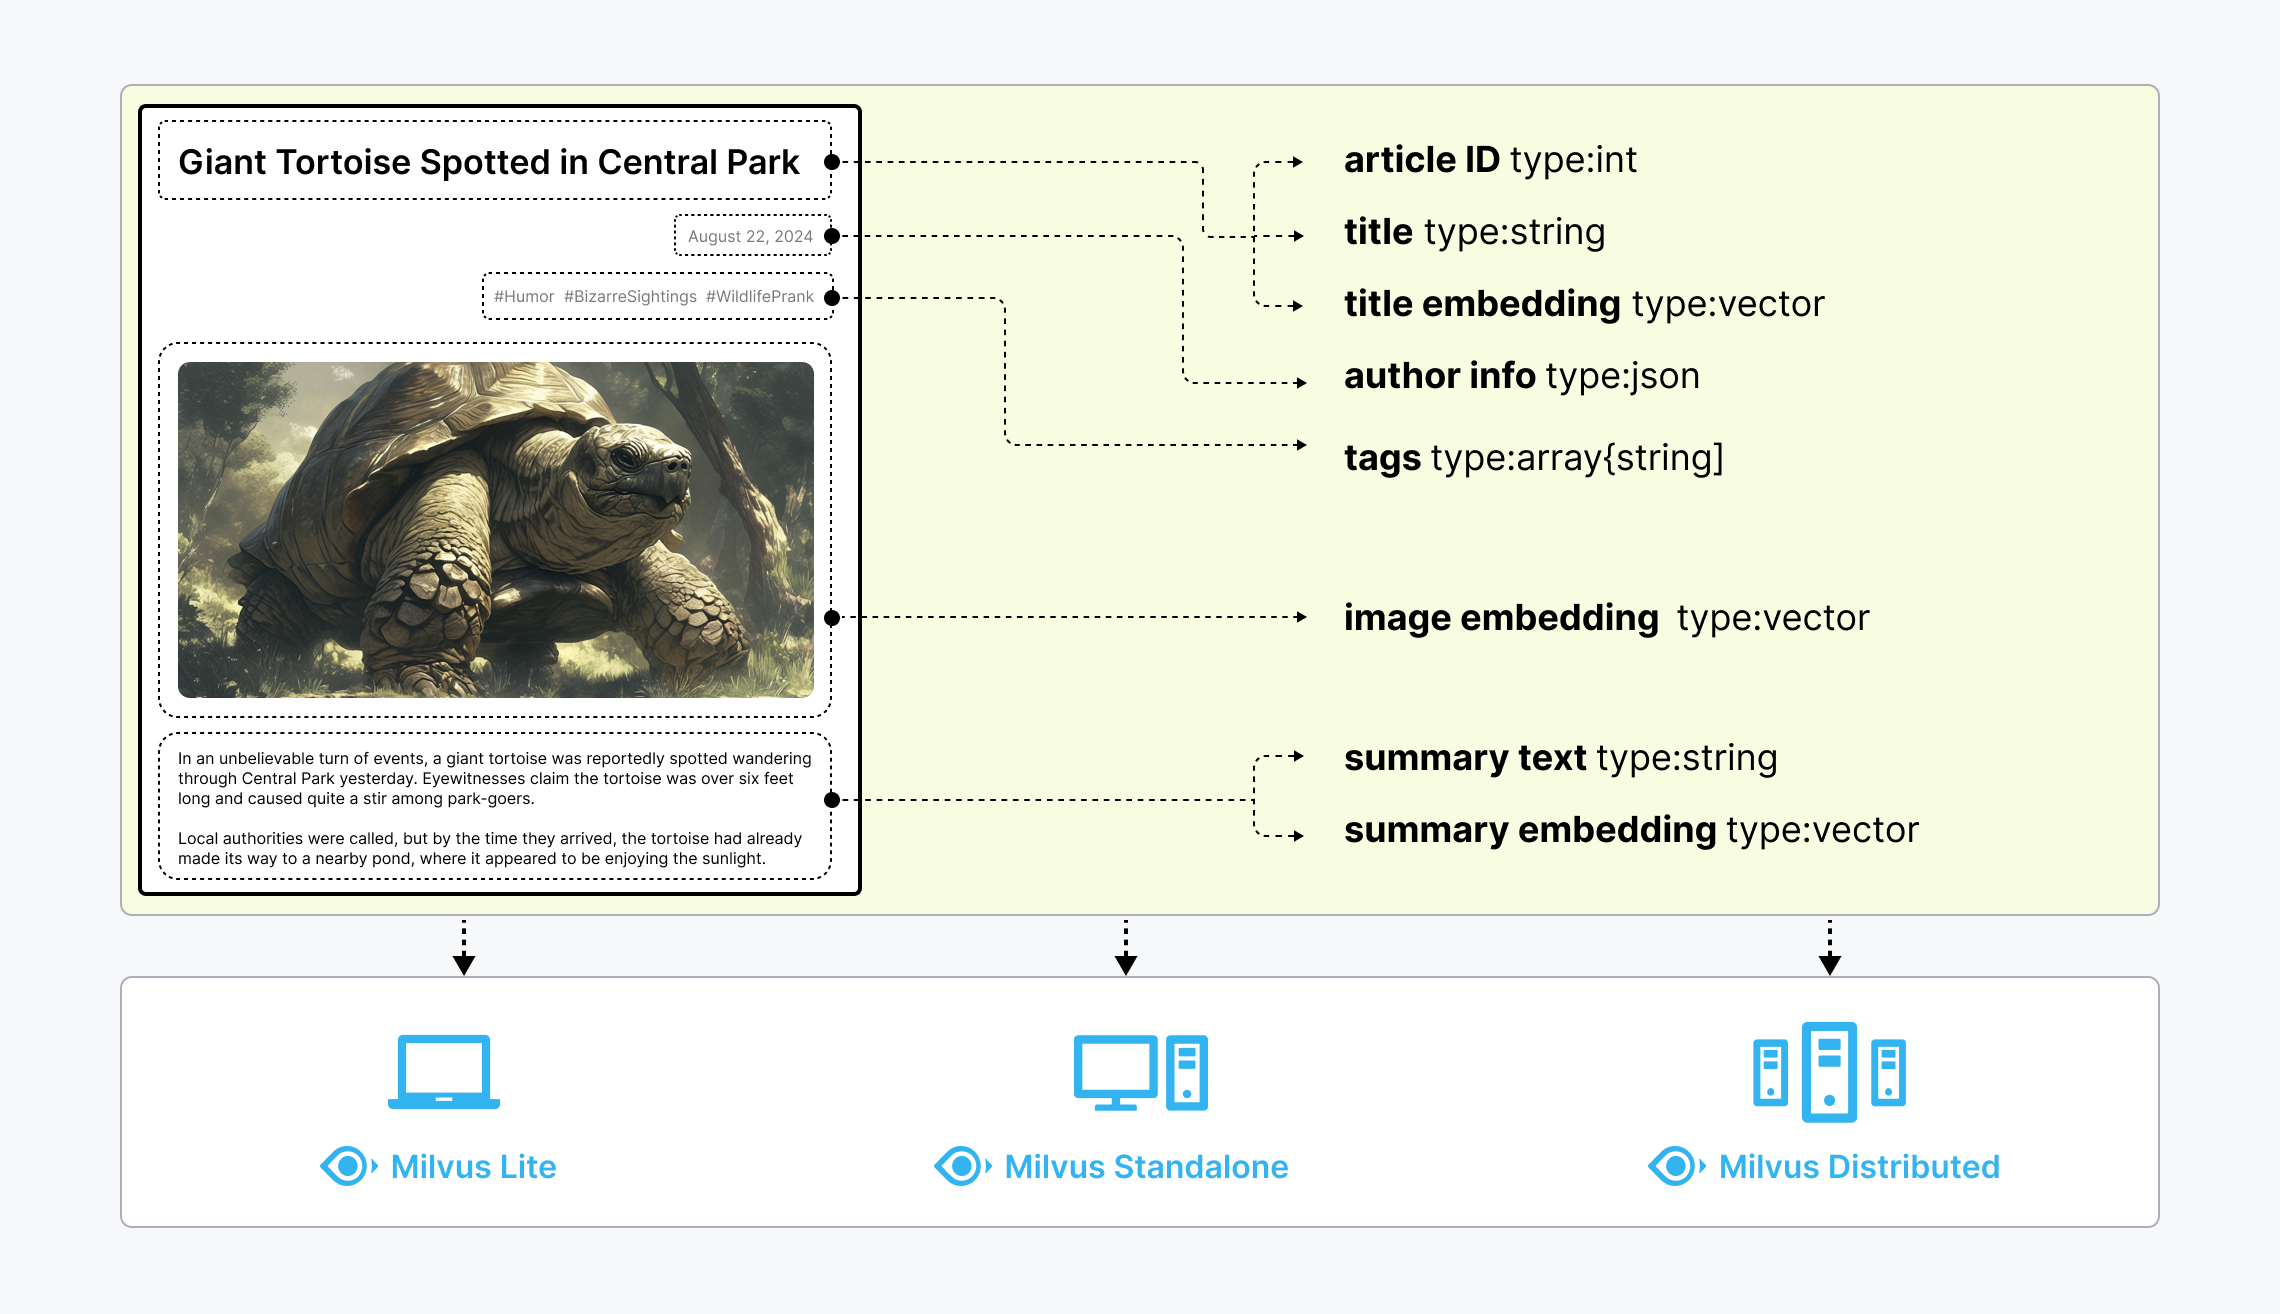 非構造化データ、埋め込み、そしてMilvus
Milvusは、Jupyter Notebookでのローカルプロトタイピングから、数百億のベクトルを管理する大規模なKubernetesクラスタまで、幅広いデータ規模に対応する3つのデプロイメントモードを提供しています:
- Milvus Liteは、アプリケーションに簡単に統合できるPythonライブラリです。Milvusの軽量版として、Jupyter Notebookでの迅速なプロトタイピングや、リソースが限られたエッジデバイスでの実行に最適です。詳細はこちら。
- Milvus Standaloneは、単一マシンでのサーバー展開であり、すべてのコンポーネントが1つのDockerイメージにバンドルされているため、手軽にデプロイできます。詳細はこちら。
- Milvus Distributedは、Kubernetesクラスター上にデプロイ可能で、数十億規模、あるいはそれ以上のシナリオ向けに設計されたクラウドネイティブアーキテクチャを特徴としています。このアーキテクチャにより、重要なコンポーネントの冗長性が確保されます。詳細はこちら。
Milvusの高速性の秘密とは?
Milvusは、開発当初から高効率なベクトルデータベースシステムとなるよう設計されました。ほとんどの場合、Milvusは他のベクトルデータベースよりも2~5倍のパフォーマンスを発揮します(VectorDBBenchの結果を参照)。この高いパフォーマンスは、いくつかの重要な設計上の決定によるものです:
ハードウェアを意識した最適化:Milvusをさまざまなハードウェア環境に対応させるため、AVX512、SIMD、GPU、NVMe SSDなど、多くのハードウェアアーキテクチャやプラットフォーム向けにパフォーマンスを最適化しています。
高度な検索アルゴリズム:Milvusは、IVF、HNSW、DiskANNなど、幅広いインメモリおよびオンディスクのインデックス作成・検索アルゴリズムをサポートしており、これらすべてが徹底的に最適化されています。FAISSやHNSWLibといった一般的な実装と比較して、Milvusは30%~70%高いパフォーマンスを発揮します。
C++による検索エンジン:ベクトルデータベースのパフォーマンスの80%以上は、その検索エンジンによって決まります。Milvusは、C++の高いパフォーマンス、低レベルでの最適化、および効率的なリソース管理を活かし、この重要なコンポーネントにC++を採用しています。 最も重要な点として、Milvusはアセンブリレベルのベクトル化からマルチスレッド並列化およびスケジューリングに至るまで、ハードウェアの能力を最大限に活用するための数多くのハードウェア対応コード最適化を統合しています。
列指向:Milvusは列指向のベクトルデータベースシステムです。 その主な利点は、データアクセスパターンに由来します。クエリを実行する際、列指向データベースは行全体ではなく、クエリに関連する特定のフィールドのみを読み込むため、アクセスされるデータ量が大幅に削減されます。さらに、列ベースのデータに対する操作は容易にベクトル化できるため、列全体に対して一度に操作を適用することが可能となり、パフォーマンスがさらに向上します。
Milvusの優れたスケーラビリティの要因
2022年、Milvusは10億規模のベクトルをサポートし、2023年には一貫した安定性を維持しながら数百億規模へとスケールアップし、Salesforce、PayPal、Shopee、Airbnb、eBay、NVIDIA、 IBM、AT&T、LINE、ROBLOX、Inflectionなど、300社以上の大手企業の大規模なシナリオを支えています。
Milvusのクラウドネイティブかつ高度に分離されたシステムアーキテクチャにより、データの増加に合わせてシステムを継続的に拡張することが可能です:
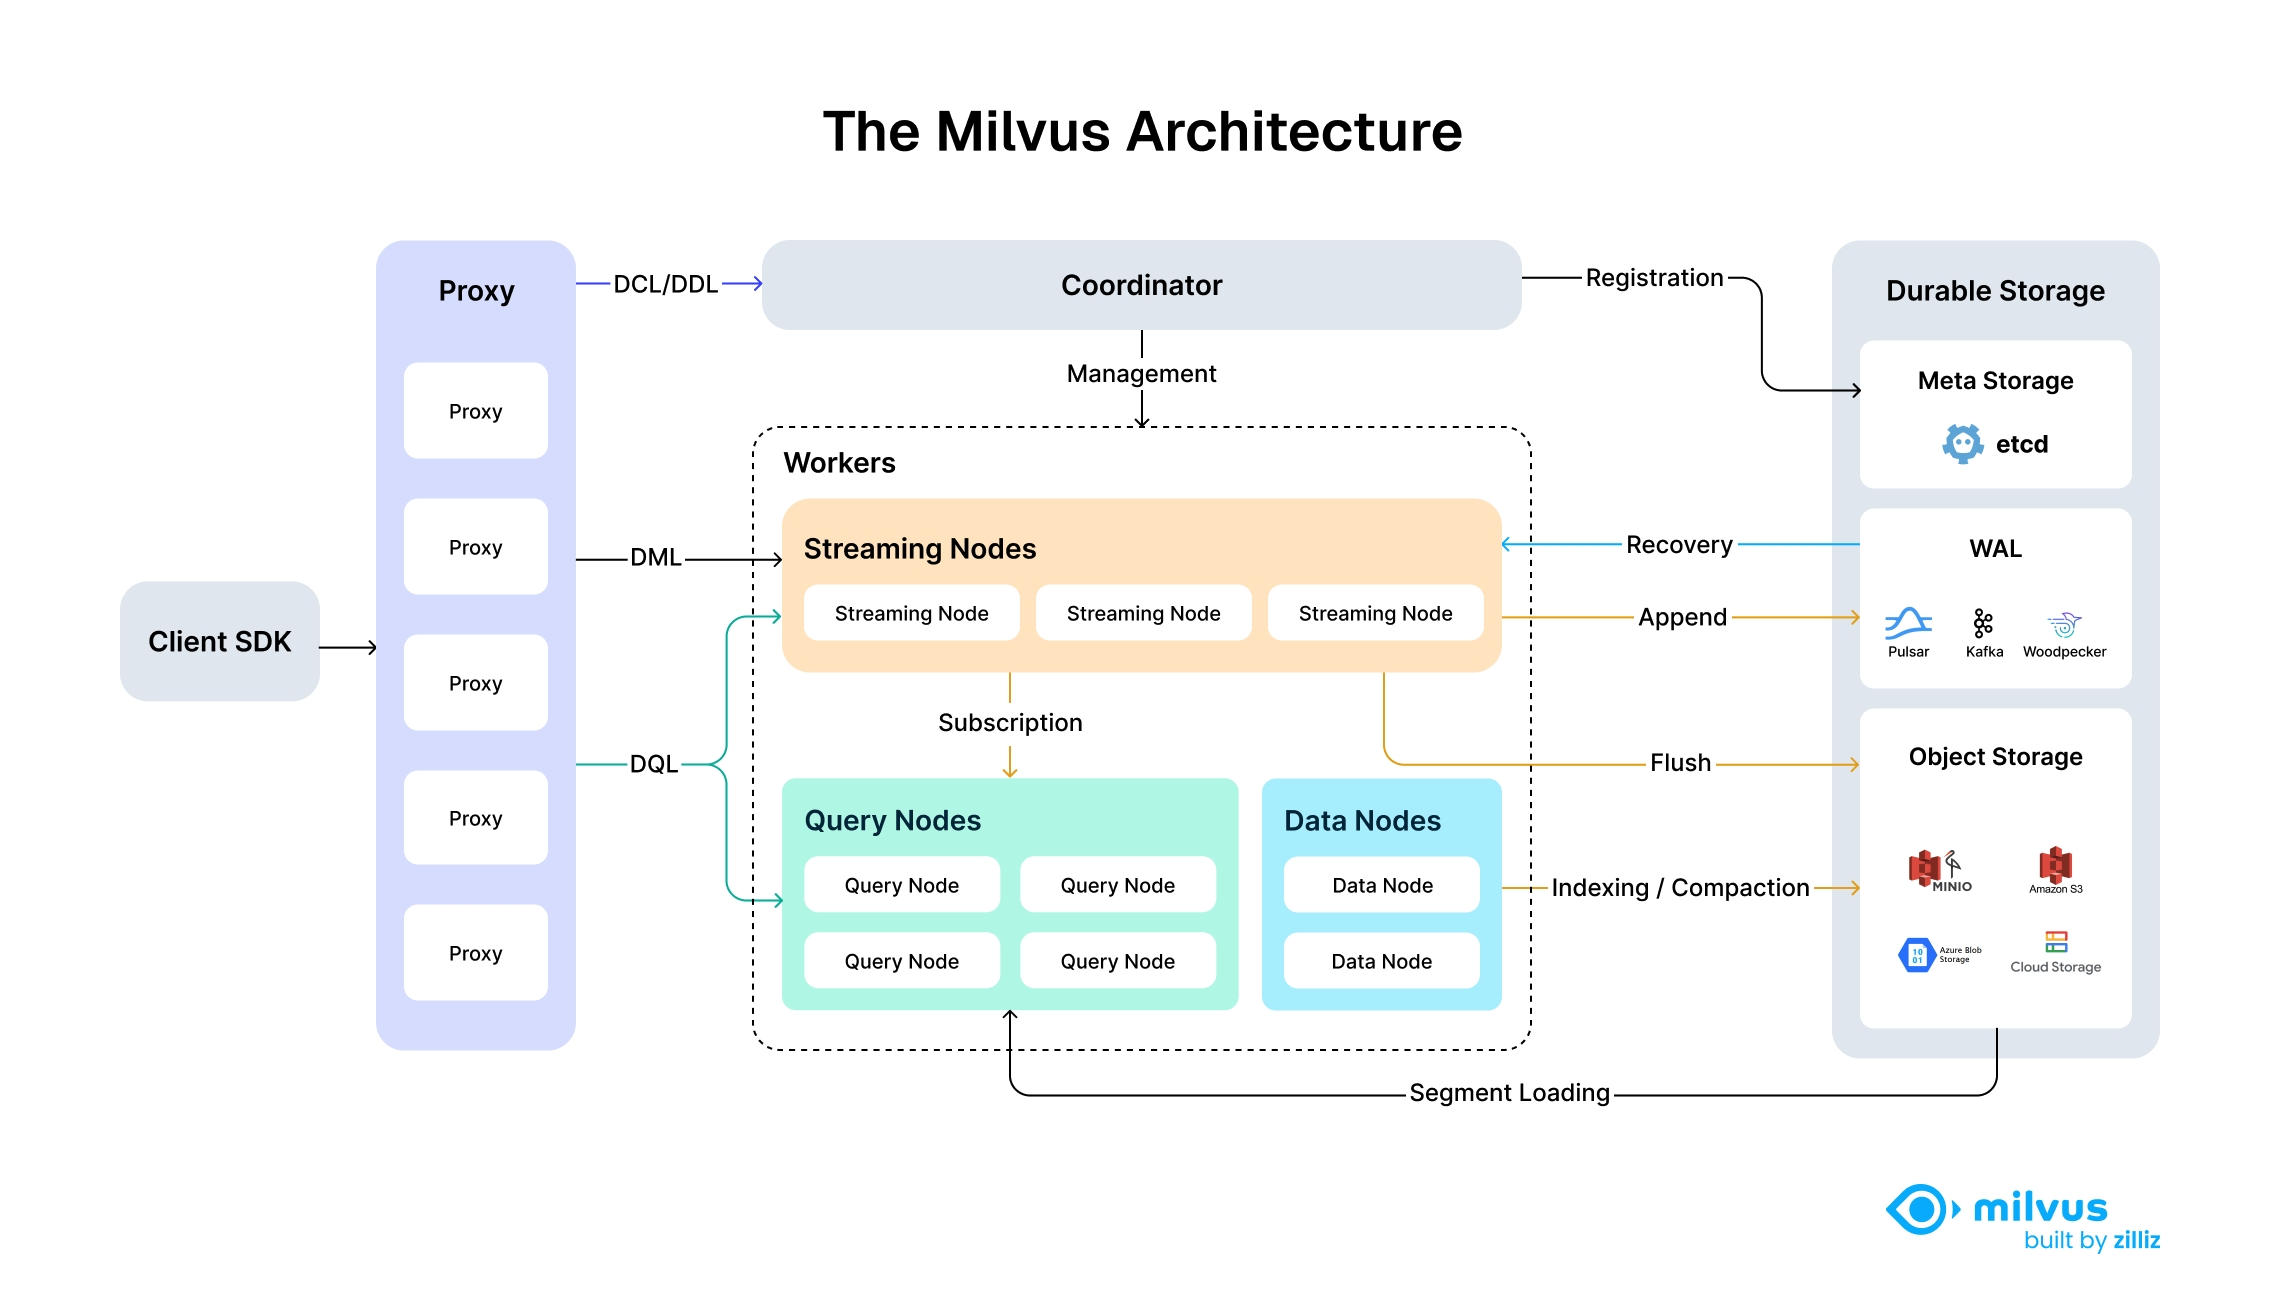 Milvusの高度に疎結合なシステムアーキテクチャ
Milvus自体は完全にステートレスであるため、Kubernetesやパブリッククラウドを活用して容易にスケールアップできます。 さらに、Milvusのコンポーネントは十分に分離されており、最も重要な3つのタスク(検索、データ挿入、インデックス作成/コンパクション)は、複雑なロジックが分離された、容易に並列化可能なプロセスとして設計されています。これにより、対応するクエリノード、データノード、インデックスノードがそれぞれ独立してアップスケールおよびアウトスケールが可能となり、パフォーマンスとコスト効率が最適化されます。
Milvusがサポートする検索の種類
Milvusは、さまざまなユースケースのニーズに応えるため、以下の検索機能をサポートしています:
- ANN検索:クエリベクトルに最も近い上位K個のベクトルを検索します。
- フィルタリング検索:指定されたフィルタリング条件の下でANN検索を実行します。
- 範囲検索:クエリベクトルから指定された半径内にあるベクトルを検索します。
- ハイブリッド検索:複数のベクトルフィールドに基づいてANN検索を実行します。
- 全文検索:BM25に基づく全文検索を行います。
- 再ランク付け:追加の基準または二次アルゴリズムに基づいて検索結果の順序を調整し、初期の ANN 検索結果を精緻化します。
- フェッチ:主キーに基づいてデータを取得します。
- クエリ:特定の式を使用してデータを取得します。
包括的な機能セット
上記の主要な検索機能に加え、Milvus では ANN 検索を基盤として実装された一連の機能も提供しており、その能力を最大限に活用することができます。
API および SDK
- RESTful API(公式)
- PyMilvus(Python SDK) (公式)
- Go SDK(公式)
- Java SDK(公式)
- Node.js(JavaScript) SDK (公式)
- C#(Microsoft 提供)
- C++ SDK(公式)
- Rust SDK(開発中)
高度なデータ型
基本データ型に加え、Milvusは様々な高度なデータ型と、それぞれに適用可能な距離メトリクスをサポートしています。
なぜMilvusなのか?
大規模環境での高性能と高可用性
Milvusは、演算とストレージを分離した分散アーキテクチャを採用しています。Milvusは水平スケーリングが可能で、多様なトラフィックパターンに適応し、読み取り負荷の高いワークロードではクエリノードを、書き込み負荷の高いワークロードではデータノードを個別に増やすことで、最適なパフォーマンスを実現します。 K8s上のステートレスなマイクロサービスにより、障害からの迅速な復旧が可能となり、高可用性が確保されます。レプリカのサポートにより、データセグメントを複数のクエリノードに分散させることで、耐障害性とスループットがさらに向上します。パフォーマンス比較についてはベンチマークをご覧ください。
多様なベクトルインデックス形式とハードウェアアクセラレーションのサポート
Milvusはシステムと中核となるベクトル検索エンジンを分離しており、HNSW、IVF、FLAT(ブルートフォース)、SCANN、DiskANNなど、さまざまなシナリオに最適化された主要なベクトルインデックス形式すべてをサポートしています。これには、量子化ベースのバリエーションやmmapも含まれます。 Milvusは、メタデータフィルタリングや範囲検索などの高度な機能に対してベクトル検索を最適化しています。さらに、ベクトル検索のパフォーマンスを向上させるためのハードウェアアクセラレーションを実装しており、NVIDIAのCAGRAなどのGPUインデックス作成もサポートしています。
柔軟なマルチテナント機能とホット/コールドストレージ
Milvusは、データベース、コレクション、パーティション、またはパーティションキーレベルでの分離を通じてマルチテナントをサポートしています。この柔軟な戦略により、単一のクラスターで数百から数百万のテナントを処理できるほか、最適化された検索パフォーマンスと柔軟なアクセス制御も確保されます。 Milvusは、ホット/コールドストレージによりコスト効率を向上させます。頻繁にアクセスされるホットデータは、パフォーマンス向上のためにメモリまたはSSDに格納でき、アクセス頻度の低いコールドデータは、低速でコスト効率の高いストレージに保持されます。この仕組みにより、重要なタスクに対して高いパフォーマンスを維持しつつ、コストを大幅に削減できます。
全文検索およびハイブリッド検索のためのスパースベクトル
Milvusは、高密度ベクトルによるセマンティック検索に加え、BM25を用いた全文検索や、SPLADEやBGE-M3などの学習済みスパース埋め込みもネイティブにサポートしています。ユーザーは、スパースベクトルと高密度ベクトルを同じコレクションに格納し、複数の検索リクエストからの結果を再ランク付けするための関数を定義することができます。セマンティック検索と全文検索を組み合わせたハイブリッド検索の例をご覧ください。
データセキュリティときめ細かなアクセス制御
Milvusは、必須のユーザー認証、TLS暗号化、およびロールベースのアクセス制御(RBAC)を実装することで、データのセキュリティを確保しています。ユーザー認証により、有効な認証情報を持つ許可されたユーザーのみがデータベースにアクセスできるようになり、TLS暗号化によりネットワーク内のすべての通信が保護されます。 さらに、RBAC により、ユーザーの役割に基づいて特定の権限を割り当てることで、きめ細かなアクセス制御が可能になります。これらの機能により、Milvus はエンタープライズアプリケーションにとって堅牢かつ安全な選択肢となり、機密データを不正アクセスや潜在的な情報漏洩から保護します。
AI 統合
埋め込みモデルの統合 埋め込みモデルは、非構造化データを高次元データ空間における数値表現に変換し、Milvusに保存できるようにします。現在、Python SDKであるPyMilvusには複数の埋め込みモデルが統合されており、データをベクトル埋め込みとして迅速に準備することができます。詳細については、「埋め込みの概要」を参照してください。
再ランク付けモデルの統合 情報検索や生成AIの分野において、再ランク付けモデル(リランカー)は、初期検索の結果順序を最適化する不可欠なツールです。PyMilvusもまた、初期検索から返される結果の順序を最適化するために、いくつかの再ランク付けモデルを統合しています。詳細については、「再ランク付けモデルの概要」を参照してください。
LangChain およびその他の AI ツールとの連携 GenAI の時代において、LangChain などのツールはアプリケーション開発者から大きな注目を集めています。Milvus は中核コンポーネントとして、通常、こうしたツールにおけるベクトルストアとして機能します。お使いの AI ツールに Milvus を統合する方法については、「連携と チュートリアル」をご参照ください。
ツールとエコシステム
Attu Attuは、Milvusおよびそこに格納されたデータを管理するための、直感的なオールインワンGUIです。詳細については、Attuのリポジトリを参照してください。
Birdwatcher Birdwatcherは、Milvus用のデバッグツールです。これを使用してetcdに接続することで、Milvusシステムの状態を確認したり、その場で設定を変更したりすることができます。詳細については、BirdWatcherを参照してください。
Prometheus および Grafana との連携 Prometheusは、Kubernetes向けのオープンソースのシステム監視およびアラートツールキットです。Grafanaは、あらゆるデータソースと連携可能なオープンソースの可視化スタックです。PrometheusとGrafanaを監視サービスプロバイダーとして使用することで、Milvus分散システムのパフォーマンスを視覚的に監視できます。詳細については、「監視サービスのデプロイ」を参照してください。
Milvus Backup Milvus Backupは、Milvusデータのバックアップと復元を可能にするツールです。さまざまなアプリケーションシナリオに対応できるよう、CLIとAPIの両方を提供しています。詳細については、「Milvus Backup」を参照してください。
Milvus データ変更キャプチャ (CDC) Milvus CDC は、プライマリ・スタンバイ方式の災害復旧のために、ある Milvus クラスタから別のクラスタへデータ変更をレプリケートできます。詳細については、「Milvus CDC」を参照してください。
Milvusコネクタ Milvusでは、Apache Sparkなどのサードパーティ製ツールとMilvusをシームレスに統合するための一連のコネクタを用意しています。現在、Sparkコネクタを使用して、MilvusデータをApache Sparkに供給し、機械学習処理を行うことができます。詳細については、「Spark-Milvusコネクタ」を参照してください。
ベクトル転送サービス (VTS) Milvus には、Milvus インスタンスと、Zilliz クラスタ、Elasticsearch、Postgres (PgVector)、および別の Milvus インスタンスを含むさまざまなデータソースとの間でデータを転送するための一連のツールが用意されています。詳細については、VTS を参照してください。
