

Che cos’è il Milvus?
Il Milvus è un rapace appartenente al genere Milvus della famiglia degli Accipitridi, noto per la sua velocità in volo, la vista acuta e la notevole capacità di adattamento.
Zilliz ha scelto il nome Milvus per il suo database vettoriale open source ad alte prestazioni e altamente scalabile, in grado di funzionare in modo efficiente in un'ampia gamma di ambienti, dai laptop ai sistemi distribuiti su larga scala. È disponibile sia come software open source che come servizio cloud.
Sviluppato da Zilliz e presto donato alla LF AI & Data Foundation, parte della Linux Foundation, Milvus è diventato uno dei principali progetti al mondo nel campo dei database vettoriali open source. È distribuito sotto licenza Apache 2.0 e la maggior parte dei collaboratori è costituita da esperti della comunità dell’High-Performance Computing (HPC), specializzati nella realizzazione di sistemi su larga scala e nell’ottimizzazione di codice sensibile all’hardware. Tra i principali collaboratori figurano professionisti provenienti da Zilliz, ARM, NVIDIA, AMD, Intel, Meta, IBM, Salesforce, Alibaba e Microsoft.
È interessante notare che ogni progetto open source di Zilliz prende il nome da un uccello, una convenzione di denominazione che simboleggia la libertà, la lungimiranza e l’evoluzione agile della tecnologia.
Dati non strutturati, embedding e Milvus
I dati non strutturati, come testo, immagini e audio, presentano formati vari e racchiudono una ricca semantica sottostante, il che ne rende difficile l’analisi. Per gestire questa complessità, si utilizzano gli embedding per convertire i dati non strutturati in vettori numerici che ne catturano le caratteristiche essenziali. Questi vettori vengono poi memorizzati in un database vettoriale, consentendo ricerche e analisi veloci e scalabili.
Milvus offre solide funzionalità di modellazione dei dati, consentendovi di organizzare i vostri dati non strutturati o multimodali in raccolte strutturate. Supporta un’ampia gamma di tipi di dati per la modellazione di diversi attributi, inclusi i comuni tipi numerici e di caratteri, vari tipi di vettori, array, insiemi e JSON, risparmiandovi lo sforzo di gestire più sistemi di database.
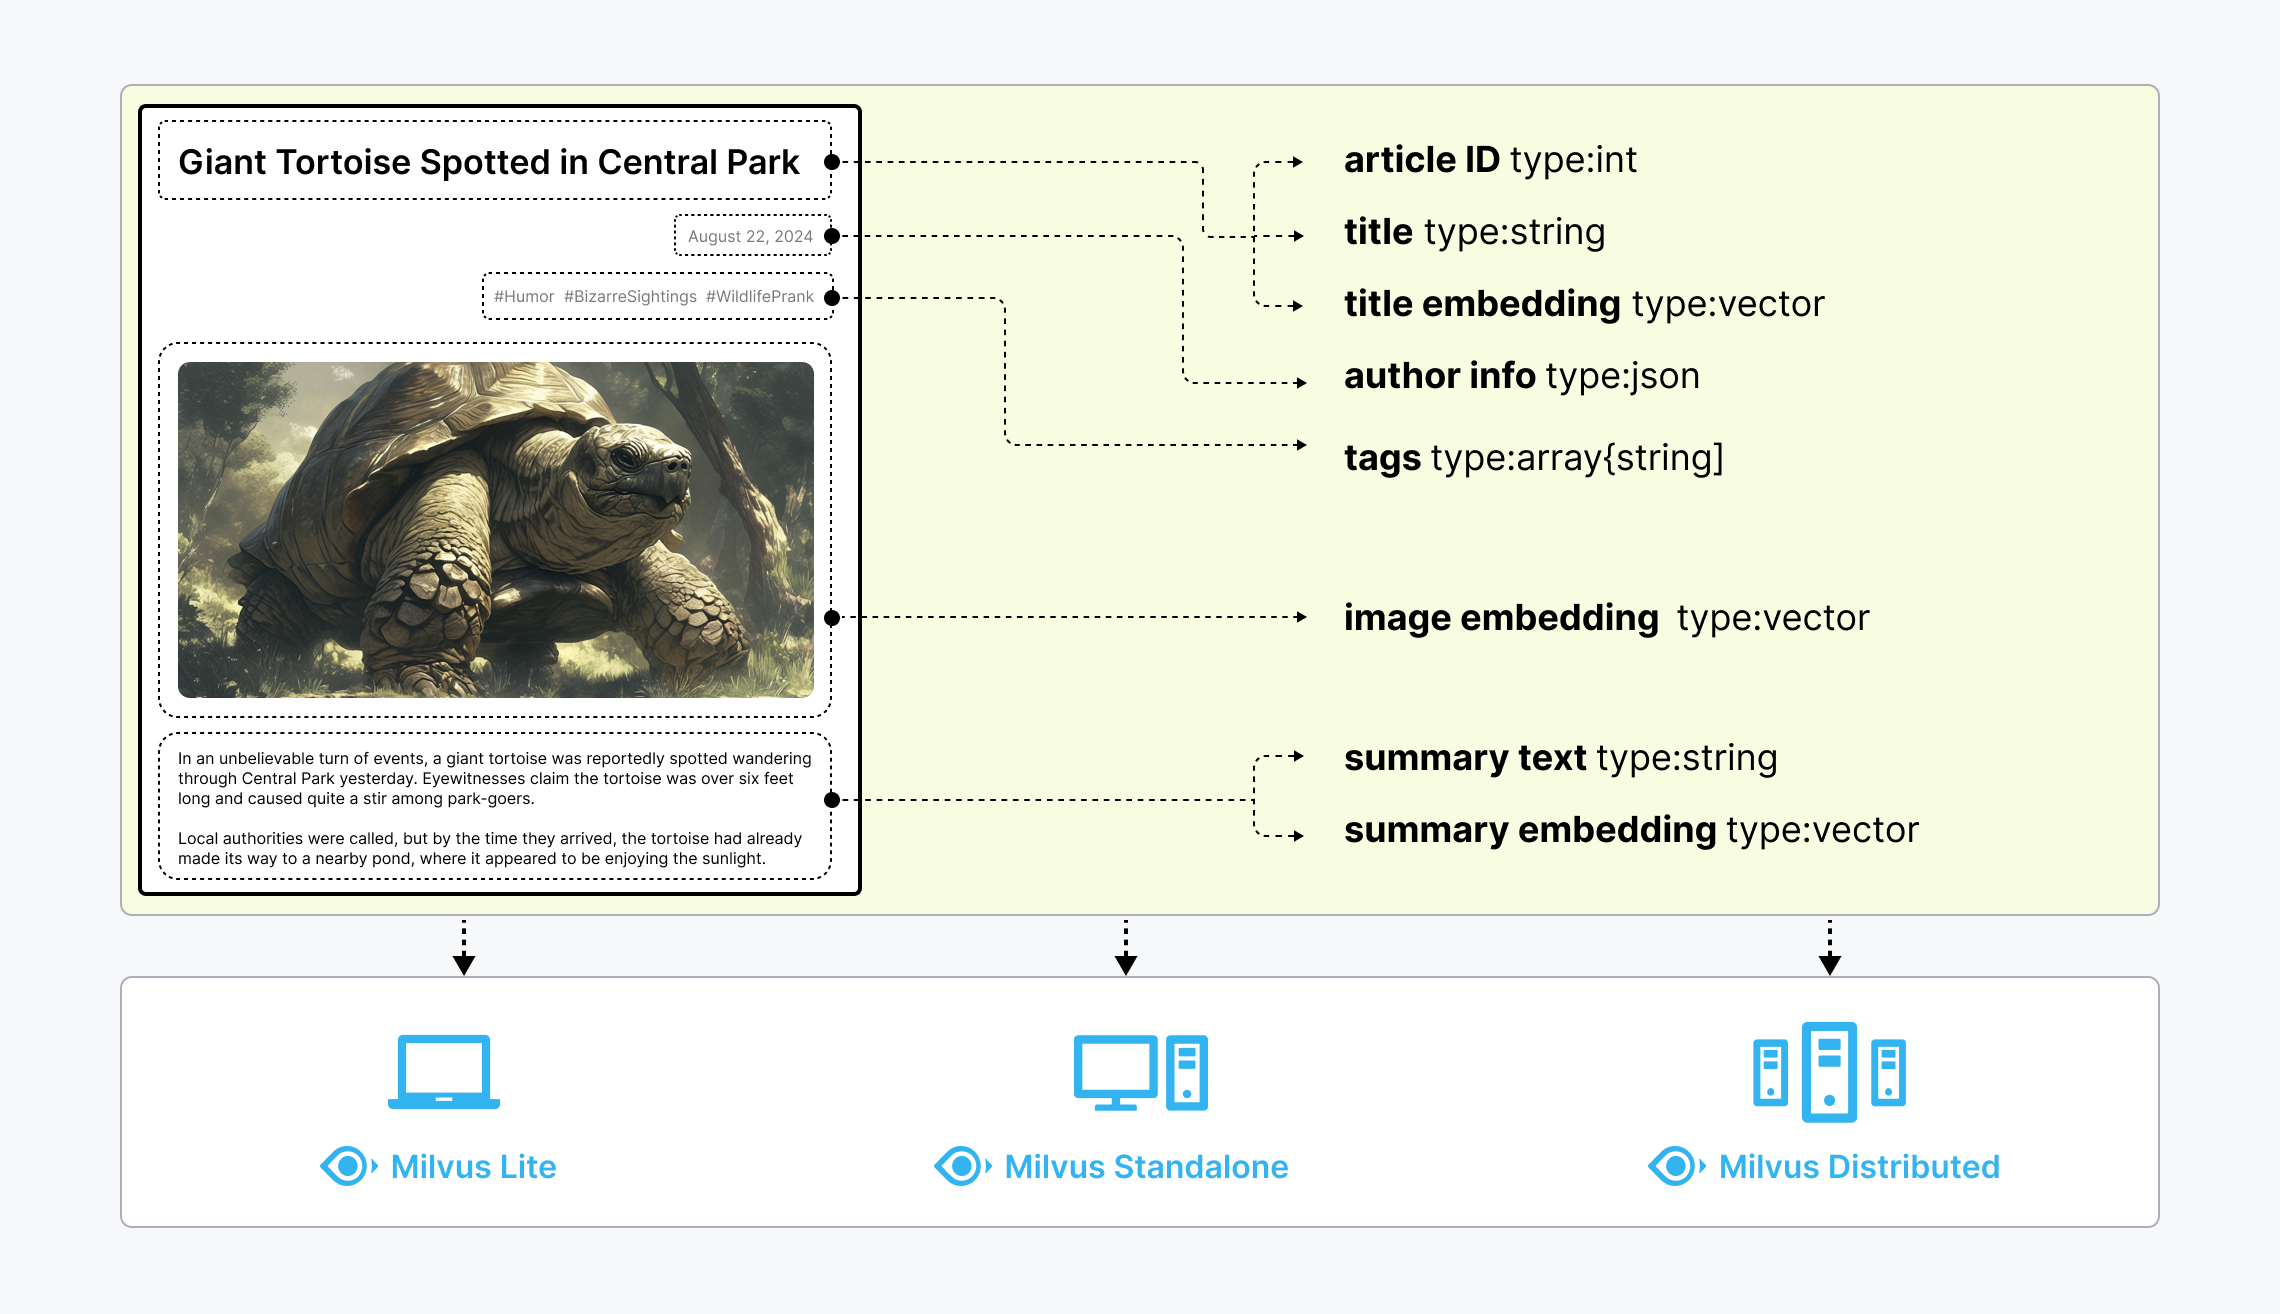 Dati non strutturati, embedding e Milvus
Milvus offre tre modalità di implementazione, che coprono un’ampia gamma di scale di dati: dalla prototipazione locale in Jupyter Notebook a enormi cluster Kubernetes che gestiscono decine di miliardi di vettori:
- Milvus Lite è una libreria Python che può essere facilmente integrata nelle vostre applicazioni. Essendo una versione leggera di Milvus, è ideale per la prototipazione rapida in Jupyter Notebook o per l’esecuzione su dispositivi edge con risorse limitate. Per saperne di più.
- Milvus Standalone è una distribuzione server su singola macchina, con tutti i componenti raggruppati in un’unica immagine Docker per una distribuzione agevole. Scopri di più.
- Milvus Distributed può essere implementato su cluster Kubernetes e presenta un’architettura cloud-native progettata per scenari su scala di miliardi o anche più grandi. Questa architettura garantisce la ridondanza dei componenti critici. Scopri di più.
Cosa rende Milvus così veloce?
Milvus è stato progettato fin dall’inizio per essere un sistema di database vettoriale altamente efficiente. Nella maggior parte dei casi, Milvus supera le prestazioni di altri database vettoriali di 2-5 volte (vedi i risultati di VectorDBBench). Queste elevate prestazioni sono il risultato di diverse decisioni chiave di progettazione:
Ottimizzazione in base all’hardware: per adattare Milvus a vari ambienti hardware, ne abbiamo ottimizzato le prestazioni specificamente per numerose architetture e piattaforme hardware, tra cui AVX512, SIMD, GPU e SSD NVMe.
Algoritmi di ricerca avanzati: Milvus supporta un’ampia gamma di algoritmi di indicizzazione e ricerca sia in memoria che su disco, tra cui IVF, HNSW, DiskANN e altri, tutti profondamente ottimizzati. Rispetto a implementazioni diffuse come FAISS e HNSWLib, Milvus offre prestazioni superiori del 30%-70%.
Motore di ricerca in C++: oltre l’80% delle prestazioni di un database vettoriale è determinato dal suo motore di ricerca. Milvus utilizza il C++ per questo componente critico grazie alle elevate prestazioni del linguaggio, all’ottimizzazione di basso livello e all’efficiente gestione delle risorse. Ma soprattutto, Milvus integra numerose ottimizzazioni del codice sensibili all’hardware, che vanno dalla vettorizzazione a livello di assembly alla parallelizzazione multithread e alla pianificazione, per sfruttare appieno le capacità dell’hardware.
Orientato alle colonne: Milvus è un sistema di database vettoriale orientato alle colonne. I vantaggi principali derivano dai modelli di accesso ai dati. Quando si eseguono query, un database orientato alle colonne legge solo i campi specifici coinvolti nella query, anziché intere righe, il che riduce notevolmente la quantità di dati a cui si accede. Inoltre, le operazioni sui dati basati su colonne possono essere facilmente vettorializzate, consentendo di applicare le operazioni all’intera colonna in una sola volta, migliorando ulteriormente le prestazioni.
Cosa rende Milvus così scalabile
Nel 2022, Milvus supportava vettori su scala di miliardi e, nel 2023, è scalato fino a decine di miliardi con stabilità costante, alimentando scenari su larga scala per oltre 300 grandi aziende, tra cui Salesforce, PayPal, Shopee, Airbnb, eBay, NVIDIA, IBM, AT&T, LINE, ROBLOX, Inflection, ecc.
L’architettura di sistema cloud-native e altamente disaccoppiata di Milvus garantisce che il sistema possa espandersi continuamente man mano che i dati crescono:
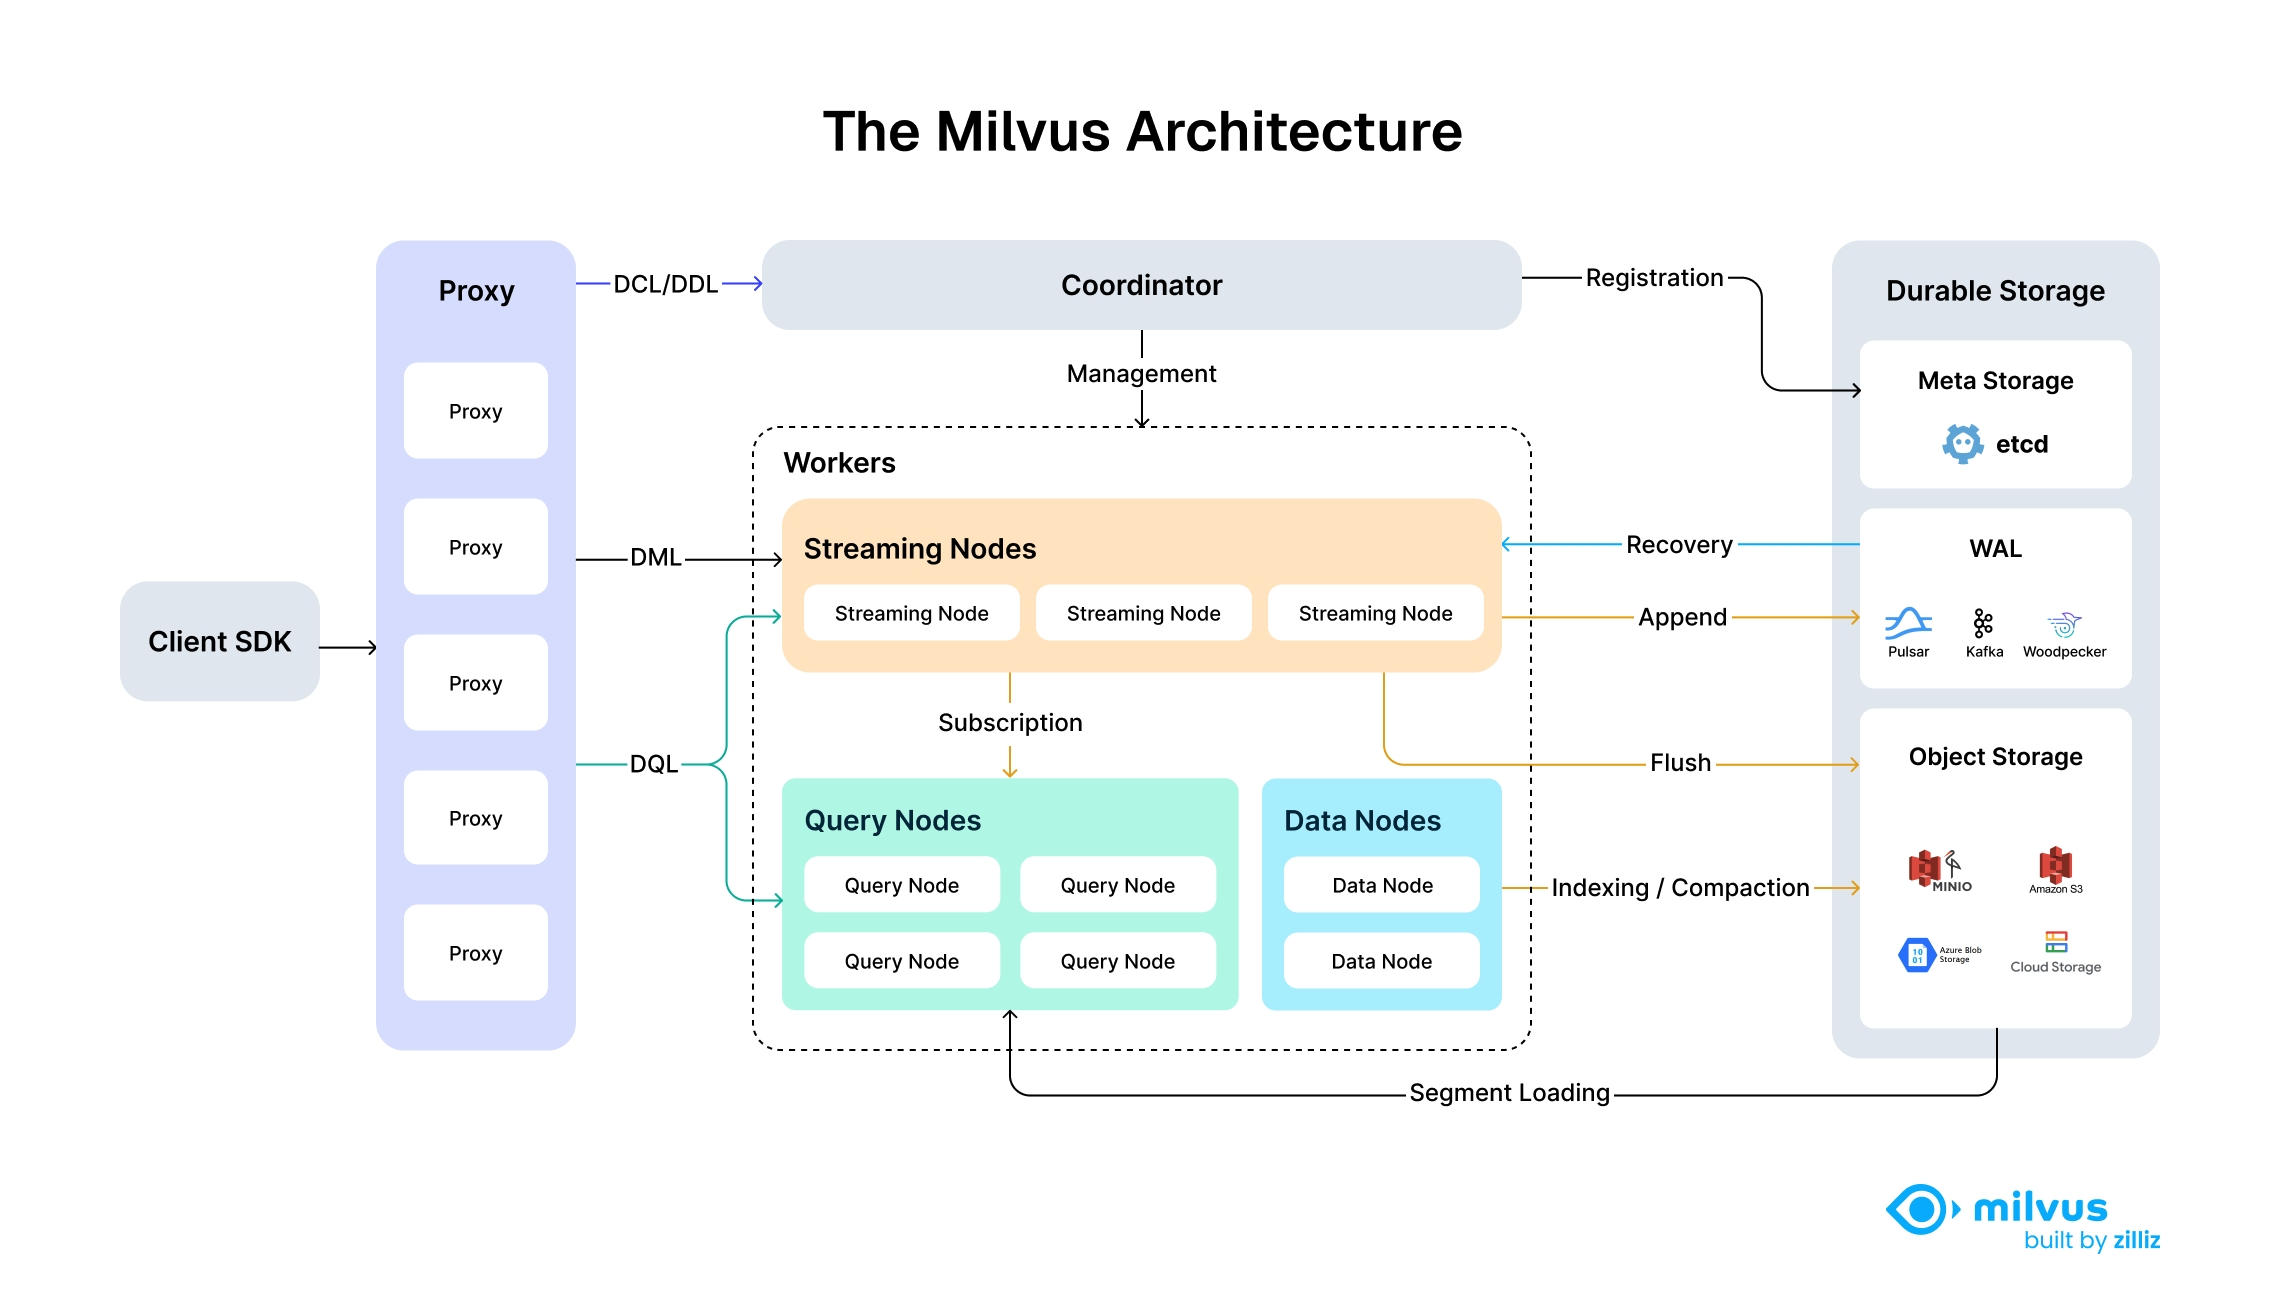 Architettura di sistema altamente disaccoppiata di Milvus
Milvus è di per sé completamente stateless, quindi può essere facilmente scalato con l’aiuto di Kubernetes o dei cloud pubblici. Inoltre, i componenti di Milvus sono ben disaccoppiati: le tre attività più critiche — ricerca, inserimento dei dati e indicizzazione/compattazione — sono progettate come processi facilmente parallelizzabili, con la logica complessa separata. Ciò garantisce che il nodo di query, il nodo dati e il nodo indice corrispondenti possano scalare sia in verticale che in orizzontale in modo indipendente, ottimizzando le prestazioni e l’efficienza in termini di costi.
Tipi di ricerche supportate da Milvus
Milvus supporta vari tipi di funzioni di ricerca per soddisfare le esigenze di diversi casi d’uso:
- Ricerca ANN: individua i primi K vettori più vicini al vettore di query.
- Ricerca con filtro: esegue una ricerca ANN in base a condizioni di filtro specificate.
- Ricerca per intervallo: individua i vettori entro un raggio specificato dal vettore di query.
- Ricerca ibrida: esegue una ricerca ANN basata su più campi vettoriali.
- Ricerca full-text: ricerca full-text basata sull’algoritmo BM25.
- Riorganizzazione dei risultati: regola l’ordine dei risultati di ricerca in base a criteri aggiuntivi o a un algoritmo secondario, perfezionando i risultati iniziali della ricerca ANN.
- Fetch: recupera i dati in base alle loro chiavi primarie.
- Query: recupera i dati utilizzando espressioni specifiche.
Set completo di funzionalità
Oltre alle principali funzionalità di ricerca menzionate sopra, Milvus offre anche una serie di funzionalità implementate attorno alle ricerche ANN, in modo da poter sfruttare appieno le sue capacità.
API e SDK
- API RESTful (ufficiale)
- PyMilvus (SDK Python) (ufficiale)
- SDK Go (ufficiale)
- SDK Java (ufficiale)
- SDK perNode.js (JavaScript) (ufficiale)
- C# (fornito da Microsoft)
- SDK C++ (ufficiale)
- SDK Rust (in fase di sviluppo)
Tipi di dati avanzati
Oltre ai tipi di dati primitivi, Milvus supporta vari tipi di dati avanzati e le rispettive metriche di distanza applicabili.
- Vettori sparsi
- Vettori binari
- Supporto JSON
- Supporto per gli array
- Geolocalizzazione
- Testo (in fase di sviluppo)
Perché Milvus?
Prestazioni elevate su larga scala e alta disponibilità
Milvus presenta un'architettura distribuita che separa l'elaborazione dall'archiviazione. Milvus è in grado di scalare orizzontalmente e adattarsi a diversi modelli di traffico, raggiungendo prestazioni ottimali aumentando in modo indipendente i nodi di query per i carichi di lavoro con un'elevata attività di lettura e i nodi di dati per i carichi di lavoro con un'elevata attività di scrittura. I microservizi stateless su K8s consentono un rapido ripristino in caso di guasto, garantendo un'elevata disponibilità. Il supporto delle repliche migliora ulteriormente la tolleranza ai guasti e il throughput caricando segmenti di dati su più nodi di query. Consulta il benchmark per un confronto delle prestazioni.
Supporto per vari tipi di indici vettoriali e accelerazione hardware
Milvus separa il sistema dal motore di ricerca vettoriale principale, consentendogli di supportare tutti i principali tipi di indici vettoriali ottimizzati per diversi scenari, tra cui HNSW, IVF, FLAT (brute-force), SCANN e DiskANN, con varianti basate sulla quantizzazione e mmap. Milvus ottimizza la ricerca vettoriale per funzionalità avanzate quali il filtraggio dei metadati e la ricerca per intervallo. Inoltre, Milvus implementa l’accelerazione hardware per migliorare le prestazioni della ricerca vettoriale e supporta l’indicizzazione tramite GPU, come CAGRA di NVIDIA.
Multi-tenancy flessibile e archiviazione "hot/cold"
Milvus supporta il multi-tenancy tramite isolamento a livello di database, collezione, partizione o chiave di partizione. Le strategie flessibili consentono a un singolo cluster di gestire da centinaia a milioni di tenant, garantendo al contempo prestazioni di ricerca ottimizzate e un controllo degli accessi flessibile. Milvus migliora l’efficacia in termini di costi grazie all’archiviazione hot/cold. I dati hot, a cui si accede frequentemente, possono essere memorizzati in memoria o su SSD per ottenere prestazioni migliori, mentre i dati cold, a cui si accede meno spesso, vengono conservati su supporti di archiviazione più lenti ed economici. Questo meccanismo può ridurre significativamente i costi, mantenendo al contempo prestazioni elevate per le attività critiche.
Vettori sparsi per la ricerca full-text e la ricerca ibrida
Oltre alla ricerca semantica tramite vettori densi, Milvus supporta nativamente anche la ricerca full-text con BM25, nonché l’embedding sparsa appreso come SPLADE e BGE-M3. Gli utenti possono memorizzare vettori sparsi e vettori densi nella stessa collezione e definire funzioni per riorganizzare i risultati provenienti da più richieste di ricerca. Vedi esempi di ricerca ibrida con ricerca semantica + ricerca full-text.
Sicurezza dei dati e controllo degli accessi granulare
Milvus garantisce la sicurezza dei dati implementando l’autenticazione obbligatoria degli utenti, la crittografia TLS e il controllo degli accessi basato sui ruoli (RBAC). L’autenticazione degli utenti assicura che solo gli utenti autorizzati con credenziali valide possano accedere al database, mentre la crittografia TLS protegge tutte le comunicazioni all’interno della rete. Inoltre, l’RBAC consente un controllo degli accessi granulare, assegnando permessi specifici agli utenti in base ai loro ruoli. Queste caratteristiche rendono Milvus una scelta solida e sicura per le applicazioni aziendali, proteggendo i dati sensibili da accessi non autorizzati e potenziali violazioni.
Integrazioni con l’IA
Integrazioni dei modelli di embedding I modelli di embedding convertono i dati non strutturati nella loro rappresentazione numerica in uno spazio di dati ad alta dimensionalità, in modo da poterli archiviare in Milvus. Attualmente, PyMilvus, l’SDK per Python, integra diversi modelli di embedding che consentono di preparare rapidamente i dati sotto forma di vettori di embedding. Per ulteriori dettagli, consultare la Panoramica sull’embedding.
Integrazioni dei modelli di reranking Nel campo del recupero delle informazioni e dell’IA generativa, un reranker è uno strumento essenziale che ottimizza l’ordine dei risultati delle ricerche iniziali. PyMilvus integra anche diversi modelli di reranking per ottimizzare l’ordine dei risultati restituiti dalle ricerche iniziali. Per ulteriori dettagli, consultare la Panoramica sui reranker.
Integrazioni con LangChain e altri strumenti di IA Nell’era della GenAI, strumenti come LangChain stanno attirando molta attenzione da parte degli sviluppatori di applicazioni. In quanto componente fondamentale, Milvus funge solitamente da archivio vettoriale in tali strumenti. Per scoprire come integrare Milvus nei tuoi strumenti di IA preferiti, consulta la nostra sezione Integrazioni e tutorial.
Strumenti ed ecosistema
Attu Attu è un’interfaccia grafica intuitiva e completa che ti aiuta a gestire Milvus e i dati in esso memorizzati. Per ulteriori dettagli, consulta il repository di Attu.
Birdwatcher Birdwatcher è uno strumento di debug per Milvus. Utilizzandolo per connettersi a etcd, è possibile verificare lo stato del proprio sistema Milvus o configurarlo al volo. Per ulteriori dettagli, consulta BirdWatcher.
Integrazioni con Prometheus e Grafana Prometheus è un toolkit open source per il monitoraggio e gli avvisi di sistema per Kubernetes. Grafana è uno stack di visualizzazione open source in grado di connettersi a tutte le fonti di dati. È possibile utilizzare Prometheus e Grafana come fornitori di servizi di monitoraggio per monitorare visivamente le prestazioni di Milvus distribuito. Per ulteriori dettagli, consultare la sezione "Distribuzione dei servizi di monitoraggio".
Milvus Backup Milvus Backup è uno strumento che consente agli utenti di eseguire il backup e il ripristino dei dati di Milvus. Fornisce sia un’interfaccia a riga di comando (CLI) che un’API per adattarsi a diversi scenari applicativi. Per ulteriori dettagli, consultare Milvus Backup.
Milvus Capture Data Change (CDC) Milvus CDC è in grado di replicare le modifiche ai dati da un cluster Milvus a un altro per il disaster recovery in configurazione primario-standby. Per ulteriori dettagli, consultare la sezione " Milvus CDC".
Connettori Milvus Milvus ha previsto una serie di connettori per consentire l’integrazione senza soluzione di continuità di Milvus con strumenti di terze parti, come Apache Spark. Attualmente, è possibile utilizzare il nostro connettore Spark per inviare i dati di Milvus ad Apache Spark per l’elaborazione tramite machine learning. Per ulteriori dettagli, consultare Connettore Spark-Milvus.
Servizi di trasmissione vettoriale (VTS) Milvus fornisce una serie di strumenti che consentono di trasferire i dati tra un’istanza Milvus e una serie di fonti di dati, tra cui cluster Zilliz, Elasticsearch, Postgres (PgVector) e un’altra istanza Milvus. Per ulteriori dettagli, consultare VTS.
