

¿Qué es el Milvus?
Milvus es un ave rapaz del género Milvus, perteneciente a la familia de los halcones Accipitridae, famosa por su velocidad en vuelo, su aguda visión y su notable capacidad de adaptación.
Zilliz adopta el nombre de Milvus para su base de datos vectorial de código abierto, de alto rendimiento y altamente escalable, que funciona de manera eficiente en una amplia gama de entornos, desde un ordenador portátil hasta sistemas distribuidos a gran escala. Está disponible tanto como software de código abierto como servicio en la nube.
Desarrollada por Zilliz y que pronto será cedida a la LF AI & Data Foundation, dependiente de la Linux Foundation, Milvus se ha convertido en uno de los proyectos de bases de datos vectoriales de código abierto más importantes del mundo. Se distribuye bajo la licencia Apache 2.0, y la mayoría de los colaboradores son expertos de la comunidad de computación de alto rendimiento (HPC), especializados en la creación de sistemas a gran escala y en la optimización de código adaptado al hardware. Entre los colaboradores principales se encuentran profesionales de Zilliz, ARM, NVIDIA, AMD, Intel, Meta, IBM, Salesforce, Alibaba y Microsoft.
Curiosamente, todos los proyectos de código abierto de Zilliz llevan el nombre de un pájaro, una convención de nomenclatura que simboliza la libertad, la visión de futuro y la evolución ágil de la tecnología.
Datos no estructurados, representaciones vectoriales y Milvus
Los datos no estructurados, como el texto, las imágenes y el audio, varían en formato y contienen una rica semántica subyacente, lo que dificulta su análisis. Para gestionar esta complejidad, se utilizan representaciones para convertir los datos no estructurados en vectores numéricos que capturan sus características esenciales. A continuación, estos vectores se almacenan en una base de datos vectorial, lo que permite realizar búsquedas y análisis rápidos y escalables.
Milvus ofrece sólidas capacidades de modelado de datos, lo que te permite organizar tus datos no estructurados o multimodales en colecciones estructuradas. Admite una amplia gama de tipos de datos para el modelado de diferentes atributos, incluidos los tipos numéricos y de caracteres habituales, diversos tipos de vectores, matrices, conjuntos y JSON, lo que te ahorra el esfuerzo de mantener múltiples sistemas de bases de datos.
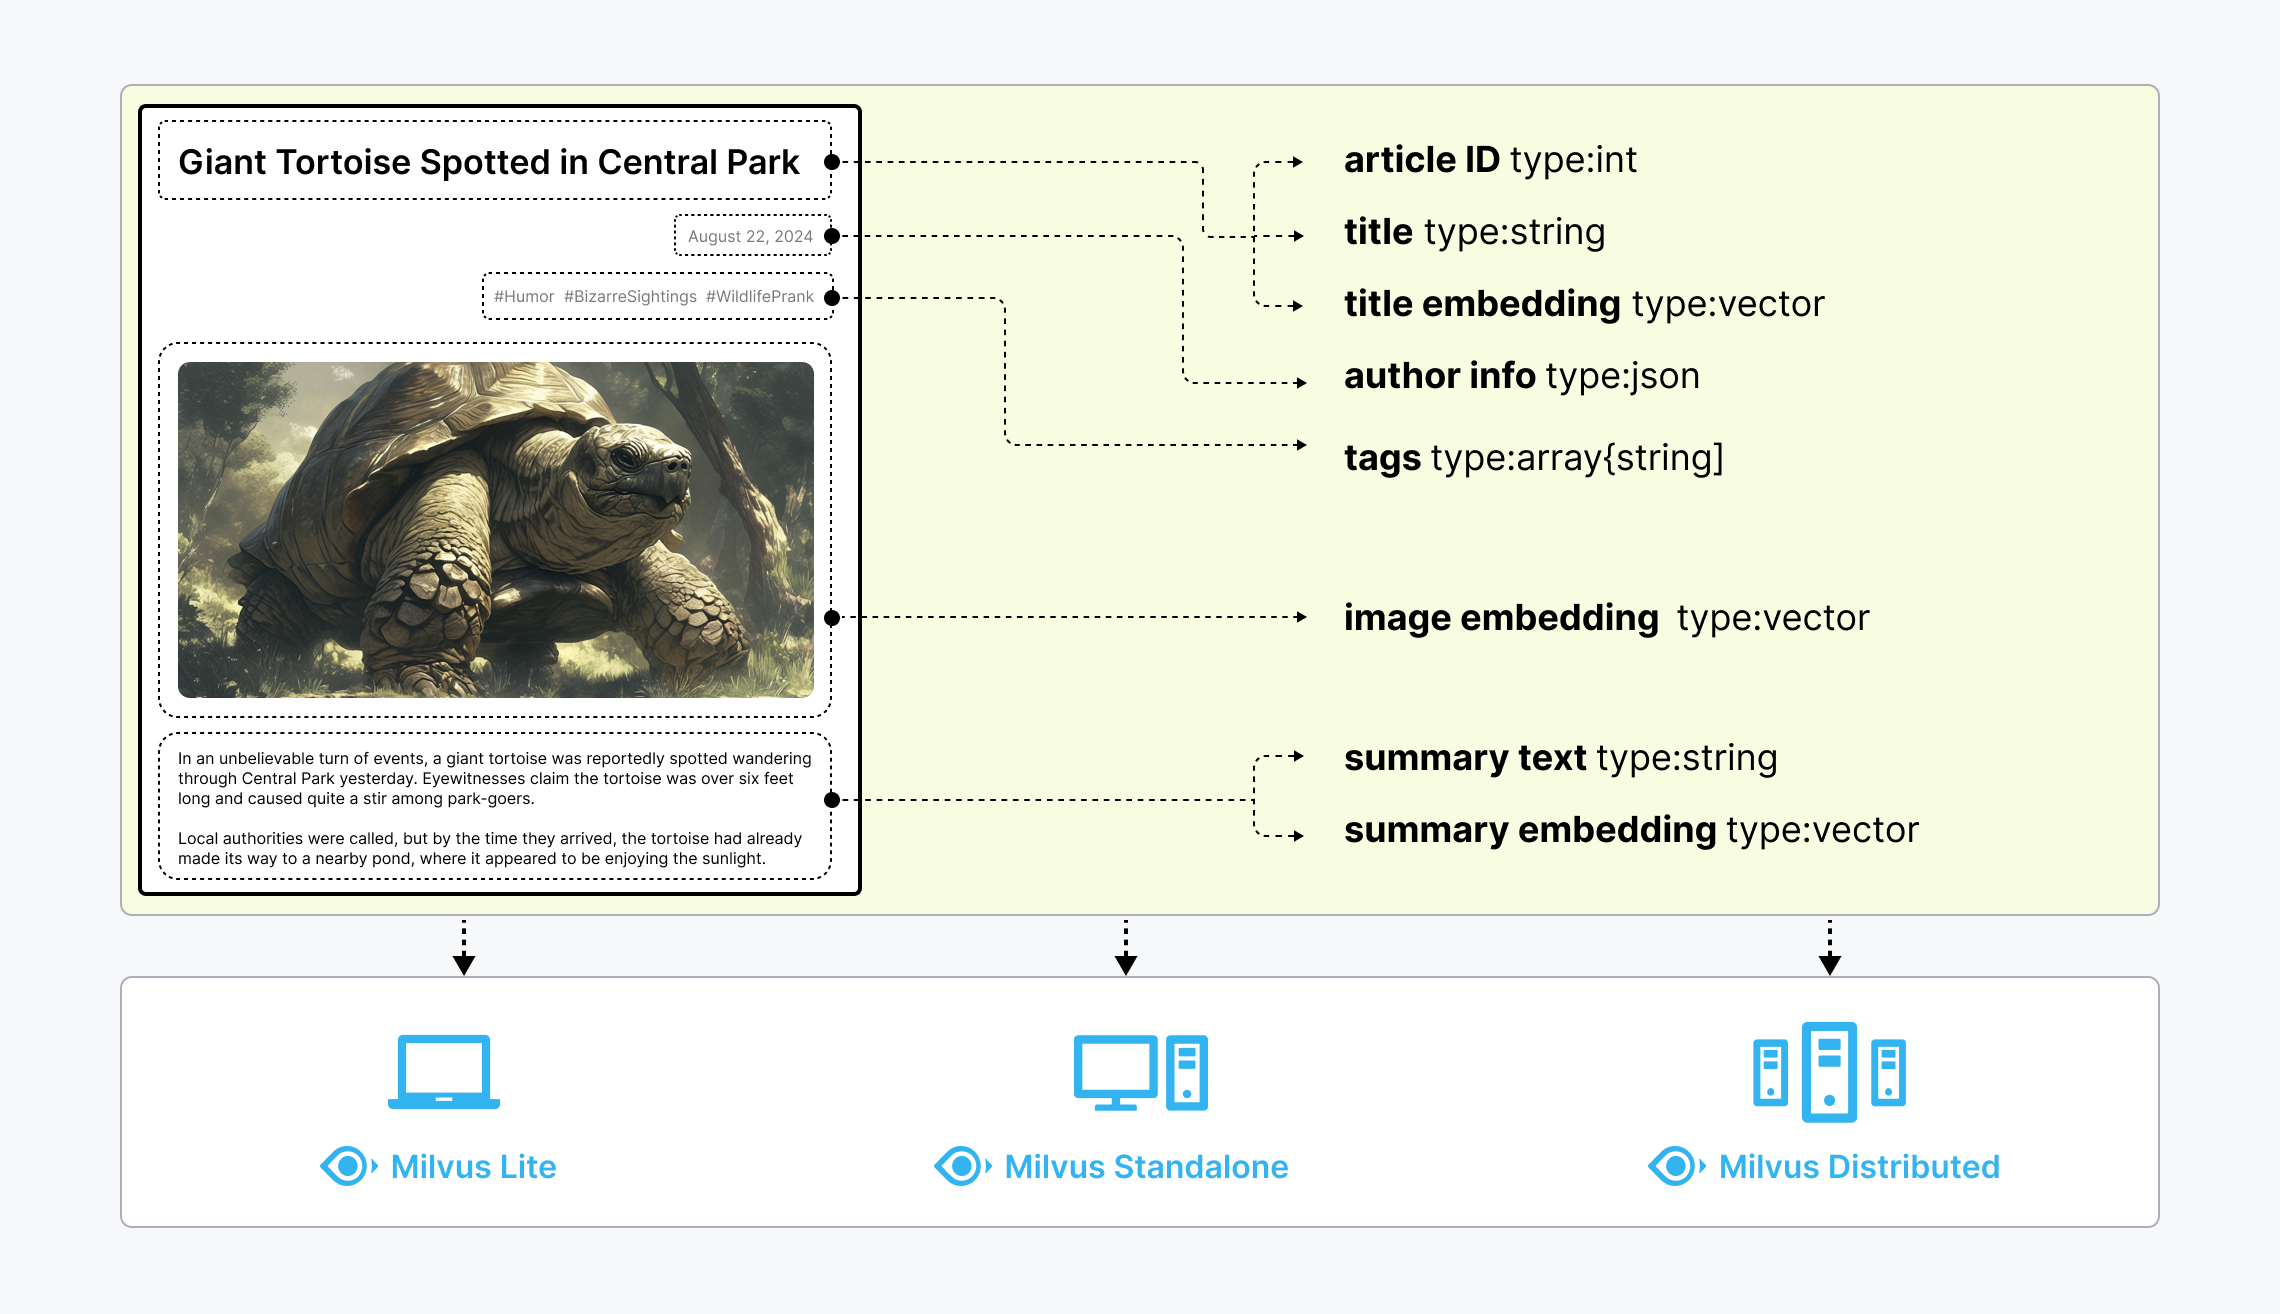 Datos no estructurados, representaciones vectoriales y Milvus
Milvus ofrece tres modos de implementación que abarcan una amplia gama de escalas de datos, desde la creación de prototipos locales en Jupyter Notebooks hasta clústeres masivos de Kubernetes que gestionan decenas de miles de millones de vectores:
- Milvus Lite es una biblioteca de Python que se puede integrar fácilmente en tus aplicaciones. Al ser una versión ligera de Milvus, resulta ideal para la creación rápida de prototipos en Jupyter Notebooks o para ejecutarse en dispositivos periféricos con recursos limitados. Más información.
- Milvus Standalone es una implementación de servidor en una sola máquina, con todos los componentes agrupados en una única imagen de Docker para facilitar la implementación. Más información.
- Milvus Distributed se puede implementar en clústeres de Kubernetes y cuenta con una arquitectura nativa de la nube diseñada para escenarios a escala de miles de millones o incluso mayores. Esta arquitectura garantiza la redundancia en los componentes críticos. Más información.
¿Qué hace que Milvus sea tan rápido?
Milvus se diseñó desde el primer momento para ser un sistema de base de datos vectorial altamente eficiente. En la mayoría de los casos, Milvus supera en rendimiento a otras bases de datos vectoriales entre 2 y 5 veces (véanse los resultados de VectorDBBench). Este alto rendimiento es el resultado de varias decisiones de diseño clave:
Optimización adaptada al hardware: Para que Milvus se adapte a diversos entornos de hardware, hemos optimizado su rendimiento específicamente para numerosas arquitecturas y plataformas de hardware, entre las que se incluyen AVX512, SIMD, GPU y SSD NVMe.
Algoritmos de búsqueda avanzados: Milvus admite una amplia gama de algoritmos de indexación y búsqueda tanto en memoria como en disco, entre los que se incluyen IVF, HNSW, DiskANN y otros, todos ellos profundamente optimizados. En comparación con implementaciones populares como FAISS y HNSWLib, Milvus ofrece un rendimiento entre un 30 % y un 70 % superior.
Motor de búsqueda en C++: Más del 80 % del rendimiento de una base de datos vectorial viene determinado por su motor de búsqueda. Milvus utiliza C++ para este componente crítico debido al alto rendimiento del lenguaje, su optimización de bajo nivel y su eficiente gestión de recursos. Y lo que es más importante, Milvus integra numerosas optimizaciones de código adaptadas al hardware, que van desde la vectorización a nivel de ensamblador hasta la paralelización y la programación multihilo, para aprovechar al máximo las capacidades del hardware.
Orientada a columnas: Milvus es un sistema de base de datos vectorial orientado a columnas. Las principales ventajas provienen de los patrones de acceso a los datos. Al realizar consultas, una base de datos orientada a columnas lee únicamente los campos específicos implicados en la consulta, en lugar de filas completas, lo que reduce considerablemente la cantidad de datos a los que se accede. Además, las operaciones sobre datos basados en columnas pueden vectorizarse fácilmente, lo que permite aplicar las operaciones a columnas enteras de una sola vez, mejorando aún más el rendimiento.
¿Qué hace que Milvus sea tan escalable?
En 2022, Milvus admitía vectores a escala de miles de millones y, en 2023, se amplió a decenas de miles de millones con una estabilidad constante, impulsando escenarios a gran escala para más de 300 grandes empresas, entre las que se incluyen Salesforce, PayPal, Shopee, Airbnb, eBay, NVIDIA, IBM, AT&T, LINE, ROBLOX, Inflection, etc.
La arquitectura de sistema nativa de la nube y altamente desacoplada de Milvus garantiza que el sistema pueda expandirse continuamente a medida que crecen los datos:
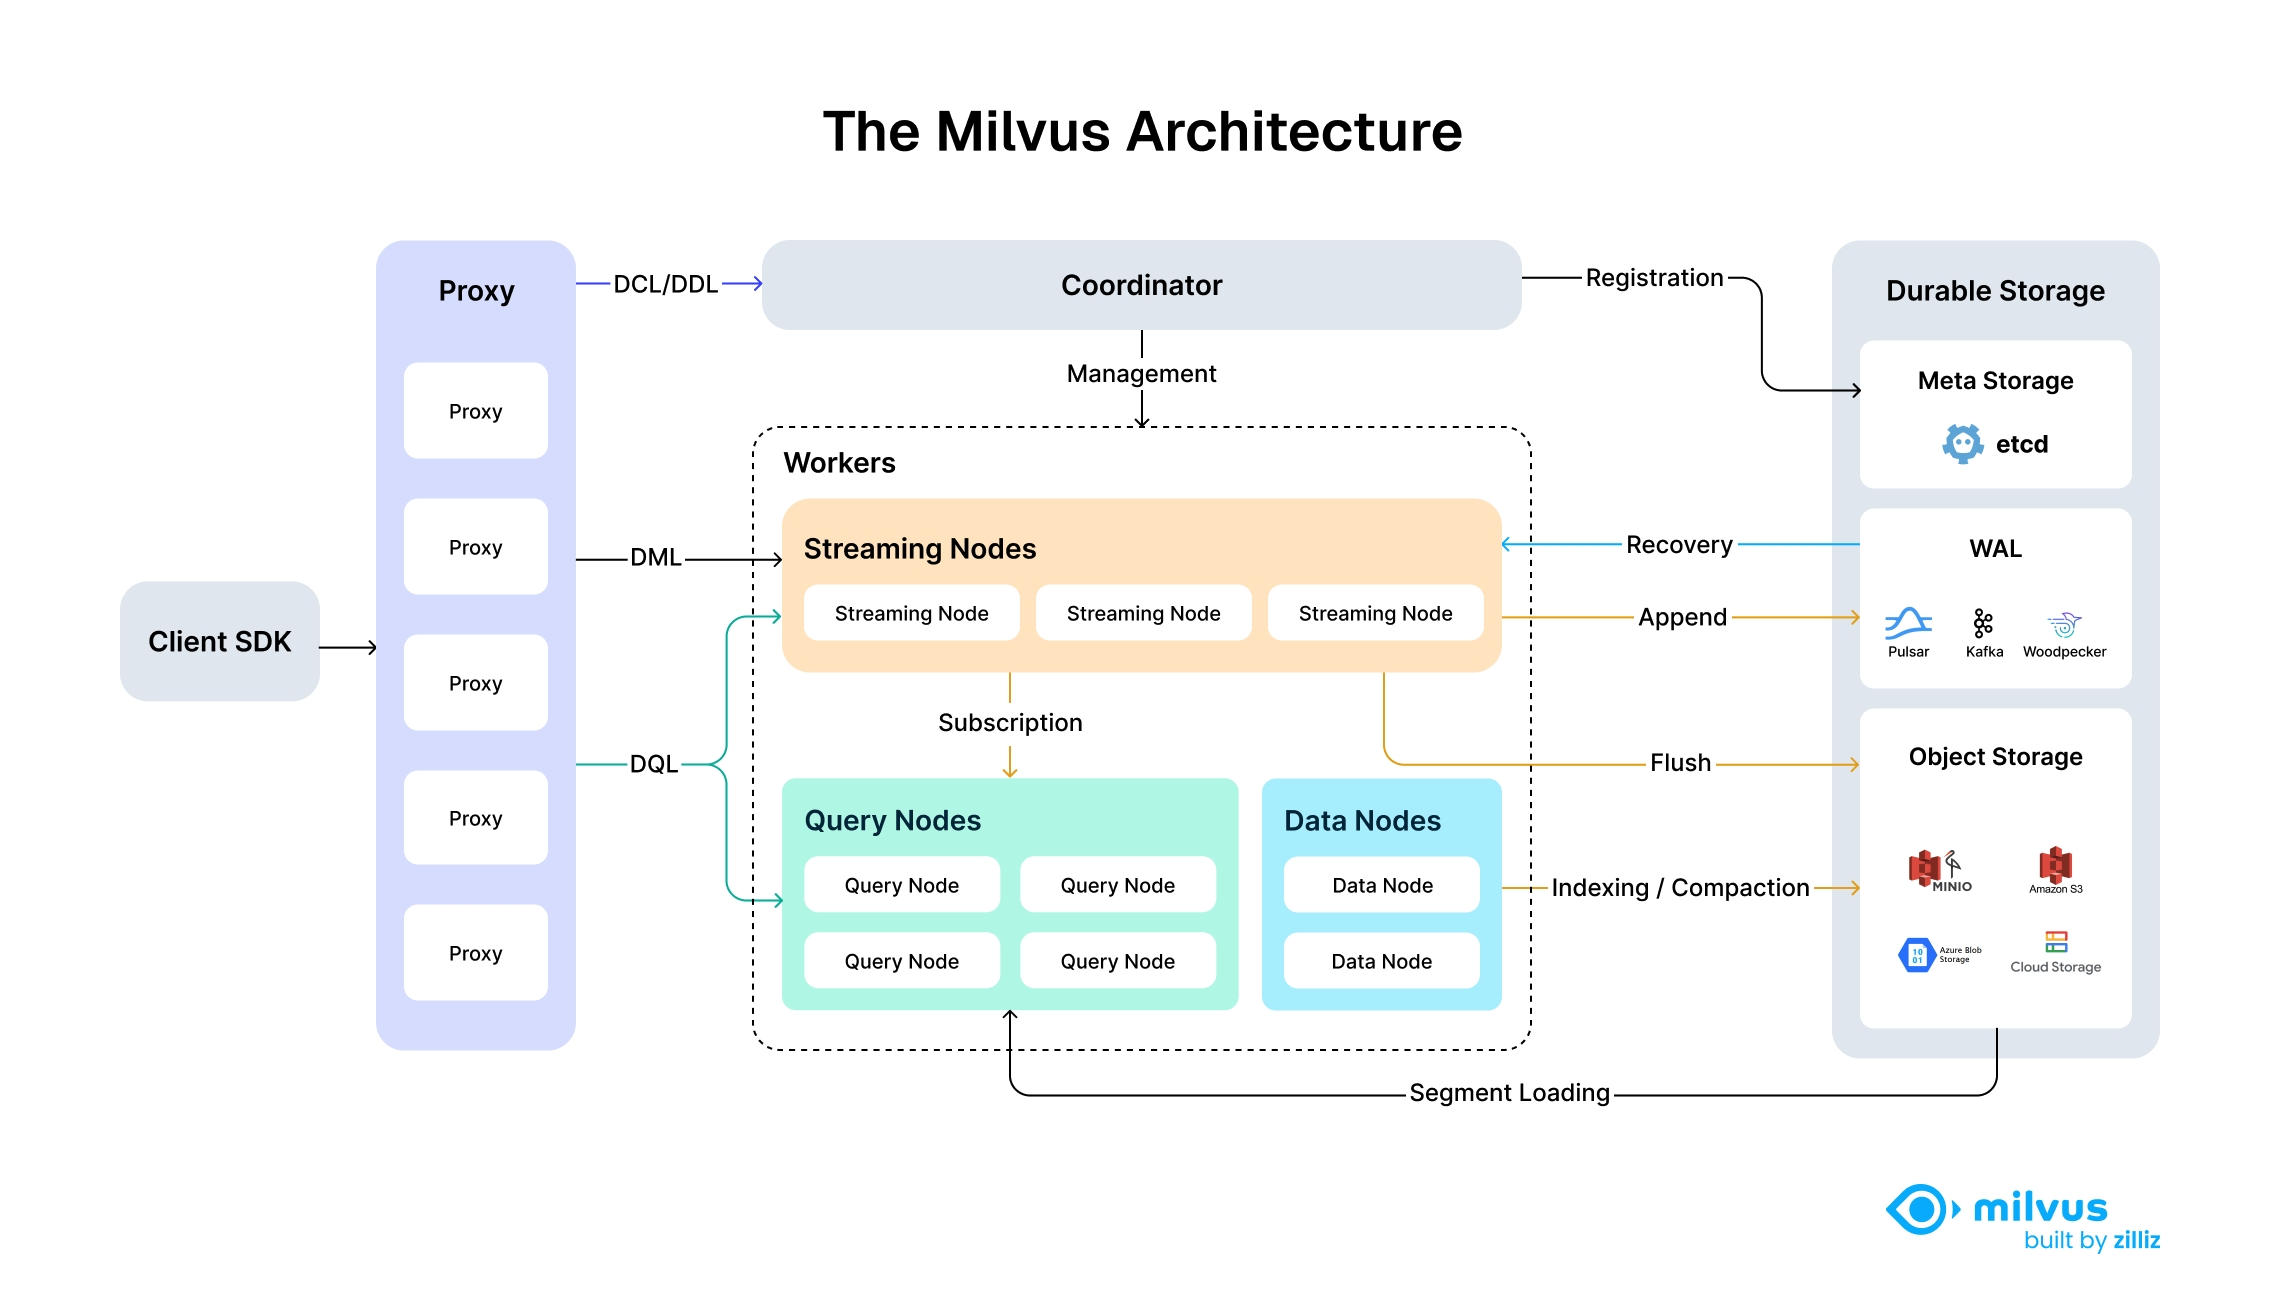 Arquitectura de sistema altamente desacoplada de Milvus
Milvus es, en sí mismo, totalmente «stateless», por lo que puede escalarse fácilmente con la ayuda de Kubernetes o de nubes públicas. Además, los componentes de Milvus están bien desacoplados, y las tres tareas más críticas —búsqueda, inserción de datos e indexación/compactación— están diseñadas como procesos fácilmente paralelizables, con la lógica compleja separada. Esto garantiza que los correspondientes nodos de consulta, de datos y de índice puedan escalar tanto vertical como horizontalmente de forma independiente, optimizando el rendimiento y la rentabilidad.
Tipos de búsquedas compatibles con Milvus
Milvus admite diversos tipos de funciones de búsqueda para satisfacer las necesidades de diferentes casos de uso:
- Búsqueda ANN: encuentra los K vectores más cercanos a tu vector de consulta.
- Búsqueda con filtrado: realiza una búsqueda ANN bajo condiciones de filtrado especificadas.
- Búsqueda por rango: encuentra vectores dentro de un radio especificado respecto al vector de consulta.
- Búsqueda híbrida: realiza una búsqueda ANN basada en múltiples campos vectoriales.
- Búsqueda de texto completo: búsqueda de texto completo basada en BM25.
- Reordenación: Ajusta el orden de los resultados de la búsqueda basándose en criterios adicionales o en un algoritmo secundario, refinando los resultados iniciales de la búsqueda ANN.
- Recuperación: Recupera datos mediante sus claves primarias.
- Consulta: recupera datos mediante expresiones específicas.
Conjunto completo de funciones
Además de las funciones de búsqueda clave mencionadas anteriormente, Milvus también ofrece un conjunto de funciones implementadas en torno a las búsquedas de la red neuronal artificial (ANN) para que puedas aprovechar al máximo sus capacidades.
API y SDK
- API RESTful (oficial)
- PyMilvus (SDK de Python) (oficial)
- SDK de Go (oficial)
- SDK de Java (oficial)
- SDK paraNode.js (JavaScript) (oficial)
- C# (aportado por Microsoft)
- SDK de C++ (oficial)
- SDK de Rust (en desarrollo)
Tipos de datos avanzados
Además de los tipos de datos primitivos, Milvus admite diversos tipos de datos avanzados y sus respectivas métricas de distancia aplicables.
- Vectores dispersos
- Vectores binarios
- Compatibilidad con JSON
- Compatibilidad con matrices
- Geolocalización
- Texto (en desarrollo)
¿Por qué Milvus?
Alto rendimiento a gran escala y alta disponibilidad
Milvus cuenta con una arquitectura distribuida que separa la computación del almacenamiento. Milvus puede escalar horizontalmente y adaptarse a diversos patrones de tráfico, logrando un rendimiento óptimo al aumentar de forma independiente los nodos de consulta para cargas de trabajo con gran volumen de lecturas y los nodos de datos para cargas de trabajo con gran volumen de escrituras. Los microservicios sin estado en K8s permiten una rápida recuperación ante fallos, lo que garantiza una alta disponibilidad. La compatibilidad con réplicas mejora aún más la tolerancia a fallos y el rendimiento al cargar segmentos de datos en múltiples nodos de consulta. Consulta la prueba de rendimiento para comparar el rendimiento.
Compatibilidad con diversos tipos de índices vectoriales y aceleración por hardware
Milvus separa el sistema del motor de búsqueda vectorial principal, lo que le permite admitir todos los principales tipos de índices vectoriales optimizados para diferentes escenarios, incluidos HNSW, IVF, FLAT (fuerza bruta), SCANN y DiskANN, con variaciones basadas en la cuantificación y mmap. Milvus optimiza la búsqueda vectorial para funciones avanzadas como el filtrado de metadatos y la búsqueda por rango. Además, Milvus implementa aceleración por hardware para mejorar el rendimiento de la búsqueda vectorial y admite la indexación por GPU, como CAGRA de NVIDIA.
Multitenencia flexible y almacenamiento «caliente»/«frío»
Milvus admite la multitenencia mediante el aislamiento a nivel de base de datos, colección, partición o clave de partición. Estas estrategias flexibles permiten que un único clúster gestione desde cientos hasta millones de usuarios, al tiempo que garantizan un rendimiento de búsqueda optimizado y un control de acceso flexible. Milvus mejora la rentabilidad gracias al almacenamiento «caliente» y «frío». Los datos «calientes», a los que se accede con frecuencia, pueden almacenarse en memoria o en SSD para obtener un mejor rendimiento, mientras que los datos «fríos», a los que se accede con menos frecuencia, se guardan en un almacenamiento más lento y económico. Este mecanismo puede reducir significativamente los costes al tiempo que mantiene un alto rendimiento para las tareas críticas.
Vector disperso para la búsqueda de texto completo y la búsqueda híbrida
Además de la búsqueda semántica mediante vectores densos, Milvus también admite de forma nativa la búsqueda de texto completo con BM25, así como incrustaciones dispersas aprendidas, como SPLADE y BGE-M3. Los usuarios pueden almacenar vectores dispersos y vectores densos en la misma colección, y definir funciones para reordenar los resultados de múltiples solicitudes de búsqueda. Véanse ejemplos de búsqueda híbrida con búsqueda semántica + búsqueda de texto completo.
Seguridad de los datos y control de acceso detallado
Milvus garantiza la seguridad de los datos mediante la implementación de la autenticación obligatoria de usuarios, el cifrado TLS y el control de acceso basado en roles (RBAC). La autenticación de usuarios garantiza que solo los usuarios autorizados con credenciales válidas puedan acceder a la base de datos, mientras que el cifrado TLS protege todas las comunicaciones dentro de la red. Además, el RBAC permite un control de acceso detallado mediante la asignación de permisos específicos a los usuarios en función de sus roles. Estas características convierten a Milvus en una opción sólida y segura para aplicaciones empresariales, ya que protege los datos confidenciales frente al acceso no autorizado y posibles brechas de seguridad.
Integraciones de IA
Integraciones de modelos de incrustación Los modelos de incrustación convierten los datos no estructurados en su representación numérica en un espacio de datos de alta dimensión, de modo que puedas almacenarlos en Milvus. Actualmente, PyMilvus, el SDK de Python, integra varios modelos de incrustación para que puedas preparar rápidamente tus datos en incrustaciones vectoriales. Para más detalles, consulta la Descripción general de la incrustación.
Integraciones de modelos de reordenación En el ámbito de la recuperación de información y la IA generativa, un reordenador es una herramienta esencial que optimiza el orden de los resultados de las búsquedas iniciales. PyMilvus también integra varios modelos de reordenación para optimizar el orden de los resultados devueltos tras las búsquedas iniciales. Para más detalles, consulte la Descripción general de los reordenadores.
Integraciones con LangChain y otras herramientas de IA En la era de la IA generativa, herramientas como LangChain están despertando un gran interés entre los desarrolladores de aplicaciones. Como componente central, Milvus suele actuar como almacén de vectores en este tipo de herramientas. Para saber cómo integrar Milvus en tus herramientas de IA favoritas, consulta nuestras Integraciones y tutoriales.
Herramientas y ecosistema
Attu Attu es una interfaz gráfica de usuario (GUI) intuitiva y «todo en uno» que le ayuda a gestionar Milvus y los datos que almacena. Para obtener más información, consulte el repositorio de Attu.
Birdwatcher Birdwatcher es una herramienta de depuración para Milvus. Al utilizarla para conectarte a etcd, puedes comprobar el estado de tu sistema Milvus o configurarlo sobre la marcha. Para más detalles, consulta BirdWatcher.
Integraciones con Prometheus y Grafana Prometheus es un conjunto de herramientas de código abierto para la monitorización y las alertas de sistemas en Kubernetes. Grafana es una plataforma de visualización de código abierto que puede conectarse con todas las fuentes de datos. Puedes utilizar Prometheus y Grafana como proveedores de servicios de monitorización para supervisar visualmente el rendimiento de Milvus distribuido. Para más detalles, consulta «Implementación de servicios de monitorización».
Milvus Backup Milvus Backup es una herramienta que permite a los usuarios realizar copias de seguridad y restaurar datos de Milvus. Proporciona tanto una interfaz de línea de comandos (CLI) como una API para adaptarse a diferentes escenarios de aplicación. Para obtener más información, consulta «Milvus Backup».
Milvus Capture Data Change (CDC) Milvus CDC puede replicar los cambios en los datos de un clúster de Milvus a otro para la recuperación ante desastres en modo primario-secundario. Para más detalles, consulta «Milvus CDC».
Conectores de Milvus Milvus ha desarrollado un conjunto de conectores para que puedas integrar Milvus a la perfección con herramientas de terceros, como Apache Spark. Actualmente, puedes utilizar nuestro conector Spark para enviar tus datos de Milvus a Apache Spark con el fin de procesarlos mediante aprendizaje automático. Para obtener más información, consulta «Conector Spark-Milvus».
Servicios de transmisión vectorial (VTS) Milvus ofrece un conjunto de herramientas para que puedas transferir tus datos entre una instancia de Milvus y diversas fuentes de datos, entre las que se incluyen clústeres de Zilliz, Elasticsearch, Postgres (PgVector) y otra instancia de Milvus. Para obtener más información, consulta VTS.
