

什麼是 Milvus?
Milvus 是一種隸屬於隼科(Accipitridae)Milvus 屬的猛禽,以其飛行的速度、敏銳的視力以及非凡的適應能力而聞名。
Zilliz 將其開源、高效能且高度可擴展的向量資料庫命名為 Milvus,該資料庫能從筆記型電腦到大型分散式系統等廣泛環境中高效運作。它同時提供開源軟體與雲端服務兩種形式。
由 Zilliz 開發,並即將捐贈給隸屬於 Linux Foundation 的 LF AI & Data Foundation,Milvus 已成為全球領先的開源向量資料庫專案之一。 該專案採用 Apache 2.0 授權條款發佈,多數貢獻者皆來自高效能運算(HPC)社群的專家,專精於建構大規模系統及優化硬體感知程式碼。核心貢獻者包括來自 Zilliz、ARM、NVIDIA、AMD、Intel、Meta、IBM、Salesforce、阿里巴巴及微軟的專業人士。
值得注意的是,Zilliz 的每個開源專案都以鳥類命名,這項命名慣例象徵著自由、遠見以及技術的敏捷演進。
非結構化資料、嵌入向量與 Milvus
非結構化資料(例如文字、圖像和音訊)格式各異且蘊含豐富的底層語義,使其分析難度較高。為應對這種複雜性,會運用嵌入向量將非結構化資料轉換為能捕捉其本質特徵的數值向量。這些向量隨後儲存於向量資料庫中,從而實現快速且可擴展的搜尋與分析。
Milvus 提供強大的資料建模能力,讓您能將非結構化或多模態資料組織成結構化集合。它支援廣泛的資料類型以進行不同的屬性建模,包括常見的數值和字元類型、各種向量類型、陣列、集合以及 JSON,讓您無需費心維護多個資料庫系統。
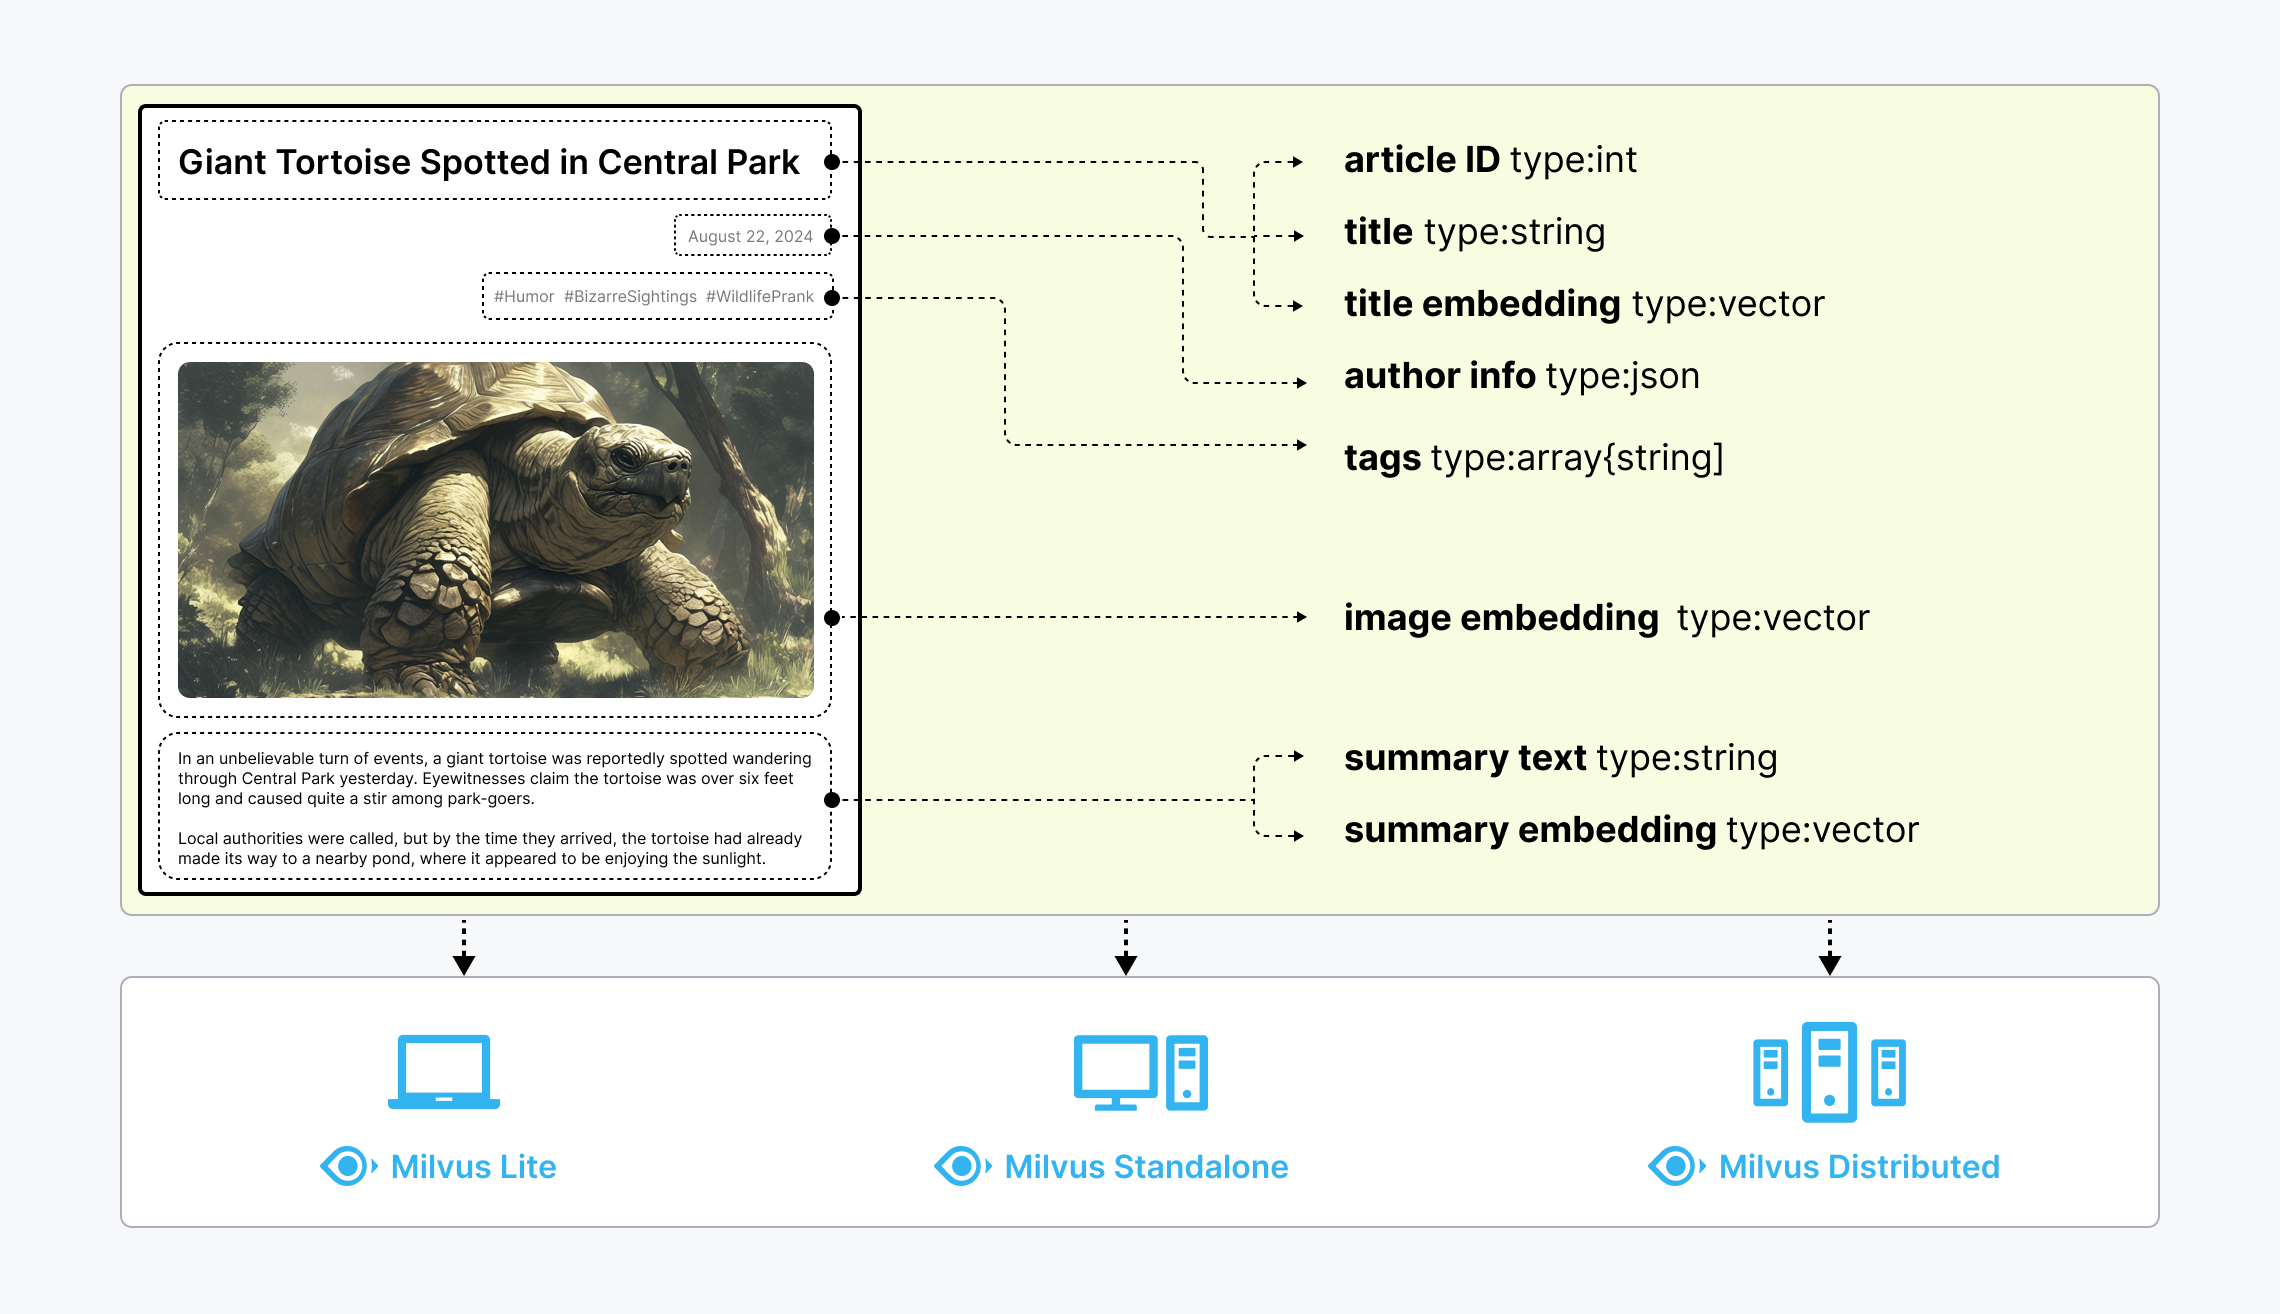 非結構化資料、嵌入向量與 Milvus
Milvus 提供三種部署模式,涵蓋廣泛的資料規模——從在 Jupyter Notebooks 中的本地原型開發,到管理數百億向量的龐大 Kubernetes 叢集:
- Milvus Lite 是一個可輕鬆整合至您應用程式的 Python 函式庫。作為 Milvus 的輕量級版本,它非常適合在 Jupyter Notebook 中進行快速原型開發,或在資源有限的邊緣裝置上運行。了解更多。
- Milvus Standalone 是一種單機伺服器部署方案,所有元件均整合至單一 Docker 映像檔中,便於部署。了解更多。
- Milvus Distributed 可部署於 Kubernetes 叢集,採用專為十億級甚至更大規模情境設計的雲原生架構。此架構確保關鍵元件具備冗餘性。了解更多。
是什麼讓 Milvus 如此快速?
Milvus 從開發之初便被設計為高效能的向量資料庫系統。在大多數情況下,Milvus 的效能比其他向量資料庫高出 2 至 5 倍(參見 VectorDBBench 測試結果)。這項卓越的效能源於幾項關鍵的設計決策:
硬體感知優化:為了讓 Milvus 能適應各種硬體環境,我們針對多種硬體架構與平台(包括 AVX512、SIMD、GPU 及 NVMe SSD)進行了專屬的效能優化。
先進的搜尋演算法:Milvus 支援多種記憶體內與磁碟上的索引/搜尋演算法,包括 IVF、HNSW、DiskANN 等,且所有演算法均經過深度優化。相較於 FAISS 和 HNSWLib 等常見實作,Milvus 的效能提升達 30% 至 70%。
以 C++ 開發的搜尋引擎:向量資料庫超過 80% 的效能取決於其搜尋引擎。Milvus 採用 C++ 開發此關鍵組件,因其具備高效能、低階優化及高效的資源管理能力。 最重要的是,Milvus 整合了眾多硬體感知式的程式碼優化技術,範圍涵蓋從匯編級向量化到多執行緒並行化與排程,以充分發揮硬體效能。
欄位導向:Milvus 是一個欄位導向的向量資料庫系統。 其主要優勢源自於資料存取模式。在執行查詢時,列導向資料庫僅讀取查詢涉及的特定欄位,而非整行資料,這大幅減少了存取的資料量。此外,針對列式資料的操作可輕鬆向量化,使操作能一次套用至整列資料,進一步提升效能。
Milvus 為何具備如此強大的可擴展性
2022 年,Milvus 已支援十億級向量;到了 2023 年,其規模更擴展至數百億級,且始終保持穩定運作,為包括 Salesforce、PayPal、Shopee、Airbnb、eBay、NVIDIA、 IBM、AT&T、LINE、ROBLOX、Inflection 等。
Milvus 的雲原生且高度解耦的系統架構,確保系統能隨著資料量增長而持續擴展:
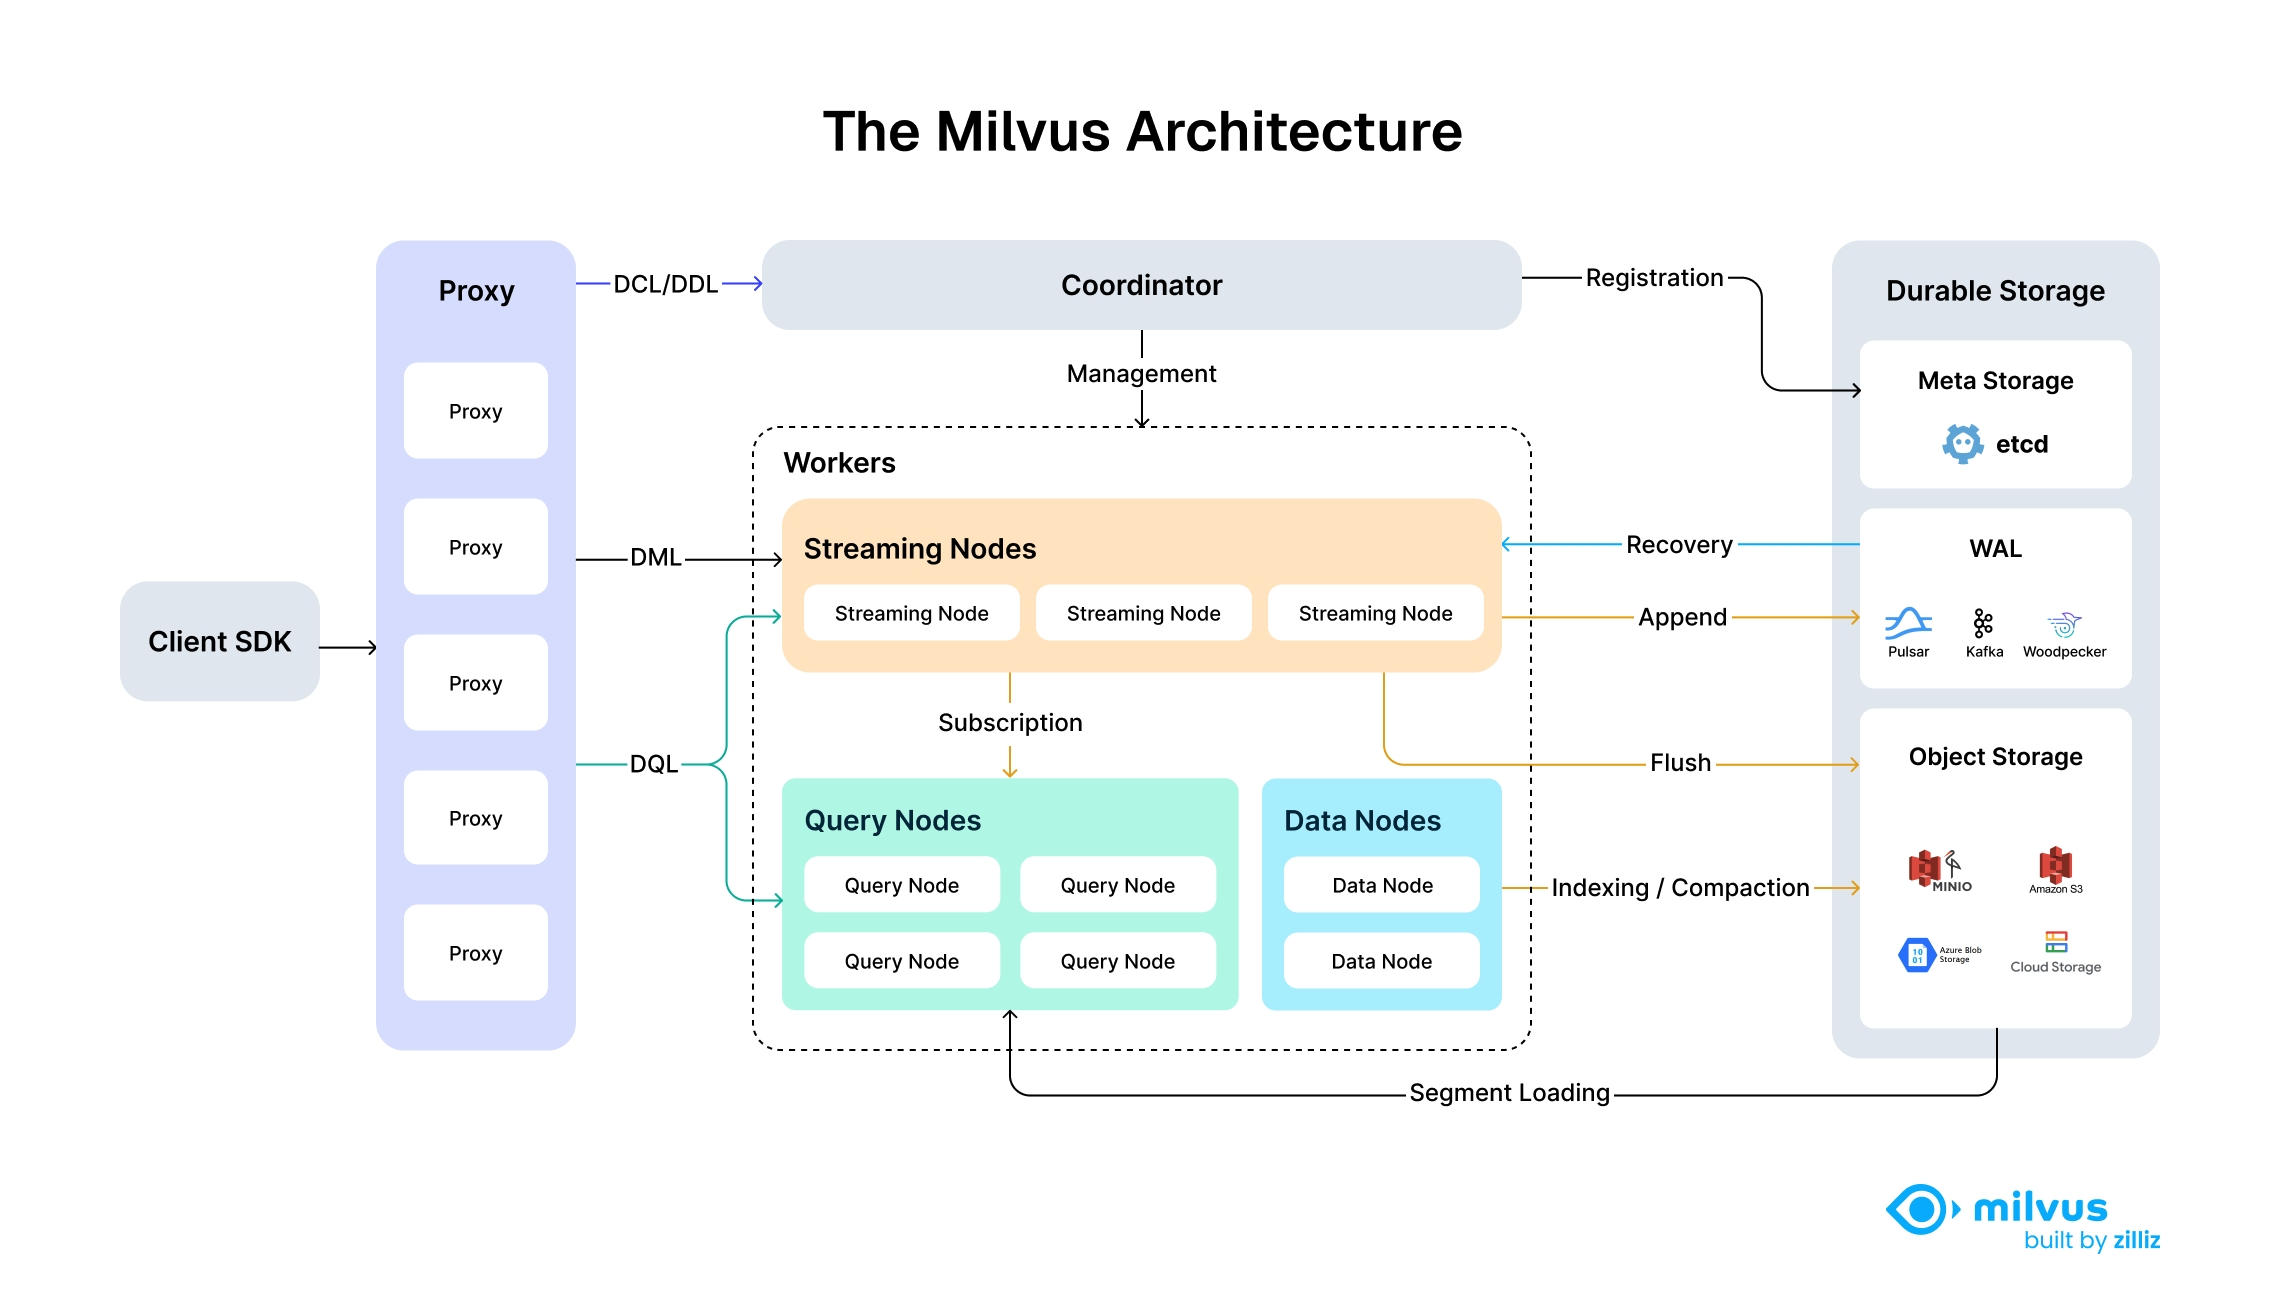 Milvus 高度解耦的系統架構
Milvus 本身完全無狀態,因此可透過 Kubernetes 或公有雲輕鬆進行擴展。 此外,Milvus 的各組件之間解耦程度極高,其中三項最關鍵的任務——搜尋、資料插入以及索引建立/壓縮——均被設計為易於並行化的流程,並將複雜邏輯分離出來。這確保了對應的查詢節點、資料節點和索引節點能夠獨立地進行縱向與橫向擴展,從而優化效能與成本效益。
Milvus 支援的搜尋類型
Milvus 支援多種搜尋功能,以滿足不同使用情境的需求:
- ANN 搜尋:找出與查詢向量最接近的前 K 個向量。
- 篩選搜尋:在指定的篩選條件下執行 ANN 搜尋。
- 範圍搜尋:找出距離查詢向量在指定半徑範圍內的向量。
- 混合搜尋:基於多個向量場進行人工神經網路搜尋。
- 全文檢索:基於 BM25 演算法的全文檢索。
- 重新排序:根據額外標準或次要演算法調整搜尋結果的順序,以優化最初的 ANN 搜尋結果。
- 擷取:根據主鍵擷取資料。
- 查詢:使用特定表達式檢索資料。
全面的特色功能集
除了上述關鍵搜尋功能外,Milvus 還提供了一套圍繞人工神經網路(ANN)搜尋所實現的功能,讓您能夠充分發揮其效能。
API 與 SDK
- RESTful API(官方)
- PyMilvus(Python SDK)(官方)
- Go SDK(官方)
- Java SDK(官方)
- Node.js(JavaScript) SDK(官方)
- C#(由 Microsoft 提供)
- C++ SDK(官方)
- Rust SDK(開發中)
進階資料類型
除了基本資料類型之外,Milvus 還支援各種進階資料類型及其各自適用的距離度量。
為何選擇 Milvus?
大規模運作下的高效能與高可用性
Milvus 採用分散式架構, 將運算與儲存分離。Milvus 能進行水平擴展並適應多樣化的流量模式,透過針對讀取密集型工作負載獨立增加查詢節點,以及針對寫入密集型工作負載獨立增加資料節點,從而實現最佳效能。 基於 K8s 的無狀態微服務可實現快速故障恢復,確保高可用性。透過在多個查詢節點上載入資料區段,複本支援功能進一步增強了容錯能力與吞吐量。請參閱基準測試以了解效能比較。
支援多種向量索引類型與硬體加速
Milvus 將系統層與核心向量搜尋引擎分離,使其能支援針對不同情境進行優化的所有主要向量索引類型,包括 HNSW、IVF、FLAT(暴力搜尋)、SCANN 及 DiskANN,並包含基於量化的變體與mmap。 Milvus針對元資料篩選和範圍搜尋等進階功能,對向量搜尋進行了優化。此外,Milvus 實作硬體加速以提升向量搜尋效能,並支援 GPU 索引功能,例如 NVIDIA 的CAGRA。
靈活的多租戶與熱/冷儲存
Milvus 透過在資料庫、集合、分區或分區鍵層級進行隔離,來支援多租戶架構。這些靈活的策略使單一叢集能處理數百至數百萬個租戶,同時確保最佳化的搜尋效能與彈性的存取控制。 Milvus 透過熱/冷儲存機制提升成本效益。頻繁存取的熱資料可儲存於記憶體或 SSD 中以獲得更佳效能,而較少存取的冷資料則存放於速度較慢但具成本效益的儲存裝置上。此機制可在維持關鍵任務高效能的同時,顯著降低成本。
用於全文搜尋與混合搜尋的稀疏向量
除了透過密集向量進行語義搜尋外,Milvus 還原生支援基於 BM25的全文搜尋,以及 SPLADE 和 BGE-M3 等學習型稀疏嵌入。使用者可將稀疏向量與密集向量儲存於同一集合中,並定義函式以重新排序來自多個搜尋請求的結果。 請參閱「語義搜尋 + 全文搜尋」的混合搜尋範例。
資料安全與細粒度存取控制
Milvus 透過實施強制性使用者驗證、TLS 加密以及基於角色的存取控制(RBAC),確保資料安全。使用者驗證可確保僅有持有有效憑證的授權使用者才能存取資料庫,而 TLS 加密則能保障網路內所有通訊的安全。 此外,RBAC 透過根據使用者角色指派特定權限,實現細粒度的存取控制。這些功能使 Milvus 成為企業應用程式的強大且安全的選擇,能保護敏感資料免於未經授權的存取及潛在的資料外洩。
AI 整合
嵌入式模型整合 嵌入式模型可將非結構化資料轉換為高維度資料空間中的數值表示形式,以便您將其儲存於 Milvus 中。目前,Python SDK「PyMilvus」已整合多種嵌入式模型,讓您能快速將資料轉換為向量嵌入。詳細資訊請參閱《嵌入式模型概覽》。
重新排序模型整合 在資訊檢索與生成式 AI 領域中,重新排序器(reranker)是優化初始搜尋結果排序的關鍵工具。PyMilvus 亦整合了多種重新排序模型,用以優化初始搜尋所返回結果的排序。詳情請參閱《重新排序器概覽》。
LangChain 及其他 AI 工具整合 在生成式 AI 時代,諸如 LangChain 之類的工具備受應用程式開發者矚目。作為核心組件,Milvus 通常在這些工具中擔任向量儲存庫的角色。若要了解如何將 Milvus 整合至您喜愛的 AI 工具中,請參閱我們的「整合方案與 教學指南 」。
工具與生態系統
Attu Attu 是一款直觀的一體化圖形使用者介面(GUI),可協助您管理 Milvus 及其儲存的資料。詳細資訊請參閱Attu儲存庫。
Birdwatcher Birdwatcher 是一款專為 Milvus 設計的除錯工具。透過它連線至 etcd,您可以檢查 Milvus 系統的狀態,或即時進行配置。詳情請參閱BirdWatcher。
Prometheus 與 Grafana 整合 Prometheus 是一款適用於 Kubernetes 的開源系統監控與警示工具套件。Grafana 則是一套可連接所有資料來源的開源視覺化平台。您可以將 Prometheus 與 Grafana 作為監控服務提供者,以視覺化方式監控 Milvus 分散式系統的效能。詳情請參閱《部署監控服務》。
Milvus Backup Milvus Backup 是一項讓使用者能備份與還原 Milvus 資料的工具。它同時提供 CLI 與 API,以適應不同的應用情境。詳細資訊請參閱Milvus Backup。
Milvus 資料變更擷取 (CDC) Milvus CDC 可將資料變更從一個 Milvus 叢集複製到另一個叢集,以實現主備災難復原。詳細資訊請參閱《Milvus CDC》。
Milvus 連接器 Milvus 已規劃了一套連接器,讓您能將 Milvus 與第三方工具(例如 Apache Spark)無縫整合。目前,您可以使用我們的 Spark 連接器,將 Milvus 資料傳送至 Apache Spark 進行機器學習處理。詳細資訊請參閱《Spark-Milvus 連接器》。
向量傳輸服務 (VTS) Milvus 提供了一套工具,讓您能在 Milvus 實例與多種資料來源之間傳輸資料,包括 Zilliz 叢集、Elasticsearch、Postgres (PgVector) 以及另一個 Milvus 實例。詳細資訊請參閱VTS。
