

Apa itu Milvus?
Milvus adalah burung pemangsa dari genus Milvus dalam keluarga elang Accipitridae, yang terkenal karena kecepatan terbangnya, penglihatan yang tajam, dan kemampuan beradaptasi yang luar biasa.
Zilliz mengadopsi nama Milvus untuk basis data vektor open-source berkinerja tinggi dan sangat skalabel yang berjalan secara efisien di berbagai lingkungan, mulai dari laptop hingga sistem terdistribusi berskala besar. Basis data ini tersedia baik sebagai perangkat lunak open-source maupun layanan cloud.
Dikembangkan oleh Zilliz dan akan segera disumbangkan ke LF AI & Data Foundation di bawah naungan Linux Foundation, Milvus telah menjadi salah satu proyek basis data vektor sumber terbuka terkemuka di dunia. Proyek ini didistribusikan di bawah lisensi Apache 2.0, dan sebagian besar kontributornya adalah para ahli dari komunitas komputasi berkinerja tinggi (HPC), yang berspesialisasi dalam membangun sistem berskala besar dan mengoptimalkan kode yang sadar perangkat keras. Kontributor inti termasuk para profesional dari Zilliz, ARM, NVIDIA, AMD, Intel, Meta, IBM, Salesforce, Alibaba, dan Microsoft.
Menariknya, setiap proyek sumber terbuka Zilliz dinamai berdasarkan nama burung, yang merupakan konvensi penamaan yang melambangkan kebebasan, pandangan ke depan, dan evolusi teknologi yang gesit.
Data Tidak Terstruktur, Embedding, dan Milvus
Data tidak terstruktur, seperti teks, gambar, dan audio, memiliki format yang bervariasi dan mengandung semantik mendasar yang kaya, sehingga sulit untuk dianalisis. Untuk mengelola kompleksitas ini, embeddings digunakan untuk mengubah data tidak terstruktur menjadi vektor numerik yang menangkap karakteristik esensialnya. Vektor-vektor ini kemudian disimpan dalam basis data vektor, memungkinkan pencarian dan analisis yang cepat serta skalabel.
Milvus menawarkan kemampuan pemodelan data yang tangguh, memungkinkan Anda mengorganisir data tidak terstruktur atau multimodal Anda ke dalam koleksi terstruktur. Milvus mendukung berbagai jenis data untuk pemodelan atribut yang berbeda, termasuk tipe numerik dan karakter umum, berbagai tipe vektor, array, himpunan, dan JSON, sehingga Anda tidak perlu repot mengelola beberapa sistem basis data.
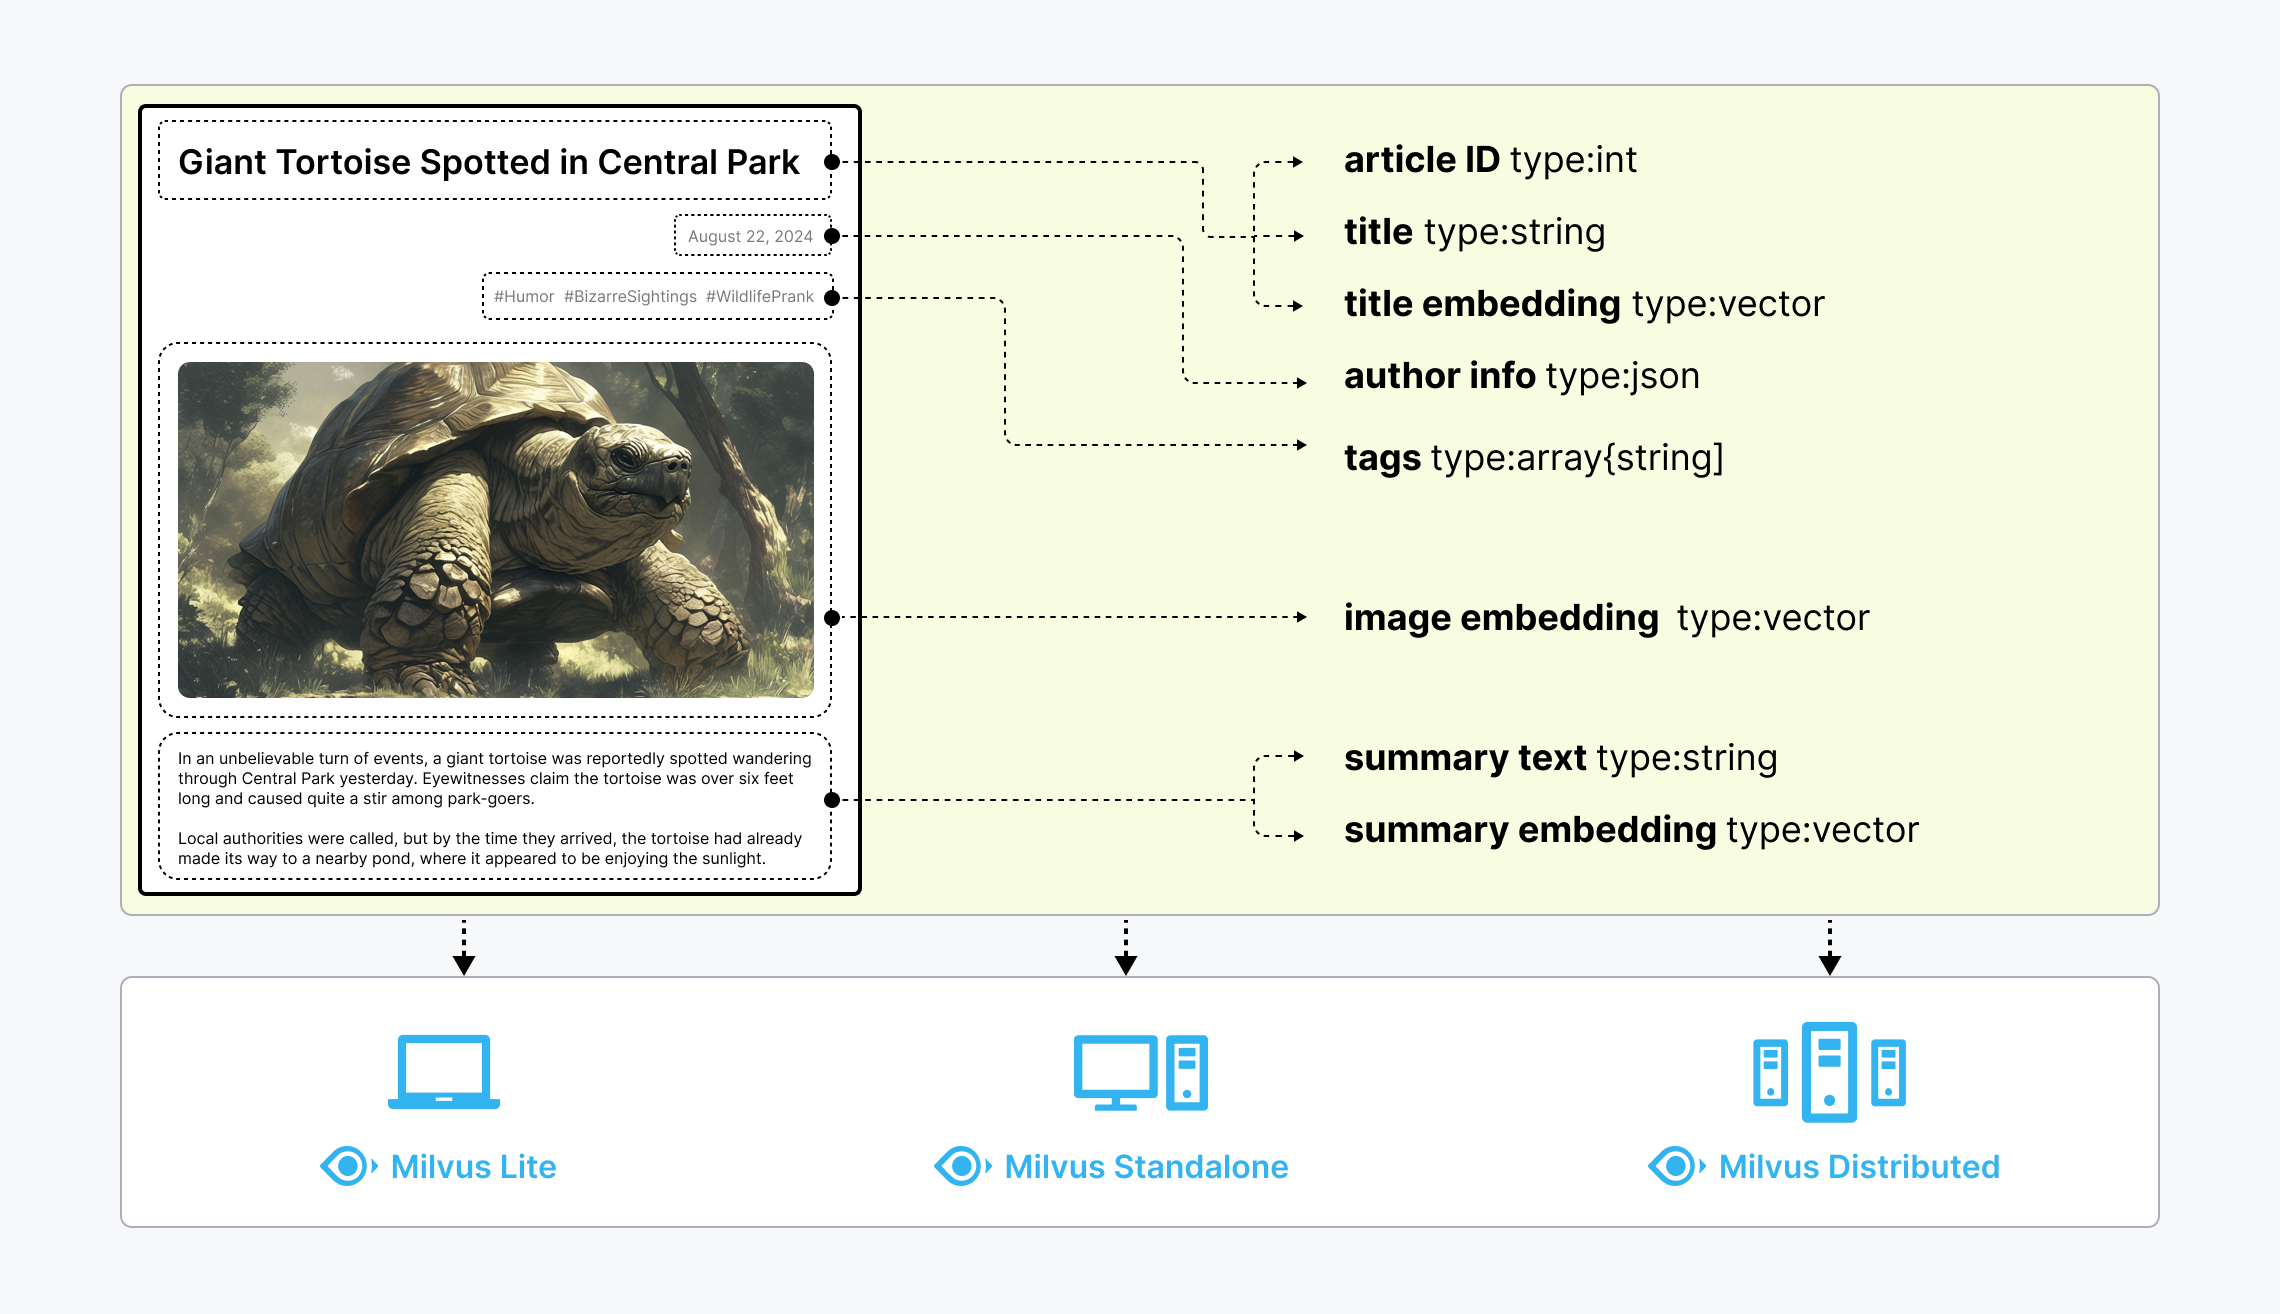 Data tidak terstruktur, embedding, dan Milvus
Milvus menawarkan tiga mode penerapan, yang mencakup berbagai skala data—mulai dari pembuatan prototipe lokal di Jupyter Notebook hingga klaster Kubernetes besar yang mengelola puluhan miliar vektor:
- Milvus Lite adalah pustaka Python yang dapat dengan mudah diintegrasikan ke dalam aplikasi Anda. Sebagai versi ringan dari Milvus, pustaka ini sangat ideal untuk pembuatan prototipe cepat di Jupyter Notebooks atau dijalankan pada perangkat edge dengan sumber daya terbatas. Pelajari lebih lanjut.
- Milvus Standalone adalah penyebaran server pada satu mesin, dengan semua komponen dikemas dalam satu gambar Docker untuk kemudahan penyebaran. Pelajari lebih lanjut.
- Milvus Distributed dapat diimplementasikan pada kluster Kubernetes, dengan arsitektur cloud-native yang dirancang untuk skenario berskala miliaran atau bahkan lebih besar. Arsitektur ini memastikan redundansi pada komponen-komponen kritis. Pelajari lebih lanjut.
Apa yang Membuat Milvus Begitu Cepat?
Milvus dirancang sejak awal untuk menjadi sistem basis data vektor yang sangat efisien. Dalam kebanyakan kasus, Milvus mengungguli basis data vektor lainnya hingga 2-5 kali lipat (lihat hasil VectorDBBench). Kinerja tinggi ini merupakan hasil dari beberapa keputusan desain utama:
Optimisasi yang Menyesuaikan dengan Perangkat Keras: Untuk mengakomodasi Milvus di berbagai lingkungan perangkat keras, kami telah mengoptimalkan kinerjanya secara khusus untuk banyak arsitektur dan platform perangkat keras, termasuk AVX512, SIMD, GPU, dan SSD NVMe.
Algoritma Pencarian Canggih: Milvus mendukung beragam algoritma pengindeksan/pencarian dalam memori dan pada disk, termasuk IVF, HNSW, DiskANN, dan lainnya, yang semuanya telah dioptimalkan secara mendalam. Dibandingkan dengan implementasi populer seperti FAISS dan HNSWLib, Milvus memberikan kinerja yang 30%-70% lebih baik.
Mesin Pencari dalam C++: Lebih dari 80% kinerja basis data vektor ditentukan oleh mesin pencari. Milvus menggunakan C++ untuk komponen kritis ini karena kinerja tinggi bahasa tersebut, optimasi tingkat rendah, dan pengelolaan sumber daya yang efisien. Yang terpenting, Milvus mengintegrasikan berbagai optimasi kode yang sadar perangkat keras, mulai dari vektorisasi tingkat perakitan hingga paralelisasi dan penjadwalan multi-thread, untuk memanfaatkan kemampuan perangkat keras secara maksimal.
Berorientasi Kolom: Milvus adalah sistem basis data vektor berorientasi kolom. Keunggulan utamanya berasal dari pola akses data. Saat melakukan kueri, basis data berorientasi kolom hanya membaca bidang tertentu yang terlibat dalam kueri, bukan seluruh baris, yang secara signifikan mengurangi jumlah data yang diakses. Selain itu, operasi pada data berbasis kolom dapat dengan mudah divektorisasi, sehingga operasi dapat diterapkan pada seluruh kolom sekaligus, yang semakin meningkatkan kinerja.
Apa yang Membuat Milvus Begitu Skalabel
Pada tahun 2022, Milvus mendukung vektor berskala miliaran, dan pada tahun 2023, skalanya meningkat hingga puluhan miliar dengan stabilitas yang konsisten, mendukung skenario berskala besar untuk lebih dari 300 perusahaan besar, termasuk Salesforce, PayPal, Shopee, Airbnb, eBay, NVIDIA, IBM, AT&T, LINE, ROBLOX, Inflection, dan lain-lain.
Arsitektur sistem Milvus yang cloud-native dan sangat terpisah memastikan bahwa sistem dapat terus berkembang seiring pertumbuhan data:
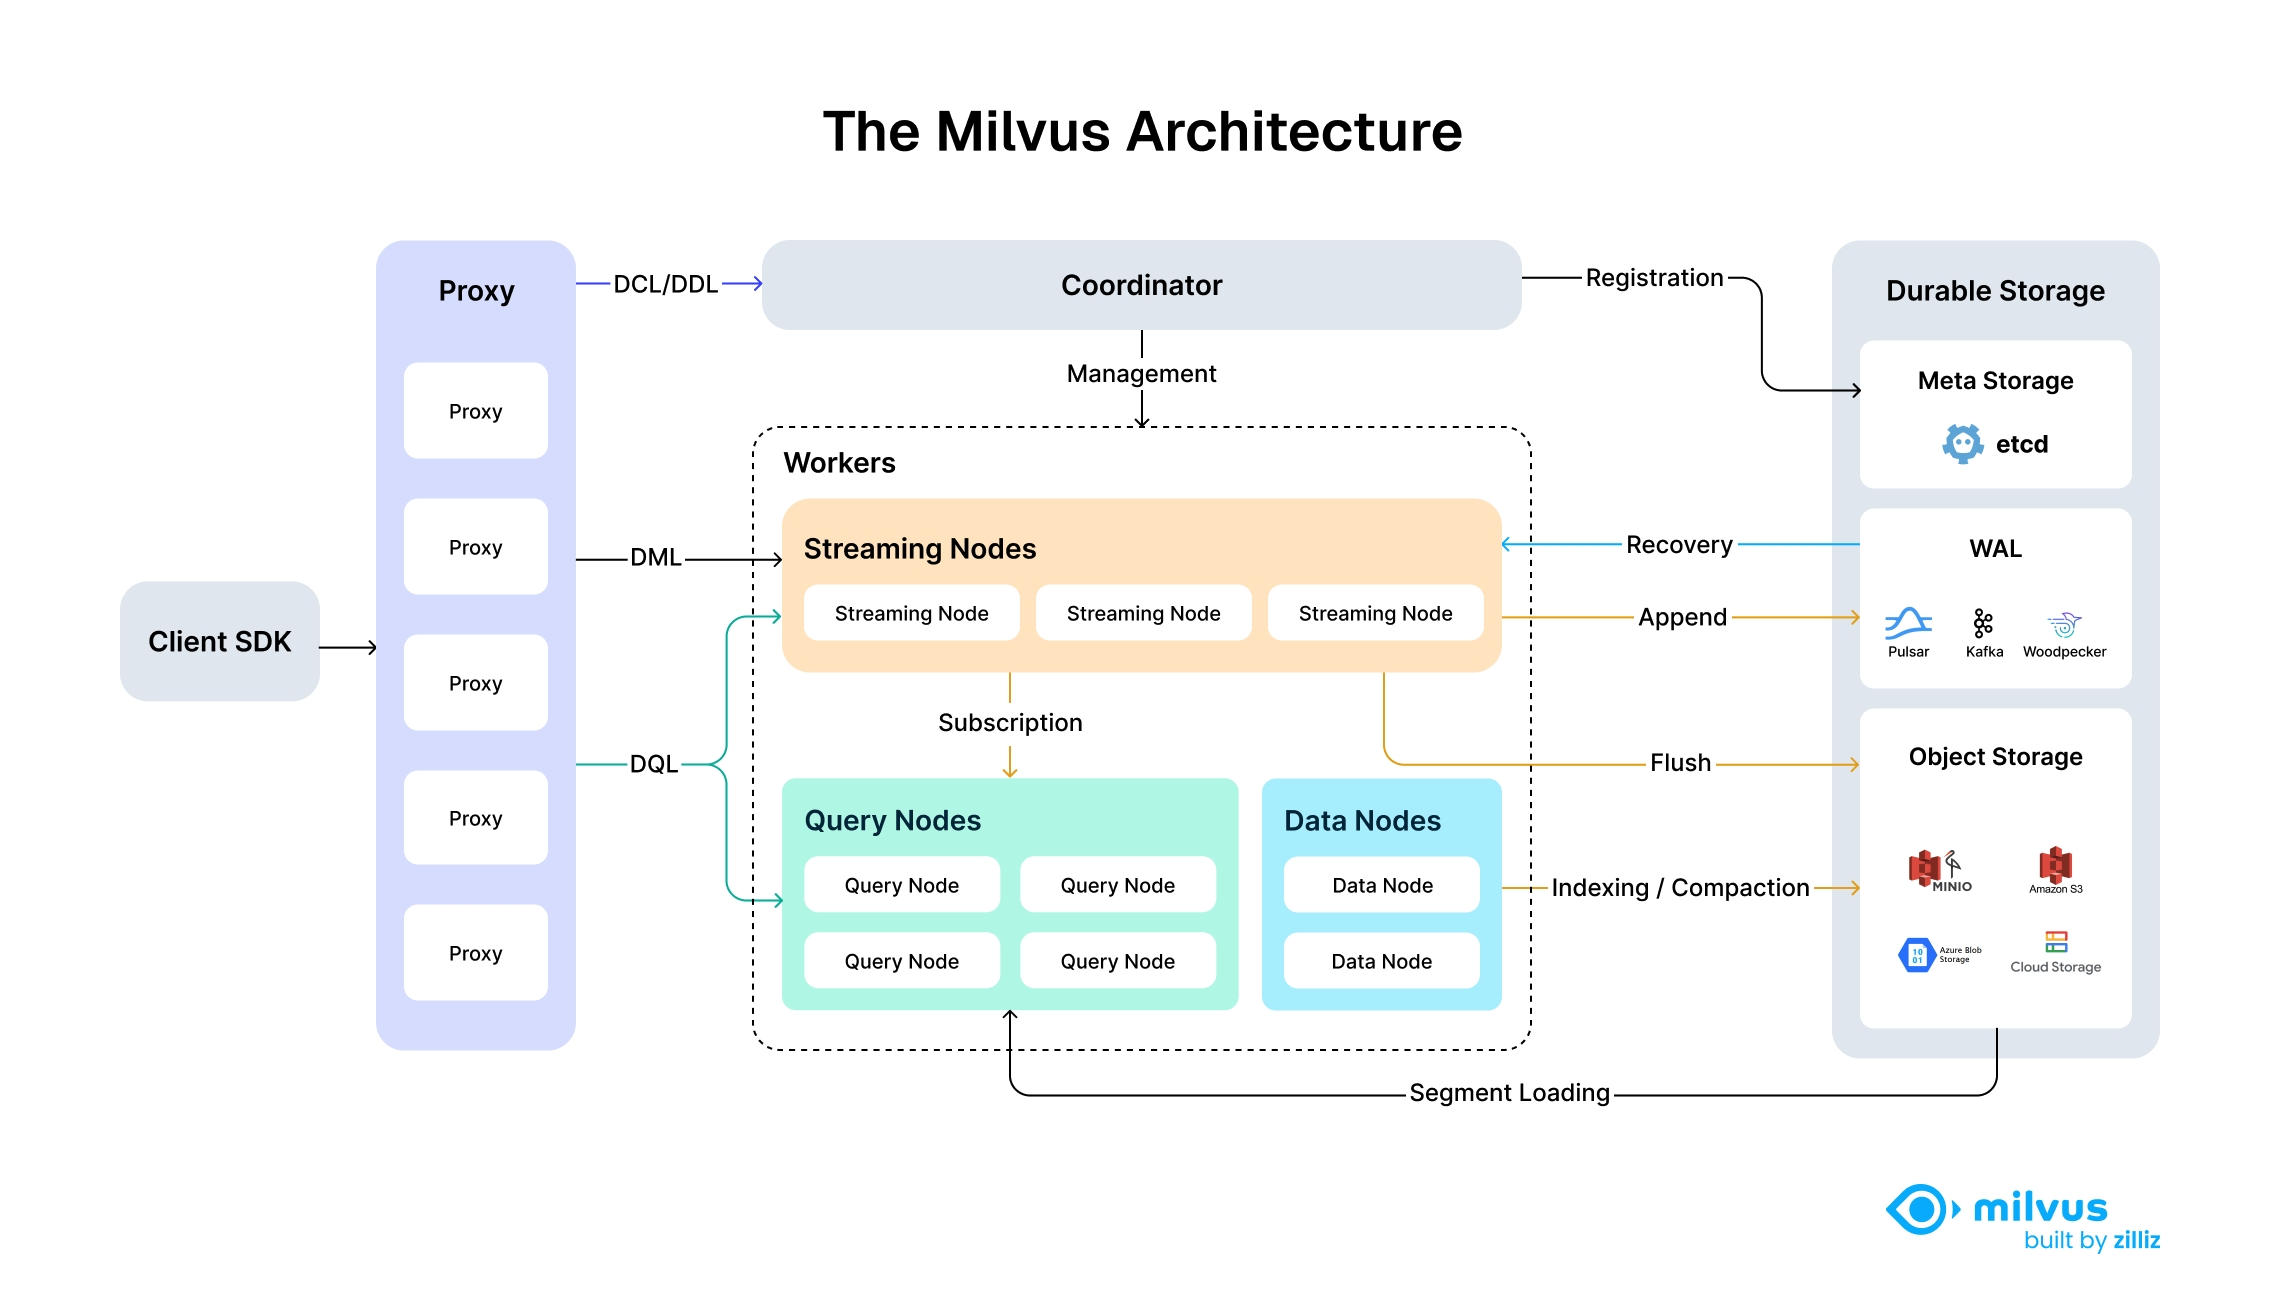 Arsitektur sistem Milvus yang sangat terpisah
Milvus sendiri sepenuhnya stateless sehingga dapat dengan mudah diskalakan dengan bantuan Kubernetes atau cloud publik. Selain itu, komponen-komponen Milvus terpisah dengan baik, dengan tiga tugas paling kritis—pencarian, penyisipan data, dan pengindeksan/pemadatan—dirancang sebagai proses yang mudah diparalelkan, dengan logika kompleks yang dipisahkan. Hal ini memastikan bahwa node kueri, node data, dan node indeks yang sesuai dapat diskalakan baik ke atas maupun ke luar secara independen, sehingga mengoptimalkan kinerja dan efisiensi biaya.
Jenis Pencarian yang Didukung oleh Milvus
Milvus mendukung berbagai jenis fungsi pencarian untuk memenuhi kebutuhan berbagai kasus penggunaan:
- Pencarian ANN: Menemukan K vektor teratas yang paling dekat dengan vektor kueri Anda.
- Pencarian Penyaringan: Melakukan pencarian ANN di bawah kondisi penyaringan yang ditentukan.
- Pencarian Rentang: Menemukan vektor dalam radius tertentu dari vektor kueri Anda.
- Pencarian Hibrida: Melakukan pencarian ANN berdasarkan beberapa bidang vektor.
- Pencarian Teks Lengkap: Pencarian teks lengkap berdasarkan BM25.
- Penataan Ulang Peringkat: Menyesuaikan urutan hasil pencarian berdasarkan kriteria tambahan atau algoritma sekunder, menyempurnakan hasil pencarian ANN awal.
- Pengambilan: Mengambil data berdasarkan kunci utamanya.
- Kueri: Mengambil data menggunakan ekspresi tertentu.
Kumpulan Fitur yang Lengkap
Selain fitur pencarian utama yang disebutkan di atas, Milvus juga menyediakan serangkaian fitur yang diimplementasikan di sekitar pencarian ANN sehingga Anda dapat memanfaatkan kemampuannya secara maksimal.
API dan SDK
- API RESTful (resmi)
- PyMilvus (SDK Python) (resmi)
- SDK Go (resmi)
- SDK Java (resmi)
- Node.js (JavaScript) SDK (resmi)
- C# (disumbangkan oleh Microsoft)
- SDK C++ (resmi)
- Rust SDK (sedang dikembangkan)
Tipe Data Lanjutan
Selain tipe data primitif, Milvus mendukung berbagai tipe data lanjutan beserta metrik jarak yang berlaku untuk masing-masing tipe tersebut.
- Vektor Sparse
- Vektor Biner
- Dukungan JSON
- Dukungan Array
- Geolokasi
- Teks (sedang dikembangkan)
Mengapa Milvus?
Kinerja Tinggi pada Skala Besar dan Ketersediaan Tinggi
Milvus memiliki arsitektur terdistribusi yang memisahkan komputasi dan penyimpanan. Milvus dapat melakukan penskalaan horizontal dan beradaptasi dengan pola lalu lintas yang beragam, sehingga mencapai kinerja optimal dengan menambah node kueri secara independen untuk beban kerja yang banyak membaca dan node data untuk beban kerja yang banyak menulis. Layanan mikro tanpa status (stateless) di K8s memungkinkan pemulihan cepat dari kegagalan, memastikan ketersediaan tinggi. Dukungan untuk replika semakin meningkatkan toleransi terhadap kegagalan dan throughput dengan memuat segmen data pada beberapa node kueri. Lihat tolok ukur untuk perbandingan kinerja.
Dukungan untuk Berbagai Jenis Indeks Vektor dan Akselerasi Perangkat Keras
Milvus memisahkan sistem dan mesin pencarian vektor inti, sehingga memungkinkan dukungan terhadap semua jenis indeks vektor utama yang dioptimalkan untuk skenario berbeda, termasuk HNSW, IVF, FLAT (brute-force), SCANN, dan DiskANN, beserta varian berbasis kuantisasi dan mmap. Milvus mengoptimalkan pencarian vektor untuk fitur-fitur canggih seperti penyaringan metadata dan pencarian rentang. Selain itu, Milvus menerapkan akselerasi perangkat keras untuk meningkatkan kinerja pencarian vektor dan mendukung pengindeksan GPU, seperti CAGRA dari NVIDIA.
Multi-tenancy yang Fleksibel dan Penyimpanan Hot/Cold
Milvus mendukung multi-tenancy melalui isolasi pada tingkat database, koleksi, partisi, atau kunci partisi. Strategi yang fleksibel ini memungkinkan satu kluster menangani ratusan hingga jutaan penyewa, sekaligus memastikan kinerja pencarian yang dioptimalkan dan kontrol akses yang fleksibel. Milvus meningkatkan efisiensi biaya dengan penyimpanan panas/dingin. Data panas yang sering diakses dapat disimpan dalam memori atau pada SSD untuk kinerja yang lebih baik, sedangkan data dingin yang jarang diakses disimpan pada penyimpanan yang lebih lambat dan hemat biaya. Mekanisme ini dapat secara signifikan mengurangi biaya sekaligus mempertahankan kinerja tinggi untuk tugas-tugas penting.
Vektor Sparse untuk Pencarian Teks Lengkap dan Pencarian Hibrida
Selain pencarian semantik melalui vektor padat, Milvus juga secara native mendukung pencarian teks lengkap dengan BM25 serta embedding spars yang dipelajari seperti SPLADE dan BGE-M3. Pengguna dapat menyimpan vektor spars dan vektor padat dalam koleksi yang sama, serta mendefinisikan fungsi untuk menyusun ulang peringkat hasil dari beberapa permintaan pencarian. Lihat contoh Pencarian Hibrida dengan pencarian semantik + pencarian teks lengkap.
Keamanan Data dan Kontrol Akses Berbasis Peran
Milvus memastikan keamanan data dengan menerapkan otentikasi pengguna wajib, enkripsi TLS, dan Kontrol Akses Berbasis Peran (RBAC). Otentikasi pengguna memastikan bahwa hanya pengguna yang berwenang dengan kredensial yang valid yang dapat mengakses basis data, sementara enkripsi TLS mengamankan semua komunikasi di dalam jaringan. Selain itu, RBAC memungkinkan kontrol akses terperinci dengan menetapkan izin khusus kepada pengguna berdasarkan peran mereka. Fitur-fitur ini menjadikan Milvus pilihan yang andal dan aman untuk aplikasi perusahaan, melindungi data sensitif dari akses tidak sah dan potensi pelanggaran.
Integrasi AI
Integrasi Model Embedding Model Embedding mengubah data tidak terstruktur menjadi representasi numeriknya dalam ruang data berdimensi tinggi sehingga Anda dapat menyimpannya di Milvus. Saat ini, PyMilvus, SDK Python, mengintegrasikan beberapa model embedding sehingga Anda dapat dengan cepat mempersiapkan data Anda menjadi vektor embedding. Untuk detailnya, lihat Ikhtisar Embedding.
Integrasi Model Reranking Dalam bidang pencarian informasi dan AI generatif, reranker merupakan alat penting yang mengoptimalkan urutan hasil dari pencarian awal. PyMilvus juga mengintegrasikan beberapa model reranking untuk mengoptimalkan urutan hasil yang dikembalikan dari pencarian awal. Untuk detailnya, lihat Ikhtisar Reranker.
Integrasi LangChain dan Alat AI Lainnya Di era GenAI, alat-alat seperti LangChain menarik banyak perhatian dari pengembang aplikasi. Sebagai komponen inti, Milvus biasanya berfungsi sebagai penyimpanan vektor dalam alat-alat tersebut. Untuk mempelajari cara mengintegrasikan Milvus ke dalam alat AI favorit Anda, lihat Integrasi dan Tutorial kami.
Alat dan Ekosistem
Attu Attu adalah antarmuka pengguna grafis (GUI) intuitif all-in-one yang membantu Anda mengelola Milvus dan data yang disimpannya. Untuk detailnya, lihat repositori Attu.
Birdwatcher Birdwatcher adalah alat debugging untuk Milvus. Dengan menggunakannya untuk terhubung ke etcd, Anda dapat memeriksa status sistem Milvus Anda atau mengonfigurasinya secara langsung. Untuk detailnya, lihat BirdWatcher.
Integrasi Prometheus & Grafana Prometheus adalah rangkaian alat pemantauan sistem dan peringatan sumber terbuka untuk Kubernetes. Grafana adalah tumpukan visualisasi sumber terbuka yang dapat terhubung dengan semua sumber data. Anda dapat menggunakan Prometheus & Grafana sebagai penyedia layanan pemantauan untuk memantau kinerja Milvus terdistribusi secara visual. Untuk detailnya, lihat Deploying Monitoring Services.
Milvus Backup Milvus Backup adalah alat yang memungkinkan pengguna mencadangkan dan memulihkan data Milvus. Alat ini menyediakan antarmuka baris perintah (CLI) dan antarmuka pemrograman aplikasi (API) agar dapat disesuaikan dengan berbagai skenario aplikasi. Untuk detailnya, lihat Milvus Backup.
Milvus Capture Data Change (CDC) Milvus CDC dapat mereplikasi perubahan data dari satu kluster Milvus ke kluster lainnya untuk pemulihan bencana (disaster recovery) tipe primer-standby. Untuk detail selengkapnya, lihat Milvus CDC.
Konektor Milvus Milvus telah merencanakan serangkaian konektor agar Anda dapat mengintegrasikan Milvus secara mulus dengan alat pihak ketiga, seperti Apache Spark. Saat ini, Anda dapat menggunakan Konektor Spark kami untuk mengalirkan data Milvus ke Apache Spark guna pemrosesan pembelajaran mesin. Untuk detailnya, lihat Konektor Spark-Milvus.
Layanan Transmisi Vektor (VTS) Milvus menyediakan serangkaian alat agar Anda dapat mentransfer data antara sebuah instance Milvus dan berbagai sumber data, termasuk kluster Zilliz, Elasticsearch, Postgres (PgVector), dan instance Milvus lainnya. Untuk detail selengkapnya, lihat VTS.
