

Wählen Sie den richtigen Analysator für Ihren Anwendungsfall
Dieser Leitfaden konzentriert sich auf die praktische Entscheidungsfindung bei der Auswahl eines Analysators. Technische Details zu den Komponenten eines Analysators und zum Hinzufügen von Analysatorparametern finden Sie unter „Analysator-Übersicht“.
Analysatoren in 2 Minuten verstehen
In Milvus verarbeitet ein Analysator den in diesem Feld gespeicherten Text, um ihn für Funktionen wie die Volltextsuche (BM25), die Phrasenübereinstimmung oder die Textübereinstimmung durchsuchbar zu machen. Stellen Sie sich einen Textprozessor vor, der Ihre Rohdaten in durchsuchbare Tokens umwandelt.
Ein Analysator arbeitet in einer einfachen, zweistufigen Pipeline:
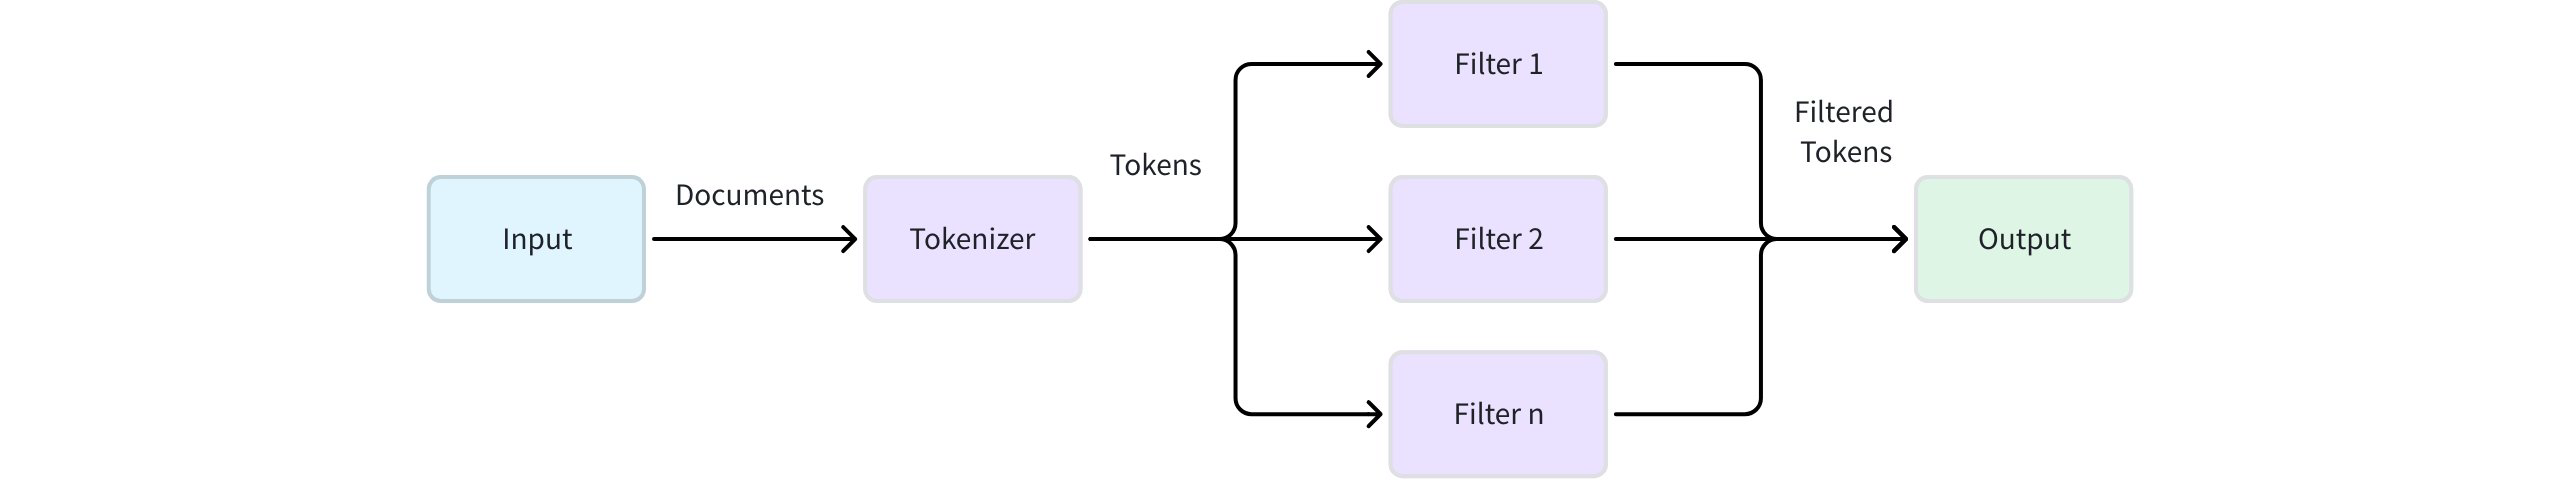 Analyzer-Workflow
Tokenisierung (erforderlich): In dieser ersten Stufe wird ein Tokenizer angewendet, um eine fortlaufende Textzeichenfolge in diskrete, aussagekräftige Einheiten, sogenannte Token, aufzuteilen. Die Tokenisierungsmethode kann je nach Sprache und Inhaltstyp erheblich variieren.
Token-Filterung (optional): Nach der Tokenisierung werden Filter angewendet, um die Token zu modifizieren, zu entfernen oder zu verfeinern. Zu diesen Vorgängen gehören beispielsweise die Umwandlung aller Token in Kleinbuchstaben, das Entfernen häufiger, bedeutungsloser Wörter (sogenannter Stoppwörter) oder die Reduzierung von Wörtern auf ihre Stammform (Stemming).
Beispiel:
Input: "Hello World!"
       1. Tokenization → ["Hello", "World", "!"]
       2. Lowercase & Punctuation Filtering → ["hello", "world"]
Warum die Wahl des Analysators wichtig ist
Die Wahl eines falschen Analysators kann dazu führen, dass relevante Dokumente nicht mehr auffindbar sind oder irrelevante Ergebnisse zurückgegeben werden.
Die folgende Tabelle fasst häufige Probleme zusammen, die durch eine unsachgemäße Auswahl des Analysators verursacht werden, und bietet umsetzbare Lösungen zur Diagnose von Suchproblemen.
Problem |
Symptom |
Beispiel (Eingabe & Ausgabe) |
Ursache (ungeeigneter Analysator) |
Lösung (geeigneter Analysator) |
|---|---|---|---|---|
Übermäßige Tokenisierung |
Textabfragen nach Fachbegriffen, Bezeichnern oder URLs finden keine relevanten Dokumente. |
|
|
Verwenden Sie einen |
Unter-Tokenisierung |
Die Suche nach einem Bestandteil einer aus mehreren Wörtern bestehenden Phrase liefert keine Dokumente, die die vollständige Phrase enthalten. |
|
Analysator mit einem |
Verwenden Sie einen |
Sprachliche Unstimmigkeiten |
Die Suchergebnisse für eine bestimmte Sprache sind unsinnig oder fehlen gänzlich. |
Chinesischer Text: |
|
Verwenden Sie einen sprachspezifischen Analysator, wie z. B. |
Nicht übereinstimmende Eingabemethode |
Benutzer geben Pinyin ein, der indizierte Text enthält jedoch chinesische Schriftzeichen. |
Chinesischer Text: |
Analysator, der ausschließlich Token mit chinesischen Schriftzeichen ausgibt |
Verwenden Sie einen benutzerdefinierten Analysator mit dem |
Erste Frage: Müssen Sie einen Analysator auswählen?
In vielen Anwendungsfällen müssen Sie nichts Besonderes tun. Lassen Sie uns klären, ob dies auch auf Sie zutrifft.
Standardverhalten: „ standard “-Analysator
Wenn Sie bei der Verwendung von Textabruf-Funktionen wie der Volltextsuche keinen Analysator angeben, verwendet Milvus automatisch den standard Analysator.
Der „ standard “-Analysator:
Teilt den Text anhand von Leerzeichen und Satzzeichen auf
Wandelt alle Token in Kleinbuchstaben um
Entfernt eine integrierte Liste gängiger englischer Stoppwörter sowie den Großteil der Satzzeichen
Beispiel für eine Transformation:
Input:  "The Milvus vector database is built for scale!"
Output: ['the', 'milvus', 'vector', 'database', 'is', 'built', 'scale']
Entscheidungskriterien: Eine schnelle Überprüfung
Anhand dieser Tabelle können Sie schnell feststellen, ob der Standard-Analysator „ standard “ Ihren Anforderungen entspricht. Ist dies nicht der Fall, müssen Sie einen anderen Weg wählen.
Ihr Inhalt |
Ist der Standard-Analyzer geeignet? |
Warum |
Was Sie benötigen |
|---|---|---|---|
Englische Blogbeiträge |
✅ Ja |
Das Standardverhalten ist ausreichend. |
Verwenden Sie die Standardeinstellung (keine Konfiguration erforderlich). |
Chinesische Dokumente |
❌ Nein |
Chinesische Wörter enthalten keine Leerzeichen und werden als ein Token behandelt. |
Verwenden Sie einen integrierten |
Arabische Dokumente |
❌ Nein |
Arabischer Text kann Buchstabenvarianten, diakritische Zeichen, Tatweel, arabisch-indische Ziffern und gängige arabische Stoppwörter enthalten, die eine sprachspezifische Behandlung erfordern. |
Verwenden Sie einen integrierten |
Thailändische Dokumente |
❌ Nein |
Thailändischer Text verwendet in der Regel keine Leerzeichen zwischen den Wörtern, daher ist eine sprachspezifische Worttrennung erforderlich. |
Verwenden Sie einen integrierten |
Technische Dokumentation |
❌ Nein |
Zeichen wie „ |
Erstellen Sie einen benutzerdefinierten Analysator mit einem |
Sprachen mit durch Leerzeichen getrennten Wörtern, wie z. B. Französisch oder Spanisch |
⚠️ Möglicherweise |
werden Zeichen mit Akzenten ( |
Ein benutzerdefinierter Analysator mit dem |
Mehrsprachige oder unbekannte Sprachen |
❌ Nein |
Dem Analyzer „ |
Verwenden Sie einen benutzerdefinierten Analysator mit dem Alternativ sollten Sie die Konfiguration mehrsprachiger Analysatoren oder eines Sprachidentifikators in Betracht ziehen, um mehrsprachige Inhalte präziser zu verarbeiten. |
Wenn der standardmäßige „ standard “-Analysator Ihre Anforderungen nicht erfüllen kann, müssen Sie einen anderen implementieren. Dabei stehen Ihnen zwei Möglichkeiten zur Verfügung:
Möglichkeit A: Verwendung integrierter Analysatoren
Integrierte Analysatoren sind vorkonfigurierte Lösungen für gängige Sprachen. Sie sind der einfachste Einstieg, wenn der Standard-Analysator nicht optimal passt.
Verfügbare integrierte Analysatoren
Analysator |
Unterstützte Sprache |
Komponenten |
Hinweise |
|---|---|---|---|
Die meisten Sprachen mit Leerzeichen als Trennzeichen (Englisch, Französisch, Deutsch, Spanisch usw.) |
|
Allgemeiner Analysator für die erste Textverarbeitung. Für einsprachige Szenarien bieten sprachspezifische Analysatoren (wie |
|
Speziell für Englisch entwickelt, wendet Stemming und das Entfernen von Stoppwörtern an, um eine bessere semantische Übereinstimmung im Englischen zu erzielen |
|
Empfohlen für rein englischsprachige Inhalte anstelle von |
|
Chinesisch |
|
Verwendet derzeit standardmäßig das Wörterbuch für vereinfachtes Chinesisch. |
|
Arabisch |
|
Empfohlen für arabischen Text anstelle von |
|
Thai |
|
Empfohlen für thailändischen Text anstelle von |
Implementierungsbeispiel
Um einen integrierten Analysator zu verwenden, geben Sie bei der Definition Ihres Feldschemas einfach dessen Typ im Feld „ analyzer_params “ an.
# Using built-in English analyzer
analyzer_params = {
    "type": "english"
}

# Applying analyzer config to target VARCHAR field in your collection schema
schema.add_field(
    field_name='text',
    datatype=DataType.VARCHAR,
    max_length=200,
    enable_analyzer=True,
    analyzer_params=analyzer_params,
)
Ausführliche Informationen zur Verwendung finden Sie unter „Volltextsuche“, „Textübereinstimmung“ oder „Phrasenübereinstimmung“.
Möglichkeit B: Erstellen eines benutzerdefinierten Analysators
Wenn die integrierten Optionen Ihren Anforderungen nicht entsprechen, können Sie einen benutzerdefinierten Analysator erstellen, indem Sie einen Tokenizer mit einer Reihe von Filtern kombinieren. Dadurch erhalten Sie die volle Kontrolle über die Textverarbeitungs-Pipeline.
Schritt 1: Wählen Sie den Tokenizer entsprechend der Sprache aus
Wählen Sie Ihren Tokenizer entsprechend der Hauptsprache Ihrer Inhalte aus:
Westliche Sprachen
Für Sprachen, in denen mit Leerzeichen getrennt wird, stehen Ihnen folgende Optionen zur Verfügung:
Tokenizer |
So funktioniert es |
Am besten geeignet für |
Beispiele |
|---|---|---|---|
Teilt Text anhand von Leerzeichen und Satzzeichen auf |
Allgemeiner Text, gemischte Zeichensetzung |
|
|
Teilt nur an Leerzeichen |
Vorverarbeiteter Inhalt, vom Benutzer formatierter Text |
|
Ostasiatische Sprachen
Sprachen, in denen Leerzeichen zwischen Wörtern nicht einheitlich verwendet werden, erfordern spezielle Tokenizer für eine korrekte Worttrennung:
Chinesisch
Tokenizer |
So funktioniert es |
Am besten geeignet für |
Beispiele |
|---|---|---|---|
Chinesische, auf einem Wörterbuch basierende Segmentierung mit intelligentem Algorithmus |
Empfohlen für chinesische Inhalte – kombiniert ein Wörterbuch mit intelligenten Algorithmen, die speziell für Chinesisch entwickelt wurden |
|
|
Reine, auf einem Wörterbuch basierende morphologische Analyse mit chinesischem Wörterbuch (cc-cedict) |
Im Vergleich zu |
|
Thai
Für die meisten thailändischen Texte verwenden Sie den integrierten thai Analysator. Verwenden Sie den eigenständigen thai Tokenizer nur, wenn Sie eine benutzerdefinierte Analysator-Pipeline erstellen müssen.
Tokenizer |
So funktioniert es |
Am besten geeignet für |
Beispiele |
|---|---|---|---|
Teilt thailändischen Text in Wort-Token auf und filtert Segmente heraus, die nur aus Leerzeichen und Satzzeichen bestehen |
Benutzerdefinierte Analysator-Pipelines für thailändischen oder gemischten thailändisch-englischen Text |
|
Japanisch und Koreanisch
Sprache |
Tokenizer |
Wörterbuchoptionen |
Am besten geeignet für |
Beispiele |
|---|---|---|---|---|
Japanisch |
ipadic (Allzweck), ipadic-neologd (moderne Begriffe), unidic (akademisch) |
Morphologische Analyse mit Behandlung von Eigennamen |
|
|
Koreanisch |
Koreanische morphologische Analyse |
|
Mehrsprachige oder unbekannte Sprachen
Für Inhalte, bei denen die Sprachen nicht vorhersehbar sind oder innerhalb von Dokumenten gemischt vorkommen:
Tokenizer |
So funktioniert es |
Am besten geeignet für |
Beispiele |
|---|---|---|---|
Unicode-fähige Tokenisierung (International Components for Unicode) |
Gemischte Schriftsysteme, unbekannte Sprachen oder wenn eine einfache Tokenisierung ausreicht |
|
Wann sollte icu verwendet werden:
Bei gemischten Sprachen, bei denen eine Sprachidentifizierung nicht praktikabel ist.
Sie möchten den Mehraufwand durch mehrsprachige Analysatoren oder den Sprachidentifikator vermeiden.
Der Inhalt hat eine Hauptsprache mit vereinzelten Fremdwörtern, die kaum zur Gesamtbedeutung beitragen (z. B. englischer Text mit vereinzelten Markennamen oder Fachbegriffen auf Japanisch oder Französisch).
Alternative Ansätze: Für eine präzisere Verarbeitung mehrsprachiger Inhalte sollten Sie den Einsatz von Mehrsprachenanalysatoren oder des Sprachidentifikators in Betracht ziehen. Weitere Informationen finden Sie unter „Mehrsprachenanalysatoren “ oder „Sprachidentifikator“.
Schritt 2: Fügen Sie Filter für eine höhere Präzision hinzu
Nachdem Sie Ihren Tokenizer ausgewählt haben, wenden Sie Filter an, die auf Ihren spezifischen Suchanforderungen und den Eigenschaften des Inhalts basieren.
Häufig verwendete Filter
Diese Filter sind für die meisten durch Leerzeichen getrennten Sprachkonfigurationen (Englisch, Französisch, Deutsch, Spanisch usw.) unverzichtbar und verbessern die Suchqualität erheblich:
Filter |
So funktioniert es |
Wann zu verwenden |
Beispiele |
|---|---|---|---|
Alle Token in Kleinbuchstaben umwandeln |
Universell – gilt für alle Sprachen mit Groß-/Kleinschreibung |
|
|
Wörter auf ihre Grundform reduzieren |
Sprachen mit Wortbeugung (Englisch, Französisch, Deutsch usw.) |
Für Englisch:
|
|
Entferne häufig vorkommende, bedeutungslose Wörter |
Die meisten Sprachen – besonders effektiv bei Sprachen mit Leerzeichen als Trennzeichen |
|
Bei ostasiatischen Sprachen (Chinesisch, Japanisch, Koreanisch usw.) sollten Sie sich stattdessen auf sprachspezifische Filter konzentrieren. Diese Sprachen verwenden in der Regel andere Ansätze zur Textverarbeitung und profitieren möglicherweise nicht wesentlich vom Stemming.
Filter zur Textnormalisierung
Diese Filter standardisieren Textvariationen, um die Konsistenz beim Abgleich zu verbessern:
Filter |
Funktionsweise |
Anwendungsfälle |
Beispiele |
|---|---|---|---|
Umwandlung von Zeichen mit Akzenten in ASCII-Entsprechungen |
Internationale Inhalte, nutzergenerierte Inhalte |
|
Token-Filterung
Steuern Sie anhand des Zeicheninhalts oder der Länge, welche Token beibehalten werden:
Filter |
So funktioniert es |
Anwendungsfälle |
Beispiele |
|---|---|---|---|
Einzelne Interpunktionszeichen entfernen |
Bereinigt die Ausgabe der Tokenizer |
|
|
Nur Buchstaben und Zahlen beibehalten |
Technische Inhalte, bereinigte Textverarbeitung |
|
|
Entferne Token außerhalb des angegebenen Längenbereichs |
Rauschen filtern (übermäßig lange Token) |
|
|
Benutzerdefinierte, musterbasierte Filterung |
Domänenspezifische Anforderungen an Token |
|
Sprachspezifische Filter
Diese Filter berücksichtigen spezifische Sprachmerkmale:
Filter |
Sprache |
Funktionsweise |
Beispiele |
|---|---|---|---|
Deutsch |
Teilt zusammengesetzte Wörter in durchsuchbare Bestandteile auf |
|
|
Chinesisch |
Behält chinesische Schriftzeichen + alphanumerische Zeichen bei |
|
|
Chinesisch |
Behält nur chinesische Schriftzeichen bei |
|
|
Chinesisch |
Gibt Pinyin-Tokenformen für chinesische Token aus |
|
Schritt 3: Kombinieren und implementieren
Um Ihren benutzerdefinierten Analysator zu erstellen, definieren Sie den Tokenizer und eine Liste von Filtern im Wörterbuch „ analyzer_params “. Die Filter werden in der Reihenfolge angewendet, in der sie aufgeführt sind.
# Example: A custom analyzer for technical content
analyzer_params = {
    "tokenizer": "whitespace",
    "filter": ["lowercase", "alphanumonly"]
}

# Applying analyzer config to target VARCHAR field in your collection schema
schema.add_field(
    field_name='text',
    datatype=DataType.VARCHAR,
    max_length=200,
    enable_analyzer=True,
    analyzer_params=analyzer_params,
)
Abschließend: Testen mit run_analyzer
Überprüfen Sie Ihre Konfiguration immer, bevor Sie sie auf eine Sammlung anwenden:
# Sample text to analyze
sample_text = "The Milvus vector database is built for scale!"

# Run analyzer with the defined configuration
result = client.run_analyzer(sample_text, analyzer_params)
print("Analyzer output:", result)
Häufige Probleme, die Sie überprüfen sollten:
Übermäßige Tokenisierung: Fachbegriffe werden falsch aufgeteilt
Unter-Tokenisierung: Phrasen werden nicht ordnungsgemäß getrennt
Fehlende Token: Wichtige Begriffe werden herausgefiltert
Ausführliche Informationen zur Verwendung finden Sie unter ` run_analyzer`.
Empfohlene Konfigurationen nach Anwendungsfall
Dieser Abschnitt enthält empfohlene Konfigurationen für Tokenizer und Filter für gängige Anwendungsfälle bei der Arbeit mit Analysatoren in Milvus. Wählen Sie die Kombination, die am besten zu Ihrem Inhaltstyp und Ihren Suchanforderungen passt.
Bevor Sie einen Analysator auf Ihre Sammlung anwenden, empfehlen wir Ihnen, run_analyzer , um die Leistung der Textanalyse zu testen und zu überprüfen.
Sprachen mit Akzenten (Französisch, Spanisch, Deutsch usw.)
Verwenden Sie einen „ standard “-Tokenizer mit Umwandlung in Kleinbuchstaben, sprachspezifischem Stemming und Stopwort-Entfernung. Diese Konfiguration funktioniert auch für andere europäische Sprachen, indem Sie die Parameter „ language “ und „ stop_words “ anpassen.
# French example
analyzer_params = {
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        "asciifolding",  # Handle accent marks
        {
            "type": "stemmer",
            "language": "french"
        },
        {
            "type": "stop",
            "stop_words": ["_french_"]
        }
    ]
}

# For other languages, modify the language parameter:
# "language": "spanish" for Spanish
# "language": "german" for German
# "stop_words": ["_spanish_"] or ["_german_"] accordingly
Englische Inhalte
Für die Verarbeitung englischer Texte mit umfassender Filterung. Sie können auch den integrierten english Analysator verwenden:
analyzer_params = {
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stemmer",
            "language": "english"
        },
        {
            "type": "stop",
            "stop_words": ["_english_"]
        }
    ]
}

# Equivalent built-in shortcut:
analyzer_params = {
    "type": "english"
}
Chinesische Inhalte
Verwenden Sie den Tokenizer „ jieba “ und wenden Sie einen Zeichenfilter an, um nur chinesische Schriftzeichen, lateinische Buchstaben und Ziffern beizubehalten.
analyzer_params = {
    "tokenizer": "jieba",
    "filter": ["cnalphanumonly"]
}

# Equivalent built-in shortcut:
analyzer_params = {
    "type": "chinese"
}
Bei vereinfachtem Chinesisch entfernt „ cnalphanumonly “ alle Token mit Ausnahme von chinesischen Schriftzeichen, alphanumerischem Text und Ziffern. Dadurch wird verhindert, dass Satzzeichen die Suchqualität beeinträchtigen.
Falls Nutzer chinesischen Text durch Eingabe von Pinyin suchen können, verwenden Sie einen benutzerdefinierten Analysator mit dem Tokenizer „ jieba “ und dem pinyin Filter anstelle des integrierten „ chinese “-Analysators.
analyzer_params = {
    "tokenizer": "jieba",
    "filter": ["pinyin"]
}
Japanische Inhalte
Verwenden Sie den Tokenizer „ lindera “ mit japanischem Wörterbuch und Filtern, um Satzzeichen zu entfernen und die Tokenlänge zu steuern:
analyzer_params = {
    "tokenizer": {
        "type": "lindera",
        "dict": "ipadic"  # Options: ipadic, ipadic-neologd, unidic
    },
    "filter": [
        "removepunct",  # Remove standalone punctuation
        {
            "type": "length",
            "min": 1,
            "max": 20
        }
    ]
}
Koreanische Inhalte
Ähnlich wie bei Japanisch verwenden Sie den „ lindera “-Tokenizer mit dem koreanischen Wörterbuch:
analyzer_params = {
    "tokenizer": {
        "type": "lindera",
        "dict": "ko-dic"
    },
    "filter": [
        "removepunct",
        {
            "type": "length",
            "min": 1,
            "max": 20
        }
    ]
}
Gemischte oder mehrsprachige Inhalte
Wenn Sie mit Inhalten arbeiten, die mehrere Sprachen umfassen oder unvorhersehbare Schriftsysteme verwenden, beginnen Sie mit dem „ icu “-Analysator. Dieser Unicode-fähige Analysator verarbeitet gemischte Schriftsysteme und Symbole effektiv.
Grundlegende mehrsprachige Konfiguration (ohne Stemming):
analyzer_params = {
    "tokenizer": "icu",
    "filter": ["lowercase", "asciifolding"]
}
Erweiterte mehrsprachige Verarbeitung:
Für eine bessere Kontrolle über das Token-Verhalten in verschiedenen Sprachen:
Verwenden Sie eine Konfiguration für mehrsprachige Analysatoren. Weitere Informationen finden Sie unter „Mehrsprachige Analysatoren“.
Implementieren Sie einen Sprachidentifikator in Ihren Inhalten. Weitere Informationen finden Sie unter „Sprachidentifikator“.
Integration mit Funktionen zur Textsuche
Nachdem Sie Ihren Analysator ausgewählt haben, können Sie ihn in die von Milvus bereitgestellten Funktionen zur Textsuche integrieren.
Volltextsuche
Analysatoren wirken sich durch die Erzeugung spärlicher Vektoren direkt auf die BM25-basierte Volltextsuche aus. Verwenden Sie denselben Analysator sowohl für die Indizierung als auch für die Abfrage, um eine konsistente Tokenisierung sicherzustellen. Sprachspezifische Analysatoren liefern im Allgemeinen bessere BM25-Bewertungen als generische. Details zur Implementierung finden Sie unter „Volltextsuche“.
Textabgleich
Textabgleich-Operationen führen auf der Grundlage der Ausgabe Ihres Analysators einen exakten Token-Abgleich zwischen Abfragen und indiziertem Inhalt durch. Details zur Implementierung finden Sie unter „Textabgleich“.
Phrasenabgleich
Der Phrasenabgleich erfordert eine konsistente Tokenisierung über mehrwortige Ausdrücke hinweg, um Phrasengrenzen und Bedeutung zu bewahren. Details zur Implementierung finden Sie unter „Phrasenabgleich“.
