

Обзор анализатора
В обработке текста анализатор является ключевым компонентом, преобразующим необработанный текст в структурированный формат, пригодный для поиска. Каждый анализатор, как правило, состоит из двух основных элементов: токенизатора и фильтра. Вместе они преобразуют входной текст в токены, очищают эти токены и готовят их для эффективного индексирования и поиска.
В Milvus анализаторы настраиваются при создании коллекции, когда вы добавляете поля типа « VARCHAR » в схему коллекции. Токены, сгенерированные анализатором, можно использовать для построения индекса для сопоставления по ключевым словам или преобразовать в разреженные вложения для полнотекстового поиска. Дополнительную информацию см. в разделах «Полнотекстовый поиск», «Сопоставление фраз» или «Сопоставление текста».
Использование анализаторов может повлиять на производительность:
Полнотекстовый поиск: при полнотекстовом поиске каналы DataNode и QueryNode обрабатывают данные медленнее, поскольку им приходится дожидаться завершения токенизации. В результате для новых данных требуется больше времени, прежде чем они станут доступны для поиска.
Сопоставление по ключевым словам: при сопоставлении по ключевым словам создание индекса также происходит медленнее, поскольку перед построением индекса необходимо завершить токенизацию.
Структура анализатора
Анализатор в Milvus состоит ровно из одного токенизатора и нуля или более фильтров.
Токенизатор: токенизатор разбивает входной текст на дискретные единицы, называемые токенами. Эти токены могут быть словами или фразами, в зависимости от типа токенизатора.
Фильтры: к токенам можно применять фильтры для их дальнейшей очистки, например, путем преобразования в нижний регистр или удаления общих слов.
Токенизаторы поддерживают только формат UTF-8. Поддержка других форматов будет добавлена в будущих версиях.
На приведенном ниже схеме рабочего процесса показано, как анализатор обрабатывает текст.
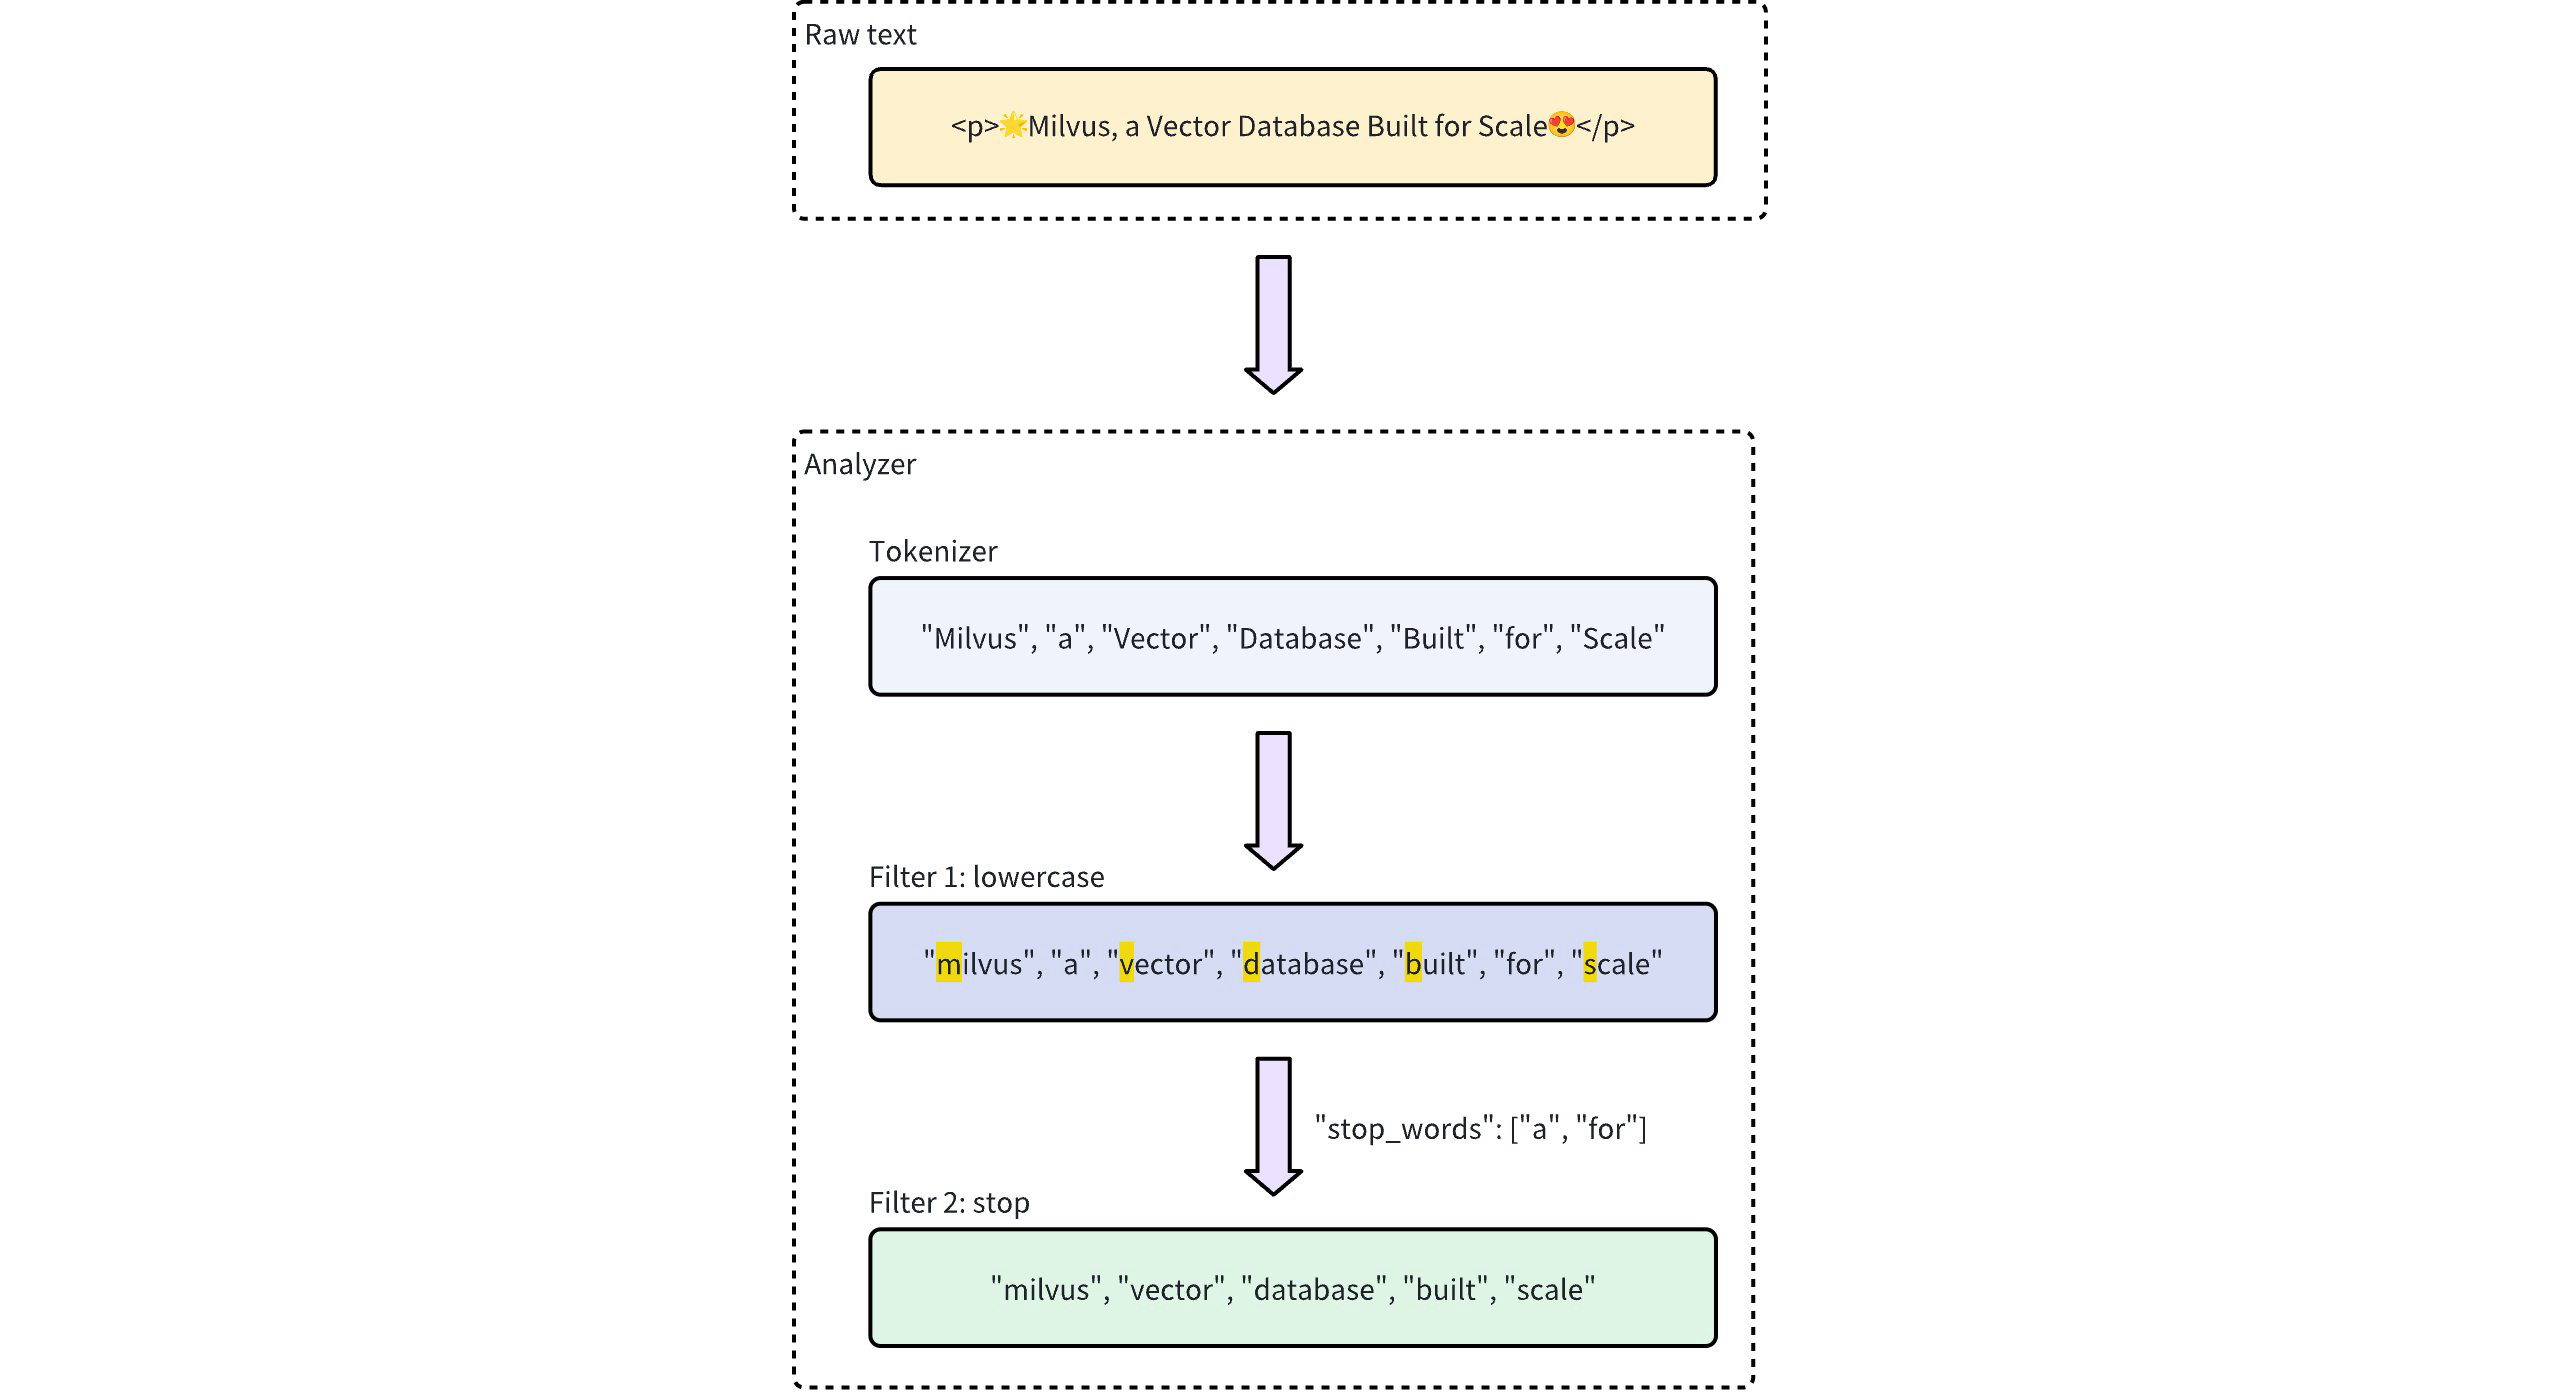 Схема работы анализатора
Типы анализаторов
Milvus предоставляет два типа анализаторов для удовлетворения различных потребностей в обработке текста:
Встроенный анализатор: это предопределенные конфигурации, которые позволяют решать типичные задачи обработки текста с минимальной настройкой. Встроенные анализаторы идеально подходят для универсального поиска, так как не требуют сложной настройки.
Пользовательский анализатор: для более сложных задач пользовательские анализаторы позволяют определять собственную конфигурацию, указывая как токенизатор, так и ноль или несколько фильтров. Такой уровень настройки особенно полезен для специализированных сценариев использования, где требуется точный контроль над обработкой текста.
- Если при создании коллекции не указаны настройки анализатора, Milvus по умолчанию использует для всей обработки текста анализатор «
standard». Подробности см. в разделе «Стандартный анализатор». - Для обеспечения оптимальной производительности поиска и запросов выбирайте анализатор, соответствующий языку ваших текстовых данных. Например, хотя анализатор «
standard» является универсальным, он может оказаться не лучшим выбором для языков с уникальными грамматическими структурами, таких как китайский, арабский, тайский, японский или корейский. В таких случаях рекомендуется использовать языкоспецифический анализатор, напримерchinese,arabic, илиthai, либо пользовательские анализаторы со специализированными токенизаторами (такими какlindera,icu), и фильтров, чтобы обеспечить точную токенизацию и более качественные результаты поиска.
Встроенный анализатор
Встроенные анализаторы в Milvus предварительно настроены с использованием определённых токенизаторов и фильтров, что позволяет использовать их сразу, без необходимости самостоятельного определения этих компонентов. Каждый встроенный анализатор служит шаблоном, включающим предустановленный токенизатор и фильтры, а также дополнительные параметры для настройки.
Например, чтобы использовать встроенный анализатор « standard », просто укажите его имя standard в качестве параметра type и, при желании, добавьте дополнительные настройки, характерные для этого типа анализатора, такие как stop_words:
analyzer_params = {
    "type": "standard", # Uses the standard built-in analyzer
    "stop_words": ["a", "an", "for"] # Defines a list of common words (stop words) to exclude from tokenization
}
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("type", "standard");
analyzerParams.put("stop_words", Arrays.asList("a", "an", "for"));
const analyzer_params = {
    "type": "standard", // Uses the standard built-in analyzer
    "stop_words": ["a", "an", "for"] // Defines a list of common words (stop words) to exclude from tokenization
};
analyzerParams := map[string]any{"type": "standard", "stop_words": []string{"a", "an", "for"}}
export analyzerParams='{
       "type": "standard",
       "stop_words": ["a", "an", "for"]
    }'
Чтобы проверить результат работы анализатора, используйте метод run_analyzer:
# Sample text to analyze
text = "An efficient system relies on a robust analyzer to correctly process text for various applications."

# Run analyzer
result = client.run_analyzer(
    text,
    analyzer_params
)
import io.milvus.v2.service.vector.request.RunAnalyzerReq;
import io.milvus.v2.service.vector.response.RunAnalyzerResp;

List<String> texts = new ArrayList<>();
texts.add("An efficient system relies on a robust analyzer to correctly process text for various applications.");

RunAnalyzerResp resp = client.runAnalyzer(RunAnalyzerReq.builder()
        .texts(texts)
        .analyzerParams(analyzerParams)
        .build());
List<RunAnalyzerResp.AnalyzerResult> results = resp.getResults();
// javascrip# Sample text to analyze
const text = "An efficient system relies on a robust analyzer to correctly process text for various applications."

// Run analyzer
const result = await client.run_analyzer({
    text,
    analyzer_params
});
import (
    "context"
    "encoding/json"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

bs, _ := json.Marshal(analyzerParams)
texts := []string{"An efficient system relies on a robust analyzer to correctly process text for various applications."}
option := milvusclient.NewRunAnalyzerOption(texts).
    WithAnalyzerParams(string(bs))

result, err := client.RunAnalyzer(ctx, option)
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
# restful
Результат будет следующим:
['efficient', 'system', 'relies', 'on', 'robust', 'analyzer', 'to', 'correctly', 'process', 'text', 'various', 'applications']
Это демонстрирует, что анализатор правильно токенизирует входной текст, отфильтровывая стоп-слова "a", "an" и "for", возвращая оставшиеся значимые токены.
Настройка встроенного анализатора standard, приведенная выше, эквивалентна настройке пользовательского анализатора со следующими параметрами, где опции tokenizer и filter явно определены для обеспечения аналогичной функциональности:
analyzer_params = {
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stop",
            "stop_words": ["a", "an", "for"]
        }
    ]
}
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("tokenizer", "standard");
analyzerParams.put("filter",
        Arrays.asList("lowercase",
                new HashMap<String, Object>() {{
                    put("type", "stop");
                    put("stop_words", Arrays.asList("a", "an", "for"));
                }}));
const analyzer_params = {
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stop",
            "stop_words": ["a", "an", "for"]
        }
    ]
};
analyzerParams = map[string]any{"tokenizer": "standard",
    "filter": []any{"lowercase", map[string]any{
        "type":       "stop",
        "stop_words": []string{"a", "an", "for"},
    }}}
export analyzerParams='{
       "type": "standard",
       "filter":  [
       "lowercase",
       {
            "type": "stop",
            "stop_words": ["a", "an", "for"]
       }
   ]
}'
Milvus предлагает следующие встроенные анализаторы, каждый из которых предназначен для конкретных задач обработки текста:
standard: Подходит для универсальной обработки текста с применением стандартной токенизации и фильтрации строчных букв.english: Оптимизирован для текстов на английском языке с поддержкой английских стоп-слов.chinese: Специализирован для обработки текстов на китайском языке, включая токенизацию, адаптированную к структурам китайского языка.arabic: Специализирован для арабского текста, с нормализацией арабского языка, нормализацией десятичных цифр, стеммингом арабских слов и удалением арабских стоп-слов.thai: Специализирован для текстов на тайском языке, с сегментацией слов на тайском, нормализацией десятичных цифр и удалением тайских стоп-слов.
Пользовательский анализатор
Для более сложной обработки текста пользовательские анализаторы в Milvus позволяют создавать индивидуальный конвейер обработки текста, задавая как токенизатор, так и фильтры. Такая настройка идеально подходит для специализированных задач, где требуется точный контроль.
Токенизатор
Токенизатор является обязательным компонентом пользовательского анализатора, который запускает конвейер анализатора, разбивая входной текст на дискретные единицы, или токены. Токенизация осуществляется по определённым правилам, таким как разделение по пробелам или знакам препинания, в зависимости от типа токенизатора. Этот процесс позволяет более точно и независимо обрабатывать каждое слово или фразу.
Например, токенизатор преобразует текст « "Vector Database Built for Scale" » в отдельные токены:
["Vector", "Database", "Built", "for", "Scale"]
Пример указания токенизатора:
analyzer_params = {
    "tokenizer": "whitespace",
}
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("tokenizer", "whitespace");
const analyzer_params = {
    "tokenizer": "whitespace",
};
analyzerParams = map[string]any{"tokenizer": "whitespace"}
export analyzerParams='{
       "type": "whitespace"
    }'
Фильтр
Фильтры — это опциональные компоненты, работающие с токенами, сгенерированными токенизатором, и преобразующие или уточняющие их по мере необходимости. Например, после применения фильтра « lowercase » к токенизированным терминам « ["Vector", "Database", "Built", "for", "Scale"] » результат может выглядеть следующим образом:
["vector", "database", "built", "for", "scale"]
Фильтры в пользовательском анализаторе могут быть как встроенными, так и пользовательскими, в зависимости от потребностей конфигурации.
Встроенные фильтры: предварительно настроены Milvus и требуют минимальной настройки. Вы можете использовать эти фильтры сразу после установки, указав их имена. Ниже перечислены встроенные фильтры, готовые к непосредственному использованию:
lowercase: Преобразует текст в нижний регистр, обеспечивая сопоставление без учета регистра. Подробности см. в разделе «Преобразование в нижний регистр».asciifolding: Преобразует символы, не входящие в ASCII, в их ASCII-эквиваленты, упрощая обработку многоязычного текста. Подробности см. в разделе «ASCII folding».alphanumonly: Сохраняет только алфавитно-цифровые символы, удаляя остальные. Подробности см. в разделе «Alphanumonly».cnalphanumonly: Удаляет лексемы, содержащие любые символы, кроме китайских иероглифов, английских букв или цифр. Подробности см. в разделе «Cnalphanumonly».cncharonly: Удаляет лексемы, содержащие любые символы, отличные от китайских иероглифов. Подробности см. в разделе «Cncharonly».pinyin: Добавляет формы токенов в пиньине для китайских токенов, что позволяет осуществлять сопоставление китайского текста на основе пиньиня. Подробности см. в разделе «Pinyin».
Пример использования встроенного фильтра:
analyzer_params = {
    "tokenizer": "standard", # Mandatory: Specifies tokenizer
    "filter": ["lowercase"], # Optional: Built-in filter that converts text to lowercase
}
Map<String, Object> analyzerParams = new HashMap<>(); analyzerParams.put("tokenizer", "standard"); analyzerParams.put("filter", Collections.singletonList("lowercase"));const analyzer_params = { "tokenizer": "standard", // Mandatory: Specifies tokenizer "filter": ["lowercase"], // Optional: Built-in filter that converts text to lowercase }analyzerParams = map[string]any{"tokenizer": "standard", "filter": []any{"lowercase"}}export analyzerParams='{ "type": "standard", "filter": ["lowercase"] }'Пользовательские фильтры: Пользовательские фильтры позволяют настраивать специализированные конфигурации. Вы можете определить пользовательский фильтр, выбрав допустимый тип фильтра (
filter.type) и добавив конкретные настройки для каждого типа фильтра. Примеры типов фильтров, поддерживающих настройку:stop: Удаляет указанные распространенные слова путем задания списка стоп-слов (например,"stop_words": ["of", "to"]). Подробности см. в разделе «Стоп-слова».length: Исключает лексемы на основе критериев длины, например, путем установки максимальной длины лексемы. Подробности см. в разделе «Length».stemmer: Преобразует слова в их корневые формы для более гибкого сопоставления. Подробности см. в разделе «Стеммер».
Пример настройки пользовательского фильтра:
analyzer_params = {
    "tokenizer": "standard", # Mandatory: Specifies tokenizer
    "filter": [
        {
            "type": "stop", # Specifies 'stop' as the filter type
            "stop_words": ["of", "to"], # Customizes stop words for this filter type
        }
    ]
}
Map<String, Object> analyzerParams = new HashMap<>(); analyzerParams.put("tokenizer", "standard"); analyzerParams.put("filter", Collections.singletonList(new HashMap<String, Object>() {{ put("type", "stop"); put("stop_words", Arrays.asList("a", "an", "for")); }}));const analyzer_params = { "tokenizer": "standard", // Mandatory: Specifies tokenizer "filter": [ { "type": "stop", // Specifies 'stop' as the filter type "stop_words": ["of", "to"], // Customizes stop words for this filter type } ] };analyzerParams = map[string]any{"tokenizer": "standard", "filter": []any{map[string]any{ "type": "stop", "stop_words": []string{"of", "to"}, }}}export analyzerParams='{ "type": "standard", "filter": [ { "type": "stop", "stop_words": ["a", "an", "for"] } ] }'
Пример использования
В этом примере вы создадите схему коллекции, включающую:
Векторное поле для вложений.
Два поля типа «
VARCHAR» для обработки текста:Одно поле использует встроенный анализатор.
В другом используется настраиваемый анализатор.
Прежде чем включить эти настройки в вашу коллекцию, вы проверите каждый анализатор с помощью метода ` run_analyzer `.
Шаг 1: Инициализация MilvusClient и создание схемы
Начните с настройки клиента Milvus и создания новой схемы.
from pymilvus import MilvusClient, DataType

# Set up a Milvus client
client = MilvusClient(uri="http://localhost:19530")

# Create a new schema
schema = client.create_schema(auto_id=True, enable_dynamic_field=False)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.v2.common.IndexParam;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

// Set up a Milvus client
ConnectConfig config = ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build();
MilvusClientV2 client = new MilvusClientV2(config);

// Create schema
CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .enableDynamicField(false)
        .build();
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

// Set up a Milvus client
const client = new MilvusClient("http://localhost:19530");
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

cli, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: "localhost:19530",
})
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
defer client.Close(ctx)

schema := entity.NewSchema().WithAutoID(true).WithDynamicFieldEnabled(false)
# restful
Шаг 2: Определение и проверка конфигураций анализаторов
Настройте и проверьте встроенный анализатор (
english):Настройка: Определите параметры встроенного анализатора английского языка.
Проверка: Используйте
run_analyzer, чтобы убедиться, что данная конфигурация обеспечивает ожидаемую токенизацию.
# Built-in analyzer configuration for English text processing
analyzer_params_built_in = {
    "type": "english"
}

# Verify built-in analyzer configuration
sample_text = "Milvus simplifies text analysis for search."
result = client.run_analyzer(sample_text, analyzer_params_built_in)
print("Built-in analyzer output:", result)

# Expected output:
# Built-in analyzer output: ['milvus', 'simplifi', 'text', 'analysi', 'search']
Map<String, Object> analyzerParamsBuiltin = new HashMap<>(); analyzerParamsBuiltin.put("type", "english"); List<String> texts = new ArrayList<>(); texts.add("Milvus simplifies text ana lysis for search."); RunAnalyzerResp resp = client.runAnalyzer(RunAnalyzerReq.builder() .texts(texts) .analyzerParams(analyzerParams) .build()); List<RunAnalyzerResp.AnalyzerResult> results = resp.getResults();// Use a built-in analyzer for VARCHAR field `title_en` const analyzerParamsBuiltIn = { type: "english", }; const sample_text = "Milvus simplifies text analysis for search."; const result = await client.run_analyzer({ text: sample_text, analyzer_params: analyzer_params_built_in });analyzerParams := map[string]any{"type": "english"} bs, _ := json.Marshal(analyzerParams) texts := []string{"Milvus simplifies text analysis for search."} option := milvusclient.NewRunAnalyzerOption(texts). WithAnalyzerParams(string(bs)) result, err := client.RunAnalyzer(ctx, option) if err != nil { fmt.Println(err.Error()) // handle error }# restfulНастройте и проверьте пользовательский анализатор:
Настройка: Определите пользовательский анализатор, использующий стандартный токенизатор вместе со встроенным фильтром преобразования в нижний регистр и пользовательскими фильтрами для длины токенов и стоп-слов.
Проверка: Воспользуйтесь
run_analyzer, чтобы убедиться, что пользовательская конфигурация обрабатывает текст в соответствии с замыслом.
# Custom analyzer configuration with a standard tokenizer and custom filters
analyzer_params_custom = {
    "tokenizer": "standard",
    "filter": [
        "lowercase",  # Built-in filter: convert tokens to lowercase
        {
            "type": "length",  # Custom filter: restrict token length
            "max": 40
        },
        {
            "type": "stop",  # Custom filter: remove specified stop words
            "stop_words": ["of", "for"]
        }
    ]
}

# Verify custom analyzer configuration
sample_text = "Milvus provides flexible, customizable analyzers for robust text processing."
result = client.run_analyzer(sample_text, analyzer_params_custom)
print("Custom analyzer output:", result)

# Expected output:
# Custom analyzer output: ['milvus', 'provides', 'flexible', 'customizable', 'analyzers', 'robust', 'text', 'processing']
// Configure a custom analyzer Map<String, Object> analyzerParams = new HashMap<>(); analyzerParams.put("tokenizer", "standard"); analyzerParams.put("filter", Arrays.asList("lowercase", new HashMap<String, Object>() {{ put("type", "length"); put("max", 40); }}, new HashMap<String, Object>() {{ put("type", "stop"); put("stop_words", Arrays.asList("of", "for")); }} ) ); List<String> texts = new ArrayList<>(); texts.add("Milvus provides flexible, customizable analyzers for robust text processing."); RunAnalyzerResp resp = client.runAnalyzer(RunAnalyzerReq.builder() .texts(texts) .analyzerParams(analyzerParams) .build()); List<RunAnalyzerResp.AnalyzerResult> results = resp.getResults();// Configure a custom analyzer for VARCHAR field `title` const analyzerParamsCustom = { tokenizer: "standard", filter: [ "lowercase", { type: "length", max: 40, }, { type: "stop", stop_words: ["of", "to"], }, ], }; const sample_text = "Milvus provides flexible, customizable analyzers for robust text processing."; const result = await client.run_analyzer({ text: sample_text, analyzer_params: analyzer_params_built_in });analyzerParams = map[string]any{"tokenizer": "standard", "filter": []any{"lowercase", map[string]any{ "type": "length", "max": 40, map[string]any{ "type": "stop", "stop_words": []string{"of", "to"}, }}} bs, _ := json.Marshal(analyzerParams) texts := []string{"Milvus provides flexible, customizable analyzers for robust text processing."} option := milvusclient.NewRunAnalyzerOption(texts). WithAnalyzerParams(string(bs)) result, err := client.RunAnalyzer(ctx, option) if err != nil { fmt.Println(err.Error()) // handle error }# curl
Шаг 3: Добавление полей в схему
Теперь, когда вы проверили настройки анализаторов, добавьте их в поля схемы:
# Add VARCHAR field 'title_en' using the built-in analyzer configuration
schema.add_field(
    field_name='title_en',
    datatype=DataType.VARCHAR,
    max_length=1000,
    enable_analyzer=True,
    analyzer_params=analyzer_params_built_in,
    enable_match=True,
)

# Add VARCHAR field 'title' using the custom analyzer configuration
schema.add_field(
    field_name='title',
    datatype=DataType.VARCHAR,
    max_length=1000,
    enable_analyzer=True,
    analyzer_params=analyzer_params_custom,
    enable_match=True,
)

# Add a vector field for embeddings
schema.add_field(field_name="embedding", datatype=DataType.FLOAT_VECTOR, dim=3)

# Add a primary key field
schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True)
schema.addField(AddFieldReq.builder()
        .fieldName("title")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .analyzerParams(analyzerParams)
        .enableMatch(true) // must enable this if you use TextMatch
        .build());

// Add vector field
schema.addField(AddFieldReq.builder()
        .fieldName("embedding")
        .dataType(DataType.FloatVector)
        .dimension(3)
        .build());
// Add primary field
schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());
// Create schema
const schema = {
  auto_id: true,
  fields: [
    {
      name: "id",
      type: DataType.INT64,
      is_primary: true,
    },
    {
      name: "title_en",
      data_type: DataType.VARCHAR,
      max_length: 1000,
      enable_analyzer: true,
      analyzer_params: analyzerParamsBuiltIn,
      enable_match: true,
    },
    {
      name: "title",
      data_type: DataType.VARCHAR,
      max_length: 1000,
      enable_analyzer: true,
      analyzer_params: analyzerParamsCustom,
      enable_match: true,
    },
    {
      name: "embedding",
      data_type: DataType.FLOAT_VECTOR,
      dim: 4,
    },
  ],
};
schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(true),
).WithField(entity.NewField().
    WithName("embedding").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(3),
).WithField(entity.NewField().
    WithName("title").
    WithDataType(entity.FieldTypeVarChar).
    WithMaxLength(1000).
    WithEnableAnalyzer(true).
    WithAnalyzerParams(analyzerParams).
    WithEnableMatch(true),
)
# restful
Шаг 4: Подготовка параметров индекса и создание коллекции
# Set up index parameters for the vector field
index_params = client.prepare_index_params()
index_params.add_index(field_name="embedding", metric_type="COSINE", index_type="AUTOINDEX")

# Create the collection with the defined schema and index parameters
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
// Set up index params for vector field
List<IndexParam> indexes = new ArrayList<>();
indexes.add(IndexParam.builder()
        .fieldName("embedding")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.COSINE)
        .build());

// Create collection with defined schema
CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
// Set up index params for vector field
const indexParams = [
  {
    name: "embedding",
    metric_type: "COSINE",
    index_type: "AUTOINDEX",
  },
];

// Create collection with defined schema
await client.createCollection({
  collection_name: "my_collection",
  schema: schema,
  index_params: indexParams,
});

console.log("Collection created successfully!");
idx := index.NewAutoIndex(index.MetricType(entity.COSINE))
indexOption := milvusclient.NewCreateIndexOption("my_collection", "embedding", idx)

err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
# restful
Что дальше
После настройки анализатора вы можете интегрировать его с функциями поиска по тексту, предоставляемыми Milvus. Подробнее:
