

Visão geral do analisador
No processamento de texto, um analisador é um componente crucial que converte texto bruto num formato estruturado e pesquisável. Cada analisador é normalmente composto por dois elementos principais: o tokenizador e o filtro. Em conjunto, transformam o texto de entrada em tokens, refinam esses tokens e preparam-nos para uma indexação e recuperação eficientes.
No Milvus, os analisadores são configurados durante a criação da coleção, quando se adicionam campos d VARCHAR a ao esquema da coleção. Os tokens produzidos por um analisador podem ser utilizados para construir um índice para correspondência de palavras-chave ou convertidos em embeddings esparsas para pesquisa de texto completo. Para mais informações, consulte Pesquisa de Texto Completo, Correspondência de Frases ou Correspondência de Texto.
A utilização de analisadores pode afetar o desempenho:
Pesquisa de texto completo: Na pesquisa de texto completo, os canais DataNode e QueryNode consomem dados mais lentamente, uma vez que têm de aguardar que a tokenização seja concluída. Consequentemente, os dados recém-ingestados demoram mais tempo a ficar disponíveis para pesquisa.
Correspondência de palavras-chave: No caso da correspondência de palavras-chave, a criação do índice também é mais lenta, uma vez que a tokenização tem de estar concluída antes de se poder criar um índice.
Anatomia de um analisador
Um analisador no Milvus consiste em exatamente um tokenizador e zero ou mais filtros.
Tokenizador: O tokenizador divide o texto de entrada em unidades discretas chamadas tokens. Estes tokens podem ser palavras ou frases, dependendo do tipo de tokenizador.
Filtros: Os filtros podem ser aplicados aos tokens para os refinar ainda mais, por exemplo, convertendo-os para minúsculas ou removendo palavras comuns.
Os tokenizadores suportam apenas o formato UTF-8. O suporte a outros formatos será adicionado em versões futuras.
O fluxo de trabalho abaixo mostra como um analisador processa o texto.
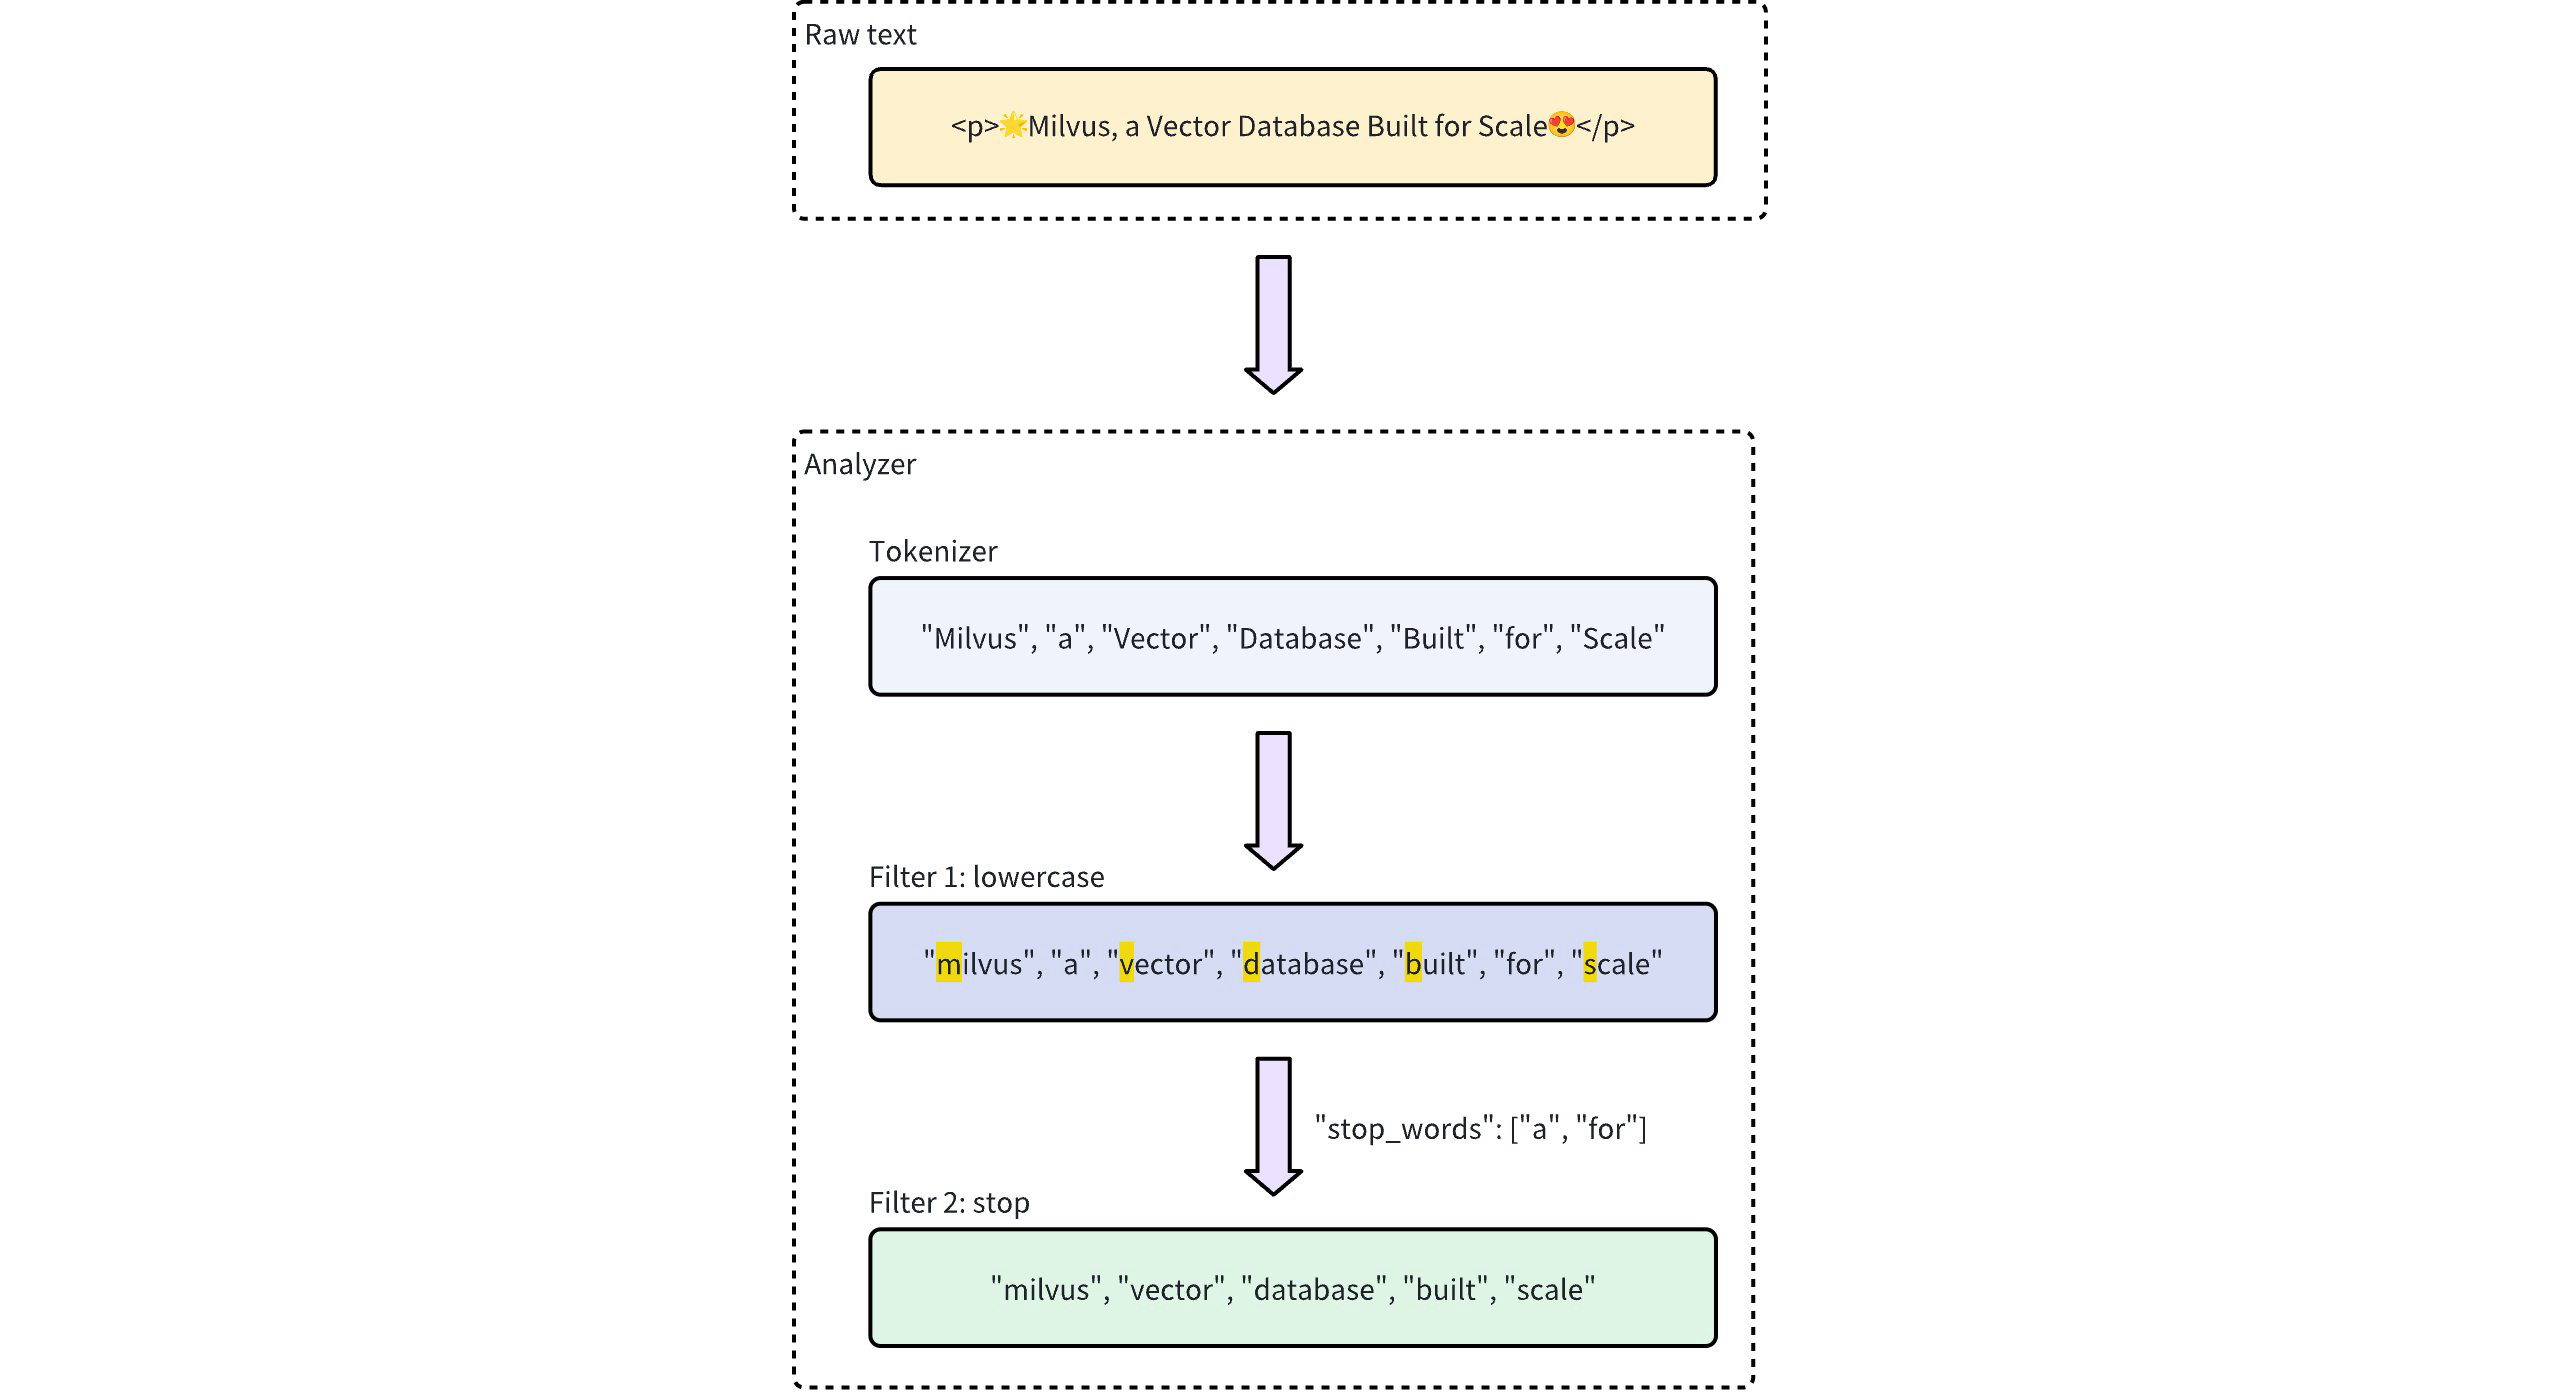 Fluxo de trabalho do processo do analisador
Tipos de analisadores
O Milvus disponibiliza dois tipos de analisadores para responder a diferentes necessidades de processamento de texto:
Analisador integrado: Trata-se de configurações predefinidas que abrangem tarefas comuns de processamento de texto com uma configuração mínima. Os analisadores integrados são ideais para pesquisas de uso geral, uma vez que não requerem uma configuração complexa.
Analisador personalizado: para requisitos mais avançados, os analisadores personalizados permitem-lhe definir a sua própria configuração, especificando tanto o tokenizador como zero ou mais filtros. Este nível de personalização é especialmente útil para casos de utilização especializados, em que é necessário um controlo preciso sobre o processamento de texto.
- Se omitir as configurações do analisador durante a criação da coleção, o Milvus utiliza, por predefinição, o analisador «
standard» para todo o processamento de texto. Para mais detalhes, consulte «Analisador Padrão». - Para um desempenho ideal de pesquisa e consulta, escolha um analisador que corresponda ao idioma dos seus dados de texto. Por exemplo, embora o analisador «
standard» seja versátil, pode não ser a melhor escolha para idiomas com estruturas gramaticais únicas, como o chinês, o árabe, o tailandês, o japonês ou o coreano. Nesses casos, utilize um analisador específico para o idioma, comochinese,arabic, outhai, ou analisadores personalizados com tokenizadores especializados (comolindera,icu) e filtros é altamente recomendado para garantir uma tokenização precisa e melhores resultados de pesquisa.
Analisador integrado
Os analisadores integrados no Milvus vêm pré-configurados com tokenizadores e filtros específicos, permitindo-lhe utilizá-los imediatamente sem necessidade de definir esses componentes. Cada analisador integrado funciona como um modelo que inclui um tokenizador e filtros predefinidos, com parâmetros opcionais para personalização.
Por exemplo, para utilizar o analisador integrado « standard », basta especificar o seu nome « standard » como « type » e, opcionalmente, incluir configurações adicionais específicas para este tipo de analisador, tais como « stop_words »:
analyzer_params = {
    "type": "standard", # Uses the standard built-in analyzer
    "stop_words": ["a", "an", "for"] # Defines a list of common words (stop words) to exclude from tokenization
}
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("type", "standard");
analyzerParams.put("stop_words", Arrays.asList("a", "an", "for"));
const analyzer_params = {
    "type": "standard", // Uses the standard built-in analyzer
    "stop_words": ["a", "an", "for"] // Defines a list of common words (stop words) to exclude from tokenization
};
analyzerParams := map[string]any{"type": "standard", "stop_words": []string{"a", "an", "for"}}
export analyzerParams='{
       "type": "standard",
       "stop_words": ["a", "an", "for"]
    }'
Para verificar o resultado da execução de um analisador, utilize o método run_analyzer:
# Sample text to analyze
text = "An efficient system relies on a robust analyzer to correctly process text for various applications."

# Run analyzer
result = client.run_analyzer(
    text,
    analyzer_params
)
import io.milvus.v2.service.vector.request.RunAnalyzerReq;
import io.milvus.v2.service.vector.response.RunAnalyzerResp;

List<String> texts = new ArrayList<>();
texts.add("An efficient system relies on a robust analyzer to correctly process text for various applications.");

RunAnalyzerResp resp = client.runAnalyzer(RunAnalyzerReq.builder()
        .texts(texts)
        .analyzerParams(analyzerParams)
        .build());
List<RunAnalyzerResp.AnalyzerResult> results = resp.getResults();
// javascrip# Sample text to analyze
const text = "An efficient system relies on a robust analyzer to correctly process text for various applications."

// Run analyzer
const result = await client.run_analyzer({
    text,
    analyzer_params
});
import (
    "context"
    "encoding/json"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

bs, _ := json.Marshal(analyzerParams)
texts := []string{"An efficient system relies on a robust analyzer to correctly process text for various applications."}
option := milvusclient.NewRunAnalyzerOption(texts).
    WithAnalyzerParams(string(bs))

result, err := client.RunAnalyzer(ctx, option)
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
# restful
O resultado será:
['efficient', 'system', 'relies', 'on', 'robust', 'analyzer', 'to', 'correctly', 'process', 'text', 'various', 'applications']
Isto demonstra que o analisador tokeniza corretamente o texto de entrada, filtrando as palavras de paragem "a", "an" e "for", ao mesmo tempo que devolve os tokens significativos restantes.
A configuração do analisador incorporado « standard » acima é equivalente à configuração de um analisador personalizado com os seguintes parâmetros, em que as opções « tokenizer » e « filter » são explicitamente definidas para obter uma funcionalidade semelhante:
analyzer_params = {
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stop",
            "stop_words": ["a", "an", "for"]
        }
    ]
}
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("tokenizer", "standard");
analyzerParams.put("filter",
        Arrays.asList("lowercase",
                new HashMap<String, Object>() {{
                    put("type", "stop");
                    put("stop_words", Arrays.asList("a", "an", "for"));
                }}));
const analyzer_params = {
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stop",
            "stop_words": ["a", "an", "for"]
        }
    ]
};
analyzerParams = map[string]any{"tokenizer": "standard",
    "filter": []any{"lowercase", map[string]any{
        "type":       "stop",
        "stop_words": []string{"a", "an", "for"},
    }}}
export analyzerParams='{
       "type": "standard",
       "filter":  [
       "lowercase",
       {
            "type": "stop",
            "stop_words": ["a", "an", "for"]
       }
   ]
}'
O Milvus oferece os seguintes analisadores integrados, cada um concebido para necessidades específicas de processamento de texto:
standard: Adequado para o processamento de texto de uso geral, aplicando tokenização padrão e filtragem de minúsculas.english: Otimizado para texto em inglês, com suporte para palavras de preenchimento em inglês.chinese: Especializado no processamento de texto em chinês, incluindo tokenização adaptada às estruturas da língua chinesa.arabic: Especializado em texto árabe, com normalização árabe, normalização de dígitos decimais, derivação de palavras em árabe e remoção de palavras vazias em árabe.thai: Especializado em texto tailandês, com segmentação de palavras tailandesas, normalização de dígitos decimais e remoção de palavras-vazio tailandesas.
Analisador personalizado
Para um processamento de texto mais avançado, os analisadores personalizados no Milvus permitem-lhe construir um pipeline de tratamento de texto à medida, especificando tanto um tokenizador como filtros. Esta configuração é ideal para casos de utilização especializados em que é necessário um controlo preciso.
Tokenizador
O tokenizador é um componente obrigatório para um analisador personalizado, que inicia o fluxo de trabalho do analisador ao dividir o texto de entrada em unidades discretas ou tokens. A tokenização segue regras específicas, tais como a divisão por espaços em branco ou pontuação, dependendo do tipo de tokenizador. Este processo permite um tratamento mais preciso e independente de cada palavra ou frase.
Por exemplo, um tokenizador converteria o texto « "Vector Database Built for Scale" » em tokens separados:
["Vector", "Database", "Built", "for", "Scale"]
Exemplo de especificação de um tokenizador:
analyzer_params = {
    "tokenizer": "whitespace",
}
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("tokenizer", "whitespace");
const analyzer_params = {
    "tokenizer": "whitespace",
};
analyzerParams = map[string]any{"tokenizer": "whitespace"}
export analyzerParams='{
       "type": "whitespace"
    }'
Filtro
Os filtros são componentes opcionais que atuam sobre os tokens produzidos pelo tokenizador, transformando-os ou refinando-os conforme necessário. Por exemplo, após aplicar um filtro « lowercase » aos termos tokenizados « ["Vector", "Database", "Built", "for", "Scale"] », o resultado poderá ser:
["vector", "database", "built", "for", "scale"]
Os filtros num analisador personalizado podem ser integrados ou personalizados, dependendo das necessidades de configuração.
Filtros integrados: pré-configurados pelo Milvus, exigindo uma configuração mínima. Pode utilizar estes filtros imediatamente, bastando especificar os seus nomes. Os filtros abaixo estão integrados para utilização direta:
lowercase: Converte o texto para minúsculas, garantindo uma correspondência que não distingue maiúsculas de minúsculas. Para mais detalhes, consulte «Lowercase».asciifolding: Converte caracteres não ASCII nos seus equivalentes ASCII, simplificando o tratamento de texto multilingue. Para mais detalhes, consulte «ASCII folding».alphanumonly: Mantém apenas os caracteres alfanuméricos, removendo os restantes. Para mais detalhes, consulte «Alphanumonly».cnalphanumonly: Remove tokens que contenham quaisquer caracteres que não sejam caracteres chineses, letras inglesas ou algarismos. Para mais detalhes, consulte «Cnalphanumonly».cncharonly: Remove tokens que contenham quaisquer caracteres não chineses. Para mais detalhes, consulte Cncharonly.pinyin: Adiciona formas de tokens em pinyin aos tokens chineses, permitindo a correspondência baseada em pinyin para texto em chinês. Para mais detalhes, consulte Pinyin.
Exemplo de utilização de um filtro integrado:
analyzer_params = {
    "tokenizer": "standard", # Mandatory: Specifies tokenizer
    "filter": ["lowercase"], # Optional: Built-in filter that converts text to lowercase
}
Map<String, Object> analyzerParams = new HashMap<>(); analyzerParams.put("tokenizer", "standard"); analyzerParams.put("filter", Collections.singletonList("lowercase"));const analyzer_params = { "tokenizer": "standard", // Mandatory: Specifies tokenizer "filter": ["lowercase"], // Optional: Built-in filter that converts text to lowercase }analyzerParams = map[string]any{"tokenizer": "standard", "filter": []any{"lowercase"}}export analyzerParams='{ "type": "standard", "filter": ["lowercase"] }'Filtros personalizados: Os filtros personalizados permitem configurações especializadas. Pode definir um filtro personalizado escolhendo um tipo de filtro válido (
filter.type) e adicionando definições específicas para cada tipo de filtro. Exemplos de tipos de filtro que suportam personalização:stop: Remove palavras comuns especificadas através da definição de uma lista de palavras de exclusão (por exemplo,"stop_words": ["of", "to"]). Para mais detalhes, consulte «Stop».length: Exclui tokens com base em critérios de comprimento, como a definição de um comprimento máximo para os tokens. Para mais detalhes, consulte «Comprimento».stemmer: Reduz as palavras às suas formas radicais para uma correspondência mais flexível. Para mais detalhes, consulte «Stemmer».
Exemplo de configuração de um filtro personalizado:
analyzer_params = {
    "tokenizer": "standard", # Mandatory: Specifies tokenizer
    "filter": [
        {
            "type": "stop", # Specifies 'stop' as the filter type
            "stop_words": ["of", "to"], # Customizes stop words for this filter type
        }
    ]
}
Map<String, Object> analyzerParams = new HashMap<>(); analyzerParams.put("tokenizer", "standard"); analyzerParams.put("filter", Collections.singletonList(new HashMap<String, Object>() {{ put("type", "stop"); put("stop_words", Arrays.asList("a", "an", "for")); }}));const analyzer_params = { "tokenizer": "standard", // Mandatory: Specifies tokenizer "filter": [ { "type": "stop", // Specifies 'stop' as the filter type "stop_words": ["of", "to"], // Customizes stop words for this filter type } ] };analyzerParams = map[string]any{"tokenizer": "standard", "filter": []any{map[string]any{ "type": "stop", "stop_words": []string{"of", "to"}, }}}export analyzerParams='{ "type": "standard", "filter": [ { "type": "stop", "stop_words": ["a", "an", "for"] } ] }'
Exemplo de utilização
Neste exemplo, irá criar um esquema de coleção que inclui:
Um campo vetorial para embeddings.
Dois campos «
VARCHAR» para processamento de texto:Um campo utiliza um analisador integrado.
O outro utiliza um analisador personalizado.
Antes de incorporar estas configurações na sua coleção, irá verificar cada analisador utilizando o método ` run_analyzer `.
Passo 1: Inicializar o MilvusClient e criar um esquema
Comece por configurar o cliente Milvus e criar um novo esquema.
from pymilvus import MilvusClient, DataType

# Set up a Milvus client
client = MilvusClient(uri="http://localhost:19530")

# Create a new schema
schema = client.create_schema(auto_id=True, enable_dynamic_field=False)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.v2.common.IndexParam;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

// Set up a Milvus client
ConnectConfig config = ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build();
MilvusClientV2 client = new MilvusClientV2(config);

// Create schema
CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .enableDynamicField(false)
        .build();
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

// Set up a Milvus client
const client = new MilvusClient("http://localhost:19530");
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

cli, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: "localhost:19530",
})
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
defer client.Close(ctx)

schema := entity.NewSchema().WithAutoID(true).WithDynamicFieldEnabled(false)
# restful
Passo 2: Definir e verificar as configurações do analisador
Configure e verifique um analisador integrado (
english):Configuração: Defina os parâmetros do analisador para o analisador de inglês integrado.
Verificação: Utilize
run_analyzerpara verificar se a configuração produz a tokenização esperada.
# Built-in analyzer configuration for English text processing
analyzer_params_built_in = {
    "type": "english"
}

# Verify built-in analyzer configuration
sample_text = "Milvus simplifies text analysis for search."
result = client.run_analyzer(sample_text, analyzer_params_built_in)
print("Built-in analyzer output:", result)

# Expected output:
# Built-in analyzer output: ['milvus', 'simplifi', 'text', 'analysi', 'search']
Map<String, Object> analyzerParamsBuiltin = new HashMap<>(); analyzerParamsBuiltin.put("type", "english"); List<String> texts = new ArrayList<>(); texts.add("Milvus simplifies text ana lysis for search."); RunAnalyzerResp resp = client.runAnalyzer(RunAnalyzerReq.builder() .texts(texts) .analyzerParams(analyzerParams) .build()); List<RunAnalyzerResp.AnalyzerResult> results = resp.getResults();// Use a built-in analyzer for VARCHAR field `title_en` const analyzerParamsBuiltIn = { type: "english", }; const sample_text = "Milvus simplifies text analysis for search."; const result = await client.run_analyzer({ text: sample_text, analyzer_params: analyzer_params_built_in });analyzerParams := map[string]any{"type": "english"} bs, _ := json.Marshal(analyzerParams) texts := []string{"Milvus simplifies text analysis for search."} option := milvusclient.NewRunAnalyzerOption(texts). WithAnalyzerParams(string(bs)) result, err := client.RunAnalyzer(ctx, option) if err != nil { fmt.Println(err.Error()) // handle error }# restfulConfigure e verifique um analisador personalizado:
Configuração: Defina um analisador personalizado que utilize um tokenizador padrão, juntamente com um filtro de minúsculas integrado e filtros personalizados para o comprimento dos tokens e palavras de paragem.
Verificação: Utilize
run_analyzerpara garantir que a configuração personalizada processa o texto conforme pretendido.
# Custom analyzer configuration with a standard tokenizer and custom filters
analyzer_params_custom = {
    "tokenizer": "standard",
    "filter": [
        "lowercase",  # Built-in filter: convert tokens to lowercase
        {
            "type": "length",  # Custom filter: restrict token length
            "max": 40
        },
        {
            "type": "stop",  # Custom filter: remove specified stop words
            "stop_words": ["of", "for"]
        }
    ]
}

# Verify custom analyzer configuration
sample_text = "Milvus provides flexible, customizable analyzers for robust text processing."
result = client.run_analyzer(sample_text, analyzer_params_custom)
print("Custom analyzer output:", result)

# Expected output:
# Custom analyzer output: ['milvus', 'provides', 'flexible', 'customizable', 'analyzers', 'robust', 'text', 'processing']
// Configure a custom analyzer Map<String, Object> analyzerParams = new HashMap<>(); analyzerParams.put("tokenizer", "standard"); analyzerParams.put("filter", Arrays.asList("lowercase", new HashMap<String, Object>() {{ put("type", "length"); put("max", 40); }}, new HashMap<String, Object>() {{ put("type", "stop"); put("stop_words", Arrays.asList("of", "for")); }} ) ); List<String> texts = new ArrayList<>(); texts.add("Milvus provides flexible, customizable analyzers for robust text processing."); RunAnalyzerResp resp = client.runAnalyzer(RunAnalyzerReq.builder() .texts(texts) .analyzerParams(analyzerParams) .build()); List<RunAnalyzerResp.AnalyzerResult> results = resp.getResults();// Configure a custom analyzer for VARCHAR field `title` const analyzerParamsCustom = { tokenizer: "standard", filter: [ "lowercase", { type: "length", max: 40, }, { type: "stop", stop_words: ["of", "to"], }, ], }; const sample_text = "Milvus provides flexible, customizable analyzers for robust text processing."; const result = await client.run_analyzer({ text: sample_text, analyzer_params: analyzer_params_built_in });analyzerParams = map[string]any{"tokenizer": "standard", "filter": []any{"lowercase", map[string]any{ "type": "length", "max": 40, map[string]any{ "type": "stop", "stop_words": []string{"of", "to"}, }}} bs, _ := json.Marshal(analyzerParams) texts := []string{"Milvus provides flexible, customizable analyzers for robust text processing."} option := milvusclient.NewRunAnalyzerOption(texts). WithAnalyzerParams(string(bs)) result, err := client.RunAnalyzer(ctx, option) if err != nil { fmt.Println(err.Error()) // handle error }# curl
Passo 3: Adicionar campos ao esquema
Agora que verificou as configurações do seu analisador, adicione-as aos campos do seu esquema:
# Add VARCHAR field 'title_en' using the built-in analyzer configuration
schema.add_field(
    field_name='title_en',
    datatype=DataType.VARCHAR,
    max_length=1000,
    enable_analyzer=True,
    analyzer_params=analyzer_params_built_in,
    enable_match=True,
)

# Add VARCHAR field 'title' using the custom analyzer configuration
schema.add_field(
    field_name='title',
    datatype=DataType.VARCHAR,
    max_length=1000,
    enable_analyzer=True,
    analyzer_params=analyzer_params_custom,
    enable_match=True,
)

# Add a vector field for embeddings
schema.add_field(field_name="embedding", datatype=DataType.FLOAT_VECTOR, dim=3)

# Add a primary key field
schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True)
schema.addField(AddFieldReq.builder()
        .fieldName("title")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .analyzerParams(analyzerParams)
        .enableMatch(true) // must enable this if you use TextMatch
        .build());

// Add vector field
schema.addField(AddFieldReq.builder()
        .fieldName("embedding")
        .dataType(DataType.FloatVector)
        .dimension(3)
        .build());
// Add primary field
schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());
// Create schema
const schema = {
  auto_id: true,
  fields: [
    {
      name: "id",
      type: DataType.INT64,
      is_primary: true,
    },
    {
      name: "title_en",
      data_type: DataType.VARCHAR,
      max_length: 1000,
      enable_analyzer: true,
      analyzer_params: analyzerParamsBuiltIn,
      enable_match: true,
    },
    {
      name: "title",
      data_type: DataType.VARCHAR,
      max_length: 1000,
      enable_analyzer: true,
      analyzer_params: analyzerParamsCustom,
      enable_match: true,
    },
    {
      name: "embedding",
      data_type: DataType.FLOAT_VECTOR,
      dim: 4,
    },
  ],
};
schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(true),
).WithField(entity.NewField().
    WithName("embedding").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(3),
).WithField(entity.NewField().
    WithName("title").
    WithDataType(entity.FieldTypeVarChar).
    WithMaxLength(1000).
    WithEnableAnalyzer(true).
    WithAnalyzerParams(analyzerParams).
    WithEnableMatch(true),
)
# restful
Passo 4: Preparar os parâmetros de indexação e criar a coleção
# Set up index parameters for the vector field
index_params = client.prepare_index_params()
index_params.add_index(field_name="embedding", metric_type="COSINE", index_type="AUTOINDEX")

# Create the collection with the defined schema and index parameters
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
// Set up index params for vector field
List<IndexParam> indexes = new ArrayList<>();
indexes.add(IndexParam.builder()
        .fieldName("embedding")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.COSINE)
        .build());

// Create collection with defined schema
CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
// Set up index params for vector field
const indexParams = [
  {
    name: "embedding",
    metric_type: "COSINE",
    index_type: "AUTOINDEX",
  },
];

// Create collection with defined schema
await client.createCollection({
  collection_name: "my_collection",
  schema: schema,
  index_params: indexParams,
});

console.log("Collection created successfully!");
idx := index.NewAutoIndex(index.MetricType(entity.COSINE))
indexOption := milvusclient.NewCreateIndexOption("my_collection", "embedding", idx)

err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
# restful
Próximos passos
Depois de configurar um analisador, pode integrar-se com as funcionalidades de recuperação de texto fornecidas pelo Milvus. Para mais detalhes:
