

البحث الهجين متعدد المحاور
في العديد من التطبيقات، يمكن البحث عن كائن باستخدام مجموعة غنية من المعلومات مثل العنوان والوصف، أو باستخدام طرق متعددة مثل النص والصور والصوت. على سبيل المثال، يجب البحث عن تغريدة تحتوي على نص وصورة إذا كان النص أو الصورة يتطابق مع دلالة استعلام البحث. يعزز البحث الهجين تجربة البحث من خلال الجمع بين عمليات البحث عبر هذه المجالات المتنوعة. يدعم Milvus ذلك من خلال السماح بالبحث في حقول متجهات متعددة، وإجراء عدة عمليات بحث تقريبية لأقرب جار (ANN) في وقت واحد. يُعد البحث الهجين متعدد المتجهات مفيدًا بشكل خاص إذا كنت ترغب في البحث عن النصوص والصور معًا، أو عن حقول نصية متعددة تصف نفس الكائن، أو عن متجهات كثيفة ومتفرقة لتحسين جودة البحث.
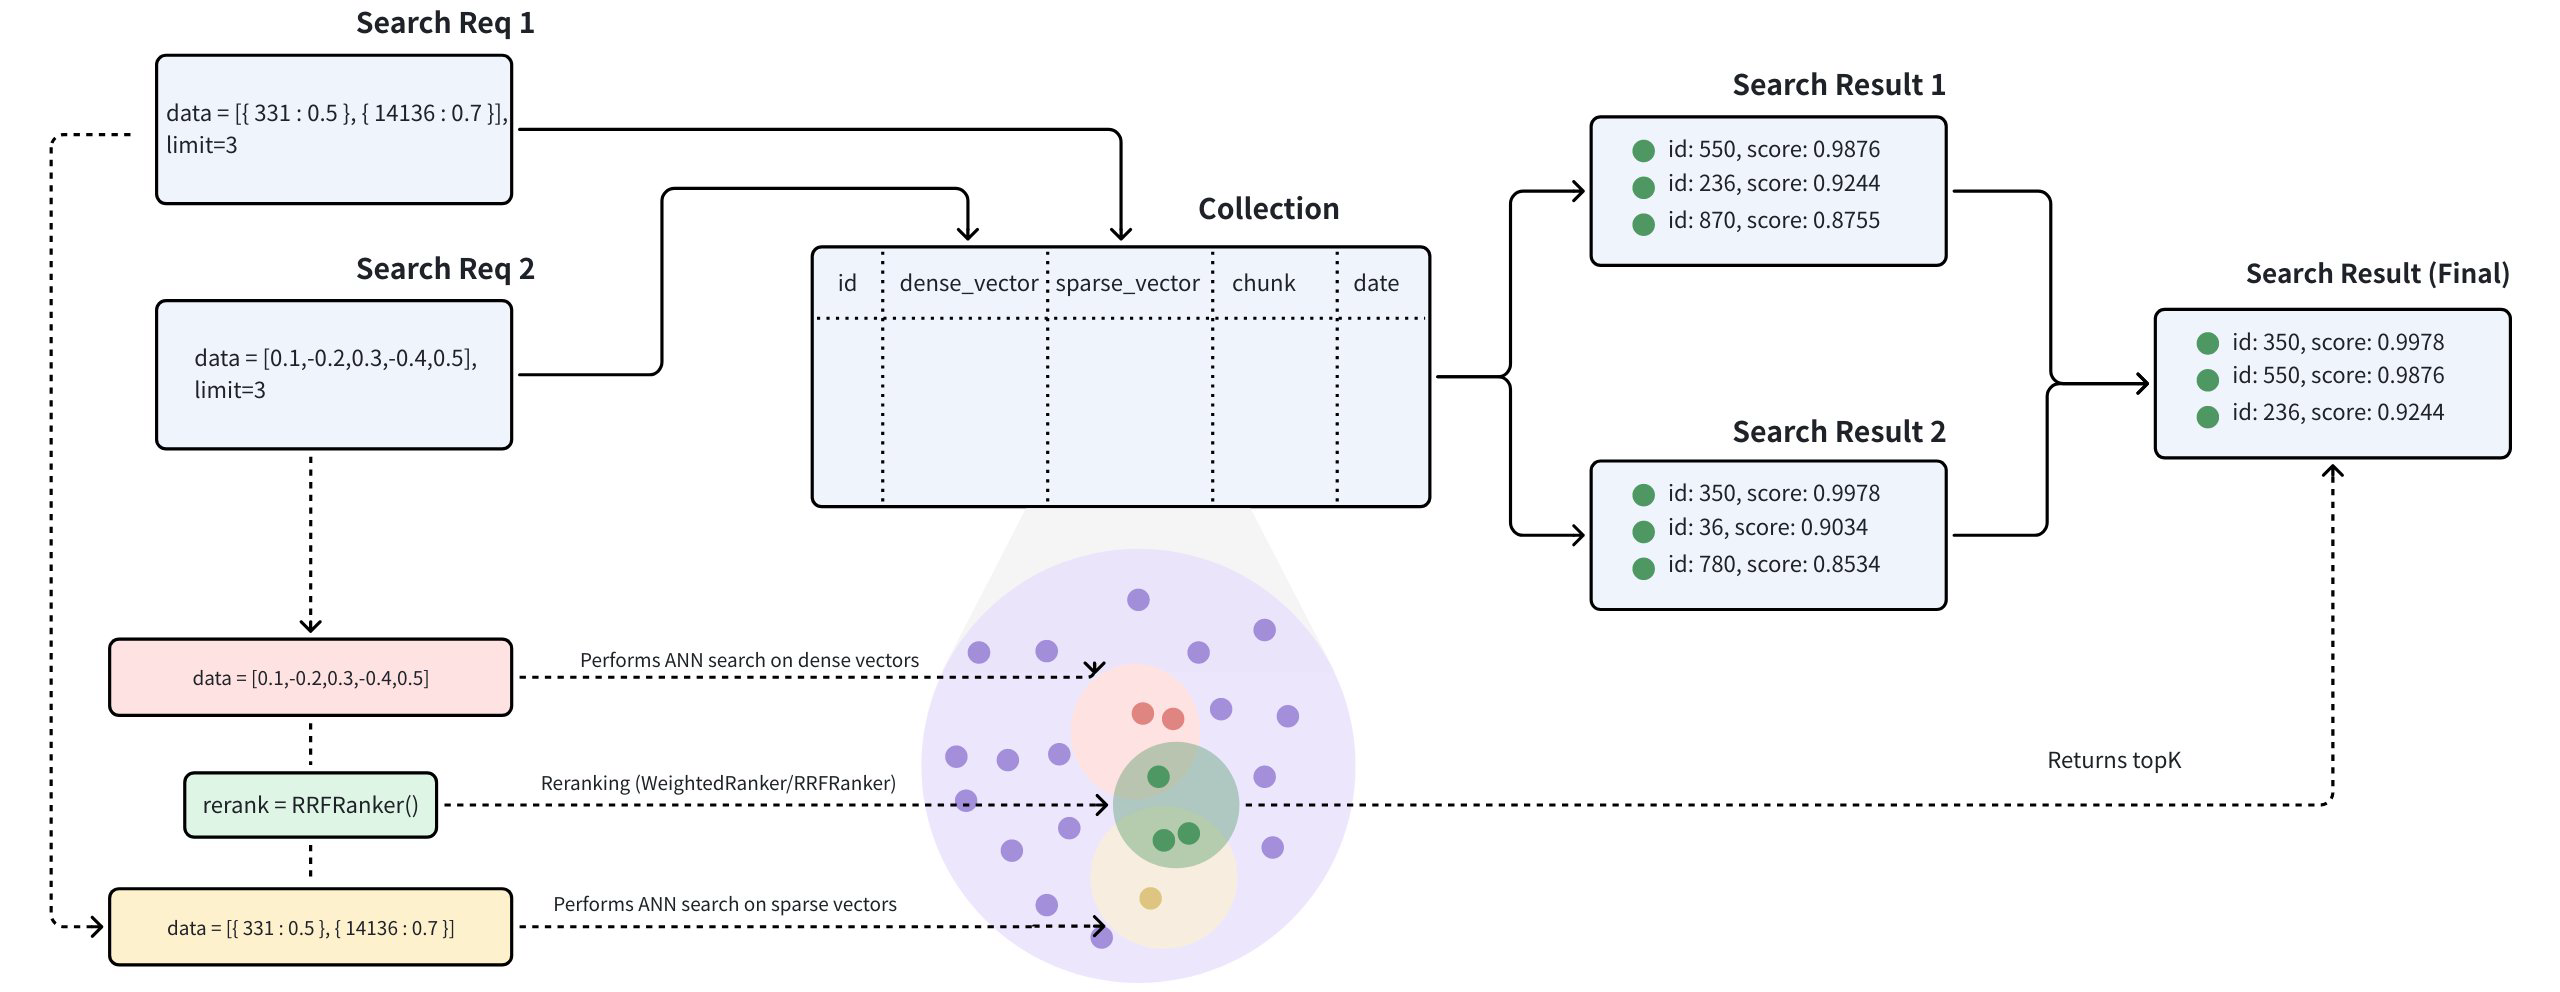 سير عمل البحث الهجين
يدمج البحث الهجين متعدد المتجهات طرق بحث مختلفة أو يمتد ليشمل التضمينات من طرق عرض متنوعة:
البحث بالمتجهات المتفرقة والكثيفة: تعد المتجهات الكثيفة ممتازة لالتقاط العلاقات الدلالية، في حين أن المتجهات المتفرقة فعالة للغاية في المطابقة الدقيقة للكلمات المفتاحية. يجمع البحث الهجين بين هذه الأساليب لتوفير فهم مفاهيمي واسع وملاءمة دقيقة للمصطلحات، مما يؤدي إلى تحسين نتائج البحث. من خلال الاستفادة من نقاط القوة في كل طريقة، يتغلب البحث الهجين على قيود الأساليب الفردية، ويقدم أداءً أفضل للاستعلامات المعقدة. إليك دليل أكثر تفصيلاً حول الاسترجاع الهجين الذي يجمع بين البحث الدلالي والبحث عن النص الكامل.
البحث المتعدد الوسائط باستخدام المتجهات: يُعد البحث المتعدد الوسائط باستخدام المتجهات تقنية قوية تتيح لك البحث عبر أنواع مختلفة من البيانات، بما في ذلك النصوص والصور والمواد الصوتية وغيرها. وتتمثل الميزة الرئيسية لهذا النهج في قدرته على توحيد الوسائط المختلفة في تجربة بحث سلسة ومتماسكة. على سبيل المثال، في البحث عن المنتجات، قد يقوم المستخدم بإدخال استعلام نصي للعثور على المنتجات الموصوفة بالنص والصور معًا. ومن خلال دمج هذه الوسائط باستخدام طريقة البحث الهجين، يمكنك تحسين دقة البحث أو إثراء نتائج البحث.
مثال
لنأخذ حالة استخدام واقعية حيث يتضمن كل منتج وصفًا نصيًّا وصورة. استنادًا إلى البيانات المتاحة، يمكننا إجراء ثلاثة أنواع من عمليات البحث:
البحث النصي الدلالي: يتضمن هذا البحث الاستعلام عن الوصف النصي للمنتج باستخدام المتجهات الكثيفة. يمكن إنشاء تضمينات نصية باستخدام نماذج مثل BERT وTransformers أو خدمات مثل OpenAI.
البحث عن النص الكامل: هنا، نستعلم عن الوصف النصي للمنتج باستخدام مطابقة الكلمات المفتاحية مع المتجهات المتفرقة. يمكن استخدام خوارزميات مثل BM25 أو نماذج التضمين المتفرقة مثل BGE-M3 أو SPLADE لهذا الغرض.
البحث متعدد الوسائط عن الصور: تستند هذه الطريقة إلى البحث في الصورة باستخدام استعلام نصي مع متجهات كثيفة. يمكن إنشاء تضمينات الصور باستخدام نماذج مثل CLIP.
سيرشدك هذا الدليل عبر مثال للبحث الهجين متعدد الوسائط الذي يجمع بين طرق البحث المذكورة أعلاه، بناءً على الوصف النصي الأولي وتضمينات صور المنتجات. سنوضح كيفية تخزين البيانات متعددة المتجهات وإجراء عمليات البحث الهجينة باستخدام استراتيجية إعادة الترتيب.
إنشاء مجموعة تحتوي على حقول متجهات متعددة
تتضمن عملية إنشاء المجموعة ثلاث خطوات رئيسية: تحديد مخطط المجموعة، وتكوين معلمات الفهرس، وإنشاء المجموعة.
تحديد مخطط المجموعة
بالنسبة للبحث الهجين متعدد المتجهات، يجب تحديد حقول متجهة متعددة ضمن مخطط المجموعة. للحصول على تفاصيل حول الحدود القصوى لعدد الحقول المتجهة المسموح بها في المجموعة، راجع حدود Zilliz Cloud. ومع ذلك، إذا لزم الأمر، يمكنك تعديل proxy.maxVectorFieldNum لتضمين ما يصل إلى 10 حقول متجهة في المجموعة حسب الحاجة.
يتضمن هذا المثال الحقول التالية في المخطط:
id: يُستخدم كمفتاح أساسي لتخزين معرّفات النصوص. هذا الحقل من نوع البياناتINT64.text: يُستخدم لتخزين المحتوى النصي. هذا الحقل من نوع البياناتVARCHARبطول أقصى يبلغ 1000 بايت. تم تعيين الخيار «enable_analyzer» على «True» لتسهيل البحث عن النص الكامل.text_dense: يُستخدم لتخزين المتجهات الكثيفة للنصوص. هذا الحقل من نوع البياناتFLOAT_VECTORمع بُعد متجه يبلغ 768.text_sparse: يُستخدم لتخزين متجهات متفرقة للنصوص. هذا الحقل من نوع البياناتSPARSE_FLOAT_VECTOR.image_dense: يُستخدم لتخزين المتجهات الكثيفة لصور المنتجات. هذا الحقل من نوع البياناتFLOAT_VETORبأبعاد متجهة تبلغ 512.
نظرًا لأننا سنستخدم خوارزمية BM25 المدمجة لإجراء بحث نصي كامل في حقل النص، فمن الضروري إضافة خوارزمية Milvus Function إلى المخطط. لمزيد من التفاصيل، يرجى الرجوع إلى البحث النصي الكامل.
from pymilvus import (
    MilvusClient, DataType, Function, FunctionType
)

client = MilvusClient(
    uri="http://localhost:19530",
    token="root:Milvus"
)

# Init schema with auto_id disabled
schema = client.create_schema(auto_id=False)

# Add fields to schema
schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True, description="product id")
schema.add_field(field_name="text", datatype=DataType.VARCHAR, max_length=1000, enable_analyzer=True, description="raw text of product description")
schema.add_field(field_name="text_dense", datatype=DataType.FLOAT_VECTOR, dim=768, description="text dense embedding")
schema.add_field(field_name="text_sparse", datatype=DataType.SPARSE_FLOAT_VECTOR, description="text sparse embedding auto-generated by the built-in BM25 function")
schema.add_field(field_name="image_dense", datatype=DataType.FLOAT_VECTOR, dim=512, description="image dense embedding")

# Add function to schema
bm25_function = Function(
    name="text_bm25_emb",
    input_field_names=["text"],
    output_field_names=["text_sparse"],
    function_type=FunctionType.BM25,
)
schema.add_function(bm25_function)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq.Function;

import java.util.*;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .token("root:Milvus")
        .build());

CreateCollectionReq.CollectionSchema schema = client.createSchema();

schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(false)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("text_dense")
        .dataType(DataType.FloatVector)
        .dimension(768)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("text_sparse")
        .dataType(DataType.SparseFloatVector)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("image_dense")
        .dataType(DataType.FloatVector)
        .dimension(512)
        .build());

schema.addFunction(Function.builder()
        .functionType(FunctionType.BM25)
        .name("text_bm25_emb")
        .inputFieldNames(Collections.singletonList("text"))
        .outputFieldNames(Collections.singletonList("text_sparse"))
        .build());
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

function := entity.NewFunction().
    WithName("text_bm25_emb").
    WithInputFields("text").
    WithOutputFields("text_sparse").
    WithType(entity.FunctionTypeBM25)

schema := entity.NewSchema()

schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true),
).WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithMaxLength(1000),
).WithField(entity.NewField().
    WithName("text_dense").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(768),
).WithField(entity.NewField().
    WithName("text_sparse").
    WithDataType(entity.FieldTypeSparseVector),
).WithField(entity.NewField().
    WithName("image_dense").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(512),
).WithFunction(function)
import { MilvusClient, DataType, FunctionType } from "@zilliz/milvus2-sdk-node";

const address = "http://localhost:19530";
const token = "root:Milvus";
const client = new MilvusClient({address, token});

// Define fields
const fields = [
    {
        name: "id",
        data_type: DataType.Int64,
        is_primary_key: true,
        auto_id: false
    },
    {
        name: "text",
        data_type: DataType.VarChar,
        max_length: 1000,
        enable_analyzer: true
    },
    {
        name: "text_dense",
        data_type: DataType.FloatVector,
        dim: 768
    },
    {
        name: "text_sparse",
        data_type: DataType.SparseFloatVector
    },
    {
        name: "image_dense",
        data_type: DataType.FloatVector,
        dim: 512
    }
];

// define function
const functions = [
    {
      name: "text_bm25_emb",
      description: "text bm25 function",
      type: FunctionType.BM25,
      input_field_names: ["text"],
      output_field_names: ["text_sparse"],
      params: {},
    },
];
export schema='{
        "autoId": false,
        "functions": [
            {
                "name": "text_bm25_emb",
                "type": "BM25",
                "inputFieldNames": ["text"],
                "outputFieldNames": ["text_sparse"],
                "params": {}
            }
        ],
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true
                }
            },
            {
                "fieldName": "text_dense",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "768"
                }
            },
            {
                "fieldName": "text_sparse",
                "dataType": "SparseFloatVector"
            },
            {
                "fieldName": "image_dense",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "512"
                }
            }
        ]
    }'
#include "milvus/MilvusClientV2.h"

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"http://localhost:19530", "root:Milvus"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

milvus::FunctionPtr function = std::make_shared<milvus::Function>("text_bm25_emb", milvus::FunctionType::BM25, "text bm25 function");
function->AddInputFieldName("text");
function->AddOutputFieldName("text_sparse");

milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->AddField({"id", milvus::DataType::INT64, "", true, false});
schema->AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR).WithMaxLength(1000).EnableAnalyzer(true));
schema->AddField(milvus::FieldSchema("text_dense", milvus::DataType::FLOAT_VECTOR).WithDimension(768));
schema->AddField({"text_sparse", milvus::DataType::SPARSE_FLOAT_VECTOR});
schema->AddField(milvus::FieldSchema("image_dense", milvus::DataType::FLOAT_VECTOR).WithDimension(512));
schema->AddFunction(function);
إنشاء فهرس
بعد تعريف مخطط المجموعة، تتمثل الخطوة التالية في تكوين الفهارس المتجهة وتحديد مقاييس التشابه. في المثال المقدم:
text_dense_index: يتم إنشاء فهرس من النوعAUTOINDEXبنوع المقياسIPلحقل المتجهات النصية الكثيفة.text_sparse_index: يتم استخدام فهرس من النوعSPARSE_INVERTED_INDEXمع نوع المقياسBM25لحقل المتجهات النصية المتفرقة.image_dense_index: يتم إنشاء فهرس من النوعAUTOINDEXبنوع المقياسIPلحقل المتجهات الكثيف الخاص بالصورة.
يمكنك اختيار أنواع فهرس أخرى حسب الضرورة لتناسب احتياجاتك وأنواع بياناتك على النحو الأمثل. لمزيد من المعلومات حول أنواع الفهرس المدعومة، يرجى الرجوع إلى الوثائق المتعلقة بأنواع الفهرس المتاحة.
# Prepare index parameters
index_params = client.prepare_index_params()

# Add indexes
index_params.add_index(
    field_name="text_dense",
    index_name="text_dense_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)

index_params.add_index(
    field_name="text_sparse",
    index_name="text_sparse_index",
    index_type="SPARSE_INVERTED_INDEX",
    metric_type="BM25",
    params={"inverted_index_algo": "DAAT_MAXSCORE"}, # or "DAAT_WAND" or "TAAT_NAIVE"
)

index_params.add_index(
    field_name="image_dense",
    index_name="image_dense_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)
import io.milvus.v2.common.IndexParam;
import java.util.*;

Map<String, Object> denseParams = new HashMap<>();

IndexParam indexParamForTextDense = IndexParam.builder()
        .fieldName("text_dense")
        .indexName("text_dense_index")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build();

Map<String, Object> sparseParams = new HashMap<>();
sparseParams.put("inverted_index_algo", "DAAT_MAXSCORE");
IndexParam indexParamForTextSparse = IndexParam.builder()
        .fieldName("text_sparse")
        .indexName("text_sparse_index")
        .indexType(IndexParam.IndexType.SPARSE_INVERTED_INDEX)
        .metricType(IndexParam.MetricType.BM25)
        .extraParams(sparseParams)
        .build();

IndexParam indexParamForImageDense = IndexParam.builder()
        .fieldName("image_dense")
        .indexName("image_dense_index")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build();

List<IndexParam> indexParams = new ArrayList<>();
indexParams.add(indexParamForTextDense);
indexParams.add(indexParamForTextSparse);
indexParams.add(indexParamForImageDense);
indexOption1 := milvusclient.NewCreateIndexOption("my_collection", "text_dense",
    index.NewAutoIndex(index.MetricType(entity.IP)))
indexOption2 := milvusclient.NewCreateIndexOption("my_collection", "text_sparse",
    index.NewSparseInvertedIndex(entity.BM25, 0.2))
indexOption3 := milvusclient.NewCreateIndexOption("my_collection", "image_dense",
    index.NewAutoIndex(index.MetricType(entity.IP)))
const index_params = [{
    field_name: "text_dense",
    index_name: "text_dense_index",
    index_type: "AUTOINDEX",
    metric_type: "IP"
},{
    field_name: "text_sparse",
    index_name: "text_sparse_index",
    index_type: "SPARSE_INVERTED_INDEX",
    metric_type: "BM25",
    params: {
      inverted_index_algo: "DAAT_MAXSCORE",
    }
},{
    field_name: "image_dense",
    index_name: "image_dense_index",
    index_type: "AUTOINDEX",
    metric_type: "IP"
}]
export indexParams='[
        {
            "fieldName": "text_dense",
            "metricType": "IP",
            "indexName": "text_dense_index",
            "indexType":"AUTOINDEX"
        },
        {
            "fieldName": "text_sparse",
            "metricType": "BM25",
            "indexName": "text_sparse_index",
            "indexType": "SPARSE_INVERTED_INDEX",
            "params":{"inverted_index_algo": "DAAT_MAXSCORE"}
        },
        {
            "fieldName": "image_dense",
            "metricType": "IP",
            "indexName": "image_dense_index",
            "indexType":"AUTOINDEX"
        }
    ]'
milvus::IndexDesc text_sparse_index("text_sparse", "text_sparse_index", milvus::IndexType::SPARSE_INVERTED_INDEX, milvus::MetricType::BM25);
text_sparse_index.AddExtraParam("inverted_index_algo", "DAAT_MAXSCORE");

std::vector<milvus::IndexDesc> indexes = {
    milvus::IndexDesc("text_dense", "text_dense_index", milvus::IndexType::AUTOINDEX, milvus::MetricType::IP),
    text_sparse_index,
    milvus::IndexDesc("image_dense", "image_dense_index", milvus::IndexType::AUTOINDEX, milvus::MetricType::IP),
};
إنشاء مجموعة
قم بإنشاء مجموعة باسم demo باستخدام مخطط المجموعة والفهارس التي تم تكوينها في الخطوتين السابقتين.
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
CreateCollectionReq createCollectionReq = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexParams)
        .build();
client.createCollection(createCollectionReq);
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption1, indexOption2, indexOption3))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
res = await client.createCollection({
    collection_name: "my_collection",
    fields: fields,
    functions: functions,
    index_params: index_params,
})
export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
status = client->CreateCollection(milvus::CreateCollectionRequest()
                                      .WithCollectionName("my_collection")
                                      .WithCollectionSchema(schema)
                                      .WithIndexes(std::move(indexes)));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
إدراج البيانات
يُدرج هذا القسم البيانات في مجموعة " my_collection " استنادًا إلى المخطط المحدد سابقًا. أثناء الإدراج، تأكد من تزويد جميع الحقول، باستثناء تلك التي تحتوي على قيم مُنشأة تلقائيًا، بالبيانات بالصيغة الصحيحة. في هذا المثال:
id: عدد صحيح يمثل معرّف المنتجtext: سلسلة تحتوي على وصف المنتجtext_dense: قائمة مكونة من 768 قيمة عائمة تمثل التضمين الكثيف لوصف النصimage_dense: قائمة مكونة من 512 قيمة عائمة تمثل التضمين الكثيف لصورة المنتج
يمكنك استخدام نفس النماذج أو نماذج مختلفة لتوليد التضمينات الكثيفة لكل حقل. في هذا المثال، للتضمينين الكثيفين أبعاد مختلفة، مما يشير إلى أنهما تم توليدهما بواسطة نماذج مختلفة. عند تعريف كل عملية بحث لاحقًا، تأكد من استخدام النموذج المقابل لتوليد تضمين الاستعلام المناسب.
نظرًا لأن هذا المثال يستخدم الدالة المدمجة BM25 لإنشاء تضمينات متفرقة من حقل النص، فلن تحتاج إلى توفير متجهات متفرقة يدويًّا. ومع ذلك، إذا اخترت عدم استخدام BM25، فيجب عليك حساب التضمينات المتفرقة مسبقًا وتوفيرها بنفسك.
import random

# Generate example vectors
def generate_dense_vector(dim):
    return [random.random() for _ in range(dim)]

data=[
    {
        "id": 0,
        "text": "Red cotton t-shirt with round neck",
        "text_dense": generate_dense_vector(768),
        "image_dense": generate_dense_vector(512)
    },
    {
        "id": 1,
        "text": "Wireless noise-cancelling over-ear headphones",
        "text_dense": generate_dense_vector(768),
        "image_dense": generate_dense_vector(512)
    },
    {
        "id": 2,
        "text": "Stainless steel water bottle, 500ml",
        "text_dense": generate_dense_vector(768),
        "image_dense": generate_dense_vector(512)
    }
]

res = client.insert(
    collection_name="my_collection",
    data=data
)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;
import io.milvus.v2.service.vector.response.InsertResp;

Gson gson = new Gson();
JsonObject row1 = new JsonObject();
row1.addProperty("id", 0);
row1.addProperty("text", "Red cotton t-shirt with round neck");
row1.add("text_dense", gson.toJsonTree(new float[]{0.3580376395471989f, -0.6023495712049978f, 0.18414012509913835f, ...}));
row1.add("image_dense", gson.toJsonTree(new float[]{0.6366019600530924f, -0.09323198122475052f, ...}));

JsonObject row2 = new JsonObject();
row2.addProperty("id", 1);
row2.addProperty("text", "Wireless noise-cancelling over-ear headphones");
row2.add("text_dense", gson.toJsonTree(new float[]{0.19886812562848388f, 0.06023560599112088f, 0.6976963061752597f, ...}));
row2.add("image_dense", gson.toJsonTree(new float[]{0.6414180010301553f, 0.8976979978567611f, ...}));

JsonObject row3 = new JsonObject();
row3.addProperty("id", 2);
row3.addProperty("text", "Stainless steel water bottle, 500ml");
row3.add("text_dense", gson.toJsonTree(new float[]{0.43742130801983836f, -0.5597502546264526f, 0.6457887650909682f, ...}));
row3.add("image_dense", gson.toJsonTree(new float[]{-0.6901259768402174f, 0.6100500332193755f, ...}));

List<JsonObject> data = Arrays.asList(row1, row2, row3);
InsertReq insertReq = InsertReq.builder()
        .collectionName("my_collection")
        .data(data)
        .build();

InsertResp insertResp = client.insert(insertReq);
_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("my_collection").
    WithInt64Column("id", []int64{0, 1, 2}).
    WithVarcharColumn("text", []string{
        "Red cotton t-shirt with round neck",
        "Wireless noise-cancelling over-ear headphones",
        "Stainless steel water bottle, 500ml",
    }).
    WithFloatVectorColumn("text_dense", 768, [][]float32{
        {0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...},
        {0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...},
        {0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...},
    }).
    WithFloatVectorColumn("image_dense", 512, [][]float32{
        {0.6366019600530924, -0.09323198122475052, ...},
        {0.6414180010301553, 0.8976979978567611, ...},
        {-0.6901259768402174, 0.6100500332193755, ...},
    }))
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
const { MilvusClient, DataType } = require("@zilliz/milvus2-sdk-node")

var data = [
    {id: 0, text: "Red cotton t-shirt with round neck" , text_dense: [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...], image_dense: [0.6366019600530924, -0.09323198122475052, ...]},
    {id: 1, text: "Wireless noise-cancelling over-ear headphones" , text_dense: [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...], image_dense: [0.6414180010301553, 0.8976979978567611, ...]},
    {id: 2, text: "Stainless steel water bottle, 500ml" , text_dense: [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...], image_dense: [-0.6901259768402174, 0.6100500332193755, ...]}
]

var res = await client.insert({
    collection_name: "my_collection",
    data: data,
})
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "data": [
        {"id": 0, "text": "Red cotton t-shirt with round neck" , "text_dense": [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...], "image_dense": [0.6366019600530924, -0.09323198122475052, ...]},
        {"id": 1, "text": "Wireless noise-cancelling over-ear headphones" , "text_dense": [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...], "image_dense": [0.6414180010301553, 0.8976979978567611, ...]},
        {"id": 2, "text": "Stainless steel water bottle, 500ml" , "text_dense": [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...], "image_dense": [-0.6901259768402174, 0.6100500332193755, ...]}
    ],
    "collectionName": "my_collection"
}'
#include <random>

std::vector<float>
GenerateFloatVector(int dimension) {
    std::random_device rd;
    std::mt19937 ran(rd());
    std::uniform_real_distribution<float> float_gen(0.0, 1.0);
    std::vector<float> vector(dimension);
    for (auto d = 0; d < dimension; ++d) {
        vector[d] = float_gen(ran);
    }
    return vector;
}

milvus::EntityRows data = {
    {{"id", 0}, {"text", "Red cotton t-shirt with round neck"}, {"text_dense", GenerateFloatVector(768)}, {"image_dense", GenerateFloatVector(512)}},
    {{"id", 1}, {"text", "Wireless noise-cancelling over-ear headphones"}, {"text_dense", GenerateFloatVector(768)}, {"image_dense", GenerateFloatVector(512)}},
    {{"id", 2}, {"text", "Stainless steel water bottle, 500ml"}, {"text_dense", GenerateFloatVector(768)}, {"image_dense", GenerateFloatVector(512)}}
};

milvus::InsertResponse response;
status = client->Insert(milvus::InsertRequest()
                            .WithCollectionName("my_collection")
                            .WithRowsData(std::move(data)),
                        response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
إجراء بحث هجين
الخطوة 1: إنشاء عدة مثيلات لـ AnnSearchRequest
يتم تنفيذ البحث الهجين عن طريق إنشاء عدة مثيلات لـ ` AnnSearchRequest ` في الدالة ` hybrid_search() `، حيث يمثل كل مثيل ` AnnSearchRequest ` طلب بحث ANN أساسي لحقل متجه معين. لذلك، قبل إجراء بحث هجين، من الضروري إنشاء مثيل ` AnnSearchRequest ` لكل حقل متجه.
بالإضافة إلى ذلك، من خلال تكوين المعلمة expr في AnnSearchRequest ، يمكنك تعيين شروط التصفية لعملية البحث الهجين الخاصة بك. يرجى الرجوع إلى «البحث المُصفى » و«شرح التصفية».
في البحث الهجين، يدعم كل AnnSearchRequest بيانات استعلام واحدة فقط.
لتوضيح قدرات حقول المتجهات البحثية المختلفة، سنقوم بإنشاء ثلاثة طلبات بحث في AnnSearchRequest باستخدام استعلام نموذجي. سنستخدم أيضًا متجهاتها الكثيفة المحسوبة مسبقًا في هذه العملية. ستستهدف طلبات البحث حقول المتجهات التالية:
text_denseللبحث الدلالي عن النصوص، مما يتيح الفهم السياقي والاسترجاع بناءً على المعنى بدلاً من المطابقة المباشرة للكلمات المفتاحية.text_sparseللبحث عن النص الكامل أو مطابقة الكلمات الرئيسية، مع التركيز على المطابقات الدقيقة للكلمات أو العبارات داخل النص.image_denseللبحث متعدد الوسائط من النص إلى الصورة، لاسترجاع صور المنتجات ذات الصلة بناءً على المحتوى الدلالي للاستعلام.
from pymilvus import AnnSearchRequest

query_text = "white headphones, quiet and comfortable"
query_dense_vector = generate_dense_vector(768)
query_multimodal_vector = generate_dense_vector(512)

# text semantic search (dense)
search_param_1 = {
    "data": [query_dense_vector],
    "anns_field": "text_dense",
    "param": {"nprobe": 10},
    "limit": 2
}
request_1 = AnnSearchRequest(**search_param_1)

# full-text search (sparse)
search_param_2 = {
    "data": [query_text],
    "anns_field": "text_sparse",
    "param": {},
    "limit": 2
}
request_2 = AnnSearchRequest(**search_param_2)

# text-to-image search (multimodal)
search_param_3 = {
    "data": [query_multimodal_vector],
    "anns_field": "image_dense",
    "param": {"nprobe": 10},
    "limit": 2
}
request_3 = AnnSearchRequest(**search_param_3)

reqs = [request_1, request_2, request_3]
import io.milvus.v2.service.vector.request.AnnSearchReq;
import io.milvus.v2.service.vector.request.data.BaseVector;
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.request.data.SparseFloatVec;
import io.milvus.v2.service.vector.request.data.EmbeddedText;

float[] queryDense = new float[]{-0.0475336798f,  0.0521207601f,  0.0904406682f, ...};
float[] queryMultimodal = new float[]{0.0158298651f, 0.5264158340f, ...};

List<BaseVector> queryTexts = Collections.singletonList(new EmbeddedText("white headphones, quiet and comfortable"));
List<BaseVector> queryDenseVectors = Collections.singletonList(new FloatVec(queryDense));
List<BaseVector> queryMultimodalVectors = Collections.singletonList(new FloatVec(queryMultimodal));

List<AnnSearchReq> searchRequests = new ArrayList<>();
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_dense")
        .vectors(queryDenseVectors)
        .params("{\"nprobe\": 10}")
        .topK(2)
        .build());
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_sparse")
        .vectors(queryTexts)
        .topK(2)
        .build());
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("image_dense")
        .vectors(queryMultimodalVectors)
        .params("{\"nprobe\": 10}")
        .topK(2)
        .build());
queryText := entity.Text("white headphones, quiet and comfortable")
queryVector := []float32{0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...}
queryMultimodalVector := []float32{0.015829865178701663, 0.5264158340734488, ...}

request1 := milvusclient.NewAnnRequest("text_dense", 2, entity.FloatVector(queryVector)).
    WithAnnParam(index.NewIvfAnnParam(10))

annParam := index.NewSparseAnnParam()
annParam.WithDropRatio(0.2)
request2 := milvusclient.NewAnnRequest("text_sparse", 2, queryText).
    WithAnnParam(annParam)

request3 := milvusclient.NewAnnRequest("image_dense", 2, entity.FloatVector(queryMultimodalVector)).
    WithAnnParam(index.NewIvfAnnParam(10))
const query_text = "white headphones, quiet and comfortable"
const query_vector = [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...]
const query_multimodal_vector = [0.015829865178701663, 0.5264158340734488, ...]

const search_param_1 = {
    "data": query_vector,
    "anns_field": "text_dense",
    "params": {"nprobe": 10},
    "limit": 2
}

const search_param_2 = {
    "data": query_text,
    "anns_field": "text_sparse",
    "limit": 2
}

const search_param_3 = {
    "data": query_multimodal_vector,
    "anns_field": "image_dense",
    "params": {"nprobe": 10},
    "limit": 2
}
export req='[
    {
        "data": [[0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...]],
        "annsField": "text_dense",
        "params": {"nprobe": 10},
        "limit": 2
    },
    {
        "data": ["white headphones, quiet and comfortable"],
        "annsField": "text_sparse",
        "limit": 2
    },
    {
        "data": [[0.015829865178701663, 0.5264158340734488, ...]],
        "annsField": "image_dense",
        "params": {"nprobe": 10},
        "limit": 2
    }
 ]'
auto query_text = "white headphones, quiet and comfortable";
auto query_dense_vector = GenerateFloatVector(768);
auto query_multimodal_vector = GenerateFloatVector(512);

// text semantic search (dense)
auto sub_req1 = milvus::SubSearchRequest()
                    .AddFloatVector(query_dense_vector)
                    .WithAnnsField("text_dense")
                    .WithLimit(2);
sub_req1.AddExtraParam("nprobe", "10");

// full-text search (sparse)
auto sub_req2 = milvus::SubSearchRequest()
                    .AddEmbeddedText(query_text)
                    .WithAnnsField("text_sparse")
                    .WithLimit(2);

// text-to-image search (multimodal)
auto sub_req3 = milvus::SubSearchRequest()
                    .AddFloatVector(query_multimodal_vector)
                    .WithAnnsField("image_dense")
                    .WithLimit(2);
sub_req3.AddExtraParam("nprobe", "10");
نظرًا لأن المعلمة limit مضبوطة على 2، فإن كل AnnSearchRequest تُرجع نتيجتي بحث. في هذا المثال، يتم إنشاء 3 مثيلات لـ AnnSearchRequest ، مما ينتج عنه إجمالي 6 نتائج بحث.
الخطوة 2: تكوين استراتيجية إعادة الترتيب
لدمج مجموعات نتائج بحث الشبكات العصبية الاصطناعية (ANN) وإعادة ترتيبها، من الضروري اختيار استراتيجية إعادة ترتيب مناسبة. يوفر Milvus عدة أنواع من استراتيجيات إعادة الترتيب. لمزيد من التفاصيل حول آليات إعادة الترتيب هذه، يرجى الرجوع إلى Weighted Ranker أو RRF Ranker.
في هذا المثال، نظرًا لعدم وجود تركيز خاص على استعلامات بحث محددة، سنستخدم استراتيجية RRFRanker.
ranker = Function(
    name="rrf",
    input_field_names=[], # Must be an empty list
    function_type=FunctionType.RERANK,
    params={
        "reranker": "rrf",
        "k": 100  # Optional
    }
)
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.CreateCollectionReq.Function;

Function ranker = Function.builder()
        .name("rrf")
        .functionType(FunctionType.RERANK)
        .param("reranker", "rrf")
        .param("k", "100")
        .build();
const rerank = {
  name: 'rrf',
  description: 'bm25 function',
  type: FunctionType.RERANK,
  input_field_names: [],
  params: {
      "reranker": "rrf",
      "k": 100
  },
};
reranker := milvusclient.NewRRFReranker().WithK(100)
# Restful
export rerank='{"k": 100}'
auto ranker = std::make_shared<milvus::RRFRerank>(100);
الخطوة 3: إجراء بحث هجين
قبل بدء البحث المختلط، تأكد من تحميل المجموعة. إذا كانت أي حقول متجهة داخل المجموعة تفتقر إلى فهرس أو لم يتم تحميلها في الذاكرة، فسيحدث خطأ عند تنفيذ طريقة البحث المختلط.
res = client.hybrid_search(
    collection_name="my_collection",
    reqs=reqs,
    ranker=ranker,
    limit=2
)
for hits in res:
    print("TopK results:")
    for hit in hits:
        print(hit)
import io.milvus.v2.common.ConsistencyLevel;
import io.milvus.v2.service.vector.request.HybridSearchReq;
import io.milvus.v2.service.vector.response.SearchResp;

HybridSearchReq hybridSearchReq = HybridSearchReq.builder()
        .collectionName("my_collection")
        .searchRequests(searchRequests)
        .ranker(ranker)
        .topK(2)
        .build();

SearchResp searchResp = client.hybridSearch(hybridSearchReq);
resultSets, err := client.HybridSearch(ctx, milvusclient.NewHybridSearchOption(
    "my_collection",
    2,
    request1,
    request2,
    request3,
).WithReranker(reranker))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
}
const { MilvusClient, DataType } = require("@zilliz/milvus2-sdk-node")

res = await client.loadCollection({
    collection_name: "my_collection"
})

import { MilvusClient, RRFRanker, WeightedRanker } from '@zilliz/milvus2-sdk-node';

const search = await client.search({
  collection_name: "my_collection",
  data: [search_param_1, search_param_2, search_param_3],
  limit: 2,
  rerank: rerank
});
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/hybrid_search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"search\": ${req},
    \"rerank\": {
        \"strategy\":\"rrf\",
        \"params\": ${rerank}
    },
    \"limit\": 2
}"
auto request = milvus::HybridSearchRequest()
                   .WithCollectionName("my_collection")
                   .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(sub_req1)))
                   .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(sub_req2)))
                   .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(sub_req3)))
                   .WithRerank(ranker)
                   .WithLimit(2);

milvus::SearchResponse response;
status = client->HybridSearch(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

for (auto& result : response.Results().Results()) {
    std::cout << "TopK results:" << std::endl;
    milvus::EntityRows output_rows;
    status = result.OutputRows(output_rows);
    for (const auto& row : output_rows) {
        std::cout << "\t" << row << std::endl;
    }
}
فيما يلي الناتج:
["['id: 1, distance: 0.006047376897186041, entity: {}', 'id: 2, distance: 0.006422005593776703, entity: {}']"]
مع تحديد المعلمة limit=2 للبحث الهجين، سيقوم Milvus بإعادة ترتيب النتائج الست التي تم الحصول عليها من عمليات البحث الثلاث. وفي النهاية، سيتم إرجاع النتيجتين الأكثر تشابهًا فقط.
الاستخدام المتقدم
تعيين منطقة زمنية مؤقتًا لعملية البحث الهجين
إذا كانت مجموعتك تحتوي على حقل " TIMESTAMPTZ "، فيمكنك تجاوز المنطقة الزمنية الافتراضية لقاعدة البيانات أو المجموعة مؤقتًا لعملية واحدة عن طريق تعيين المعلمة " timezone " في استدعاء البحث الهجين. يتحكم هذا في كيفية عرض قيم " TIMESTAMPTZ " ومقارنتها أثناء العملية.
يجب أن تكون قيمة timezone معرّف منطقة زمنية صالحًا وفقًا لـ IANA (على سبيل المثال، Asia/Shanghai أو America/Chicago أو UTC). للحصول على تفاصيل حول كيفية استخدام حقل TIMESTAMPTZ ، راجع حقل TIMESTAMPTZ.
يوضح المثال أدناه كيفية تعيين منطقة زمنية مؤقتًا لعملية بحث مختلطة:
res = client.hybrid_search(
    collection_name="my_collection",
    reqs=reqs,
    ranker=ranker,
    limit=2,
    timezone="America/Havana",
)
List<AnnSearchReq> tzRequests = new ArrayList<>();
tzRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_dense")
        .vectors(queryDenseVectors)
        .params("{\"nprobe\": 10}")
        .topK(2)
        .timezone("America/Havana")
        .build());
tzRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_sparse")
        .vectors(queryTexts)
        .topK(2)
        .timezone("America/Havana")
        .build());
tzRequests.add(AnnSearchReq.builder()
        .vectorFieldName("image_dense")
        .vectors(queryMultimodalVectors)
        .params("{\"nprobe\": 10}")
        .topK(2)
        .timezone("America/Havana")
        .build());

HybridSearchReq tzHybridSearchReq = HybridSearchReq.builder()
        .collectionName("my_collection")
        .searchRequests(tzRequests)
        .ranker(ranker)
        .topK(2)
        .build();

SearchResp tzSearchResp = client.hybridSearch(tzHybridSearchReq);
tzRequest1 := milvusclient.NewAnnRequest("text_dense", 2, entity.FloatVector(queryVector)).
    WithAnnParam(index.NewIvfAnnParam(10)).
    WithSearchParam("timezone", "America/Havana")

tzRequest2 := milvusclient.NewAnnRequest("text_sparse", 2, queryText).
    WithAnnParam(annParam).
    WithSearchParam("timezone", "America/Havana")

tzRequest3 := milvusclient.NewAnnRequest("image_dense", 2, entity.FloatVector(queryMultimodalVector)).
    WithAnnParam(index.NewIvfAnnParam(10)).
    WithSearchParam("timezone", "America/Havana")

resultSets, err = client.HybridSearch(ctx, milvusclient.NewHybridSearchOption(
    "my_collection",
    2,
    tzRequest1,
    tzRequest2,
    tzRequest3,
).WithReranker(reranker))
res = await client.search({
  collection_name: "my_collection",
  data: [
    { ...search_param_1, params: { "nprobe": 10, timezone: "America/Havana" } },
    { ...search_param_2, params: { timezone: "America/Havana" } },
    { ...search_param_3, params: { "nprobe": 10, timezone: "America/Havana" } },
  ],
  limit: 2,
  rerank: rerank
});
# restful
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/hybrid_search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
-d '{
    "collectionName": "my_collection",
    "search": [
        {
            "data": [[0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...]],
            "annsField": "text_dense",
            "params": {"nprobe": 10, "timezone": "America/Havana"},
            "limit": 2
        },
        {
            "data": ["white headphones, quiet and comfortable"],
            "annsField": "text_sparse",
            "params": {"timezone": "America/Havana"},
            "limit": 2
        },
        {
            "data": [[0.015829865178701663, 0.5264158340734488, ...]],
            "annsField": "image_dense",
            "params": {"nprobe": 10, "timezone": "America/Havana"},
            "limit": 2
        }
    ],
    "rerank": {
        "strategy": "rrf",
        "params": {"k": 100}
    },
    "limit": 2
}'
auto tz_req1 = milvus::SubSearchRequest()
                   .AddFloatVector(query_dense_vector)
                   .WithAnnsField("text_dense")
                   .WithTimezone("America/Havana")
                   .WithLimit(2);
tz_req1.AddExtraParam("nprobe", "10");

auto tz_req2 = milvus::SubSearchRequest()
                   .AddEmbeddedText(query_text)
                   .WithAnnsField("text_sparse")
                   .WithTimezone("America/Havana")
                   .WithLimit(2);

auto tz_req3 = milvus::SubSearchRequest()
                   .AddFloatVector(query_multimodal_vector)
                   .WithAnnsField("image_dense")
                   .WithTimezone("America/Havana")
                   .WithLimit(2);
tz_req3.AddExtraParam("nprobe", "10");

auto tz_request = milvus::HybridSearchRequest()
                      .WithCollectionName("my_collection")
                      .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(tz_req1)))
                      .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(tz_req2)))
                      .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(tz_req3)))
                      .WithRerank(ranker)
                      .WithLimit(2);

milvus::SearchResponse tz_response;
status = client->HybridSearch(tz_request, tz_response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
