

Pesquisa híbrida multivectorial
Em muitas aplicações, um objeto pode ser pesquisado através de um vasto conjunto de informações, tais como título e descrição, ou através de múltiplas modalidades, como texto, imagens e áudio. Por exemplo, um tweet que contenha um texto e uma imagem deve ser encontrado se o texto ou a imagem corresponderem à semântica da consulta de pesquisa. A pesquisa híbrida melhora a experiência de pesquisa ao combinar pesquisas nestes diversos campos. O Milvus suporta esta funcionalidade, permitindo a pesquisa em vários campos vetoriais e realizando simultaneamente várias pesquisas do tipo «Vizinho Mais Próximo Aproximado» (ANN). A pesquisa híbrida multivetorial é particularmente útil se pretender pesquisar tanto texto como imagens, vários campos de texto que descrevem o mesmo objeto ou vetores densos e esparsos para melhorar a qualidade da pesquisa.
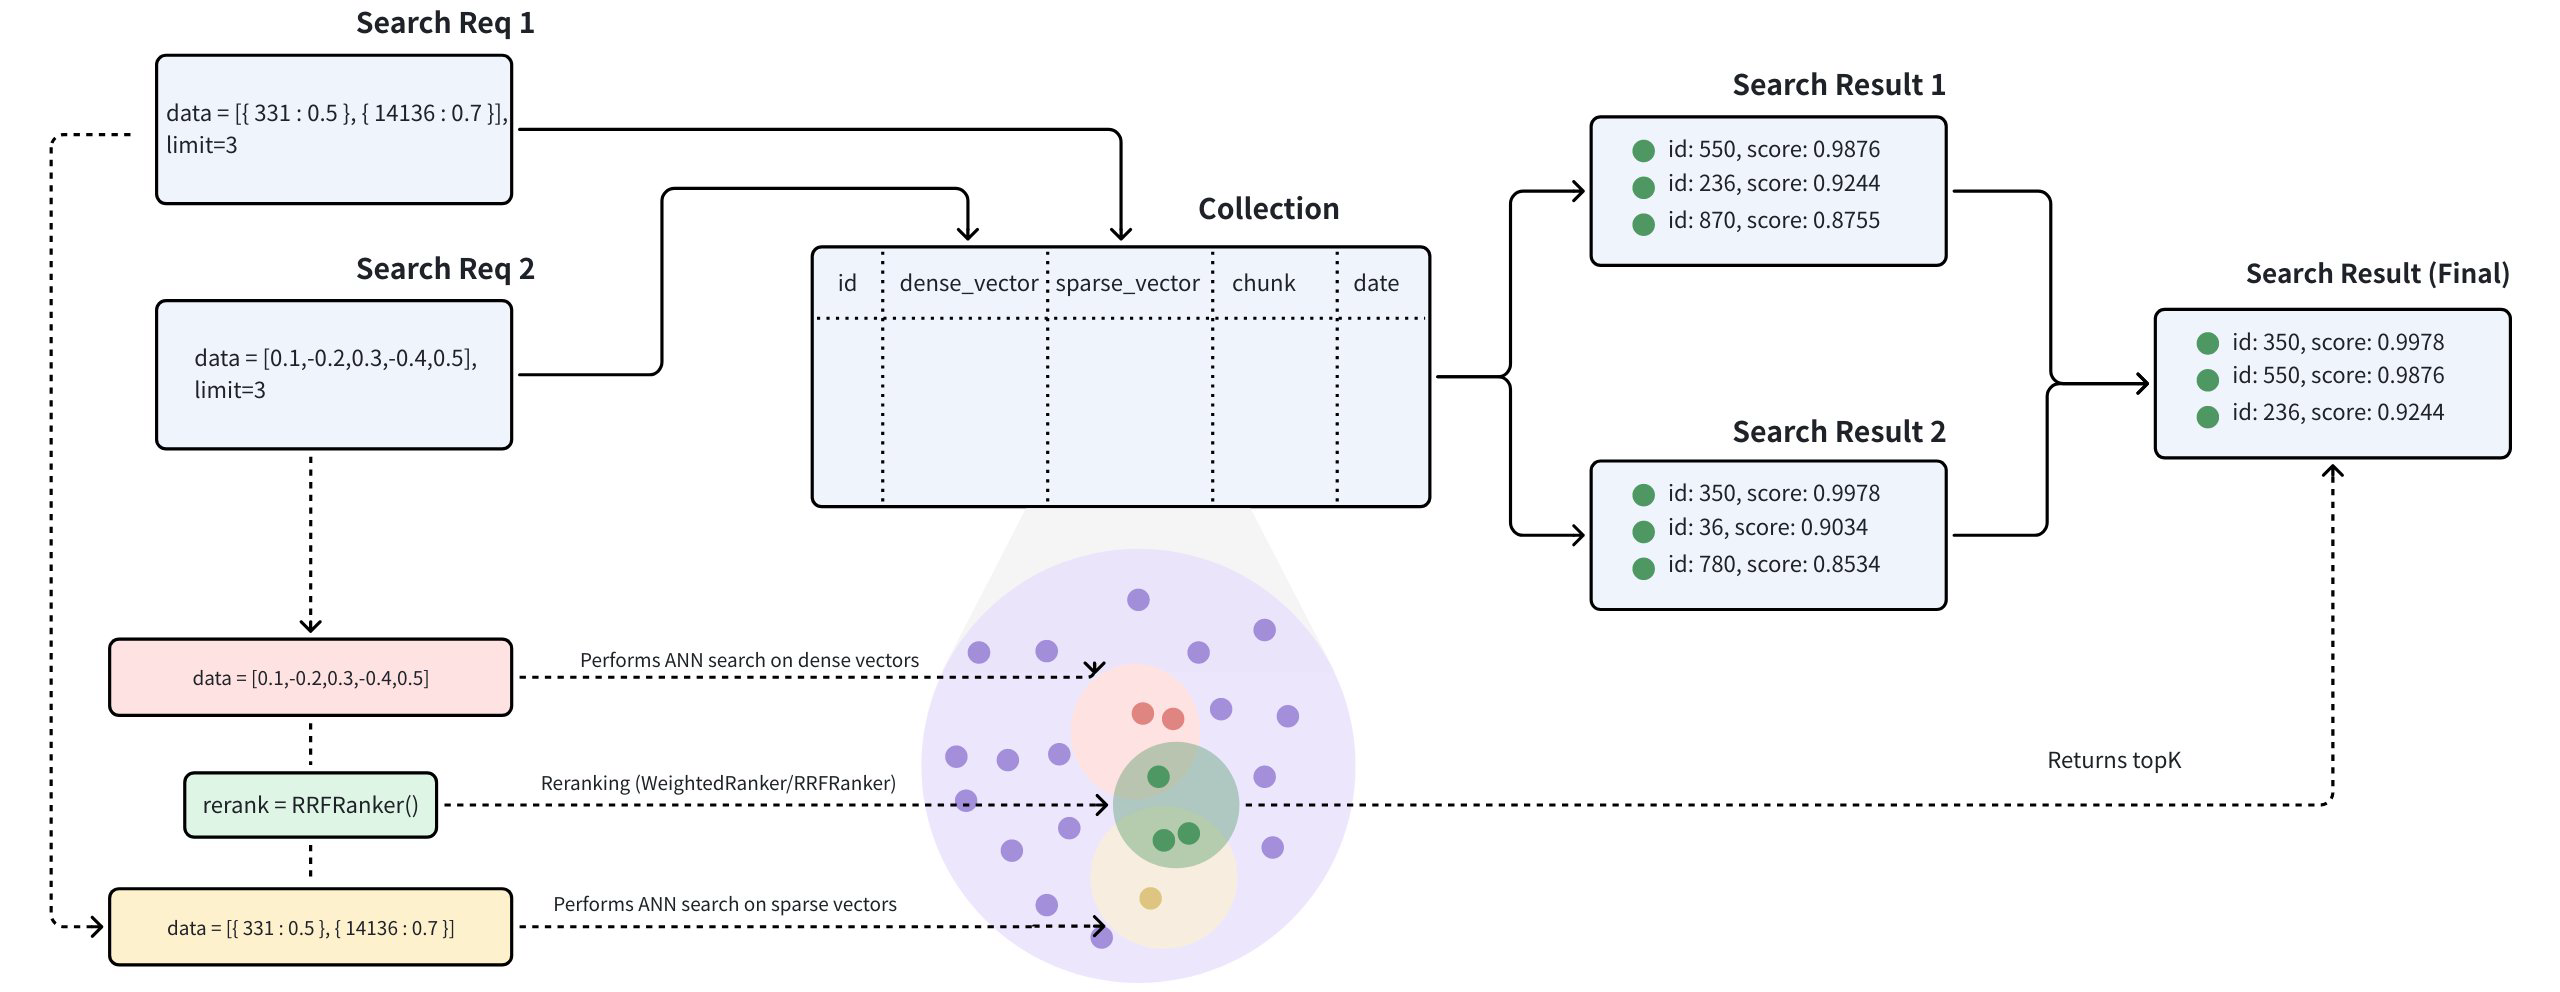 Fluxo de trabalho da pesquisa híbrida
A pesquisa híbrida multivetorial integra diferentes métodos de pesquisa ou abrange representações de várias modalidades:
Pesquisa de vetores esparsos e densos: os vetores densos são excelentes para captar relações semânticas, enquanto os vetores esparsos são altamente eficazes para a correspondência precisa de palavras-chave. A pesquisa híbrida combina estas abordagens para proporcionar tanto uma compreensão conceptual ampla como a relevância exata dos termos, melhorando assim os resultados da pesquisa. Ao tirar partido dos pontos fortes de cada método, a pesquisa híbrida supera as limitações das abordagens individuais, oferecendo um melhor desempenho para consultas complexas. Aqui está um guia mais detalhado sobre a recuperação híbrida que combina a pesquisa semântica com a pesquisa de texto completo.
Pesquisa vetorial multimodal: A pesquisa vetorial multimodal é uma técnica poderosa que permite pesquisar em vários tipos de dados, incluindo texto, imagens, áudio e outros. A principal vantagem desta abordagem é a sua capacidade de unificar diferentes modalidades numa experiência de pesquisa integrada e coesa. Por exemplo, na pesquisa de produtos, um utilizador pode introduzir uma consulta de texto para encontrar produtos descritos tanto por texto como por imagens. Ao combinar estas modalidades através de um método de pesquisa híbrida, é possível melhorar a precisão da pesquisa ou enriquecer os resultados da pesquisa.
Exemplo
Consideremos um caso de utilização do mundo real em que cada produto inclui uma descrição textual e uma imagem. Com base nos dados disponíveis, podemos realizar três tipos de pesquisas:
Pesquisa semântica de texto: isto envolve consultar a descrição textual do produto utilizando vetores densos. As incorporações de texto podem ser geradas utilizando modelos como o BERT e o Transformers ou serviços como o OpenAI.
Pesquisa de texto completo: aqui, pesquisamos a descrição textual do produto utilizando uma correspondência de palavras-chave com vetores esparsos. Para este efeito, podem ser utilizados algoritmos como o BM25 ou modelos de incorporação esparsa, tais como o BGE-M3 ou o SPLADE.
Pesquisa multimodal por imagem: Este método pesquisa a imagem através de uma consulta de texto com vetores densos. As incorporações de imagem podem ser geradas com modelos como o CLIP.
Este guia irá guiá-lo através de um exemplo de pesquisa híbrida multimodal que combina os métodos de pesquisa acima referidos, partindo da descrição textual bruta e das incorporações de imagem dos produtos. Iremos demonstrar como armazenar dados multivetoriais e realizar pesquisas híbridas com uma estratégia de reclassificação.
Criar uma coleção com vários campos vetoriais
O processo de criação de uma coleção envolve três etapas principais: definir o esquema da coleção, configurar os parâmetros do índice e criar a coleção.
Definir o esquema
Para a pesquisa híbrida multivectorial, devemos definir vários campos vetoriais dentro de um esquema de coleção. Para obter detalhes sobre os limites relativos ao número de campos vetoriais permitidos numa coleção, consulte os Limites da Zilliz Cloud. No entanto, se necessário, pode ajustar o proxy.maxVectorFieldNum para incluir até 10 campos vetoriais numa coleção, conforme necessário.
Este exemplo incorpora os seguintes campos no esquema:
id: Serve como chave primária para armazenar IDs de texto. Este campo é do tipo de dados `INT64`.text: Utilizado para armazenar conteúdo textual. Este campo é do tipo de dados «VARCHAR», com um comprimento máximo de 1 000 bytes. A opção «enable_analyzer» está definida como «True» para facilitar a pesquisa de texto completo.text_dense: Utilizado para armazenar vetores densos dos textos. Este campo é do tipo de dados `FLOAT_VECTOR`, com uma dimensão de vetor de 768.text_sparse: Utilizado para armazenar vetores esparsos dos textos. Este campo é do tipo de dadosSPARSE_FLOAT_VECTOR.image_dense: Utilizado para armazenar vetores densos das imagens dos produtos. Este campo é do tipo de dados `FLOAT_VETOR`, com uma dimensão de vetor de 512.
Uma vez que iremos utilizar o algoritmo BM25 integrado para realizar uma pesquisa de texto completo no campo de texto, é necessário adicionar o Milvus Function ao esquema. Para mais detalhes, consulte Pesquisa de Texto Completo.
from pymilvus import (
    MilvusClient, DataType, Function, FunctionType
)

client = MilvusClient(
    uri="http://localhost:19530",
    token="root:Milvus"
)

# Init schema with auto_id disabled
schema = client.create_schema(auto_id=False)

# Add fields to schema
schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True, description="product id")
schema.add_field(field_name="text", datatype=DataType.VARCHAR, max_length=1000, enable_analyzer=True, description="raw text of product description")
schema.add_field(field_name="text_dense", datatype=DataType.FLOAT_VECTOR, dim=768, description="text dense embedding")
schema.add_field(field_name="text_sparse", datatype=DataType.SPARSE_FLOAT_VECTOR, description="text sparse embedding auto-generated by the built-in BM25 function")
schema.add_field(field_name="image_dense", datatype=DataType.FLOAT_VECTOR, dim=512, description="image dense embedding")

# Add function to schema
bm25_function = Function(
    name="text_bm25_emb",
    input_field_names=["text"],
    output_field_names=["text_sparse"],
    function_type=FunctionType.BM25,
)
schema.add_function(bm25_function)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq.Function;

import java.util.*;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .token("root:Milvus")
        .build());

CreateCollectionReq.CollectionSchema schema = client.createSchema();

schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(false)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("text_dense")
        .dataType(DataType.FloatVector)
        .dimension(768)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("text_sparse")
        .dataType(DataType.SparseFloatVector)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("image_dense")
        .dataType(DataType.FloatVector)
        .dimension(512)
        .build());

schema.addFunction(Function.builder()
        .functionType(FunctionType.BM25)
        .name("text_bm25_emb")
        .inputFieldNames(Collections.singletonList("text"))
        .outputFieldNames(Collections.singletonList("text_sparse"))
        .build());
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

function := entity.NewFunction().
    WithName("text_bm25_emb").
    WithInputFields("text").
    WithOutputFields("text_sparse").
    WithType(entity.FunctionTypeBM25)

schema := entity.NewSchema()

schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true),
).WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithMaxLength(1000),
).WithField(entity.NewField().
    WithName("text_dense").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(768),
).WithField(entity.NewField().
    WithName("text_sparse").
    WithDataType(entity.FieldTypeSparseVector),
).WithField(entity.NewField().
    WithName("image_dense").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(512),
).WithFunction(function)
import { MilvusClient, DataType, FunctionType } from "@zilliz/milvus2-sdk-node";

const address = "http://localhost:19530";
const token = "root:Milvus";
const client = new MilvusClient({address, token});

// Define fields
const fields = [
    {
        name: "id",
        data_type: DataType.Int64,
        is_primary_key: true,
        auto_id: false
    },
    {
        name: "text",
        data_type: DataType.VarChar,
        max_length: 1000,
        enable_analyzer: true
    },
    {
        name: "text_dense",
        data_type: DataType.FloatVector,
        dim: 768
    },
    {
        name: "text_sparse",
        data_type: DataType.SparseFloatVector
    },
    {
        name: "image_dense",
        data_type: DataType.FloatVector,
        dim: 512
    }
];

// define function
const functions = [
    {
      name: "text_bm25_emb",
      description: "text bm25 function",
      type: FunctionType.BM25,
      input_field_names: ["text"],
      output_field_names: ["text_sparse"],
      params: {},
    },
];
export schema='{
        "autoId": false,
        "functions": [
            {
                "name": "text_bm25_emb",
                "type": "BM25",
                "inputFieldNames": ["text"],
                "outputFieldNames": ["text_sparse"],
                "params": {}
            }
        ],
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true
                }
            },
            {
                "fieldName": "text_dense",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "768"
                }
            },
            {
                "fieldName": "text_sparse",
                "dataType": "SparseFloatVector"
            },
            {
                "fieldName": "image_dense",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "512"
                }
            }
        ]
    }'
#include "milvus/MilvusClientV2.h"

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"http://localhost:19530", "root:Milvus"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

milvus::FunctionPtr function = std::make_shared<milvus::Function>("text_bm25_emb", milvus::FunctionType::BM25, "text bm25 function");
function->AddInputFieldName("text");
function->AddOutputFieldName("text_sparse");

milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->AddField({"id", milvus::DataType::INT64, "", true, false});
schema->AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR).WithMaxLength(1000).EnableAnalyzer(true));
schema->AddField(milvus::FieldSchema("text_dense", milvus::DataType::FLOAT_VECTOR).WithDimension(768));
schema->AddField({"text_sparse", milvus::DataType::SPARSE_FLOAT_VECTOR});
schema->AddField(milvus::FieldSchema("image_dense", milvus::DataType::FLOAT_VECTOR).WithDimension(512));
schema->AddFunction(function);
Criar índice
Após definir o esquema da coleção, o próximo passo é configurar os índices vetoriais e especificar as métricas de similaridade. No exemplo apresentado:
text_dense_index: é criado um índice do tipo «AUTOINDEX» com o tipo de métricIP» para o campo de vetor denso de texto.text_sparse_index: é utilizado um índice do tipo «SPARSE_INVERTED_INDEX» com o tipo de métrica «BM25» para o campo de vetores de texto esparso.image_dense_index: é criado um índice do tipo «AUTOINDEX» com o tipo de métrica «IP» para o campo vetorial denso de imagens.
Pode escolher outros tipos de índice, conforme necessário, para melhor se adequarem às suas necessidades e tipos de dados. Para mais informações sobre os tipos de índice suportados, consulte a documentação sobre os tipos de índice disponíveis.
# Prepare index parameters
index_params = client.prepare_index_params()

# Add indexes
index_params.add_index(
    field_name="text_dense",
    index_name="text_dense_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)

index_params.add_index(
    field_name="text_sparse",
    index_name="text_sparse_index",
    index_type="SPARSE_INVERTED_INDEX",
    metric_type="BM25",
    params={"inverted_index_algo": "DAAT_MAXSCORE"}, # or "DAAT_WAND" or "TAAT_NAIVE"
)

index_params.add_index(
    field_name="image_dense",
    index_name="image_dense_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)
import io.milvus.v2.common.IndexParam;
import java.util.*;

Map<String, Object> denseParams = new HashMap<>();

IndexParam indexParamForTextDense = IndexParam.builder()
        .fieldName("text_dense")
        .indexName("text_dense_index")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build();

Map<String, Object> sparseParams = new HashMap<>();
sparseParams.put("inverted_index_algo", "DAAT_MAXSCORE");
IndexParam indexParamForTextSparse = IndexParam.builder()
        .fieldName("text_sparse")
        .indexName("text_sparse_index")
        .indexType(IndexParam.IndexType.SPARSE_INVERTED_INDEX)
        .metricType(IndexParam.MetricType.BM25)
        .extraParams(sparseParams)
        .build();

IndexParam indexParamForImageDense = IndexParam.builder()
        .fieldName("image_dense")
        .indexName("image_dense_index")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build();

List<IndexParam> indexParams = new ArrayList<>();
indexParams.add(indexParamForTextDense);
indexParams.add(indexParamForTextSparse);
indexParams.add(indexParamForImageDense);
indexOption1 := milvusclient.NewCreateIndexOption("my_collection", "text_dense",
    index.NewAutoIndex(index.MetricType(entity.IP)))
indexOption2 := milvusclient.NewCreateIndexOption("my_collection", "text_sparse",
    index.NewSparseInvertedIndex(entity.BM25, 0.2))
indexOption3 := milvusclient.NewCreateIndexOption("my_collection", "image_dense",
    index.NewAutoIndex(index.MetricType(entity.IP)))
const index_params = [{
    field_name: "text_dense",
    index_name: "text_dense_index",
    index_type: "AUTOINDEX",
    metric_type: "IP"
},{
    field_name: "text_sparse",
    index_name: "text_sparse_index",
    index_type: "SPARSE_INVERTED_INDEX",
    metric_type: "BM25",
    params: {
      inverted_index_algo: "DAAT_MAXSCORE",
    }
},{
    field_name: "image_dense",
    index_name: "image_dense_index",
    index_type: "AUTOINDEX",
    metric_type: "IP"
}]
export indexParams='[
        {
            "fieldName": "text_dense",
            "metricType": "IP",
            "indexName": "text_dense_index",
            "indexType":"AUTOINDEX"
        },
        {
            "fieldName": "text_sparse",
            "metricType": "BM25",
            "indexName": "text_sparse_index",
            "indexType": "SPARSE_INVERTED_INDEX",
            "params":{"inverted_index_algo": "DAAT_MAXSCORE"}
        },
        {
            "fieldName": "image_dense",
            "metricType": "IP",
            "indexName": "image_dense_index",
            "indexType":"AUTOINDEX"
        }
    ]'
milvus::IndexDesc text_sparse_index("text_sparse", "text_sparse_index", milvus::IndexType::SPARSE_INVERTED_INDEX, milvus::MetricType::BM25);
text_sparse_index.AddExtraParam("inverted_index_algo", "DAAT_MAXSCORE");

std::vector<milvus::IndexDesc> indexes = {
    milvus::IndexDesc("text_dense", "text_dense_index", milvus::IndexType::AUTOINDEX, milvus::MetricType::IP),
    text_sparse_index,
    milvus::IndexDesc("image_dense", "image_dense_index", milvus::IndexType::AUTOINDEX, milvus::MetricType::IP),
};
Criar coleção
Crie uma coleção com o nome « demo » com o esquema da coleção e os índices configurados nos dois passos anteriores.
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
CreateCollectionReq createCollectionReq = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexParams)
        .build();
client.createCollection(createCollectionReq);
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption1, indexOption2, indexOption3))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
res = await client.createCollection({
    collection_name: "my_collection",
    fields: fields,
    functions: functions,
    index_params: index_params,
})
export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
status = client->CreateCollection(milvus::CreateCollectionRequest()
                                      .WithCollectionName("my_collection")
                                      .WithCollectionSchema(schema)
                                      .WithIndexes(std::move(indexes)));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
Inserir dados
Esta secção insere dados na coleção « my_collection » com base no esquema definido anteriormente. Durante a inserção, certifique-se de que todos os campos, exceto aqueles com valores gerados automaticamente, são preenchidos com dados no formato correto. Neste exemplo:
id: um número inteiro que representa o ID do produtotext: uma cadeia de caracteres contendo a descrição do produtotext_dense: uma lista de 768 valores de ponto flutuante que representam a incorporação densa da descrição do textoimage_dense: uma lista de 512 valores de ponto flutuante que representam a incorporação densa da imagem do produto
Pode utilizar modelos iguais ou diferentes para gerar incorporações densas para cada campo. Neste exemplo, as duas incorporações densas têm dimensões diferentes, o que sugere que foram geradas por modelos distintos. Ao definir cada pesquisa posteriormente, certifique-se de que utiliza o modelo correspondente para gerar a incorporação de consulta adequada.
Uma vez que este exemplo utiliza a função BM25 incorporada para gerar incorporações esparsas a partir do campo de texto, não é necessário fornecer vetores esparsos manualmente. No entanto, se optar por não utilizar o BM25, terá de pré-calcular e fornecer as incorporações esparsas por si próprio.
import random

# Generate example vectors
def generate_dense_vector(dim):
    return [random.random() for _ in range(dim)]

data=[
    {
        "id": 0,
        "text": "Red cotton t-shirt with round neck",
        "text_dense": generate_dense_vector(768),
        "image_dense": generate_dense_vector(512)
    },
    {
        "id": 1,
        "text": "Wireless noise-cancelling over-ear headphones",
        "text_dense": generate_dense_vector(768),
        "image_dense": generate_dense_vector(512)
    },
    {
        "id": 2,
        "text": "Stainless steel water bottle, 500ml",
        "text_dense": generate_dense_vector(768),
        "image_dense": generate_dense_vector(512)
    }
]

res = client.insert(
    collection_name="my_collection",
    data=data
)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;
import io.milvus.v2.service.vector.response.InsertResp;

Gson gson = new Gson();
JsonObject row1 = new JsonObject();
row1.addProperty("id", 0);
row1.addProperty("text", "Red cotton t-shirt with round neck");
row1.add("text_dense", gson.toJsonTree(new float[]{0.3580376395471989f, -0.6023495712049978f, 0.18414012509913835f, ...}));
row1.add("image_dense", gson.toJsonTree(new float[]{0.6366019600530924f, -0.09323198122475052f, ...}));

JsonObject row2 = new JsonObject();
row2.addProperty("id", 1);
row2.addProperty("text", "Wireless noise-cancelling over-ear headphones");
row2.add("text_dense", gson.toJsonTree(new float[]{0.19886812562848388f, 0.06023560599112088f, 0.6976963061752597f, ...}));
row2.add("image_dense", gson.toJsonTree(new float[]{0.6414180010301553f, 0.8976979978567611f, ...}));

JsonObject row3 = new JsonObject();
row3.addProperty("id", 2);
row3.addProperty("text", "Stainless steel water bottle, 500ml");
row3.add("text_dense", gson.toJsonTree(new float[]{0.43742130801983836f, -0.5597502546264526f, 0.6457887650909682f, ...}));
row3.add("image_dense", gson.toJsonTree(new float[]{-0.6901259768402174f, 0.6100500332193755f, ...}));

List<JsonObject> data = Arrays.asList(row1, row2, row3);
InsertReq insertReq = InsertReq.builder()
        .collectionName("my_collection")
        .data(data)
        .build();

InsertResp insertResp = client.insert(insertReq);
_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("my_collection").
    WithInt64Column("id", []int64{0, 1, 2}).
    WithVarcharColumn("text", []string{
        "Red cotton t-shirt with round neck",
        "Wireless noise-cancelling over-ear headphones",
        "Stainless steel water bottle, 500ml",
    }).
    WithFloatVectorColumn("text_dense", 768, [][]float32{
        {0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...},
        {0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...},
        {0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...},
    }).
    WithFloatVectorColumn("image_dense", 512, [][]float32{
        {0.6366019600530924, -0.09323198122475052, ...},
        {0.6414180010301553, 0.8976979978567611, ...},
        {-0.6901259768402174, 0.6100500332193755, ...},
    }))
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
const { MilvusClient, DataType } = require("@zilliz/milvus2-sdk-node")

var data = [
    {id: 0, text: "Red cotton t-shirt with round neck" , text_dense: [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...], image_dense: [0.6366019600530924, -0.09323198122475052, ...]},
    {id: 1, text: "Wireless noise-cancelling over-ear headphones" , text_dense: [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...], image_dense: [0.6414180010301553, 0.8976979978567611, ...]},
    {id: 2, text: "Stainless steel water bottle, 500ml" , text_dense: [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...], image_dense: [-0.6901259768402174, 0.6100500332193755, ...]}
]

var res = await client.insert({
    collection_name: "my_collection",
    data: data,
})
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "data": [
        {"id": 0, "text": "Red cotton t-shirt with round neck" , "text_dense": [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...], "image_dense": [0.6366019600530924, -0.09323198122475052, ...]},
        {"id": 1, "text": "Wireless noise-cancelling over-ear headphones" , "text_dense": [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...], "image_dense": [0.6414180010301553, 0.8976979978567611, ...]},
        {"id": 2, "text": "Stainless steel water bottle, 500ml" , "text_dense": [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...], "image_dense": [-0.6901259768402174, 0.6100500332193755, ...]}
    ],
    "collectionName": "my_collection"
}'
#include <random>

std::vector<float>
GenerateFloatVector(int dimension) {
    std::random_device rd;
    std::mt19937 ran(rd());
    std::uniform_real_distribution<float> float_gen(0.0, 1.0);
    std::vector<float> vector(dimension);
    for (auto d = 0; d < dimension; ++d) {
        vector[d] = float_gen(ran);
    }
    return vector;
}

milvus::EntityRows data = {
    {{"id", 0}, {"text", "Red cotton t-shirt with round neck"}, {"text_dense", GenerateFloatVector(768)}, {"image_dense", GenerateFloatVector(512)}},
    {{"id", 1}, {"text", "Wireless noise-cancelling over-ear headphones"}, {"text_dense", GenerateFloatVector(768)}, {"image_dense", GenerateFloatVector(512)}},
    {{"id", 2}, {"text", "Stainless steel water bottle, 500ml"}, {"text_dense", GenerateFloatVector(768)}, {"image_dense", GenerateFloatVector(512)}}
};

milvus::InsertResponse response;
status = client->Insert(milvus::InsertRequest()
                            .WithCollectionName("my_collection")
                            .WithRowsData(std::move(data)),
                        response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
Efetuar uma pesquisa híbrida
Passo 1: Criar várias instâncias de AnnSearchRequest
A Pesquisa Híbrida é implementada através da criação de várias instâncias de ` AnnSearchRequest ` na função ` hybrid_search() `, em que cada ` AnnSearchRequest ` representa um pedido de pesquisa ANN básico para um campo vetorial específico. Por conseguinte, antes de realizar uma Pesquisa Híbrida, é necessário criar uma instância de ` AnnSearchRequest ` para cada campo vetorial.
Além disso, ao configurar o parâmetro expr numa AnnSearchRequest, pode definir as condições de filtragem para a sua pesquisa híbrida. Consulte «Pesquisa Filtrada » e «Explicação da Filtragem».
Na Pesquisa Híbrida, cada « AnnSearchRequest » suporta apenas um conjunto de dados de consulta.
Para demonstrar as capacidades de vários campos vetoriais de pesquisa, iremos construir três pedidos de pesquisa « AnnSearchRequest » utilizando uma consulta de exemplo. Iremos também utilizar os seus vetores densos pré-calculados para este processo. Os pedidos de pesquisa terão como alvo os seguintes campos vetoriais:
text_densepara a pesquisa semântica de texto, permitindo a compreensão contextual e a recuperação com base no significado, em vez da correspondência direta de palavras-chave;text_sparsepara pesquisa de texto completo ou correspondência de palavras-chave, com foco em correspondências exatas de palavras ou frases dentro do texto.image_densepara pesquisa multimodal de texto para imagem, para recuperar imagens de produtos relevantes com base no conteúdo semântico da consulta.
from pymilvus import AnnSearchRequest

query_text = "white headphones, quiet and comfortable"
query_dense_vector = generate_dense_vector(768)
query_multimodal_vector = generate_dense_vector(512)

# text semantic search (dense)
search_param_1 = {
    "data": [query_dense_vector],
    "anns_field": "text_dense",
    "param": {"nprobe": 10},
    "limit": 2
}
request_1 = AnnSearchRequest(**search_param_1)

# full-text search (sparse)
search_param_2 = {
    "data": [query_text],
    "anns_field": "text_sparse",
    "param": {},
    "limit": 2
}
request_2 = AnnSearchRequest(**search_param_2)

# text-to-image search (multimodal)
search_param_3 = {
    "data": [query_multimodal_vector],
    "anns_field": "image_dense",
    "param": {"nprobe": 10},
    "limit": 2
}
request_3 = AnnSearchRequest(**search_param_3)

reqs = [request_1, request_2, request_3]
import io.milvus.v2.service.vector.request.AnnSearchReq;
import io.milvus.v2.service.vector.request.data.BaseVector;
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.request.data.SparseFloatVec;
import io.milvus.v2.service.vector.request.data.EmbeddedText;

float[] queryDense = new float[]{-0.0475336798f,  0.0521207601f,  0.0904406682f, ...};
float[] queryMultimodal = new float[]{0.0158298651f, 0.5264158340f, ...};

List<BaseVector> queryTexts = Collections.singletonList(new EmbeddedText("white headphones, quiet and comfortable"));
List<BaseVector> queryDenseVectors = Collections.singletonList(new FloatVec(queryDense));
List<BaseVector> queryMultimodalVectors = Collections.singletonList(new FloatVec(queryMultimodal));

List<AnnSearchReq> searchRequests = new ArrayList<>();
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_dense")
        .vectors(queryDenseVectors)
        .params("{\"nprobe\": 10}")
        .topK(2)
        .build());
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_sparse")
        .vectors(queryTexts)
        .topK(2)
        .build());
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("image_dense")
        .vectors(queryMultimodalVectors)
        .params("{\"nprobe\": 10}")
        .topK(2)
        .build());
queryText := entity.Text("white headphones, quiet and comfortable")
queryVector := []float32{0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...}
queryMultimodalVector := []float32{0.015829865178701663, 0.5264158340734488, ...}

request1 := milvusclient.NewAnnRequest("text_dense", 2, entity.FloatVector(queryVector)).
    WithAnnParam(index.NewIvfAnnParam(10))

annParam := index.NewSparseAnnParam()
annParam.WithDropRatio(0.2)
request2 := milvusclient.NewAnnRequest("text_sparse", 2, queryText).
    WithAnnParam(annParam)

request3 := milvusclient.NewAnnRequest("image_dense", 2, entity.FloatVector(queryMultimodalVector)).
    WithAnnParam(index.NewIvfAnnParam(10))
const query_text = "white headphones, quiet and comfortable"
const query_vector = [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...]
const query_multimodal_vector = [0.015829865178701663, 0.5264158340734488, ...]

const search_param_1 = {
    "data": query_vector,
    "anns_field": "text_dense",
    "params": {"nprobe": 10},
    "limit": 2
}

const search_param_2 = {
    "data": query_text,
    "anns_field": "text_sparse",
    "limit": 2
}

const search_param_3 = {
    "data": query_multimodal_vector,
    "anns_field": "image_dense",
    "params": {"nprobe": 10},
    "limit": 2
}
export req='[
    {
        "data": [[0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...]],
        "annsField": "text_dense",
        "params": {"nprobe": 10},
        "limit": 2
    },
    {
        "data": ["white headphones, quiet and comfortable"],
        "annsField": "text_sparse",
        "limit": 2
    },
    {
        "data": [[0.015829865178701663, 0.5264158340734488, ...]],
        "annsField": "image_dense",
        "params": {"nprobe": 10},
        "limit": 2
    }
 ]'
auto query_text = "white headphones, quiet and comfortable";
auto query_dense_vector = GenerateFloatVector(768);
auto query_multimodal_vector = GenerateFloatVector(512);

// text semantic search (dense)
auto sub_req1 = milvus::SubSearchRequest()
                    .AddFloatVector(query_dense_vector)
                    .WithAnnsField("text_dense")
                    .WithLimit(2);
sub_req1.AddExtraParam("nprobe", "10");

// full-text search (sparse)
auto sub_req2 = milvus::SubSearchRequest()
                    .AddEmbeddedText(query_text)
                    .WithAnnsField("text_sparse")
                    .WithLimit(2);

// text-to-image search (multimodal)
auto sub_req3 = milvus::SubSearchRequest()
                    .AddFloatVector(query_multimodal_vector)
                    .WithAnnsField("image_dense")
                    .WithLimit(2);
sub_req3.AddExtraParam("nprobe", "10");
Dado que o parâmetro limit está definido para 2, cada AnnSearchRequest devolve 2 resultados de pesquisa. Neste exemplo, são criadas 3 instâncias de AnnSearchRequest, resultando num total de 6 resultados de pesquisa.
Passo 2: Configurar uma estratégia de reclassificação
Para fundir e reordenar os conjuntos de resultados de pesquisa da ANN, é essencial selecionar uma estratégia de reordenação adequada. O Milvus oferece vários tipos de estratégias de reordenação. Para mais detalhes sobre estes mecanismos de reordenação, consulte o «Weighted Ranker » ou o «RRF Ranker».
Neste exemplo, uma vez que não há ênfase particular em consultas de pesquisa específicas, iremos avançar com a estratégia RRFRanker.
ranker = Function(
    name="rrf",
    input_field_names=[], # Must be an empty list
    function_type=FunctionType.RERANK,
    params={
        "reranker": "rrf",
        "k": 100  # Optional
    }
)
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.CreateCollectionReq.Function;

Function ranker = Function.builder()
        .name("rrf")
        .functionType(FunctionType.RERANK)
        .param("reranker", "rrf")
        .param("k", "100")
        .build();
const rerank = {
  name: 'rrf',
  description: 'bm25 function',
  type: FunctionType.RERANK,
  input_field_names: [],
  params: {
      "reranker": "rrf",
      "k": 100
  },
};
reranker := milvusclient.NewRRFReranker().WithK(100)
# Restful
export rerank='{"k": 100}'
auto ranker = std::make_shared<milvus::RRFRerank>(100);
Passo 3: Realizar uma pesquisa híbrida
Antes de iniciar uma Pesquisa Híbrida, certifique-se de que a coleção está carregada. Se algum campo vetorial dentro da coleção não tiver um índice ou não estiver carregado na memória, ocorrerá um erro ao executar o método de Pesquisa Híbrida.
res = client.hybrid_search(
    collection_name="my_collection",
    reqs=reqs,
    ranker=ranker,
    limit=2
)
for hits in res:
    print("TopK results:")
    for hit in hits:
        print(hit)
import io.milvus.v2.common.ConsistencyLevel;
import io.milvus.v2.service.vector.request.HybridSearchReq;
import io.milvus.v2.service.vector.response.SearchResp;

HybridSearchReq hybridSearchReq = HybridSearchReq.builder()
        .collectionName("my_collection")
        .searchRequests(searchRequests)
        .ranker(ranker)
        .topK(2)
        .build();

SearchResp searchResp = client.hybridSearch(hybridSearchReq);
resultSets, err := client.HybridSearch(ctx, milvusclient.NewHybridSearchOption(
    "my_collection",
    2,
    request1,
    request2,
    request3,
).WithReranker(reranker))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
}
const { MilvusClient, DataType } = require("@zilliz/milvus2-sdk-node")

res = await client.loadCollection({
    collection_name: "my_collection"
})

import { MilvusClient, RRFRanker, WeightedRanker } from '@zilliz/milvus2-sdk-node';

const search = await client.search({
  collection_name: "my_collection",
  data: [search_param_1, search_param_2, search_param_3],
  limit: 2,
  rerank: rerank
});
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/hybrid_search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"search\": ${req},
    \"rerank\": {
        \"strategy\":\"rrf\",
        \"params\": ${rerank}
    },
    \"limit\": 2
}"
auto request = milvus::HybridSearchRequest()
                   .WithCollectionName("my_collection")
                   .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(sub_req1)))
                   .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(sub_req2)))
                   .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(sub_req3)))
                   .WithRerank(ranker)
                   .WithLimit(2);

milvus::SearchResponse response;
status = client->HybridSearch(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

for (auto& result : response.Results().Results()) {
    std::cout << "TopK results:" << std::endl;
    milvus::EntityRows output_rows;
    status = result.OutputRows(output_rows);
    for (const auto& row : output_rows) {
        std::cout << "\t" << row << std::endl;
    }
}
Segue-se o resultado:
["['id: 1, distance: 0.006047376897186041, entity: {}', 'id: 2, distance: 0.006422005593776703, entity: {}']"]
Com o parâmetro « limit=2 » especificado para a Pesquisa Híbrida, o Milvus irá reclassificar os seis resultados obtidos nas três pesquisas. Por fim, serão apresentados apenas os dois resultados mais semelhantes.
Utilização avançada
Definir temporariamente um fuso horário para uma pesquisa híbrida
Se a sua coleção tiver um campo « TIMESTAMPTZ », pode substituir temporariamente o fuso horário predefinido da base de dados ou da coleção para uma única operação, definindo o parâmetro « timezone » na chamada de pesquisa híbrida. Isto controla a forma como os valores « TIMESTAMPTZ » são apresentados e comparados durante a operação.
O valor de ` timezone ` deve ser um identificador de fuso horário IANA válido (por exemplo, Asia/Shanghai, America/Chicago ou UTC). Para obter detalhes sobre como utilizar o campo ` TIMESTAMPTZ `, consulte o campo `TIMESTAMPTZ`.
O exemplo abaixo mostra como definir temporariamente um fuso horário para uma operação de pesquisa híbrida:
res = client.hybrid_search(
    collection_name="my_collection",
    reqs=reqs,
    ranker=ranker,
    limit=2,
    timezone="America/Havana",
)
List<AnnSearchReq> tzRequests = new ArrayList<>();
tzRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_dense")
        .vectors(queryDenseVectors)
        .params("{\"nprobe\": 10}")
        .topK(2)
        .timezone("America/Havana")
        .build());
tzRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_sparse")
        .vectors(queryTexts)
        .topK(2)
        .timezone("America/Havana")
        .build());
tzRequests.add(AnnSearchReq.builder()
        .vectorFieldName("image_dense")
        .vectors(queryMultimodalVectors)
        .params("{\"nprobe\": 10}")
        .topK(2)
        .timezone("America/Havana")
        .build());

HybridSearchReq tzHybridSearchReq = HybridSearchReq.builder()
        .collectionName("my_collection")
        .searchRequests(tzRequests)
        .ranker(ranker)
        .topK(2)
        .build();

SearchResp tzSearchResp = client.hybridSearch(tzHybridSearchReq);
tzRequest1 := milvusclient.NewAnnRequest("text_dense", 2, entity.FloatVector(queryVector)).
    WithAnnParam(index.NewIvfAnnParam(10)).
    WithSearchParam("timezone", "America/Havana")

tzRequest2 := milvusclient.NewAnnRequest("text_sparse", 2, queryText).
    WithAnnParam(annParam).
    WithSearchParam("timezone", "America/Havana")

tzRequest3 := milvusclient.NewAnnRequest("image_dense", 2, entity.FloatVector(queryMultimodalVector)).
    WithAnnParam(index.NewIvfAnnParam(10)).
    WithSearchParam("timezone", "America/Havana")

resultSets, err = client.HybridSearch(ctx, milvusclient.NewHybridSearchOption(
    "my_collection",
    2,
    tzRequest1,
    tzRequest2,
    tzRequest3,
).WithReranker(reranker))
res = await client.search({
  collection_name: "my_collection",
  data: [
    { ...search_param_1, params: { "nprobe": 10, timezone: "America/Havana" } },
    { ...search_param_2, params: { timezone: "America/Havana" } },
    { ...search_param_3, params: { "nprobe": 10, timezone: "America/Havana" } },
  ],
  limit: 2,
  rerank: rerank
});
# restful
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/hybrid_search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
-d '{
    "collectionName": "my_collection",
    "search": [
        {
            "data": [[0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...]],
            "annsField": "text_dense",
            "params": {"nprobe": 10, "timezone": "America/Havana"},
            "limit": 2
        },
        {
            "data": ["white headphones, quiet and comfortable"],
            "annsField": "text_sparse",
            "params": {"timezone": "America/Havana"},
            "limit": 2
        },
        {
            "data": [[0.015829865178701663, 0.5264158340734488, ...]],
            "annsField": "image_dense",
            "params": {"nprobe": 10, "timezone": "America/Havana"},
            "limit": 2
        }
    ],
    "rerank": {
        "strategy": "rrf",
        "params": {"k": 100}
    },
    "limit": 2
}'
auto tz_req1 = milvus::SubSearchRequest()
                   .AddFloatVector(query_dense_vector)
                   .WithAnnsField("text_dense")
                   .WithTimezone("America/Havana")
                   .WithLimit(2);
tz_req1.AddExtraParam("nprobe", "10");

auto tz_req2 = milvus::SubSearchRequest()
                   .AddEmbeddedText(query_text)
                   .WithAnnsField("text_sparse")
                   .WithTimezone("America/Havana")
                   .WithLimit(2);

auto tz_req3 = milvus::SubSearchRequest()
                   .AddFloatVector(query_multimodal_vector)
                   .WithAnnsField("image_dense")
                   .WithTimezone("America/Havana")
                   .WithLimit(2);
tz_req3.AddExtraParam("nprobe", "10");

auto tz_request = milvus::HybridSearchRequest()
                      .WithCollectionName("my_collection")
                      .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(tz_req1)))
                      .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(tz_req2)))
                      .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(tz_req3)))
                      .WithRerank(ranker)
                      .WithLimit(2);

milvus::SearchResponse tz_response;
status = client->HybridSearch(tz_request, tz_response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
