

다중 벡터 하이브리드 검색
많은 응용 분야에서, 객체는 제목이나 설명과 같은 다양한 정보 세트나 텍스트, 이미지, 오디오와 같은 여러 모달리티를 통해 검색될 수 있습니다. 예를 들어, 텍스트와 이미지가 포함된 트윗은 텍스트나 이미지 중 어느 한쪽이 검색 쿼리의 의미와 일치할 경우 검색 대상이 됩니다. 하이브리드 검색은 이러한 다양한 영역에 걸친 검색을 결합하여 검색 경험을 향상시킵니다. Milvus는 여러 벡터 필드에 대한 검색을 허용하고, 여러 개의 근사 최인접 이웃(ANN) 검색을 동시에 수행함으로써 이를 지원합니다. 다중 벡터 하이브리드 검색은 텍스트와 이미지를 모두 검색하거나, 동일한 객체를 설명하는 여러 텍스트 필드를 검색하거나, 검색 품질을 높이기 위해 밀집 벡터와 희소 벡터를 함께 검색하려는 경우에 특히 유용합니다.
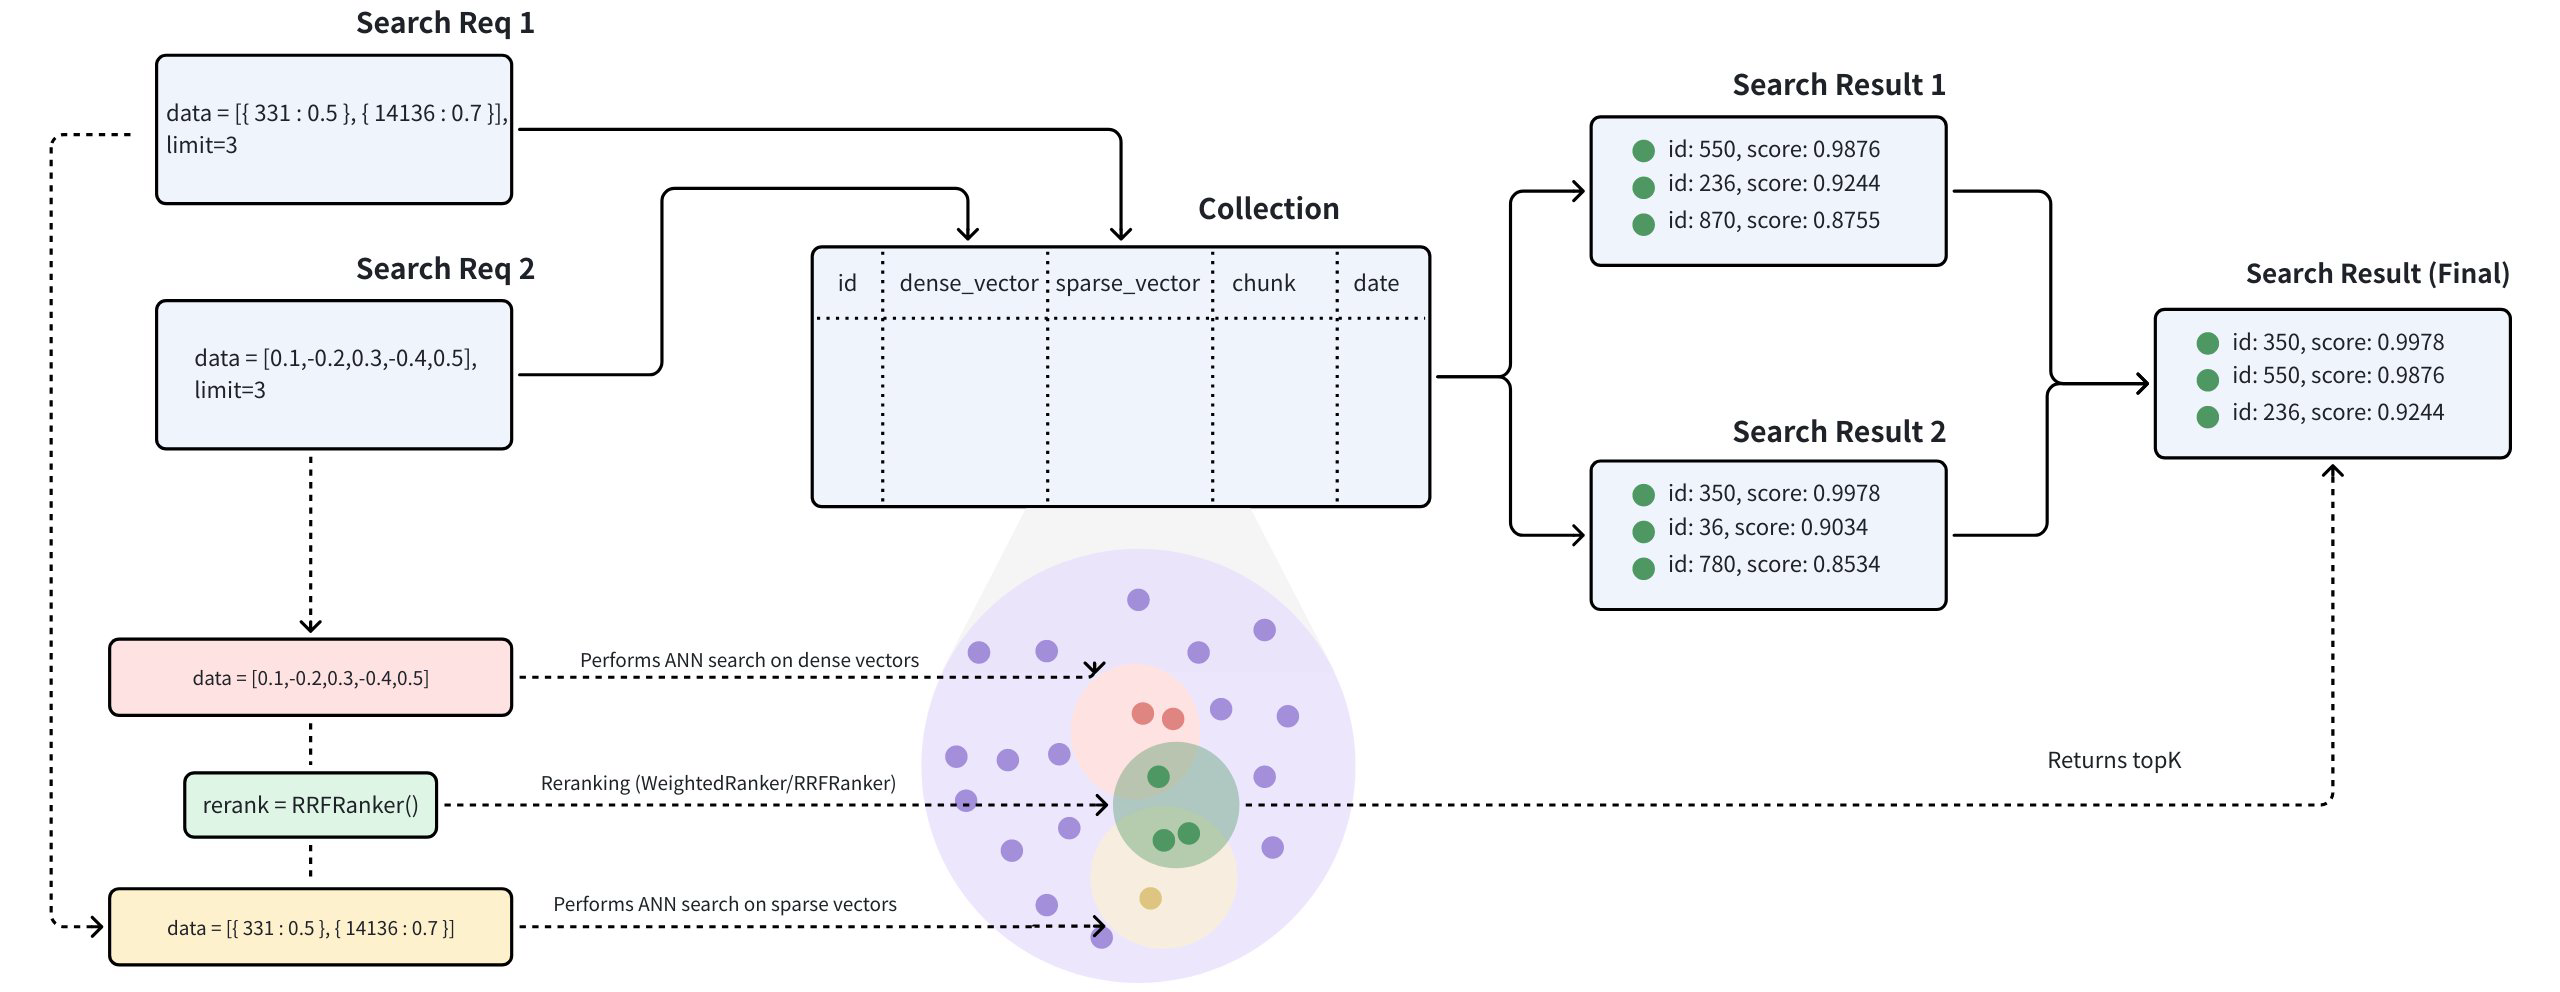 하이브리드 검색 워크플로우
다중 벡터 하이브리드 검색은 서로 다른 검색 방법을 통합하거나 다양한 모달리티의 임베딩을 아우릅니다:
희소-밀집 벡터 검색: 밀집 벡터는 의미적 관계를 포착하는 데 탁월한 반면, 희소 벡터는 정확한 키워드 일치에 매우 효과적입니다. 하이브리드 검색은 이러한 접근 방식을 결합하여 광범위한 개념적 이해와 정확한 용어 관련성을 모두 제공함으로써 검색 결과를 향상시킵니다. 각 방법의 장점을 활용함으로써 하이브리드 검색은 개별 접근 방식의 한계를 극복하고, 복잡한 쿼리에 대해 더 나은 성능을 제공합니다. 다음은 의미 검색과 전체 텍스트 검색을 결합한 하이브리드 검색에 대한 보다 자세한 가이드입니다.
다중 모달 벡터 검색: 다중 모달 벡터 검색은 텍스트, 이미지, 오디오 등 다양한 데이터 유형을 아우르는 검색을 가능하게 하는 강력한 기술입니다. 이 접근 방식의 주요 장점은 서로 다른 모달리티를 통합하여 매끄럽고 일관된 검색 경험을 제공한다는 점입니다. 예를 들어, 상품 검색에서 사용자는 텍스트와 이미지로 모두 설명된 상품을 찾기 위해 텍스트 쿼리를 입력할 수 있습니다. 하이브리드 검색 방식을 통해 이러한 모달리티를 결합함으로써 검색 정확도를 높이거나 검색 결과를 더욱 풍부하게 만들 수 있습니다.
예시
각 제품에 텍스트 설명과 이미지가 포함된 실제 사용 사례를 살펴보겠습니다. 이용 가능한 데이터를 바탕으로 다음 세 가지 유형의 검색을 수행할 수 있습니다:
의미론적 텍스트 검색: 이는 밀집 벡터를 사용하여 제품의 텍스트 설명을 검색하는 방식입니다. 텍스트 임베딩은 BERT 및 Transformers와 같은 모델이나 OpenAI와 같은 서비스를 통해 생성할 수 있습니다.
전체 텍스트 검색: 이 경우, 스파스 벡터를 활용한 키워드 매칭을 통해 제품의 텍스트 설명을 검색합니다. 이를 위해 BM25와 같은 알고리즘이나 BGE-M3, SPLADE와 같은 스파스 임베딩 모델을 활용할 수 있습니다.
다중 모달 이미지 검색: 이 방법은 밀집 벡터를 활용한 텍스트 쿼리를 통해 이미지를 검색합니다. 이미지 임베딩은 CLIP과 같은 모델을 사용하여 생성할 수 있습니다.
이 가이드에서는 제품의 원본 텍스트 설명과 이미지 임베딩을 바탕으로, 위의 검색 방법을 결합한 다중 모달 하이브리드 검색의 예시를 단계별로 안내합니다. 다중 벡터 데이터를 저장하고 재순위 지정 전략을 통해 하이브리드 검색을 수행하는 방법을 시연할 것입니다.
여러 벡터 필드가 포함된 컬렉션 생성
컬렉션을 생성하는 과정에는 컬렉션 스키마 정의, 인덱스 매개변수 구성, 컬렉션 생성이라는 세 가지 주요 단계가 포함됩니다.
스키마 정의
다중 벡터 하이브리드 검색을 위해서는 컬렉션 스키마 내에 여러 벡터 필드를 정의해야 합니다. 컬렉션에 허용되는 벡터 필드 수의 제한에 대한 자세한 내용은 Zilliz Cloud 사용 제한을 참조하십시오. 그러나 필요한 경우, proxy.maxVectorFieldNum 조정하여 필요에 따라 컬렉션에 최대 10개의 벡터 필드를 포함시킬 수 있습니다.
이 예제에서는 다음 필드를 스키마에 포함합니다:
id: 텍스트 ID를 저장하기 위한 기본 키 역할을 합니다. 이 필드의 데이터 유형은 `INT64`입니다.text: 텍스트 콘텐츠를 저장하는 데 사용됩니다. 이 필드의 데이터 유형은 `VARCHAR`이며 최대 길이는 1000바이트입니다. 전체 텍스트 검색을 용이하게 하기 위해 `enable_analyzer` 옵션은 `True`로 설정되어 있습니다.text_dense: 텍스트의 조밀 벡터를 저장하는 데 사용됩니다. 이 필드는 데이터 유형이 `FLOAT_VECTOR`이며, 벡터 차원은 768입니다.text_sparse: 텍스트의 스파스 벡터를 저장하는 데 사용됩니다. 이 필드의 데이터 유형은SPARSE_FLOAT_VECTOR입니다.image_dense: 상품 이미지의 밀집 벡터를 저장하는 데 사용됩니다. 이 필드는 벡터 차원이 512인FLOAT_VETOR데이터 유형입니다.
텍스트 필드에 대해 내장된 BM25 알고리즘을 사용하여 전체 텍스트 검색을 수행할 예정이므로, 스키마에 Milvus Function 를 추가해야 합니다. 자세한 내용은 전체 텍스트 검색을 참조하십시오.
from pymilvus import (
    MilvusClient, DataType, Function, FunctionType
)

client = MilvusClient(
    uri="http://localhost:19530",
    token="root:Milvus"
)

# Init schema with auto_id disabled
schema = client.create_schema(auto_id=False)

# Add fields to schema
schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True, description="product id")
schema.add_field(field_name="text", datatype=DataType.VARCHAR, max_length=1000, enable_analyzer=True, description="raw text of product description")
schema.add_field(field_name="text_dense", datatype=DataType.FLOAT_VECTOR, dim=768, description="text dense embedding")
schema.add_field(field_name="text_sparse", datatype=DataType.SPARSE_FLOAT_VECTOR, description="text sparse embedding auto-generated by the built-in BM25 function")
schema.add_field(field_name="image_dense", datatype=DataType.FLOAT_VECTOR, dim=512, description="image dense embedding")

# Add function to schema
bm25_function = Function(
    name="text_bm25_emb",
    input_field_names=["text"],
    output_field_names=["text_sparse"],
    function_type=FunctionType.BM25,
)
schema.add_function(bm25_function)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq.Function;

import java.util.*;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .token("root:Milvus")
        .build());

CreateCollectionReq.CollectionSchema schema = client.createSchema();

schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(false)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("text_dense")
        .dataType(DataType.FloatVector)
        .dimension(768)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("text_sparse")
        .dataType(DataType.SparseFloatVector)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("image_dense")
        .dataType(DataType.FloatVector)
        .dimension(512)
        .build());

schema.addFunction(Function.builder()
        .functionType(FunctionType.BM25)
        .name("text_bm25_emb")
        .inputFieldNames(Collections.singletonList("text"))
        .outputFieldNames(Collections.singletonList("text_sparse"))
        .build());
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

function := entity.NewFunction().
    WithName("text_bm25_emb").
    WithInputFields("text").
    WithOutputFields("text_sparse").
    WithType(entity.FunctionTypeBM25)

schema := entity.NewSchema()

schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true),
).WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithMaxLength(1000),
).WithField(entity.NewField().
    WithName("text_dense").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(768),
).WithField(entity.NewField().
    WithName("text_sparse").
    WithDataType(entity.FieldTypeSparseVector),
).WithField(entity.NewField().
    WithName("image_dense").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(512),
).WithFunction(function)
import { MilvusClient, DataType, FunctionType } from "@zilliz/milvus2-sdk-node";

const address = "http://localhost:19530";
const token = "root:Milvus";
const client = new MilvusClient({address, token});

// Define fields
const fields = [
    {
        name: "id",
        data_type: DataType.Int64,
        is_primary_key: true,
        auto_id: false
    },
    {
        name: "text",
        data_type: DataType.VarChar,
        max_length: 1000,
        enable_analyzer: true
    },
    {
        name: "text_dense",
        data_type: DataType.FloatVector,
        dim: 768
    },
    {
        name: "text_sparse",
        data_type: DataType.SparseFloatVector
    },
    {
        name: "image_dense",
        data_type: DataType.FloatVector,
        dim: 512
    }
];

// define function
const functions = [
    {
      name: "text_bm25_emb",
      description: "text bm25 function",
      type: FunctionType.BM25,
      input_field_names: ["text"],
      output_field_names: ["text_sparse"],
      params: {},
    },
];
export schema='{
        "autoId": false,
        "functions": [
            {
                "name": "text_bm25_emb",
                "type": "BM25",
                "inputFieldNames": ["text"],
                "outputFieldNames": ["text_sparse"],
                "params": {}
            }
        ],
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true
                }
            },
            {
                "fieldName": "text_dense",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "768"
                }
            },
            {
                "fieldName": "text_sparse",
                "dataType": "SparseFloatVector"
            },
            {
                "fieldName": "image_dense",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "512"
                }
            }
        ]
    }'
#include "milvus/MilvusClientV2.h"

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"http://localhost:19530", "root:Milvus"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

milvus::FunctionPtr function = std::make_shared<milvus::Function>("text_bm25_emb", milvus::FunctionType::BM25, "text bm25 function");
function->AddInputFieldName("text");
function->AddOutputFieldName("text_sparse");

milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->AddField({"id", milvus::DataType::INT64, "", true, false});
schema->AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR).WithMaxLength(1000).EnableAnalyzer(true));
schema->AddField(milvus::FieldSchema("text_dense", milvus::DataType::FLOAT_VECTOR).WithDimension(768));
schema->AddField({"text_sparse", milvus::DataType::SPARSE_FLOAT_VECTOR});
schema->AddField(milvus::FieldSchema("image_dense", milvus::DataType::FLOAT_VECTOR).WithDimension(512));
schema->AddFunction(function);
인덱스 생성
컬렉션 스키마를 정의한 후, 다음 단계는 벡터 인덱스를 구성하고 유사도 메트릭을 지정하는 것입니다. 주어진 예시에서는:
text_dense_index: 텍스트 밀집 벡터 필드에 대해AUTOINDEX유형의 인덱스와IP메트릭 유형이 생성됩니다.text_sparse_index: 텍스트 스파스 벡터 필드에는BM25메트릭 유형을 가진SPARSE_INVERTED_INDEX유형의 인덱스가 사용됩니다.image_dense_index: 이미지 밀집 벡터 필드에 대해 `AUTOINDEX` 유형의 인덱스가 `IP` 메트릭 유형으로 생성됩니다.
필요에 따라 사용자의 요구 사항과 데이터 유형에 가장 적합한 다른 인덱스 유형을 선택할 수 있습니다. 지원되는 인덱스 유형에 대한 자세한 내용은 사용 가능한 인덱스 유형에 관한 문서를 참조하십시오.
# Prepare index parameters
index_params = client.prepare_index_params()

# Add indexes
index_params.add_index(
    field_name="text_dense",
    index_name="text_dense_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)

index_params.add_index(
    field_name="text_sparse",
    index_name="text_sparse_index",
    index_type="SPARSE_INVERTED_INDEX",
    metric_type="BM25",
    params={"inverted_index_algo": "DAAT_MAXSCORE"}, # or "DAAT_WAND" or "TAAT_NAIVE"
)

index_params.add_index(
    field_name="image_dense",
    index_name="image_dense_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)
import io.milvus.v2.common.IndexParam;
import java.util.*;

Map<String, Object> denseParams = new HashMap<>();

IndexParam indexParamForTextDense = IndexParam.builder()
        .fieldName("text_dense")
        .indexName("text_dense_index")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build();

Map<String, Object> sparseParams = new HashMap<>();
sparseParams.put("inverted_index_algo", "DAAT_MAXSCORE");
IndexParam indexParamForTextSparse = IndexParam.builder()
        .fieldName("text_sparse")
        .indexName("text_sparse_index")
        .indexType(IndexParam.IndexType.SPARSE_INVERTED_INDEX)
        .metricType(IndexParam.MetricType.BM25)
        .extraParams(sparseParams)
        .build();

IndexParam indexParamForImageDense = IndexParam.builder()
        .fieldName("image_dense")
        .indexName("image_dense_index")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build();

List<IndexParam> indexParams = new ArrayList<>();
indexParams.add(indexParamForTextDense);
indexParams.add(indexParamForTextSparse);
indexParams.add(indexParamForImageDense);
indexOption1 := milvusclient.NewCreateIndexOption("my_collection", "text_dense",
    index.NewAutoIndex(index.MetricType(entity.IP)))
indexOption2 := milvusclient.NewCreateIndexOption("my_collection", "text_sparse",
    index.NewSparseInvertedIndex(entity.BM25, 0.2))
indexOption3 := milvusclient.NewCreateIndexOption("my_collection", "image_dense",
    index.NewAutoIndex(index.MetricType(entity.IP)))
const index_params = [{
    field_name: "text_dense",
    index_name: "text_dense_index",
    index_type: "AUTOINDEX",
    metric_type: "IP"
},{
    field_name: "text_sparse",
    index_name: "text_sparse_index",
    index_type: "SPARSE_INVERTED_INDEX",
    metric_type: "BM25",
    params: {
      inverted_index_algo: "DAAT_MAXSCORE",
    }
},{
    field_name: "image_dense",
    index_name: "image_dense_index",
    index_type: "AUTOINDEX",
    metric_type: "IP"
}]
export indexParams='[
        {
            "fieldName": "text_dense",
            "metricType": "IP",
            "indexName": "text_dense_index",
            "indexType":"AUTOINDEX"
        },
        {
            "fieldName": "text_sparse",
            "metricType": "BM25",
            "indexName": "text_sparse_index",
            "indexType": "SPARSE_INVERTED_INDEX",
            "params":{"inverted_index_algo": "DAAT_MAXSCORE"}
        },
        {
            "fieldName": "image_dense",
            "metricType": "IP",
            "indexName": "image_dense_index",
            "indexType":"AUTOINDEX"
        }
    ]'
milvus::IndexDesc text_sparse_index("text_sparse", "text_sparse_index", milvus::IndexType::SPARSE_INVERTED_INDEX, milvus::MetricType::BM25);
text_sparse_index.AddExtraParam("inverted_index_algo", "DAAT_MAXSCORE");

std::vector<milvus::IndexDesc> indexes = {
    milvus::IndexDesc("text_dense", "text_dense_index", milvus::IndexType::AUTOINDEX, milvus::MetricType::IP),
    text_sparse_index,
    milvus::IndexDesc("image_dense", "image_dense_index", milvus::IndexType::AUTOINDEX, milvus::MetricType::IP),
};
컬렉션 생성
앞서 두 단계에서 구성한 컬렉션 스키마와 인덱스를 사용하여 ' demo '라는 이름의 컬렉션을 생성합니다.
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
CreateCollectionReq createCollectionReq = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexParams)
        .build();
client.createCollection(createCollectionReq);
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption1, indexOption2, indexOption3))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
res = await client.createCollection({
    collection_name: "my_collection",
    fields: fields,
    functions: functions,
    index_params: index_params,
})
export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
status = client->CreateCollection(milvus::CreateCollectionRequest()
                                      .WithCollectionName("my_collection")
                                      .WithCollectionSchema(schema)
                                      .WithIndexes(std::move(indexes)));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
데이터 삽입
이 섹션에서는 앞서 정의한 스키마에 따라 ' my_collection ' 컬렉션에 데이터를 삽입합니다. 삽입 시 자동 생성된 값을 가진 필드를 제외한 모든 필드에 올바른 형식의 데이터가 제공되도록 해야 합니다. 이 예시에서는:
id: 제품 ID를 나타내는 정수text: 상품 설명을 포함하는 문자열text_dense: 텍스트 설명의 밀집 임베딩을 나타내는 768개의 부동 소수점 값 목록image_dense: 상품 이미지의 밀집 임베딩을 나타내는 512개의 부동소수점 값 목록
각 필드에 대한 밀집 임베딩을 생성할 때 동일한 모델을 사용하거나 서로 다른 모델을 사용할 수 있습니다. 이 예시에서 두 밀집 임베딩은 차원이 서로 다르므로, 서로 다른 모델로 생성되었음을 시사합니다. 나중에 각 검색을 정의할 때는 해당 모델을 사용하여 적절한 쿼리 임베딩을 생성해야 합니다.
이 예제에서는 내장된 BM25 함수를 사용하여 텍스트 필드에서 스파스 임베딩을 생성하므로, 스파스 벡터를 수동으로 제공할 필요가 없습니다. 그러나 BM25를 사용하지 않기로 선택한 경우, 스파스 임베딩을 직접 사전 계산하여 제공해야 합니다.
import random

# Generate example vectors
def generate_dense_vector(dim):
    return [random.random() for _ in range(dim)]

data=[
    {
        "id": 0,
        "text": "Red cotton t-shirt with round neck",
        "text_dense": generate_dense_vector(768),
        "image_dense": generate_dense_vector(512)
    },
    {
        "id": 1,
        "text": "Wireless noise-cancelling over-ear headphones",
        "text_dense": generate_dense_vector(768),
        "image_dense": generate_dense_vector(512)
    },
    {
        "id": 2,
        "text": "Stainless steel water bottle, 500ml",
        "text_dense": generate_dense_vector(768),
        "image_dense": generate_dense_vector(512)
    }
]

res = client.insert(
    collection_name="my_collection",
    data=data
)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;
import io.milvus.v2.service.vector.response.InsertResp;

Gson gson = new Gson();
JsonObject row1 = new JsonObject();
row1.addProperty("id", 0);
row1.addProperty("text", "Red cotton t-shirt with round neck");
row1.add("text_dense", gson.toJsonTree(new float[]{0.3580376395471989f, -0.6023495712049978f, 0.18414012509913835f, ...}));
row1.add("image_dense", gson.toJsonTree(new float[]{0.6366019600530924f, -0.09323198122475052f, ...}));

JsonObject row2 = new JsonObject();
row2.addProperty("id", 1);
row2.addProperty("text", "Wireless noise-cancelling over-ear headphones");
row2.add("text_dense", gson.toJsonTree(new float[]{0.19886812562848388f, 0.06023560599112088f, 0.6976963061752597f, ...}));
row2.add("image_dense", gson.toJsonTree(new float[]{0.6414180010301553f, 0.8976979978567611f, ...}));

JsonObject row3 = new JsonObject();
row3.addProperty("id", 2);
row3.addProperty("text", "Stainless steel water bottle, 500ml");
row3.add("text_dense", gson.toJsonTree(new float[]{0.43742130801983836f, -0.5597502546264526f, 0.6457887650909682f, ...}));
row3.add("image_dense", gson.toJsonTree(new float[]{-0.6901259768402174f, 0.6100500332193755f, ...}));

List<JsonObject> data = Arrays.asList(row1, row2, row3);
InsertReq insertReq = InsertReq.builder()
        .collectionName("my_collection")
        .data(data)
        .build();

InsertResp insertResp = client.insert(insertReq);
_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("my_collection").
    WithInt64Column("id", []int64{0, 1, 2}).
    WithVarcharColumn("text", []string{
        "Red cotton t-shirt with round neck",
        "Wireless noise-cancelling over-ear headphones",
        "Stainless steel water bottle, 500ml",
    }).
    WithFloatVectorColumn("text_dense", 768, [][]float32{
        {0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...},
        {0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...},
        {0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...},
    }).
    WithFloatVectorColumn("image_dense", 512, [][]float32{
        {0.6366019600530924, -0.09323198122475052, ...},
        {0.6414180010301553, 0.8976979978567611, ...},
        {-0.6901259768402174, 0.6100500332193755, ...},
    }))
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
const { MilvusClient, DataType } = require("@zilliz/milvus2-sdk-node")

var data = [
    {id: 0, text: "Red cotton t-shirt with round neck" , text_dense: [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...], image_dense: [0.6366019600530924, -0.09323198122475052, ...]},
    {id: 1, text: "Wireless noise-cancelling over-ear headphones" , text_dense: [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...], image_dense: [0.6414180010301553, 0.8976979978567611, ...]},
    {id: 2, text: "Stainless steel water bottle, 500ml" , text_dense: [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...], image_dense: [-0.6901259768402174, 0.6100500332193755, ...]}
]

var res = await client.insert({
    collection_name: "my_collection",
    data: data,
})
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "data": [
        {"id": 0, "text": "Red cotton t-shirt with round neck" , "text_dense": [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...], "image_dense": [0.6366019600530924, -0.09323198122475052, ...]},
        {"id": 1, "text": "Wireless noise-cancelling over-ear headphones" , "text_dense": [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...], "image_dense": [0.6414180010301553, 0.8976979978567611, ...]},
        {"id": 2, "text": "Stainless steel water bottle, 500ml" , "text_dense": [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...], "image_dense": [-0.6901259768402174, 0.6100500332193755, ...]}
    ],
    "collectionName": "my_collection"
}'
#include <random>

std::vector<float>
GenerateFloatVector(int dimension) {
    std::random_device rd;
    std::mt19937 ran(rd());
    std::uniform_real_distribution<float> float_gen(0.0, 1.0);
    std::vector<float> vector(dimension);
    for (auto d = 0; d < dimension; ++d) {
        vector[d] = float_gen(ran);
    }
    return vector;
}

milvus::EntityRows data = {
    {{"id", 0}, {"text", "Red cotton t-shirt with round neck"}, {"text_dense", GenerateFloatVector(768)}, {"image_dense", GenerateFloatVector(512)}},
    {{"id", 1}, {"text", "Wireless noise-cancelling over-ear headphones"}, {"text_dense", GenerateFloatVector(768)}, {"image_dense", GenerateFloatVector(512)}},
    {{"id", 2}, {"text", "Stainless steel water bottle, 500ml"}, {"text_dense", GenerateFloatVector(768)}, {"image_dense", GenerateFloatVector(512)}}
};

milvus::InsertResponse response;
status = client->Insert(milvus::InsertRequest()
                            .WithCollectionName("my_collection")
                            .WithRowsData(std::move(data)),
                        response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
하이브리드 검색 수행
1단계: 여러 AnnSearchRequest 인스턴스 생성
하이브리드 검색은 ` hybrid_search() ` 함수에서 여러 개의 ` AnnSearchRequest `를 생성하여 구현되며, 각 ` AnnSearchRequest `는 특정 벡터 필드에 대한 기본 ANN 검색 요청을 나타냅니다. 따라서 하이브리드 검색을 수행하기 전에 각 벡터 필드에 대해 ` AnnSearchRequest `를 생성해야 합니다.
또한, AnnSearchRequest 내의 expr 매개변수를 구성함으로써 하이브리드 검색에 대한 필터링 조건을 설정할 수 있습니다. ‘필터링된 검색’ 및 ‘필터링 설명’을 참조하십시오.
하이브리드 검색에서 각 AnnSearchRequest 은 하나의 쿼리 데이터만 지원합니다.
다양한 벡터 필드의 기능을 시연하기 위해, 샘플 쿼리를 사용하여 세 가지 AnnSearchRequest 검색 요청을 구성해 보겠습니다. 이 과정에서 미리 계산된 밀집 벡터도 함께 사용할 것입니다. 검색 요청은 다음 벡터 필드를 대상으로 합니다:
text_dense의미론적 텍스트 검색: 직접적인 키워드 일치보다는 의미를 기반으로 한 문맥 이해 및 검색을 가능하게 합니다.text_sparse전체 텍스트 검색 또는 키워드 매칭을 위한 것으로, 텍스트 내의 정확한 단어 또는 구문 일치에 중점을 둡니다.image_dense다중 모달 텍스트-이미지 검색용으로, 쿼리의 의미적 내용을 기반으로 관련 제품 이미지를 검색합니다.
from pymilvus import AnnSearchRequest

query_text = "white headphones, quiet and comfortable"
query_dense_vector = generate_dense_vector(768)
query_multimodal_vector = generate_dense_vector(512)

# text semantic search (dense)
search_param_1 = {
    "data": [query_dense_vector],
    "anns_field": "text_dense",
    "param": {"nprobe": 10},
    "limit": 2
}
request_1 = AnnSearchRequest(**search_param_1)

# full-text search (sparse)
search_param_2 = {
    "data": [query_text],
    "anns_field": "text_sparse",
    "param": {},
    "limit": 2
}
request_2 = AnnSearchRequest(**search_param_2)

# text-to-image search (multimodal)
search_param_3 = {
    "data": [query_multimodal_vector],
    "anns_field": "image_dense",
    "param": {"nprobe": 10},
    "limit": 2
}
request_3 = AnnSearchRequest(**search_param_3)

reqs = [request_1, request_2, request_3]
import io.milvus.v2.service.vector.request.AnnSearchReq;
import io.milvus.v2.service.vector.request.data.BaseVector;
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.request.data.SparseFloatVec;
import io.milvus.v2.service.vector.request.data.EmbeddedText;

float[] queryDense = new float[]{-0.0475336798f,  0.0521207601f,  0.0904406682f, ...};
float[] queryMultimodal = new float[]{0.0158298651f, 0.5264158340f, ...};

List<BaseVector> queryTexts = Collections.singletonList(new EmbeddedText("white headphones, quiet and comfortable"));
List<BaseVector> queryDenseVectors = Collections.singletonList(new FloatVec(queryDense));
List<BaseVector> queryMultimodalVectors = Collections.singletonList(new FloatVec(queryMultimodal));

List<AnnSearchReq> searchRequests = new ArrayList<>();
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_dense")
        .vectors(queryDenseVectors)
        .params("{\"nprobe\": 10}")
        .topK(2)
        .build());
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_sparse")
        .vectors(queryTexts)
        .topK(2)
        .build());
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("image_dense")
        .vectors(queryMultimodalVectors)
        .params("{\"nprobe\": 10}")
        .topK(2)
        .build());
queryText := entity.Text("white headphones, quiet and comfortable")
queryVector := []float32{0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...}
queryMultimodalVector := []float32{0.015829865178701663, 0.5264158340734488, ...}

request1 := milvusclient.NewAnnRequest("text_dense", 2, entity.FloatVector(queryVector)).
    WithAnnParam(index.NewIvfAnnParam(10))

annParam := index.NewSparseAnnParam()
annParam.WithDropRatio(0.2)
request2 := milvusclient.NewAnnRequest("text_sparse", 2, queryText).
    WithAnnParam(annParam)

request3 := milvusclient.NewAnnRequest("image_dense", 2, entity.FloatVector(queryMultimodalVector)).
    WithAnnParam(index.NewIvfAnnParam(10))
const query_text = "white headphones, quiet and comfortable"
const query_vector = [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...]
const query_multimodal_vector = [0.015829865178701663, 0.5264158340734488, ...]

const search_param_1 = {
    "data": query_vector,
    "anns_field": "text_dense",
    "params": {"nprobe": 10},
    "limit": 2
}

const search_param_2 = {
    "data": query_text,
    "anns_field": "text_sparse",
    "limit": 2
}

const search_param_3 = {
    "data": query_multimodal_vector,
    "anns_field": "image_dense",
    "params": {"nprobe": 10},
    "limit": 2
}
export req='[
    {
        "data": [[0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...]],
        "annsField": "text_dense",
        "params": {"nprobe": 10},
        "limit": 2
    },
    {
        "data": ["white headphones, quiet and comfortable"],
        "annsField": "text_sparse",
        "limit": 2
    },
    {
        "data": [[0.015829865178701663, 0.5264158340734488, ...]],
        "annsField": "image_dense",
        "params": {"nprobe": 10},
        "limit": 2
    }
 ]'
auto query_text = "white headphones, quiet and comfortable";
auto query_dense_vector = GenerateFloatVector(768);
auto query_multimodal_vector = GenerateFloatVector(512);

// text semantic search (dense)
auto sub_req1 = milvus::SubSearchRequest()
                    .AddFloatVector(query_dense_vector)
                    .WithAnnsField("text_dense")
                    .WithLimit(2);
sub_req1.AddExtraParam("nprobe", "10");

// full-text search (sparse)
auto sub_req2 = milvus::SubSearchRequest()
                    .AddEmbeddedText(query_text)
                    .WithAnnsField("text_sparse")
                    .WithLimit(2);

// text-to-image search (multimodal)
auto sub_req3 = milvus::SubSearchRequest()
                    .AddFloatVector(query_multimodal_vector)
                    .WithAnnsField("image_dense")
                    .WithLimit(2);
sub_req3.AddExtraParam("nprobe", "10");
limit 매개변수가 2로 설정되어 있으므로, 각 AnnSearchRequest 호출은 2개의 검색 결과를 반환합니다. 이 예제에서는 3개의 AnnSearchRequest 인스턴스가 생성되어 총 6개의 검색 결과가 생성됩니다.
2단계: 재순위 지정 전략 구성
ANN 검색 결과 집합을 병합하고 재순위를 매기려면 적절한 재순위 지정 전략을 선택하는 것이 필수적입니다. Milvus는 여러 유형의 재순위 지정 전략을 제공합니다. 이러한 재순위 지정 메커니즘에 대한 자세한 내용은 가중치 순위 지정기(Weighted Ranker ) 또는 RRF 순위 지정기(RRF Ranker)를 참조하십시오.
이 예제에서는 특정 검색 쿼리에 특별히 중점을 두지 않으므로 RRFRanker 전략을 사용하겠습니다.
ranker = Function(
    name="rrf",
    input_field_names=[], # Must be an empty list
    function_type=FunctionType.RERANK,
    params={
        "reranker": "rrf",
        "k": 100  # Optional
    }
)
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.CreateCollectionReq.Function;

Function ranker = Function.builder()
        .name("rrf")
        .functionType(FunctionType.RERANK)
        .param("reranker", "rrf")
        .param("k", "100")
        .build();
const rerank = {
  name: 'rrf',
  description: 'bm25 function',
  type: FunctionType.RERANK,
  input_field_names: [],
  params: {
      "reranker": "rrf",
      "k": 100
  },
};
reranker := milvusclient.NewRRFReranker().WithK(100)
# Restful
export rerank='{"k": 100}'
auto ranker = std::make_shared<milvus::RRFRerank>(100);
3단계: 하이브리드 검색 수행
하이브리드 검색을 시작하기 전에 컬렉션이 로드되었는지 확인하십시오. 컬렉션 내의 벡터 필드 중 인덱스가 없거나 메모리에 로드되지 않은 것이 있다면, 하이브리드 검색 메서드를 실행할 때 오류가 발생합니다.
res = client.hybrid_search(
    collection_name="my_collection",
    reqs=reqs,
    ranker=ranker,
    limit=2
)
for hits in res:
    print("TopK results:")
    for hit in hits:
        print(hit)
import io.milvus.v2.common.ConsistencyLevel;
import io.milvus.v2.service.vector.request.HybridSearchReq;
import io.milvus.v2.service.vector.response.SearchResp;

HybridSearchReq hybridSearchReq = HybridSearchReq.builder()
        .collectionName("my_collection")
        .searchRequests(searchRequests)
        .ranker(ranker)
        .topK(2)
        .build();

SearchResp searchResp = client.hybridSearch(hybridSearchReq);
resultSets, err := client.HybridSearch(ctx, milvusclient.NewHybridSearchOption(
    "my_collection",
    2,
    request1,
    request2,
    request3,
).WithReranker(reranker))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
}
const { MilvusClient, DataType } = require("@zilliz/milvus2-sdk-node")

res = await client.loadCollection({
    collection_name: "my_collection"
})

import { MilvusClient, RRFRanker, WeightedRanker } from '@zilliz/milvus2-sdk-node';

const search = await client.search({
  collection_name: "my_collection",
  data: [search_param_1, search_param_2, search_param_3],
  limit: 2,
  rerank: rerank
});
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/hybrid_search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"search\": ${req},
    \"rerank\": {
        \"strategy\":\"rrf\",
        \"params\": ${rerank}
    },
    \"limit\": 2
}"
auto request = milvus::HybridSearchRequest()
                   .WithCollectionName("my_collection")
                   .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(sub_req1)))
                   .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(sub_req2)))
                   .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(sub_req3)))
                   .WithRerank(ranker)
                   .WithLimit(2);

milvus::SearchResponse response;
status = client->HybridSearch(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

for (auto& result : response.Results().Results()) {
    std::cout << "TopK results:" << std::endl;
    milvus::EntityRows output_rows;
    status = result.OutputRows(output_rows);
    for (const auto& row : output_rows) {
        std::cout << "\t" << row << std::endl;
    }
}
다음은 출력 결과입니다:
["['id: 1, distance: 0.006047376897186041, entity: {}', 'id: 2, distance: 0.006422005593776703, entity: {}']"]
하이브리드 검색에 ` limit=2 ` 매개변수가 지정되면, Milvus는 세 번의 검색에서 얻은 여섯 개의 결과를 재순위화합니다. 최종적으로 가장 유사한 상위 두 결과만 반환됩니다.
고급 사용법
하이브리드 검색에 대한 시간대를 일시적으로 설정하기
컬렉션에 TIMESTAMPTZ 필드가 있는 경우, 하이브리드 검색 호출 시 timezone 매개변수를 설정하여 단일 작업에 대해 데이터베이스 또는 컬렉션의 기본 시간대를 일시적으로 재정의할 수 있습니다. 이는 작업 중에 TIMESTAMPTZ 값이 표시되고 비교되는 방식을 제어합니다.
timezone 의 값은 유효한 IANA 시간대 식별자 (예: Asia/Shanghai, America/Chicago 또는 UTC)여야 합니다. TIMESTAMPTZ 필드 사용 방법에 대한 자세한 내용은 TIMESTAMPTZ 필드를 참조하십시오.
다음 예제는 하이브리드 검색 작업에 대해 시간대를 임시로 설정하는 방법을 보여줍니다.
res = client.hybrid_search(
    collection_name="my_collection",
    reqs=reqs,
    ranker=ranker,
    limit=2,
    timezone="America/Havana",
)
List<AnnSearchReq> tzRequests = new ArrayList<>();
tzRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_dense")
        .vectors(queryDenseVectors)
        .params("{\"nprobe\": 10}")
        .topK(2)
        .timezone("America/Havana")
        .build());
tzRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_sparse")
        .vectors(queryTexts)
        .topK(2)
        .timezone("America/Havana")
        .build());
tzRequests.add(AnnSearchReq.builder()
        .vectorFieldName("image_dense")
        .vectors(queryMultimodalVectors)
        .params("{\"nprobe\": 10}")
        .topK(2)
        .timezone("America/Havana")
        .build());

HybridSearchReq tzHybridSearchReq = HybridSearchReq.builder()
        .collectionName("my_collection")
        .searchRequests(tzRequests)
        .ranker(ranker)
        .topK(2)
        .build();

SearchResp tzSearchResp = client.hybridSearch(tzHybridSearchReq);
tzRequest1 := milvusclient.NewAnnRequest("text_dense", 2, entity.FloatVector(queryVector)).
    WithAnnParam(index.NewIvfAnnParam(10)).
    WithSearchParam("timezone", "America/Havana")

tzRequest2 := milvusclient.NewAnnRequest("text_sparse", 2, queryText).
    WithAnnParam(annParam).
    WithSearchParam("timezone", "America/Havana")

tzRequest3 := milvusclient.NewAnnRequest("image_dense", 2, entity.FloatVector(queryMultimodalVector)).
    WithAnnParam(index.NewIvfAnnParam(10)).
    WithSearchParam("timezone", "America/Havana")

resultSets, err = client.HybridSearch(ctx, milvusclient.NewHybridSearchOption(
    "my_collection",
    2,
    tzRequest1,
    tzRequest2,
    tzRequest3,
).WithReranker(reranker))
res = await client.search({
  collection_name: "my_collection",
  data: [
    { ...search_param_1, params: { "nprobe": 10, timezone: "America/Havana" } },
    { ...search_param_2, params: { timezone: "America/Havana" } },
    { ...search_param_3, params: { "nprobe": 10, timezone: "America/Havana" } },
  ],
  limit: 2,
  rerank: rerank
});
# restful
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/hybrid_search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
-d '{
    "collectionName": "my_collection",
    "search": [
        {
            "data": [[0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...]],
            "annsField": "text_dense",
            "params": {"nprobe": 10, "timezone": "America/Havana"},
            "limit": 2
        },
        {
            "data": ["white headphones, quiet and comfortable"],
            "annsField": "text_sparse",
            "params": {"timezone": "America/Havana"},
            "limit": 2
        },
        {
            "data": [[0.015829865178701663, 0.5264158340734488, ...]],
            "annsField": "image_dense",
            "params": {"nprobe": 10, "timezone": "America/Havana"},
            "limit": 2
        }
    ],
    "rerank": {
        "strategy": "rrf",
        "params": {"k": 100}
    },
    "limit": 2
}'
auto tz_req1 = milvus::SubSearchRequest()
                   .AddFloatVector(query_dense_vector)
                   .WithAnnsField("text_dense")
                   .WithTimezone("America/Havana")
                   .WithLimit(2);
tz_req1.AddExtraParam("nprobe", "10");

auto tz_req2 = milvus::SubSearchRequest()
                   .AddEmbeddedText(query_text)
                   .WithAnnsField("text_sparse")
                   .WithTimezone("America/Havana")
                   .WithLimit(2);

auto tz_req3 = milvus::SubSearchRequest()
                   .AddFloatVector(query_multimodal_vector)
                   .WithAnnsField("image_dense")
                   .WithTimezone("America/Havana")
                   .WithLimit(2);
tz_req3.AddExtraParam("nprobe", "10");

auto tz_request = milvus::HybridSearchRequest()
                      .WithCollectionName("my_collection")
                      .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(tz_req1)))
                      .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(tz_req2)))
                      .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(tz_req3)))
                      .WithRerank(ranker)
                      .WithLimit(2);

milvus::SearchResponse tz_response;
status = client->HybridSearch(tz_request, tz_response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
