

Ricerca ibrida multiveettoriale
In molte applicazioni, è possibile effettuare la ricerca di un oggetto utilizzando un ampio insieme di informazioni, quali titolo e descrizione, oppure ricorrendo a diverse modalità, quali testo, immagini e audio. Ad esempio, un tweet contenente un testo e un’immagine dovrà essere individuato se il testo o l’immagine corrispondono al significato della query di ricerca. La ricerca ibrida migliora l’esperienza di ricerca combinando le ricerche in questi diversi campi. Milvus supporta questa funzionalità consentendo la ricerca su più campi vettoriali, effettuando contemporaneamente diverse ricerche con l’algoritmo Approximate Nearest Neighbor (ANN). La ricerca ibrida multivettoriale è particolarmente utile se si desidera cercare sia testo che immagini, più campi di testo che descrivono lo stesso oggetto, oppure vettori densi e sparsi per migliorare la qualità della ricerca.
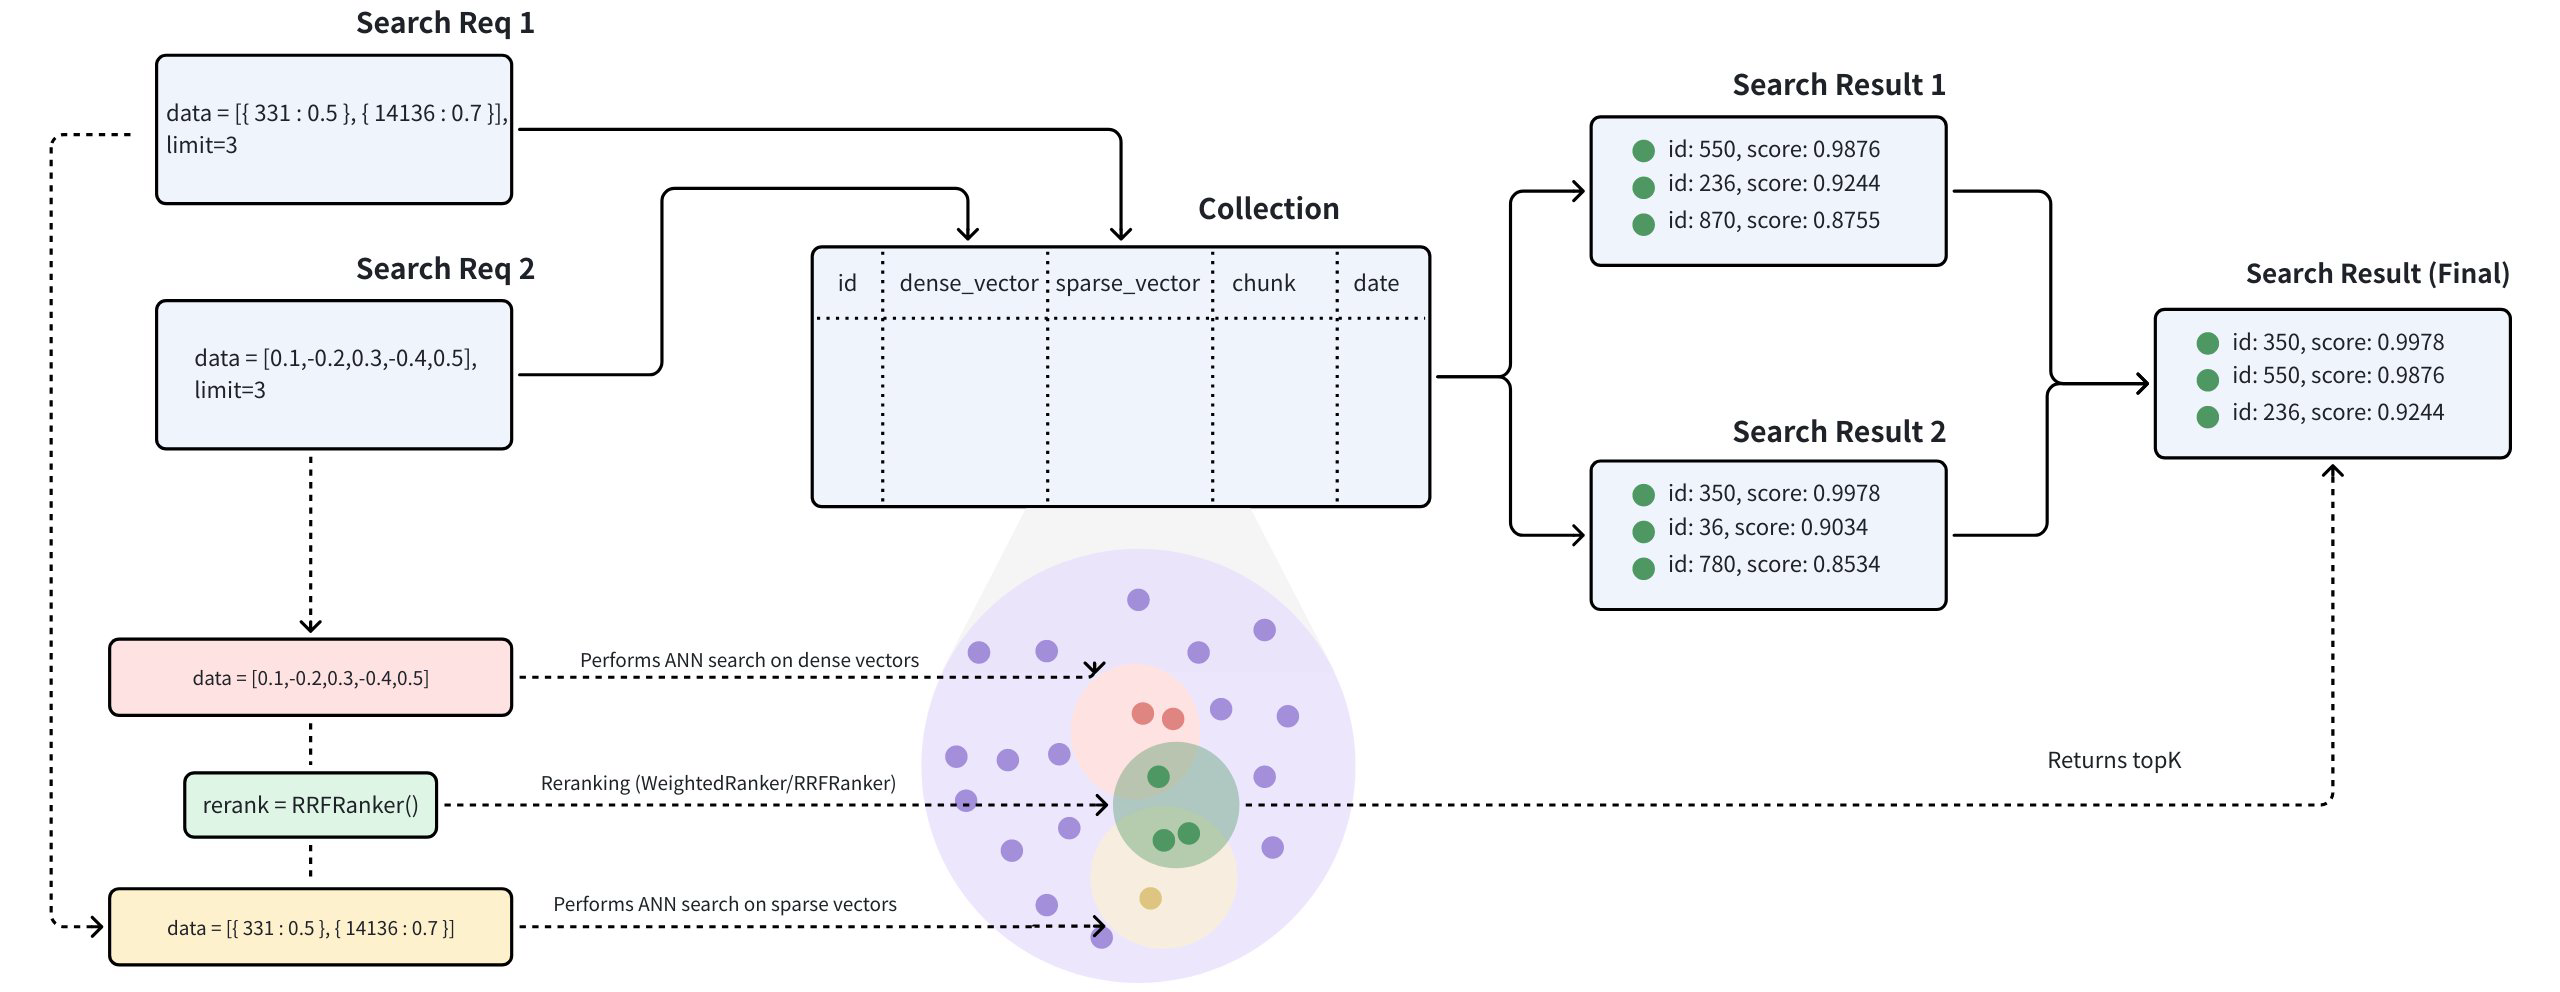 Flusso di lavoro della ricerca ibrida
La ricerca ibrida multivettoriale integra diversi metodi di ricerca o abbraccia le rappresentazioni di varie modalità:
Ricerca con vettori sparsi e densi: i vettori densi sono eccellenti per cogliere le relazioni semantiche, mentre i vettori sparsi sono altamente efficaci per la corrispondenza precisa delle parole chiave. La ricerca ibrida combina questi approcci per fornire sia un'ampia comprensione concettuale sia l’esatta pertinenza dei termini, migliorando così i risultati di ricerca. Sfruttando i punti di forza di ciascun metodo, la ricerca ibrida supera i limiti dei singoli approcci, offrendo prestazioni migliori per le query complesse. Ecco una guida più dettagliata sul recupero ibrido che combina la ricerca semantica con la ricerca full-text.
Ricerca vettoriale multimodale: la ricerca vettoriale multimodale è una tecnica potente che consente di effettuare ricerche su vari tipi di dati, tra cui testo, immagini, audio e altro. Il vantaggio principale di questo approccio è la sua capacità di unificare diverse modalità in un’esperienza di ricerca fluida e coerente. Ad esempio, nella ricerca di prodotti, un utente potrebbe inserire una query testuale per trovare prodotti descritti sia con testo che con immagini. Combinando queste modalità tramite un metodo di ricerca ibrido, è possibile migliorare la precisione della ricerca o arricchire i risultati.
Esempio
Consideriamo un caso d’uso reale in cui ogni prodotto include una descrizione testuale e un’immagine. Sulla base dei dati disponibili, possiamo effettuare tre tipi di ricerca:
Ricerca testuale semantica: consiste nell’effettuare una query sulla descrizione testuale del prodotto utilizzando vettori densi. Gli embedding testuali possono essere generati utilizzando modelli come BERT e Transformers o servizi come OpenAI.
Ricerca full-text: in questo caso, si effettua la ricerca nella descrizione testuale del prodotto tramite una corrispondenza per parole chiave con vettori sparsi. A tal fine si possono utilizzare algoritmi come BM25 o modelli di embedding sparsi quali BGE-M3 o SPLADE.
Ricerca multimodale per immagini: questo metodo effettua la ricerca sull’immagine utilizzando una query testuale con vettori densi. Gli embedding delle immagini possono essere generati con modelli come CLIP.
Questa guida illustrerà un esempio di ricerca ibrida multimodale che combina i metodi di ricerca sopra descritti, partendo dalla descrizione testuale grezza e dagli embedding delle immagini dei prodotti. Mostreremo come memorizzare dati multivettoriali ed eseguire ricerche ibride con una strategia di riclassificazione.
Creazione di una collezione con più campi vettoriali
Il processo di creazione di una collezione prevede tre passaggi chiave: definizione dello schema della collezione, configurazione dei parametri dell’indice e creazione della collezione.
Definizione dello schema
Per la ricerca ibrida multivettoriale, è necessario definire più campi vettoriali all’interno dello schema della collezione. Per i dettagli sui limiti relativi al numero di campi vettoriali consentiti in una collezione, consulta Limiti di Zilliz Cloud. Tuttavia, se necessario, è possibile modificare l’ proxy.maxVectorFieldNum per includere fino a 10 campi vettoriali in una collezione, a seconda delle esigenze.
Questo esempio incorpora i seguenti campi nello schema:
id: Funge da chiave primaria per l’archiviazione degli ID di testo. Questo campo è di tipoINT64.text: Utilizzato per memorizzare il contenuto testuale. Questo campo è di tipoVARCHARcon una lunghezza massima di 1000 byte. L’opzioneenable_analyzerè impostata suTrueper facilitare la ricerca full-text.text_dense: Utilizzato per memorizzare vettori densi dei testi. Questo campo è di tipoFLOAT_VECTORcon una dimensione vettoriale pari a 768.text_sparse: Utilizzato per memorizzare vettori sparsi dei testi. Questo campo è di tipoSPARSE_FLOAT_VECTOR.image_dense: Utilizzato per memorizzare i vettori densi delle immagini dei prodotti. Questo campo è di tipoFLOAT_VETORcon una dimensione vettoriale pari a 512.
Poiché utilizzeremo l’algoritmo BM25 integrato per eseguire una ricerca full-text sul campo di testo, è necessario aggiungere il campo Milvus Function allo schema. Per ulteriori dettagli, fare riferimento alla sezione Ricerca full-text.
from pymilvus import (
    MilvusClient, DataType, Function, FunctionType
)

client = MilvusClient(
    uri="http://localhost:19530",
    token="root:Milvus"
)

# Init schema with auto_id disabled
schema = client.create_schema(auto_id=False)

# Add fields to schema
schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True, description="product id")
schema.add_field(field_name="text", datatype=DataType.VARCHAR, max_length=1000, enable_analyzer=True, description="raw text of product description")
schema.add_field(field_name="text_dense", datatype=DataType.FLOAT_VECTOR, dim=768, description="text dense embedding")
schema.add_field(field_name="text_sparse", datatype=DataType.SPARSE_FLOAT_VECTOR, description="text sparse embedding auto-generated by the built-in BM25 function")
schema.add_field(field_name="image_dense", datatype=DataType.FLOAT_VECTOR, dim=512, description="image dense embedding")

# Add function to schema
bm25_function = Function(
    name="text_bm25_emb",
    input_field_names=["text"],
    output_field_names=["text_sparse"],
    function_type=FunctionType.BM25,
)
schema.add_function(bm25_function)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq.Function;

import java.util.*;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .token("root:Milvus")
        .build());

CreateCollectionReq.CollectionSchema schema = client.createSchema();

schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(false)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("text_dense")
        .dataType(DataType.FloatVector)
        .dimension(768)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("text_sparse")
        .dataType(DataType.SparseFloatVector)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("image_dense")
        .dataType(DataType.FloatVector)
        .dimension(512)
        .build());

schema.addFunction(Function.builder()
        .functionType(FunctionType.BM25)
        .name("text_bm25_emb")
        .inputFieldNames(Collections.singletonList("text"))
        .outputFieldNames(Collections.singletonList("text_sparse"))
        .build());
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

function := entity.NewFunction().
    WithName("text_bm25_emb").
    WithInputFields("text").
    WithOutputFields("text_sparse").
    WithType(entity.FunctionTypeBM25)

schema := entity.NewSchema()

schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true),
).WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithMaxLength(1000),
).WithField(entity.NewField().
    WithName("text_dense").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(768),
).WithField(entity.NewField().
    WithName("text_sparse").
    WithDataType(entity.FieldTypeSparseVector),
).WithField(entity.NewField().
    WithName("image_dense").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(512),
).WithFunction(function)
import { MilvusClient, DataType, FunctionType } from "@zilliz/milvus2-sdk-node";

const address = "http://localhost:19530";
const token = "root:Milvus";
const client = new MilvusClient({address, token});

// Define fields
const fields = [
    {
        name: "id",
        data_type: DataType.Int64,
        is_primary_key: true,
        auto_id: false
    },
    {
        name: "text",
        data_type: DataType.VarChar,
        max_length: 1000,
        enable_analyzer: true
    },
    {
        name: "text_dense",
        data_type: DataType.FloatVector,
        dim: 768
    },
    {
        name: "text_sparse",
        data_type: DataType.SparseFloatVector
    },
    {
        name: "image_dense",
        data_type: DataType.FloatVector,
        dim: 512
    }
];

// define function
const functions = [
    {
      name: "text_bm25_emb",
      description: "text bm25 function",
      type: FunctionType.BM25,
      input_field_names: ["text"],
      output_field_names: ["text_sparse"],
      params: {},
    },
];
export schema='{
        "autoId": false,
        "functions": [
            {
                "name": "text_bm25_emb",
                "type": "BM25",
                "inputFieldNames": ["text"],
                "outputFieldNames": ["text_sparse"],
                "params": {}
            }
        ],
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true
                }
            },
            {
                "fieldName": "text_dense",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "768"
                }
            },
            {
                "fieldName": "text_sparse",
                "dataType": "SparseFloatVector"
            },
            {
                "fieldName": "image_dense",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "512"
                }
            }
        ]
    }'
#include "milvus/MilvusClientV2.h"

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"http://localhost:19530", "root:Milvus"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

milvus::FunctionPtr function = std::make_shared<milvus::Function>("text_bm25_emb", milvus::FunctionType::BM25, "text bm25 function");
function->AddInputFieldName("text");
function->AddOutputFieldName("text_sparse");

milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->AddField({"id", milvus::DataType::INT64, "", true, false});
schema->AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR).WithMaxLength(1000).EnableAnalyzer(true));
schema->AddField(milvus::FieldSchema("text_dense", milvus::DataType::FLOAT_VECTOR).WithDimension(768));
schema->AddField({"text_sparse", milvus::DataType::SPARSE_FLOAT_VECTOR});
schema->AddField(milvus::FieldSchema("image_dense", milvus::DataType::FLOAT_VECTOR).WithDimension(512));
schema->AddFunction(function);
Creazione dell’indice
Dopo aver definito lo schema della collezione, il passo successivo consiste nel configurare gli indici vettoriali e specificare le metriche di similarità. Nell’esempio riportato:
text_dense_index: viene creato un indice di tipo `AUTOINDEX` con tipo di metrica `IP` per il campo vettoriale denso di testo.text_sparse_index: per il campo vettoriale a densità elevata di testo viene utilizzato un indice di tipoSPARSE_INVERTED_INDEXcon tipo di metricaBM25.image_dense_index: viene creato un indice di tipoAUTOINDEXcon tipo di metricaIPper il campo vettoriale denso di immagini.
È possibile scegliere altri tipi di indice, a seconda delle esigenze e dei tipi di dati. Per ulteriori informazioni sui tipi di indice supportati, consultare la documentazione sui tipi di indice disponibili.
# Prepare index parameters
index_params = client.prepare_index_params()

# Add indexes
index_params.add_index(
    field_name="text_dense",
    index_name="text_dense_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)

index_params.add_index(
    field_name="text_sparse",
    index_name="text_sparse_index",
    index_type="SPARSE_INVERTED_INDEX",
    metric_type="BM25",
    params={"inverted_index_algo": "DAAT_MAXSCORE"}, # or "DAAT_WAND" or "TAAT_NAIVE"
)

index_params.add_index(
    field_name="image_dense",
    index_name="image_dense_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)
import io.milvus.v2.common.IndexParam;
import java.util.*;

Map<String, Object> denseParams = new HashMap<>();

IndexParam indexParamForTextDense = IndexParam.builder()
        .fieldName("text_dense")
        .indexName("text_dense_index")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build();

Map<String, Object> sparseParams = new HashMap<>();
sparseParams.put("inverted_index_algo", "DAAT_MAXSCORE");
IndexParam indexParamForTextSparse = IndexParam.builder()
        .fieldName("text_sparse")
        .indexName("text_sparse_index")
        .indexType(IndexParam.IndexType.SPARSE_INVERTED_INDEX)
        .metricType(IndexParam.MetricType.BM25)
        .extraParams(sparseParams)
        .build();

IndexParam indexParamForImageDense = IndexParam.builder()
        .fieldName("image_dense")
        .indexName("image_dense_index")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build();

List<IndexParam> indexParams = new ArrayList<>();
indexParams.add(indexParamForTextDense);
indexParams.add(indexParamForTextSparse);
indexParams.add(indexParamForImageDense);
indexOption1 := milvusclient.NewCreateIndexOption("my_collection", "text_dense",
    index.NewAutoIndex(index.MetricType(entity.IP)))
indexOption2 := milvusclient.NewCreateIndexOption("my_collection", "text_sparse",
    index.NewSparseInvertedIndex(entity.BM25, 0.2))
indexOption3 := milvusclient.NewCreateIndexOption("my_collection", "image_dense",
    index.NewAutoIndex(index.MetricType(entity.IP)))
const index_params = [{
    field_name: "text_dense",
    index_name: "text_dense_index",
    index_type: "AUTOINDEX",
    metric_type: "IP"
},{
    field_name: "text_sparse",
    index_name: "text_sparse_index",
    index_type: "SPARSE_INVERTED_INDEX",
    metric_type: "BM25",
    params: {
      inverted_index_algo: "DAAT_MAXSCORE",
    }
},{
    field_name: "image_dense",
    index_name: "image_dense_index",
    index_type: "AUTOINDEX",
    metric_type: "IP"
}]
export indexParams='[
        {
            "fieldName": "text_dense",
            "metricType": "IP",
            "indexName": "text_dense_index",
            "indexType":"AUTOINDEX"
        },
        {
            "fieldName": "text_sparse",
            "metricType": "BM25",
            "indexName": "text_sparse_index",
            "indexType": "SPARSE_INVERTED_INDEX",
            "params":{"inverted_index_algo": "DAAT_MAXSCORE"}
        },
        {
            "fieldName": "image_dense",
            "metricType": "IP",
            "indexName": "image_dense_index",
            "indexType":"AUTOINDEX"
        }
    ]'
milvus::IndexDesc text_sparse_index("text_sparse", "text_sparse_index", milvus::IndexType::SPARSE_INVERTED_INDEX, milvus::MetricType::BM25);
text_sparse_index.AddExtraParam("inverted_index_algo", "DAAT_MAXSCORE");

std::vector<milvus::IndexDesc> indexes = {
    milvus::IndexDesc("text_dense", "text_dense_index", milvus::IndexType::AUTOINDEX, milvus::MetricType::IP),
    text_sparse_index,
    milvus::IndexDesc("image_dense", "image_dense_index", milvus::IndexType::AUTOINDEX, milvus::MetricType::IP),
};
Creazione di una raccolta
Creare una collezione denominata demo con lo schema della collezione e gli indici configurati nei due passaggi precedenti.
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
CreateCollectionReq createCollectionReq = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexParams)
        .build();
client.createCollection(createCollectionReq);
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption1, indexOption2, indexOption3))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
res = await client.createCollection({
    collection_name: "my_collection",
    fields: fields,
    functions: functions,
    index_params: index_params,
})
export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
status = client->CreateCollection(milvus::CreateCollectionRequest()
                                      .WithCollectionName("my_collection")
                                      .WithCollectionSchema(schema)
                                      .WithIndexes(std::move(indexes)));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
Inserimento dei dati
Questa sezione inserisce i dati nella collezione " my_collection " in base allo schema definito in precedenza. Durante l'inserimento, assicurarsi che tutti i campi, ad eccezione di quelli con valori generati automaticamente, siano compilati con dati nel formato corretto. In questo esempio:
id: un numero intero che rappresenta l’ID del prodottotext: una stringa contenente la descrizione del prodottotext_dense: un elenco di 768 valori in virgola mobile che rappresentano l’embedding denso della descrizione testualeimage_dense: un elenco di 512 valori in virgola mobile che rappresentano l’embedding denso dell’immagine del prodotto
È possibile utilizzare modelli uguali o diversi per generare embedding densi per ciascun campo. In questo esempio, i due embedding densi hanno dimensioni diverse, il che suggerisce che siano stati generati da modelli diversi. Quando in seguito si definirà ciascuna ricerca, assicurarsi di utilizzare il modello corrispondente per generare l’embedding di query appropriato.
Poiché questo esempio utilizza la funzione integrata BM25 per generare embedding sparsi dal campo di testo, non è necessario fornire manualmente i vettori sparsi. Tuttavia, se si sceglie di non utilizzare BM25, è necessario precalcolare e fornire autonomamente gli embedding sparsi.
import random

# Generate example vectors
def generate_dense_vector(dim):
    return [random.random() for _ in range(dim)]

data=[
    {
        "id": 0,
        "text": "Red cotton t-shirt with round neck",
        "text_dense": generate_dense_vector(768),
        "image_dense": generate_dense_vector(512)
    },
    {
        "id": 1,
        "text": "Wireless noise-cancelling over-ear headphones",
        "text_dense": generate_dense_vector(768),
        "image_dense": generate_dense_vector(512)
    },
    {
        "id": 2,
        "text": "Stainless steel water bottle, 500ml",
        "text_dense": generate_dense_vector(768),
        "image_dense": generate_dense_vector(512)
    }
]

res = client.insert(
    collection_name="my_collection",
    data=data
)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;
import io.milvus.v2.service.vector.response.InsertResp;

Gson gson = new Gson();
JsonObject row1 = new JsonObject();
row1.addProperty("id", 0);
row1.addProperty("text", "Red cotton t-shirt with round neck");
row1.add("text_dense", gson.toJsonTree(new float[]{0.3580376395471989f, -0.6023495712049978f, 0.18414012509913835f, ...}));
row1.add("image_dense", gson.toJsonTree(new float[]{0.6366019600530924f, -0.09323198122475052f, ...}));

JsonObject row2 = new JsonObject();
row2.addProperty("id", 1);
row2.addProperty("text", "Wireless noise-cancelling over-ear headphones");
row2.add("text_dense", gson.toJsonTree(new float[]{0.19886812562848388f, 0.06023560599112088f, 0.6976963061752597f, ...}));
row2.add("image_dense", gson.toJsonTree(new float[]{0.6414180010301553f, 0.8976979978567611f, ...}));

JsonObject row3 = new JsonObject();
row3.addProperty("id", 2);
row3.addProperty("text", "Stainless steel water bottle, 500ml");
row3.add("text_dense", gson.toJsonTree(new float[]{0.43742130801983836f, -0.5597502546264526f, 0.6457887650909682f, ...}));
row3.add("image_dense", gson.toJsonTree(new float[]{-0.6901259768402174f, 0.6100500332193755f, ...}));

List<JsonObject> data = Arrays.asList(row1, row2, row3);
InsertReq insertReq = InsertReq.builder()
        .collectionName("my_collection")
        .data(data)
        .build();

InsertResp insertResp = client.insert(insertReq);
_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("my_collection").
    WithInt64Column("id", []int64{0, 1, 2}).
    WithVarcharColumn("text", []string{
        "Red cotton t-shirt with round neck",
        "Wireless noise-cancelling over-ear headphones",
        "Stainless steel water bottle, 500ml",
    }).
    WithFloatVectorColumn("text_dense", 768, [][]float32{
        {0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...},
        {0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...},
        {0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...},
    }).
    WithFloatVectorColumn("image_dense", 512, [][]float32{
        {0.6366019600530924, -0.09323198122475052, ...},
        {0.6414180010301553, 0.8976979978567611, ...},
        {-0.6901259768402174, 0.6100500332193755, ...},
    }))
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
const { MilvusClient, DataType } = require("@zilliz/milvus2-sdk-node")

var data = [
    {id: 0, text: "Red cotton t-shirt with round neck" , text_dense: [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...], image_dense: [0.6366019600530924, -0.09323198122475052, ...]},
    {id: 1, text: "Wireless noise-cancelling over-ear headphones" , text_dense: [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...], image_dense: [0.6414180010301553, 0.8976979978567611, ...]},
    {id: 2, text: "Stainless steel water bottle, 500ml" , text_dense: [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...], image_dense: [-0.6901259768402174, 0.6100500332193755, ...]}
]

var res = await client.insert({
    collection_name: "my_collection",
    data: data,
})
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "data": [
        {"id": 0, "text": "Red cotton t-shirt with round neck" , "text_dense": [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...], "image_dense": [0.6366019600530924, -0.09323198122475052, ...]},
        {"id": 1, "text": "Wireless noise-cancelling over-ear headphones" , "text_dense": [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...], "image_dense": [0.6414180010301553, 0.8976979978567611, ...]},
        {"id": 2, "text": "Stainless steel water bottle, 500ml" , "text_dense": [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...], "image_dense": [-0.6901259768402174, 0.6100500332193755, ...]}
    ],
    "collectionName": "my_collection"
}'
#include <random>

std::vector<float>
GenerateFloatVector(int dimension) {
    std::random_device rd;
    std::mt19937 ran(rd());
    std::uniform_real_distribution<float> float_gen(0.0, 1.0);
    std::vector<float> vector(dimension);
    for (auto d = 0; d < dimension; ++d) {
        vector[d] = float_gen(ran);
    }
    return vector;
}

milvus::EntityRows data = {
    {{"id", 0}, {"text", "Red cotton t-shirt with round neck"}, {"text_dense", GenerateFloatVector(768)}, {"image_dense", GenerateFloatVector(512)}},
    {{"id", 1}, {"text", "Wireless noise-cancelling over-ear headphones"}, {"text_dense", GenerateFloatVector(768)}, {"image_dense", GenerateFloatVector(512)}},
    {{"id", 2}, {"text", "Stainless steel water bottle, 500ml"}, {"text_dense", GenerateFloatVector(768)}, {"image_dense", GenerateFloatVector(512)}}
};

milvus::InsertResponse response;
status = client->Insert(milvus::InsertRequest()
                            .WithCollectionName("my_collection")
                            .WithRowsData(std::move(data)),
                        response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
Eseguire una ricerca ibrida
Passaggio 1: Creare più istanze di AnnSearchRequest
La ricerca ibrida viene implementata creando più istanze di ` AnnSearchRequest ` nella funzione ` hybrid_search() `, dove ogni ` AnnSearchRequest ` rappresenta una richiesta di ricerca ANN di base per un campo vettoriale specifico. Pertanto, prima di eseguire una ricerca ibrida, è necessario creare un ` AnnSearchRequest ` per ciascun campo vettoriale.
Inoltre, configurando il parametro expr in un AnnSearchRequest, è possibile impostare le condizioni di filtraggio per la ricerca ibrida. Si prega di fare riferimento alle sezioni Ricerca filtrata e Spiegazione del filtraggio.
Nella ricerca ibrida, ogni AnnSearchRequest supporta un solo set di dati di query.
Per dimostrare le capacità dei vari campi vettoriali di ricerca, costruiremo tre richieste di ricerca " AnnSearchRequest " utilizzando una query di esempio. Per questo processo utilizzeremo anche i relativi vettori densi precalcolati. Le richieste di ricerca avranno come obiettivo i seguenti campi vettoriali:
text_denseper la ricerca semantica nel testo, che consente la comprensione contestuale e il recupero in base al significato piuttosto che alla corrispondenza diretta delle parole chiave.text_sparseper la ricerca full-text o la corrispondenza delle parole chiave, concentrandosi sulle corrispondenze esatte di parole o frasi all’interno del testo.image_denseper la ricerca multimodale da testo a immagine, al fine di recuperare immagini di prodotti pertinenti in base al contenuto semantico della query.
from pymilvus import AnnSearchRequest

query_text = "white headphones, quiet and comfortable"
query_dense_vector = generate_dense_vector(768)
query_multimodal_vector = generate_dense_vector(512)

# text semantic search (dense)
search_param_1 = {
    "data": [query_dense_vector],
    "anns_field": "text_dense",
    "param": {"nprobe": 10},
    "limit": 2
}
request_1 = AnnSearchRequest(**search_param_1)

# full-text search (sparse)
search_param_2 = {
    "data": [query_text],
    "anns_field": "text_sparse",
    "param": {},
    "limit": 2
}
request_2 = AnnSearchRequest(**search_param_2)

# text-to-image search (multimodal)
search_param_3 = {
    "data": [query_multimodal_vector],
    "anns_field": "image_dense",
    "param": {"nprobe": 10},
    "limit": 2
}
request_3 = AnnSearchRequest(**search_param_3)

reqs = [request_1, request_2, request_3]
import io.milvus.v2.service.vector.request.AnnSearchReq;
import io.milvus.v2.service.vector.request.data.BaseVector;
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.request.data.SparseFloatVec;
import io.milvus.v2.service.vector.request.data.EmbeddedText;

float[] queryDense = new float[]{-0.0475336798f,  0.0521207601f,  0.0904406682f, ...};
float[] queryMultimodal = new float[]{0.0158298651f, 0.5264158340f, ...};

List<BaseVector> queryTexts = Collections.singletonList(new EmbeddedText("white headphones, quiet and comfortable"));
List<BaseVector> queryDenseVectors = Collections.singletonList(new FloatVec(queryDense));
List<BaseVector> queryMultimodalVectors = Collections.singletonList(new FloatVec(queryMultimodal));

List<AnnSearchReq> searchRequests = new ArrayList<>();
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_dense")
        .vectors(queryDenseVectors)
        .params("{\"nprobe\": 10}")
        .topK(2)
        .build());
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_sparse")
        .vectors(queryTexts)
        .topK(2)
        .build());
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("image_dense")
        .vectors(queryMultimodalVectors)
        .params("{\"nprobe\": 10}")
        .topK(2)
        .build());
queryText := entity.Text("white headphones, quiet and comfortable")
queryVector := []float32{0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...}
queryMultimodalVector := []float32{0.015829865178701663, 0.5264158340734488, ...}

request1 := milvusclient.NewAnnRequest("text_dense", 2, entity.FloatVector(queryVector)).
    WithAnnParam(index.NewIvfAnnParam(10))

annParam := index.NewSparseAnnParam()
annParam.WithDropRatio(0.2)
request2 := milvusclient.NewAnnRequest("text_sparse", 2, queryText).
    WithAnnParam(annParam)

request3 := milvusclient.NewAnnRequest("image_dense", 2, entity.FloatVector(queryMultimodalVector)).
    WithAnnParam(index.NewIvfAnnParam(10))
const query_text = "white headphones, quiet and comfortable"
const query_vector = [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...]
const query_multimodal_vector = [0.015829865178701663, 0.5264158340734488, ...]

const search_param_1 = {
    "data": query_vector,
    "anns_field": "text_dense",
    "params": {"nprobe": 10},
    "limit": 2
}

const search_param_2 = {
    "data": query_text,
    "anns_field": "text_sparse",
    "limit": 2
}

const search_param_3 = {
    "data": query_multimodal_vector,
    "anns_field": "image_dense",
    "params": {"nprobe": 10},
    "limit": 2
}
export req='[
    {
        "data": [[0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...]],
        "annsField": "text_dense",
        "params": {"nprobe": 10},
        "limit": 2
    },
    {
        "data": ["white headphones, quiet and comfortable"],
        "annsField": "text_sparse",
        "limit": 2
    },
    {
        "data": [[0.015829865178701663, 0.5264158340734488, ...]],
        "annsField": "image_dense",
        "params": {"nprobe": 10},
        "limit": 2
    }
 ]'
auto query_text = "white headphones, quiet and comfortable";
auto query_dense_vector = GenerateFloatVector(768);
auto query_multimodal_vector = GenerateFloatVector(512);

// text semantic search (dense)
auto sub_req1 = milvus::SubSearchRequest()
                    .AddFloatVector(query_dense_vector)
                    .WithAnnsField("text_dense")
                    .WithLimit(2);
sub_req1.AddExtraParam("nprobe", "10");

// full-text search (sparse)
auto sub_req2 = milvus::SubSearchRequest()
                    .AddEmbeddedText(query_text)
                    .WithAnnsField("text_sparse")
                    .WithLimit(2);

// text-to-image search (multimodal)
auto sub_req3 = milvus::SubSearchRequest()
                    .AddFloatVector(query_multimodal_vector)
                    .WithAnnsField("image_dense")
                    .WithLimit(2);
sub_req3.AddExtraParam("nprobe", "10");
Dato che il parametro limit è impostato su 2, ogni AnnSearchRequest restituisce 2 risultati di ricerca. In questo esempio, vengono create 3 istanze di AnnSearchRequest, per un totale di 6 risultati di ricerca.
Fase 2: Configurare una strategia di riclassificazione
Per unire e riorganizzare in ordine di rilevanza gli insiemi di risultati di ricerca ANN, è essenziale selezionare una strategia di riorganizzazione adeguata. Milvus offre diversi tipi di strategie di riorganizzazione. Per ulteriori dettagli su questi meccanismi di riorganizzazione, fare riferimento a Weighted Ranker o RRF Ranker.
In questo esempio, poiché non vi è particolare enfasi su specifiche query di ricerca, procederemo con la strategia RRFRanker.
ranker = Function(
    name="rrf",
    input_field_names=[], # Must be an empty list
    function_type=FunctionType.RERANK,
    params={
        "reranker": "rrf",
        "k": 100  # Optional
    }
)
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.CreateCollectionReq.Function;

Function ranker = Function.builder()
        .name("rrf")
        .functionType(FunctionType.RERANK)
        .param("reranker", "rrf")
        .param("k", "100")
        .build();
const rerank = {
  name: 'rrf',
  description: 'bm25 function',
  type: FunctionType.RERANK,
  input_field_names: [],
  params: {
      "reranker": "rrf",
      "k": 100
  },
};
reranker := milvusclient.NewRRFReranker().WithK(100)
# Restful
export rerank='{"k": 100}'
auto ranker = std::make_shared<milvus::RRFRerank>(100);
Passaggio 3: Eseguire una ricerca ibrida
Prima di avviare una ricerca ibrida, assicurarsi che la collezione sia caricata. Se alcuni campi vettoriali all’interno della collezione non dispongono di un indice o non sono caricati in memoria, si verificherà un errore durante l’esecuzione del metodo di ricerca ibrida.
res = client.hybrid_search(
    collection_name="my_collection",
    reqs=reqs,
    ranker=ranker,
    limit=2
)
for hits in res:
    print("TopK results:")
    for hit in hits:
        print(hit)
import io.milvus.v2.common.ConsistencyLevel;
import io.milvus.v2.service.vector.request.HybridSearchReq;
import io.milvus.v2.service.vector.response.SearchResp;

HybridSearchReq hybridSearchReq = HybridSearchReq.builder()
        .collectionName("my_collection")
        .searchRequests(searchRequests)
        .ranker(ranker)
        .topK(2)
        .build();

SearchResp searchResp = client.hybridSearch(hybridSearchReq);
resultSets, err := client.HybridSearch(ctx, milvusclient.NewHybridSearchOption(
    "my_collection",
    2,
    request1,
    request2,
    request3,
).WithReranker(reranker))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
}
const { MilvusClient, DataType } = require("@zilliz/milvus2-sdk-node")

res = await client.loadCollection({
    collection_name: "my_collection"
})

import { MilvusClient, RRFRanker, WeightedRanker } from '@zilliz/milvus2-sdk-node';

const search = await client.search({
  collection_name: "my_collection",
  data: [search_param_1, search_param_2, search_param_3],
  limit: 2,
  rerank: rerank
});
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/hybrid_search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"search\": ${req},
    \"rerank\": {
        \"strategy\":\"rrf\",
        \"params\": ${rerank}
    },
    \"limit\": 2
}"
auto request = milvus::HybridSearchRequest()
                   .WithCollectionName("my_collection")
                   .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(sub_req1)))
                   .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(sub_req2)))
                   .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(sub_req3)))
                   .WithRerank(ranker)
                   .WithLimit(2);

milvus::SearchResponse response;
status = client->HybridSearch(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

for (auto& result : response.Results().Results()) {
    std::cout << "TopK results:" << std::endl;
    milvus::EntityRows output_rows;
    status = result.OutputRows(output_rows);
    for (const auto& row : output_rows) {
        std::cout << "\t" << row << std::endl;
    }
}
Di seguito è riportato l’output:
["['id: 1, distance: 0.006047376897186041, entity: {}', 'id: 2, distance: 0.006422005593776703, entity: {}']"]
Con il parametro ` limit=2 ` specificato per la ricerca ibrida, Milvus riclassificherà i sei risultati ottenuti dalle tre ricerche. Alla fine, verranno restituiti solo i due risultati più simili.
Utilizzo avanzato
Impostazione temporanea di un fuso orario per una ricerca ibrida
Se la collezione dispone di un campo " TIMESTAMPTZ ", è possibile sovrascrivere temporaneamente il fuso orario predefinito del database o della collezione per una singola operazione impostando il parametro " timezone " nella chiamata di ricerca ibrida. Ciò determina la modalità di visualizzazione e confronto dei valori " TIMESTAMPTZ " durante l'operazione.
Il valore di ` timezone ` deve essere un identificatore di fuso orario IANA valido (ad esempio, `Asia/Shanghai`, `America/Chicago` o `UTC`). Per ulteriori dettagli su come utilizzare il campo ` TIMESTAMPTZ `, consultare il campo `TIMESTAMPTZ`.
L'esempio riportato di seguito mostra come impostare temporaneamente un fuso orario per un'operazione di ricerca ibrida:
res = client.hybrid_search(
    collection_name="my_collection",
    reqs=reqs,
    ranker=ranker,
    limit=2,
    timezone="America/Havana",
)
List<AnnSearchReq> tzRequests = new ArrayList<>();
tzRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_dense")
        .vectors(queryDenseVectors)
        .params("{\"nprobe\": 10}")
        .topK(2)
        .timezone("America/Havana")
        .build());
tzRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_sparse")
        .vectors(queryTexts)
        .topK(2)
        .timezone("America/Havana")
        .build());
tzRequests.add(AnnSearchReq.builder()
        .vectorFieldName("image_dense")
        .vectors(queryMultimodalVectors)
        .params("{\"nprobe\": 10}")
        .topK(2)
        .timezone("America/Havana")
        .build());

HybridSearchReq tzHybridSearchReq = HybridSearchReq.builder()
        .collectionName("my_collection")
        .searchRequests(tzRequests)
        .ranker(ranker)
        .topK(2)
        .build();

SearchResp tzSearchResp = client.hybridSearch(tzHybridSearchReq);
tzRequest1 := milvusclient.NewAnnRequest("text_dense", 2, entity.FloatVector(queryVector)).
    WithAnnParam(index.NewIvfAnnParam(10)).
    WithSearchParam("timezone", "America/Havana")

tzRequest2 := milvusclient.NewAnnRequest("text_sparse", 2, queryText).
    WithAnnParam(annParam).
    WithSearchParam("timezone", "America/Havana")

tzRequest3 := milvusclient.NewAnnRequest("image_dense", 2, entity.FloatVector(queryMultimodalVector)).
    WithAnnParam(index.NewIvfAnnParam(10)).
    WithSearchParam("timezone", "America/Havana")

resultSets, err = client.HybridSearch(ctx, milvusclient.NewHybridSearchOption(
    "my_collection",
    2,
    tzRequest1,
    tzRequest2,
    tzRequest3,
).WithReranker(reranker))
res = await client.search({
  collection_name: "my_collection",
  data: [
    { ...search_param_1, params: { "nprobe": 10, timezone: "America/Havana" } },
    { ...search_param_2, params: { timezone: "America/Havana" } },
    { ...search_param_3, params: { "nprobe": 10, timezone: "America/Havana" } },
  ],
  limit: 2,
  rerank: rerank
});
# restful
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/hybrid_search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
-d '{
    "collectionName": "my_collection",
    "search": [
        {
            "data": [[0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...]],
            "annsField": "text_dense",
            "params": {"nprobe": 10, "timezone": "America/Havana"},
            "limit": 2
        },
        {
            "data": ["white headphones, quiet and comfortable"],
            "annsField": "text_sparse",
            "params": {"timezone": "America/Havana"},
            "limit": 2
        },
        {
            "data": [[0.015829865178701663, 0.5264158340734488, ...]],
            "annsField": "image_dense",
            "params": {"nprobe": 10, "timezone": "America/Havana"},
            "limit": 2
        }
    ],
    "rerank": {
        "strategy": "rrf",
        "params": {"k": 100}
    },
    "limit": 2
}'
auto tz_req1 = milvus::SubSearchRequest()
                   .AddFloatVector(query_dense_vector)
                   .WithAnnsField("text_dense")
                   .WithTimezone("America/Havana")
                   .WithLimit(2);
tz_req1.AddExtraParam("nprobe", "10");

auto tz_req2 = milvus::SubSearchRequest()
                   .AddEmbeddedText(query_text)
                   .WithAnnsField("text_sparse")
                   .WithTimezone("America/Havana")
                   .WithLimit(2);

auto tz_req3 = milvus::SubSearchRequest()
                   .AddFloatVector(query_multimodal_vector)
                   .WithAnnsField("image_dense")
                   .WithTimezone("America/Havana")
                   .WithLimit(2);
tz_req3.AddExtraParam("nprobe", "10");

auto tz_request = milvus::HybridSearchRequest()
                      .WithCollectionName("my_collection")
                      .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(tz_req1)))
                      .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(tz_req2)))
                      .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(tz_req3)))
                      .WithRerank(ranker)
                      .WithLimit(2);

milvus::SearchResponse tz_response;
status = client->HybridSearch(tz_request, tz_response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
