

Panoramica sull'analizzatore
Nell'elaborazione del testo, un analizzatore è un componente fondamentale che converte il testo grezzo in un formato strutturato e ricercabile. Ogni analizzatore è costituito in genere da due elementi principali: il tokenizzatore e il filtro. Insieme, trasformano il testo in ingresso in token, perfezionano tali token e li preparano per un'indicizzazione e un recupero efficienti.
In Milvus, gli analizzatori vengono configurati durante la creazione della collezione, quando si aggiungono campi di tip VARCHAR a allo schema della collezione. I token prodotti da un analizzatore possono essere utilizzati per costruire un indice per la corrispondenza delle parole chiave oppure convertiti in embedding sparsi per la ricerca full-text. Per ulteriori informazioni, consultare Ricerca full-text, Corrispondenza di frasi o Corrispondenza di testo.
L’uso degli analizzatori può influire sulle prestazioni:
Ricerca full-text: per la ricerca full-text, i canali DataNode e QueryNode consumano i dati più lentamente poiché devono attendere il completamento della tokenizzazione. Di conseguenza, i dati appena acquisiti impiegano più tempo a diventare disponibili per la ricerca.
Corrispondenza per parola chiave: anche per la corrispondenza per parola chiave la creazione dell’indice è più lenta, poiché la tokenizzazione deve essere completata prima che l’indice possa essere creato.
Anatomia di un analizzatore
Un analizzatore in Milvus è costituito esattamente da un tokenizzatore e da zero o più filtri.
Tokenizzatore: il tokenizzatore suddivide il testo in ingresso in unità discrete chiamate token. Questi token possono essere parole o frasi, a seconda del tipo di tokenizzatore.
Filtri: i filtri possono essere applicati ai token per perfezionarli ulteriormente, ad esempio convertendoli in minuscolo o rimuovendo le parole comuni.
I tokenizzatori supportano solo il formato UTF-8. Il supporto per altri formati verrà aggiunto nelle versioni future.
Il flusso di lavoro riportato di seguito illustra come un analizzatore elabora il testo.
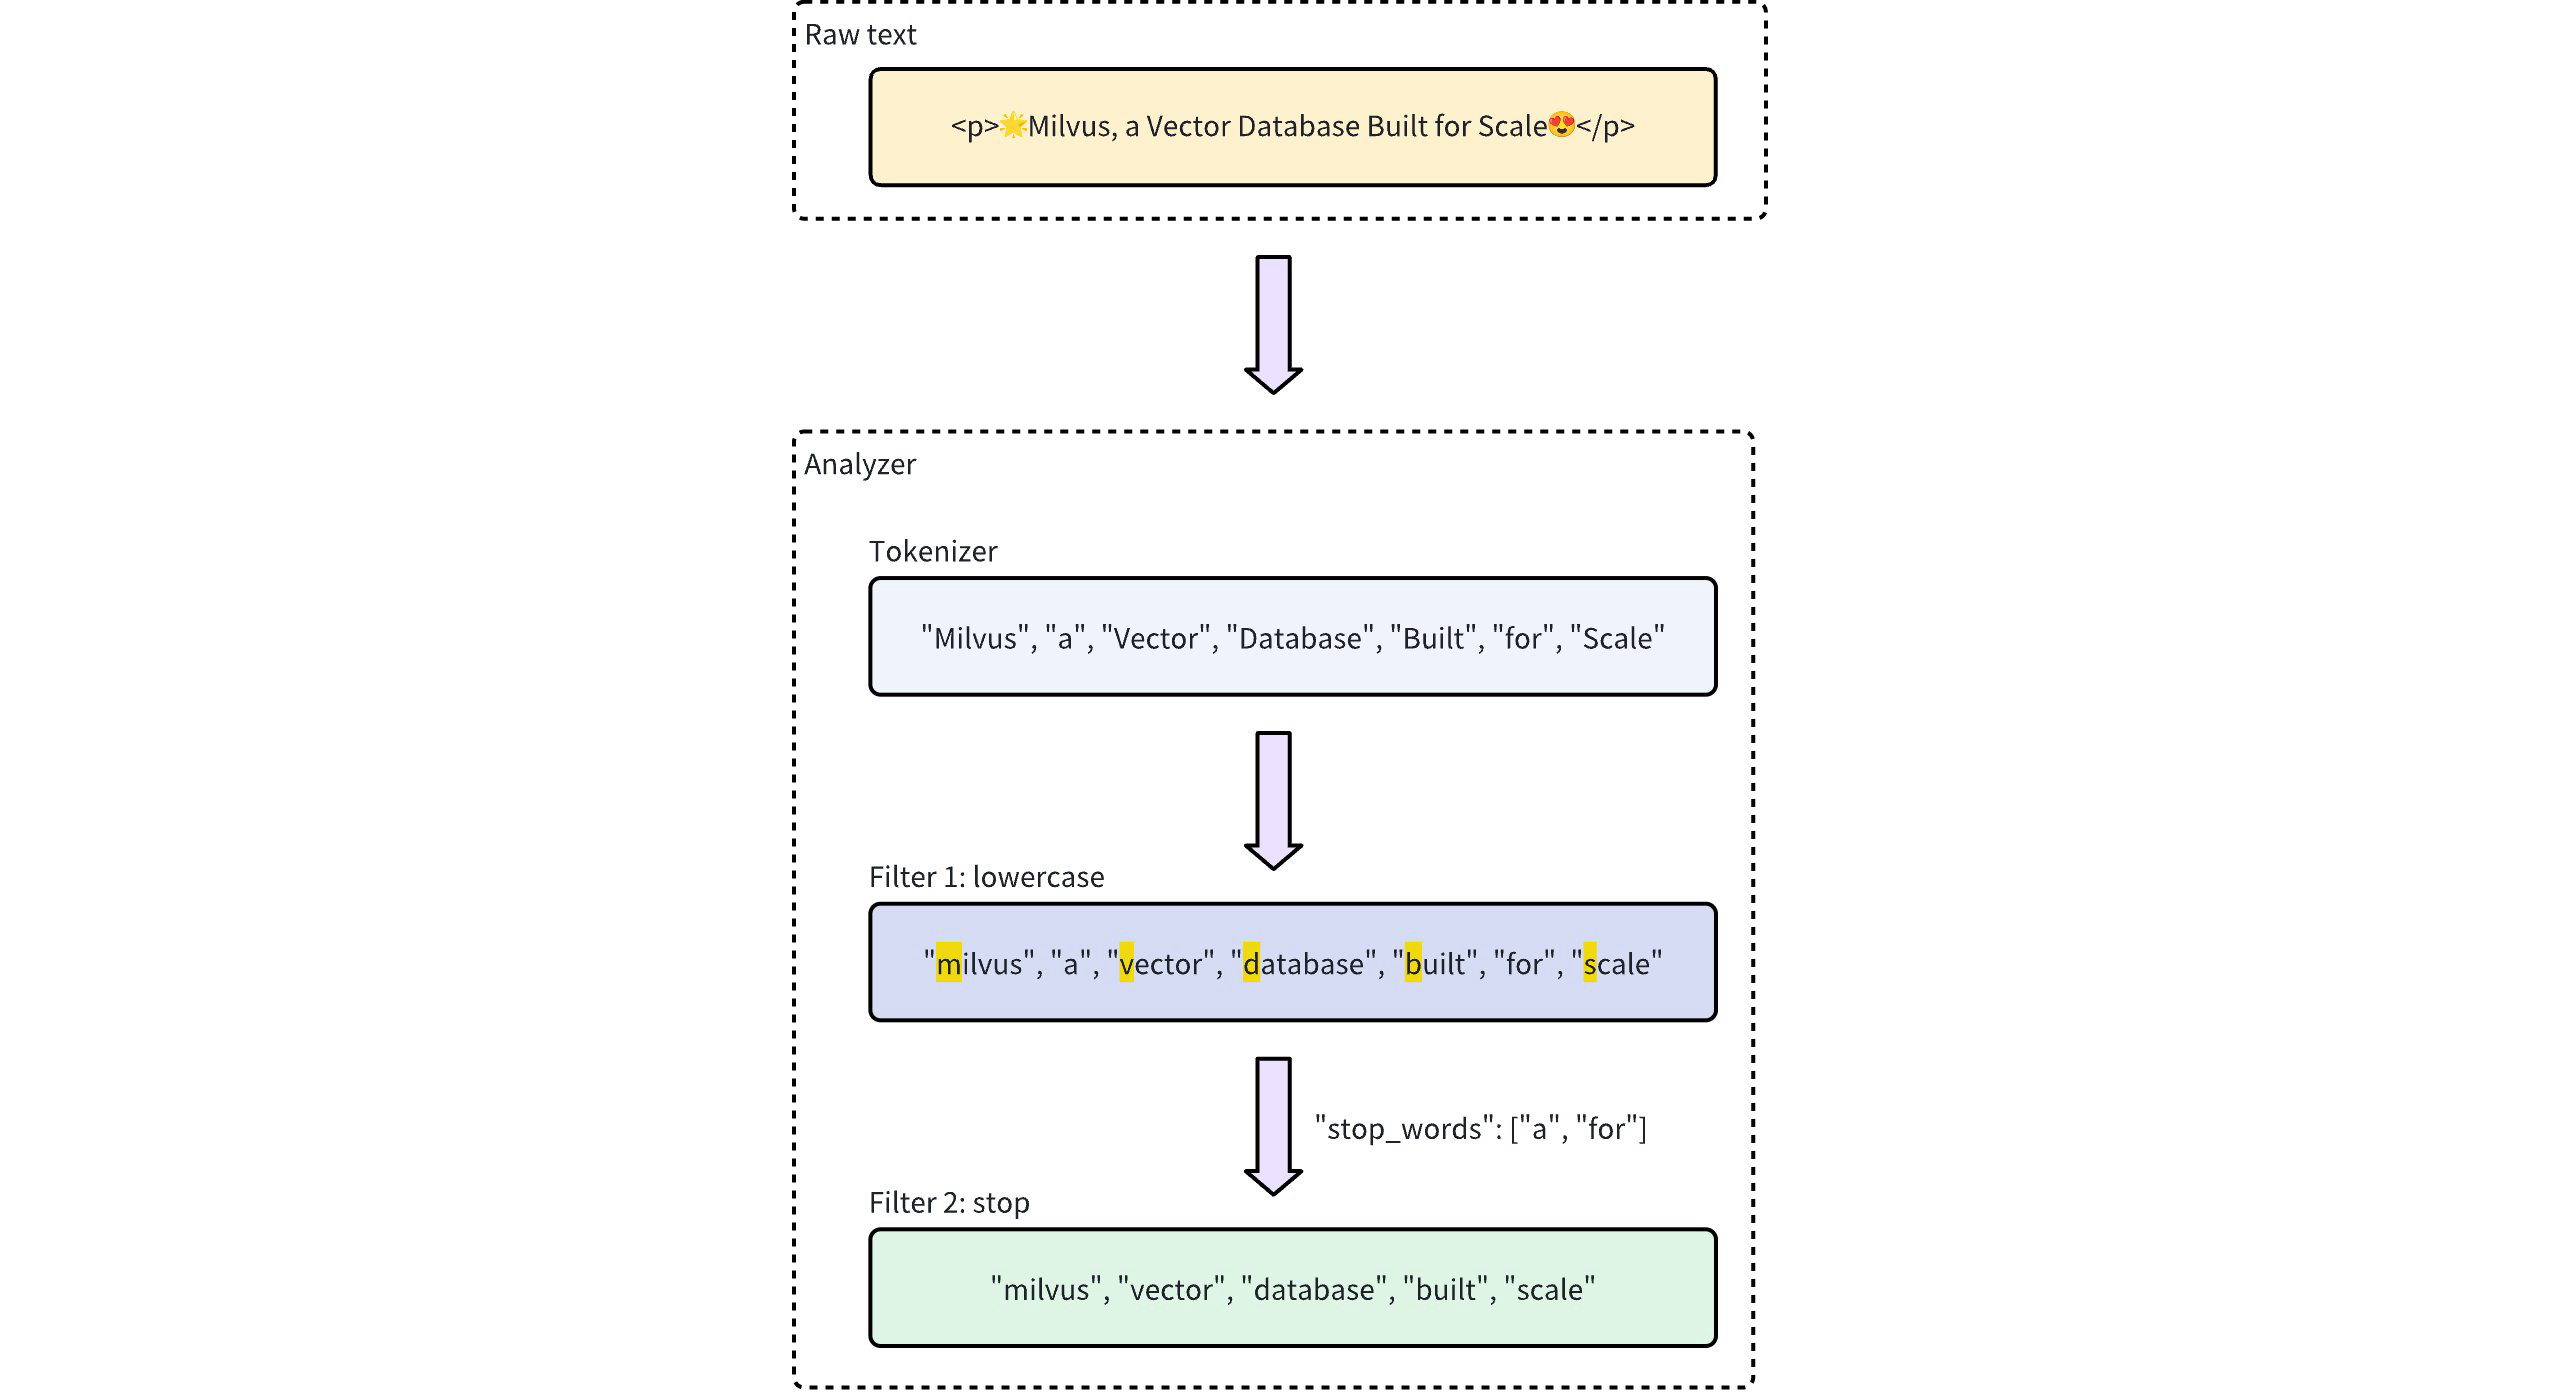 Flusso di lavoro del processo di analisi
Tipi di analizzatori
Milvus offre due tipi di analizzatori per soddisfare diverse esigenze di elaborazione del testo:
Analizzatore integrato: si tratta di configurazioni predefinite che coprono le attività comuni di elaborazione del testo con una configurazione minima. Gli analizzatori integrati sono ideali per ricerche generiche, poiché non richiedono configurazioni complesse.
Analizzatore personalizzato: per esigenze più avanzate, gli analizzatori personalizzati consentono di definire la propria configurazione specificando sia il tokenizzatore che zero o più filtri. Questo livello di personalizzazione è particolarmente utile per casi d’uso specializzati in cui è necessario un controllo preciso sull’elaborazione del testo.
- Se si omettono le configurazioni dell’analizzatore durante la creazione della raccolta, Milvus utilizza per impostazione predefinita l’analizzatore
standardper tutta l’elaborazione del testo. Per ulteriori dettagli, consultare Analizzatore standard. - Per ottenere prestazioni ottimali nella ricerca e nelle query, scegli un analizzatore che corrisponda alla lingua dei tuoi dati testuali. Ad esempio, sebbene l’analizzatore
standardsia versatile, potrebbe non essere la scelta migliore per lingue con strutture grammaticali particolari, come il cinese, l’arabo, il thailandese, il giapponese o il coreano. In tali casi, è consigliabile utilizzare un analizzatore specifico per la lingua, comechinese,arabic, othai, oppure analizzatori personalizzati con tokenizzatori specializzati (comelindera,icu) e filtri è altamente raccomandato per garantire una tokenizzazione accurata e risultati di ricerca migliori.
Analizzatore integrato
Gli analizzatori integrati in Milvus sono preconfigurati con tokenizzatori e filtri specifici, consentendo di utilizzarli immediatamente senza dover definire autonomamente tali componenti. Ciascun analizzatore integrato funge da modello che include un tokenizzatore e filtri preimpostati, con parametri opzionali per la personalizzazione.
Ad esempio, per utilizzare l’analizzatore integrato « standard », è sufficiente specificarne il nome « standard » come « type » e, facoltativamente, includere configurazioni aggiuntive specifiche per questo tipo di analizzatore, come « stop_words »:
analyzer_params = {
    "type": "standard", # Uses the standard built-in analyzer
    "stop_words": ["a", "an", "for"] # Defines a list of common words (stop words) to exclude from tokenization
}
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("type", "standard");
analyzerParams.put("stop_words", Arrays.asList("a", "an", "for"));
const analyzer_params = {
    "type": "standard", // Uses the standard built-in analyzer
    "stop_words": ["a", "an", "for"] // Defines a list of common words (stop words) to exclude from tokenization
};
analyzerParams := map[string]any{"type": "standard", "stop_words": []string{"a", "an", "for"}}
export analyzerParams='{
       "type": "standard",
       "stop_words": ["a", "an", "for"]
    }'
Per verificare il risultato dell’esecuzione di un analizzatore, utilizzare il metodo run_analyzer:
# Sample text to analyze
text = "An efficient system relies on a robust analyzer to correctly process text for various applications."

# Run analyzer
result = client.run_analyzer(
    text,
    analyzer_params
)
import io.milvus.v2.service.vector.request.RunAnalyzerReq;
import io.milvus.v2.service.vector.response.RunAnalyzerResp;

List<String> texts = new ArrayList<>();
texts.add("An efficient system relies on a robust analyzer to correctly process text for various applications.");

RunAnalyzerResp resp = client.runAnalyzer(RunAnalyzerReq.builder()
        .texts(texts)
        .analyzerParams(analyzerParams)
        .build());
List<RunAnalyzerResp.AnalyzerResult> results = resp.getResults();
// javascrip# Sample text to analyze
const text = "An efficient system relies on a robust analyzer to correctly process text for various applications."

// Run analyzer
const result = await client.run_analyzer({
    text,
    analyzer_params
});
import (
    "context"
    "encoding/json"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

bs, _ := json.Marshal(analyzerParams)
texts := []string{"An efficient system relies on a robust analyzer to correctly process text for various applications."}
option := milvusclient.NewRunAnalyzerOption(texts).
    WithAnalyzerParams(string(bs))

result, err := client.RunAnalyzer(ctx, option)
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
# restful
L'output sarà:
['efficient', 'system', 'relies', 'on', 'robust', 'analyzer', 'to', 'correctly', 'process', 'text', 'various', 'applications']
Ciò dimostra che l'analizzatore tokenizza correttamente il testo di input filtrando le parole vuote "a", "an" e "for", restituendo al contempo i token significativi rimanenti.
La configurazione dell’analizzatore integrato standard sopra riportata è equivalente alla configurazione di un analizzatore personalizzato con i seguenti parametri, in cui le opzioni tokenizer e filter sono definite esplicitamente per ottenere una funzionalità simile:
analyzer_params = {
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stop",
            "stop_words": ["a", "an", "for"]
        }
    ]
}
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("tokenizer", "standard");
analyzerParams.put("filter",
        Arrays.asList("lowercase",
                new HashMap<String, Object>() {{
                    put("type", "stop");
                    put("stop_words", Arrays.asList("a", "an", "for"));
                }}));
const analyzer_params = {
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stop",
            "stop_words": ["a", "an", "for"]
        }
    ]
};
analyzerParams = map[string]any{"tokenizer": "standard",
    "filter": []any{"lowercase", map[string]any{
        "type":       "stop",
        "stop_words": []string{"a", "an", "for"},
    }}}
export analyzerParams='{
       "type": "standard",
       "filter":  [
       "lowercase",
       {
            "type": "stop",
            "stop_words": ["a", "an", "for"]
       }
   ]
}'
Milvus offre i seguenti analizzatori integrati, ciascuno progettato per specifiche esigenze di elaborazione del testo:
standard: Adatto all’elaborazione di testo generica, applicando la tokenizzazione standard e il filtraggio delle lettere minuscole.english: Ottimizzato per testi in lingua inglese, con supporto per le parole vuote inglesi.chinese: Specializzato per l’elaborazione di testi in cinese, inclusa la tokenizzazione adattata alle strutture della lingua cinese.arabic: Specializzato per il testo arabo, con normalizzazione araba, normalizzazione delle cifre decimali, stemming arabo e rimozione delle parole vuote arabe.thai: Specializzato per testi in thailandese, con segmentazione delle parole in thailandese, normalizzazione delle cifre decimali e rimozione delle parole vuote in thailandese.
Analizzatore personalizzato
Per un'elaborazione del testo più avanzata, gli analizzatori personalizzati di Milvus consentono di creare una pipeline di gestione del testo su misura, specificando sia un tokenizzatore che dei filtri. Questa configurazione è ideale per casi d'uso specializzati in cui è richiesto un controllo preciso.
Tokenizzatore
Il tokenizer è un componente obbligatorio per un analizzatore personalizzato, che avvia la pipeline di analisi suddividendo il testo in ingresso in unità discrete o token. La tokenizzazione segue regole specifiche, come la suddivisione in base agli spazi o alla punteggiatura, a seconda del tipo di tokenizer. Questo processo consente una gestione più precisa e indipendente di ogni parola o frase.
Ad esempio, un tokenizer convertirebbe il testo "Vector Database Built for Scale" in token separati:
["Vector", "Database", "Built", "for", "Scale"]
Esempio di specificazione di un tokenizer:
analyzer_params = {
    "tokenizer": "whitespace",
}
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("tokenizer", "whitespace");
const analyzer_params = {
    "tokenizer": "whitespace",
};
analyzerParams = map[string]any{"tokenizer": "whitespace"}
export analyzerParams='{
       "type": "whitespace"
    }'
Filtro
I filtri sono componenti opzionali che agiscono sui token prodotti dal tokenizzatore, trasformandoli o perfezionandoli secondo necessità. Ad esempio, dopo aver applicato un filtro " lowercase " ai termini tokenizzati ["Vector", "Database", "Built", "for", "Scale"], il risultato potrebbe essere:
["vector", "database", "built", "for", "scale"]
I filtri in un analizzatore personalizzato possono essere integrati o personalizzati, a seconda delle esigenze di configurazione.
Filtri integrati: preconfigurati da Milvus, richiedono una configurazione minima. È possibile utilizzare questi filtri immediatamente specificandone i nomi. I filtri riportati di seguito sono integrati e pronti all’uso:
lowercase: Converte il testo in minuscolo, garantendo una corrispondenza che non distingue tra maiuscole e minuscole. Per i dettagli, consultare Minuscolo.asciifolding: Converte i caratteri non ASCII nei loro equivalenti ASCII, semplificando la gestione del testo multilingue. Per i dettagli, consultare " ASCII folding".alphanumonly: Mantiene solo i caratteri alfanumerici rimuovendo gli altri. Per i dettagli, consultare Alphanumonly.cnalphanumonly: Rimuove i token che contengono caratteri diversi da quelli cinesi, lettere inglesi o cifre. Per i dettagli, consultare Cnalphanumonly.cncharonly: Rimuove i token che contengono qualsiasi carattere non cinese. Per ulteriori dettagli, consultare Cncharonly.pinyin: Aggiunge forme di token Pinyin per i token cinesi, consentendo la corrispondenza basata sul Pinyin per il testo cinese. Per ulteriori dettagli, consultare Pinyin.
Esempio di utilizzo di un filtro integrato:
analyzer_params = {
    "tokenizer": "standard", # Mandatory: Specifies tokenizer
    "filter": ["lowercase"], # Optional: Built-in filter that converts text to lowercase
}
Map<String, Object> analyzerParams = new HashMap<>(); analyzerParams.put("tokenizer", "standard"); analyzerParams.put("filter", Collections.singletonList("lowercase"));const analyzer_params = { "tokenizer": "standard", // Mandatory: Specifies tokenizer "filter": ["lowercase"], // Optional: Built-in filter that converts text to lowercase }analyzerParams = map[string]any{"tokenizer": "standard", "filter": []any{"lowercase"}}export analyzerParams='{ "type": "standard", "filter": ["lowercase"] }'Filtri personalizzati: i filtri personalizzati consentono configurazioni specializzate. È possibile definire un filtro personalizzato scegliendo un tipo di filtro valido (
filter.type) e aggiungendo impostazioni specifiche per ciascun tipo di filtro. Esempi di tipi di filtro che supportano la personalizzazione:stop: Rimuove parole comuni specificate impostando un elenco di parole di stop (ad es.,"stop_words": ["of", "to"]). Per ulteriori dettagli, consultare la sezione Stop.length: Esclude i token in base a criteri di lunghezza, come l’impostazione di una lunghezza massima del token. Per ulteriori dettagli, consultare la sezione «Length».stemmer: Riduce le parole alle loro forme radice per una corrispondenza più flessibile. Per i dettagli, consultare la sezione " Stemmer".
Esempio di configurazione di un filtro personalizzato:
analyzer_params = {
    "tokenizer": "standard", # Mandatory: Specifies tokenizer
    "filter": [
        {
            "type": "stop", # Specifies 'stop' as the filter type
            "stop_words": ["of", "to"], # Customizes stop words for this filter type
        }
    ]
}
Map<String, Object> analyzerParams = new HashMap<>(); analyzerParams.put("tokenizer", "standard"); analyzerParams.put("filter", Collections.singletonList(new HashMap<String, Object>() {{ put("type", "stop"); put("stop_words", Arrays.asList("a", "an", "for")); }}));const analyzer_params = { "tokenizer": "standard", // Mandatory: Specifies tokenizer "filter": [ { "type": "stop", // Specifies 'stop' as the filter type "stop_words": ["of", "to"], // Customizes stop words for this filter type } ] };analyzerParams = map[string]any{"tokenizer": "standard", "filter": []any{map[string]any{ "type": "stop", "stop_words": []string{"of", "to"}, }}}export analyzerParams='{ "type": "standard", "filter": [ { "type": "stop", "stop_words": ["a", "an", "for"] } ] }'
Esempio di utilizzo
In questo esempio, creerai uno schema di raccolta che include:
Un campo vettoriale per gli embedding.
Due campi "
VARCHAR" per l'elaborazione del testo:Un campo utilizza un analizzatore integrato.
L'altro utilizza un analizzatore personalizzato.
Prima di incorporare queste configurazioni nella propria collezione, si verificherà ciascun analizzatore utilizzando il metodo ` run_analyzer `.
Passaggio 1: inizializzare MilvusClient e creare lo schema
Inizia configurando il client Milvus e creando un nuovo schema.
from pymilvus import MilvusClient, DataType

# Set up a Milvus client
client = MilvusClient(uri="http://localhost:19530")

# Create a new schema
schema = client.create_schema(auto_id=True, enable_dynamic_field=False)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.v2.common.IndexParam;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

// Set up a Milvus client
ConnectConfig config = ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build();
MilvusClientV2 client = new MilvusClientV2(config);

// Create schema
CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .enableDynamicField(false)
        .build();
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

// Set up a Milvus client
const client = new MilvusClient("http://localhost:19530");
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

cli, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: "localhost:19530",
})
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
defer client.Close(ctx)

schema := entity.NewSchema().WithAutoID(true).WithDynamicFieldEnabled(false)
# restful
Passaggio 2: Definire e verificare le configurazioni degli analizzatori
Configurare e verificare un analizzatore integrato (
english):Configurazione: definire i parametri dell'analizzatore per l'analizzatore predefinito in inglese.
Verifica: utilizzare
run_analyzerper verificare che la configurazione produca la tokenizzazione prevista.
# Built-in analyzer configuration for English text processing
analyzer_params_built_in = {
    "type": "english"
}

# Verify built-in analyzer configuration
sample_text = "Milvus simplifies text analysis for search."
result = client.run_analyzer(sample_text, analyzer_params_built_in)
print("Built-in analyzer output:", result)

# Expected output:
# Built-in analyzer output: ['milvus', 'simplifi', 'text', 'analysi', 'search']
Map<String, Object> analyzerParamsBuiltin = new HashMap<>(); analyzerParamsBuiltin.put("type", "english"); List<String> texts = new ArrayList<>(); texts.add("Milvus simplifies text ana lysis for search."); RunAnalyzerResp resp = client.runAnalyzer(RunAnalyzerReq.builder() .texts(texts) .analyzerParams(analyzerParams) .build()); List<RunAnalyzerResp.AnalyzerResult> results = resp.getResults();// Use a built-in analyzer for VARCHAR field `title_en` const analyzerParamsBuiltIn = { type: "english", }; const sample_text = "Milvus simplifies text analysis for search."; const result = await client.run_analyzer({ text: sample_text, analyzer_params: analyzer_params_built_in });analyzerParams := map[string]any{"type": "english"} bs, _ := json.Marshal(analyzerParams) texts := []string{"Milvus simplifies text analysis for search."} option := milvusclient.NewRunAnalyzerOption(texts). WithAnalyzerParams(string(bs)) result, err := client.RunAnalyzer(ctx, option) if err != nil { fmt.Println(err.Error()) // handle error }# restfulConfigurare e verificare un analizzatore personalizzato:
Configurazione: definire un analizzatore personalizzato che utilizzi un tokenizzatore standard insieme a un filtro per la conversione in minuscolo integrato e a filtri personalizzati per la lunghezza dei token e le parole di stop.
Verifica: utilizzare
run_analyzerper assicurarsi che la configurazione personalizzata elabori il testo come previsto.
# Custom analyzer configuration with a standard tokenizer and custom filters
analyzer_params_custom = {
    "tokenizer": "standard",
    "filter": [
        "lowercase",  # Built-in filter: convert tokens to lowercase
        {
            "type": "length",  # Custom filter: restrict token length
            "max": 40
        },
        {
            "type": "stop",  # Custom filter: remove specified stop words
            "stop_words": ["of", "for"]
        }
    ]
}

# Verify custom analyzer configuration
sample_text = "Milvus provides flexible, customizable analyzers for robust text processing."
result = client.run_analyzer(sample_text, analyzer_params_custom)
print("Custom analyzer output:", result)

# Expected output:
# Custom analyzer output: ['milvus', 'provides', 'flexible', 'customizable', 'analyzers', 'robust', 'text', 'processing']
// Configure a custom analyzer Map<String, Object> analyzerParams = new HashMap<>(); analyzerParams.put("tokenizer", "standard"); analyzerParams.put("filter", Arrays.asList("lowercase", new HashMap<String, Object>() {{ put("type", "length"); put("max", 40); }}, new HashMap<String, Object>() {{ put("type", "stop"); put("stop_words", Arrays.asList("of", "for")); }} ) ); List<String> texts = new ArrayList<>(); texts.add("Milvus provides flexible, customizable analyzers for robust text processing."); RunAnalyzerResp resp = client.runAnalyzer(RunAnalyzerReq.builder() .texts(texts) .analyzerParams(analyzerParams) .build()); List<RunAnalyzerResp.AnalyzerResult> results = resp.getResults();// Configure a custom analyzer for VARCHAR field `title` const analyzerParamsCustom = { tokenizer: "standard", filter: [ "lowercase", { type: "length", max: 40, }, { type: "stop", stop_words: ["of", "to"], }, ], }; const sample_text = "Milvus provides flexible, customizable analyzers for robust text processing."; const result = await client.run_analyzer({ text: sample_text, analyzer_params: analyzer_params_built_in });analyzerParams = map[string]any{"tokenizer": "standard", "filter": []any{"lowercase", map[string]any{ "type": "length", "max": 40, map[string]any{ "type": "stop", "stop_words": []string{"of", "to"}, }}} bs, _ := json.Marshal(analyzerParams) texts := []string{"Milvus provides flexible, customizable analyzers for robust text processing."} option := milvusclient.NewRunAnalyzerOption(texts). WithAnalyzerParams(string(bs)) result, err := client.RunAnalyzer(ctx, option) if err != nil { fmt.Println(err.Error()) // handle error }# curl
Passaggio 3: Aggiungere campi allo schema
Ora che hai verificato le configurazioni dell’analizzatore, aggiungile ai campi dello schema:
# Add VARCHAR field 'title_en' using the built-in analyzer configuration
schema.add_field(
    field_name='title_en',
    datatype=DataType.VARCHAR,
    max_length=1000,
    enable_analyzer=True,
    analyzer_params=analyzer_params_built_in,
    enable_match=True,
)

# Add VARCHAR field 'title' using the custom analyzer configuration
schema.add_field(
    field_name='title',
    datatype=DataType.VARCHAR,
    max_length=1000,
    enable_analyzer=True,
    analyzer_params=analyzer_params_custom,
    enable_match=True,
)

# Add a vector field for embeddings
schema.add_field(field_name="embedding", datatype=DataType.FLOAT_VECTOR, dim=3)

# Add a primary key field
schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True)
schema.addField(AddFieldReq.builder()
        .fieldName("title")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .analyzerParams(analyzerParams)
        .enableMatch(true) // must enable this if you use TextMatch
        .build());

// Add vector field
schema.addField(AddFieldReq.builder()
        .fieldName("embedding")
        .dataType(DataType.FloatVector)
        .dimension(3)
        .build());
// Add primary field
schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());
// Create schema
const schema = {
  auto_id: true,
  fields: [
    {
      name: "id",
      type: DataType.INT64,
      is_primary: true,
    },
    {
      name: "title_en",
      data_type: DataType.VARCHAR,
      max_length: 1000,
      enable_analyzer: true,
      analyzer_params: analyzerParamsBuiltIn,
      enable_match: true,
    },
    {
      name: "title",
      data_type: DataType.VARCHAR,
      max_length: 1000,
      enable_analyzer: true,
      analyzer_params: analyzerParamsCustom,
      enable_match: true,
    },
    {
      name: "embedding",
      data_type: DataType.FLOAT_VECTOR,
      dim: 4,
    },
  ],
};
schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(true),
).WithField(entity.NewField().
    WithName("embedding").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(3),
).WithField(entity.NewField().
    WithName("title").
    WithDataType(entity.FieldTypeVarChar).
    WithMaxLength(1000).
    WithEnableAnalyzer(true).
    WithAnalyzerParams(analyzerParams).
    WithEnableMatch(true),
)
# restful
Passaggio 4: Preparare i parametri dell'indice e creare la raccolta
# Set up index parameters for the vector field
index_params = client.prepare_index_params()
index_params.add_index(field_name="embedding", metric_type="COSINE", index_type="AUTOINDEX")

# Create the collection with the defined schema and index parameters
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
// Set up index params for vector field
List<IndexParam> indexes = new ArrayList<>();
indexes.add(IndexParam.builder()
        .fieldName("embedding")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.COSINE)
        .build());

// Create collection with defined schema
CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
// Set up index params for vector field
const indexParams = [
  {
    name: "embedding",
    metric_type: "COSINE",
    index_type: "AUTOINDEX",
  },
];

// Create collection with defined schema
await client.createCollection({
  collection_name: "my_collection",
  schema: schema,
  index_params: indexParams,
});

console.log("Collection created successfully!");
idx := index.NewAutoIndex(index.MetricType(entity.COSINE))
indexOption := milvusclient.NewCreateIndexOption("my_collection", "embedding", idx)

err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
# restful
Prossimi passi
Dopo aver configurato un analizzatore, è possibile integrarlo con le funzionalità di recupero del testo fornite da Milvus. Per ulteriori dettagli:
