
Recherche hybride multivectorielle
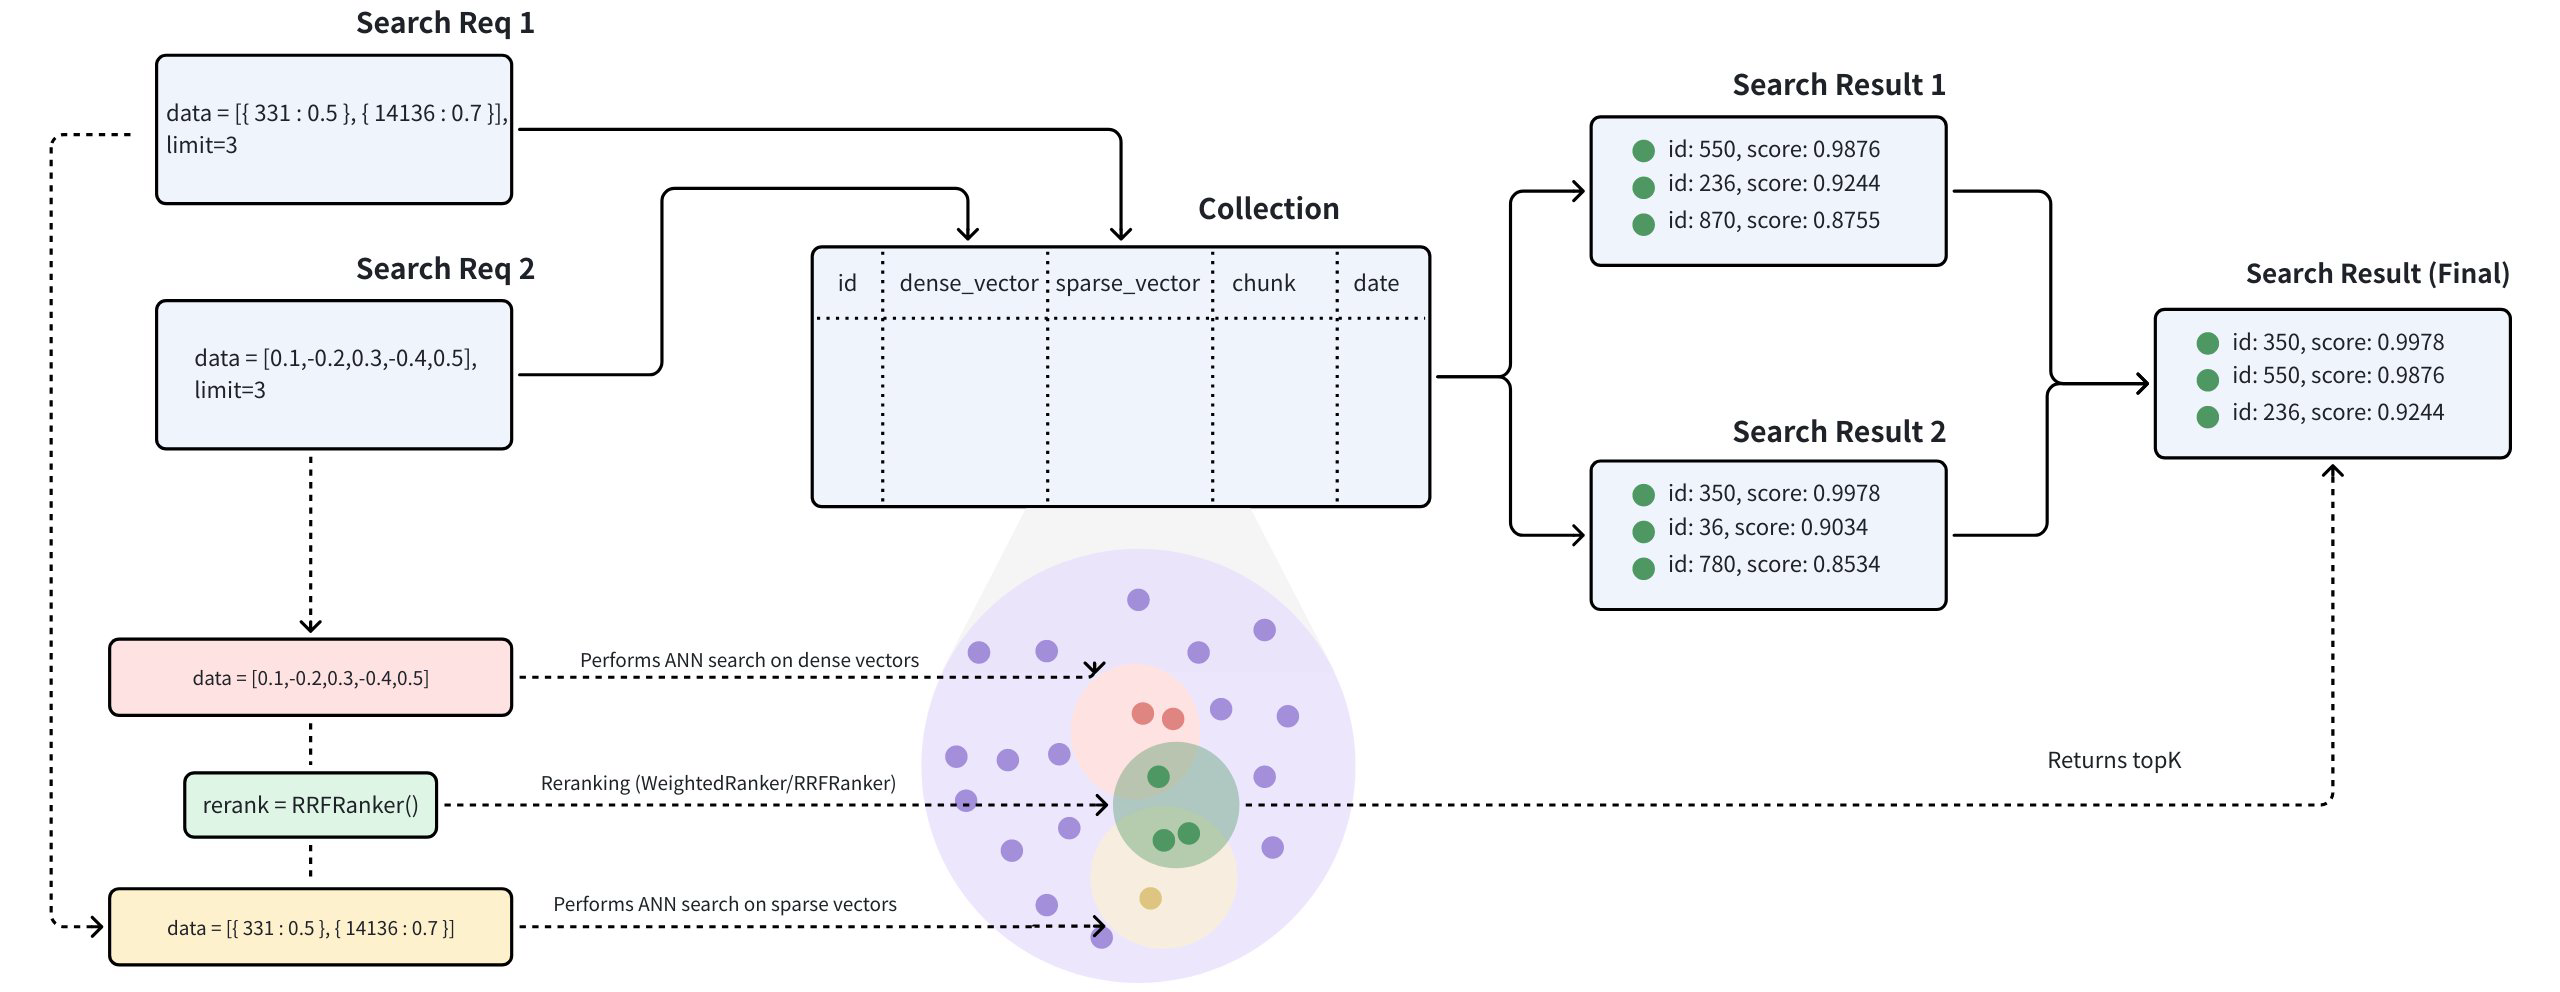
Dans de nombreuses applications, un objet peut faire l’objet d’une recherche à partir d’un ensemble riche d’informations, telles que le titre et la description, ou à l’aide de plusieurs modalités, telles que le texte, les images et l’audio. Par exemple, un tweet comportant un texte et une image doit être trouvé si le texte ou l’image correspond à la sémantique de la requête de recherche. La recherche hybride améliore l'expérience de recherche en combinant les recherches sur ces différents champs. Milvus prend en charge cette fonctionnalité en permettant d'effectuer des recherches sur plusieurs champs vectoriels, en lançant simultanément plusieurs recherches par « voisin le plus proche approximatif » (ANN). La recherche hybride multivectorielle est particulièrement utile si vous souhaitez rechercher à la fois du texte et des images, plusieurs champs de texte décrivant le même objet, ou encore des vecteurs denses et clairsemés afin d’améliorer la qualité de la recherche.
 Workflow de recherche hybride
La recherche hybride multivectorielle intègre différentes méthodes de recherche ou couvre des représentations issues de diverses modalités :
Recherche sur vecteurs denses et clairsemés: les vecteurs denses sont excellents pour saisir les relations sémantiques, tandis que les vecteurs clairsemés sont très efficaces pour la correspondance précise de mots-clés. La recherche hybride combine ces approches pour offrir à la fois une compréhension conceptuelle globale et une pertinence exacte des termes, améliorant ainsi les résultats de recherche. En tirant parti des atouts de chaque méthode, la recherche hybride surmonte les limites des approches individuelles, offrant de meilleures performances pour les requêtes complexes. Voici un guide plus détaillé sur la recherche hybride qui combine la recherche sémantique et la recherche en texte intégral.
Recherche vectorielle multimodale: la recherche vectorielle multimodale est une technique puissante qui vous permet d’effectuer des recherches sur différents types de données, notamment du texte, des images, des fichiers audio et bien d’autres encore. Le principal avantage de cette approche réside dans sa capacité à unifier différentes modalités au sein d’une expérience de recherche fluide et cohérente. Par exemple, dans le cadre d’une recherche de produits, un utilisateur peut saisir une requête textuelle pour trouver des produits décrits à la fois par du texte et des images. En combinant ces modalités via une méthode de recherche hybride, vous pouvez améliorer la précision de la recherche ou enrichir les résultats.
Exemple
Prenons un cas d’utilisation concret où chaque produit comprend une description textuelle et une image. À partir des données disponibles, nous pouvons effectuer trois types de recherches :
Recherche textuelle sémantique : elle consiste à interroger la description textuelle du produit à l’aide de vecteurs denses. Les représentations textuelles peuvent être générées à l’aide de modèles tels que BERT et Transformers ou de services comme OpenAI.
Recherche en texte intégral: ici, on interroge la description textuelle du produit à l’aide d’une correspondance par mot-clé avec des vecteurs clairsemés. Des algorithmes tels que BM25 ou des modèles d’embedding clairsemés comme BGE-M3 ou SPLADE peuvent être utilisés à cette fin.
Recherche multimodale par image : cette méthode interroge l’image à l’aide d’une requête textuelle avec des vecteurs denses. Les représentations d’images peuvent être générées à l’aide de modèles tels que CLIP.
Ce guide vous présentera un exemple de recherche hybride multimodale combinant les méthodes de recherche ci-dessus, à partir de la description textuelle brute et des représentations vectorielles des images des produits. Nous vous montrerons comment stocker des données multivectorielles et effectuer des recherches hybrides à l’aide d’une stratégie de reclassement.
Créer une collection avec plusieurs champs vectoriels
Le processus de création d’une collection comporte trois étapes clés : la définition du schéma de la collection, la configuration des paramètres d’indexation et la création de la collection.
Définir le schéma
Pour la recherche hybride multivectorielle, il convient de définir plusieurs champs vectoriels au sein d’un schéma de collection. Pour plus de détails sur les limites relatives au nombre de champs vectoriels autorisés dans une collection, consultez la section « Limites de Zilliz Cloud ». Toutefois, si nécessaire, vous pouvez ajuster la proxy.maxVectorFieldNum pour inclure jusqu’à 10 champs vectoriels dans une collection selon vos besoins.
Cet exemple intègre les champs suivants dans le schéma :
id: Sert de clé primaire pour le stockage des identifiants de texte. Ce champ est de typeINT64.text: Utilisé pour stocker du contenu textuel. Ce champ est de type «VARCHAR» avec une longueur maximale de 1 000 octets. L’option «enable_analyzer» est définie sur «True» afin de faciliter la recherche en texte intégral.text_dense: Utilisé pour stocker les vecteurs denses des textes. Ce champ est de type «FLOAT_VECTOR» et possède une dimension vectorielle de 768.text_sparse: Utilisé pour stocker les vecteurs clairsemés des textes. Ce champ est de typeSPARSE_FLOAT_VECTOR.image_dense: Utilisé pour stocker les vecteurs denses des images de produits. Ce champ est de typeFLOAT_VETORavec une dimension vectorielle de 512.
Comme nous allons utiliser l'algorithme BM25 intégré pour effectuer une recherche en texte intégral sur le champ de texte, il est nécessaire d'ajouter l'Function Milvus au schéma. Pour plus de détails, veuillez vous reporter à la section Recherche en texte intégral.
from pymilvus import (
    MilvusClient, DataType, Function, FunctionType
)

client = MilvusClient(
    uri="http://localhost:19530",
    token="root:Milvus"
)

# Init schema with auto_id disabled
schema = client.create_schema(auto_id=False)

# Add fields to schema
schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True, description="product id")
schema.add_field(field_name="text", datatype=DataType.VARCHAR, max_length=1000, enable_analyzer=True, description="raw text of product description")
schema.add_field(field_name="text_dense", datatype=DataType.FLOAT_VECTOR, dim=768, description="text dense embedding")
schema.add_field(field_name="text_sparse", datatype=DataType.SPARSE_FLOAT_VECTOR, description="text sparse embedding auto-generated by the built-in BM25 function")
schema.add_field(field_name="image_dense", datatype=DataType.FLOAT_VECTOR, dim=512, description="image dense embedding")

# Add function to schema
bm25_function = Function(
    name="text_bm25_emb",
    input_field_names=["text"],
    output_field_names=["text_sparse"],
    function_type=FunctionType.BM25,
)
schema.add_function(bm25_function)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq.Function;

import java.util.*;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .token("root:Milvus")
        .build());

CreateCollectionReq.CollectionSchema schema = client.createSchema();

schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(false)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("text_dense")
        .dataType(DataType.FloatVector)
        .dimension(768)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("text_sparse")
        .dataType(DataType.SparseFloatVector)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("image_dense")
        .dataType(DataType.FloatVector)
        .dimension(512)
        .build());

schema.addFunction(Function.builder()
        .functionType(FunctionType.BM25)
        .name("text_bm25_emb")
        .inputFieldNames(Collections.singletonList("text"))
        .outputFieldNames(Collections.singletonList("text_sparse"))
        .build());
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

function := entity.NewFunction().
    WithName("text_bm25_emb").
    WithInputFields("text").
    WithOutputFields("text_sparse").
    WithType(entity.FunctionTypeBM25)

schema := entity.NewSchema()

schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true),
).WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithMaxLength(1000),
).WithField(entity.NewField().
    WithName("text_dense").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(768),
).WithField(entity.NewField().
    WithName("text_sparse").
    WithDataType(entity.FieldTypeSparseVector),
).WithField(entity.NewField().
    WithName("image_dense").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(512),
).WithFunction(function)
import { MilvusClient, DataType, FunctionType } from "@zilliz/milvus2-sdk-node";

const address = "http://localhost:19530";
const token = "root:Milvus";
const client = new MilvusClient({address, token});

// Define fields
const fields = [
    {
        name: "id",
        data_type: DataType.Int64,
        is_primary_key: true,
        auto_id: false
    },
    {
        name: "text",
        data_type: DataType.VarChar,
        max_length: 1000,
        enable_analyzer: true
    },
    {
        name: "text_dense",
        data_type: DataType.FloatVector,
        dim: 768
    },
    {
        name: "text_sparse",
        data_type: DataType.SparseFloatVector
    },
    {
        name: "image_dense",
        data_type: DataType.FloatVector,
        dim: 512
    }
];

// define function
const functions = [
    {
      name: "text_bm25_emb",
      description: "text bm25 function",
      type: FunctionType.BM25,
      input_field_names: ["text"],
      output_field_names: ["text_sparse"],
      params: {},
    },
];
export schema='{
        "autoId": false,
        "functions": [
            {
                "name": "text_bm25_emb",
                "type": "BM25",
                "inputFieldNames": ["text"],
                "outputFieldNames": ["text_sparse"],
                "params": {}
            }
        ],
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true
                }
            },
            {
                "fieldName": "text_dense",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "768"
                }
            },
            {
                "fieldName": "text_sparse",
                "dataType": "SparseFloatVector"
            },
            {
                "fieldName": "image_dense",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "512"
                }
            }
        ]
    }'
#include "milvus/MilvusClientV2.h"

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"http://localhost:19530", "root:Milvus"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

milvus::FunctionPtr function = std::make_shared<milvus::Function>("text_bm25_emb", milvus::FunctionType::BM25, "text bm25 function");
function->AddInputFieldName("text");
function->AddOutputFieldName("text_sparse");

milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->AddField({"id", milvus::DataType::INT64, "", true, false});
schema->AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR).WithMaxLength(1000).EnableAnalyzer(true));
schema->AddField(milvus::FieldSchema("text_dense", milvus::DataType::FLOAT_VECTOR).WithDimension(768));
schema->AddField({"text_sparse", milvus::DataType::SPARSE_FLOAT_VECTOR});
schema->AddField(milvus::FieldSchema("image_dense", milvus::DataType::FLOAT_VECTOR).WithDimension(512));
schema->AddFunction(function);
Créer un index
Après avoir défini le schéma de la collection, l’étape suivante consiste à configurer les index vectoriels et à spécifier les métriques de similarité. Dans l’exemple donné :
text_dense_index: un index de type «AUTOINDEX» avec le type de métrique «IP» est créé pour le champ de texte à vecteur dense.text_sparse_index: un index de type «SPARSE_INVERTED_INDEX» avec le type de métrique «BM25» est utilisé pour le champ vectoriel de texte clairsemé.image_dense_index: un index de type «AUTOINDEX» avec le type de métrique «IP» est créé pour le champ vectoriel d’images denses.
Vous pouvez choisir d’autres types d’index selon vos besoins et les types de données, afin de trouver la solution la mieux adaptée. Pour plus d’informations sur les types d’index pris en charge, veuillez consulter la documentation relative aux types d’index disponibles.
# Prepare index parameters
index_params = client.prepare_index_params()

# Add indexes
index_params.add_index(
    field_name="text_dense",
    index_name="text_dense_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)

index_params.add_index(
    field_name="text_sparse",
    index_name="text_sparse_index",
    index_type="SPARSE_INVERTED_INDEX",
    metric_type="BM25",
    params={"inverted_index_algo": "DAAT_MAXSCORE"}, # or "DAAT_WAND" or "TAAT_NAIVE"
)

index_params.add_index(
    field_name="image_dense",
    index_name="image_dense_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)
import io.milvus.v2.common.IndexParam;
import java.util.*;

Map<String, Object> denseParams = new HashMap<>();

IndexParam indexParamForTextDense = IndexParam.builder()
        .fieldName("text_dense")
        .indexName("text_dense_index")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build();

Map<String, Object> sparseParams = new HashMap<>();
sparseParams.put("inverted_index_algo", "DAAT_MAXSCORE");
IndexParam indexParamForTextSparse = IndexParam.builder()
        .fieldName("text_sparse")
        .indexName("text_sparse_index")
        .indexType(IndexParam.IndexType.SPARSE_INVERTED_INDEX)
        .metricType(IndexParam.MetricType.BM25)
        .extraParams(sparseParams)
        .build();

IndexParam indexParamForImageDense = IndexParam.builder()
        .fieldName("image_dense")
        .indexName("image_dense_index")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build();

List<IndexParam> indexParams = new ArrayList<>();
indexParams.add(indexParamForTextDense);
indexParams.add(indexParamForTextSparse);
indexParams.add(indexParamForImageDense);
indexOption1 := milvusclient.NewCreateIndexOption("my_collection", "text_dense",
    index.NewAutoIndex(index.MetricType(entity.IP)))
indexOption2 := milvusclient.NewCreateIndexOption("my_collection", "text_sparse",
    index.NewSparseInvertedIndex(entity.BM25, 0.2))
indexOption3 := milvusclient.NewCreateIndexOption("my_collection", "image_dense",
    index.NewAutoIndex(index.MetricType(entity.IP)))
const index_params = [{
    field_name: "text_dense",
    index_name: "text_dense_index",
    index_type: "AUTOINDEX",
    metric_type: "IP"
},{
    field_name: "text_sparse",
    index_name: "text_sparse_index",
    index_type: "SPARSE_INVERTED_INDEX",
    metric_type: "BM25",
    params: {
      inverted_index_algo: "DAAT_MAXSCORE",
    }
},{
    field_name: "image_dense",
    index_name: "image_dense_index",
    index_type: "AUTOINDEX",
    metric_type: "IP"
}]
export indexParams='[
        {
            "fieldName": "text_dense",
            "metricType": "IP",
            "indexName": "text_dense_index",
            "indexType":"AUTOINDEX"
        },
        {
            "fieldName": "text_sparse",
            "metricType": "BM25",
            "indexName": "text_sparse_index",
            "indexType": "SPARSE_INVERTED_INDEX",
            "params":{"inverted_index_algo": "DAAT_MAXSCORE"}
        },
        {
            "fieldName": "image_dense",
            "metricType": "IP",
            "indexName": "image_dense_index",
            "indexType":"AUTOINDEX"
        }
    ]'
milvus::IndexDesc text_sparse_index("text_sparse", "text_sparse_index", milvus::IndexType::SPARSE_INVERTED_INDEX, milvus::MetricType::BM25);
text_sparse_index.AddExtraParam("inverted_index_algo", "DAAT_MAXSCORE");

std::vector<milvus::IndexDesc> indexes = {
    milvus::IndexDesc("text_dense", "text_dense_index", milvus::IndexType::AUTOINDEX, milvus::MetricType::IP),
    text_sparse_index,
    milvus::IndexDesc("image_dense", "image_dense_index", milvus::IndexType::AUTOINDEX, milvus::MetricType::IP),
};
Créer une collection
Créez une collection nommée demo avec le schéma de collection et les index configurés lors des deux étapes précédentes.
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
CreateCollectionReq createCollectionReq = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexParams)
        .build();
client.createCollection(createCollectionReq);
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption1, indexOption2, indexOption3))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
res = await client.createCollection({
    collection_name: "my_collection",
    fields: fields,
    functions: functions,
    index_params: index_params,
})
export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
status = client->CreateCollection(milvus::CreateCollectionRequest()
                                      .WithCollectionName("my_collection")
                                      .WithCollectionSchema(schema)
                                      .WithIndexes(std::move(indexes)));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
Insérer des données
Cette section permet d’insérer des données dans la collection « my_collection » en fonction du schéma défini précédemment. Lors de l’insertion, assurez-vous que tous les champs, à l’exception de ceux dont les valeurs sont générées automatiquement, contiennent des données au format correct. Dans cet exemple :
id: un entier représentant l’ID du produittext: une chaîne de caractères contenant la description du produittext_dense: une liste de 768 valeurs à virgule flottante représentant l’embedding dense de la description textuelleimage_dense: une liste de 512 valeurs à virgule flottante représentant l'embeddement dense de l'image du produit
Vous pouvez utiliser le même modèle ou des modèles différents pour générer des représentations denses pour chaque champ. Dans cet exemple, les deux représentations denses ont des dimensions différentes, ce qui suggère qu’elles ont été générées par des modèles différents. Lorsque vous définirez chaque recherche ultérieurement, veillez à utiliser le modèle correspondant pour générer la représentation de requête appropriée.
Comme cet exemple utilise la fonction BM25 intégrée pour générer des représentations clairsemées à partir du champ de texte, vous n’avez pas besoin de fournir manuellement des vecteurs clairsemés. Cependant, si vous choisissez de ne pas utiliser BM25, vous devez précalculer et fournir vous-même les représentations clairsemées.
import random

# Generate example vectors
def generate_dense_vector(dim):
    return [random.random() for _ in range(dim)]

data=[
    {
        "id": 0,
        "text": "Red cotton t-shirt with round neck",
        "text_dense": generate_dense_vector(768),
        "image_dense": generate_dense_vector(512)
    },
    {
        "id": 1,
        "text": "Wireless noise-cancelling over-ear headphones",
        "text_dense": generate_dense_vector(768),
        "image_dense": generate_dense_vector(512)
    },
    {
        "id": 2,
        "text": "Stainless steel water bottle, 500ml",
        "text_dense": generate_dense_vector(768),
        "image_dense": generate_dense_vector(512)
    }
]

res = client.insert(
    collection_name="my_collection",
    data=data
)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;
import io.milvus.v2.service.vector.response.InsertResp;

Gson gson = new Gson();
JsonObject row1 = new JsonObject();
row1.addProperty("id", 0);
row1.addProperty("text", "Red cotton t-shirt with round neck");
row1.add("text_dense", gson.toJsonTree(new float[]{0.3580376395471989f, -0.6023495712049978f, 0.18414012509913835f, ...}));
row1.add("image_dense", gson.toJsonTree(new float[]{0.6366019600530924f, -0.09323198122475052f, ...}));

JsonObject row2 = new JsonObject();
row2.addProperty("id", 1);
row2.addProperty("text", "Wireless noise-cancelling over-ear headphones");
row2.add("text_dense", gson.toJsonTree(new float[]{0.19886812562848388f, 0.06023560599112088f, 0.6976963061752597f, ...}));
row2.add("image_dense", gson.toJsonTree(new float[]{0.6414180010301553f, 0.8976979978567611f, ...}));

JsonObject row3 = new JsonObject();
row3.addProperty("id", 2);
row3.addProperty("text", "Stainless steel water bottle, 500ml");
row3.add("text_dense", gson.toJsonTree(new float[]{0.43742130801983836f, -0.5597502546264526f, 0.6457887650909682f, ...}));
row3.add("image_dense", gson.toJsonTree(new float[]{-0.6901259768402174f, 0.6100500332193755f, ...}));

List<JsonObject> data = Arrays.asList(row1, row2, row3);
InsertReq insertReq = InsertReq.builder()
        .collectionName("my_collection")
        .data(data)
        .build();

InsertResp insertResp = client.insert(insertReq);
_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("my_collection").
    WithInt64Column("id", []int64{0, 1, 2}).
    WithVarcharColumn("text", []string{
        "Red cotton t-shirt with round neck",
        "Wireless noise-cancelling over-ear headphones",
        "Stainless steel water bottle, 500ml",
    }).
    WithFloatVectorColumn("text_dense", 768, [][]float32{
        {0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...},
        {0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...},
        {0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...},
    }).
    WithFloatVectorColumn("image_dense", 512, [][]float32{
        {0.6366019600530924, -0.09323198122475052, ...},
        {0.6414180010301553, 0.8976979978567611, ...},
        {-0.6901259768402174, 0.6100500332193755, ...},
    }))
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
const { MilvusClient, DataType } = require("@zilliz/milvus2-sdk-node")

var data = [
    {id: 0, text: "Red cotton t-shirt with round neck" , text_dense: [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...], image_dense: [0.6366019600530924, -0.09323198122475052, ...]},
    {id: 1, text: "Wireless noise-cancelling over-ear headphones" , text_dense: [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...], image_dense: [0.6414180010301553, 0.8976979978567611, ...]},
    {id: 2, text: "Stainless steel water bottle, 500ml" , text_dense: [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...], image_dense: [-0.6901259768402174, 0.6100500332193755, ...]}
]

var res = await client.insert({
    collection_name: "my_collection",
    data: data,
})
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "data": [
        {"id": 0, "text": "Red cotton t-shirt with round neck" , "text_dense": [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...], "image_dense": [0.6366019600530924, -0.09323198122475052, ...]},
        {"id": 1, "text": "Wireless noise-cancelling over-ear headphones" , "text_dense": [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...], "image_dense": [0.6414180010301553, 0.8976979978567611, ...]},
        {"id": 2, "text": "Stainless steel water bottle, 500ml" , "text_dense": [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...], "image_dense": [-0.6901259768402174, 0.6100500332193755, ...]}
    ],
    "collectionName": "my_collection"
}'
#include <random>

std::vector<float>
GenerateFloatVector(int dimension) {
    std::random_device rd;
    std::mt19937 ran(rd());
    std::uniform_real_distribution<float> float_gen(0.0, 1.0);
    std::vector<float> vector(dimension);
    for (auto d = 0; d < dimension; ++d) {
        vector[d] = float_gen(ran);
    }
    return vector;
}

milvus::EntityRows data = {
    {{"id", 0}, {"text", "Red cotton t-shirt with round neck"}, {"text_dense", GenerateFloatVector(768)}, {"image_dense", GenerateFloatVector(512)}},
    {{"id", 1}, {"text", "Wireless noise-cancelling over-ear headphones"}, {"text_dense", GenerateFloatVector(768)}, {"image_dense", GenerateFloatVector(512)}},
    {{"id", 2}, {"text", "Stainless steel water bottle, 500ml"}, {"text_dense", GenerateFloatVector(768)}, {"image_dense", GenerateFloatVector(512)}}
};

milvus::InsertResponse response;
status = client->Insert(milvus::InsertRequest()
                            .WithCollectionName("my_collection")
                            .WithRowsData(std::move(data)),
                        response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
Effectuer une recherche hybride
Étape 1 : Créer plusieurs instances AnnSearchRequest
La recherche hybride est mise en œuvre en créant plusieurs instances ` AnnSearchRequest ` dans la fonction ` hybrid_search() `, chaque ` AnnSearchRequest ` représentant une requête de recherche ANN de base pour un champ vectoriel spécifique. Par conséquent, avant d’effectuer une recherche hybride, il est nécessaire de créer une instance ` AnnSearchRequest ` pour chaque champ vectoriel.
De plus, en configurant le paramètre expr dans un AnnSearchRequest, vous pouvez définir les conditions de filtrage pour votre recherche hybride. Veuillez vous reporter aux sections « Recherche filtrée » et « Explication du filtrage ».
Dans la recherche hybride, chaque AnnSearchRequest ne prend en charge qu’une seule requête.
Afin d’illustrer les capacités des différents champs vectoriels de recherche, nous allons construire trois requêtes de recherche « AnnSearchRequest » à partir d’un exemple de requête. Nous utiliserons également ses vecteurs denses précalculés pour ce processus. Les requêtes de recherche cibleront les champs vectoriels suivants :
text_densepour la recherche sémantique de texte, permettant une compréhension contextuelle et une récupération basée sur le sens plutôt que sur la correspondance directe de mots-clés ;text_sparsepour la recherche en texte intégral ou la correspondance de mots-clés, en se concentrant sur les correspondances exactes de mots ou d’expressions au sein du texte.image_densepour la recherche multimodale texte-image, afin de récupérer des images de produits pertinentes en fonction du contenu sémantique de la requête.
from pymilvus import AnnSearchRequest

query_text = "white headphones, quiet and comfortable"
query_dense_vector = generate_dense_vector(768)
query_multimodal_vector = generate_dense_vector(512)

# text semantic search (dense)
search_param_1 = {
    "data": [query_dense_vector],
    "anns_field": "text_dense",
    "param": {"nprobe": 10},
    "limit": 2
}
request_1 = AnnSearchRequest(**search_param_1)

# full-text search (sparse)
search_param_2 = {
    "data": [query_text],
    "anns_field": "text_sparse",
    "param": {},
    "limit": 2
}
request_2 = AnnSearchRequest(**search_param_2)

# text-to-image search (multimodal)
search_param_3 = {
    "data": [query_multimodal_vector],
    "anns_field": "image_dense",
    "param": {"nprobe": 10},
    "limit": 2
}
request_3 = AnnSearchRequest(**search_param_3)

reqs = [request_1, request_2, request_3]
import io.milvus.v2.service.vector.request.AnnSearchReq;
import io.milvus.v2.service.vector.request.data.BaseVector;
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.request.data.SparseFloatVec;
import io.milvus.v2.service.vector.request.data.EmbeddedText;

float[] queryDense = new float[]{-0.0475336798f,  0.0521207601f,  0.0904406682f, ...};
float[] queryMultimodal = new float[]{0.0158298651f, 0.5264158340f, ...};

List<BaseVector> queryTexts = Collections.singletonList(new EmbeddedText("white headphones, quiet and comfortable"));
List<BaseVector> queryDenseVectors = Collections.singletonList(new FloatVec(queryDense));
List<BaseVector> queryMultimodalVectors = Collections.singletonList(new FloatVec(queryMultimodal));

List<AnnSearchReq> searchRequests = new ArrayList<>();
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_dense")
        .vectors(queryDenseVectors)
        .params("{\"nprobe\": 10}")
        .topK(2)
        .build());
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_sparse")
        .vectors(queryTexts)
        .topK(2)
        .build());
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("image_dense")
        .vectors(queryMultimodalVectors)
        .params("{\"nprobe\": 10}")
        .topK(2)
        .build());
queryText := entity.Text("white headphones, quiet and comfortable")
queryVector := []float32{0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...}
queryMultimodalVector := []float32{0.015829865178701663, 0.5264158340734488, ...}

request1 := milvusclient.NewAnnRequest("text_dense", 2, entity.FloatVector(queryVector)).
    WithAnnParam(index.NewIvfAnnParam(10))

annParam := index.NewSparseAnnParam()
annParam.WithDropRatio(0.2)
request2 := milvusclient.NewAnnRequest("text_sparse", 2, queryText).
    WithAnnParam(annParam)

request3 := milvusclient.NewAnnRequest("image_dense", 2, entity.FloatVector(queryMultimodalVector)).
    WithAnnParam(index.NewIvfAnnParam(10))
const query_text = "white headphones, quiet and comfortable"
const query_vector = [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...]
const query_multimodal_vector = [0.015829865178701663, 0.5264158340734488, ...]

const search_param_1 = {
    "data": query_vector,
    "anns_field": "text_dense",
    "params": {"nprobe": 10},
    "limit": 2
}

const search_param_2 = {
    "data": query_text,
    "anns_field": "text_sparse",
    "limit": 2
}

const search_param_3 = {
    "data": query_multimodal_vector,
    "anns_field": "image_dense",
    "params": {"nprobe": 10},
    "limit": 2
}
export req='[
    {
        "data": [[0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...]],
        "annsField": "text_dense",
        "params": {"nprobe": 10},
        "limit": 2
    },
    {
        "data": ["white headphones, quiet and comfortable"],
        "annsField": "text_sparse",
        "limit": 2
    },
    {
        "data": [[0.015829865178701663, 0.5264158340734488, ...]],
        "annsField": "image_dense",
        "params": {"nprobe": 10},
        "limit": 2
    }
 ]'
auto query_text = "white headphones, quiet and comfortable";
auto query_dense_vector = GenerateFloatVector(768);
auto query_multimodal_vector = GenerateFloatVector(512);

// text semantic search (dense)
auto sub_req1 = milvus::SubSearchRequest()
                    .AddFloatVector(query_dense_vector)
                    .WithAnnsField("text_dense")
                    .WithLimit(2);
sub_req1.AddExtraParam("nprobe", "10");

// full-text search (sparse)
auto sub_req2 = milvus::SubSearchRequest()
                    .AddEmbeddedText(query_text)
                    .WithAnnsField("text_sparse")
                    .WithLimit(2);

// text-to-image search (multimodal)
auto sub_req3 = milvus::SubSearchRequest()
                    .AddFloatVector(query_multimodal_vector)
                    .WithAnnsField("image_dense")
                    .WithLimit(2);
sub_req3.AddExtraParam("nprobe", "10");
Étant donné que le paramètre ` limit ` est défini sur 2, chaque ` AnnSearchRequest ` renvoie 2 résultats de recherche. Dans cet exemple, 3 instances de ` AnnSearchRequest ` sont créées, ce qui donne un total de 6 résultats de recherche.
Étape 2 : Configurer une stratégie de reclassement
Pour fusionner et reclasser les ensembles de résultats de recherche ANN, il est essentiel de choisir une stratégie de reclassement appropriée. Milvus propose plusieurs types de stratégies de reclassement. Pour plus de détails sur ces mécanismes de reclassement, veuillez vous reporter aux sections « Weighted Ranker » ou « RRF Ranker ».
Dans cet exemple, comme aucune requête de recherche spécifique n’est privilégiée, nous allons utiliser la stratégie RRFRanker.
ranker = Function(
    name="rrf",
    input_field_names=[], # Must be an empty list
    function_type=FunctionType.RERANK,
    params={
        "reranker": "rrf",
        "k": 100  # Optional
    }
)
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.CreateCollectionReq.Function;

Function ranker = Function.builder()
        .name("rrf")
        .functionType(FunctionType.RERANK)
        .param("reranker", "rrf")
        .param("k", "100")
        .build();
const rerank = {
  name: 'rrf',
  description: 'bm25 function',
  type: FunctionType.RERANK,
  input_field_names: [],
  params: {
      "reranker": "rrf",
      "k": 100
  },
};
reranker := milvusclient.NewRRFReranker().WithK(100)
# Restful
export rerank='{"k": 100}'
auto ranker = std::make_shared<milvus::RRFRerank>(100);
Étape 3 : Effectuer une recherche hybride
Avant de lancer une recherche hybride, assurez-vous que la collection est chargée. Si certains champs vectoriels de la collection ne disposent pas d’index ou ne sont pas chargés en mémoire, une erreur se produira lors de l’exécution de la méthode de recherche hybride.
res = client.hybrid_search(
    collection_name="my_collection",
    reqs=reqs,
    ranker=ranker,
    limit=2
)
for hits in res:
    print("TopK results:")
    for hit in hits:
        print(hit)
import io.milvus.v2.common.ConsistencyLevel;
import io.milvus.v2.service.vector.request.HybridSearchReq;
import io.milvus.v2.service.vector.response.SearchResp;

HybridSearchReq hybridSearchReq = HybridSearchReq.builder()
        .collectionName("my_collection")
        .searchRequests(searchRequests)
        .ranker(ranker)
        .topK(2)
        .build();

SearchResp searchResp = client.hybridSearch(hybridSearchReq);
resultSets, err := client.HybridSearch(ctx, milvusclient.NewHybridSearchOption(
    "my_collection",
    2,
    request1,
    request2,
    request3,
).WithReranker(reranker))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
}
const { MilvusClient, DataType } = require("@zilliz/milvus2-sdk-node")

res = await client.loadCollection({
    collection_name: "my_collection"
})

import { MilvusClient, RRFRanker, WeightedRanker } from '@zilliz/milvus2-sdk-node';

const search = await client.search({
  collection_name: "my_collection",
  data: [search_param_1, search_param_2, search_param_3],
  limit: 2,
  rerank: rerank
});
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/hybrid_search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"search\": ${req},
    \"rerank\": {
        \"strategy\":\"rrf\",
        \"params\": ${rerank}
    },
    \"limit\": 2
}"
auto request = milvus::HybridSearchRequest()
                   .WithCollectionName("my_collection")
                   .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(sub_req1)))
                   .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(sub_req2)))
                   .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(sub_req3)))
                   .WithRerank(ranker)
                   .WithLimit(2);

milvus::SearchResponse response;
status = client->HybridSearch(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

for (auto& result : response.Results().Results()) {
    std::cout << "TopK results:" << std::endl;
    milvus::EntityRows output_rows;
    status = result.OutputRows(output_rows);
    for (const auto& row : output_rows) {
        std::cout << "\t" << row << std::endl;
    }
}
Voici le résultat :
["['id: 1, distance: 0.006047376897186041, entity: {}', 'id: 2, distance: 0.006422005593776703, entity: {}']"]
Lorsque le paramètre ` limit=2 ` est spécifié pour la recherche hybride, Milvus reclasse les six résultats obtenus à partir des trois recherches. Au final, seuls les deux résultats les plus similaires seront renvoyés.
Utilisation avancée
Définir temporairement un fuseau horaire pour une recherche hybride
Si votre collection dispose d’un champ « TIMESTAMPTZ », vous pouvez temporairement remplacer le fuseau horaire par défaut de la base de données ou de la collection pour une opération unique en définissant le paramètre « timezone » dans l’appel de recherche hybride. Cela contrôle la manière dont les valeurs « TIMESTAMPTZ » sont affichées et comparées pendant l’opération.
La valeur de timezone doit être un identifiant de fuseau horaire IANA valide (par exemple, Asia/Shanghai, America/Chicago ou UTC). Pour plus de détails sur l’utilisation du champ TIMESTAMPTZ, reportez-vous à la section Champ TIMESTAMPTZ.
L'exemple ci-dessous montre comment définir temporairement un fuseau horaire pour une opération de recherche hybride :
res = client.hybrid_search(
    collection_name="my_collection",
    reqs=reqs,
    ranker=ranker,
    limit=2,
    timezone="America/Havana",
)
List<AnnSearchReq> tzRequests = new ArrayList<>();
tzRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_dense")
        .vectors(queryDenseVectors)
        .params("{\"nprobe\": 10}")
        .topK(2)
        .timezone("America/Havana")
        .build());
tzRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_sparse")
        .vectors(queryTexts)
        .topK(2)
        .timezone("America/Havana")
        .build());
tzRequests.add(AnnSearchReq.builder()
        .vectorFieldName("image_dense")
        .vectors(queryMultimodalVectors)
        .params("{\"nprobe\": 10}")
        .topK(2)
        .timezone("America/Havana")
        .build());

HybridSearchReq tzHybridSearchReq = HybridSearchReq.builder()
        .collectionName("my_collection")
        .searchRequests(tzRequests)
        .ranker(ranker)
        .topK(2)
        .build();

SearchResp tzSearchResp = client.hybridSearch(tzHybridSearchReq);
tzRequest1 := milvusclient.NewAnnRequest("text_dense", 2, entity.FloatVector(queryVector)).
    WithAnnParam(index.NewIvfAnnParam(10)).
    WithSearchParam("timezone", "America/Havana")

tzRequest2 := milvusclient.NewAnnRequest("text_sparse", 2, queryText).
    WithAnnParam(annParam).
    WithSearchParam("timezone", "America/Havana")

tzRequest3 := milvusclient.NewAnnRequest("image_dense", 2, entity.FloatVector(queryMultimodalVector)).
    WithAnnParam(index.NewIvfAnnParam(10)).
    WithSearchParam("timezone", "America/Havana")

resultSets, err = client.HybridSearch(ctx, milvusclient.NewHybridSearchOption(
    "my_collection",
    2,
    tzRequest1,
    tzRequest2,
    tzRequest3,
).WithReranker(reranker))
res = await client.search({
  collection_name: "my_collection",
  data: [
    { ...search_param_1, params: { "nprobe": 10, timezone: "America/Havana" } },
    { ...search_param_2, params: { timezone: "America/Havana" } },
    { ...search_param_3, params: { "nprobe": 10, timezone: "America/Havana" } },
  ],
  limit: 2,
  rerank: rerank
});
# restful
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/hybrid_search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
-d '{
    "collectionName": "my_collection",
    "search": [
        {
            "data": [[0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...]],
            "annsField": "text_dense",
            "params": {"nprobe": 10, "timezone": "America/Havana"},
            "limit": 2
        },
        {
            "data": ["white headphones, quiet and comfortable"],
            "annsField": "text_sparse",
            "params": {"timezone": "America/Havana"},
            "limit": 2
        },
        {
            "data": [[0.015829865178701663, 0.5264158340734488, ...]],
            "annsField": "image_dense",
            "params": {"nprobe": 10, "timezone": "America/Havana"},
            "limit": 2
        }
    ],
    "rerank": {
        "strategy": "rrf",
        "params": {"k": 100}
    },
    "limit": 2
}'
auto tz_req1 = milvus::SubSearchRequest()
                   .AddFloatVector(query_dense_vector)
                   .WithAnnsField("text_dense")
                   .WithTimezone("America/Havana")
                   .WithLimit(2);
tz_req1.AddExtraParam("nprobe", "10");

auto tz_req2 = milvus::SubSearchRequest()
                   .AddEmbeddedText(query_text)
                   .WithAnnsField("text_sparse")
                   .WithTimezone("America/Havana")
                   .WithLimit(2);

auto tz_req3 = milvus::SubSearchRequest()
                   .AddFloatVector(query_multimodal_vector)
                   .WithAnnsField("image_dense")
                   .WithTimezone("America/Havana")
                   .WithLimit(2);
tz_req3.AddExtraParam("nprobe", "10");

auto tz_request = milvus::HybridSearchRequest()
                      .WithCollectionName("my_collection")
                      .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(tz_req1)))
                      .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(tz_req2)))
                      .AddSubRequest(std::make_shared<milvus::SubSearchRequest>(std::move(tz_req3)))
                      .WithRerank(ranker)
                      .WithLimit(2);

milvus::SearchResponse tz_response;
status = client->HybridSearch(tz_request, tz_response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
