

Présentation de l'analyseur
Dans le traitement de texte, un analyseur est un composant essentiel qui convertit le texte brut en un format structuré et consultable. Chaque analyseur se compose généralement de deux éléments principaux : un tokeniseur et un filtre. Ensemble, ils transforment le texte d'entrée en tokens, affinent ces tokens et les préparent pour un indexage et une recherche efficaces.
Dans Milvus, les analyseurs sont configurés lors de la création d’une collection, lorsque vous ajoutez des champs d’ VARCHAR s au schéma de la collection. Les tokens générés par un analyseur peuvent être utilisés pour construire un index destiné à la correspondance par mot-clé ou convertis en représentations clairsemées pour la recherche en texte intégral. Pour plus d’informations, consultez les sections Recherche en texte intégral, Correspondance de phrases ou Correspondance de texte.
L’utilisation d’analyseurs peut avoir un impact sur les performances :
Recherche en texte intégral : pour la recherche en texte intégral, les canaux DataNode et QueryNode consomment les données plus lentement, car ils doivent attendre que la tokenisation soit terminée. Par conséquent, les données nouvellement ingérées mettent plus de temps à être disponibles pour la recherche.
Correspondance par mot-clé : pour la correspondance par mot-clé, la création d’index est également plus lente, car la tokenisation doit être terminée avant qu’un index puisse être construit.
Anatomie d’un analyseur
Dans Milvus, un analyseur se compose exactement d’un tokeniseur et de zéro ou plusieurs filtres.
Tokeniseur: le tokeniseur divise le texte d’entrée en unités distinctes appelées « tokens ». Ces tokens peuvent être des mots ou des expressions, selon le type de tokeniseur.
Filtres: des filtres peuvent être appliqués aux tokens afin de les affiner davantage, par exemple en les mettant en minuscules ou en supprimant les mots courants.
Les tokeniseurs ne prennent en charge que le format UTF-8. La prise en charge d’autres formats sera ajoutée dans les prochaines versions.
Le flux de travail ci-dessous illustre la manière dont un analyseur traite le texte.
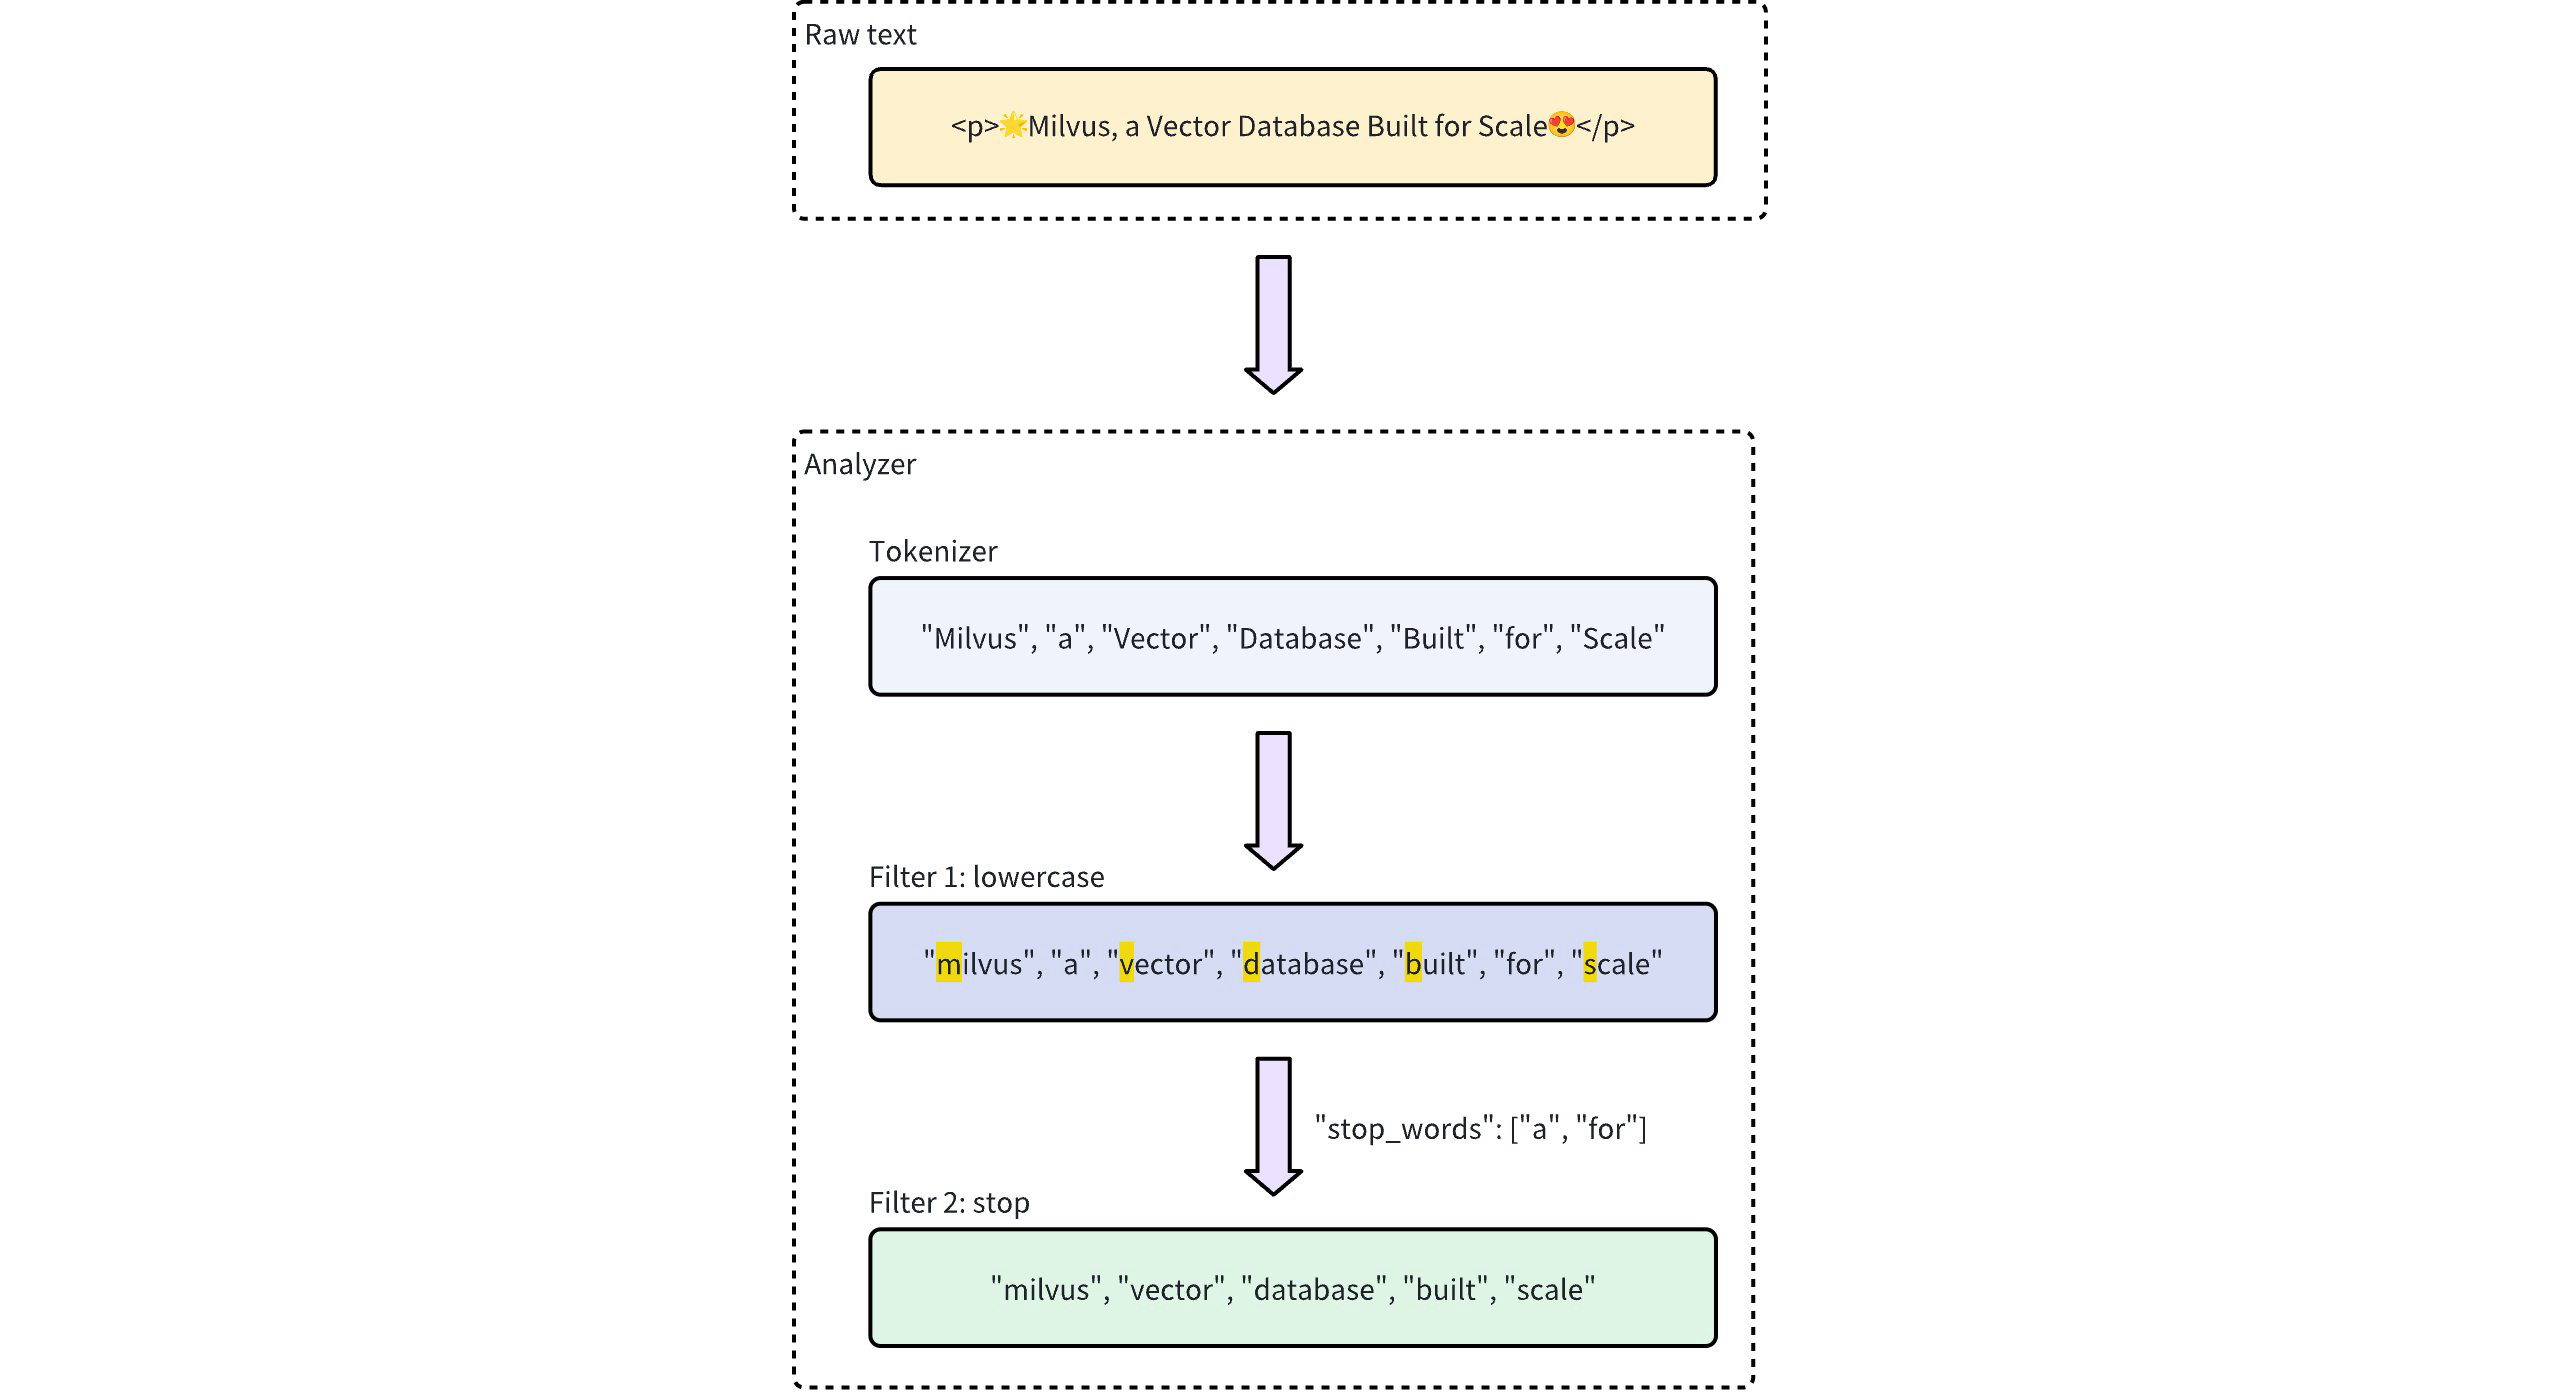 Flux de travail du processus d’analyse
Types d'analyseurs
Milvus propose deux types d’analyseurs pour répondre à différents besoins en matière de traitement de texte :
Analyseur intégré: il s'agit de configurations prédéfinies qui couvrent les tâches courantes de traitement de texte avec un minimum de configuration. Les analyseurs intégrés sont idéaux pour les recherches générales, car ils ne nécessitent aucune configuration complexe.
Analyseur personnalisé: pour des besoins plus avancés, les analyseurs personnalisés vous permettent de définir votre propre configuration en spécifiant à la fois le tokeniseur et zéro ou plusieurs filtres. Ce niveau de personnalisation est particulièrement utile pour les cas d'utilisation spécialisés où un contrôle précis du traitement du texte est nécessaire.
- Si vous omettez de définir des configurations d’analyseur lors de la création d’une collection, Milvus utilise par défaut l’analyseur «
standard» pour tout le traitement de texte. Pour plus de détails, consultez la section Analyseur standard. - Pour des performances optimales en matière de recherche et de requêtes, choisissez un analyseur adapté à la langue de vos données textuelles. Par exemple, bien que l’analyseur «
standard» soit polyvalent, il n’est pas forcément le meilleur choix pour les langues présentant des structures grammaticales particulières, telles que le chinois, l’arabe, le thaï, le japonais ou le coréen. Dans de tels cas, il est préférable d’utiliser un analyseur spécifique à la langue, tel quechinese,arabic, outhai, ou des analyseurs personnalisés dotés de tokeniseurs spécialisés (tels quelindera,icu) et des filtres est vivement recommandé pour garantir une tokenisation précise et de meilleurs résultats de recherche.
Analyseur intégré
Les analyseurs intégrés à Milvus sont préconfigurés avec des tokeniseurs et des filtres spécifiques, ce qui vous permet de les utiliser immédiatement sans avoir à définir vous-même ces composants. Chaque analyseur intégré sert de modèle comprenant un tokeniseur et des filtres prédéfinis, avec des paramètres optionnels permettant une personnalisation.
Par exemple, pour utiliser l’analyseur intégré « standard », il suffit de spécifier son nom « standard » comme « type » et, si vous le souhaitez, d’inclure des configurations supplémentaires spécifiques à ce type d’analyseur, telles que « stop_words » :
analyzer_params = {
    "type": "standard", # Uses the standard built-in analyzer
    "stop_words": ["a", "an", "for"] # Defines a list of common words (stop words) to exclude from tokenization
}
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("type", "standard");
analyzerParams.put("stop_words", Arrays.asList("a", "an", "for"));
const analyzer_params = {
    "type": "standard", // Uses the standard built-in analyzer
    "stop_words": ["a", "an", "for"] // Defines a list of common words (stop words) to exclude from tokenization
};
analyzerParams := map[string]any{"type": "standard", "stop_words": []string{"a", "an", "for"}}
export analyzerParams='{
       "type": "standard",
       "stop_words": ["a", "an", "for"]
    }'
Pour vérifier le résultat de l’exécution d’un analyseur, utilisez la méthode ` run_analyzer ` :
# Sample text to analyze
text = "An efficient system relies on a robust analyzer to correctly process text for various applications."

# Run analyzer
result = client.run_analyzer(
    text,
    analyzer_params
)
import io.milvus.v2.service.vector.request.RunAnalyzerReq;
import io.milvus.v2.service.vector.response.RunAnalyzerResp;

List<String> texts = new ArrayList<>();
texts.add("An efficient system relies on a robust analyzer to correctly process text for various applications.");

RunAnalyzerResp resp = client.runAnalyzer(RunAnalyzerReq.builder()
        .texts(texts)
        .analyzerParams(analyzerParams)
        .build());
List<RunAnalyzerResp.AnalyzerResult> results = resp.getResults();
// javascrip# Sample text to analyze
const text = "An efficient system relies on a robust analyzer to correctly process text for various applications."

// Run analyzer
const result = await client.run_analyzer({
    text,
    analyzer_params
});
import (
    "context"
    "encoding/json"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

bs, _ := json.Marshal(analyzerParams)
texts := []string{"An efficient system relies on a robust analyzer to correctly process text for various applications."}
option := milvusclient.NewRunAnalyzerOption(texts).
    WithAnalyzerParams(string(bs))

result, err := client.RunAnalyzer(ctx, option)
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
# restful
Le résultat sera le suivant :
['efficient', 'system', 'relies', 'on', 'robust', 'analyzer', 'to', 'correctly', 'process', 'text', 'various', 'applications']
Cela démontre que l’analyseur tokenise correctement le texte d’entrée en filtrant les mots vides "a", "an" et "for", tout en renvoyant les tokens significatifs restants.
La configuration de l’analyseur intégré « standard » ci-dessus équivaut à la configuration d’un analyseur personnalisé avec les paramètres suivants, où les options « tokenizer » et « filter » sont explicitement définies pour obtenir une fonctionnalité similaire :
analyzer_params = {
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stop",
            "stop_words": ["a", "an", "for"]
        }
    ]
}
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("tokenizer", "standard");
analyzerParams.put("filter",
        Arrays.asList("lowercase",
                new HashMap<String, Object>() {{
                    put("type", "stop");
                    put("stop_words", Arrays.asList("a", "an", "for"));
                }}));
const analyzer_params = {
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stop",
            "stop_words": ["a", "an", "for"]
        }
    ]
};
analyzerParams = map[string]any{"tokenizer": "standard",
    "filter": []any{"lowercase", map[string]any{
        "type":       "stop",
        "stop_words": []string{"a", "an", "for"},
    }}}
export analyzerParams='{
       "type": "standard",
       "filter":  [
       "lowercase",
       {
            "type": "stop",
            "stop_words": ["a", "an", "for"]
       }
   ]
}'
Milvus propose les analyseurs intégrés suivants, chacun étant conçu pour répondre à des besoins spécifiques en matière de traitement de texte :
standard: Convient au traitement de texte généraliste, en appliquant une tokenisation standard et un filtrage des minuscules.english: Optimisé pour les textes en anglais, avec prise en charge des mots vides anglais.chinese: Spécialisé dans le traitement des textes en chinois, avec notamment une tokenisation adaptée aux structures de la langue chinoise.arabic: Spécialisé dans le traitement des textes en arabe, avec normalisation arabe, normalisation des chiffres décimaux, lemmatisation arabe et suppression des mots vides en arabe.thai: Spécialisé dans le traitement des textes en thaï, avec segmentation des mots en thaï, normalisation des chiffres décimaux et suppression des mots vides en thaï.
Analyseur personnalisé
Pour un traitement de texte plus avancé, les analyseurs personnalisés de Milvus vous permettent de créer un pipeline de traitement de texte sur mesure en spécifiant à la fois un tokeniseur et des filtres. Cette configuration est idéale pour les cas d’utilisation spécialisés nécessitant un contrôle précis.
Tokeniseur
Le tokeniseur est un composant obligatoire d’un analyseur personnalisé ; il lance le pipeline d’analyse en décomposant le texte d’entrée en unités distinctes, appelées tokens. La tokenisation suit des règles spécifiques, telles que la division par des espaces ou des signes de ponctuation, selon le type de tokeniseur. Ce processus permet un traitement plus précis et indépendant de chaque mot ou expression.
Par exemple, un tokeniseur convertirait le texte « "Vector Database Built for Scale" » en tokens distincts :
["Vector", "Database", "Built", "for", "Scale"]
Exemple de spécification d’un tokenizer:
analyzer_params = {
    "tokenizer": "whitespace",
}
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("tokenizer", "whitespace");
const analyzer_params = {
    "tokenizer": "whitespace",
};
analyzerParams = map[string]any{"tokenizer": "whitespace"}
export analyzerParams='{
       "type": "whitespace"
    }'
Filtre
Les filtres sont des composants facultatifs qui agissent sur les tokens produits par le tokeniseur, en les transformant ou en les affinant selon les besoins. Par exemple, après avoir appliqué un filtre « lowercase » aux termes tokenisés « ["Vector", "Database", "Built", "for", "Scale"] », le résultat pourrait être :
["vector", "database", "built", "for", "scale"]
Les filtres d’un analyseur personnalisé peuvent être intégrés ou personnalisés, selon les besoins de configuration.
Filtres intégrés: préconfigurés par Milvus, ils ne nécessitent qu’une configuration minimale. Vous pouvez utiliser ces filtres tels quels en spécifiant leur nom. Les filtres ci-dessous sont intégrés et prêts à l’emploi :
lowercase: Convertit le texte en minuscules, garantissant ainsi une correspondance insensible à la casse. Pour plus de détails, consultez la section « Minuscules ».asciifolding: Convertit les caractères non ASCII en leurs équivalents ASCII, ce qui simplifie le traitement des textes multilingues. Pour plus de détails, consultez la section « ASCII folding ».alphanumonly: Ne conserve que les caractères alphanumériques en supprimant les autres. Pour plus de détails, consultez la section « Alphanumonly ».cnalphanumonly: Supprime les tokens contenant tout caractère autre que des caractères chinois, des lettres anglaises ou des chiffres. Pour plus de détails, voir « Cnalphanumonly ».cncharonly: Supprime les tokens contenant des caractères non chinois. Pour plus de détails, voir Cncharonly.pinyin: Ajoute des formes de tokens en pinyin pour les tokens chinois, ce qui permet une correspondance basée sur le pinyin pour le texte chinois. Pour plus de détails, voir « Pinyin ».
Exemple d'utilisation d'un filtre intégré :
analyzer_params = {
    "tokenizer": "standard", # Mandatory: Specifies tokenizer
    "filter": ["lowercase"], # Optional: Built-in filter that converts text to lowercase
}
Map<String, Object> analyzerParams = new HashMap<>(); analyzerParams.put("tokenizer", "standard"); analyzerParams.put("filter", Collections.singletonList("lowercase"));const analyzer_params = { "tokenizer": "standard", // Mandatory: Specifies tokenizer "filter": ["lowercase"], // Optional: Built-in filter that converts text to lowercase }analyzerParams = map[string]any{"tokenizer": "standard", "filter": []any{"lowercase"}}export analyzerParams='{ "type": "standard", "filter": ["lowercase"] }'Filtres personnalisés: les filtres personnalisés permettent des configurations spécialisées. Vous pouvez définir un filtre personnalisé en choisissant un type de filtre valide (
filter.type) et en ajoutant des paramètres spécifiques pour chaque type de filtre. Exemples de types de filtres prenant en charge la personnalisation :stop: Supprime les mots courants spécifiés en définissant une liste de mots vides (par exemple,"stop_words": ["of", "to"]). Pour plus de détails, consultez la section Mots vides.length: Exclut des tokens en fonction de critères de longueur, par exemple en définissant une longueur maximale pour les tokens. Pour plus de détails, consultez la section « Longueur ».stemmer: Réduit les mots à leur forme de racine pour une correspondance plus flexible. Pour plus de détails, voir « Stemmer ».
Exemple de configuration d’un filtre personnalisé :
analyzer_params = {
    "tokenizer": "standard", # Mandatory: Specifies tokenizer
    "filter": [
        {
            "type": "stop", # Specifies 'stop' as the filter type
            "stop_words": ["of", "to"], # Customizes stop words for this filter type
        }
    ]
}
Map<String, Object> analyzerParams = new HashMap<>(); analyzerParams.put("tokenizer", "standard"); analyzerParams.put("filter", Collections.singletonList(new HashMap<String, Object>() {{ put("type", "stop"); put("stop_words", Arrays.asList("a", "an", "for")); }}));const analyzer_params = { "tokenizer": "standard", // Mandatory: Specifies tokenizer "filter": [ { "type": "stop", // Specifies 'stop' as the filter type "stop_words": ["of", "to"], // Customizes stop words for this filter type } ] };analyzerParams = map[string]any{"tokenizer": "standard", "filter": []any{map[string]any{ "type": "stop", "stop_words": []string{"of", "to"}, }}}export analyzerParams='{ "type": "standard", "filter": [ { "type": "stop", "stop_words": ["a", "an", "for"] } ] }'
Exemple d'utilisation
Dans cet exemple, vous allez créer un schéma de collection comprenant :
Un champ vectoriel pour les représentations.
Deux champs d'
VARCHARs pour le traitement de texte :Un champ utilise un analyseur intégré.
L'autre utilise un analyseur personnalisé.
Avant d'intégrer ces configurations à votre collection, vous allez vérifier chaque analyseur à l'aide de la méthode ` run_analyzer `.
Étape 1 : Initialiser MilvusClient et créer un schéma
Commencez par configurer le client Milvus et créer un nouveau schéma.
from pymilvus import MilvusClient, DataType

# Set up a Milvus client
client = MilvusClient(uri="http://localhost:19530")

# Create a new schema
schema = client.create_schema(auto_id=True, enable_dynamic_field=False)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.v2.common.IndexParam;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

// Set up a Milvus client
ConnectConfig config = ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build();
MilvusClientV2 client = new MilvusClientV2(config);

// Create schema
CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .enableDynamicField(false)
        .build();
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

// Set up a Milvus client
const client = new MilvusClient("http://localhost:19530");
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

cli, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: "localhost:19530",
})
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
defer client.Close(ctx)

schema := entity.NewSchema().WithAutoID(true).WithDynamicFieldEnabled(false)
# restful
Étape 2 : Définir et vérifier les configurations des analyseurs
Configurez et vérifiez un analyseur intégré (
english):Configuration : définissez les paramètres de l'analyseur intégré pour l'anglais.
Vérification : utilisez
run_analyzerpour vérifier que la configuration produit la tokenisation attendue.
# Built-in analyzer configuration for English text processing
analyzer_params_built_in = {
    "type": "english"
}

# Verify built-in analyzer configuration
sample_text = "Milvus simplifies text analysis for search."
result = client.run_analyzer(sample_text, analyzer_params_built_in)
print("Built-in analyzer output:", result)

# Expected output:
# Built-in analyzer output: ['milvus', 'simplifi', 'text', 'analysi', 'search']
Map<String, Object> analyzerParamsBuiltin = new HashMap<>(); analyzerParamsBuiltin.put("type", "english"); List<String> texts = new ArrayList<>(); texts.add("Milvus simplifies text ana lysis for search."); RunAnalyzerResp resp = client.runAnalyzer(RunAnalyzerReq.builder() .texts(texts) .analyzerParams(analyzerParams) .build()); List<RunAnalyzerResp.AnalyzerResult> results = resp.getResults();// Use a built-in analyzer for VARCHAR field `title_en` const analyzerParamsBuiltIn = { type: "english", }; const sample_text = "Milvus simplifies text analysis for search."; const result = await client.run_analyzer({ text: sample_text, analyzer_params: analyzer_params_built_in });analyzerParams := map[string]any{"type": "english"} bs, _ := json.Marshal(analyzerParams) texts := []string{"Milvus simplifies text analysis for search."} option := milvusclient.NewRunAnalyzerOption(texts). WithAnalyzerParams(string(bs)) result, err := client.RunAnalyzer(ctx, option) if err != nil { fmt.Println(err.Error()) // handle error }# restfulConfigurer et vérifier un analyseur personnalisé :
Configuration : définissez un analyseur personnalisé qui utilise un tokeniseur standard ainsi qu’un filtre de mise en minuscules intégré et des filtres personnalisés pour la longueur des tokens et les mots vides.
Vérification : utilisez
run_analyzerpour vous assurer que la configuration personnalisée traite le texte comme prévu.
# Custom analyzer configuration with a standard tokenizer and custom filters
analyzer_params_custom = {
    "tokenizer": "standard",
    "filter": [
        "lowercase",  # Built-in filter: convert tokens to lowercase
        {
            "type": "length",  # Custom filter: restrict token length
            "max": 40
        },
        {
            "type": "stop",  # Custom filter: remove specified stop words
            "stop_words": ["of", "for"]
        }
    ]
}

# Verify custom analyzer configuration
sample_text = "Milvus provides flexible, customizable analyzers for robust text processing."
result = client.run_analyzer(sample_text, analyzer_params_custom)
print("Custom analyzer output:", result)

# Expected output:
# Custom analyzer output: ['milvus', 'provides', 'flexible', 'customizable', 'analyzers', 'robust', 'text', 'processing']
// Configure a custom analyzer Map<String, Object> analyzerParams = new HashMap<>(); analyzerParams.put("tokenizer", "standard"); analyzerParams.put("filter", Arrays.asList("lowercase", new HashMap<String, Object>() {{ put("type", "length"); put("max", 40); }}, new HashMap<String, Object>() {{ put("type", "stop"); put("stop_words", Arrays.asList("of", "for")); }} ) ); List<String> texts = new ArrayList<>(); texts.add("Milvus provides flexible, customizable analyzers for robust text processing."); RunAnalyzerResp resp = client.runAnalyzer(RunAnalyzerReq.builder() .texts(texts) .analyzerParams(analyzerParams) .build()); List<RunAnalyzerResp.AnalyzerResult> results = resp.getResults();// Configure a custom analyzer for VARCHAR field `title` const analyzerParamsCustom = { tokenizer: "standard", filter: [ "lowercase", { type: "length", max: 40, }, { type: "stop", stop_words: ["of", "to"], }, ], }; const sample_text = "Milvus provides flexible, customizable analyzers for robust text processing."; const result = await client.run_analyzer({ text: sample_text, analyzer_params: analyzer_params_built_in });analyzerParams = map[string]any{"tokenizer": "standard", "filter": []any{"lowercase", map[string]any{ "type": "length", "max": 40, map[string]any{ "type": "stop", "stop_words": []string{"of", "to"}, }}} bs, _ := json.Marshal(analyzerParams) texts := []string{"Milvus provides flexible, customizable analyzers for robust text processing."} option := milvusclient.NewRunAnalyzerOption(texts). WithAnalyzerParams(string(bs)) result, err := client.RunAnalyzer(ctx, option) if err != nil { fmt.Println(err.Error()) // handle error }# curl
Étape 3 : Ajouter des champs au schéma
Maintenant que vous avez vérifié vos configurations d'analyseur, ajoutez-les aux champs de votre schéma :
# Add VARCHAR field 'title_en' using the built-in analyzer configuration
schema.add_field(
    field_name='title_en',
    datatype=DataType.VARCHAR,
    max_length=1000,
    enable_analyzer=True,
    analyzer_params=analyzer_params_built_in,
    enable_match=True,
)

# Add VARCHAR field 'title' using the custom analyzer configuration
schema.add_field(
    field_name='title',
    datatype=DataType.VARCHAR,
    max_length=1000,
    enable_analyzer=True,
    analyzer_params=analyzer_params_custom,
    enable_match=True,
)

# Add a vector field for embeddings
schema.add_field(field_name="embedding", datatype=DataType.FLOAT_VECTOR, dim=3)

# Add a primary key field
schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True)
schema.addField(AddFieldReq.builder()
        .fieldName("title")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .analyzerParams(analyzerParams)
        .enableMatch(true) // must enable this if you use TextMatch
        .build());

// Add vector field
schema.addField(AddFieldReq.builder()
        .fieldName("embedding")
        .dataType(DataType.FloatVector)
        .dimension(3)
        .build());
// Add primary field
schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());
// Create schema
const schema = {
  auto_id: true,
  fields: [
    {
      name: "id",
      type: DataType.INT64,
      is_primary: true,
    },
    {
      name: "title_en",
      data_type: DataType.VARCHAR,
      max_length: 1000,
      enable_analyzer: true,
      analyzer_params: analyzerParamsBuiltIn,
      enable_match: true,
    },
    {
      name: "title",
      data_type: DataType.VARCHAR,
      max_length: 1000,
      enable_analyzer: true,
      analyzer_params: analyzerParamsCustom,
      enable_match: true,
    },
    {
      name: "embedding",
      data_type: DataType.FLOAT_VECTOR,
      dim: 4,
    },
  ],
};
schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(true),
).WithField(entity.NewField().
    WithName("embedding").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(3),
).WithField(entity.NewField().
    WithName("title").
    WithDataType(entity.FieldTypeVarChar).
    WithMaxLength(1000).
    WithEnableAnalyzer(true).
    WithAnalyzerParams(analyzerParams).
    WithEnableMatch(true),
)
# restful
Étape 4 : Préparer les paramètres d'indexation et créer la collection
# Set up index parameters for the vector field
index_params = client.prepare_index_params()
index_params.add_index(field_name="embedding", metric_type="COSINE", index_type="AUTOINDEX")

# Create the collection with the defined schema and index parameters
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
// Set up index params for vector field
List<IndexParam> indexes = new ArrayList<>();
indexes.add(IndexParam.builder()
        .fieldName("embedding")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.COSINE)
        .build());

// Create collection with defined schema
CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
// Set up index params for vector field
const indexParams = [
  {
    name: "embedding",
    metric_type: "COSINE",
    index_type: "AUTOINDEX",
  },
];

// Create collection with defined schema
await client.createCollection({
  collection_name: "my_collection",
  schema: schema,
  index_params: indexParams,
});

console.log("Collection created successfully!");
idx := index.NewAutoIndex(index.MetricType(entity.COSINE))
indexOption := milvusclient.NewCreateIndexOption("my_collection", "embedding", idx)

err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
# restful
Et ensuite ?
Une fois l'analyseur configuré, vous pouvez l'intégrer aux fonctionnalités de recherche de texte fournies par Milvus. Pour plus de détails :
