

Gambaran Umum Penganalisis
Dalam pemrosesan teks, penganalisis merupakan komponen penting yang mengubah teks mentah menjadi format yang terstruktur dan dapat dicari. Setiap penganalisis biasanya terdiri dari dua elemen inti: tokenizer dan filter. Bersama-sama, keduanya mengubah teks masukan menjadi token, menyempurnakan token tersebut, dan mempersiapkannya untuk pengindeksan serta pencarian yang efisien.
Di Milvus, penganalisis dikonfigurasi selama pembuatan koleksi saat Anda menambahkan bidang VARCHAR ke skema koleksi. Token yang dihasilkan oleh penganalisis dapat digunakan untuk membangun indeks untuk pencocokan kata kunci atau dikonversi menjadi embedding jarang untuk pencarian teks lengkap. Untuk informasi lebih lanjut, lihat Pencarian Teks Lengkap, Pencocokan Frasa, atau Pencocokan Teks.
Penggunaan penganalisis dapat memengaruhi kinerja:
Pencarian teks lengkap: Untuk pencarian teks lengkap, saluran DataNode dan QueryNode memproses data lebih lambat karena harus menunggu proses tokenisasi selesai. Akibatnya, data yang baru dimasukkan membutuhkan waktu lebih lama untuk tersedia untuk pencarian.
Pencocokan kata kunci: Untuk pencocokan kata kunci, pembuatan indeks juga lebih lambat karena tokenisasi harus selesai terlebih dahulu sebelum indeks dapat dibuat.
Anatomi sebuah penganalisis
Sebuah penganalisis di Milvus terdiri dari tepat satu tokenizer dan nol atau lebih filter.
Tokenizer: Tokenizer memecah teks masukan menjadi unit-unit terpisah yang disebut token. Token-token ini bisa berupa kata atau frasa, tergantung pada jenis tokenizer.
Filter: Filter dapat diterapkan pada token untuk menyempurnakannya lebih lanjut, misalnya dengan mengubahnya menjadi huruf kecil atau menghapus kata-kata umum.
Tokenizer hanya mendukung format UTF-8. Dukungan untuk format lain akan ditambahkan pada rilis mendatang.
Alur kerja di bawah ini menunjukkan bagaimana penganalisis memproses teks.
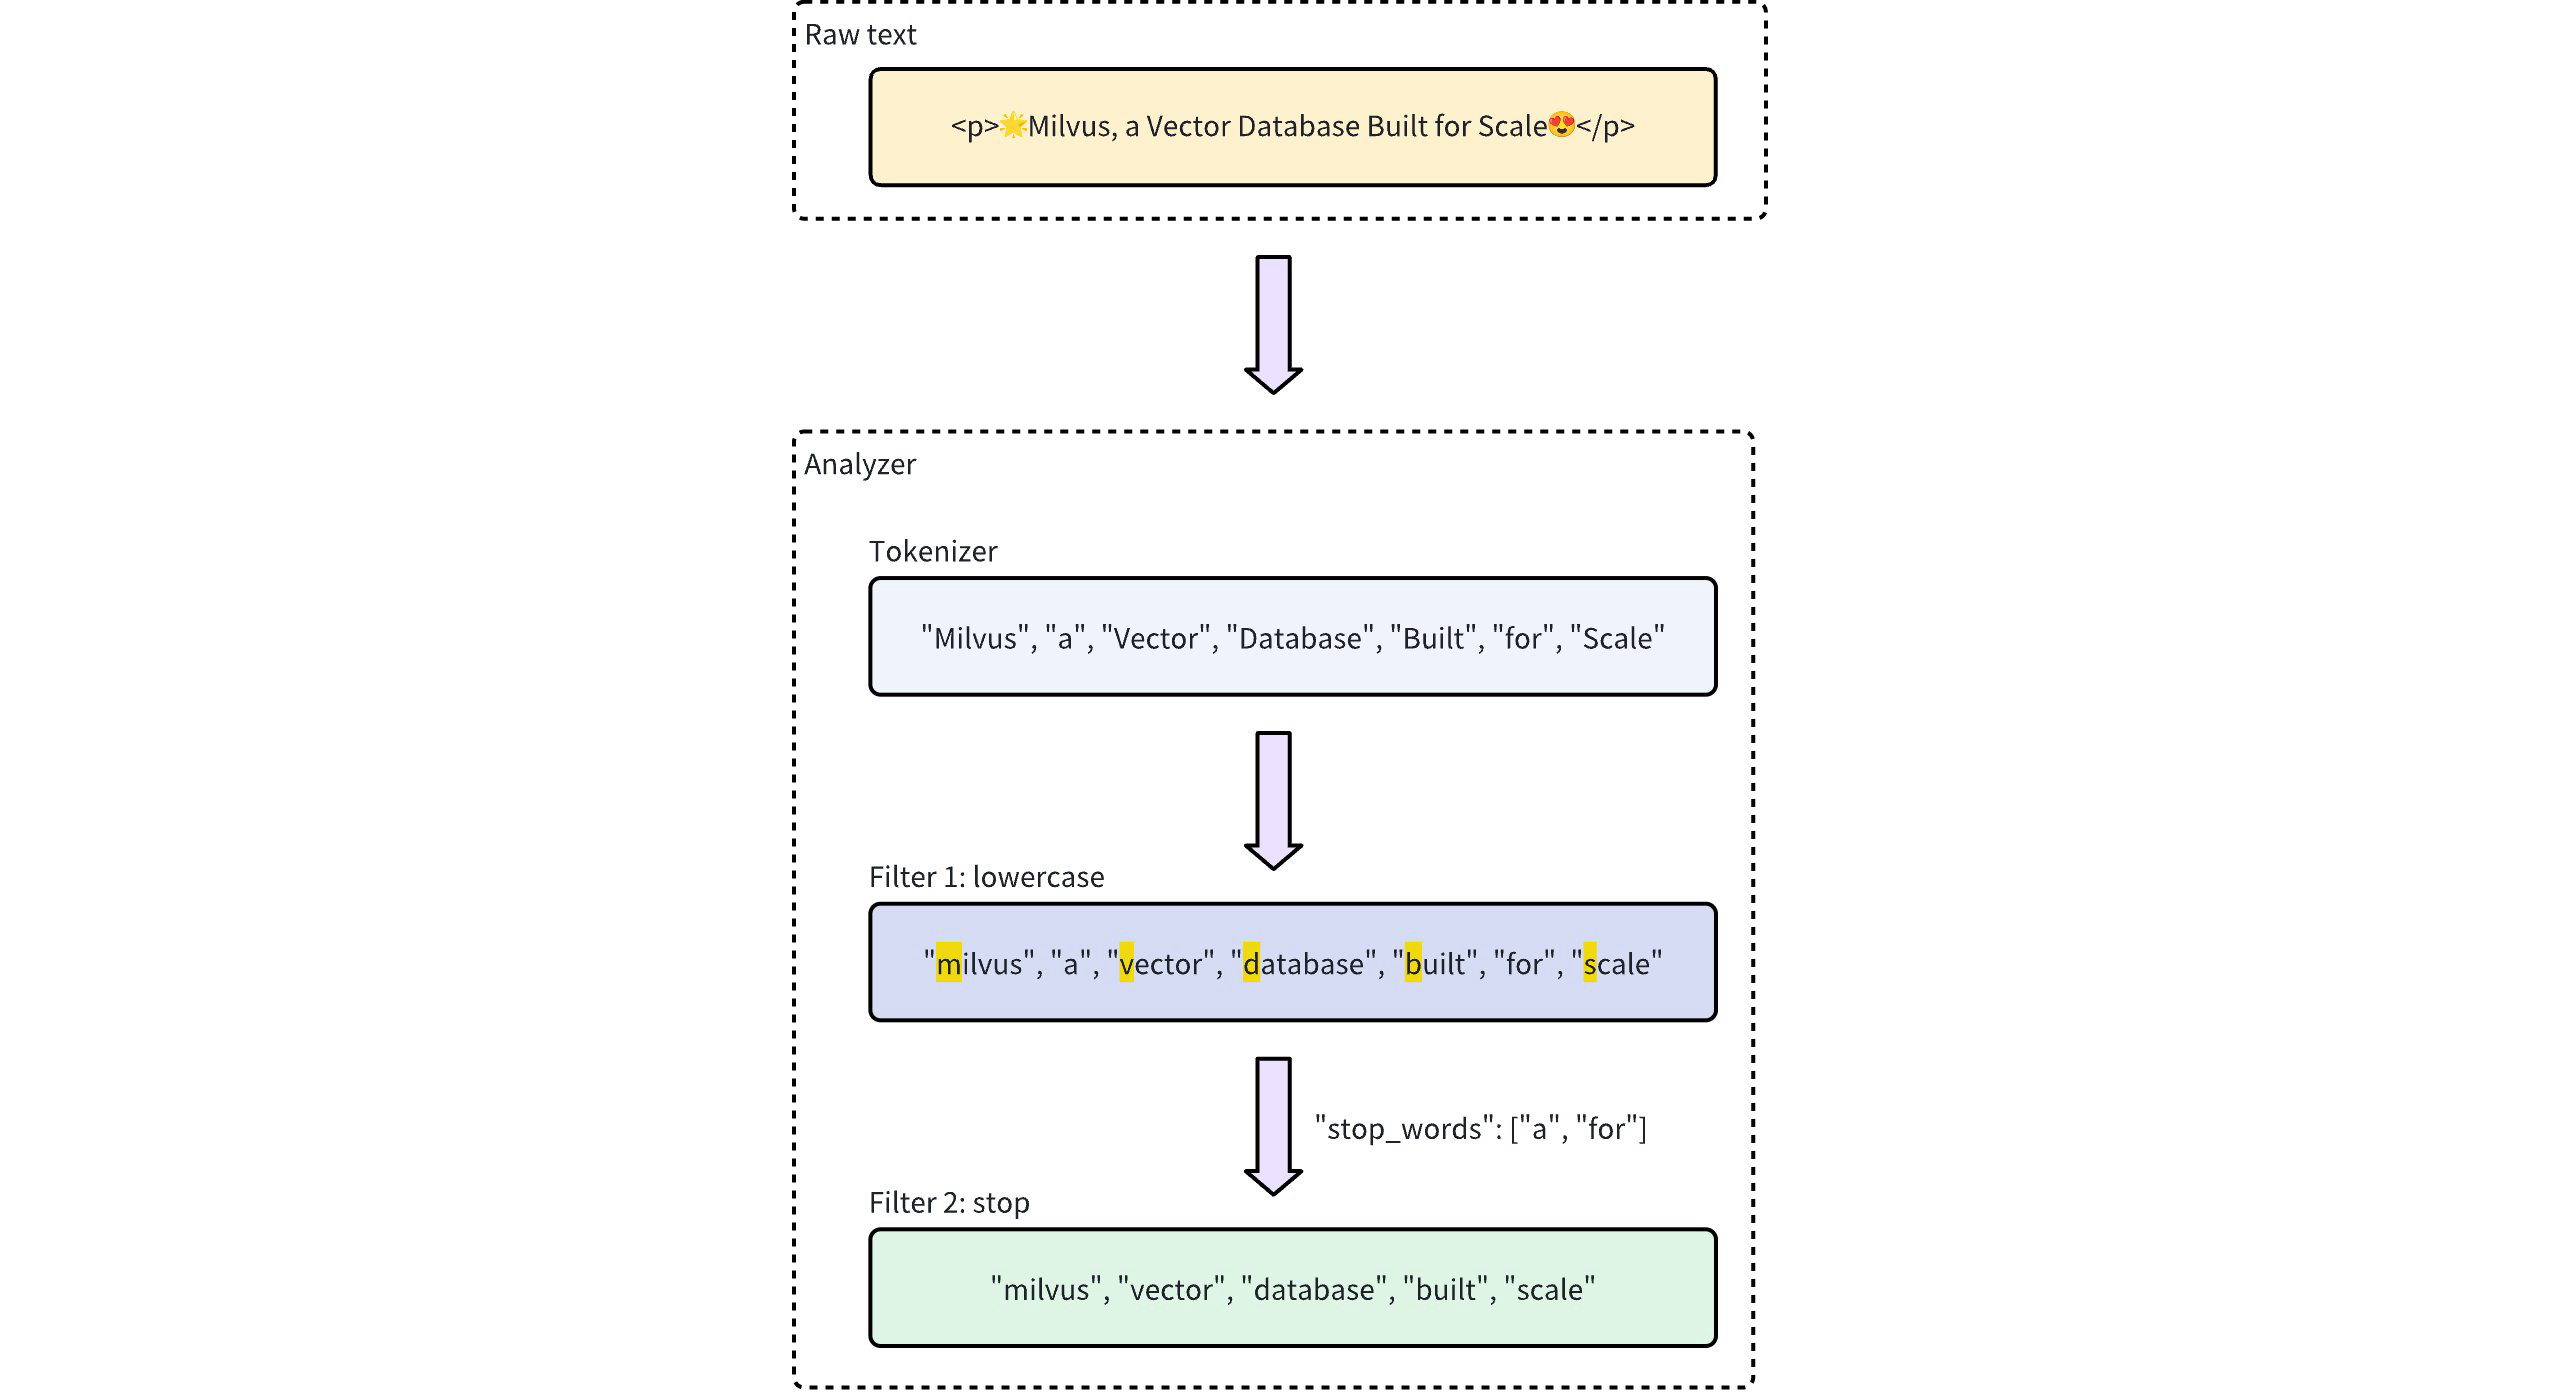 Alur Kerja Proses Penganalisis
Jenis-jenis Analyzer
Milvus menyediakan dua jenis penganalisis untuk memenuhi berbagai kebutuhan pemrosesan teks:
Penganalisis bawaan: Ini adalah konfigurasi yang telah ditentukan sebelumnya yang mencakup tugas-tugas pemrosesan teks umum dengan pengaturan minimal. Penganalisis bawaan sangat ideal untuk pencarian tujuan umum, karena tidak memerlukan konfigurasi yang rumit.
Penganalisis khusus: Untuk kebutuhan yang lebih canggih, penganalisis khusus memungkinkan Anda menentukan konfigurasi sendiri dengan menentukan tokenizer dan nol atau lebih filter. Tingkat penyesuaian ini sangat berguna untuk kasus penggunaan khusus yang memerlukan kontrol yang tepat atas pemrosesan teks.
- Jika Anda tidak menentukan konfigurasi penganalisis saat membuat koleksi, Milvus secara default akan menggunakan penganalisis "
standard" untuk semua pemrosesan teks. Untuk detailnya, lihat Penganalisis Standar. - Untuk kinerja pencarian dan kueri yang optimal, pilih penganalisis yang sesuai dengan bahasa data teks Anda. Misalnya, meskipun penganalisis "
standard" bersifat serbaguna, penganalisis ini mungkin bukan pilihan terbaik untuk bahasa dengan struktur tata bahasa yang unik, seperti bahasa Mandarin, Arab, Thailand, Jepang, atau Korea. Dalam kasus seperti itu, gunakan penganalisis khusus bahasa sepertichinese,arabic, atauthai, atau penganalisis khusus dengan tokenizer khusus (sepertilindera,icu) dan filter sangat disarankan untuk memastikan tokenisasi yang akurat dan hasil pencarian yang lebih baik.
Penganalisis bawaan
Penganalisis bawaan di Milvus telah dikonfigurasi sebelumnya dengan tokenizer dan filter tertentu, sehingga Anda dapat langsung menggunakannya tanpa perlu mendefinisikan komponen-komponen ini sendiri. Setiap penganalisis bawaan berfungsi sebagai templat yang mencakup tokenizer dan filter yang telah ditetapkan sebelumnya, dengan parameter opsional untuk penyesuaian.
Misalnya, untuk menggunakan penganalisis bawaan ` standard `, cukup tentukan namanya ` standard ` sebagai ` type ` dan secara opsional sertakan konfigurasi tambahan yang spesifik untuk jenis penganalisis ini, seperti ` stop_words`:
analyzer_params = {
    "type": "standard", # Uses the standard built-in analyzer
    "stop_words": ["a", "an", "for"] # Defines a list of common words (stop words) to exclude from tokenization
}
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("type", "standard");
analyzerParams.put("stop_words", Arrays.asList("a", "an", "for"));
const analyzer_params = {
    "type": "standard", // Uses the standard built-in analyzer
    "stop_words": ["a", "an", "for"] // Defines a list of common words (stop words) to exclude from tokenization
};
analyzerParams := map[string]any{"type": "standard", "stop_words": []string{"a", "an", "for"}}
export analyzerParams='{
       "type": "standard",
       "stop_words": ["a", "an", "for"]
    }'
Untuk memeriksa hasil eksekusi penganalisis, gunakan metode ` run_analyzer `:
# Sample text to analyze
text = "An efficient system relies on a robust analyzer to correctly process text for various applications."

# Run analyzer
result = client.run_analyzer(
    text,
    analyzer_params
)
import io.milvus.v2.service.vector.request.RunAnalyzerReq;
import io.milvus.v2.service.vector.response.RunAnalyzerResp;

List<String> texts = new ArrayList<>();
texts.add("An efficient system relies on a robust analyzer to correctly process text for various applications.");

RunAnalyzerResp resp = client.runAnalyzer(RunAnalyzerReq.builder()
        .texts(texts)
        .analyzerParams(analyzerParams)
        .build());
List<RunAnalyzerResp.AnalyzerResult> results = resp.getResults();
// javascrip# Sample text to analyze
const text = "An efficient system relies on a robust analyzer to correctly process text for various applications."

// Run analyzer
const result = await client.run_analyzer({
    text,
    analyzer_params
});
import (
    "context"
    "encoding/json"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

bs, _ := json.Marshal(analyzerParams)
texts := []string{"An efficient system relies on a robust analyzer to correctly process text for various applications."}
option := milvusclient.NewRunAnalyzerOption(texts).
    WithAnalyzerParams(string(bs))

result, err := client.RunAnalyzer(ctx, option)
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
# restful
Hasilnya akan menjadi:
['efficient', 'system', 'relies', 'on', 'robust', 'analyzer', 'to', 'correctly', 'process', 'text', 'various', 'applications']
Ini menunjukkan bahwa penganalisis tersebut berhasil menokenisasi teks masukan dengan menyaring kata-kata penghalang (stop words) "a", "an", dan "for", sekaligus mengembalikan token-token bermakna yang tersisa.
Konfigurasi penganalisis bawaan standard di atas setara dengan menyiapkan penganalisis khusus dengan parameter berikut, di mana opsi tokenizer dan filter didefinisikan secara eksplisit untuk mencapai fungsionalitas serupa:
analyzer_params = {
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stop",
            "stop_words": ["a", "an", "for"]
        }
    ]
}
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("tokenizer", "standard");
analyzerParams.put("filter",
        Arrays.asList("lowercase",
                new HashMap<String, Object>() {{
                    put("type", "stop");
                    put("stop_words", Arrays.asList("a", "an", "for"));
                }}));
const analyzer_params = {
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stop",
            "stop_words": ["a", "an", "for"]
        }
    ]
};
analyzerParams = map[string]any{"tokenizer": "standard",
    "filter": []any{"lowercase", map[string]any{
        "type":       "stop",
        "stop_words": []string{"a", "an", "for"},
    }}}
export analyzerParams='{
       "type": "standard",
       "filter":  [
       "lowercase",
       {
            "type": "stop",
            "stop_words": ["a", "an", "for"]
       }
   ]
}'
Milvus menyediakan penganalisis bawaan berikut ini, yang masing-masing dirancang untuk kebutuhan pemrosesan teks tertentu:
standard: Cocok untuk pemrosesan teks umum, menerapkan tokenisasi standar dan penyaringan huruf kecil.english: Dioptimalkan untuk teks berbahasa Inggris, dengan dukungan untuk kata-kata pengisi (stop words) dalam bahasa Inggris.chinese: Khusus untuk pemrosesan teks bahasa Mandarin, termasuk tokenisasi yang disesuaikan dengan struktur bahasa Mandarin.arabic: Didesain khusus untuk teks bahasa Arab, dengan normalisasi bahasa Arab, normalisasi angka desimal, stemming bahasa Arab, dan penghapusan kata-kata pengisi bahasa Arab.thai: Dikhususkan untuk teks bahasa Thailand, dengan segmentasi kata bahasa Thailand, normalisasi angka desimal, dan penghapusan kata penghubung bahasa Thailand.
Penganalisis khusus
Untuk pemrosesan teks yang lebih canggih, penganalisis khusus di Milvus memungkinkan Anda membangun alur kerja penanganan teks yang disesuaikan dengan menentukan tokenizer dan filter. Pengaturan ini ideal untuk kasus penggunaan khusus yang memerlukan kontrol yang tepat.
Tokenizer
Tokenizer adalah komponen wajib untuk penganalisis khusus, yang memulai alur kerja penganalisis dengan memecah teks masukan menjadi unit-unit terpisah atau token. Tokenisasi mengikuti aturan tertentu, seperti pemisahan berdasarkan spasi kosong atau tanda baca, tergantung pada jenis tokenizer. Proses ini memungkinkan penanganan yang lebih tepat dan independen terhadap setiap kata atau frasa.
Misalnya, tokenizer akan mengubah teks "Vector Database Built for Scale" menjadi token-token terpisah:
["Vector", "Database", "Built", "for", "Scale"]
Contoh penentuan tokenizer:
analyzer_params = {
    "tokenizer": "whitespace",
}
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("tokenizer", "whitespace");
const analyzer_params = {
    "tokenizer": "whitespace",
};
analyzerParams = map[string]any{"tokenizer": "whitespace"}
export analyzerParams='{
       "type": "whitespace"
    }'
Filter
Filter adalah komponen opsional yang bekerja pada token yang dihasilkan oleh tokenizer, mengubah atau menyempurnakannya sesuai kebutuhan. Misalnya, setelah menerapkan filter " lowercase " pada istilah yang telah ditokenisasi " ["Vector", "Database", "Built", "for", "Scale"]", hasilnya mungkin adalah:
["vector", "database", "built", "for", "scale"]
Filter dalam penganalisis khusus dapat berupa filter bawaan atau khusus, tergantung pada kebutuhan konfigurasi.
Filter bawaan: Telah dikonfigurasi sebelumnya oleh Milvus, sehingga hanya memerlukan pengaturan minimal. Anda dapat menggunakan filter ini secara langsung dengan menentukan namanya. Filter di bawah ini sudah terintegrasi dan siap digunakan:
lowercase: Mengubah teks menjadi huruf kecil, memastikan pencocokan yang tidak peka huruf besar-kecil. Untuk detailnya, lihat Lowercase.asciifolding: Mengubah karakter non-ASCII menjadi setara ASCII, sehingga memudahkan penanganan teks multibahasa. Untuk detailnya, lihat ASCII folding.alphanumonly: Hanya mempertahankan karakter alfanumerik dengan menghapus karakter lainnya. Untuk detailnya, lihat Alphanumonly.cnalphanumonly: Menghapus token yang mengandung karakter apa pun selain karakter Tionghoa, huruf Inggris, atau angka. Untuk detailnya, lihat Cnalphanumonly.cncharonly: Menghapus token yang mengandung karakter apa pun selain karakter Tionghoa. Untuk detailnya, lihat Cncharonly.pinyin: Menambahkan bentuk token Pinyin untuk token bahasa Tionghoa, sehingga memungkinkan pencocokan berbasis Pinyin untuk teks bahasa Tionghoa. Untuk detailnya, lihat Pinyin.
Contoh penggunaan filter bawaan:
analyzer_params = {
    "tokenizer": "standard", # Mandatory: Specifies tokenizer
    "filter": ["lowercase"], # Optional: Built-in filter that converts text to lowercase
}
Map<String, Object> analyzerParams = new HashMap<>(); analyzerParams.put("tokenizer", "standard"); analyzerParams.put("filter", Collections.singletonList("lowercase"));const analyzer_params = { "tokenizer": "standard", // Mandatory: Specifies tokenizer "filter": ["lowercase"], // Optional: Built-in filter that converts text to lowercase }analyzerParams = map[string]any{"tokenizer": "standard", "filter": []any{"lowercase"}}export analyzerParams='{ "type": "standard", "filter": ["lowercase"] }'Filter khusus: Filter khusus memungkinkan konfigurasi yang lebih spesifik. Anda dapat mendefinisikan filter khusus dengan memilih jenis filter yang valid (
filter.type) dan menambahkan pengaturan khusus untuk setiap jenis filter. Contoh jenis filter yang mendukung penyesuaian:stop: Menghapus kata-kata umum yang ditentukan dengan menetapkan daftar kata penghalang (misalnya,"stop_words": ["of", "to"]). Untuk detailnya, lihat Stop.length: Mengecualikan token berdasarkan kriteria panjang, seperti menetapkan panjang token maksimum. Untuk detailnya, lihat Length.stemmer: Mengubah kata menjadi bentuk akarnya untuk pencocokan yang lebih fleksibel. Untuk detailnya, lihat Stemmer.
Contoh konfigurasi filter khusus:
analyzer_params = {
    "tokenizer": "standard", # Mandatory: Specifies tokenizer
    "filter": [
        {
            "type": "stop", # Specifies 'stop' as the filter type
            "stop_words": ["of", "to"], # Customizes stop words for this filter type
        }
    ]
}
Map<String, Object> analyzerParams = new HashMap<>(); analyzerParams.put("tokenizer", "standard"); analyzerParams.put("filter", Collections.singletonList(new HashMap<String, Object>() {{ put("type", "stop"); put("stop_words", Arrays.asList("a", "an", "for")); }}));const analyzer_params = { "tokenizer": "standard", // Mandatory: Specifies tokenizer "filter": [ { "type": "stop", // Specifies 'stop' as the filter type "stop_words": ["of", "to"], // Customizes stop words for this filter type } ] };analyzerParams = map[string]any{"tokenizer": "standard", "filter": []any{map[string]any{ "type": "stop", "stop_words": []string{"of", "to"}, }}}export analyzerParams='{ "type": "standard", "filter": [ { "type": "stop", "stop_words": ["a", "an", "for"] } ] }'
Contoh penggunaan
Dalam contoh ini, Anda akan membuat skema koleksi yang mencakup:
Sebuah bidang vektor untuk embedding.
Dua bidang "
VARCHAR" untuk pemrosesan teks:Satu bidang menggunakan penganalisis bawaan.
Yang lainnya menggunakan penganalisis khusus.
Sebelum memasukkan konfigurasi ini ke dalam koleksi Anda, Anda akan memverifikasi setiap penganalisis menggunakan metode ` run_analyzer `.
Langkah 1: Inisialisasi MilvusClient dan buat skema
Mulailah dengan menyiapkan klien Milvus dan membuat skema baru.
from pymilvus import MilvusClient, DataType

# Set up a Milvus client
client = MilvusClient(uri="http://localhost:19530")

# Create a new schema
schema = client.create_schema(auto_id=True, enable_dynamic_field=False)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.v2.common.IndexParam;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

// Set up a Milvus client
ConnectConfig config = ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build();
MilvusClientV2 client = new MilvusClientV2(config);

// Create schema
CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .enableDynamicField(false)
        .build();
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

// Set up a Milvus client
const client = new MilvusClient("http://localhost:19530");
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

cli, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: "localhost:19530",
})
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
defer client.Close(ctx)

schema := entity.NewSchema().WithAutoID(true).WithDynamicFieldEnabled(false)
# restful
Langkah 2: Menentukan dan memverifikasi konfigurasi penganalisis
Konfigurasikan dan verifikasi penganalisis bawaan (
english):Konfigurasi: Tentukan parameter penganalisis untuk penganalisis bahasa Inggris bawaan.
Verifikasi: Gunakan
run_analyzeruntuk memeriksa apakah konfigurasi tersebut menghasilkan tokenisasi yang diharapkan.
# Built-in analyzer configuration for English text processing
analyzer_params_built_in = {
    "type": "english"
}

# Verify built-in analyzer configuration
sample_text = "Milvus simplifies text analysis for search."
result = client.run_analyzer(sample_text, analyzer_params_built_in)
print("Built-in analyzer output:", result)

# Expected output:
# Built-in analyzer output: ['milvus', 'simplifi', 'text', 'analysi', 'search']
Map<String, Object> analyzerParamsBuiltin = new HashMap<>(); analyzerParamsBuiltin.put("type", "english"); List<String> texts = new ArrayList<>(); texts.add("Milvus simplifies text ana lysis for search."); RunAnalyzerResp resp = client.runAnalyzer(RunAnalyzerReq.builder() .texts(texts) .analyzerParams(analyzerParams) .build()); List<RunAnalyzerResp.AnalyzerResult> results = resp.getResults();// Use a built-in analyzer for VARCHAR field `title_en` const analyzerParamsBuiltIn = { type: "english", }; const sample_text = "Milvus simplifies text analysis for search."; const result = await client.run_analyzer({ text: sample_text, analyzer_params: analyzer_params_built_in });analyzerParams := map[string]any{"type": "english"} bs, _ := json.Marshal(analyzerParams) texts := []string{"Milvus simplifies text analysis for search."} option := milvusclient.NewRunAnalyzerOption(texts). WithAnalyzerParams(string(bs)) result, err := client.RunAnalyzer(ctx, option) if err != nil { fmt.Println(err.Error()) // handle error }# restfulKonfigurasikan dan verifikasi penganalisis khusus:
Konfigurasi: Tentukan penganalisis khusus yang menggunakan tokenizer standar bersama dengan filter huruf kecil bawaan serta filter khusus untuk panjang token dan kata-kata penghubung.
Verifikasi: Gunakan
run_analyzeruntuk memastikan konfigurasi kustom tersebut memproses teks sesuai yang diharapkan.
# Custom analyzer configuration with a standard tokenizer and custom filters
analyzer_params_custom = {
    "tokenizer": "standard",
    "filter": [
        "lowercase",  # Built-in filter: convert tokens to lowercase
        {
            "type": "length",  # Custom filter: restrict token length
            "max": 40
        },
        {
            "type": "stop",  # Custom filter: remove specified stop words
            "stop_words": ["of", "for"]
        }
    ]
}

# Verify custom analyzer configuration
sample_text = "Milvus provides flexible, customizable analyzers for robust text processing."
result = client.run_analyzer(sample_text, analyzer_params_custom)
print("Custom analyzer output:", result)

# Expected output:
# Custom analyzer output: ['milvus', 'provides', 'flexible', 'customizable', 'analyzers', 'robust', 'text', 'processing']
// Configure a custom analyzer Map<String, Object> analyzerParams = new HashMap<>(); analyzerParams.put("tokenizer", "standard"); analyzerParams.put("filter", Arrays.asList("lowercase", new HashMap<String, Object>() {{ put("type", "length"); put("max", 40); }}, new HashMap<String, Object>() {{ put("type", "stop"); put("stop_words", Arrays.asList("of", "for")); }} ) ); List<String> texts = new ArrayList<>(); texts.add("Milvus provides flexible, customizable analyzers for robust text processing."); RunAnalyzerResp resp = client.runAnalyzer(RunAnalyzerReq.builder() .texts(texts) .analyzerParams(analyzerParams) .build()); List<RunAnalyzerResp.AnalyzerResult> results = resp.getResults();// Configure a custom analyzer for VARCHAR field `title` const analyzerParamsCustom = { tokenizer: "standard", filter: [ "lowercase", { type: "length", max: 40, }, { type: "stop", stop_words: ["of", "to"], }, ], }; const sample_text = "Milvus provides flexible, customizable analyzers for robust text processing."; const result = await client.run_analyzer({ text: sample_text, analyzer_params: analyzer_params_built_in });analyzerParams = map[string]any{"tokenizer": "standard", "filter": []any{"lowercase", map[string]any{ "type": "length", "max": 40, map[string]any{ "type": "stop", "stop_words": []string{"of", "to"}, }}} bs, _ := json.Marshal(analyzerParams) texts := []string{"Milvus provides flexible, customizable analyzers for robust text processing."} option := milvusclient.NewRunAnalyzerOption(texts). WithAnalyzerParams(string(bs)) result, err := client.RunAnalyzer(ctx, option) if err != nil { fmt.Println(err.Error()) // handle error }# curl
Langkah 3: Tambahkan bidang ke skema
Setelah Anda memverifikasi konfigurasi penganalisis, tambahkan ke bidang skema Anda:
# Add VARCHAR field 'title_en' using the built-in analyzer configuration
schema.add_field(
    field_name='title_en',
    datatype=DataType.VARCHAR,
    max_length=1000,
    enable_analyzer=True,
    analyzer_params=analyzer_params_built_in,
    enable_match=True,
)

# Add VARCHAR field 'title' using the custom analyzer configuration
schema.add_field(
    field_name='title',
    datatype=DataType.VARCHAR,
    max_length=1000,
    enable_analyzer=True,
    analyzer_params=analyzer_params_custom,
    enable_match=True,
)

# Add a vector field for embeddings
schema.add_field(field_name="embedding", datatype=DataType.FLOAT_VECTOR, dim=3)

# Add a primary key field
schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True)
schema.addField(AddFieldReq.builder()
        .fieldName("title")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .analyzerParams(analyzerParams)
        .enableMatch(true) // must enable this if you use TextMatch
        .build());

// Add vector field
schema.addField(AddFieldReq.builder()
        .fieldName("embedding")
        .dataType(DataType.FloatVector)
        .dimension(3)
        .build());
// Add primary field
schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());
// Create schema
const schema = {
  auto_id: true,
  fields: [
    {
      name: "id",
      type: DataType.INT64,
      is_primary: true,
    },
    {
      name: "title_en",
      data_type: DataType.VARCHAR,
      max_length: 1000,
      enable_analyzer: true,
      analyzer_params: analyzerParamsBuiltIn,
      enable_match: true,
    },
    {
      name: "title",
      data_type: DataType.VARCHAR,
      max_length: 1000,
      enable_analyzer: true,
      analyzer_params: analyzerParamsCustom,
      enable_match: true,
    },
    {
      name: "embedding",
      data_type: DataType.FLOAT_VECTOR,
      dim: 4,
    },
  ],
};
schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(true),
).WithField(entity.NewField().
    WithName("embedding").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(3),
).WithField(entity.NewField().
    WithName("title").
    WithDataType(entity.FieldTypeVarChar).
    WithMaxLength(1000).
    WithEnableAnalyzer(true).
    WithAnalyzerParams(analyzerParams).
    WithEnableMatch(true),
)
# restful
Langkah 4: Siapkan parameter indeks dan buat koleksi
# Set up index parameters for the vector field
index_params = client.prepare_index_params()
index_params.add_index(field_name="embedding", metric_type="COSINE", index_type="AUTOINDEX")

# Create the collection with the defined schema and index parameters
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
// Set up index params for vector field
List<IndexParam> indexes = new ArrayList<>();
indexes.add(IndexParam.builder()
        .fieldName("embedding")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.COSINE)
        .build());

// Create collection with defined schema
CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
// Set up index params for vector field
const indexParams = [
  {
    name: "embedding",
    metric_type: "COSINE",
    index_type: "AUTOINDEX",
  },
];

// Create collection with defined schema
await client.createCollection({
  collection_name: "my_collection",
  schema: schema,
  index_params: indexParams,
});

console.log("Collection created successfully!");
idx := index.NewAutoIndex(index.MetricType(entity.COSINE))
indexOption := milvusclient.NewCreateIndexOption("my_collection", "embedding", idx)

err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
# restful
Langkah selanjutnya
Setelah mengonfigurasi penganalisis, Anda dapat mengintegrasikannya dengan fitur pencarian teks yang disediakan oleh Milvus. Untuk detailnya:
