
Traitement des données
Cet article fournit une description détaillée de la mise en œuvre de l'insertion de données, de la création d'index et de l'interrogation des données dans Milvus.
Insertion de données
Vous pouvez choisir le nombre de shards utilisés par une collection dans Milvus : chaque shard correspond à un canal virtuel (vchannel). Comme illustré ci-dessous, Milvus attribue ensuite chaque vchannel à un canal physique (pchannel), et chaque pchannel est lié à un nœud de streaming spécifique.
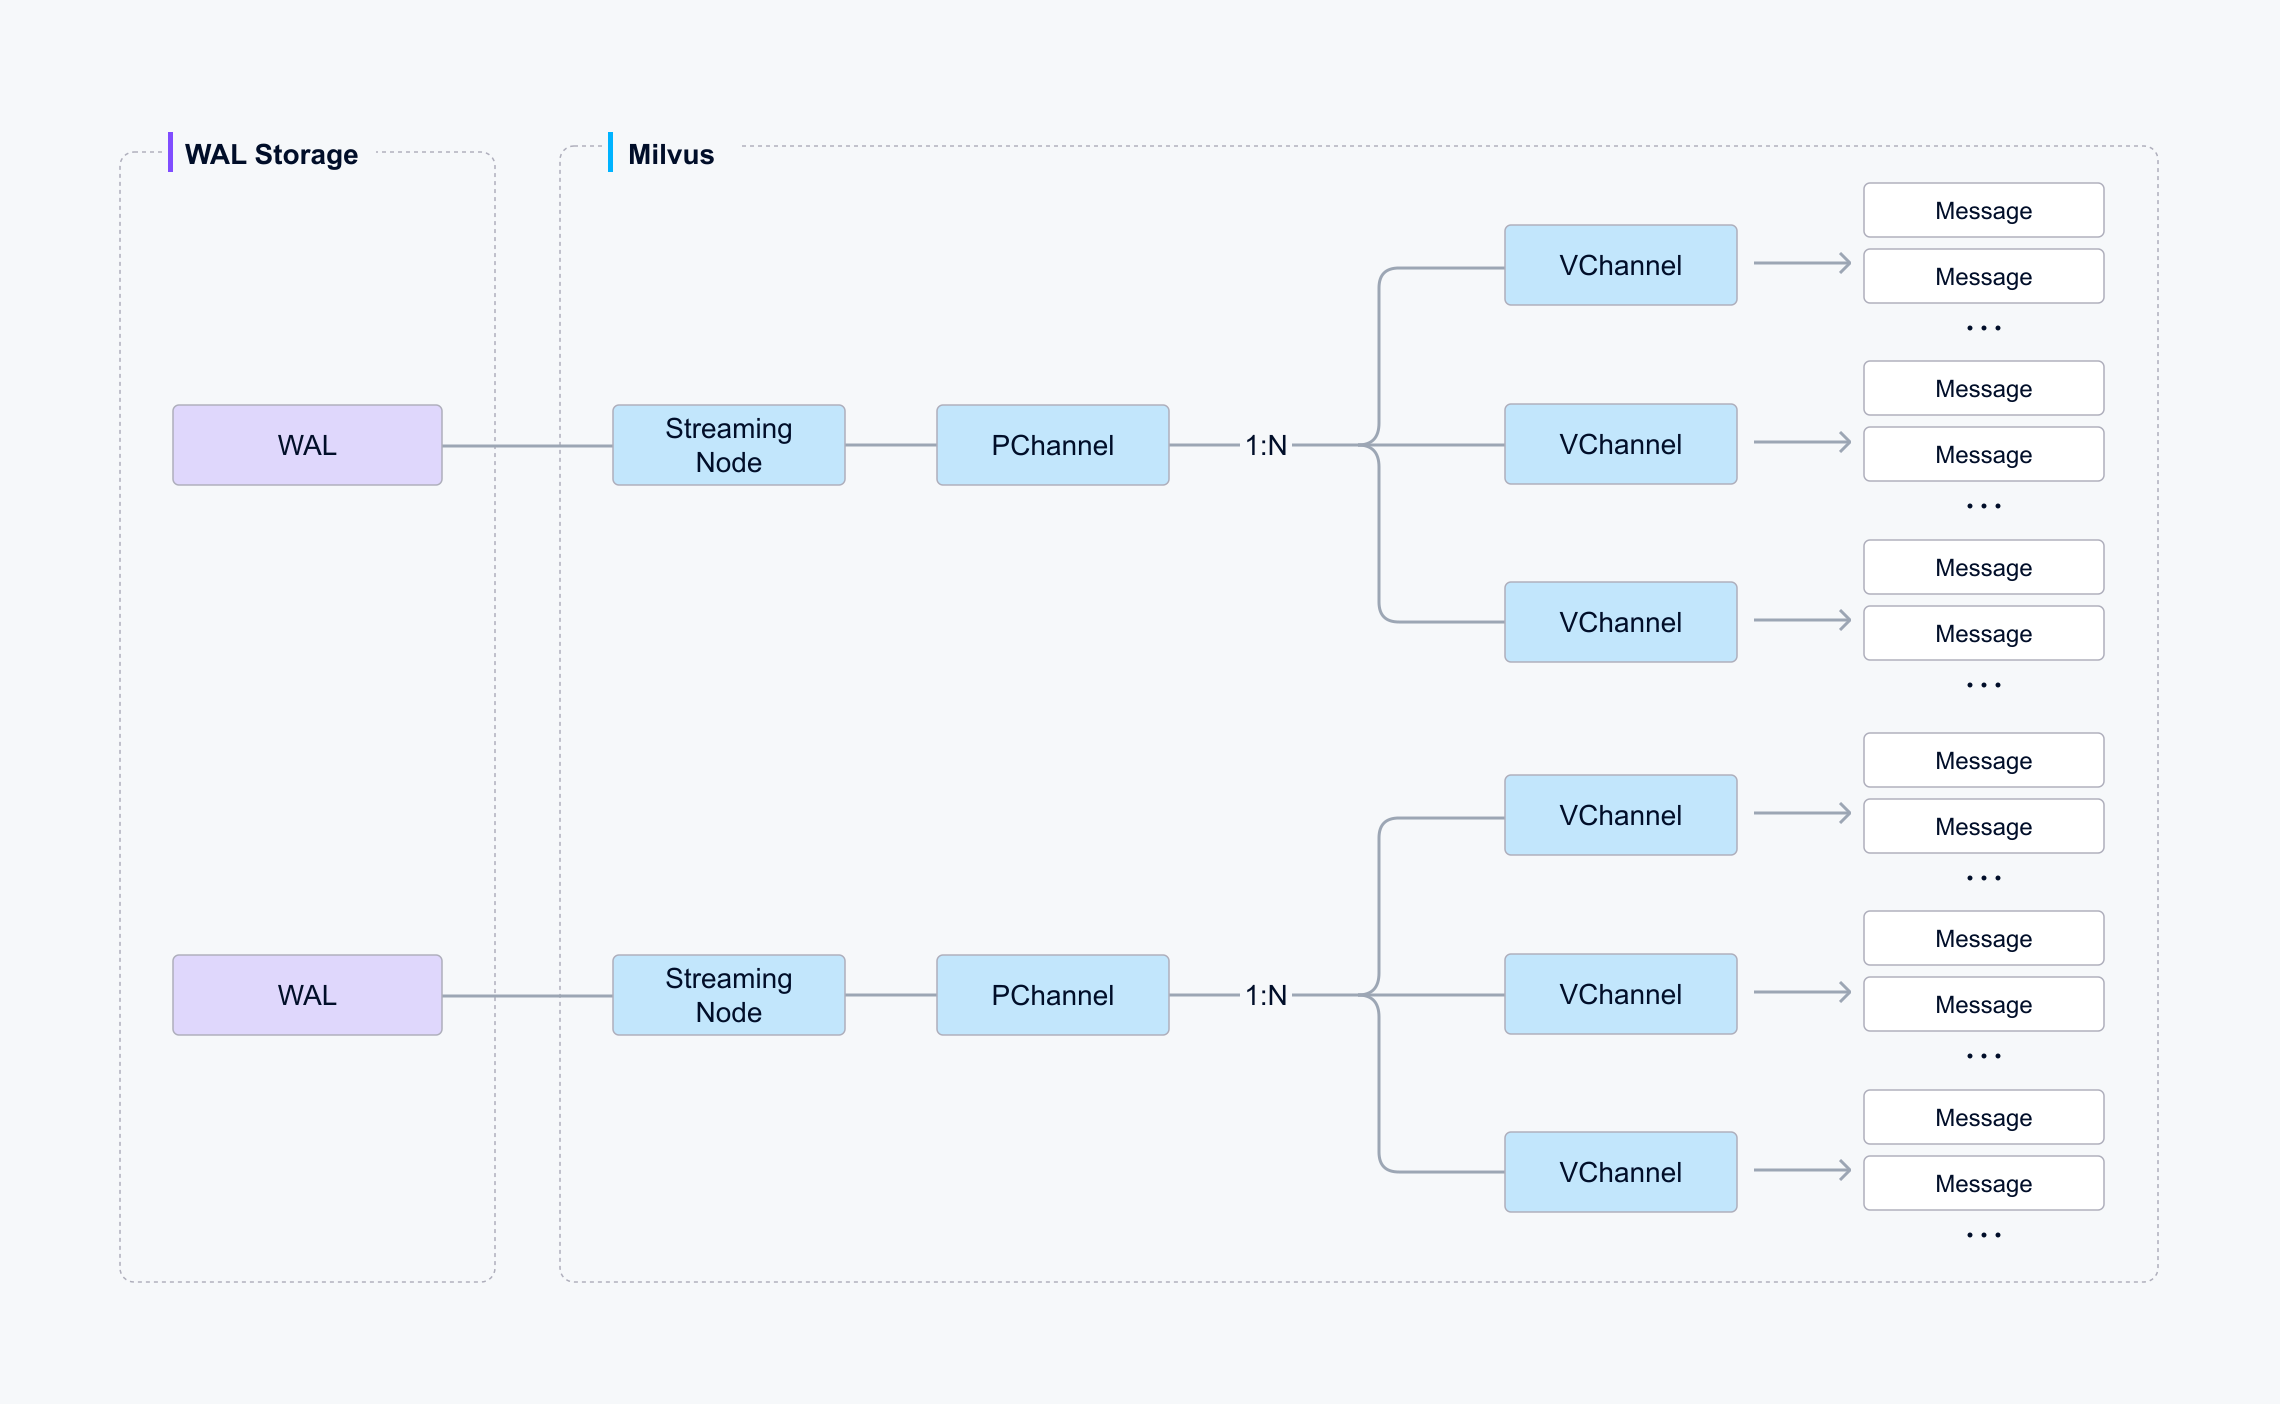 VChannel, PChannel et nœud de streaming
Après vérification des données, le proxy divise le message écrit en plusieurs paquets de données correspondant aux shards, conformément aux règles de routage des shards spécifiées.
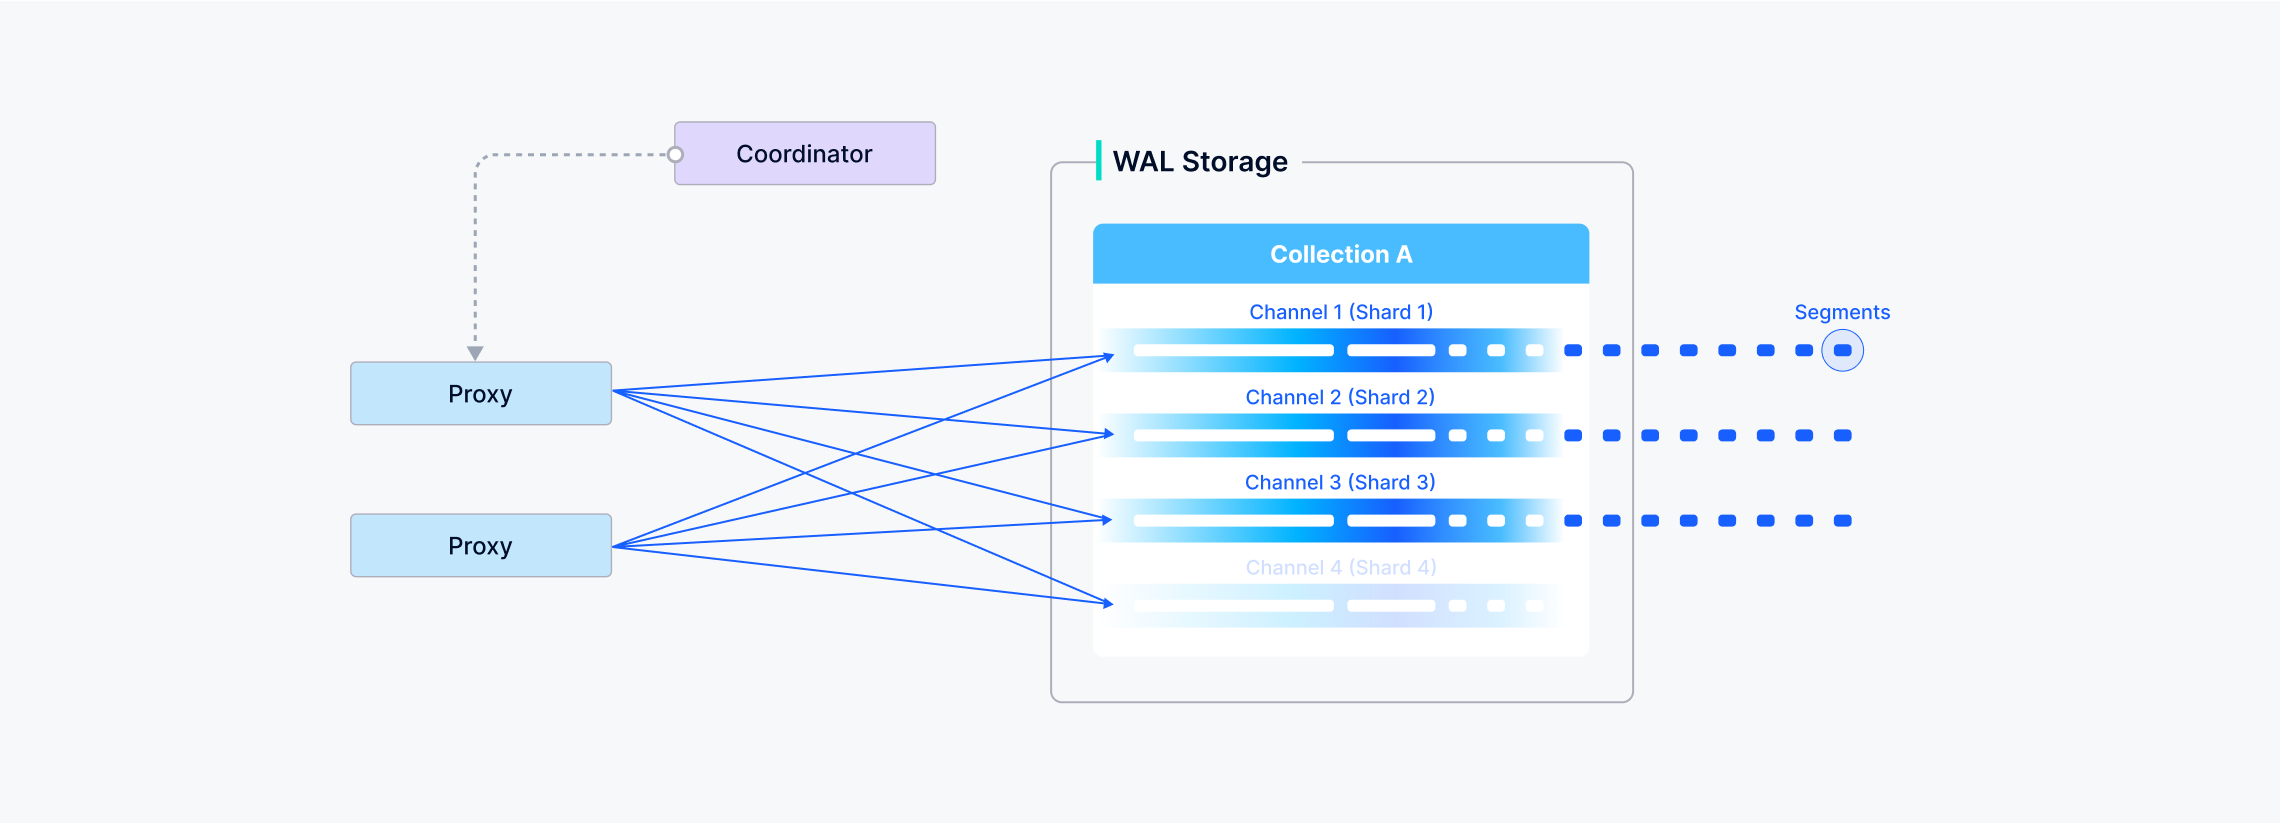 Canaux 1
Les données écrites d’un fragment (vchannel) sont ensuite envoyées au nœud de streaming correspondant du pchannel.
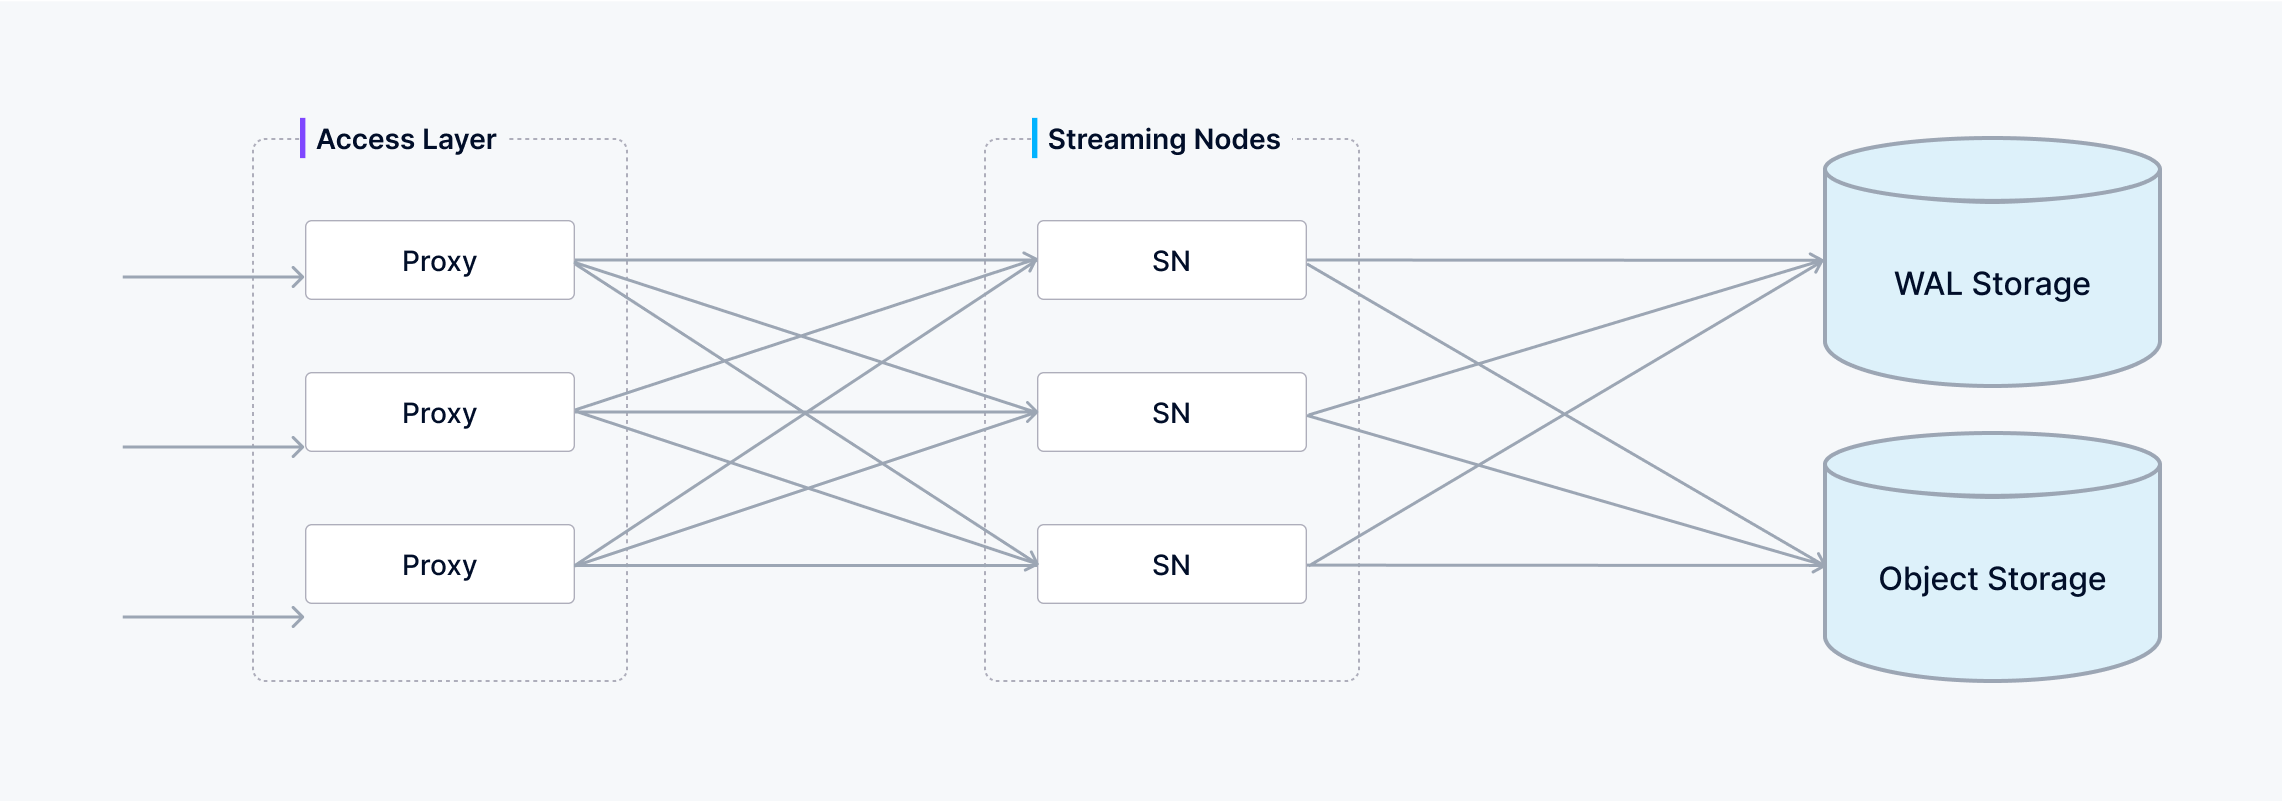 Flux d’écriture
Le nœud de streaming attribue un horodatage Oracle (TSO) à chaque paquet de données afin d’établir un ordre total des opérations. Il effectue des contrôles de cohérence sur la charge utile avant de l’écrire dans le journal d’écriture anticipée (WAL) sous-jacent. Une fois les données validées de manière durable dans le WAL, leur conservation est garantie : même en cas de panne, le nœud de streaming peut rejouer le WAL pour récupérer intégralement toutes les opérations en attente.
Parallèlement, le nœud de streaming découpe également de manière asynchrone les entrées validées du WAL en segments distincts. Il existe deux types de segments :
- Segment croissant: toutes les données qui n’ont pas encore été persistées dans le stockage d’objets.
- Segment scellé: toutes les données ont été persistées dans le stockage objet ; les données d’un segment scellé sont immuables.
Le passage d’un segment en croissance à un segment scellé s’appelle un « flush ». Le nœud de streaming déclenche un flush dès qu’il a ingéré et écrit toutes les entrées WAL disponibles pour ce segment — c’est-à-dire lorsqu’il n’y a plus d’enregistrements en attente dans le journal d’écriture anticipée sous-jacent —, moment auquel le segment est finalisé et optimisé pour la lecture.
Création d’index
La création d’index est effectuée par le nœud de données. Afin d’éviter une création fréquente d’index lors des mises à jour des données, une collection dans Milvus est divisée en segments, chacun disposant de son propre index.
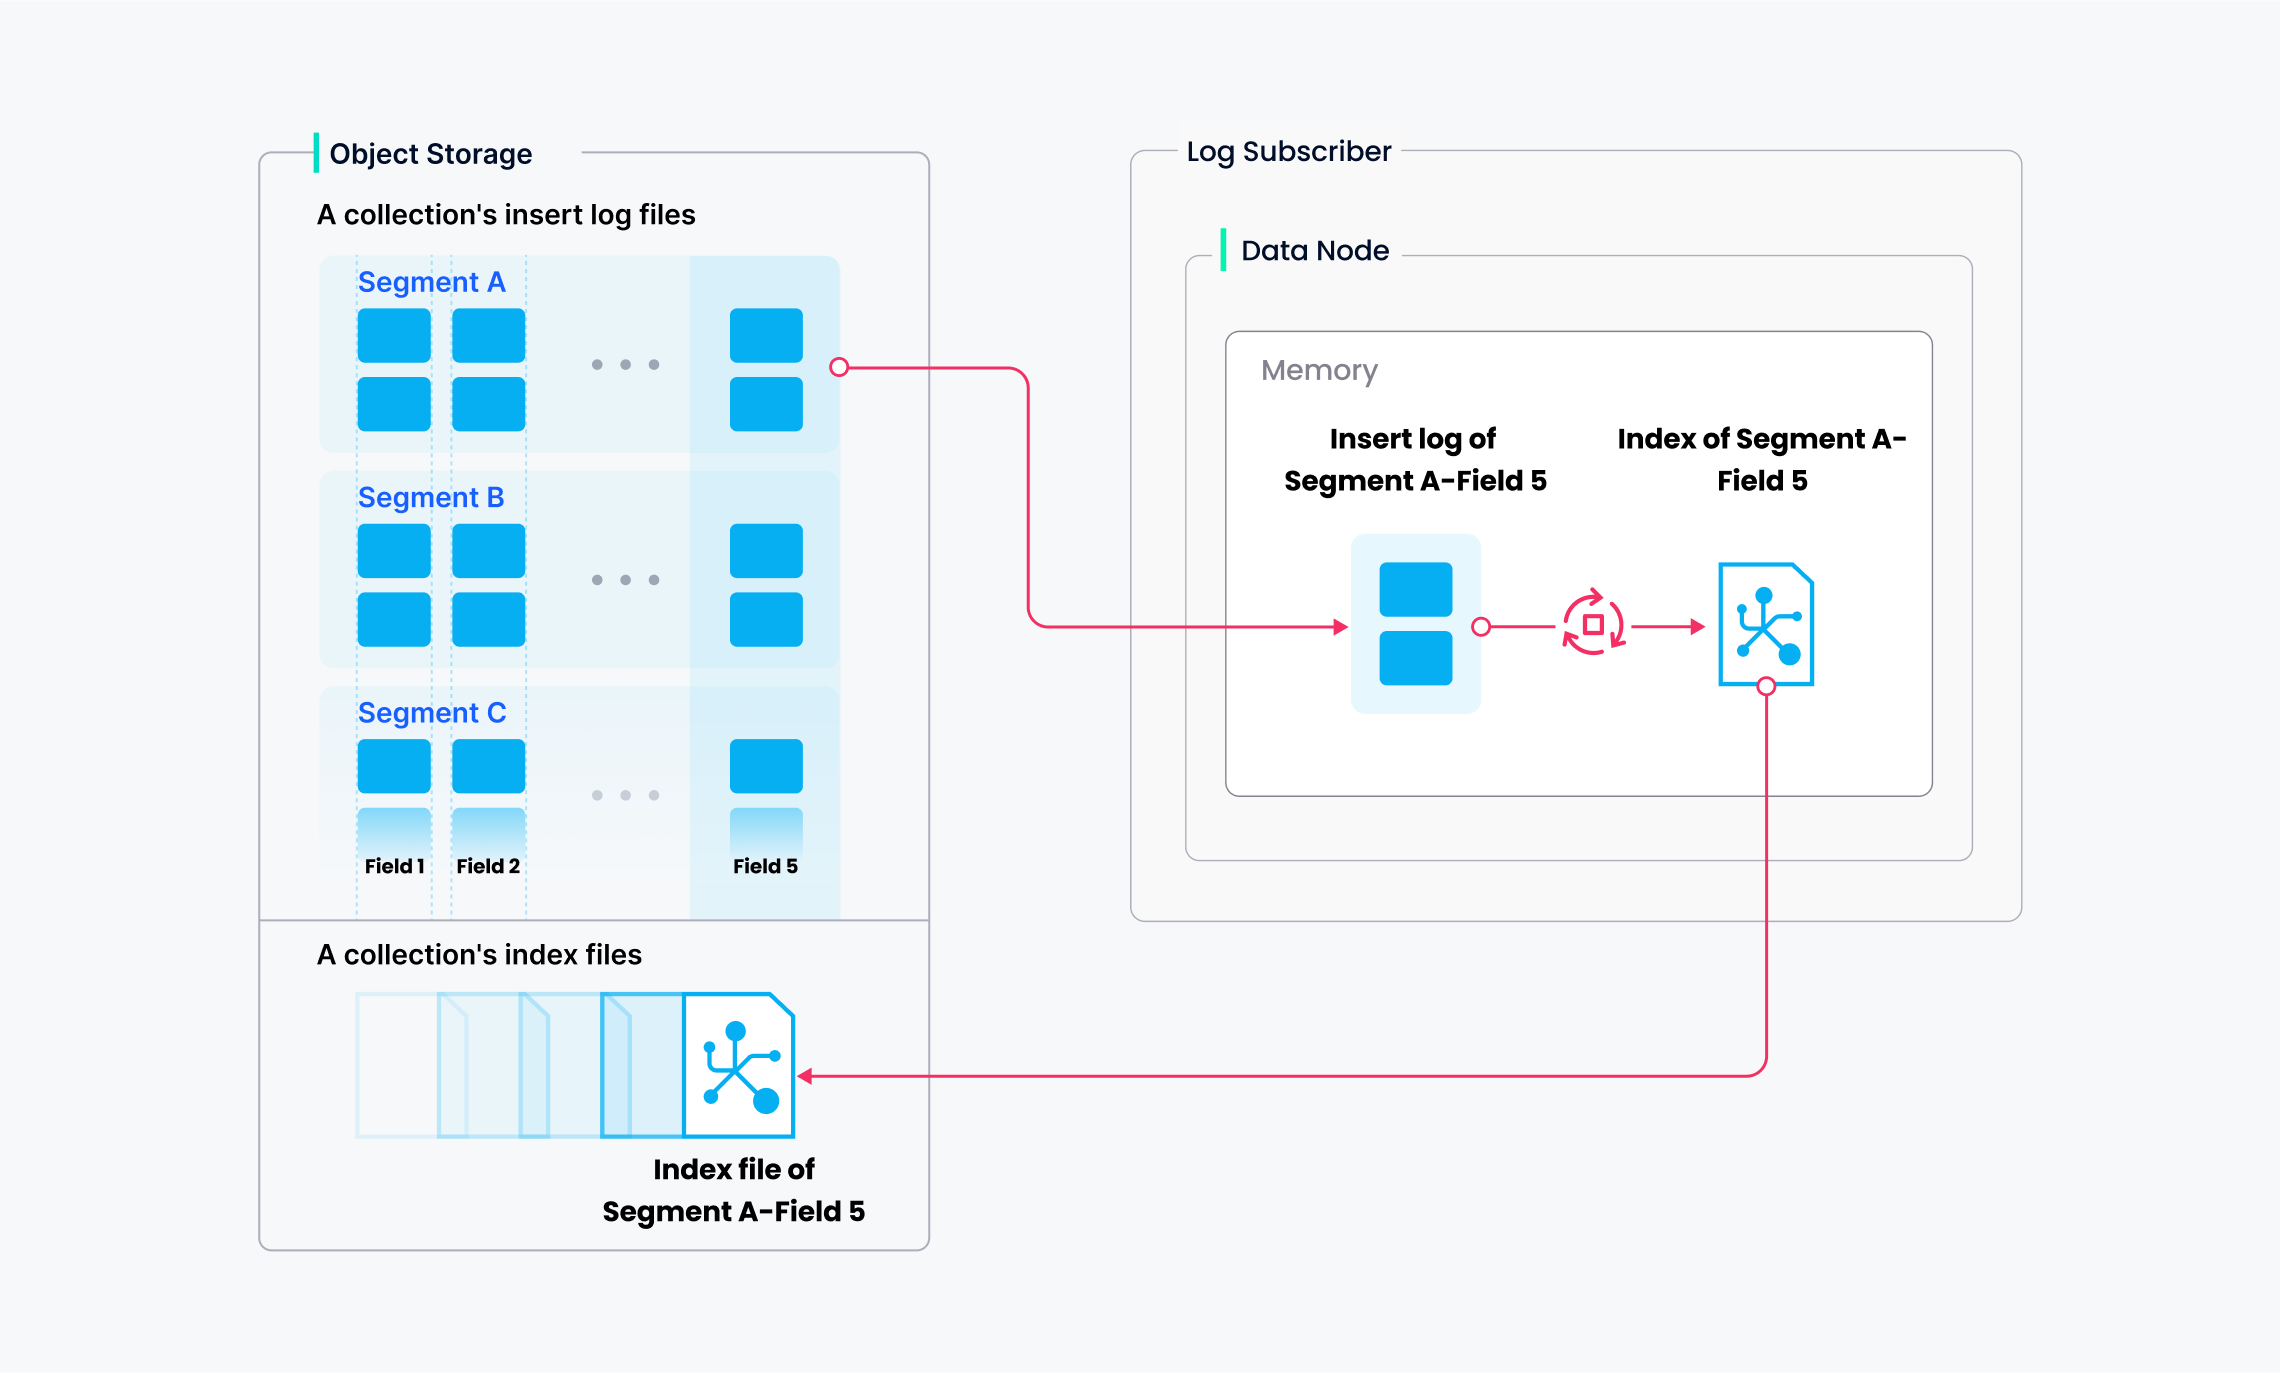 Création d’index
Milvus prend en charge la création d’index pour chaque champ vectoriel, champ scalaire et champ principal. Tant l’entrée que la sortie de la création d’index font appel au stockage objet : le nœud de données charge en mémoire les instantanés de journal à indexer provenant d’un segment (qui se trouve dans le stockage objet), désérialise les données et métadonnées correspondantes pour créer l’index, sérialise l’index une fois la création terminée, puis le réécrit dans le stockage objet.
La construction d’index implique principalement des opérations sur des vecteurs et des matrices et est donc très gourmande en ressources de calcul et en mémoire. Les vecteurs ne peuvent pas être indexés efficacement avec des index traditionnels basés sur des arborescences en raison de leur nature hautement dimensionnelle, mais peuvent l’être à l’aide de techniques plus abouties dans ce domaine, telles que les index basés sur des clusters ou des graphes. Quel que soit son type, la construction d’un index implique des calculs itératifs massifs pour les vecteurs à grande échelle, tels que l’algorithme des K-moyennes ou la traversée de graphes.
Contrairement à l’indexation des données scalaires, la création d’un index vectoriel doit tirer pleinement parti de l’accélération SIMD (single instruction, multiple data). Milvus prend en charge nativement les jeux d’instructions SIMD, par exemple SSE, AVX2 et AVX512. Compte tenu des « ratés » et de la nature gourmande en ressources de la création d’index vectoriels, l’élasticité revêt une importance cruciale pour Milvus d’un point de vue économique. Les futures versions de Milvus approfondiront les explorations dans le domaine du calcul hétérogène et du calcul sans serveur afin de réduire les coûts associés.
Par ailleurs, Milvus prend également en charge le filtrage scalaire et les requêtes sur le champ principal. Il dispose d’index intégrés pour améliorer l’efficacité des requêtes, tels que les index de type filtre de Bloom, les index de hachage, les index arborescents et les index inversés, et prévoit d’introduire davantage d’index externes, notamment des index bitmap et des index approximatifs.
Requête sur les données
La requête de données désigne le processus consistant à rechercher, dans une collection spécifiée, les k vecteurs les plus proches d’un vecteur cible ou tous les vecteurs situés dans un rayon spécifié par rapport à ce vecteur. Les vecteurs sont renvoyés avec leur clé primaire et leurs champs correspondants.
 Requête de données
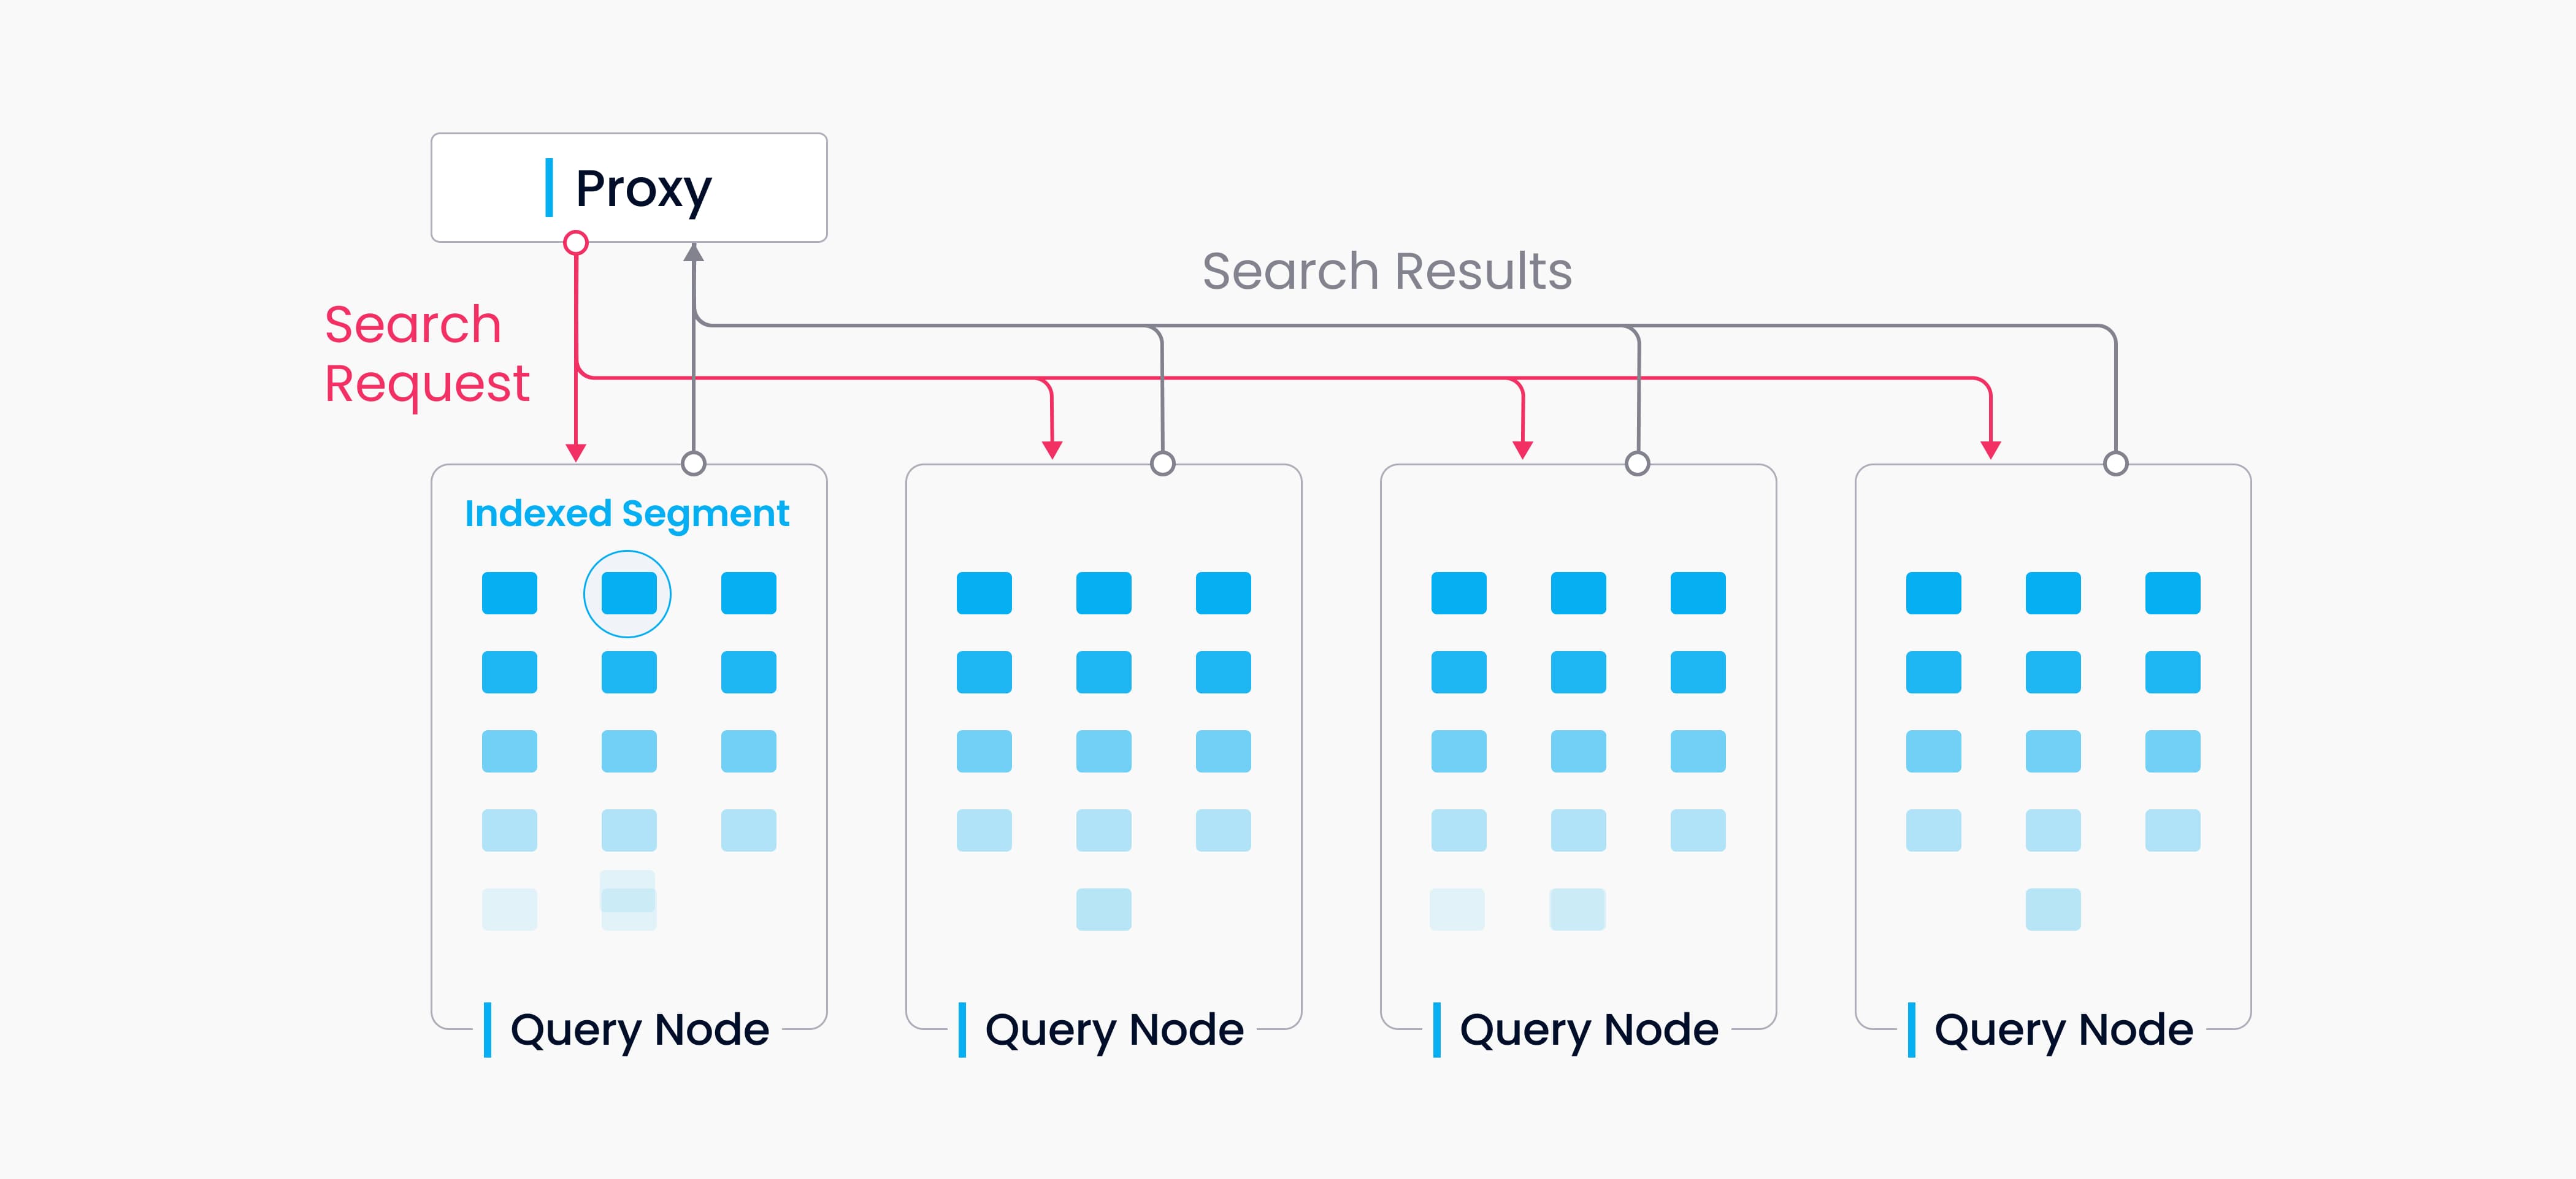
Dans Milvus, une collection est divisée en plusieurs segments ; le nœud de streaming charge les segments en cours de croissance et gère les données en temps réel, tandis que les nœuds de requête chargent les segments scellés.
Lorsqu’une requête de recherche arrive, le proxy la diffuse à tous les nœuds de streaming responsables des shards concernés afin de permettre une recherche simultanée.
Lorsqu’une requête de recherche arrive, le proxy demande simultanément aux nœuds de streaming qui détiennent les fragments correspondants d’exécuter la recherche.
Chaque nœud de streaming génère un plan de requête, effectue une recherche dans ses données locales en cours de croissance et contacte simultanément les nœuds de requête distants pour récupérer les résultats historiques, puis agrège le tout en un seul résultat de fragment.
Enfin, le proxy rassemble tous les résultats des fragments, les fusionne en un résultat final et le renvoie au client.
 Transfert
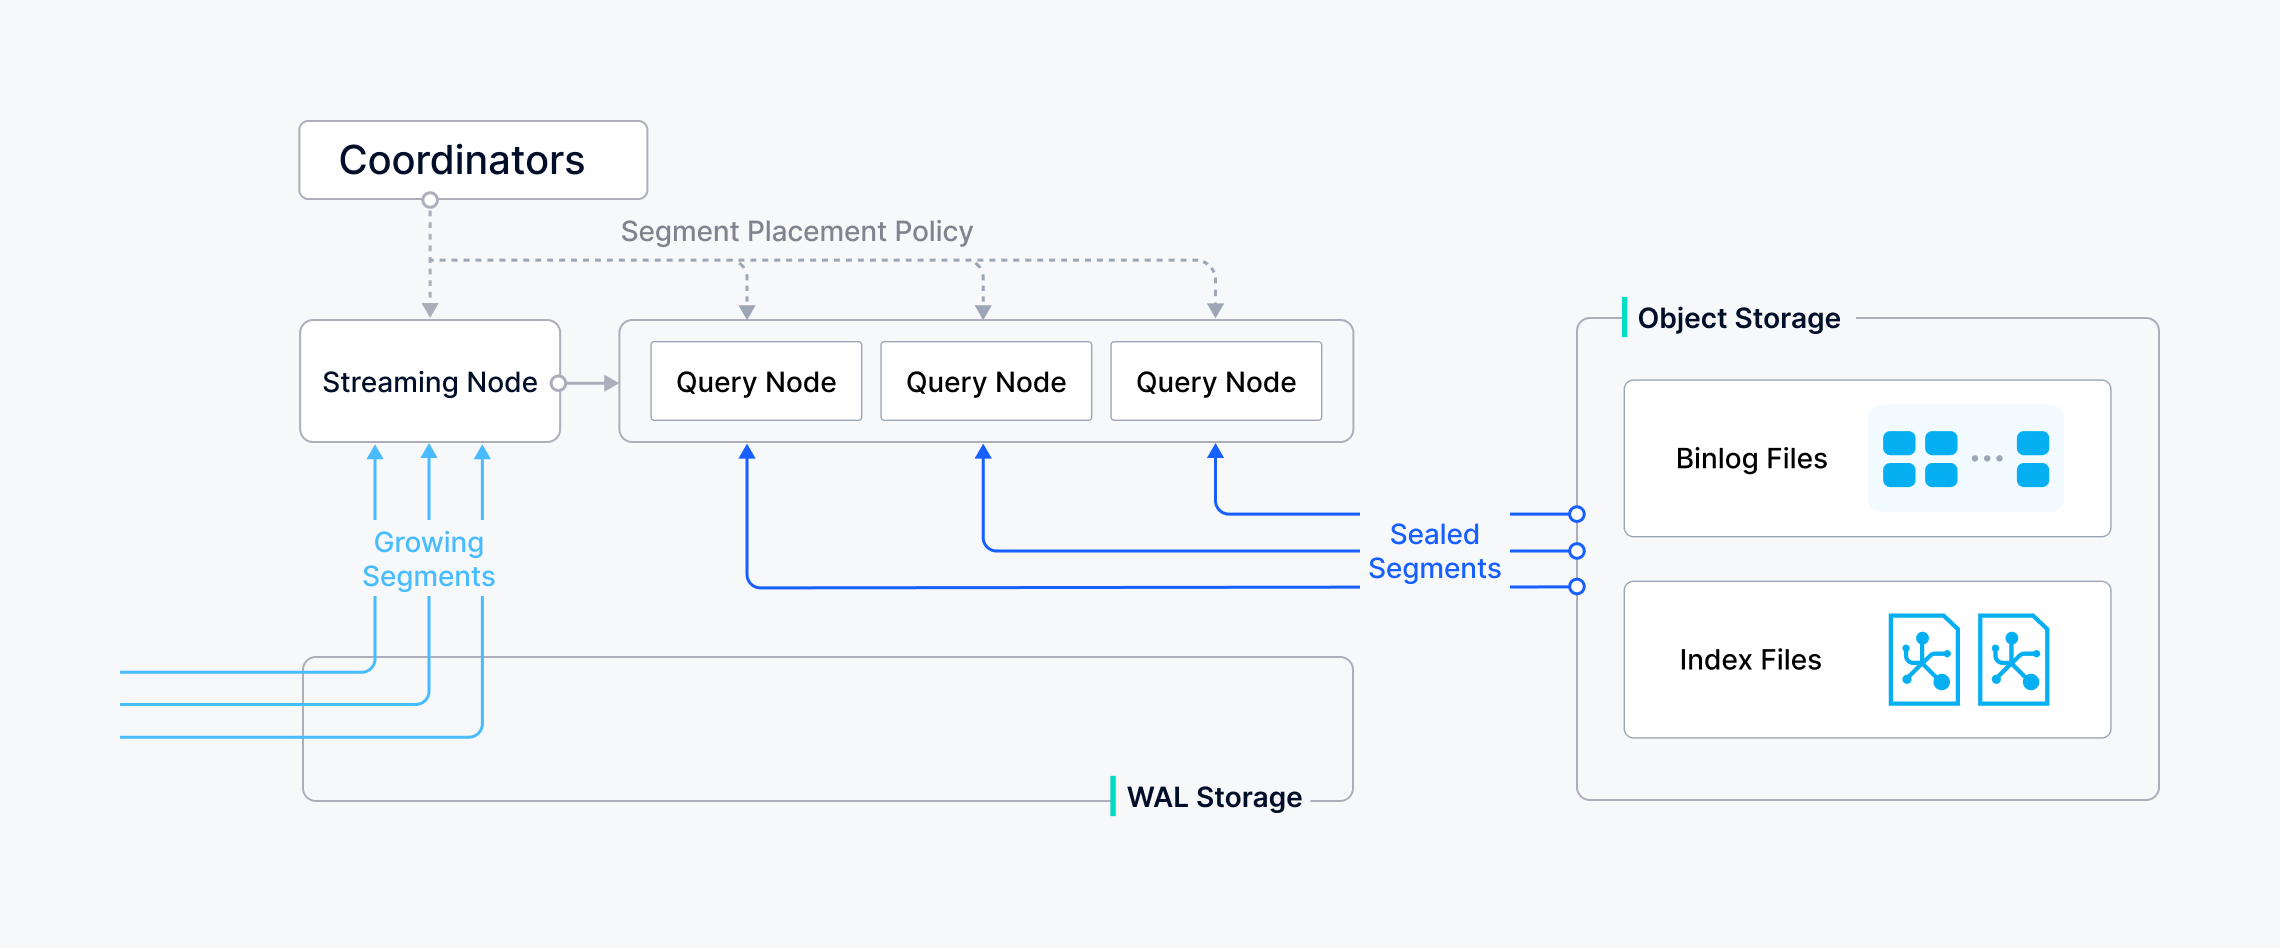
Lorsqu’un segment en croissance sur un nœud de streaming est vidé dans un segment scellé — ou lorsqu’un nœud de données achève une compaction —, le coordinateur lance une opération de transfert pour convertir ces données en croissance en données historiques. Le coordinateur répartit ensuite les segments scellés de manière uniforme entre tous les nœuds de requête, en équilibrant l’utilisation de la mémoire, la charge du processeur et le nombre de segments, puis libère tout segment redondant.
Et ensuite ?
- Découvrez comment utiliser la base de données vectorielle Milvus pour les requêtes en temps réel.
- Découvrez l’insertion et la persistance des données dans Milvus.
- Découvrez comment les données sont traitées dans Milvus.
