

文本匹配
Milvus 中的文本匹配功能可根据特定术语精确检索文档。该功能主要用于满足特定条件的过滤搜索,并可结合标量过滤来优化查询结果,从而在满足标量条件的向量中进行相似度搜索。
TEXT_MATCH 可查找完全匹配的已分析术语,而“TEXT_MATCH_FUZZY ”则可容忍查询令牌与索引令牌之间存在较小的编辑距离。两者均为布尔过滤操作,不会对匹配文档的相关性进行评分。如果您希望根据查询术语的语义含义和重要性检索最相关的文档,建议您使用全文搜索。
概述
Milvus 集成了Tantivy来支持其底层的倒排索引和基于术语的文本搜索。对于每条文本条目,Milvus 会按照以下流程进行索引:
分析器:分析器通过将输入文本切分为单个单词(即词元)来处理文本,然后根据需要应用过滤器。这使得 Milvus 能够基于这些词元构建索引。
索引:文本分析完成后,Milvus 会创建一个倒排索引,将每个唯一词素映射到包含该词素的文档。
当用户执行文本匹配时,系统会利用倒排索引快速检索所有包含该术语的文档。这比逐个扫描每个文档要快得多。
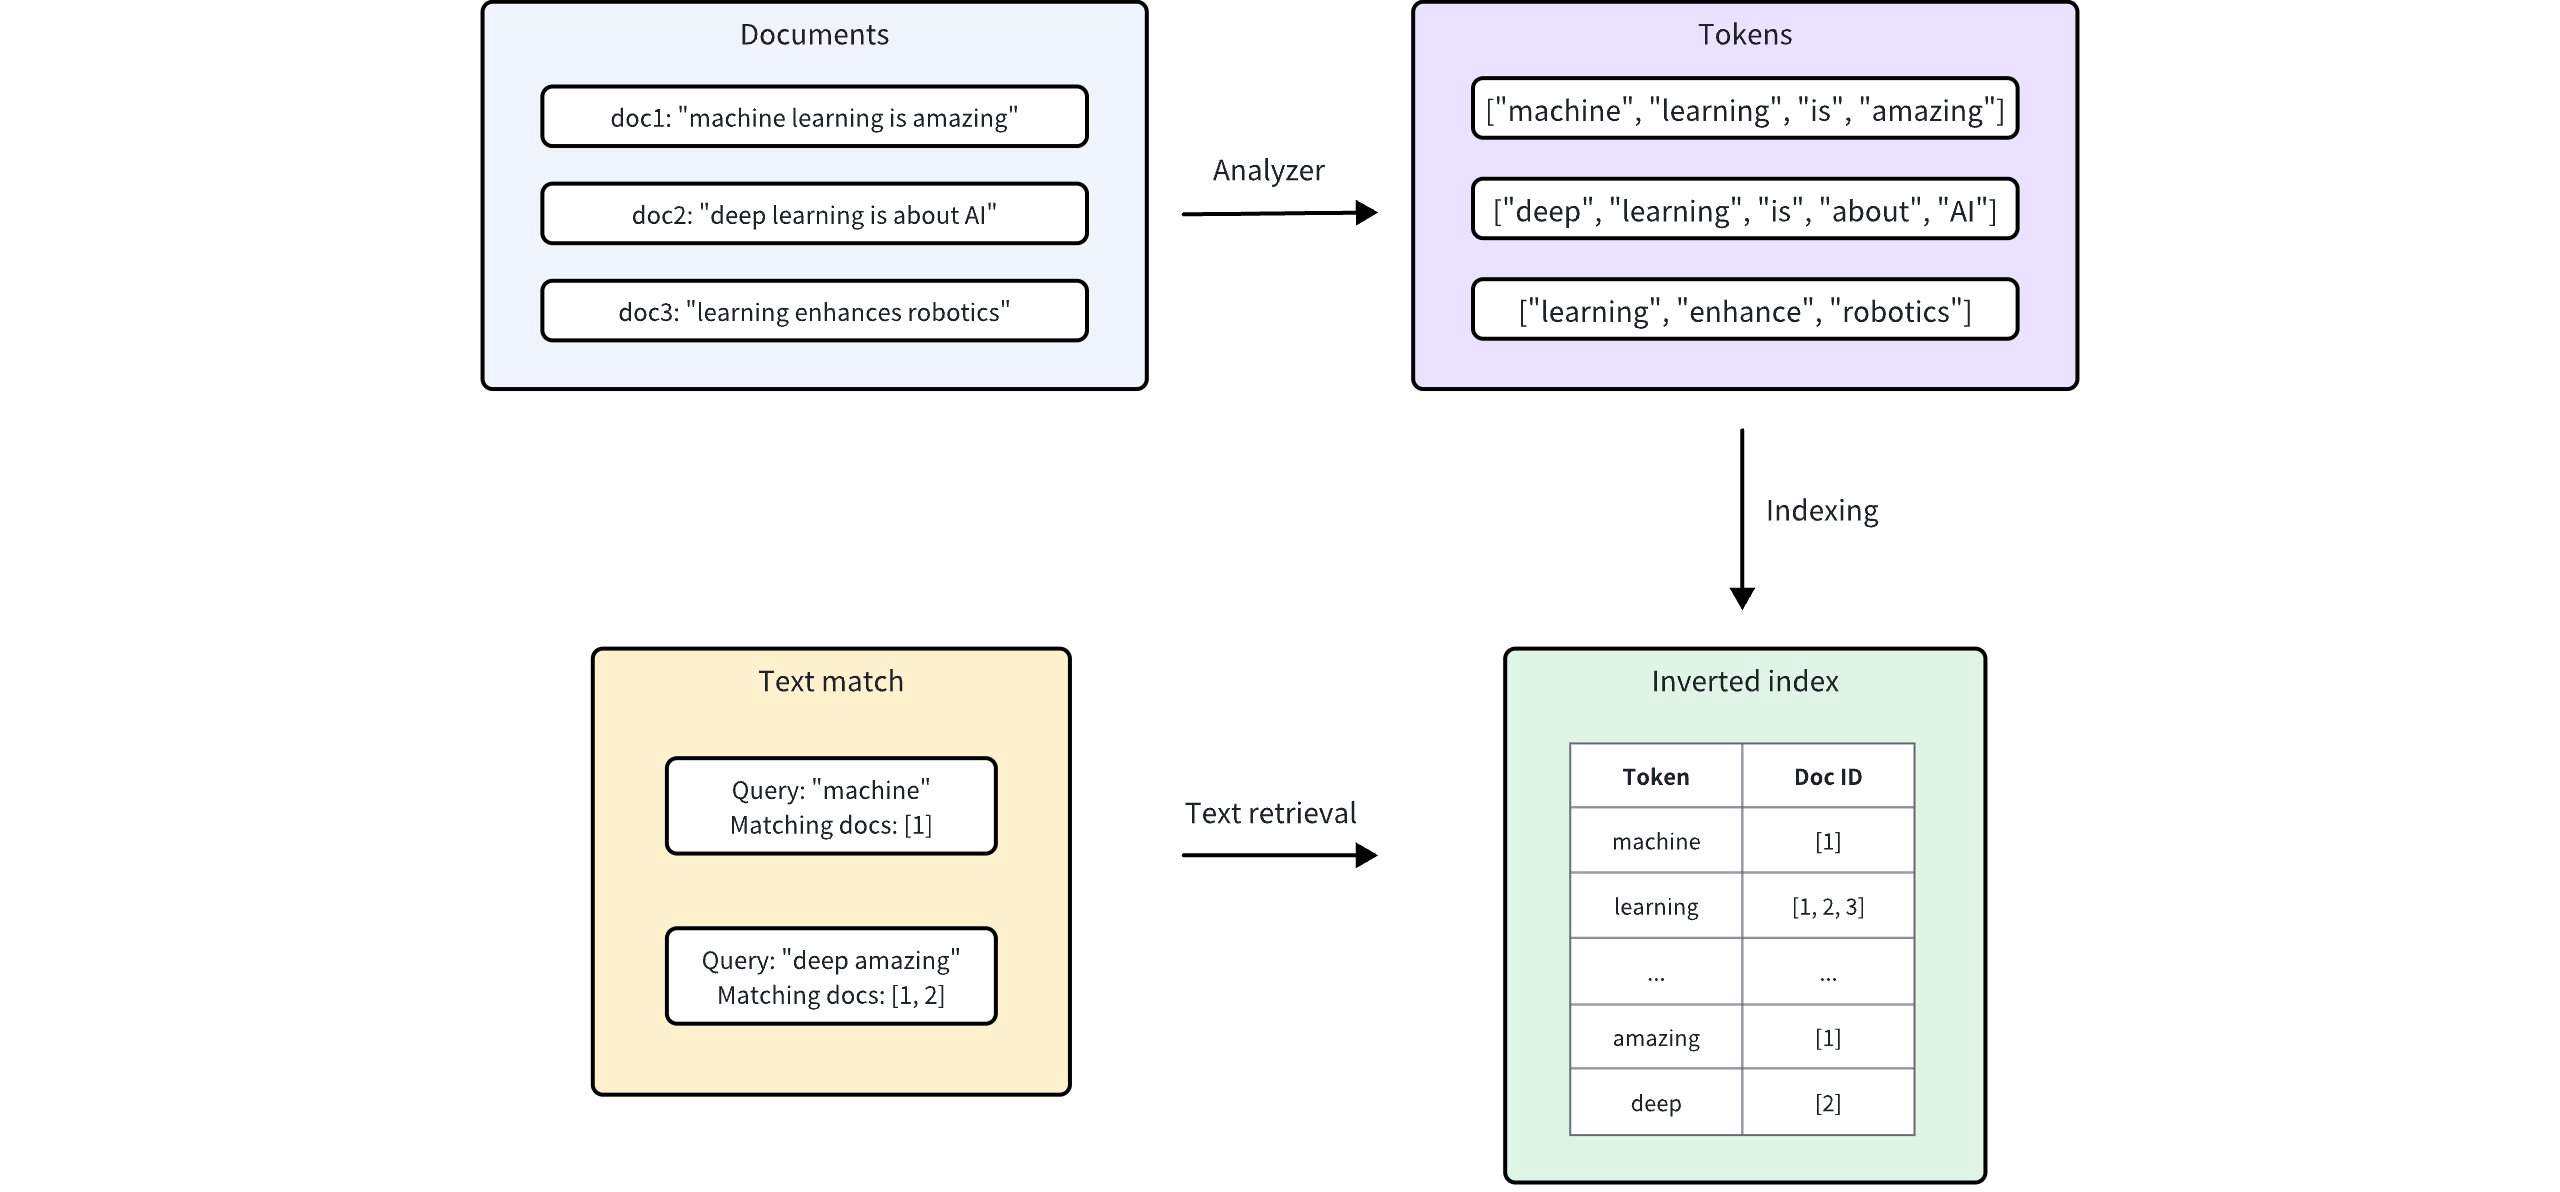 关键词匹配
启用文本匹配
文本匹配适用于已启用匹配功能的字符串字段。本页示例使用 VARCHAR,该字段在所有客户端 SDK 中均受支持。在 Milvus 3.0.x 中, TEXT 字段在启用 Storage V3 时也支持文本匹配。对于这两种字段类型,请将 `enable_analyzer ` 和 `enable_match ` 均设置为 `True`,然后在定义 Collection Schema 时可选地配置分析器。
将 `enable_analyzer ` 和enable_match
若要为特定的VARCHAR 字段启用文本匹配,请在定义字段模式时将enable_analyzer 和enable_match 两个参数均设置为True 。这将指示 Milvus 对文本进行分词,并为指定字段创建倒排索引,从而实现快速高效的文本匹配。
from pymilvus import MilvusClient, DataType

schema = MilvusClient.create_schema(enable_dynamic_field=False)
schema.add_field(
    field_name="id",
    datatype=DataType.INT64,
    is_primary=True,
    auto_id=True
)
schema.add_field(
    field_name='text',
    datatype=DataType.VARCHAR,
    max_length=1000,
    enable_analyzer=True, # Whether to enable text analysis for this field
    enable_match=True # Whether to enable text match
)
schema.add_field(
    field_name="embeddings",
    datatype=DataType.FLOAT_VECTOR,
    dim=5
)
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .enableDynamicField(false)
        .build();
schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .enableMatch(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("embeddings")
        .dataType(DataType.FloatVector)
        .dimension(5)
        .build());
import "github.com/milvus-io/milvus/client/v2/entity"

schema := entity.NewSchema().WithDynamicFieldEnabled(false)
schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(true),
).WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithEnableMatch(true).
    WithMaxLength(1000),
).WithField(entity.NewField().
    WithName("embeddings").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(5),
)
const schema = [
  {
    name: "id",
    data_type: DataType.Int64,
    is_primary_key: true,
  },
  {
    name: "text",
    data_type: "VarChar",
    enable_analyzer: true,
    enable_match: true,
    max_length: 1000,
  },
  {
    name: "embeddings",
    data_type: DataType.FloatVector,
    dim: 5,
  },
];
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true,
                    "enable_match": true
                }
            },
            {
                "fieldName": "embeddings",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "5"
                }
            }
        ]
    }'
milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->SetEnableDynamicField(false);
schema->AddField({"id", milvus::DataType::INT64, "", true, true});
schema->AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR).WithMaxLength(1000).EnableAnalyzer(true).EnableMatch(true));
schema->AddField(milvus::FieldSchema("embeddings", milvus::DataType::FLOAT_VECTOR).WithDimension(5));
可选:配置分析器
关键词匹配的性能和准确性取决于所选的分析器。不同的分析器针对不同的语言和文本结构进行了优化,因此选择合适的分析器将对您特定用例的搜索结果产生显著影响。
默认情况下,Milvus 使用standard 分析器,该分析器基于空格和标点符号对文本进行分词,移除长度超过 40 个字符的词元,并将文本转换为小写。应用此默认设置无需额外参数。有关更多信息,请参阅“标准”。
如果需要使用其他分析器,您可以通过analyzer_params 参数进行配置。例如,要应用english 分析器来处理英文文本:
analyzer_params = {
    "type": "english"
}
schema.add_field(
    field_name='text',
    datatype=DataType.VARCHAR,
    max_length=200,
    enable_analyzer=True,
    analyzer_params = analyzer_params,
    enable_match = True,
)
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("type", "english");
schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(200)
        .enableAnalyzer(true)
        .analyzerParams(analyzerParams)
        .enableMatch(true)
        .build());
analyzerParams := map[string]any{"type": "english"}
schema.WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithEnableMatch(true).
    WithAnalyzerParams(analyzerParams).
    WithMaxLength(200),
)
const schema = [
  {
    name: "id",
    data_type: DataType.Int64,
    is_primary_key: true,
  },
  {
    name: "text",
    data_type: "VarChar",
    enable_analyzer: true,
    enable_match: true,
    max_length: 1000,
    analyzer_params: { type: 'english' },
  },
  {
    name: "embeddings",
    data_type: DataType.FloatVector,
    dim: 5,
  },
];
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 200,
                    "enable_analyzer": true,
                    "enable_match": true,
                    "analyzer_params": {"type": "english"}
                }
            },
            {
                "fieldName": "embeddings",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "5"
                }
            }
        ]
    }'
nlohmann::json analyzer_params = {{"type", "english"}};
schema->AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR).WithMaxLength(200).EnableAnalyzer(true).WithAnalyzerParams(analyzer_params).EnableMatch(true));
Milvus 还提供了适用于不同语言和场景的多种其他分析器。更多详情请参阅《分析器概述》。
使用文本匹配
在Schema中为 `VARCHAR ` 或 `TEXT ` 字段启用文本匹配功能后,即可使用 `TEXT_MATCH ` 表达式执行文本匹配。
TEXT_MATCH 表达式语法
TEXT_MATCH 表达式用于指定要搜索的字段和术语。其语法如下:
TEXT_MATCH(field_name, text)
std::string filter = "TEXT_MATCH(field_name, text)";
export filter="\"TEXT_MATCH(field_name, text)\""
field_name: 要搜索的、支持匹配功能的VARCHAR或TEXT字段的名称。text: 要搜索的术语。多个术语可以用空格或根据语言和配置的分析器所确定的其他适当分隔符分隔。
默认情况下,TEXT_MATCH 使用“或”(OR)匹配逻辑,这意味着它将返回包含所指定任一术语的文档。例如,若要在text 字段中搜索包含术语machine 或deep 的文档,请使用以下表达式:
filter = "TEXT_MATCH(text, 'machine deep')"
String filter = "TEXT_MATCH(text, 'machine deep')";
filter := "TEXT_MATCH(text, 'machine deep')"
const filter = "TEXT_MATCH(text, 'machine deep')";
export filter="\"TEXT_MATCH(text, 'machine deep')\""
std::string filter = "TEXT_MATCH(text, 'machine deep')";
您还可以使用逻辑操作符组合多个TEXT_MATCH 表达式,以执行“AND”匹配。
若要在“
text”字段中搜索同时包含“machine”和“deep”的文档,请使用以下表达式:filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')"String filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')";filter := "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')"const filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')"export filter="\"TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')\""std::string filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')";若要搜索在
text字段中同时包含machine和learning但不包含deep的文档,请使用以下表达式:filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')"String filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')";filter := "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')"const filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')";export filter="\"not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')\""std::string filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')";
TEXT_MATCH_FUZZY 表达式语法Compatible with Milvus 3.0.0+
使用TEXT_MATCH_FUZZY 可容忍查询令牌与索引令牌之间的拼写差异。Milvus会使用字段的分析器分析查询文本,并对生成的每个令牌应用模糊匹配。如果查询产生多个令牌,当任何一个令牌满足配置的编辑距离时,该表达式即匹配一个实体。
语法如下:
TEXT_MATCH_FUZZY(field_name, text, max_edit_distance = 1)
std::string filter = "TEXT_MATCH_FUZZY(field_name, text, max_edit_distance = 1)";
export filter="\"TEXT_MATCH_FUZZY(field_name, text, max_edit_distance = 1)\""
field_name: 要搜索的、已启用匹配功能的VARCHAR或TEXT字段的名称。text: 待分析并与索引词进行匹配的查询文本。max_edit_distance: 每个查询令牌允许的最大编辑距离。该选项名称必须精确为max_edit_distance,其值必须为0、1或2。值为0时执行精确令牌匹配,等同于TEXT_MATCH。
例如,以下表达式匹配与 `machne` 仅相差一个字符的令牌,包括 `machine`:
filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)"
String filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)";
filter := "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)"
const filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)";
export filter="\"TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)\""
std::string filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)";
TEXT_MATCH_FUZZY 是过滤表达式语法的一部分,因此客户端 SDK 无需专门的模糊匹配方法。在搜索或查询操作中,将该表达式通过与TEXT_MATCH 相同的filter 参数传递即可。
使用文本匹配进行搜索
文本匹配可与向量相似度搜索结合使用,以缩小搜索范围并提升搜索性能。通过在向量相似度搜索之前使用文本匹配对Collection进行过滤,可以减少需要搜索的文档数量,从而缩短查询时间。
在此示例中,filter 表达式将搜索结果过滤为仅包含与指定术语keyword1 或keyword2 匹配的文档。随后,针对这一经过过滤的文档子集执行向量相似度搜索。
您可以通过配置文本高亮器,在搜索结果中突出显示匹配的术语。详情请参阅“文本高亮器”。
# Match entities with `keyword1` or `keyword2`
filter = "TEXT_MATCH(text, 'keyword1 keyword2')"

# Assuming 'embeddings' is the vector field and 'text' is the VARCHAR field
result = client.search(
    collection_name="my_collection", # Your collection name
    anns_field="embeddings", # Vector field name
    data=[query_vector], # Query vector
    filter=filter,
    search_params={"params": {"nprobe": 10}},
    limit=10, # Max. number of results to return
    output_fields=["id", "text"] # Fields to return
)
String filter = "TEXT_MATCH(text, 'keyword1 keyword2')";

SearchResp searchResp = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .annsField("embeddings")
        .data(Collections.singletonList(queryVector)))
        .filter(filter)
        .topK(10)
        .outputFields(Arrays.asList("id", "text"))
        .build());
filter := "TEXT_MATCH(text, 'keyword1 keyword2')"

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    10,               // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("embeddings").
    WithFilter(filter).
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
// Match entities with `keyword1` or `keyword2`
const filter = "TEXT_MATCH(text, 'keyword1 keyword2')";

// Assuming 'embeddings' is the vector field and 'text' is the VARCHAR field
const result = await client.search(
    collection_name: "my_collection", // Your collection name
    anns_field: "embeddings", // Vector field name
    data: [query_vector], // Query vector
    filter: filter,
    params: {"nprobe": 10},
    limit: 10, // Max. number of results to return
    output_fields: ["id", "text"] //Fields to return
);
export filter="\"TEXT_MATCH(text, 'keyword1 keyword2')\""

export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "annsField": "embeddings",
    "data": [[0.19886812562848388, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501, 0.838729485096104]],
    "filter": '"$filter"',
    "searchParams": {
        "params": {
            "nprobe": 10
        }
    },
    "limit": 10,
    "outputFields": ["text","id"]
}'
// Match entities with `keyword1` or `keyword2`
std::string filter = "TEXT_MATCH(text, 'keyword1 keyword2')";

// Assuming 'embeddings' is the vector field and 'text' is the VARCHAR field
auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .WithAnnsField("embeddings")
                   .AddFloatVector(query_vector)
                   .WithFilter(filter)
                   .AddExtraParam("nprobe", "10")
                   .WithLimit(10)
                   .AddOutputField("id")
                   .AddOutputField("text");

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
带文本匹配的查询
文本匹配也可用于查询操作中的标量过滤。通过在 `query() ` 方法的 `expr ` 参数中指定 `TEXT_MATCH ` 表达式,您可以检索与给定术语匹配的文档。
下面的示例检索text 字段同时包含keyword1 和keyword2 这两个术语的文档。
# Match entities with both `keyword1` and `keyword2`
filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')"

result = client.query(
    collection_name="my_collection",
    filter=filter,
    output_fields=["id", "text"]
)
String filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')";

QueryResp queryResp = client.query(QueryReq.builder()
        .collectionName("my_collection")
        .filter(filter)
        .outputFields(Arrays.asList("id", "text"))
        .build()
);
filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')"
resultSet, err := client.Query(ctx, milvusclient.NewQueryOption("my_collection").
    WithFilter(filter).
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
// Match entities with both `keyword1` and `keyword2`
const filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')";

const result = await client.query(
    collection_name: "my_collection",
    filter: filter,
    output_fields: ["id", "text"]
)
export filter="\"TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')\""

export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/query" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "filter": '"$filter"',
    "outputFields": ["id", "text"]
}'
// Match entities with both `keyword1` and `keyword2`
std::string filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')";

auto request = milvus::QueryRequest()
                   .WithCollectionName("my_collection")
                   .WithFilter(filter)
                   .AddOutputField("id")
                   .AddOutputField("text");

milvus::QueryResponse response;
auto status = client->Query(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
注意事项
为字段启用术语匹配会触发倒排索引的创建,这会消耗存储资源。在决定是否启用此功能时,请考虑其对存储的影响,因为该影响会因文本大小、唯一词元以及所使用的分析器而异。
在 Schema 中定义分析器后,其设置将对该 Collection 永久生效。若您认为其他分析器更能满足需求,可考虑删除现有 Collection,并使用所需的分析器配置创建新 Collection。
filter表达式中的转义规则:表达式中用双引号或单引号括起的字符将被解释为字符串常量。如果字符串常量包含转义字符,则必须使用转义序列来表示这些转义字符。例如,使用
\\表示\,使用\\t表示制表符\t,使用\\n表示换行符。如果字符串常量由单引号包围,则常量内的单引号应表示为
\\',而双引号可以表示为"或\\"。示例:'It\\'s milvus'。如果字符串常量由双引号包围,则常量中的双引号应表示为
\\",而单引号可以表示为'或\\'。示例:"He said \\"Hi\\""。
