

文字匹配
Milvus 中的文字比對功能可根據特定術語進行精確的文件檢索。此功能主要用於篩選搜尋以滿足特定條件,並可整合標量篩選來精確化查詢結果,從而允許在符合標量標準的向量內進行相似度搜尋。
TEXT_MATCH 可搜尋完全相符的已分析術語,而「TEXT_MATCH_FUZZY 」則能容許查詢標記與索引標記之間存在微小的編輯距離。兩者皆屬布林篩選操作,且不會對匹配文件的相關性進行評分。若您希望根據查詢術語的語義含義與重要性來檢索最相關的文件,我們建議您使用「全文搜尋」。
概述
Milvus 整合了Tantivy,以驅動其底層的反向索引及基於術語的文字搜尋功能。對於每筆文字輸入,Milvus 會依照以下程序進行索引:
分析器:分析器會將輸入的文字切分成單詞(或稱詞元),並根據需要套用過濾器。這使 Milvus 能基於這些詞元建立索引。
建立索引:完成文字分析後,Milvus 會建立一個倒排索引,將每個唯一的詞元映射至包含該詞元的文件。
當使用者執行文字比對時,系統會利用倒排索引快速檢索所有包含該術語的文件。此方法遠比逐一掃描每份文件來得迅速。
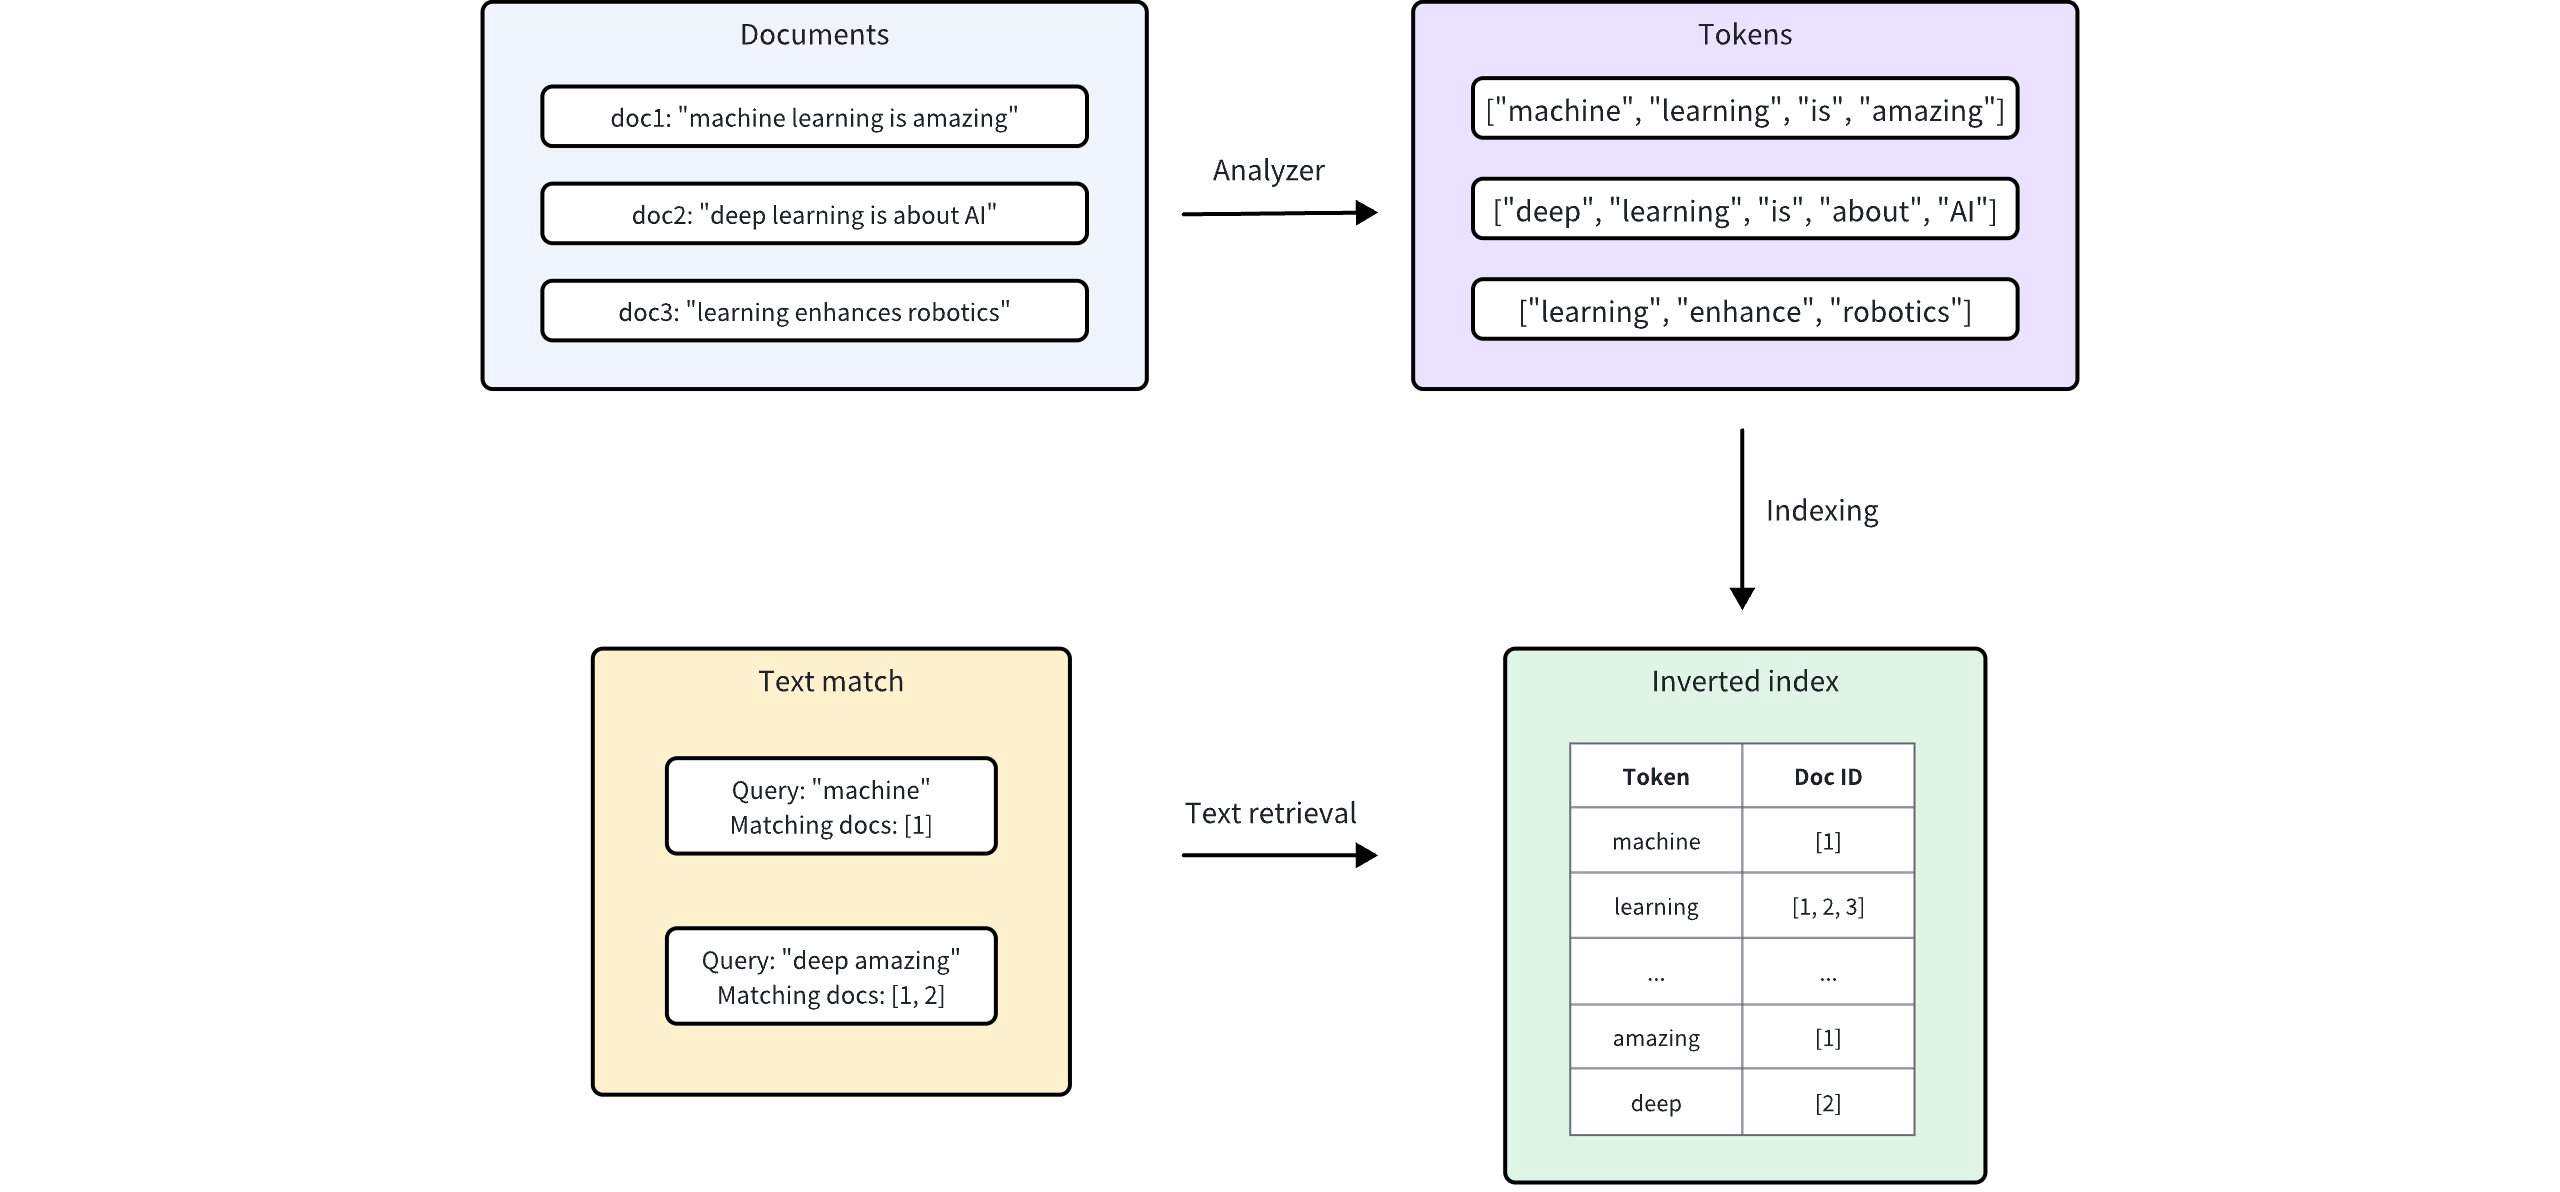 關鍵字比對
啟用文字比對
文字比對功能適用於已啟用比對功能的字串欄位。本頁的範例使用 VARCHAR,該字段在所有客戶端 SDK 中均受支援。在 Milvus 3.0.x 中, TEXT 當啟用 Storage V3 時,字段亦支援文字比對。無論使用何種字段類型,請將 `enable_analyzer ` 與 `enable_match ` 皆設定為 `True`,並可在定義集合架構時選擇性地配置分析器。
設定enable_analyzer 和enable_match
若要為特定的VARCHAR 欄位啟用文字比對功能,請在定義欄位架構時,將enable_analyzer 與enable_match 兩項參數皆設定為True 。此設定會指示 Milvus 將文字進行分詞,並為指定欄位建立倒排索引,從而實現快速且高效的文字比對。
from pymilvus import MilvusClient, DataType

schema = MilvusClient.create_schema(enable_dynamic_field=False)
schema.add_field(
    field_name="id",
    datatype=DataType.INT64,
    is_primary=True,
    auto_id=True
)
schema.add_field(
    field_name='text',
    datatype=DataType.VARCHAR,
    max_length=1000,
    enable_analyzer=True, # Whether to enable text analysis for this field
    enable_match=True # Whether to enable text match
)
schema.add_field(
    field_name="embeddings",
    datatype=DataType.FLOAT_VECTOR,
    dim=5
)
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .enableDynamicField(false)
        .build();
schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .enableMatch(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("embeddings")
        .dataType(DataType.FloatVector)
        .dimension(5)
        .build());
import "github.com/milvus-io/milvus/client/v2/entity"

schema := entity.NewSchema().WithDynamicFieldEnabled(false)
schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(true),
).WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithEnableMatch(true).
    WithMaxLength(1000),
).WithField(entity.NewField().
    WithName("embeddings").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(5),
)
const schema = [
  {
    name: "id",
    data_type: DataType.Int64,
    is_primary_key: true,
  },
  {
    name: "text",
    data_type: "VarChar",
    enable_analyzer: true,
    enable_match: true,
    max_length: 1000,
  },
  {
    name: "embeddings",
    data_type: DataType.FloatVector,
    dim: 5,
  },
];
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true,
                    "enable_match": true
                }
            },
            {
                "fieldName": "embeddings",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "5"
                }
            }
        ]
    }'
milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->SetEnableDynamicField(false);
schema->AddField({"id", milvus::DataType::INT64, "", true, true});
schema->AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR).WithMaxLength(1000).EnableAnalyzer(true).EnableMatch(true));
schema->AddField(milvus::FieldSchema("embeddings", milvus::DataType::FLOAT_VECTOR).WithDimension(5));
可選:設定分析器
關鍵字匹配的效能與準確度取決於所選的分析器。不同的分析器針對各種語言和文字結構進行了優化,因此選擇合適的分析器將對您特定使用情境的搜尋結果產生顯著影響。
預設情況下,Milvus 使用standard 分析器,該分析器會根據空白字元和標點符號將文字分詞,移除長度超過 40 個字元的詞元,並將文字轉換為小寫。套用此預設設定無需額外參數。如需更多資訊,請參閱「標準」。
若需使用其他分析器,可透過 `analyzer_params ` 參數進行設定。例如,若要套用 `english ` 分析器來處理英文文本:
analyzer_params = {
    "type": "english"
}
schema.add_field(
    field_name='text',
    datatype=DataType.VARCHAR,
    max_length=200,
    enable_analyzer=True,
    analyzer_params = analyzer_params,
    enable_match = True,
)
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("type", "english");
schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(200)
        .enableAnalyzer(true)
        .analyzerParams(analyzerParams)
        .enableMatch(true)
        .build());
analyzerParams := map[string]any{"type": "english"}
schema.WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithEnableMatch(true).
    WithAnalyzerParams(analyzerParams).
    WithMaxLength(200),
)
const schema = [
  {
    name: "id",
    data_type: DataType.Int64,
    is_primary_key: true,
  },
  {
    name: "text",
    data_type: "VarChar",
    enable_analyzer: true,
    enable_match: true,
    max_length: 1000,
    analyzer_params: { type: 'english' },
  },
  {
    name: "embeddings",
    data_type: DataType.FloatVector,
    dim: 5,
  },
];
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 200,
                    "enable_analyzer": true,
                    "enable_match": true,
                    "analyzer_params": {"type": "english"}
                }
            },
            {
                "fieldName": "embeddings",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "5"
                }
            }
        ]
    }'
nlohmann::json analyzer_params = {{"type", "english"}};
schema->AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR).WithMaxLength(200).EnableAnalyzer(true).WithAnalyzerParams(analyzer_params).EnableMatch(true));
Milvus 亦提供多種適用於不同語言與情境的分析器。如需更多詳細資訊,請參閱《分析器概覽》。
使用文字比對
在您的集合架構中為 `VARCHAR ` 或 `TEXT ` 欄位啟用文字比對功能後,即可使用 `TEXT_MATCH ` 表達式執行文字比對。
TEXT_MATCH 表達式語法
TEXT_MATCH 表達式用於指定要搜尋的欄位及搜尋詞。其語法如下:
TEXT_MATCH(field_name, text)
std::string filter = "TEXT_MATCH(field_name, text)";
export filter="\"TEXT_MATCH(field_name, text)\""
field_name: 需進行搜尋的、已啟用比對功能的VARCHAR或TEXT欄位名稱。text: 要搜尋的術語。多個術語可使用空格分隔,或根據語言及已配置的分析器使用其他適當的分隔符。
預設情況下,TEXT_MATCH 會採用「或 (OR)」匹配邏輯,這表示它會回傳包含任何指定搜尋詞的文件。例如,若要在text 欄位中搜尋包含machine 或deep 其中任一搜尋詞的文件,請使用以下表達式:
filter = "TEXT_MATCH(text, 'machine deep')"
String filter = "TEXT_MATCH(text, 'machine deep')";
filter := "TEXT_MATCH(text, 'machine deep')"
const filter = "TEXT_MATCH(text, 'machine deep')";
export filter="\"TEXT_MATCH(text, 'machine deep')\""
std::string filter = "TEXT_MATCH(text, 'machine deep')";
您也可以使用邏輯運算子組合多個TEXT_MATCH 表達式,以執行「AND」匹配。
若要搜尋在「
text」欄位中同時包含「machine」和「deep」的文件,請使用以下表達式:filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')"String filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')";filter := "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')"const filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')"export filter="\"TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')\""std::string filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')";若要搜尋在
text欄位中同時包含machine和learning,但不包含deep的文件,請使用以下表達式:filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')"String filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')";filter := "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')"const filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')";export filter="\"not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')\""std::string filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')";
TEXT_MATCH_FUZZY 表達式語法Compatible with Milvus 3.0.0+
使用 `TEXT_MATCH_FUZZY ` 可容許查詢標記與索引標記之間的拼寫差異。Milvus 會使用該欄位的分析器來分析查詢文字,並對每個產生的標記套用模糊匹配。若查詢產生多個標記,當任何一個標記符合設定的編輯距離時,該表達式即會匹配該實體。
語法如下:
TEXT_MATCH_FUZZY(field_name, text, max_edit_distance = 1)
std::string filter = "TEXT_MATCH_FUZZY(field_name, text, max_edit_distance = 1)";
export filter="\"TEXT_MATCH_FUZZY(field_name, text, max_edit_distance = 1)\""
field_name: 需搜尋的、已啟用匹配功能的 `VARCHAR` 或 `TEXT` 欄位名稱。text: 需進行分析並與索引標記進行比對的查詢文字。max_edit_distance: 每個查詢標記允許的最大編輯距離。此選項名稱必須精確為max_edit_distance,其值必須為0、1或2。若值為0,則執行精確標記比對,等同於TEXT_MATCH。
例如,以下表達式會匹配與machne 僅相差一個編輯操作的標記,包括machine :
filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)"
String filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)";
filter := "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)"
const filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)";
export filter="\"TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)\""
std::string filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)";
TEXT_MATCH_FUZZY 屬於篩選表達式語法的一部分,因此客戶端 SDK 無需提供專用的模糊匹配方法。請在搜尋或查詢操作中,透過與TEXT_MATCH 相同的filter 參數傳遞該表達式。
使用文字匹配進行搜尋
文字比對可與向量相似度搜尋結合使用,以縮小搜尋範圍並提升搜尋效能。透過在執行向量相似度搜尋前,先使用文字比對對集合進行篩選,可減少需搜尋的文件數量,從而加快查詢速度。
在此範例中,filter 表達式會篩選搜尋結果,僅包含與指定詞彙keyword1 或keyword2 相符的文件。隨後,系統會針對這組已篩選的文件子集執行向量相似度搜尋。
您可以透過配置文字高亮顯示功能,在搜尋結果中標示出匹配的關鍵字。詳情請參閱「文字高亮顯示功能」。
# Match entities with `keyword1` or `keyword2`
filter = "TEXT_MATCH(text, 'keyword1 keyword2')"

# Assuming 'embeddings' is the vector field and 'text' is the VARCHAR field
result = client.search(
    collection_name="my_collection", # Your collection name
    anns_field="embeddings", # Vector field name
    data=[query_vector], # Query vector
    filter=filter,
    search_params={"params": {"nprobe": 10}},
    limit=10, # Max. number of results to return
    output_fields=["id", "text"] # Fields to return
)
String filter = "TEXT_MATCH(text, 'keyword1 keyword2')";

SearchResp searchResp = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .annsField("embeddings")
        .data(Collections.singletonList(queryVector)))
        .filter(filter)
        .topK(10)
        .outputFields(Arrays.asList("id", "text"))
        .build());
filter := "TEXT_MATCH(text, 'keyword1 keyword2')"

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    10,               // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("embeddings").
    WithFilter(filter).
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
// Match entities with `keyword1` or `keyword2`
const filter = "TEXT_MATCH(text, 'keyword1 keyword2')";

// Assuming 'embeddings' is the vector field and 'text' is the VARCHAR field
const result = await client.search(
    collection_name: "my_collection", // Your collection name
    anns_field: "embeddings", // Vector field name
    data: [query_vector], // Query vector
    filter: filter,
    params: {"nprobe": 10},
    limit: 10, // Max. number of results to return
    output_fields: ["id", "text"] //Fields to return
);
export filter="\"TEXT_MATCH(text, 'keyword1 keyword2')\""

export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "annsField": "embeddings",
    "data": [[0.19886812562848388, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501, 0.838729485096104]],
    "filter": '"$filter"',
    "searchParams": {
        "params": {
            "nprobe": 10
        }
    },
    "limit": 10,
    "outputFields": ["text","id"]
}'
// Match entities with `keyword1` or `keyword2`
std::string filter = "TEXT_MATCH(text, 'keyword1 keyword2')";

// Assuming 'embeddings' is the vector field and 'text' is the VARCHAR field
auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .WithAnnsField("embeddings")
                   .AddFloatVector(query_vector)
                   .WithFilter(filter)
                   .AddExtraParam("nprobe", "10")
                   .WithLimit(10)
                   .AddOutputField("id")
                   .AddOutputField("text");

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
使用文字匹配進行查詢
文字匹配亦可用於查詢操作中的標量過濾。透過在query() 方法的expr 參數中指定TEXT_MATCH 表達式,即可擷取與指定詞彙相符的文件。
以下範例會檢索text 欄位同時包含keyword1 和keyword2 這兩項術語的文件。
# Match entities with both `keyword1` and `keyword2`
filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')"

result = client.query(
    collection_name="my_collection",
    filter=filter,
    output_fields=["id", "text"]
)
String filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')";

QueryResp queryResp = client.query(QueryReq.builder()
        .collectionName("my_collection")
        .filter(filter)
        .outputFields(Arrays.asList("id", "text"))
        .build()
);
filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')"
resultSet, err := client.Query(ctx, milvusclient.NewQueryOption("my_collection").
    WithFilter(filter).
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
// Match entities with both `keyword1` and `keyword2`
const filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')";

const result = await client.query(
    collection_name: "my_collection",
    filter: filter,
    output_fields: ["id", "text"]
)
export filter="\"TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')\""

export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/query" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "filter": '"$filter"',
    "outputFields": ["id", "text"]
}'
// Match entities with both `keyword1` and `keyword2`
std::string filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')";

auto request = milvus::QueryRequest()
                   .WithCollectionName("my_collection")
                   .WithFilter(filter)
                   .AddOutputField("id")
                   .AddOutputField("text");

milvus::QueryResponse response;
auto status = client->Query(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
注意事項
為某個欄位啟用術語匹配功能會觸發建立倒排索引,這會消耗儲存資源。在決定是否啟用此功能時,請考量其對儲存空間的影響,因為這會因文字大小、唯一詞元以及所使用的分析器而異。
一旦在資料結構中定義了分析器,其設定即對該集合永久生效。若您認為其他分析器更能滿足需求,可考慮刪除現有集合,並使用所需的分析器設定建立新的集合。
filter表達式中的轉義規則:在表達式中,以雙引號或單引號包圍的字元將被解釋為字串常數。若字串常數包含轉義字元,則必須使用轉義序列來表示該轉義字元。例如,使用
\\來表示\,使用\\t來表示制表符\t,以及使用\\n來表示換行符。若字串常數以單引號包圍,則常數內的單引號應以
\\'表示,而雙引號則可使用"或\\"表示。範例:'It\\'s milvus'。若字串常數以雙引號包圍,則常數內的雙引號應表示為
\\",而單引號則可表示為'或\\'。範例:"He said \\"Hi\\""。
