

Совпадение по фразеCompatible with Milvus 2.5.17+
Поиск по фразе позволяет находить документы, содержащие термины запроса в виде точной фразы. По умолчанию слова должны встречаться в том же порядке и непосредственно рядом друг с другом. Например, запрос «робототехника машинное обучение» найдет текст типа «…типичные модели машинного обучения в робототехнике…», где слова «робототехника», «машинное» и «обучение» идут последовательно, без других слов между ними.
Однако в реальных сценариях строгое фразное сопоставление может быть слишком жестким. Возможно, вам нужно найти текст типа «…модели машинного обучения, широко применяемые в робототехнике…». Здесь присутствуют те же ключевые слова, но они не расположены рядом и не в исходном порядке. Для решения этой проблемы фразное сопоставление поддерживает параметр « slop », который обеспечивает гибкость. Значение параметра « slop » определяет, сколько позиционных сдвигов допускается между терминами в фразе. Например, если значение параметра « slop » равно 1, запрос «machine learning» может сопоставляться с текстом типа «…machine deep learning…», где одно слово («deep») разделяет исходные термины.
Обзор
Функция поиска по фразам, реализованная с помощью библиотеки поисковой системы Tantivy, работает за счёт анализа информации о положении слов в документах. На приведённой ниже схеме показан этот процесс:
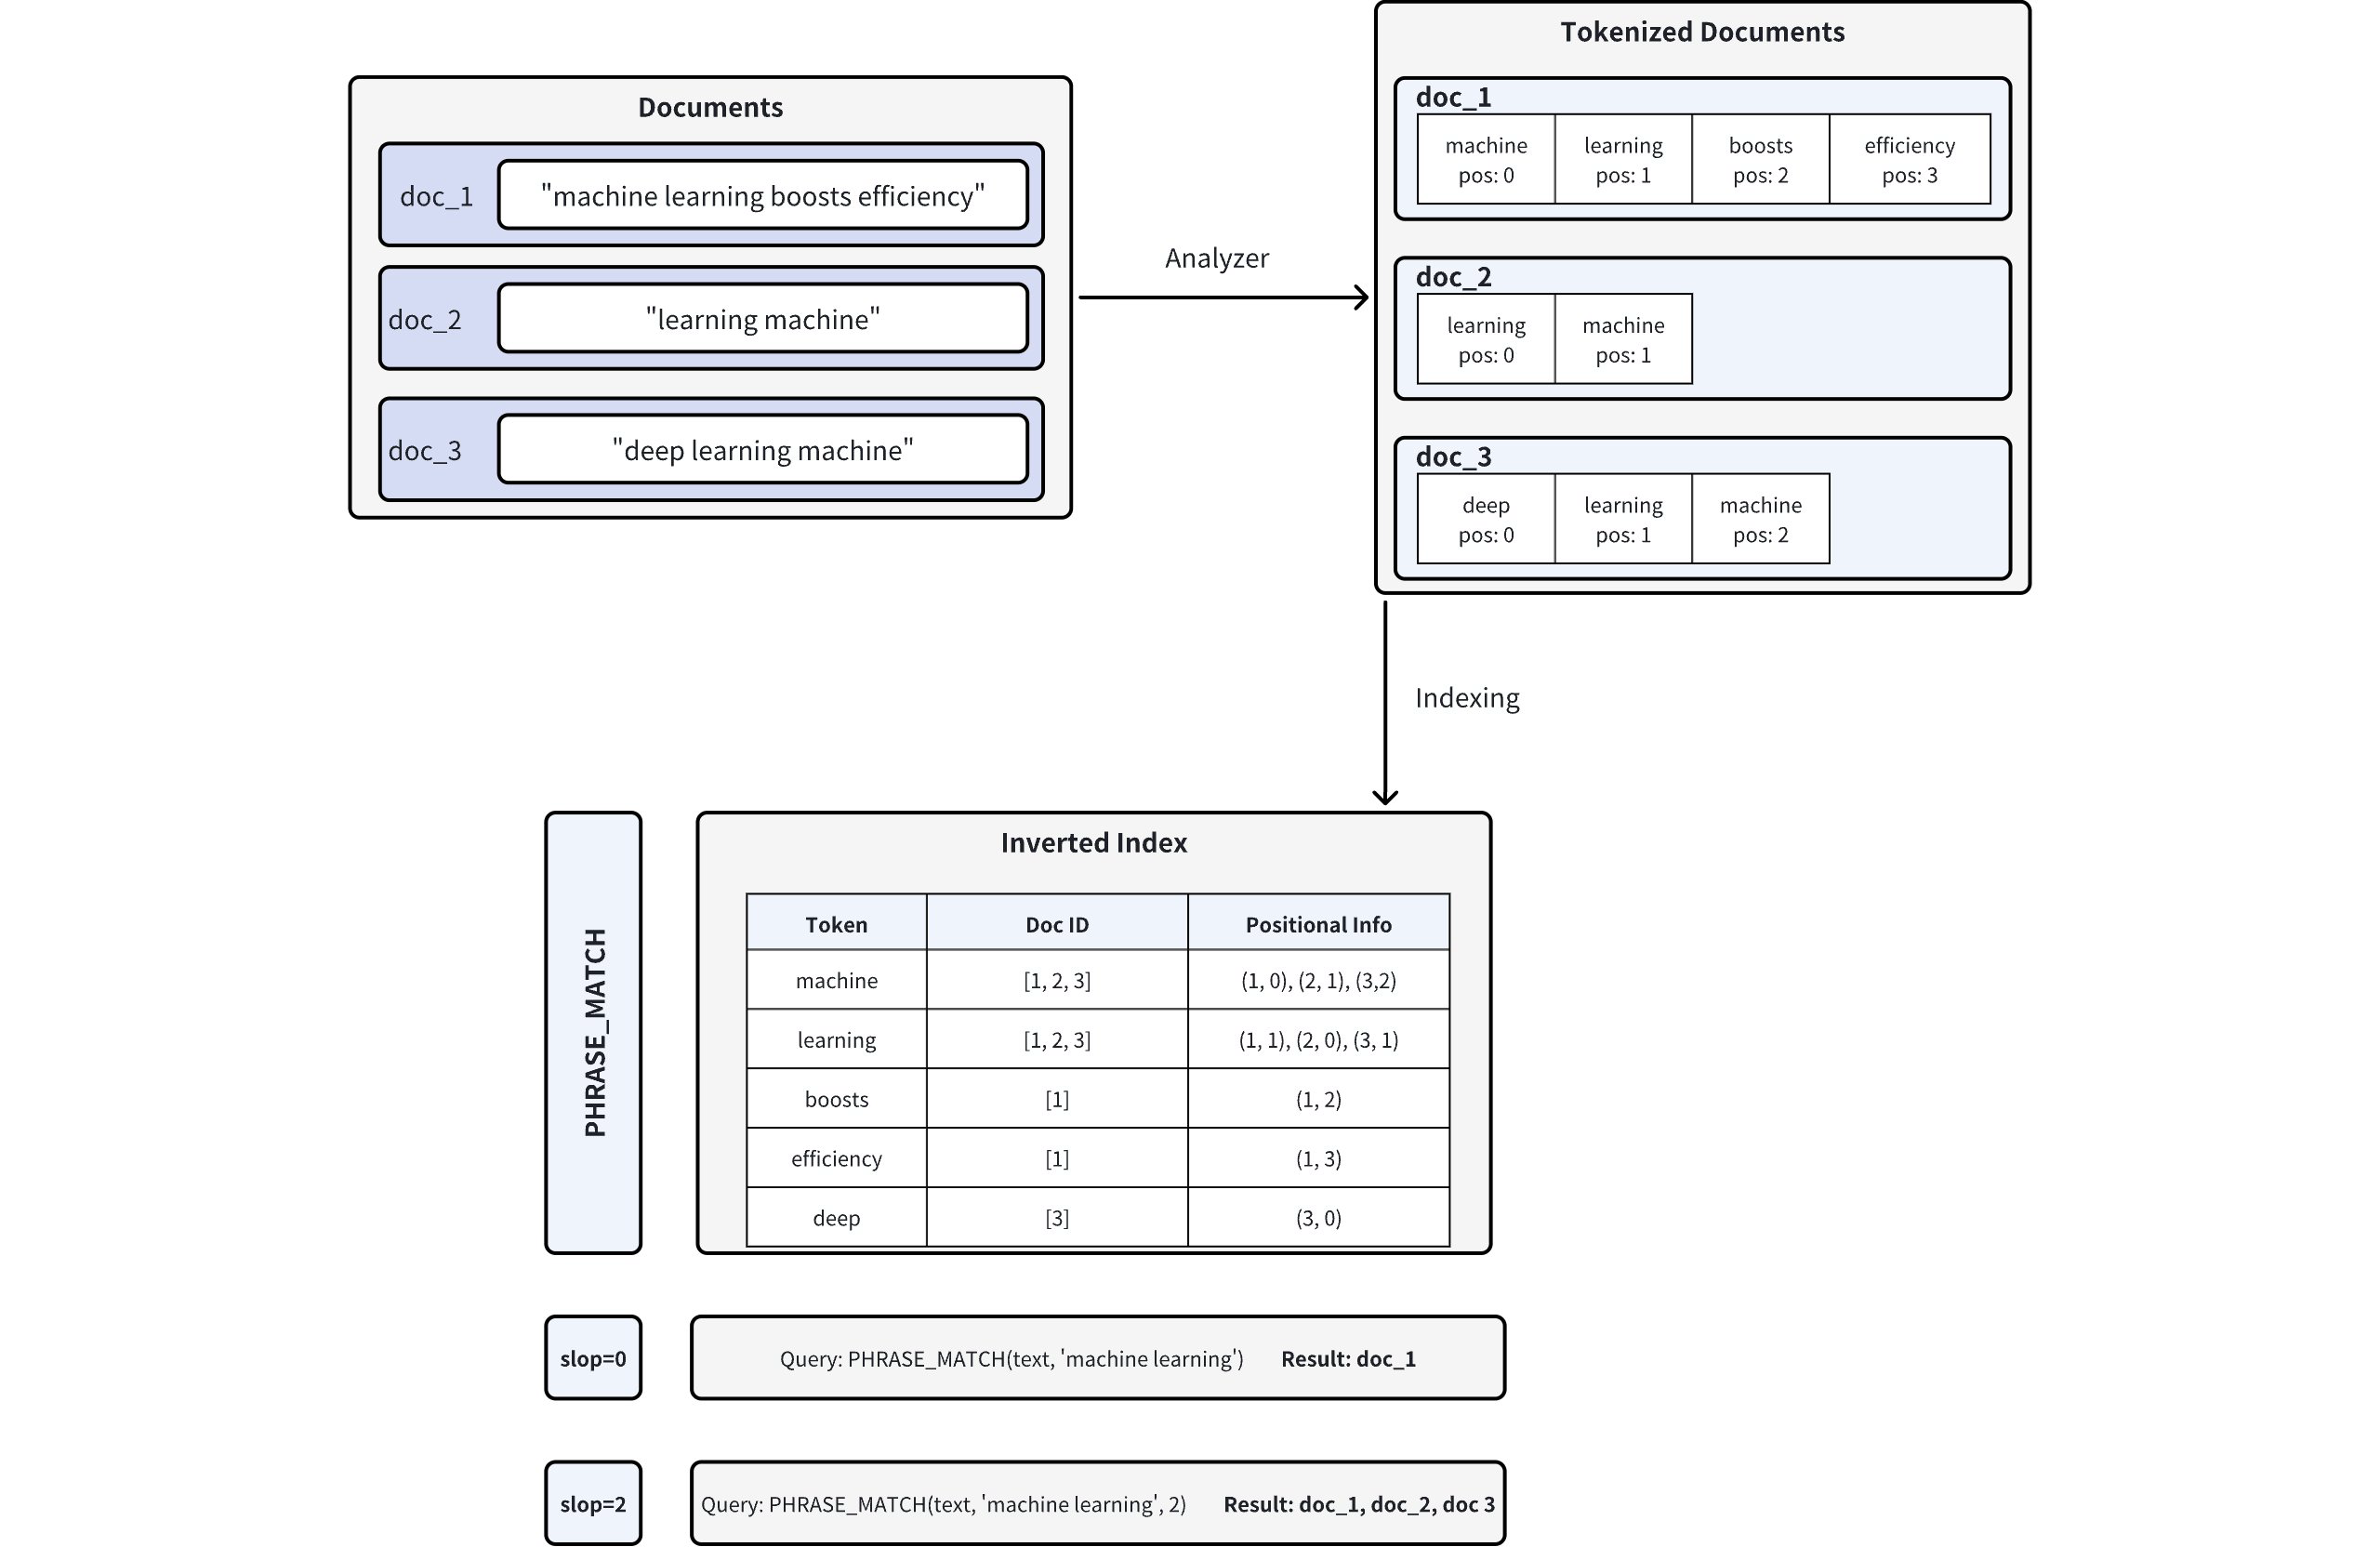 Рабочий процесс поиска по фразам
Токенизация документа: при загрузке документов в Milvus текст разбивается на токены (отдельные слова или термины) с помощью анализатора, при этом для каждого токена фиксируется информация о его позиции. Например, doc_1 токенизируется в [«machine» (pos=0), «learning» (pos=1), «boosts» (pos=2), «efficiency» (pos=3)]. Для получения дополнительной информации об анализаторах см. раздел «Обзор анализаторов».
Создание инвертированного индекса: Milvus создаёт инвертированный индекс, сопоставляя каждый токен с документом (документами), в котором он встречается, и с позициями этого токена в этих документах.
Сопоставление фраз: при выполнении фразового запроса Milvus ищет каждый токен в инвертированном индексе и проверяет их позиции, чтобы определить, появляются ли они в правильном порядке и на нужном расстоянии друг от друга. Параметр «
slop» контролирует максимальное количество позиций, допустимое между совпадающими токенами:slop = 0 означает, что токены должны встречаться в точном порядке и непосредственно рядом друг с другом (т. е. без лишних слов между ними).
- В примере точно соответствует только doc_1 («machine» в позиции 0, «learning» в позиции 1).
slop = 2 допускает до двух позиций гибкости или перестановки между совпадающими токенами.
Это допускает обратный порядок («learning machine») или небольшой промежуток между токенами.
Следовательно, совпадают doc_1, doc_2 («learning» в позиции 0, «machine» в позиции 1) и doc_3 («learning» в позиции 1, «machine» в позиции 2).
Включение фразового сопоставления
Фразовое сопоставление работает с типом поля « VARCHAR » — типом данных «string» в Milvus. Чтобы включить фразовое сопоставление, настройте схему коллекции, установив для параметров « enable_analyzer » и « enable_match » значение « True », аналогично текстовому сопоставлению.
Установите значения enable_analyzer и enable_match
Чтобы включить поиск по фразам для конкретного поля VARCHAR, при определении схемы поля установите для обоих параметров enable_analyzer и enable_match значение True. Эта настройка указывает Milvus на необходимость токенизации текста и создания инвертированного индекса с позиционной информацией, необходимой для эффективного поиска по фразам.
Ниже приведён пример определения схемы, позволяющий включить сопоставление фраз:
from pymilvus import MilvusClient, DataType

# Create a schema for a new collection
schema = MilvusClient.create_schema(enable_dynamic_field=False)
schema.add_field(
    field_name="id",
    datatype=DataType.INT64,
    is_primary=True,
    auto_id=True
)
# Add a VARCHAR field configured for phrase matching
schema.add_field(
    field_name='text',                 # Name of the field
    datatype=DataType.VARCHAR,         # Field data type set as VARCHAR (string)
    max_length=1000,                   # Maximum length of the string
    enable_analyzer=True,              # Enables text analysis (tokenization)
    enable_match=True                  # Enables inverted indexing for phrase matching
)
schema.add_field(
    field_name="embeddings",
    datatype=DataType.FLOAT_VECTOR,
    dim=5
)
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

// Create a schema for a new collection
CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .enableDynamicField(false)
        .build();
schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());
// Add a VARCHAR field configured for phrase matching
schema.addField(AddFieldReq.builder()
        .fieldName("text")              // Name of the field
        .dataType(DataType.VarChar)     // Field data type set as VARCHAR (string)
        .maxLength(1000)                // Maximum length of the string
        .enableAnalyzer(true)           // Enables text analysis (tokenization)
        .enableMatch(true)              // Enables inverted indexing for phrase matching
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("embeddings")
        .dataType(DataType.FloatVector)
        .dimension(5)
        .build());
import "github.com/milvus-io/milvus/client/v2/entity"

// Create a schema for a new collection
schema := entity.NewSchema().WithDynamicFieldEnabled(false)
schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(true),
).WithField(entity.NewField().
    WithName("text").                      // Name of the field
    WithDataType(entity.FieldTypeVarChar). // Field data type set as VARCHAR (string)
    WithMaxLength(1000).                   // Maximum length of the string
    WithEnableAnalyzer(true).              // Enables text analysis (tokenization)
    WithEnableMatch(true),                 // Enables inverted indexing for phrase matching
).WithField(entity.NewField().
    WithName("embeddings").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(5),
)
import { DataType } from "@zilliz/milvus2-sdk-node";

// Create a schema for a new collection
const schema = [
  {
    name: "id",
    data_type: DataType.Int64,
    is_primary_key: true,
    autoID: true,
  },
  // Add a VARCHAR field configured for phrase matching
  {
    name: "text", // Name of the field
    data_type: DataType.VarChar, // Field data type set as VARCHAR (string)
    max_length: 1000, // Maximum length of the string
    enable_analyzer: true, // Enables text analysis (tokenization)
    enable_match: true, // Enables inverted indexing for phrase matching
  },
  {
    name: "embeddings",
    data_type: DataType.FloatVector,
    dim: 5,
  },
];
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true,
                    "enable_match": true
                }
            },
            {
                "fieldName": "embeddings",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "5"
                }
            }
        ]
    }'
#include "milvus/types/CollectionSchema.h"

// Create a schema for a new collection
milvus::CollectionSchema schema("tech_articles");
schema.SetEnableDynamicField(false);
schema.AddField(milvus::FieldSchema("id", milvus::DataType::INT64, "", true, true));
// Add a VARCHAR field configured for phrase matching
schema.AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR)  // Name of the field
                    .WithMaxLength(1000)    // Maximum length of the string
                    .EnableAnalyzer(true)   // Enables text analysis (tokenization)
                    .EnableMatch(true));    // Enables inverted indexing for phrase matching
schema.AddField(milvus::FieldSchema("embeddings", milvus::DataType::FLOAT_VECTOR)
                    .WithDimension(5));
Необязательно: настройка анализатора
Точность сопоставления фраз в значительной степени зависит от анализатора, используемого для токенизации ваших текстовых данных. Различные анализаторы подходят для разных языков и форматов текста, что влияет на токенизацию и точность позиционного сопоставления. Выбор подходящего анализатора для вашего конкретного случая использования позволит оптимизировать результаты сопоставления фраз.
По умолчанию Milvus использует стандартный анализатор, который разбивает текст на токены на основе пробелов и знаков препинания, удаляет токены длиной более 40 символов и преобразует текст в нижний регистр. Для использования по умолчанию дополнительные параметры не требуются. Подробности см. в разделе «Стандартный анализатор ».
Если вашему приложению требуется конкретный анализатор, настройте его с помощью параметра ` analyzer_params `. Например, вот как настроить анализатор ` english ` для сопоставления фраз в тексте на английском языке:
# Define analyzer parameters for English-language tokenization
analyzer_params = {
    "type": "english"
}

# Add the VARCHAR field with the English analyzer enabled
schema.add_field(
    field_name='text',                 # Name of the field
    datatype=DataType.VARCHAR,         # Field data type set as VARCHAR
    max_length=1000,                   # Maximum length of the string
    enable_analyzer=True,              # Enables text analysis
    analyzer_params=analyzer_params,   # Specifies the analyzer configuration
    enable_match=True                  # Enables inverted indexing for phrase matching
)
// Define analyzer parameters for English-language tokenization
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("type", "english");

// Add the VARCHAR field with the English analyzer enabled
schema.addField(AddFieldReq.builder()
        .fieldName("text")              // Name of the field
        .dataType(DataType.VarChar)     // Field data type set as VARCHAR
        .maxLength(1000)                // Maximum length of the string
        .enableAnalyzer(true)           // Enables text analysis
        .analyzerParams(analyzerParams) // Specifies the analyzer configuration
        .enableMatch(true)              // Enables inverted indexing for phrase matching
        .build());
// Define analyzer parameters for English-language tokenization
analyzerParams := map[string]any{"type": "english"}

// Add the VARCHAR field with the English analyzer enabled
schema.WithField(entity.NewField().
    WithName("text").                      // Name of the field
    WithDataType(entity.FieldTypeVarChar). // Field data type set as VARCHAR
    WithMaxLength(1000).                   // Maximum length of the string
    WithEnableAnalyzer(true).              // Enables text analysis
    WithAnalyzerParams(analyzerParams).    // Specifies the analyzer configuration
    WithEnableMatch(true),                 // Enables inverted indexing for phrase matching
)
// Define analyzer parameters for English-language tokenization
const analyzer_params = { type: "english" };

// Add the VARCHAR field with the English analyzer enabled
const schema = [
  {
    name: "text", // Name of the field
    data_type: DataType.VarChar, // Field data type set as VARCHAR
    max_length: 1000, // Maximum length of the string
    enable_analyzer: true, // Enables text analysis
    analyzer_params: analyzer_params, // Specifies the analyzer configuration
    enable_match: true, // Enables inverted indexing for phrase matching
  },
];
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true,
                    "analyzer_params": {"type": "english"},
                    "enable_match": true
                }
            }
        ]
    }'
// Define analyzer parameters for English-language tokenization
nlohmann::json analyzer_params = {{"type", "english"}};

// Add the VARCHAR field with the English analyzer enabled
schema.AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR)  // Name of the field
                    .WithMaxLength(1000)                // Maximum length of the string
                    .EnableAnalyzer(true)               // Enables text analysis
                    .WithAnalyzerParams(analyzer_params) // Specifies the analyzer configuration
                    .EnableMatch(true));                // Enables inverted indexing for phrase matching
Milvus поддерживает несколько анализаторов, адаптированных для различных языков и сценариев использования. Подробную информацию см. в разделе «Обзор анализаторов».
Использование поиска по фразам
После включения сопоставления для поля VARCHAR в схеме коллекции можно выполнять сопоставление фраз с помощью выражения PHRASE_MATCH.
В выражении « PHRASE_MATCH » не учитывается регистр. Можно использовать как « PHRASE_MATCH », так и « phrase_match ».
Синтаксис выражения PHRASE_MATCH
Используйте выражение « PHRASE_MATCH » для указания поля, фразы и опциональной гибкости (slop) при поиске. Синтаксис следующий:
PHRASE_MATCH(field_name, phrase, slop)
PHRASE_MATCH(field_name, phrase, slop)
PHRASE_MATCH(field_name, phrase, slop)
PHRASE_MATCH(field_name, phrase, slop)
PHRASE_MATCH(field_name, phrase, slop)
PHRASE_MATCH(field_name, phrase, slop)
field_name: Имя поля «VARCHAR», по которому выполняется поиск по фразе.phrase: Точная фраза, которую нужно найти.slop(необязательно): Целое число, указывающее максимальное количество позиций, допускаемых в совпадающих токенах.0(по умолчанию): Соответствует только точным фразам. Пример: Фильтр для «machine learning» будет соответствовать именно «machine learning», но не «machine boosts learning» или «learning machine».1: Допускает незначительные вариации, такие как один дополнительный термин или небольшое смещение позиции. Пример: фильтр для «machine learning» найдет совпадение с «machine boosts learning» (один токен между «machine» и «learning»), но не с «learning machine» (термины в обратном порядке).2: Допускает большую гибкость, включая обратный порядок терминов или до двух токенов между ними. Пример: Фильтр по запросу «machine learning» будет находить совпадения с «learning machine» (термины в обратном порядке) или «machine quickly boosts learning» (два токена между «machine» и «learning»).
Пример набора данных
Предположим, у вас есть коллекция с именем tech_articles, содержащая следующие пять сущностей:
|
|
|---|---|
1 |
«Машинное обучение повышает эффективность анализа больших массивов данных» |
2 |
«Освоение машинного подхода имеет жизненно важное значение для прогресса современного искусственного интеллекта» |
3 |
«Архитектуры систем глубокого обучения оптимизируют вычислительную нагрузку» |
4 |
«Машина быстро улучшает производительность модели для непрерывного обучения» |
5 |
«Обучение сложным алгоритмам расширяет возможности ИИ» |
Запрос с сопоставлением фразы
При использовании метода query() параметр PHRASE_MATCH действует как скалярный фильтр. Возвращаются только те документы, которые содержат указанную фразу (с учетом допустимого отклонения).
Пример: slop = 0 (точное совпадение)
В этом примере возвращаются документы, содержащие точную фразу «machine learning» без каких-либо дополнительных токенов между словами.
# Match documents containing exactly "machine learning"
filter = "PHRASE_MATCH(text, 'machine learning')"

result = client.query(
    collection_name="tech_articles",
    filter=filter,
    output_fields=["id", "text"]
)
// Match documents containing exactly "machine learning"
String filter = "PHRASE_MATCH(text, 'machine learning')";

QueryResp queryResp = client.query(QueryReq.builder()
        .collectionName("tech_articles")
        .filter(filter)
        .outputFields(Arrays.asList("id", "text"))
        .build());
// Match documents containing exactly "machine learning"
filter := "PHRASE_MATCH(text, 'machine learning')"

resultSet, err := client.Query(ctx, milvusclient.NewQueryOption("tech_articles").
    WithFilter(filter).
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
// Match documents containing exactly "machine learning"
const filter = "PHRASE_MATCH(text, 'machine learning')";

const result = await client.query({
    collection_name: "tech_articles",
    filter: filter,
    output_fields: ["id", "text"],
});
export filter="\"PHRASE_MATCH(text, 'machine learning')\""

export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/query" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "tech_articles",
    "filter": '"$filter"',
    "outputFields": ["id", "text"]
}'
// Match documents containing exactly "machine learning"
milvus::QueryResponse response;
auto status = client->Query(milvus::QueryRequest()
                                .WithCollectionName("tech_articles")
                                .WithFilter("PHRASE_MATCH(text, 'machine learning')")
                                .AddOutputField("id")
                                .AddOutputField("text"),
                            response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
Ожидаемые результаты поиска:
|
|
|---|---|
1 |
«Машинное обучение повышает эффективность анализа больших массивов данных» |
Только документ 1 содержит точную фразу «machine learning» в указанном порядке без дополнительных токенов.
Поиск с помощью фразового сопоставления
В поисковых операциях PHRASE_MATCH используется для фильтрации документов перед применением ранжирования по векторному сходству. Этот двухэтапный подход сначала сужает набор кандидатов с помощью текстового сопоставления, а затем заново ранжирует этих кандидатов на основе векторных вложений.
Пример: slop = 1
Здесь мы допускаем погрешность (slop) равную 1. Фильтр применяется к документам, содержащим фразу «learning machine», с небольшой гибкостью.
# Example: Filter documents containing "learning machine" with slop=1
filter_slop1 = "PHRASE_MATCH(text, 'learning machine', 1)"

result_slop1 = client.search(
    collection_name="tech_articles",
    anns_field="embeddings",
    data=[query_vector],
    filter=filter_slop1,
    search_params={"params": {"nprobe": 10}},
    limit=10,
    output_fields=["id", "text"]
)
// Example: Filter documents containing "learning machine" with slop=1
String filter = "PHRASE_MATCH(text, 'learning machine', 1)";

Map<String, Object> searchParams = new HashMap<>();
searchParams.put("nprobe", 10);

SearchResp searchResp = client.search(SearchReq.builder()
        .collectionName("tech_articles")
        .annsField("embeddings")
        .data(Collections.singletonList(queryVector))
        .filter(filter)
        .searchParams(searchParams)
        .topK(10)
        .outputFields(Arrays.asList("id", "text"))
        .build());
// Example: Filter documents containing "learning machine" with slop=1
filter := "PHRASE_MATCH(text, 'learning machine', 1)"

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "tech_articles", // collectionName
    10,              // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("embeddings").
    WithFilter(filter).
    WithSearchParam("nprobe", "10").
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
// Example: Filter documents containing "learning machine" with slop=1
const filter = "PHRASE_MATCH(text, 'learning machine', 1)";

const result = await client.search({
    collection_name: "tech_articles",
    anns_field: "embeddings",
    data: [query_vector],
    filter: filter,
    params: { nprobe: 10 },
    limit: 10,
    output_fields: ["id", "text"],
});
export filter="\"PHRASE_MATCH(text, 'learning machine', 1)\""

export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "tech_articles",
    "annsField": "embeddings",
    "data": [[0.19886812562848388, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501, 0.838729485096104]],
    "filter": '"$filter"',
    "searchParams": {
        "params": {
            "nprobe": 10
        }
    },
    "limit": 10,
    "outputFields": ["id", "text"]
}'
// Example: Filter documents containing "learning machine" with slop=1
milvus::SearchResponse response;
auto status = client->Search(milvus::SearchRequest()
                                 .WithCollectionName("tech_articles")
                                 .WithAnnsField("embeddings")
                                 .AddFloatVector(query_vector)
                                 .WithFilter("PHRASE_MATCH(text, 'learning machine', 1)")
                                 .AddExtraParam("nprobe", "10")
                                 .WithLimit(10)
                                 .AddOutputField("id")
                                 .AddOutputField("text"),
                             response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
Результаты сопоставления:
|
|
|---|---|
2 |
«Изучение машинного подхода имеет жизненно важное значение для прогресса современного ИИ» |
3 |
«Архитектуры систем глубокого обучения оптимизируют вычислительную нагрузку» |
5 |
«Освоение передовых алгоритмов машинного обучения расширяет возможности искусственного интеллекта» |
Пример: slop = 2
В этом примере допускается отклонение 2, что означает, что между словами «machine» и «learning» допускается до двух дополнительных токенов (или терминов в обратном порядке) .
# Example: Filter documents containing "machine learning" with slop=2
filter_slop2 = "PHRASE_MATCH(text, 'machine learning', 2)"

result_slop2 = client.search(
    collection_name="tech_articles",
    anns_field="embeddings",             # Vector field name
    data=[query_vector],                 # Query vector
    filter=filter_slop2,                 # Filter expression
    search_params={"params": {"nprobe": 10}},
    limit=10,                            # Maximum results to return
    output_fields=["id", "text"]
)
// Example: Filter documents containing "machine learning" with slop=2
String filter = "PHRASE_MATCH(text, 'machine learning', 2)";

Map<String, Object> searchParams = new HashMap<>();
searchParams.put("nprobe", 10);

SearchResp searchResp = client.search(SearchReq.builder()
        .collectionName("tech_articles")
        .annsField("embeddings")            // Vector field name
        .data(Collections.singletonList(queryVector)) // Query vector
        .filter(filter)                     // Filter expression
        .searchParams(searchParams)
        .topK(10)                           // Maximum results to return
        .outputFields(Arrays.asList("id", "text"))
        .build());
// Example: Filter documents containing "machine learning" with slop=2
filter := "PHRASE_MATCH(text, 'machine learning', 2)"

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "tech_articles", // collectionName
    10,              // limit, maximum results to return
    []entity.Vector{entity.FloatVector(queryVector)}, // query vector
).WithANNSField("embeddings"). // vector field name
    WithFilter(filter).        // filter expression
    WithSearchParam("nprobe", "10").
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
// Example: Filter documents containing "machine learning" with slop=2
const filter = "PHRASE_MATCH(text, 'machine learning', 2)";

const result = await client.search({
    collection_name: "tech_articles",
    anns_field: "embeddings", // Vector field name
    data: [query_vector], // Query vector
    filter: filter, // Filter expression
    params: { nprobe: 10 },
    limit: 10, // Maximum results to return
    output_fields: ["id", "text"],
});
export filter="\"PHRASE_MATCH(text, 'machine learning', 2)\""

export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "tech_articles",
    "annsField": "embeddings",
    "data": [[0.19886812562848388, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501, 0.838729485096104]],
    "filter": '"$filter"',
    "searchParams": {
        "params": {
            "nprobe": 10
        }
    },
    "limit": 10,
    "outputFields": ["id", "text"]
}'
// Example: Filter documents containing "machine learning" with slop=2
milvus::SearchResponse response;
auto status = client->Search(milvus::SearchRequest()
                                 .WithCollectionName("tech_articles")
                                 .WithAnnsField("embeddings") // Vector field name
                                 .AddFloatVector(query_vector) // Query vector
                                 .WithFilter("PHRASE_MATCH(text, 'machine learning', 2)") // Filter expression
                                 .AddExtraParam("nprobe", "10")
                                 .WithLimit(10) // Maximum results to return
                                 .AddOutputField("id")
                                 .AddOutputField("text"),
                             response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
Результаты поиска:
|
|
|---|---|
1 |
«Машинное обучение повышает эффективность анализа больших массивов данных» |
3 |
«Архитектуры систем глубокого обучения оптимизируют вычислительную нагрузку» |
Пример: slop = 3
В этом примере значение slop, равное 3, обеспечивает ещё большую гибкость. Фильтр ищет фразу «machine learning», при этом между словами допускается до трёх позиций токенов.
# Example: Filter documents containing "machine learning" with slop=3
filter_slop3 = "PHRASE_MATCH(text, 'machine learning', 3)"

result_slop2 = client.search(
    collection_name="tech_articles",
    anns_field="embeddings",             # Vector field name
    data=[query_vector],                 # Query vector
    filter=filter_slop3,                 # Filter expression
    search_params={"params": {"nprobe": 10}},
    limit=10,                            # Maximum results to return
    output_fields=["id", "text"]
)
// Example: Filter documents containing "machine learning" with slop=3
String filter = "PHRASE_MATCH(text, 'machine learning', 3)";

Map<String, Object> searchParams = new HashMap<>();
searchParams.put("nprobe", 10);

SearchResp searchResp = client.search(SearchReq.builder()
        .collectionName("tech_articles")
        .annsField("embeddings")            // Vector field name
        .data(Collections.singletonList(queryVector)) // Query vector
        .filter(filter)                     // Filter expression
        .searchParams(searchParams)
        .topK(10)                           // Maximum results to return
        .outputFields(Arrays.asList("id", "text"))
        .build());
// Example: Filter documents containing "machine learning" with slop=3
filter := "PHRASE_MATCH(text, 'machine learning', 3)"

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "tech_articles", // collectionName
    10,              // limit, maximum results to return
    []entity.Vector{entity.FloatVector(queryVector)}, // query vector
).WithANNSField("embeddings"). // vector field name
    WithFilter(filter).        // filter expression
    WithSearchParam("nprobe", "10").
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
// Example: Filter documents containing "machine learning" with slop=3
const filter = "PHRASE_MATCH(text, 'machine learning', 3)";

const result = await client.search({
    collection_name: "tech_articles",
    anns_field: "embeddings", // Vector field name
    data: [query_vector], // Query vector
    filter: filter, // Filter expression
    params: { nprobe: 10 },
    limit: 10, // Maximum results to return
    output_fields: ["id", "text"],
});
export filter="\"PHRASE_MATCH(text, 'machine learning', 3)\""

export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "tech_articles",
    "annsField": "embeddings",
    "data": [[0.19886812562848388, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501, 0.838729485096104]],
    "filter": '"$filter"',
    "searchParams": {
        "params": {
            "nprobe": 10
        }
    },
    "limit": 10,
    "outputFields": ["id", "text"]
}'
// Example: Filter documents containing "machine learning" with slop=3
milvus::SearchResponse response;
auto status = client->Search(milvus::SearchRequest()
                                 .WithCollectionName("tech_articles")
                                 .WithAnnsField("embeddings") // Vector field name
                                 .AddFloatVector(query_vector) // Query vector
                                 .WithFilter("PHRASE_MATCH(text, 'machine learning', 3)") // Filter expression
                                 .AddExtraParam("nprobe", "10")
                                 .WithLimit(10) // Maximum results to return
                                 .AddOutputField("id")
                                 .AddOutputField("text"),
                             response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
Результаты поиска:
|
|
|---|---|
1 |
«Машинное обучение повышает эффективность анализа больших массивов данных» |
2 |
«Изучение машинного подхода имеет жизненно важное значение для прогресса современного ИИ» |
3 |
«Архитектуры систем глубокого обучения оптимизируют вычислительную нагрузку» |
5 |
«Изучение передовых алгоритмов машинного обучения расширяет возможности ИИ» |
Рекомендации
Включение сопоставления фраз для поля приводит к созданию инвертированного индекса, что требует ресурсов хранения. При принятии решения о включении этой функции учитывайте влияние на хранение, поскольку оно зависит от размера текста, количества уникальных токенов и используемого анализатора.
После определения анализатора в схеме его настройки становятся постоянными для данной коллекции. Если вы решите, что другой анализатор лучше соответствует вашим потребностям, можно удалить существующую коллекцию и создать новую с нужной конфигурацией анализатора.
Производительность поиска по фразам зависит от способа токенизации текста. Прежде чем применять анализатор ко всей коллекции, воспользуйтесь методом `
run_analyzer`, чтобы проверить результаты токенизации. Дополнительные сведения см. в разделе «Обзор анализаторов».Правила экранирования в выражениях
filter:Символы, заключённые в двойные или одинарные кавычки внутри выражений, интерпретируются как строковые константы. Если строковая константа содержит символы экранирования, они должны быть представлены с помощью экранирующих последовательностей. Например, используйте `
\\` для представления\, `\\t` — для табуляции\t, а `\\n` — для символа новой строки.Если строковая константа заключена в одинарные кавычки, одинарная кавычка внутри константы должна представляться как
\\', тогда как двойная кавычка может представляться либо как", либо как\\". Пример:'It\\'s milvus'.Если строковая константа заключена в двойные кавычки, двойная кавычка внутри константы должна быть представлена как
\\", а одинарная кавычка может быть представлена либо как', либо как\\'. Пример:"He said \\"Hi\\"".
