

Совпадение текста
Функция «Совпадение текста» в Milvus позволяет точно находить документы на основе конкретных терминов. Эта функция в основном используется для фильтрованного поиска, отвечающего определенным условиям, и может включать скалярную фильтрацию для уточнения результатов запроса, что позволяет выполнять поиск по схожести среди векторов, отвечающих скалярным критериям.
TEXT_MATCH Находит точные проанализированные термины, в то время как поиск по фразам ( TEXT_MATCH_FUZZY ) допускает небольшое расстояние редактирования между токенами запроса и индексированными токенами. Обе операции являются булевыми операциями фильтрации и не оценивают релевантность найденных документов. Если вы хотите найти наиболее релевантные документы на основе семантического значения и важности терминов запроса, мы рекомендуем использовать полнотекстовый поиск (Full Text Search).
Обзор
Milvus интегрирует Tantivy для обеспечения работы своего базового инвертированного индекса и текстового поиска по терминам. Каждый текстовый фрагмент Milvus индексирует следующим образом:
Анализатор: Анализатор обрабатывает входной текст, разбивая его на отдельные слова (токены), а затем применяя необходимые фильтры. Это позволяет Milvus создавать индекс на основе этих токенов.
Индексирование: после анализа текста Milvus создает инвертированный индекс, который сопоставляет каждый уникальный токен с документами, в которых он встречается.
Когда пользователь выполняет поиск по тексту, инвертированный индекс используется для быстрого извлечения всех документов, содержащих искомые термины. Это происходит гораздо быстрее, чем сканирование каждого документа по отдельности.
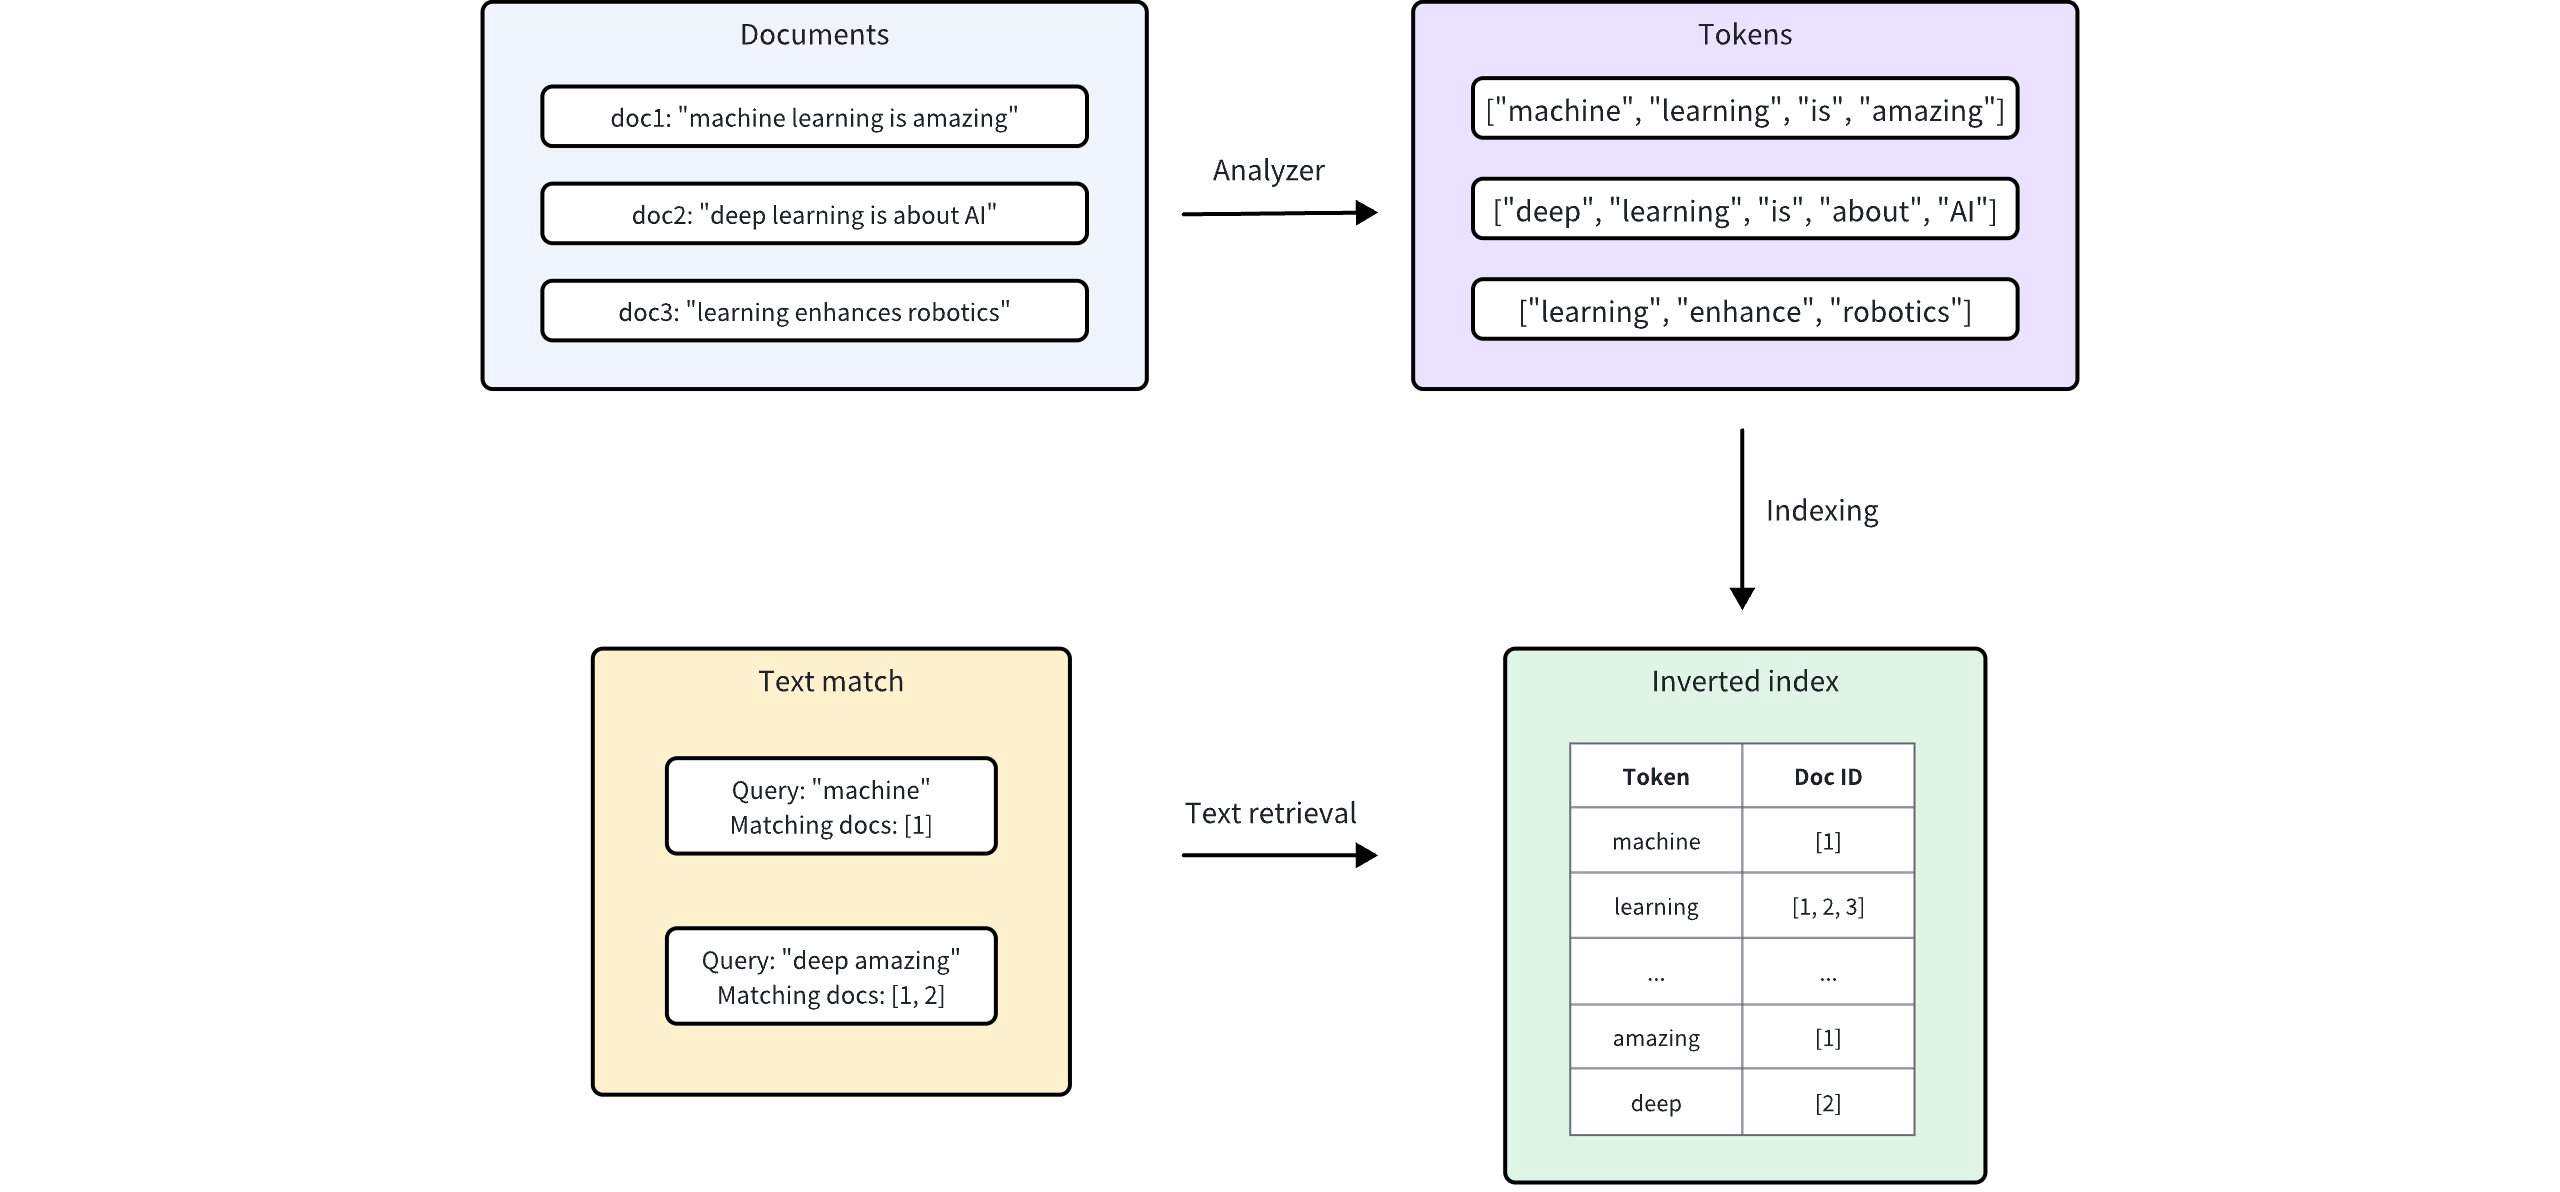 Поиск по ключевым словам
Включение текстового сопоставления
Поиск по тексту работает с строковыми полями, для которых включена функция поиска. В примерах на этой странице используется VARCHAR, который поддерживается во всех клиентских SDK. В Milvus 3.0.x TEXT поля также поддерживают текстовый поиск, если включен Storage V3. Для любого из этих типов полей установите значения enable_analyzer и enable_match равными True, а затем, при необходимости, настройте анализатор при определении схемы коллекции.
Установите значения для параметров enable_analyzer и enable_match
Чтобы включить текстовое сопоставление для конкретного поля типа « VARCHAR », при определении схемы поля установите значения параметров « enable_analyzer » и « enable_match » равными True. Это укажет Milvus на необходимость токенизации текста и создания инвертированного индекса для указанного поля, что обеспечит быстрое и эффективное текстовое сопоставление.
from pymilvus import MilvusClient, DataType

schema = MilvusClient.create_schema(enable_dynamic_field=False)
schema.add_field(
    field_name="id",
    datatype=DataType.INT64,
    is_primary=True,
    auto_id=True
)
schema.add_field(
    field_name='text',
    datatype=DataType.VARCHAR,
    max_length=1000,
    enable_analyzer=True, # Whether to enable text analysis for this field
    enable_match=True # Whether to enable text match
)
schema.add_field(
    field_name="embeddings",
    datatype=DataType.FLOAT_VECTOR,
    dim=5
)
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .enableDynamicField(false)
        .build();
schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .enableMatch(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("embeddings")
        .dataType(DataType.FloatVector)
        .dimension(5)
        .build());
import "github.com/milvus-io/milvus/client/v2/entity"

schema := entity.NewSchema().WithDynamicFieldEnabled(false)
schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(true),
).WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithEnableMatch(true).
    WithMaxLength(1000),
).WithField(entity.NewField().
    WithName("embeddings").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(5),
)
const schema = [
  {
    name: "id",
    data_type: DataType.Int64,
    is_primary_key: true,
  },
  {
    name: "text",
    data_type: "VarChar",
    enable_analyzer: true,
    enable_match: true,
    max_length: 1000,
  },
  {
    name: "embeddings",
    data_type: DataType.FloatVector,
    dim: 5,
  },
];
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true,
                    "enable_match": true
                }
            },
            {
                "fieldName": "embeddings",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "5"
                }
            }
        ]
    }'
milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->SetEnableDynamicField(false);
schema->AddField({"id", milvus::DataType::INT64, "", true, true});
schema->AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR).WithMaxLength(1000).EnableAnalyzer(true).EnableMatch(true));
schema->AddField(milvus::FieldSchema("embeddings", milvus::DataType::FLOAT_VECTOR).WithDimension(5));
Необязательно: настройка анализатора
Производительность и точность сопоставления по ключевым словам зависят от выбранного анализатора. Различные анализаторы адаптированы к разным языкам и структурам текста, поэтому выбор подходящего анализатора может существенно повлиять на результаты поиска в вашем конкретном случае использования.
По умолчанию Milvus использует анализатор « standard », который разбивает текст на токены на основе пробелов и знаков препинания, удаляет токены длиной более 40 символов и преобразует текст в нижний регистр. Для применения этой настройки по умолчанию не требуется никаких дополнительных параметров. Дополнительную информацию см. в разделе «Стандарт».
Если требуется другой анализатор, его можно настроить с помощью параметра ` analyzer_params `. Например, чтобы применить анализатор ` english ` для обработки текста на английском языке:
analyzer_params = {
    "type": "english"
}
schema.add_field(
    field_name='text',
    datatype=DataType.VARCHAR,
    max_length=200,
    enable_analyzer=True,
    analyzer_params = analyzer_params,
    enable_match = True,
)
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("type", "english");
schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(200)
        .enableAnalyzer(true)
        .analyzerParams(analyzerParams)
        .enableMatch(true)
        .build());
analyzerParams := map[string]any{"type": "english"}
schema.WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithEnableMatch(true).
    WithAnalyzerParams(analyzerParams).
    WithMaxLength(200),
)
const schema = [
  {
    name: "id",
    data_type: DataType.Int64,
    is_primary_key: true,
  },
  {
    name: "text",
    data_type: "VarChar",
    enable_analyzer: true,
    enable_match: true,
    max_length: 1000,
    analyzer_params: { type: 'english' },
  },
  {
    name: "embeddings",
    data_type: DataType.FloatVector,
    dim: 5,
  },
];
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 200,
                    "enable_analyzer": true,
                    "enable_match": true,
                    "analyzer_params": {"type": "english"}
                }
            },
            {
                "fieldName": "embeddings",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "5"
                }
            }
        ]
    }'
nlohmann::json analyzer_params = {{"type", "english"}};
schema->AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR).WithMaxLength(200).EnableAnalyzer(true).WithAnalyzerParams(analyzer_params).EnableMatch(true));
Milvus также предоставляет различные другие анализаторы, подходящие для разных языков и сценариев. Подробнее см. в разделе «Обзор анализаторов».
Использование сопоставления текста
После включения текстового сопоставления для поля VARCHAR или TEXT в схеме вашей коллекции вы можете выполнять текстовое сопоставление с помощью выражения TEXT_MATCH.
Синтаксис выражения TEXT_MATCH
Выражение TEXT_MATCH используется для указания поля и терминов, по которым будет выполняться поиск. Его синтаксис следующий:
TEXT_MATCH(field_name, text)
std::string filter = "TEXT_MATCH(field_name, text)";
export filter="\"TEXT_MATCH(field_name, text)\""
field_name: Имя поляVARCHARилиTEXTс поддержкой сопоставления, в котором будет выполняться поиск.text: Термины для поиска. Несколько терминов можно разделять пробелами или другими подходящими разделителями в зависимости от языка и настроенного анализатора.
По умолчанию в TEXT_MATCH используется логика сопоставления «ИЛИ» (OR), то есть будут возвращены документы, содержащие любой из указанных терминов. Например, чтобы найти документы, содержащие термин « machine » или « deep » в поле « text », используйте следующее выражение:
filter = "TEXT_MATCH(text, 'machine deep')"
String filter = "TEXT_MATCH(text, 'machine deep')";
filter := "TEXT_MATCH(text, 'machine deep')"
const filter = "TEXT_MATCH(text, 'machine deep')";
export filter="\"TEXT_MATCH(text, 'machine deep')\""
std::string filter = "TEXT_MATCH(text, 'machine deep')";
Вы также можете комбинировать несколько выражений TEXT_MATCH с помощью логических операторов для выполнения поиска по условию «И ».
Чтобы найти документы, содержащие как «
machine», так и «deep» в поле «text», используйте следующее выражение:filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')"String filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')";filter := "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')"const filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')"export filter="\"TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')\""std::string filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')";Для поиска документов, содержащих как
machine, так иlearning, но не содержащихdeepв полеtext, используйте следующие выражения:filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')"String filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')";filter := "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')"const filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')";export filter="\"not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')\""std::string filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')";
Синтаксис выражения TEXT_MATCH_FUZZYCompatible with Milvus 3.0.0+
Используйте TEXT_MATCH_FUZZY, чтобы учитывать различия в написании между токенами запроса и индексированными токенами. Milvus анализирует текст запроса с помощью анализатора поля и применяет неточное сопоставление к каждому полученному токену. Если запрос генерирует несколько токенов, выражение сопоставляется с сущностью, когда любой токен удовлетворяет настроенному расстоянию редактирования.
Синтаксис следующий:
TEXT_MATCH_FUZZY(field_name, text, max_edit_distance = 1)
std::string filter = "TEXT_MATCH_FUZZY(field_name, text, max_edit_distance = 1)";
export filter="\"TEXT_MATCH_FUZZY(field_name, text, max_edit_distance = 1)\""
field_name: Название поля с поддержкой сопоставления, настроенного с помощьюVARCHARилиTEXT, в котором будет выполняться поиск.text: Текст запроса, который необходимо проанализировать и сопоставить с индексированными токенами.max_edit_distance: Максимальное допустимое расстояние редактирования для каждого токена запроса. Имя параметра должно быть именноmax_edit_distance, а его значением должно быть0,1или2. Значение0выполняет точное сопоставление токенов, что эквивалентноTEXT_MATCH.
Например, следующее выражение находит токены, отличающиеся не более чем на одну букву от machne, включая machine:
filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)"
String filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)";
filter := "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)"
const filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)";
export filter="\"TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)\""
std::string filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)";
TEXT_MATCH_FUZZY является частью синтаксиса фильтрующих выражений, поэтому клиентские SDK не требуют специального метода неточного сопоставления. Передайте выражение через тот же параметр filter, который используется для TEXT_MATCH в операциях поиска или запроса.
Поиск с текстовым сопоставлением
Совпадение по тексту можно использовать в сочетании с векторным поиском по схожести, чтобы сузить область поиска и повысить производительность поиска. Фильтруя коллекцию с помощью совпадения по тексту перед векторным поиском по схожести, вы можете уменьшить количество документов, которые необходимо просматривать, что приводит к сокращению времени выполнения запроса.
В этом примере выражение filter фильтрует результаты поиска, чтобы включить только те документы, которые содержат указанный термин keyword1 или keyword2. Затем поиск по векторному сходству выполняется над этим отфильтрованным подмножеством документов.
Вы можете выделять совпадающие термины в результатах поиска, настроив подсветку текста. Подробности см. в разделе «Подсветка текста ».
# Match entities with `keyword1` or `keyword2`
filter = "TEXT_MATCH(text, 'keyword1 keyword2')"

# Assuming 'embeddings' is the vector field and 'text' is the VARCHAR field
result = client.search(
    collection_name="my_collection", # Your collection name
    anns_field="embeddings", # Vector field name
    data=[query_vector], # Query vector
    filter=filter,
    search_params={"params": {"nprobe": 10}},
    limit=10, # Max. number of results to return
    output_fields=["id", "text"] # Fields to return
)
String filter = "TEXT_MATCH(text, 'keyword1 keyword2')";

SearchResp searchResp = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .annsField("embeddings")
        .data(Collections.singletonList(queryVector)))
        .filter(filter)
        .topK(10)
        .outputFields(Arrays.asList("id", "text"))
        .build());
filter := "TEXT_MATCH(text, 'keyword1 keyword2')"

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    10,               // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("embeddings").
    WithFilter(filter).
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
// Match entities with `keyword1` or `keyword2`
const filter = "TEXT_MATCH(text, 'keyword1 keyword2')";

// Assuming 'embeddings' is the vector field and 'text' is the VARCHAR field
const result = await client.search(
    collection_name: "my_collection", // Your collection name
    anns_field: "embeddings", // Vector field name
    data: [query_vector], // Query vector
    filter: filter,
    params: {"nprobe": 10},
    limit: 10, // Max. number of results to return
    output_fields: ["id", "text"] //Fields to return
);
export filter="\"TEXT_MATCH(text, 'keyword1 keyword2')\""

export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "annsField": "embeddings",
    "data": [[0.19886812562848388, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501, 0.838729485096104]],
    "filter": '"$filter"',
    "searchParams": {
        "params": {
            "nprobe": 10
        }
    },
    "limit": 10,
    "outputFields": ["text","id"]
}'
// Match entities with `keyword1` or `keyword2`
std::string filter = "TEXT_MATCH(text, 'keyword1 keyword2')";

// Assuming 'embeddings' is the vector field and 'text' is the VARCHAR field
auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .WithAnnsField("embeddings")
                   .AddFloatVector(query_vector)
                   .WithFilter(filter)
                   .AddExtraParam("nprobe", "10")
                   .WithLimit(10)
                   .AddOutputField("id")
                   .AddOutputField("text");

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
Запрос с текстовым совпадением
Совпадение текста также можно использовать для скалярной фильтрации в операциях запроса. Указав выражение TEXT_MATCH в параметре expr метода query(), можно получить документы, соответствующие заданным терминам.
В приведённом ниже примере извлекаются документы, в поле « text » которых содержатся оба термина: « keyword1 » и « keyword2 ».
# Match entities with both `keyword1` and `keyword2`
filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')"

result = client.query(
    collection_name="my_collection",
    filter=filter,
    output_fields=["id", "text"]
)
String filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')";

QueryResp queryResp = client.query(QueryReq.builder()
        .collectionName("my_collection")
        .filter(filter)
        .outputFields(Arrays.asList("id", "text"))
        .build()
);
filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')"
resultSet, err := client.Query(ctx, milvusclient.NewQueryOption("my_collection").
    WithFilter(filter).
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
// Match entities with both `keyword1` and `keyword2`
const filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')";

const result = await client.query(
    collection_name: "my_collection",
    filter: filter,
    output_fields: ["id", "text"]
)
export filter="\"TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')\""

export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/query" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "filter": '"$filter"',
    "outputFields": ["id", "text"]
}'
// Match entities with both `keyword1` and `keyword2`
std::string filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')";

auto request = milvus::QueryRequest()
                   .WithCollectionName("my_collection")
                   .WithFilter(filter)
                   .AddOutputField("id")
                   .AddOutputField("text");

milvus::QueryResponse response;
auto status = client->Query(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
Рекомендации
Включение сопоставления терминов для поля приводит к созданию инвертированного индекса, что требует ресурсов хранения. При принятии решения о включении этой функции учитывайте влияние на хранилище, поскольку оно зависит от размера текста, количества уникальных токенов и используемого анализатора.
После определения анализатора в схеме его настройки становятся постоянными для данной коллекции. Если вы решите, что другой анализатор лучше соответствует вашим потребностям, можно удалить существующую коллекцию и создать новую с нужной конфигурацией анализатора.
Правила экранирования в выражениях
filter:Символы, заключенные в двойные или одинарные кавычки в выражениях, интерпретируются как строковые константы. Если строковая константа содержит символы экранирования, они должны быть представлены с помощью экранирующих последовательностей. Например, используйте
\\для представления\,\\tдля представления табуляции\tи\\nдля представления символа новой строки.Если строковая константа заключена в одинарные кавычки, одинарная кавычка внутри константы должна представляться как
\\', а двойная кавычка может представляться либо как", либо как\\". Пример:'It\\'s milvus'.Если строковая константа заключена в двойные кавычки, двойная кавычка внутри константы должна быть представлена как
\\", а одинарная кавычка может быть представлена либо как', либо как\\'. Пример:"He said \\"Hi\\"".
