

Групповой поиск
Групповой поиск позволяет Milvus группировать результаты поиска по значениям в указанном поле для агрегирования данных на более высоком уровне. Например, с помощью базового поиска ANN можно найти книги, похожие на рассматриваемую, а с помощью группированного поиска — найти категории книг, которые могут затрагивать темы, обсуждаемые в этой книге. В данном разделе описывается, как использовать группированный поиск, а также приводятся основные моменты, которые следует учитывать.
Обзор
Когда объекты в результатах поиска имеют одинаковое значение в скалярном поле, это указывает на их сходство по определенному атрибуту, что может негативно повлиять на результаты поиска.
Предположим, что в коллекции хранится несколько документов (обозначенных docId). Чтобы сохранить как можно больше семантической информации при преобразовании документов в векторы, каждый документ разбивается на более мелкие, удобные для работы абзацы (или фрагменты) и хранится в виде отдельных объектов. Несмотря на то что документ разбит на более мелкие части, пользователи часто по-прежнему заинтересованы в том, чтобы определить, какие документы наиболее соответствуют их потребностям.
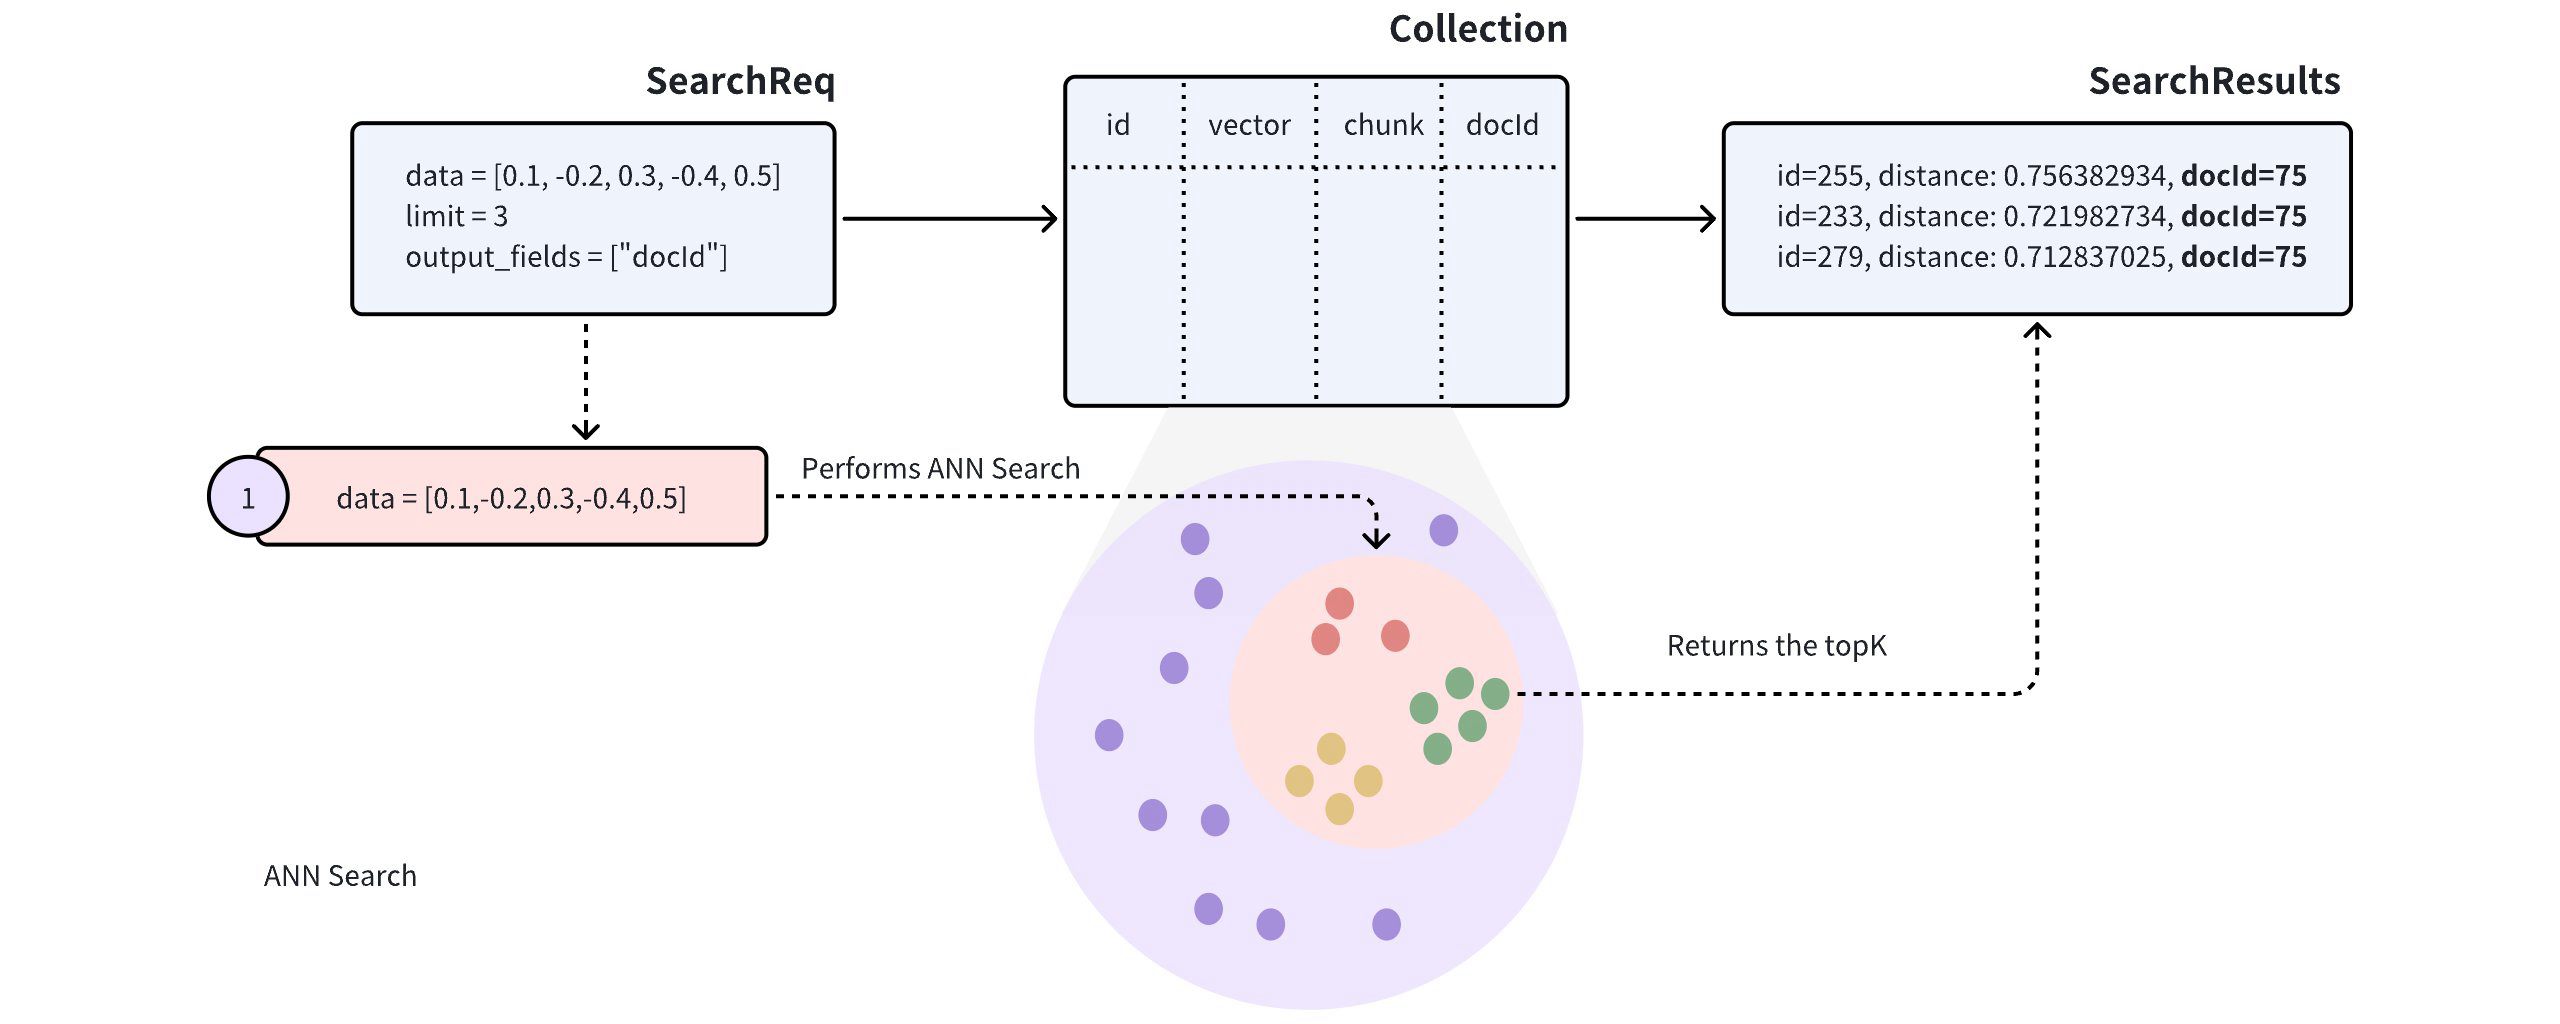 Поиск Ann
При выполнении поиска по методу приближенного ближайшего соседа (ANN) в такой коллекции результаты поиска могут включать несколько абзацев из одного и того же документа, что может привести к игнорированию других документов, что, возможно, не соответствует предполагаемому сценарию использования.
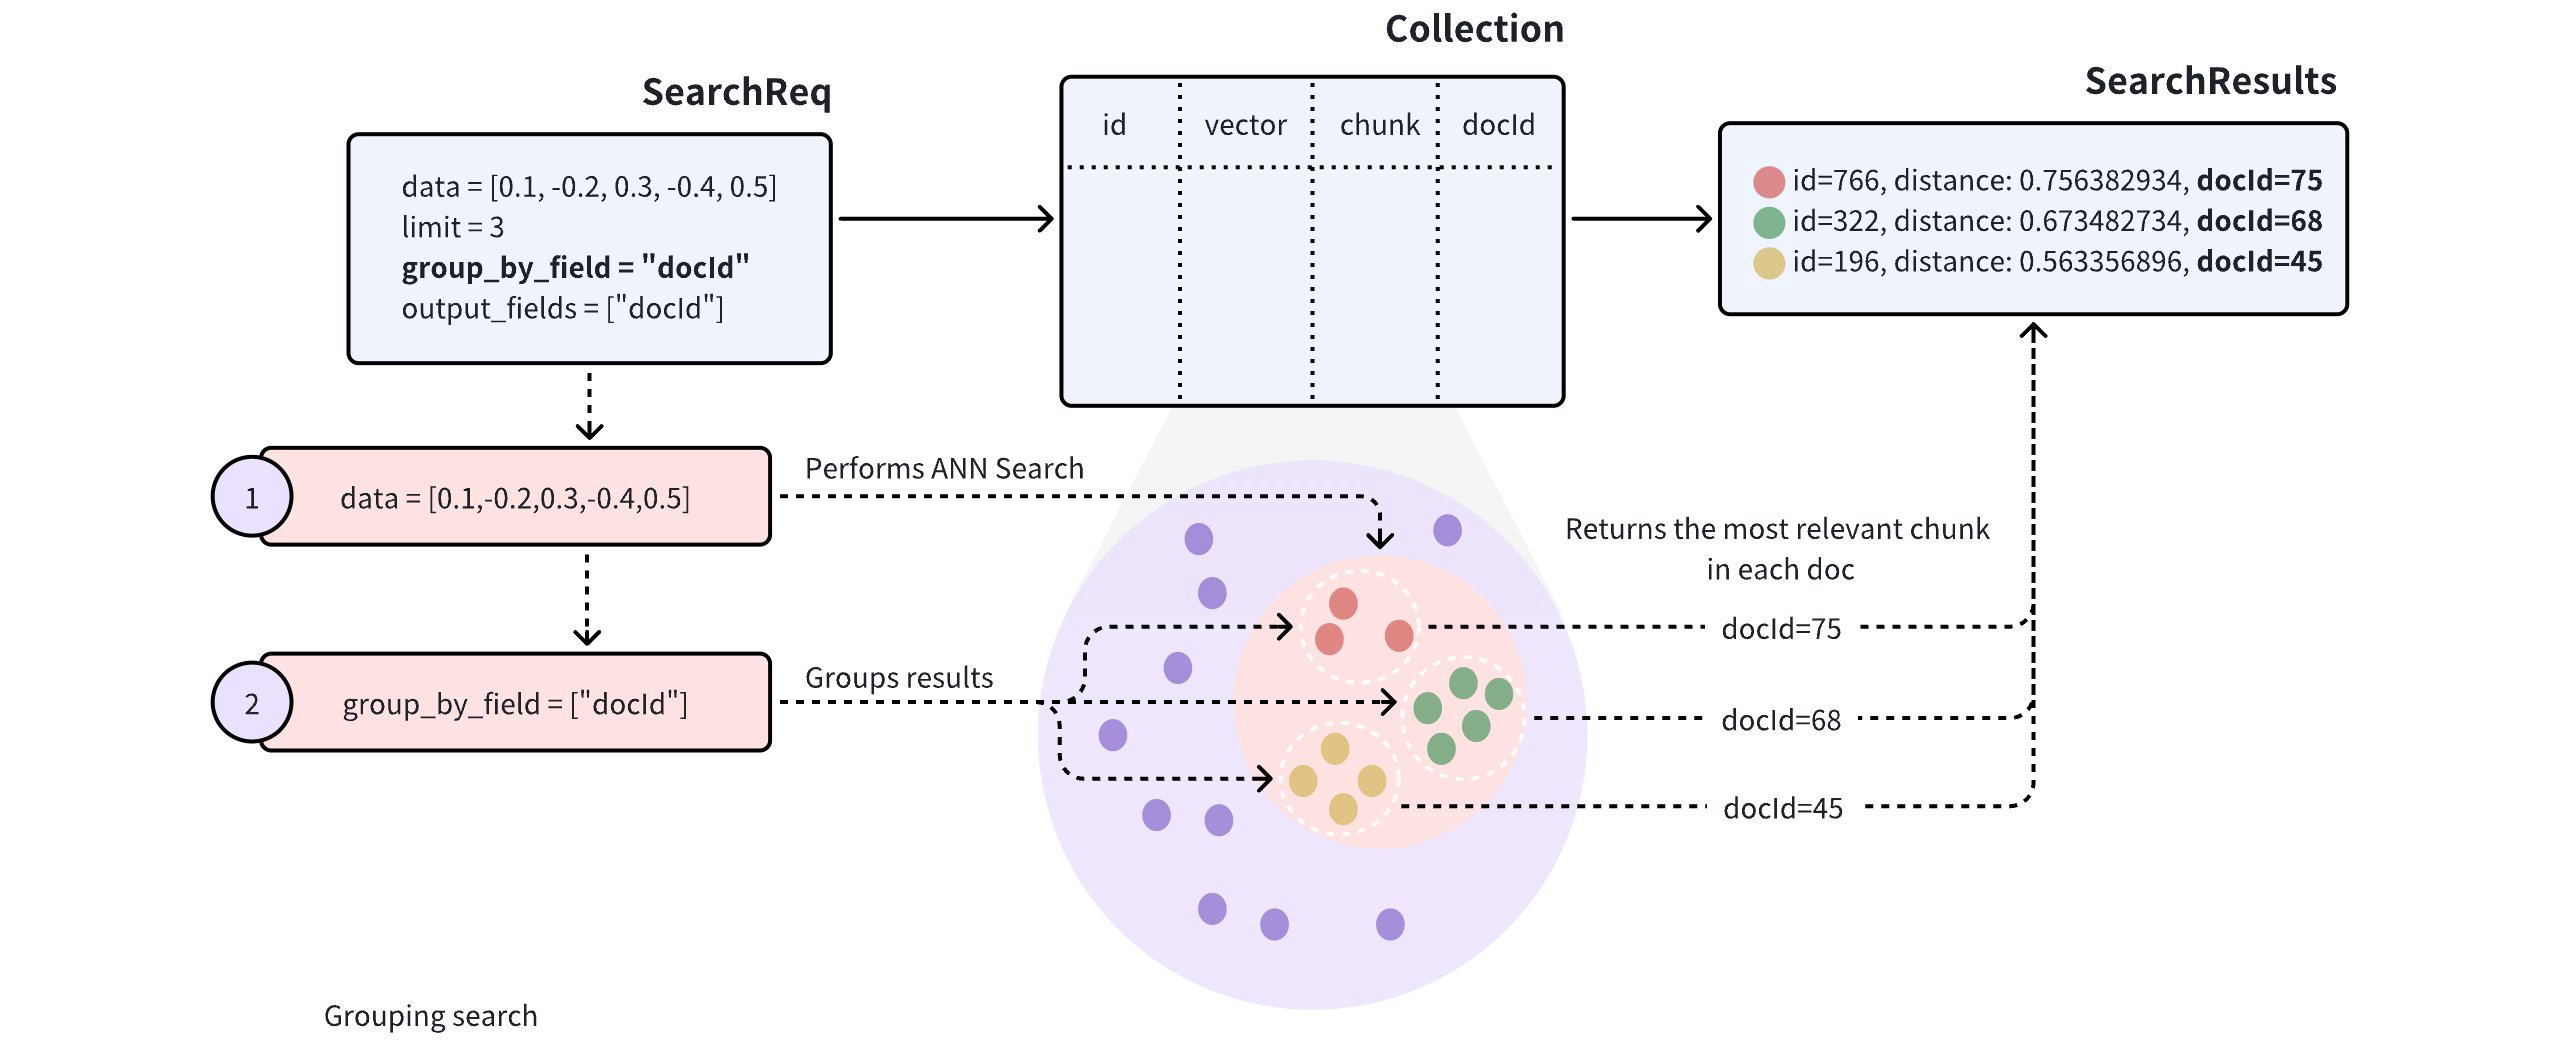 Групповой поиск
Чтобы повысить разнообразие результатов поиска, вы можете добавить в запрос на поиск параметр ` group_by_field `, чтобы включить групповой поиск. Как показано на схеме, вы можете установить значение параметра ` group_by_field ` равным ` docId`. Получив такой запрос, Milvus:
Выполнит поиск с использованием нейронной сети (ANN) на основе предоставленного вектора запроса, чтобы найти все объекты, наиболее похожие на запрос.
Сгруппирует результаты поиска по указанному параметру «
group_by_field», напримерdocId.Вернет лучшие результаты для каждой группы, как определено параметром
limit, с наиболее похожим объектом из каждой группы.
По умолчанию групповой поиск возвращает только одну сущность на группу. Если вы хотите увеличить количество результатов, возвращаемых для каждой группы, вы можете настроить это с помощью параметров group_size и strict_group_size.
Выполнение группового поиска
В этом разделе приведены примеры кода, демонстрирующие использование группового поиска. В следующем примере предполагается, что коллекция содержит поля id, vector, chunk и docId.
[
        {"id": 0, "vector": [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592], "chunk": "pink_8682", "docId": 1},
        {"id": 1, "vector": [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501, 0.838729485096104], "chunk": "red_7025", "docId": 5},
        {"id": 2, "vector": [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, 0.7894058910881185, 0.20785793220625592], "chunk": "orange_6781", "docId": 2},
        {"id": 3, "vector": [0.3172005263489739, 0.9719044792798428, -0.36981146090600725, -0.4860894583077995, 0.95791889146345], "chunk": "pink_9298", "docId": 3},
        {"id": 4, "vector": [0.4452349528804562, -0.8757026943054742, 0.8220779437047674, 0.46406290649483184, 0.30337481143159106], "chunk": "red_4794", "docId": 3},
        {"id": 5, "vector": [0.985825131989184, -0.8144651566660419, 0.6299267002202009, 0.1206906911183383, -0.1446277761879955], "chunk": "yellow_4222", "docId": 4},
        {"id": 6, "vector": [0.8371977790571115, -0.015764369584852833, -0.31062937026679327, -0.562666951622192, -0.8984947637863987], "chunk": "red_9392", "docId": 1},
        {"id": 7, "vector": [-0.33445148015177995, -0.2567135004164067, 0.8987539745369246, 0.9402995886420709, 0.5378064918413052], "chunk": "grey_8510", "docId": 2},
        {"id": 8, "vector": [0.39524717779832685, 0.4000257286739164, -0.5890507376891594, -0.8650502298996872, -0.6140360785406336], "chunk": "white_9381", "docId": 5},
        {"id": 9, "vector": [0.5718280481994695, 0.24070317428066512, -0.3737913482606834, -0.06726932177492717, -0.6980531615588608], "chunk": "purple_4976", "docId": 3},
]
В запросе на поиск установите для полей group_by_field и output_fields значение docId. Milvus сгруппирует результаты по указанному полю и вернёт наиболее похожую сущность из каждой группы, включая значение docId для каждой возвращаемой сущности.
from pymilvus import MilvusClient

client = MilvusClient(
    uri="http://localhost:19530",
    token="root:Milvus"
)

query_vectors = [
    [0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088]]

# Group search results
res = client.search(
    collection_name="my_collection",
    data=query_vectors,
    limit=3,
    group_by_field="docId",
    output_fields=["docId"]
)

# Retrieve the values in the `docId` column
doc_ids = [result['entity']['docId'] for result in res[0]]
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.vector.request.SearchReq
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.response.SearchResp

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .token("root:Milvus")
        .build());

FloatVec queryVector = new FloatVec(new float[]{0.14529211512077012f, 0.9147257273453546f, 0.7965055218724449f, 0.7009258593102812f, 0.5605206522382088f});
SearchReq searchReq = SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryVector))
        .topK(3)
        .groupByFieldName("docId")
        .outputFields(Collections.singletonList("docId"))
        .build();

SearchResp searchResp = client.search(searchReq);

List<List<SearchResp.SearchResult>> searchResults = searchResp.getSearchResults();
for (List<SearchResp.SearchResult> results : searchResults) {
    System.out.println("TopK results:");
    for (SearchResp.SearchResult result : results) {
        System.out.println(result);
    }
}

// Output
// TopK results:
// SearchResp.SearchResult(entity={docId=5}, score=0.74767184, id=1)
// SearchResp.SearchResult(entity={docId=2}, score=0.6254269, id=7)
// SearchResp.SearchResult(entity={docId=3}, score=0.3611898, id=3)
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

queryVector := []float32{0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592}

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    3,               // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("vector").
    WithGroupByField("docId").
    WithOutputFields("docId"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("docId: ", resultSet.GetColumn("docId").FieldData().GetScalars())
}
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const address = "http://localhost:19530";
const token = "root:Milvus";
const client = new MilvusClient({address, token});

var query_vector = [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]

res = await client.search({
    collection_name: "my_collection",
    data: [query_vector],
    limit: 3,
    group_by_field: "docId"
})

// Retrieve the values in the `docId` column
var docIds = res.results.map(result => result.entity.docId)
export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": [
        [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]
    ],
    "annsField": "vector",
    "limit": 3,
    "groupingField": "docId",
    "outputFields": ["docId"]
}'
#include "milvus/MilvusClientV2.h"
#include <iostream>
#include <stdexcept>
#include <vector>

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"http://localhost:19530", "root:Milvus"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    throw std::runtime_error(status.Message());
}

std::vector<float> query_vector = {0.3580376395471989f, -0.6023495712049978f, 0.18414012509913835f, -0.26286205330961354f, 0.9029438446296592f};
auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .AddFloatVector(query_vector)
                   .WithLimit(3)
                   .WithAnnsField("vector")
                   .WithGroupByField("docId")
                   .AddOutputField("docId");

milvus::SearchResponse response;
status = client->Search(request, response);
if (!status.IsOk()) {
    throw std::runtime_error(status.Message());
}

for (auto& result : response.Results().Results()) {
    std::cout << "TopK results:" << std::endl;
    milvus::EntityRows output_rows;
    status = result.OutputRows(output_rows);
    if (!status.IsOk()) {
        throw std::runtime_error(status.Message());
    }
    for (const auto& row : output_rows) {
        std::cout << "\t" << row << std::endl;
    }
}
В приведённом выше запросе параметр limit=3 указывает, что система вернёт результаты поиска из трёх групп, причём каждая группа будет содержать единственный объект, наиболее схожий с вектором запроса.
Настройка размера группы
По умолчанию функция группового поиска возвращает только один объект в каждой группе. Если вам требуется несколько результатов в каждой группе, измените параметры group_size и strict_group_size.
# Group search results

res = client.search(
    collection_name="my_collection",
    data=query_vectors, # query vector
    limit=5, # number of groups to return
    group_by_field="docId", # grouping field
    group_size=2, # p to 2 entities to return from each group
    strict_group_size=True, # return exact 2 entities from each group
    output_fields=["docId"]
)
FloatVec queryVector = new FloatVec(new float[]{0.14529211512077012f, 0.9147257273453546f, 0.7965055218724449f, 0.7009258593102812f, 0.5605206522382088f});
SearchReq searchReq = SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryVector))
        .topK(5)
        .groupByFieldName("docId")
        .groupSize(2)
        .strictGroupSize(true)
        .outputFields(Collections.singletonList("docId"))
        .build();

SearchResp searchResp = client.search(searchReq);

List<List<SearchResp.SearchResult>> searchResults = searchResp.getSearchResults();
for (List<SearchResp.SearchResult> results : searchResults) {
    System.out.println("TopK results:");
    for (SearchResp.SearchResult result : results) {
        System.out.println(result);
    }
}

// Output
// TopK results:
// SearchResp.SearchResult(entity={docId=5}, score=0.74767184, id=1)
// SearchResp.SearchResult(entity={docId=5}, score=-0.49148706, id=8)
// SearchResp.SearchResult(entity={docId=2}, score=0.6254269, id=7)
// SearchResp.SearchResult(entity={docId=2}, score=0.38515577, id=2)
// SearchResp.SearchResult(entity={docId=3}, score=0.3611898, id=3)
// SearchResp.SearchResult(entity={docId=3}, score=0.19556211, id=4)
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

queryVector := []float32{0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592}

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    5,               // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("vector").
    WithGroupByField("docId").
    WithStrictGroupSize(true).
    WithGroupSize(2).
    WithOutputFields("docId"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("docId: ", resultSet.GetColumn("docId").FieldData().GetScalars())
}
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const address = "http://localhost:19530";
const token = "root:Milvus";
const client = new MilvusClient({address, token});

var query_vector = [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]

res = await client.search({
    collection_name: "my_collection",
    data: [query_vector],
    limit: 5,
    group_by_field: "docId",
    group_size: 2,
    strict_group_size: true
})

// Retrieve the values in the `docId` column
var docIds = res.results.map(result => result.entity.docId)
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": [
        [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]
    ],
    "annsField": "vector",
    "limit": 5,
    "groupingField": "docId",
    "groupSize":2,
    "strictGroupSize":true,
    "outputFields": ["docId"]
}'
#include "milvus/MilvusClientV2.h"
#include <iostream>
#include <stdexcept>
#include <vector>

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"http://localhost:19530", "root:Milvus"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    throw std::runtime_error(status.Message());
}

std::vector<float> query_vector = {0.3580376395471989f, -0.6023495712049978f, 0.18414012509913835f, -0.26286205330961354f, 0.9029438446296592f};
auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .AddFloatVector(query_vector)
                   .WithLimit(5)
                   .WithAnnsField("vector")
                   .WithGroupByField("docId")
                   .WithGroupSize(2)
                   .WithStrictGroupSize(true)
                   .AddOutputField("docId");

milvus::SearchResponse response;
status = client->Search(request, response);
if (!status.IsOk()) {
    throw std::runtime_error(status.Message());
}

for (auto& result : response.Results().Results()) {
    std::cout << "TopK results:" << std::endl;
    milvus::EntityRows output_rows;
    status = result.OutputRows(output_rows);
    if (!status.IsOk()) {
        throw std::runtime_error(status.Message());
    }
    for (const auto& row : output_rows) {
        std::cout << "\t" << row << std::endl;
    }
}
В приведенном выше примере:
group_size: Указывает желаемое количество объектов, которые должны возвращаться в каждой группе. Например, установка значенияgroup_size=2означает, что каждая группа (или каждыйdocId) в идеале должна возвращать два наиболее похожих абзаца (или фрагмента). Если параметрgroup_sizeне задан, система по умолчанию возвращает один результат в каждой группе.strict_group_size: Этот булевый параметр определяет, должна ли система строго соблюдать количество, заданное параметром `group_size`. При значении `strict_group_size=True` система будет пытаться включить в каждую группу точное количество элементов, указанное в `group_size` (например, два абзаца), за исключением случаев, когда в данной группе недостаточно данных. По умолчанию (strict_group_size=False) система уделяет приоритетное внимание соблюдению количества групп, заданного параметромlimit, а не обеспечению того, чтобы каждая группа содержалаgroup_sizeэлементов. Такой подход, как правило, более эффективен в случаях, когда распределение данных неравномерно.
Дополнительные сведения о параметрах см. в разделе search.
Сортировка групп по скалярному полюCompatible with Milvus 3.0.x
Вы можете совместить поиск с группировкой (Grouping Search) с функцией сортировки по скалярному полю ( order_by_fields ), чтобы упорядочить группы по скалярному полю. Это полезно, когда вам нужны разнообразные результаты в разных группах, но при этом вы хотите, чтобы группы следовали порядку, значимому для бизнеса, например, по цене или рейтингу.
В следующем примере результаты поиска сгруппированы по параметру « category », в каждую группу входит не более трёх объектов, а возвращённые группы отсортированы по значению параметра « price » от наименьшего к наибольшему.
res = client.search(
    collection_name="product_catalog",
    data=query_vectors,
    anns_field="embedding",
    limit=20,
    group_by_field="category",
    group_size=3,
    strict_group_size=True,
    output_fields=["category", "price", "rating"],
    order_by_fields=[
        {"field": "price", "order": "asc"}
    ],
)
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.request.aggregation.AggDirection;
import io.milvus.v2.service.vector.request.aggregation.OrderByField;
import io.milvus.v2.service.vector.response.SearchResp;
import java.util.List;

// Prerequisite: client is connected to Milvus and product_catalog is loaded.
FloatVec queryVector = new FloatVec(new float[]{0.14529211512077012f, 0.9147257273453546f, 0.7965055218724449f, 0.7009258593102812f, 0.5605206522382088f});
SearchReq request = SearchReq.builder()
    .collectionName("product_catalog")
    .data(List.of(queryVector))
    .annsField("embedding")
    .topK(20)
    .groupByFieldName("category")
    .groupSize(3)
    .strictGroupSize(true)
    .outputFields(List.of("category", "price", "rating"))
    .orderByFields(List.of(OrderByField.builder()
        .fieldName("price").direction(AggDirection.ASC).build()))
    .build();
SearchResp response = client.search(request);
System.out.println(response.getSearchResults());
// Prerequisite: client is connected to Milvus and product_catalog is loaded.
const queryVector = [0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088];
const response = await client.search({
  collection_name: "product_catalog",
  data: [queryVector],
  anns_field: "embedding",
  limit: 20,
  group_by_field: "category",
  group_size: 3,
  strict_group_size: true,
  output_fields: ["category", "price", "rating"],
  order_by_fields: [{ field: "price", order: "asc" }],
});
console.log(response.results);
import (
    "fmt"
    "github.com/milvus-io/milvus/client/v3/entity"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

// Prerequisite: client is connected to Milvus and product_catalog is loaded.
queryVector := []float32{0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088}
results, err := client.Search(ctx, milvusclient.NewSearchOption(
    "product_catalog", 20, []entity.Vector{entity.FloatVector(queryVector)},
).
    WithANNSField("embedding").
    WithGroupByField("category").
    WithGroupSize(3).
    WithStrictGroupSize(true).
    WithOutputFields("category", "price", "rating").
    WithSearchParam("order_by_fields", "price:asc"))
if err != nil {
    panic(err)
}
for _, result := range results {
    fmt.Println(result.IDs, result.Scores)
    fmt.Println(result.GetColumn("category"), result.GetColumn("price"), result.GetColumn("rating"))
}
# Prerequisite: set CLUSTER_ENDPOINT and TOKEN for your Milvus instance.
curl --request POST \
  --url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
  --header "Authorization: Bearer ${TOKEN}" \
  --header "Content-Type: application/json" \
  --data '{
    "collectionName": "product_catalog",
    "data": [[0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088]],
    "annsField": "embedding",
    "limit": 20,
    "groupingField": "category",
    "groupSize": 3,
    "strictGroupSize": true,
    "outputFields": ["category", "price", "rating"],
    "orderByFields": ["price:asc"]
  }'
#include "milvus/MilvusClientV2.h"
#include <iostream>
#include <stdexcept>

// Prerequisite: client is connected to Milvus and product_catalog is loaded.
std::vector<float> query_vector = {0.14529211512077012f, 0.9147257273453546f, 0.7965055218724449f, 0.7009258593102812f, 0.5605206522382088f};
auto request = milvus::SearchRequest()
    .WithCollectionName("product_catalog")
    .AddFloatVector(query_vector)
    .WithAnnsField("embedding")
    .WithLimit(20)
    .WithGroupByField("category")
    .WithGroupSize(3)
    .WithStrictGroupSize(true)
    .AddOutputField("category")
    .AddOutputField("price")
    .AddOutputField("rating")
    .AddOrderByField(milvus::OrderByField("price", milvus::AggregationDirection::ASC));
milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) { throw std::runtime_error(status.Message()); }
for (const auto& result : response.Results().Results()) {
    milvus::EntityRows rows;
    status = result.OutputRows(rows);
    if (!status.IsOk()) { throw std::runtime_error(status.Message()); }
    std::cout << rows << std::endl;
}
В приведённом выше запросе параметр ` limit=20 ` означает, что Milvus выбирает до 20 групп, а не 20 объектов. Поскольку ` group_size=3`, плоский список результатов может содержать в общей сложности до 60 объектов.
При использовании order_by_fields с group_by_field Milvus сортирует группы по указанному значению скалярного поля ведущего объекта каждой группы. Внутри каждой группы объекты остаются отсортированными по степени сходства с вектором запроса.
Рекомендации
Индексирование: Эта функция группировки работает только для коллекций, проиндексированных с использованием следующих типов индексов: FLAT, IVF_FLAT, IVF_SQ8, HNSW, HNSW_PQ, HNSW_PRQ, HNSW_SQ, DISKANN, SPARSE_INVERTED_INDEX.
Количество групп: Параметр `
limit` определяет количество групп, из которых возвращаются результаты поиска, а не конкретное количество объектов в каждой группе. Установка подходящего значения `limit` помогает контролировать разнообразие результатов поиска и производительность запроса. Уменьшение значения `limit` может снизить вычислительные затраты, если данные распределены плотно или существует проблема с производительностью.Количество объектов в группе: Параметр
group_sizeуправляет количеством объектов, возвращаемых в каждой группе. Регулировка значенияgroup_sizeв соответствии с вашим сценарием использования может повысить насыщенность результатов поиска. Однако при неравномерном распределении данных некоторые группы могут возвращать меньшее количество объектов, чем указано в параметреgroup_size, особенно в условиях ограниченного объема данных.Строгий размер группы: при значении
strict_group_size=Trueсистема будет пытаться возвращать указанное количество сущностей (group_size) для каждой группы, за исключением случаев, когда в данной группе недостаточно данных. Этот параметр обеспечивает постоянное количество сущностей в каждой группе, но может привести к снижению производительности при неравномерном распределении данных или ограниченных ресурсах. Если строгое количество сущностей не требуется, установка значенияstrict_group_size=Falseможет повысить скорость выполнения запросов.Если векторы запроса уже существуют в целевой коллекции, рассмотрите возможность использования параметра `
ids` вместо их извлечения перед выполнением поиска. Подробности см. в разделе «Поиск по первичному ключу».
