

Pesquisa de texto completo
A pesquisa de texto completo é uma funcionalidade que recupera documentos que contenham termos ou frases específicas em conjuntos de dados de texto, classificando depois os resultados com base na relevância. Esta funcionalidade supera as limitações da pesquisa semântica, que pode ignorar termos precisos, garantindo que obtém os resultados mais precisos e contextualmente relevantes. Além disso, simplifica as pesquisas vetoriais ao aceitar a introdução de texto bruto, convertendo automaticamente os seus dados de texto em embeddings esparsos, sem necessidade de gerar manualmente embeddings vetoriais.
Utilizando o algoritmo BM25 para a pontuação de relevância, esta funcionalidade é particularmente valiosa em cenários de geração aumentada por recuperação (RAG), onde dá prioridade a documentos que correspondem de forma próxima a termos de pesquisa específicos.
Ao integrar a pesquisa de texto completo com a pesquisa vetorial densa baseada em semântica, pode melhorar a precisão e a relevância dos resultados da pesquisa. Para mais informações, consulte Pesquisa Híbrida.
Implementação do BM25
O Milvus fornece pesquisa de texto completo com base no algoritmo de relevância BM25, uma função de pontuação amplamente adotada em sistemas de recuperação de informação, e integra-a no fluxo de trabalho de pesquisa para fornecer resultados de texto precisos e ordenados por relevância.
A pesquisa de texto completo no Milvus segue o fluxo de trabalho abaixo:
Introdução de texto bruto: insere documentos de texto ou introduz uma consulta utilizando texto simples, sem necessidade de modelos de incorporação.
Análise de texto: O Milvus utiliza um analisador para processar o seu texto em termos significativos que possam ser indexados e pesquisados.
Processamento da função BM25: Uma função integrada transforma estes termos em representações de vetores esparsos otimizadas para a pontuação BM25.
Armazenamento na coleção: O Milvus armazena as incorporações esparsas resultantes numa coleção para uma recuperação e classificação rápidas.
Pontuação de relevância BM25: No momento da pesquisa, o Milvus aplica a função de pontuação BM25 para calcular a relevância do documento e devolver resultados classificados que melhor correspondam aos termos da consulta.
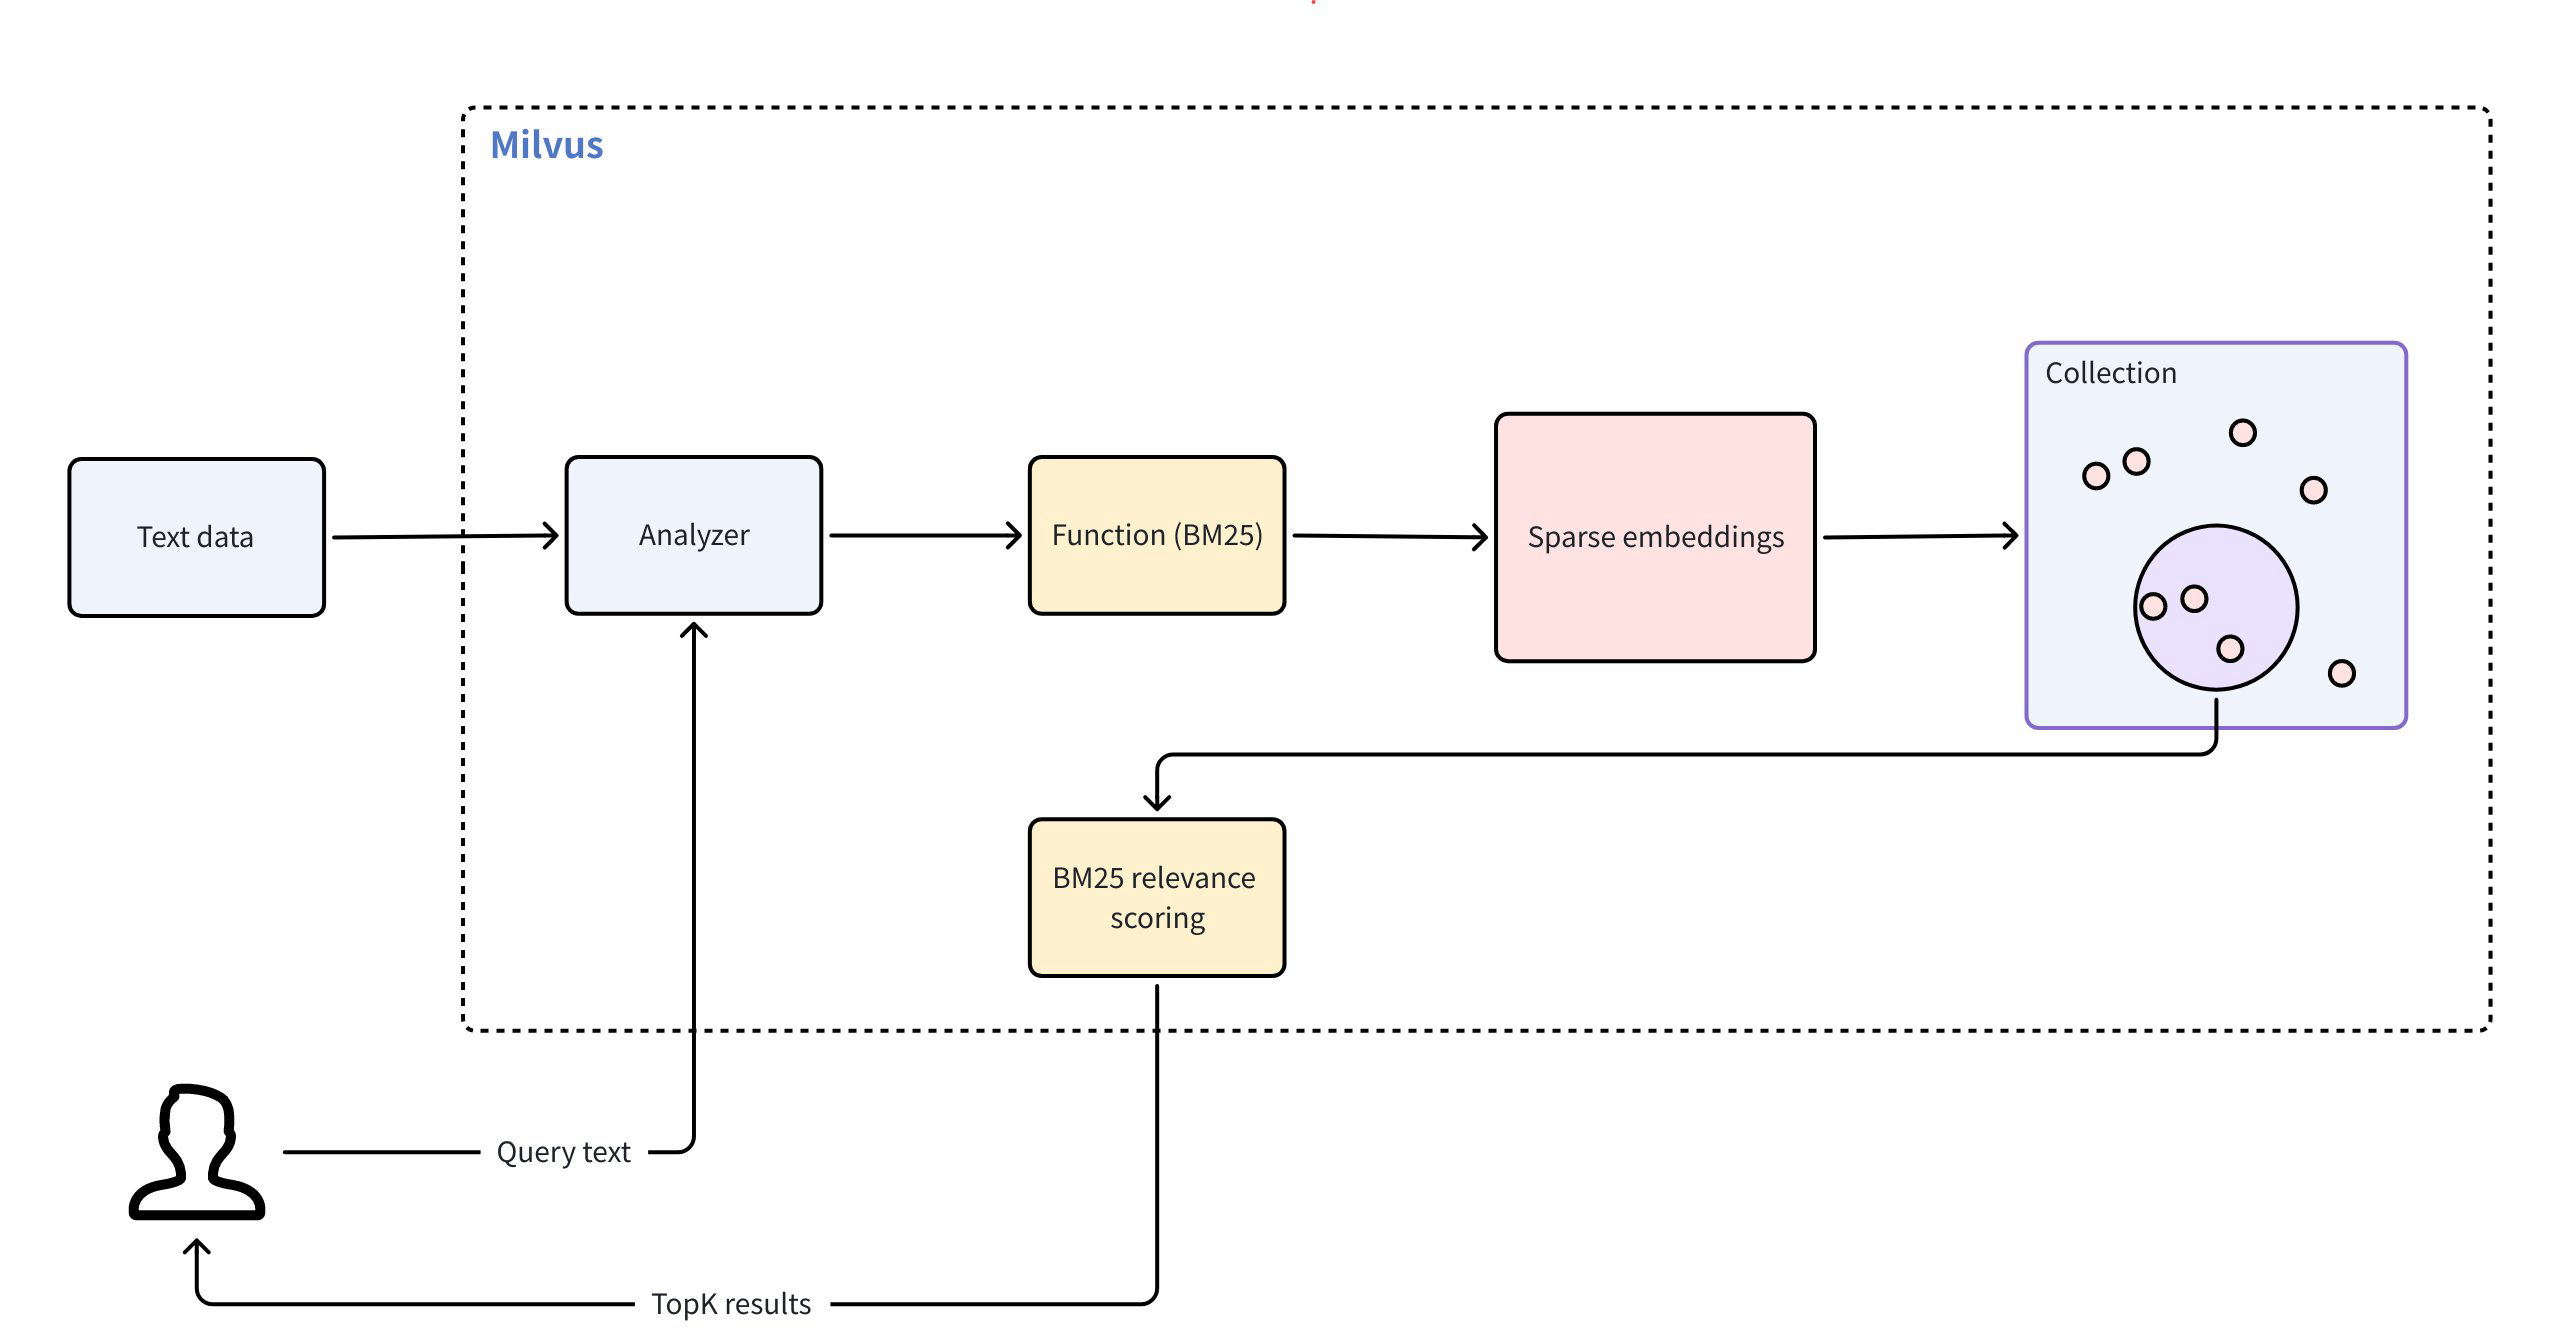 Pesquisa de texto completo
Para utilizar a pesquisa de texto completo, siga estes passos principais:
Criar uma coleção: Configure os campos necessários e defina uma função BM25 que converta texto bruto em representações esparsas.
Inserir dados: Importe os seus documentos de texto bruto para a coleção.
Efetue pesquisas: utilize texto de consulta em linguagem natural para recuperar resultados ordenados com base na relevância BM25.
Criar uma coleção para a pesquisa de texto completo BM25
Para ativar a pesquisa de texto completo com tecnologia BM25, deve preparar uma coleção com os campos obrigatórios, definir uma função BM25 para gerar vetores esparsos, configurar um índice e, em seguida, criar a coleção.
Definir campos do esquema
O esquema da sua coleção deve incluir, pelo menos, três campos obrigatórios:
Campo primário: identifica de forma única cada entidade na coleção.
Campo de cadeia de caracteres (
VARCHARouTEXT): Armazena documentos de texto bruto. É necessário definirenable_analyzer=Truepara que o Milvus possa processar o texto para a classificação de relevância do BM25. Por predefinição, o Milvus utiliza ostandardanalisador para a análise de texto. Para configurar um analisador diferente, consulte a Visão Geral do Analisador. Os exemplos nesta página utilizamVARCHAR; para textos longos, pode definir o campo de entrada comoTEXTe omitirmax_length. Para um exemplo completo, consulte Campo de Texto.Campo de vetor esparso (
SPARSE_FLOAT_VECTOR): Armazena incorporações esparsas geradas automaticamente pela função BM25.
from pymilvus import MilvusClient, DataType, Function, FunctionType

client = MilvusClient(
    uri="http://localhost:19530",
    token="root:Milvus"
)

schema = client.create_schema()

schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True, auto_id=True) # Primary field
schema.add_field(field_name="text", datatype=DataType.VARCHAR, max_length=1000, enable_analyzer=True) # Text field
schema.add_field(field_name="sparse", datatype=DataType.SPARSE_FLOAT_VECTOR) # Sparse vector field; no dim required for sparse vectors
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .build();
schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("sparse")
        .dataType(DataType.SparseFloatVector)
        .build());
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

schema := entity.NewSchema()
schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(true),
).WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithMaxLength(1000),
).WithField(entity.NewField().
    WithName("sparse").
    WithDataType(entity.FieldTypeSparseVector),
)
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const address = "http://localhost:19530";
const token = "root:Milvus";
const client = new MilvusClient({address, token});
const schema = [
  {
    name: "id",
    data_type: DataType.Int64,
    is_primary_key: true,
  },
  {
    name: "text",
    data_type: "VarChar",
    enable_analyzer: true,
    enable_match: true,
    max_length: 1000,
  },
  {
    name: "sparse",
    data_type: DataType.SparseFloatVector,
  },
];

console.log(res.results)
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true
                }
            },
            {
                "fieldName": "sparse",
                "dataType": "SparseFloatVector"
            }
        ]
    }'
Na configuração anterior,
id: funciona como chave primária e é gerado automaticamente comauto_id=True.text: armazena os seus dados de texto bruto para operações de pesquisa de texto completo. O campo pode utilizarVARCHARpara texto limitado ouTEXTpara conteúdo de origem extenso.sparse: um campo vetorial reservado para armazenar embeddings esparsas geradas internamente para operações de pesquisa de texto completo. O tipo de dados deve serSPARSE_FLOAT_VECTOR.
Definir a função BM25
A função BM25 converte texto tokenizado em vetores esparsos que suportam a pontuação BM25.
Defina a função e adicione-a ao seu esquema:
bm25_function = Function(
    name="text_bm25_emb", # Function name
    input_field_names=["text"], # Name of the VARCHAR or TEXT field containing raw text data
    output_field_names=["sparse"], # Name of the SPARSE_FLOAT_VECTOR field reserved to store generated embeddings
    function_type=FunctionType.BM25, # Set to `BM25`
)

schema.add_function(bm25_function)
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.CreateCollectionReq.Function;

import java.util.*;

schema.addFunction(Function.builder()
        .functionType(FunctionType.BM25)
        .name("text_bm25_emb")
        .inputFieldNames(Collections.singletonList("text"))
        .outputFieldNames(Collections.singletonList("sparse"))
        .build());
function := entity.NewFunction().
    WithName("text_bm25_emb").
    WithInputFields("text").
    WithOutputFields("sparse").
    WithType(entity.FunctionTypeBM25)
schema.WithFunction(function)
const functions = [
    {
      name: 'text_bm25_emb',
      description: 'bm25 function',
      type: FunctionType.BM25,
      input_field_names: ['text'],
      output_field_names: ['sparse'],
      params: {},
    },
];
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true
                }
            },
            {
                "fieldName": "sparse",
                "dataType": "SparseFloatVector"
            }
        ],
        "functions": [
            {
                "name": "text_bm25_emb",
                "type": "BM25",
                "inputFieldNames": ["text"],
                "outputFieldNames": ["sparse"],
                "params": {}
            }
        ]
    }'
Parâmetro |
Descrição |
|---|---|
|
O nome da função. Esta função converte o seu texto bruto do campo « |
|
O nome do campo « |
|
O nome do campo onde os vetores esparsos gerados internamente serão armazenados. Para « |
|
O tipo da função a utilizar. Deve ser ` |
Se vários campos de texto necessitarem de processamento BM25, defina uma função BM25 por campo, cada uma com um nome e um campo de saída únicos.
Configurar o índice
Após definir o esquema com os campos necessários e a função incorporada, configure o índice para a sua coleção.
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="sparse",

    index_type="SPARSE_INVERTED_INDEX",
    metric_type="BM25",
    params={
        "inverted_index_algo": "DAAT_MAXSCORE",
        "bm25_k1": 1.2,
        "bm25_b": 0.75
    }

)
import io.milvus.v2.common.IndexParam;

Map<String,Object> params = new HashMap<>();
params.put("inverted_index_algo", "DAAT_MAXSCORE");
params.put("bm25_k1", 1.2);
params.put("bm25_b", 0.75);

List<IndexParam> indexes = new ArrayList<>();
indexes.add(IndexParam.builder()
        .fieldName("sparse")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.BM25)
        .extraParams(params)
        .build());
indexOption := milvusclient.NewCreateIndexOption("my_collection", "sparse",
    index.NewAutoIndex(entity.MetricType(entity.BM25)))
    .WithExtraParam("inverted_index_algo", "DAAT_MAXSCORE")
    .WithExtraParam("bm25_k1", 1.2)
    .WithExtraParam("bm25_b", 0.75)
const index_params = [
  {
    field_name: "sparse",
    metric_type: "BM25",
    index_type: "SPARSE_INVERTED_INDEX",
    params: {
        "inverted_index_algo": "DAAT_MAXSCORE",
        "bm25_k1": 1.2,
        "bm25_b": 0.75
    }
  },
];
export indexParams='[
        {
            "fieldName": "sparse",
            "metricType": "BM25",
            "indexType": "AUTOINDEX",
            "params":{
               "inverted_index_algo": "DAAT_MAXSCORE",
               "bm25_k1": 1.2,
               "bm25_b": 0.75
            }
        }
    ]'
Parâmetro |
Descrição |
|---|---|
|
O nome do campo vetorial a indexar. Para a pesquisa de texto completo, este deve ser o campo que armazena os vetores esparsos gerados. Neste exemplo, defina o valor como |
|
O tipo de índice a criar. Para a pesquisa de texto completo BM25 no Milvus, defina este valor como |
|
O valor deste parâmetro deve ser definido como « |
|
Um dicionário de parâmetros adicionais específicos do índice. |
|
O algoritmo utilizado para construir e consultar o índice invertido esparso BM25. Valores válidos:
|
|
Controla a saturação da frequência dos termos. Valores mais elevados aumentam a importância das frequências dos termos na classificação dos documentos. Intervalo recomendado: [1,2; 2,0]. Valor predefinido: 1,2. |
|
Controla o grau de normalização do comprimento do documento. Normalmente, são utilizados valores entre 0 e 1, sendo o valor predefinido 0,75. Um valor de 0 significa que não há normalização do comprimento, enquanto um valor de 1 significa normalização total do comprimento. |
Criar a coleção
Crie agora a coleção utilizando o esquema e os parâmetros de índice definidos.
client.create_collection(
    collection_name='my_collection',
    schema=schema,
    index_params=index_params
)
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
await client.create_collection(
    collection_name: 'my_collection',
    schema: schema,
    index_params: index_params,
    functions: functions
);
export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
Inserir dados de texto
Depois de configurar a sua coleção e o índice, está pronto para inserir dados de texto. Neste processo, basta fornecer o texto bruto. A função integrada que definimos anteriormente gera automaticamente o vetor esparso correspondente para cada entrada de texto.
client.insert('my_collection', [
    {'text': 'information retrieval is a field of study.'},
    {'text': 'information retrieval focuses on finding relevant information in large datasets.'},
    {'text': 'data mining and information retrieval overlap in research.'},
])
import com.google.gson.Gson;
import com.google.gson.JsonObject;

import io.milvus.v2.service.vector.request.InsertReq;

Gson gson = new Gson();
List<JsonObject> rows = Arrays.asList(
        gson.fromJson("{\"text\": \"information retrieval is a field of study.\"}", JsonObject.class),
        gson.fromJson("{\"text\": \"information retrieval focuses on finding relevant information in large datasets.\"}", JsonObject.class),
        gson.fromJson("{\"text\": \"data mining and information retrieval overlap in research.\"}", JsonObject.class)
);

client.insert(InsertReq.builder()
        .collectionName("my_collection")
        .data(rows)
        .build());
// go
await client.insert({
collection_name: 'my_collection',
data: [
    {'text': 'information retrieval is a field of study.'},
    {'text': 'information retrieval focuses on finding relevant information in large datasets.'},
    {'text': 'data mining and information retrieval overlap in research.'},
]);
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "data": [
        {"text": "information retrieval is a field of study."},
        {"text": "information retrieval focuses on finding relevant information in large datasets."},
        {"text": "data mining and information retrieval overlap in research."}
    ],
    "collectionName": "my_collection"
}'
Efetuar pesquisa de texto completo
Depois de inserir dados na sua coleção, pode realizar pesquisas de texto completo utilizando consultas de texto bruto. O Milvus converte automaticamente a sua consulta num vetor esparso e classifica os resultados da pesquisa correspondentes utilizando o algoritmo BM25, devolvendo depois os resultados topK (limit).
Pode destacar os termos correspondentes nos resultados da pesquisa configurando um realçador de texto. Consulte Realçador de texto para obter mais detalhes.
res = client.search(
    collection_name='my_collection',
    data=['whats the focus of information retrieval?'],
    anns_field='sparse',
    output_fields=['text'], # Fields to return in search results; sparse field cannot be output
    limit=3,
)

print(res)
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.EmbeddedText;
import io.milvus.v2.service.vector.response.SearchResp;

Map<String,Object> searchParams = new HashMap<>();

SearchResp searchResp = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(new EmbeddedText("whats the focus of information retrieval?")))
        .annsField("sparse")
        .topK(3)
        .searchParams(searchParams)
        .outputFields(Collections.singletonList("text"))
        .build());
annSearchParams := index.NewCustomAnnParam()
resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    3,               // limit
    []entity.Vector{entity.Text("whats the focus of information retrieval?")},
).WithConsistencyLevel(entity.ClStrong).
    WithANNSField("sparse").
    WithAnnParam(annSearchParams).
    WithOutputFields("text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("text: ", resultSet.GetColumn("text").FieldData().GetScalars())
}
await client.search(
    collection_name: 'my_collection',
    data: ['whats the focus of information retrieval?'],
    anns_field: 'sparse',
    output_fields: ['text'],
    limit: 3,
)
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
--data-raw '{
    "collectionName": "my_collection",
    "data": [
        "whats the focus of information retrieval?"
    ],
    "annsField": "sparse",
    "limit": 3,
    "outputFields": [
        "text"
    ],
    "searchParams":{
        "params":{}
    }
}'
Parâmetro |
Descrição |
|---|---|
|
Um dicionário que contém parâmetros de pesquisa. |
|
Proporção de termos de baixa importância a ignorar durante a pesquisa. O valor deve estar no intervalo [0,0; 1,0). Para mais detalhes, consulte «Vetor esparso». |
|
Texto bruto da consulta em linguagem natural. O Milvus converte automaticamente a sua consulta de texto em vetores esparsos utilizando a função BM25 — não forneça vetores pré-calculados. |
|
O nome do campo que contém vetores esparsos gerados internamente. |
|
Lista de nomes de campos a devolver nos resultados da pesquisa. Suporta todos os campos, exceto o campo de vetores esparsos que contém embeddings gerados pelo BM25. Os campos de saída comuns incluem o campo da chave primária (por exemplo, |
|
Número máximo de correspondências principais a devolver. |
Perguntas Frequentes
Posso obter ou aceder aos vetores esparsos gerados pela função BM25 na pesquisa de texto completo?
Não, os vetores esparsos gerados pela função BM25 não são diretamente acessíveis nem podem ser apresentados na pesquisa de texto completo. Aqui estão os detalhes:
A função BM25 gera vetores esparsos internamente para classificação e recuperação
Estes vetores são armazenados no campo «sparse», mas não podem ser incluídos em
output_fieldsSó é possível apresentar os campos de texto originais e os metadados (como
id,text)
Exemplo:
# ❌ This throws an error - you cannot output the sparse field
client.search(
    collection_name='my_collection',
    data=['query text'],
    anns_field='sparse',
    output_fields=['text', 'sparse']  # 'sparse' causes an error
    limit=3,
    search_params=search_params
)

# ✅ This works - output text fields only
client.search(
    collection_name='my_collection',
    data=['query text'],
    anns_field='sparse',
    output_fields=['text']
    limit=3,
    search_params=search_params
)
Por que razão preciso de definir um campo de vetor esparso se não posso aceder ao mesmo?
O campo de vetor esparso funciona como um índice de pesquisa interno, semelhante aos índices de bases de dados com os quais os utilizadores não interagem diretamente.
Fundamentação do projeto:
Separação de preocupações: o utilizador trabalha com texto (entrada/saída), enquanto o Milvus lida com vetores (processamento interno)
Desempenho: Os vetores esparsos pré-calculados permitem uma classificação BM25 rápida durante as consultas
Experiência do utilizador: Abstraí as operações vetoriais complexas por trás de uma interface de texto simples
Se precisar de aceder aos vetores:
Utilize operações manuais com vetores esparsos em vez da pesquisa de texto completo
Crie coleções separadas para fluxos de trabalho personalizados com vetores esparsos
Para mais detalhes, consulte «Vetor Esparso».
