

다중 벡터 하이브리드 검색
많은 애플리케이션에서 개체는 제목, 설명과 같은 다양한 정보 또는 텍스트, 이미지, 오디오와 같은 여러 양식으로 검색될 수 있습니다. 예를 들어, 텍스트와 이미지가 포함된 트윗의 경우 텍스트나 이미지 중 하나가 검색 쿼리의 의미와 일치하면 검색됩니다. 하이브리드 검색은 이러한 다양한 분야의 검색을 결합하여 검색 경험을 향상시킵니다. 밀버스는 여러 벡터 필드에 대한 검색을 허용하고 여러 개의 근사 이웃(ANN) 검색을 동시에 수행함으로써 이를 지원합니다. 다중 벡터 하이브리드 검색은 텍스트와 이미지, 동일한 객체를 설명하는 여러 텍스트 필드 또는 검색 품질을 개선하기 위해 조밀하고 희박한 벡터를 모두 검색하려는 경우에 특히 유용합니다.
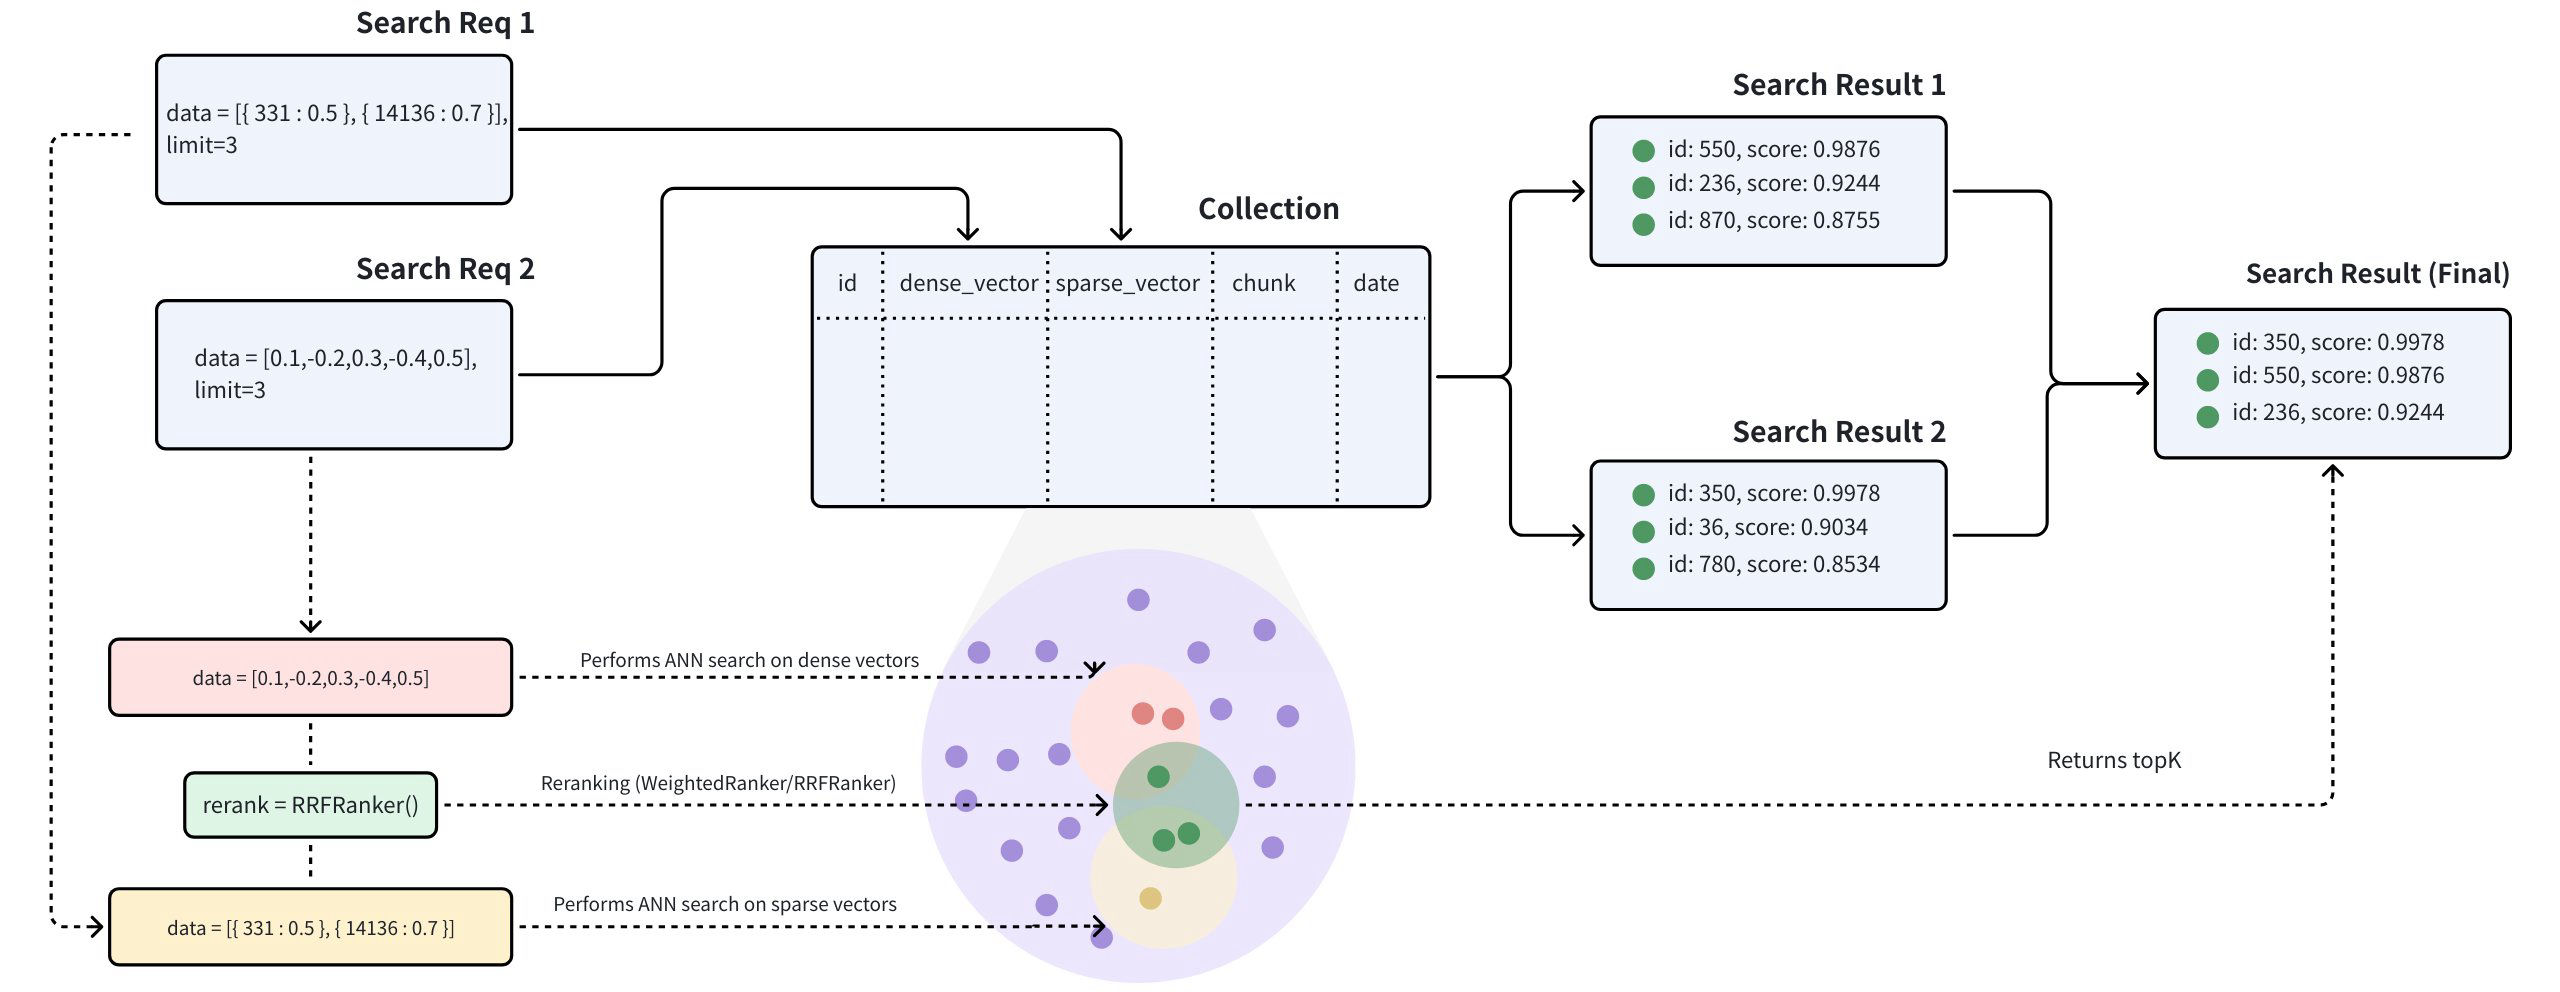 하이브리드 검색 워크플로
다중 벡터 하이브리드 검색은 서로 다른 검색 방법을 통합하거나 다양한 양식의 임베딩을 포괄합니다:
스파스-밀도 벡터 검색: 고밀도 벡터는 의미론적 관계를 포착하는 데 탁월한 반면, 스파스 벡터는 정확한 키워드 매칭에 매우 효과적입니다. 하이브리드 검색은 이러한 접근 방식을 결합하여 폭넓은 개념 이해와 정확한 용어 관련성을 모두 제공함으로써 검색 결과를 개선합니다. 하이브리드 검색은 각 방법의 강점을 활용함으로써 개별 접근 방식의 한계를 극복하고 복잡한 쿼리에 대해 더 나은 성능을 제공합니다. 시맨틱 검색과 전체 텍스트 검색을 결합한 하이브리드 검색에 대한 자세한 가이드는 다음과 같습니다.
멀티모달 벡터 검색: 멀티모달 벡터 검색은 텍스트, 이미지, 오디오 등 다양한 데이터 유형에 걸쳐 검색할 수 있는 강력한 기술입니다. 이 접근 방식의 가장 큰 장점은 다양한 방식을 매끄럽고 일관된 검색 환경으로 통합할 수 있다는 점입니다. 예를 들어, 제품 검색에서 사용자가 텍스트 쿼리를 입력하면 텍스트와 이미지로 설명된 제품을 모두 찾을 수 있습니다. 하이브리드 검색 방식을 통해 이러한 검색 방식을 결합하면 검색 정확도를 높이거나 검색 결과를 더욱 풍부하게 만들 수 있습니다.
예시
각 제품에 텍스트 설명과 이미지가 포함되어 있는 실제 사용 사례를 고려해 보겠습니다. 사용 가능한 데이터를 기반으로 세 가지 유형의 검색을 수행할 수 있습니다:
시맨틱 텍스트 검색: 여기에는 고밀도 벡터를 사용하여 제품의 텍스트 설명을 쿼리하는 것이 포함됩니다. 텍스트 임베딩은 BERT, Transformers와 같은 모델이나 OpenAI와 같은 서비스를 사용하여 생성할 수 있습니다.
전체 텍스트 검색: 여기서는 희소 벡터와 키워드 일치를 사용하여 제품의 텍스트 설명을 쿼리합니다. 이를 위해 BM25와 같은 알고리즘이나 BGE-M3 또는 SPLADE와 같은 스파스 임베딩 모델을 활용할 수 있습니다.
멀티모달 이미지 검색: 이 방법은 고밀도 벡터가 포함된 텍스트 쿼리를 사용하여 이미지를 쿼리합니다. 이미지 임베딩은 CLIP과 같은 모델을 사용하여 생성할 수 있습니다.
이 가이드에서는 제품의 원시 텍스트 설명과 이미지 임베딩이 주어졌을 때 위의 검색 방법을 결합한 멀티모달 하이브리드 검색의 예시를 안내합니다. 다중 벡터 데이터를 저장하고 재랭크 전략으로 하이브리드 검색을 수행하는 방법을 보여드리겠습니다.
여러 벡터 필드가 있는 컬렉션 만들기
컬렉션을 만드는 과정에는 컬렉션 스키마 정의, 인덱스 매개변수 구성, 컬렉션 생성의 세 가지 주요 단계가 포함됩니다.
스키마 정의
다중 벡터 하이브리드 검색의 경우, 컬렉션 스키마 내에 여러 개의 벡터 필드를 정의해야 합니다. 기본적으로 각 컬렉션은 최대 4개의 벡터 필드를 수용할 수 있습니다. 그러나 필요한 경우 필요에 따라 컬렉션에 최대 10개의 벡터 필드를 포함하도록 proxy.maxVectorFieldNum 을 조정할 수 있습니다.
이 예에서는 다음 필드를 스키마에 통합합니다:
id: 텍스트 ID를 저장하는 기본 키 역할을 합니다. 이 필드의 데이터 유형은INT64입니다.text: 텍스트 콘텐츠를 저장하는 데 사용됩니다. 이 필드는 최대 길이가 1000바이트인VARCHAR데이터 유형입니다.enable_analyzer옵션은 전체 텍스트 검색을 용이하게 하기 위해True으로 설정됩니다.text_dense: 텍스트의 고밀도 벡터를 저장하는 데 사용됩니다. 이 필드는 벡터 크기가 768인 데이터 유형FLOAT_VECTOR입니다.text_sparse: 텍스트의 스파스 벡터를 저장하는 데 사용됩니다. 이 필드는 데이터 유형SPARSE_FLOAT_VECTOR.image_dense: 제품 이미지의 고밀도 벡터를 저장하는 데 사용됩니다. 이 필드는 벡터 차원이 512인 데이터 유형FLOAT_VETOR입니다.
텍스트 필드에서 전체 텍스트 검색을 수행하기 위해 기본 제공 BM25 알고리즘을 사용하므로 스키마에 Milvus Function 를 추가해야 합니다. 자세한 내용은 전체 텍스트 검색을 참조하세요.
from pymilvus import (
    MilvusClient, DataType, Function, FunctionType
)

client = MilvusClient(
    uri="http://localhost:19530",
    token="root:Milvus"
)

# Init schema with auto_id disabled
schema = MilvusClient.create_schema(auto_id=False)

# Add fields to schema
schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True, description="product id")
schema.add_field(field_name="text", datatype=DataType.VARCHAR, max_length=1000, enable_analyzer=True, description="raw text of product description")
schema.add_field(field_name="text_dense", datatype=DataType.FLOAT_VECTOR, dim=768, description="text dense embedding")
schema.add_field(field_name="text_sparse", datatype=DataType.SPARSE_FLOAT_VECTOR, description="text sparse embedding auto-generated by the built-in BM25 function")
schema.add_field(field_name="image_dense", datatype=DataType.FLOAT_VECTOR, dim=512, description="image dense embedding")

# Add function to schema
bm25_function = Function(
    name="text_bm25_emb",
    input_field_names=["text"],
    output_field_names=["text_sparse"],
    function_type=FunctionType.BM25,
)
schema.add_function(bm25_function)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq.Function;

import java.util.*;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .token("root:Milvus")
        .build());

CreateCollectionReq.CollectionSchema schema = client.createSchema();

schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(false)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("text_dense")
        .dataType(DataType.FloatVector)
        .dimension(768)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("text_sparse")
        .dataType(DataType.SparseFloatVector)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("image_dense")
        .dataType(DataType.FloatVector)
        .dimension(512)
        .build());

schema.addFunction(Function.builder()
        .functionType(FunctionType.BM25)
        .name("text_bm25_emb")
        .inputFieldNames(Collections.singletonList("text"))
        .outputFieldNames(Collections.singletonList("text_sparse"))
        .build());
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

function := entity.NewFunction().
    WithName("text_bm25_emb").
    WithInputFields("text").
    WithOutputFields("text_sparse").
    WithType(entity.FunctionTypeBM25)

schema := entity.NewSchema()

schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true),
).WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithMaxLength(1000),
).WithField(entity.NewField().
    WithName("text_dense").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(768),
).WithField(entity.NewField().
    WithName("text_sparse").
    WithDataType(entity.FieldTypeSparseVector),
).WithField(entity.NewField().
    WithName("image_dense").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(512),
).WithFunction(function)
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const address = "http://localhost:19530";
const token = "root:Milvus";
const client = new MilvusClient({address, token});

// Define fields
const fields = [
    {
        name: "id",
        data_type: DataType.Int64,
        is_primary_key: true,
        auto_id: false
    },
    {
        name: "text",
        data_type: DataType.VarChar,
        max_length: 1000,
        enable_match: true
    },
    {
        name: "text_dense",
        data_type: DataType.FloatVector,
        dim: 768
    },
    {
        name: "text_sparse",
        data_type: DataType.SPARSE_FLOAT_VECTOR
    },
    {
        name: "image_dense",
        data_type: DataType.FloatVector,
        dim: 512
    }
];

// define function
const functions = [
    {
      name: "text_bm25_emb",
      description: "text bm25 function",
      type: FunctionType.BM25,
      input_field_names: ["text"],
      output_field_names: ["text_sparse"],
      params: {},
    },
];
export bm25Function='{
    "name": "text_bm25_emb",
    "type": "BM25",
    "inputFieldNames": ["text"],
    "outputFieldNames": ["text_sparse"],
    "params": {}
}'

export schema='{
        "autoId": false,
        "functions": [$bm25Function],
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true
                }
            },
            {
                "fieldName": "text_dense",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "768"
                }
            },
            {
                "fieldName": "text_sparse",
                "dataType": "SparseFloatVector"
            },
            {
                "fieldName": "image_dense",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "512"
                }
            }
        ]
    }'
색인 생성
from pymilvus import MilvusClient

# Prepare index parameters
index_params = client.prepare_index_params()

# Add indexes
index_params.add_index(
    field_name="text_dense",
    index_name="text_dense_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)

index_params.add_index(
    field_name="text_sparse",
    index_name="text_sparse_index",
    index_type="SPARSE_INVERTED_INDEX",
    metric_type="BM25",
    params={"inverted_index_algo": "DAAT_MAXSCORE"}, # or "DAAT_WAND" or "TAAT_NAIVE"
)

index_params.add_index(
    field_name="image_dense",
    index_name="image_dense_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)
import io.milvus.v2.common.IndexParam;
import java.util.*;

Map<String, Object> denseParams = new HashMap<>();

IndexParam indexParamForTextDense = IndexParam.builder()
        .fieldName("text_dense")
        .indexName("text_dense_index")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build();

Map<String, Object> sparseParams = new HashMap<>();
sparseParams.put("inverted_index_algo": "DAAT_MAXSCORE");
IndexParam indexParamForTextSparse = IndexParam.builder()
        .fieldName("text_sparse")
        .indexName("text_sparse_index")
        .indexType(IndexParam.IndexType.SPARSE_INVERTED_INDEX)
        .metricType(IndexParam.MetricType.BM25)
        .extraParams(sparseParams)
        .build();

IndexParam indexParamForImageDense = IndexParam.builder()
        .fieldName("image_dense")
        .indexName("image_dense_index")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build();

List<IndexParam> indexParams = new ArrayList<>();
indexParams.add(indexParamForTextDense);
indexParams.add(indexParamForTextSparse);
indexParams.add(indexParamForImageDense);
indexOption1 := milvusclient.NewCreateIndexOption("my_collection", "text_dense",
    index.NewAutoIndex(index.MetricType(entity.IP)))
indexOption2 := milvusclient.NewCreateIndexOption("my_collection", "text_sparse",
    index.NewSparseInvertedIndex(entity.BM25, 0.2))
indexOption3 := milvusclient.NewCreateIndexOption("my_collection", "image_dense",
    index.NewAutoIndex(index.MetricType(entity.IP)))
)
const index_params = [{
    field_name: "text_dense",
    index_name: "text_dense_index",
    index_type: "AUTOINDEX",
    metric_type: "IP"
},{
    field_name: "text_sparse",
    index_name: "text_sparse_index",
    index_type: "IndexType.SPARSE_INVERTED_INDEX",
    metric_type: "BM25",
    params: {
      inverted_index_algo: "DAAT_MAXSCORE",
    }
},{
    field_name: "image_dense",
    index_name: "image_dense_index",
    index_type: "AUTOINDEX",
    metric_type: "IP"
}]
export indexParams='[
        {
            "fieldName": "text_dense",
            "metricType": "IP",
            "indexName": "text_dense_index",
            "indexType":"AUTOINDEX"
        },
        {
            "fieldName": "text_sparse",
            "metricType": "BM25",
            "indexName": "text_sparse_index",
            "indexType": "SPARSE_INVERTED_INDEX",
            "params":{"inverted_index_algo": "DAAT_MAXSCORE"}
        },
        {
            "fieldName": "image_dense",
            "metricType": "IP",
            "indexName": "image_dense_index",
            "indexType":"AUTOINDEX"
        }
    ]'
컬렉션 만들기
앞의 두 단계에서 구성한 컬렉션 스키마와 인덱스를 사용하여 demo 이라는 이름의 컬렉션을 생성합니다.
from pymilvus import MilvusClient

client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
CreateCollectionReq createCollectionReq = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexParams)
        .build();
client.createCollection(createCollectionReq);
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption1, indexOption2))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
res = await client.createCollection({
    collection_name: "my_collection",
    fields: fields,
    index_params: index_params,
})
export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
데이터 삽입
이 섹션에서는 앞서 정의한 스키마에 따라 my_collection 컬렉션에 데이터를 삽입합니다. 삽입하는 동안 자동 생성된 값이 있는 필드를 제외한 모든 필드에 올바른 형식의 데이터가 제공되는지 확인합니다. 이 예제에서는
id: 제품 ID를 나타내는 정수text: 제품 설명이 포함된 문자열text_dense텍스트 설명의 밀집 임베딩을 나타내는 768개의 부동 소수점 값 목록image_dense제품 이미지의 조밀 임베딩을 나타내는 512개의 부동 소수점 값 목록입니다.
각 필드에 대해 동일하거나 다른 모델을 사용하여 고밀도 임베딩을 생성할 수 있습니다. 이 예제에서는 두 개의 고밀도 임베딩의 크기가 다르므로 서로 다른 모델에서 생성되었음을 알 수 있습니다. 나중에 각 검색을 정의할 때는 해당 모델을 사용하여 적절한 쿼리 임베딩을 생성해야 합니다.
이 예에서는 기본 제공 BM25 함수를 사용하여 텍스트 필드에서 스파스 임베딩을 생성하므로 스파스 벡터를 수동으로 제공할 필요가 없습니다. 그러나 BM25를 사용하지 않으려면 스파스 임베딩을 직접 미리 계산하여 제공해야 합니다.
from pymilvus import MilvusClient

data=[
    {
        "id": 0,
        "text": "Red cotton t-shirt with round neck",
        "text_dense": [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...],
        "image_dense": [0.6366019600530924, -0.09323198122475052, ...]
    },
    {
        "id": 1,
        "text": "Wireless noise-cancelling over-ear headphones",
        "text_dense": [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...],
        "image_dense": [0.6414180010301553, 0.8976979978567611, ...]
    },
    {
        "id": 2,
        "text": "Stainless steel water bottle, 500ml",
        "dense": [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...],
        "image_dense": [-0.6901259768402174, 0.6100500332193755, ...]
    }
]

res = client.insert(
    collection_name="my_collection",
    data=data
)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;

Gson gson = new Gson();
JsonObject row1 = new JsonObject();
row1.addProperty("id", 0);
row1.addProperty("text", "Red cotton t-shirt with round neck");
row1.add("text_dense", gson.toJsonTree(text_dense1));
row1.add("image_dense", gson.toJsonTree(image_dense));

JsonObject row2 = new JsonObject();
row2.addProperty("id", 1);
row2.addProperty("text", "Wireless noise-cancelling over-ear headphones");
row2.add("text_dense", gson.toJsonTree(text_dense2));
row2.add("image_dense", gson.toJsonTree(image_dense2));

JsonObject row3 = new JsonObject();
row3.addProperty("id", 2);
row3.addProperty("text", "Stainless steel water bottle, 500ml");
row3.add("text_dense", gson.toJsonTree(dense3));
row3.add("image_dense", gson.toJsonTree(sparse3));

List<JsonObject> data = Arrays.asList(row1, row2, row3);
InsertReq insertReq = InsertReq.builder()
        .collectionName("my_collection")
        .data(data)
        .build();

InsertResp insertResp = client.insert(insertReq);
_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("my_collection").
    WithInt64Column("id", []int64{0, 1, 2}).
    WithVarcharColumn("text", []string{
        "Red cotton t-shirt with round neck",
        "Wireless noise-cancelling over-ear headphones",
        "Stainless steel water bottle, 500ml",
    }).
    WithFloatVectorColumn("text_dense", 768, [][]float32{
        {0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...},
        {0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...},
        {0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...},
    }).
    WithFloatVectorColumn("image_dense", 512, [][]float32{
        {0.6366019600530924, -0.09323198122475052, ...},
        {0.6414180010301553, 0.8976979978567611, ...},
        {-0.6901259768402174, 0.6100500332193755, ...},
    }).
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
const { MilvusClient, DataType } = require("@zilliz/milvus2-sdk-node")

var data = [
    {id: 0, text: "Red cotton t-shirt with round neck" , text_dense: [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...], image_dense: [0.6366019600530924, -0.09323198122475052, ...]},
    {id: 1, text: "Wireless noise-cancelling over-ear headphones" , text_dense: [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...], image_dense: [0.6414180010301553, 0.8976979978567611, ...]},
    {id: 2, text: "Stainless steel water bottle, 500ml" , text_dense: [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...], image_dense: [-0.6901259768402174, 0.6100500332193755, ...]}
]

var res = await client.insert({
    collection_name: "my_collection",
    data: data,
})
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
-d '{
    "data": [
        {"id": 0, "text": "Red cotton t-shirt with round neck" , "text_dense": [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...], "image_dense": [0.6366019600530924, -0.09323198122475052, ...]},
        {"id": 1, "text": "Wireless noise-cancelling over-ear headphones" , "text_dense": [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...], "image_dense": [0.6414180010301553, 0.8976979978567611, ...]},
        {"id": 2, "text": "Stainless steel water bottle, 500ml" , "text_dense": [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...], "image_dense": [-0.6901259768402174, 0.6100500332193755, ...]}
    ],
    "collectionName": "my_collection"
}'
하이브리드 검색 수행
여러 개의 AnnSearchRequest 인스턴스 생성하기
하이브리드 검색은 hybrid_search() 함수에 AnnSearchRequest 을 여러 개 생성하여 구현되며, 각 AnnSearchRequest 은 특정 벡터 필드에 대한 기본 ANN 검색 요청을 나타냅니다. 따라서 하이브리드 검색을 수행하기 전에 각 벡터 필드에 대해 AnnSearchRequest 을 생성해야 합니다.
또한 AnnSearchRequest 에서 expr 파라미터를 구성하여 하이브리드 검색의 필터링 조건을 설정할 수 있습니다. 필터링된 검색 및 필터링을 참조하세요.
하이브리드 검색에서 각 AnnSearchRequest 은 하나의 쿼리 데이터만 지원합니다.
다양한 검색 벡터 필드의 기능을 보여드리기 위해 샘플 쿼리를 사용하여 세 개의 AnnSearchRequest 검색 요청을 구성하겠습니다. 또한 이 과정에서 미리 계산된 고밀도 벡터를 사용합니다. 검색 요청은 다음 벡터 필드를 대상으로 합니다:
text_dense시맨틱 텍스트 검색의 경우, 직접적인 키워드 매칭이 아닌 의미를 기반으로 문맥을 이해하고 검색할 수 있도록 합니다.text_sparse전체 텍스트 검색 또는 키워드 검색의 경우, 텍스트 내의 정확한 단어나 구문 일치에 중점을 둡니다.image_dense멀티모달 텍스트-이미지 검색의 경우 쿼리의 의미론적 내용을 기반으로 관련 제품 이미지를 검색합니다.
from pymilvus import AnnSearchRequest

query_text = "white headphones, quiet and comfortable"
query_dense_vector = [0.3580376395471989, -0.6023495712049978, 0.5142999509918703, ...]
query_multimodal_vector = [0.015829865178701663, 0.5264158340734488, ...]

# text semantic search (dense)
search_param_1 = {
    "data": [query_dense_vector],
    "anns_field": "text_dense",
    "param": {"nprobe": 10},
    "limit": 2
}
request_1 = AnnSearchRequest(**search_param_1)

# full-text search (sparse)
search_param_2 = {
    "data": [query_text],
    "anns_field": "text_sparse",
    "limit": 2
}
request_2 = AnnSearchRequest(**search_param_2)

# text-to-image search (multimodal)
search_param_3 = {
    "data": [query_multimodal_vector],
    "anns_field": "image_dense",
    "param": {"nprobe": 10},
    "limit": 2
}
request_3 = AnnSearchRequest(**search_param_3)

reqs = [request_1, request_2, request_3]
import io.milvus.v2.service.vector.request.AnnSearchReq;
import io.milvus.v2.service.vector.request.data.BaseVector;
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.request.data.SparseFloatVec;
import io.milvus.v2.service.vector.request.data.EmbeddedText;

float[] queryDense = new float[]{-0.0475336798f,  0.0521207601f,  0.0904406682f, ...};
float[] queryMultimodal = new float[]{0.0158298651f, 0.5264158340f, ...}

List<BaseVector> queryTexts = Collections.singletonList(new EmbeddedText("white headphones, quiet and comfortable");)
List<BaseVector> queryDenseVectors = Collections.singletonList(new FloatVec(queryDense));
List<BaseVector> queryMultimodalVectors = Collections.singletonList(new FloatVec(queryMultimodal));

List<AnnSearchReq> searchRequests = new ArrayList<>();
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_dense")
        .vectors(queryDenseVectors)
        .params("{\"nprobe\": 10}")
        .topK(2)
        .build());
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_sparse")
        .vectors(queryTexts)
        .topK(2)
        .build());
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("image_dense")
        .vectors(queryMultimodalVectors)
        .params("{\"nprobe\": 10}")
        .topK(2)
        .build());
queryText := entity.Text({"white headphones, quiet and comfortable"})
queryVector := []float32{0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...}
queryMultimodalVector := []float32{0.015829865178701663, 0.5264158340734488, ...}

request1 := milvusclient.NewAnnRequest("text_dense", 2, entity.FloatVector(queryVector)).
    WithAnnParam(index.NewIvfAnnParam(10))

annParam := index.NewSparseAnnParam()
annParam.WithDropRatio(0.2)
request2 := milvusclient.NewAnnRequest("text_sparse", 2, queryText).
    WithAnnParam(annParam)

request3 := milvusclient.NewAnnRequest("image_dense", 2, entity.FloatVector(queryMultimodalVector)).
    WithAnnParam(index.NewIvfAnnParam(10))
const query_text = "white headphones, quiet and comfortable"
const query_vector = [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...]
const query_multimodal_vector = [0.015829865178701663, 0.5264158340734488, ...]

const search_param_1 = {
    "data": query_vector,
    "anns_field": "text_dense",
    "param": {"nprobe": 10},
    "limit": 2
}

const search_param_2 = {
    "data": query_text,
    "anns_field": "text_sparse",
    "limit": 2
}

const search_param_3 = {
    "data": query_multimodal_vector,
    "anns_field": "image_dense",
    "param": {"nprobe": 10},
    "limit": 2
}
export req='[
    {
        "data": [[0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...]],
        "annsField": "text_dense",
        "params": {"nprobe": 10},
        "limit": 2
    },
    {
        "data": ["white headphones, quiet and comfortable"],
        "annsField": "text_sparse",
        "limit": 2
    },
    {
        "data": [[0.015829865178701663, 0.5264158340734488, ...]],
        "annsField": "image_dense",
        "params": {"nprobe": 10},
        "limit": 2
    }
 ]'
limit 매개 변수가 2로 설정되어 있으면 AnnSearchRequest 각각 2개의 검색 결과를 반환합니다. 이 예에서는 3개의 AnnSearchRequest 인스턴스가 생성되어 총 6개의 검색 결과가 생성됩니다.
순위 재조정 전략 구성
ANN 검색 결과 집합을 병합하고 재랭크하려면 적절한 재랭크 전략을 선택하는 것이 필수적입니다. 밀버스는 두 가지 유형의 재랭크 전략을 제공합니다:
가중 순위: 결과에서 특정 벡터 필드를 강조해야 하는 경우 이 전략을 사용합니다. 가중랭커를 사용하면 특정 벡터 필드에 더 큰 가중치를 할당하여 더 눈에 띄게 강조할 수 있습니다.
RRFRanker(상호 순위 융합 랭커): 특별히 강조할 필요가 없는 경우 이 전략을 선택하세요. RRFRanker는 각 벡터 필드의 중요도를 효과적으로 균형 있게 조정합니다.
이러한 순위 재조정 메커니즘에 대한 자세한 내용은 순위 재조정을 참조하세요.
이 예제에서는 특정 검색 쿼리에 특별히 중점을 두지 않으므로 RRFRanker 전략을 진행하겠습니다.
from pymilvus import RRFRanker

ranker = RRFRanker(100)
import io.milvus.v2.service.vector.request.ranker.BaseRanker;
import io.milvus.v2.service.vector.request.ranker.RRFRanker;

BaseRanker reranker = new RRFRanker(100);
reranker := milvusclient.NewRRFReranker().WithK(100)
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const rerank = RRFRanker("100");
export rerank='{
        "strategy": "rrf",
        "params": { "k": 100}
    }'
하이브리드 검색 수행
하이브리드 검색을 시작하기 전에 컬렉션이 로드되었는지 확인합니다. 컬렉션 내의 벡터 필드에 인덱스가 없거나 메모리에 로드되지 않은 경우 하이브리드 검색 메서드를 실행할 때 오류가 발생합니다.
from pymilvus import MilvusClient

res = client.hybrid_search(
    collection_name="my_collection",
    reqs=reqs,
    ranker=ranker,
    limit=2
)
for hits in res:
    print("TopK results:")
    for hit in hits:
        print(hit)
import io.milvus.v2.common.ConsistencyLevel;
import io.milvus.v2.service.vector.request.HybridSearchReq;
import io.milvus.v2.service.vector.response.SearchResp;

HybridSearchReq hybridSearchReq = HybridSearchReq.builder()
        .collectionName("my_collection")
        .searchRequests(searchRequests)
        .ranker(reranker)
        .topK(2)
        .build();

SearchResp searchResp = client.hybridSearch(hybridSearchReq);
resultSets, err := client.HybridSearch(ctx, milvusclient.NewHybridSearchOption(
    "my_collection",
    2,
    request1,
    request2,
    request3,
).WithReranker(reranker))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
}
const { MilvusClient, DataType } = require("@zilliz/milvus2-sdk-node")

res = await client.loadCollection({
    collection_name: "my_collection"
})

import { MilvusClient, RRFRanker, WeightedRanker } from '@zilliz/milvus2-sdk-node';

const search = await client.search({
  collection_name: "my_collection",
  data: [search_param_1, search_param_2, search_param_3],
  limit: 2,
  rerank: rerank
});
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/advanced_search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
-d "{
    \"collectionName\": \"my_collection\",
    \"search\": ${req},
    \"rerank\": {
        \"strategy\":\"rrf\",
        \"params\": ${rerank}
    },
    \"limit\": 2
}"
다음은 출력입니다:
["['id: 1, distance: 0.006047376897186041, entity: {}', 'id: 2, distance: 0.006422005593776703, entity: {}']"]
하이브리드 검색에 limit=2 파라미터를 지정하면 Milvus는 세 가지 검색에서 얻은 여섯 가지 결과의 순위를 다시 매깁니다. 궁극적으로 가장 유사한 상위 두 개의 결과만 반환합니다.
