

텍스트 일치
Milvus의 텍스트 매치 기능은 특정 용어를 기반으로 정확한 문서 검색을 가능하게 합니다. 이 기능은 주로 특정 조건을 충족하는 필터링 검색에 사용되며, 스칼라 필터링을 통합하여 쿼리 결과를 정교화할 수 있어 스칼라 기준을 충족하는 벡터 내에서 유사도 검색을 수행할 수 있습니다.
TEXT_MATCH 정확한 분석 용어를 찾는 반면, ‘ TEXT_MATCH_FUZZY ’는 쿼리 토큰과 색인된 토큰 간의 약간의 편집 거리를 허용합니다. 두 기능 모두 부울 필터링 연산이며, 일치하는 문서의 관련성을 점수화하지 않습니다. 쿼리 용어의 의미적 함의와 중요도에 따라 가장 관련성이 높은 문서를 검색하려면 ‘전체 텍스트 검색(Full Text Search)’을 사용하는 것이 좋습니다.
개요
Milvus는 Tantivy를 통합하여 기본 역색인 및 용어 기반 텍스트 검색 기능을 지원합니다. Milvus는 각 텍스트 입력에 대해 다음 절차를 따라 색인을 생성합니다.
분석기(Analyzer): 분석기는 입력 텍스트를 개별 단어 또는 토큰으로 분할한 후, 필요에 따라 필터를 적용하여 처리합니다. 이를 통해 Milvus는 이러한 토큰을 기반으로 인덱스를 구축할 수 있습니다.
색인 생성: 텍스트 분석 후, Milvus는 각 고유 토큰을 해당 토큰이 포함된 문서에 매핑하는 역색인을 생성합니다.
사용자가 텍스트 일치를 수행하면, 역색인을 사용하여 해당 용어가 포함된 모든 문서를 신속하게 검색합니다. 이는 각 문서를 일일이 스캔하는 것보다 훨씬 빠릅니다.
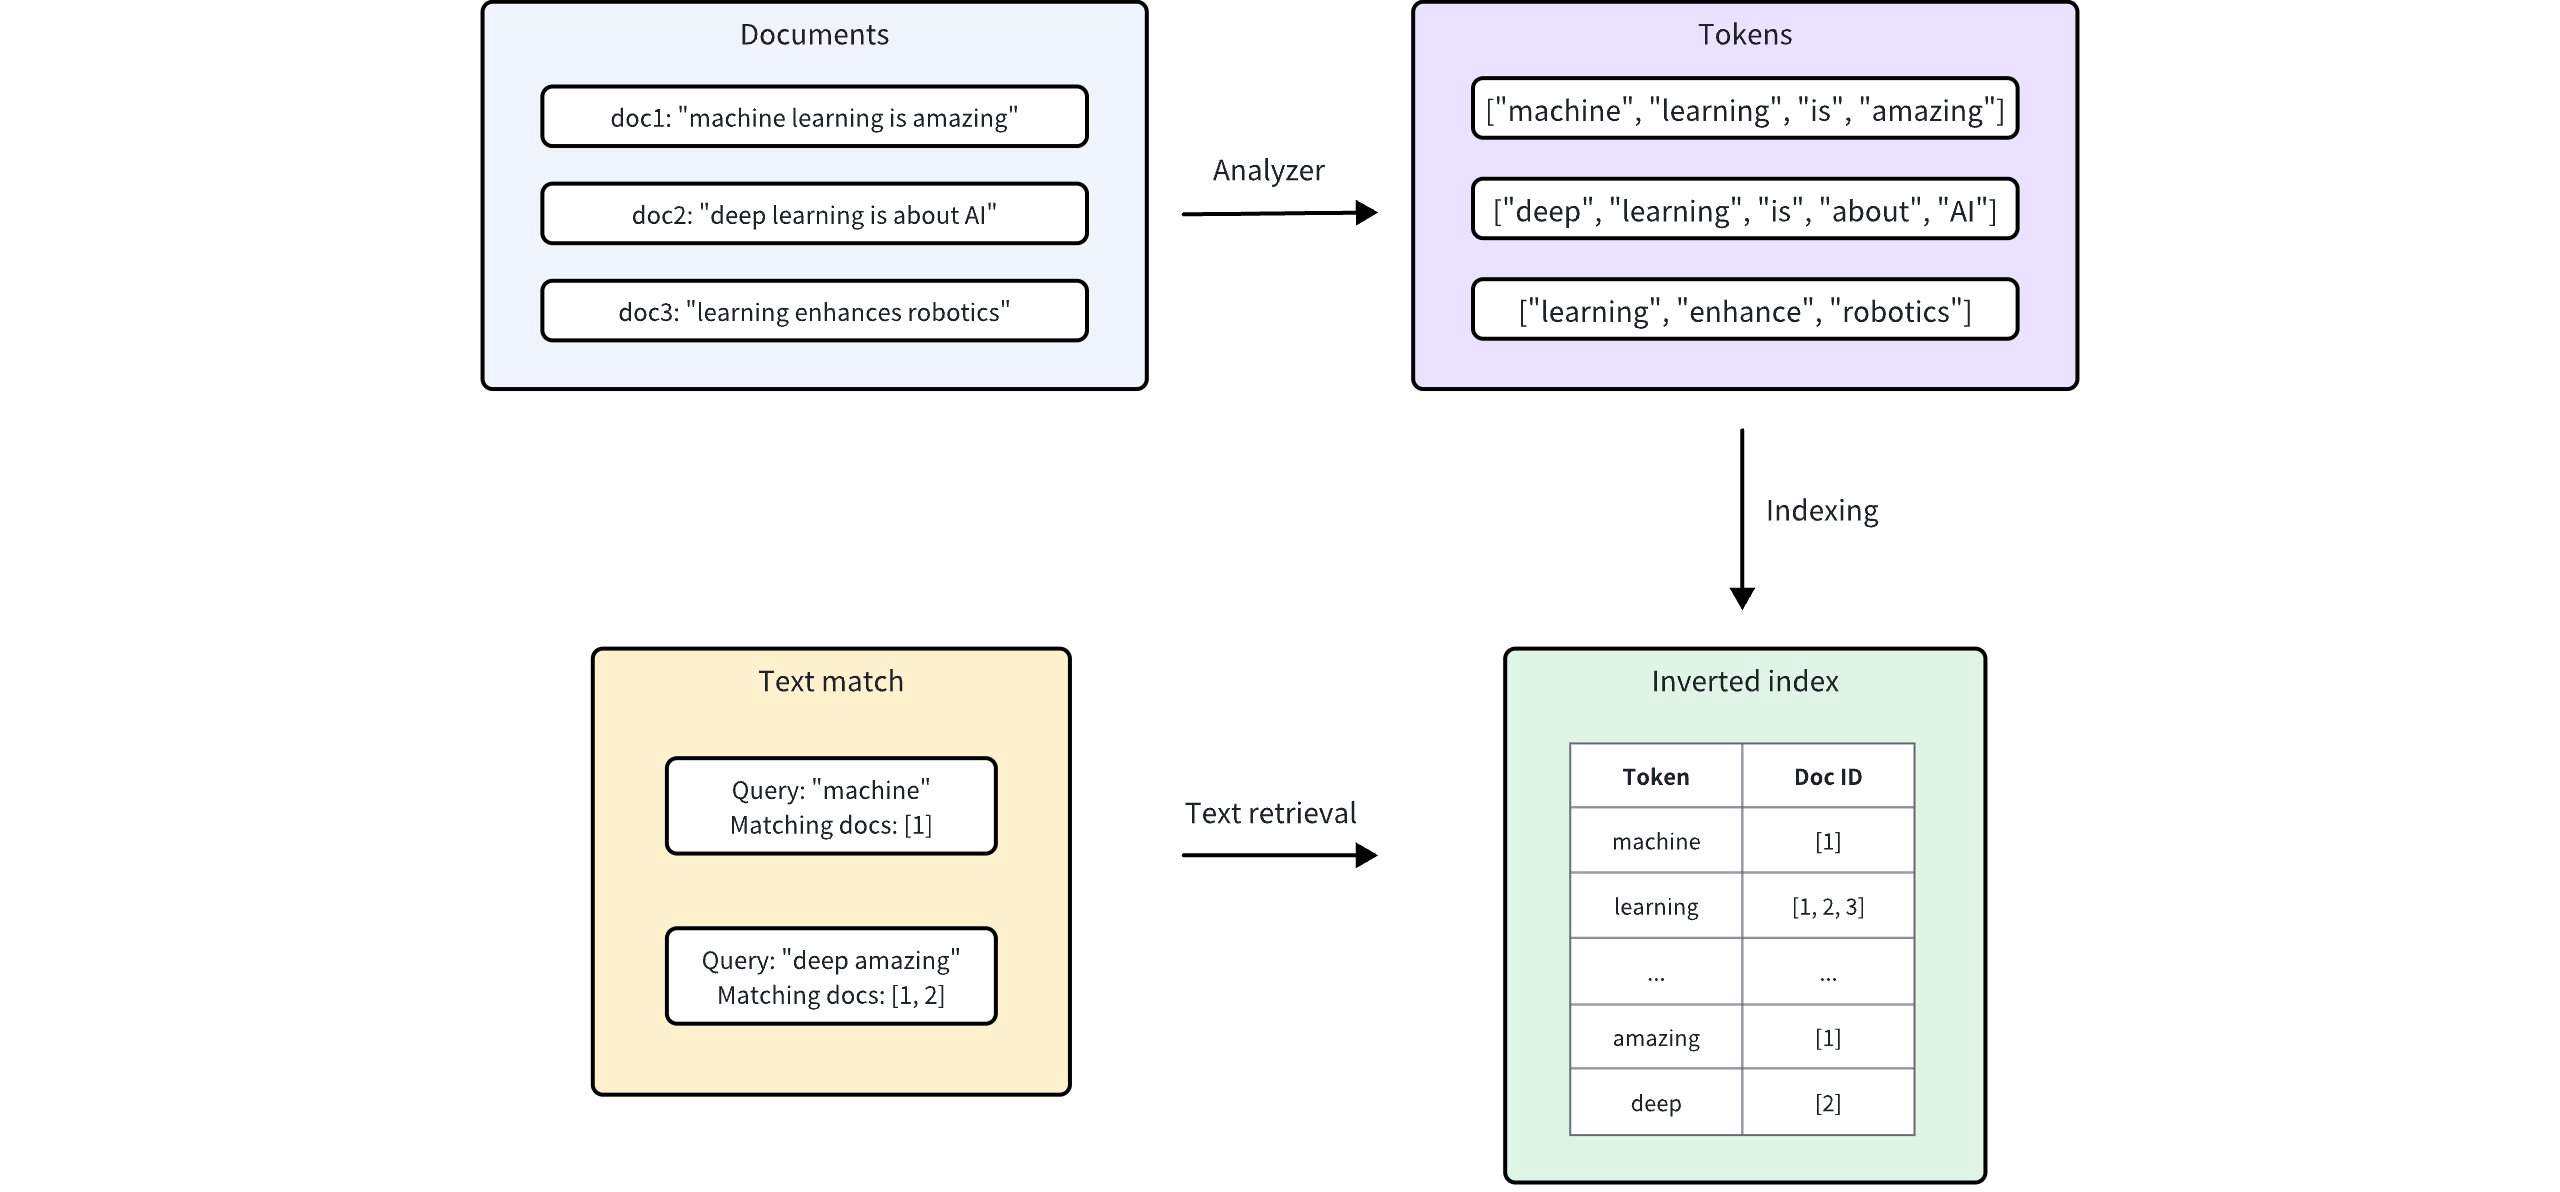 키워드 일치
텍스트 일치 활성화
텍스트 일치 기능은 일치가 활성화된 문자열 필드에서 작동합니다. 이 페이지의 예제에서는 VARCHAR를 사용하며, 이는 모든 클라이언트 SDK에서 지원됩니다. Milvus 3.0.x에서는 TEXT 필드도 Storage V3가 활성화된 경우 텍스트 일치를 지원합니다. 두 필드 유형 모두에서 ` enable_analyzer `과 ` enable_match `을 모두 ` True`으로 설정한 다음, 컬렉션 스키마를 정의할 때 선택적으로 분석기를 구성할 수 있습니다.
enable_analyzer 및 enable_match
특정 VARCHAR 필드에 대해 텍스트 일치를 활성화하려면, 필드 스키마를 정의할 때 enable_analyzer 및 enable_match 매개변수를 모두 True 로 설정하십시오. 이렇게 하면 Milvus가 텍스트를 토큰화하고 지정된 필드에 대한 역색인을 생성하여 빠르고 효율적인 텍스트 일치를 수행할 수 있습니다.
from pymilvus import MilvusClient, DataType

schema = MilvusClient.create_schema(enable_dynamic_field=False)
schema.add_field(
    field_name="id",
    datatype=DataType.INT64,
    is_primary=True,
    auto_id=True
)
schema.add_field(
    field_name='text',
    datatype=DataType.VARCHAR,
    max_length=1000,
    enable_analyzer=True, # Whether to enable text analysis for this field
    enable_match=True # Whether to enable text match
)
schema.add_field(
    field_name="embeddings",
    datatype=DataType.FLOAT_VECTOR,
    dim=5
)
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .enableDynamicField(false)
        .build();
schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .enableMatch(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("embeddings")
        .dataType(DataType.FloatVector)
        .dimension(5)
        .build());
import "github.com/milvus-io/milvus/client/v2/entity"

schema := entity.NewSchema().WithDynamicFieldEnabled(false)
schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(true),
).WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithEnableMatch(true).
    WithMaxLength(1000),
).WithField(entity.NewField().
    WithName("embeddings").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(5),
)
const schema = [
  {
    name: "id",
    data_type: DataType.Int64,
    is_primary_key: true,
  },
  {
    name: "text",
    data_type: "VarChar",
    enable_analyzer: true,
    enable_match: true,
    max_length: 1000,
  },
  {
    name: "embeddings",
    data_type: DataType.FloatVector,
    dim: 5,
  },
];
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true,
                    "enable_match": true
                }
            },
            {
                "fieldName": "embeddings",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "5"
                }
            }
        ]
    }'
선택 사항: 분석기 구성
키워드 일치 검색의 성능과 정확도는 선택한 분석기에 따라 달라집니다. 분석기는 각기 다른 언어와 텍스트 구조에 맞게 설계되어 있으므로, 특정 사용 사례에 적합한 분석기를 선택하면 검색 결과에 상당한 영향을 미칠 수 있습니다.
기본적으로 Milvus는 standard 분석기를 사용하며, 이 분석기는 공백과 구두점을 기준으로 텍스트를 토큰화하고, 40자보다 긴 토큰을 제거하며, 텍스트를 소문자로 변환합니다. 이 기본 설정을 적용하는 데 추가 매개변수는 필요하지 않습니다. 자세한 내용은 Standard를 참조하십시오.
다른 분석기가 필요한 경우, ` analyzer_params ` 매개변수를 사용하여 분석기를 구성할 수 있습니다. 예를 들어, 영어 텍스트 처리에 ` english ` 분석기를 적용하려면 다음과 같이 합니다.
analyzer_params = {
    "type": "english"
}
schema.add_field(
    field_name='text',
    datatype=DataType.VARCHAR,
    max_length=200,
    enable_analyzer=True,
    analyzer_params = analyzer_params,
    enable_match = True,
)
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("type", "english");
schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(200)
        .enableAnalyzer(true)
        .analyzerParams(analyzerParams)
        .enableMatch(true)
        .build());
analyzerParams := map[string]any{"type": "english"}
schema.WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithEnableMatch(true).
    WithAnalyzerParams(analyzerParams).
    WithMaxLength(200),
)
const schema = [
  {
    name: "id",
    data_type: DataType.Int64,
    is_primary_key: true,
  },
  {
    name: "text",
    data_type: "VarChar",
    enable_analyzer: true,
    enable_match: true,
    max_length: 1000,
    analyzer_params: { type: 'english' },
  },
  {
    name: "embeddings",
    data_type: DataType.FloatVector,
    dim: 5,
  },
];
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 200,
                    "enable_analyzer": true,
                    "enable_match": true,
                    "analyzer_params": {"type": "english"}
                }
            },
            {
                "fieldName": "embeddings",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "5"
                }
            }
        ]
    }'
Milvus는 또한 다양한 언어와 시나리오에 적합한 여러 분석기를 제공합니다. 자세한 내용은 ‘분석기 개요’를 참조하십시오.
텍스트 매칭 사용
컬렉션 스키마에서 VARCHAR 또는 TEXT 필드에 대해 텍스트 일치 기능을 활성화한 후에는 TEXT_MATCH 표현식을 사용하여 텍스트 일치를 수행할 수 있습니다.
TEXT_MATCH 표현식 구문
TEXT_MATCH 표현식은 검색할 필드와 검색어를 지정하는 데 사용됩니다. 구문은 다음과 같습니다.
TEXT_MATCH(field_name, text)
field_name: 검색할 일치 기능이 활성화된VARCHAR또는TEXT필드의 이름.text: 검색할 용어입니다. 여러 용어는 공백이나 언어 및 구성된 분석기에 따라 적절한 구분 기호로 구분할 수 있습니다.
기본적으로 TEXT_MATCH 는 OR 매칭 논리를 사용하므로, 지정된 용어 중 하나라도 포함된 문서를 반환합니다. 예를 들어, text 필드에서 machine 또는 deep 용어가 포함된 문서를 검색하려면 다음 표현식을 사용합니다:
filter = "TEXT_MATCH(text, 'machine deep')"
String filter = "TEXT_MATCH(text, 'machine deep')";
filter := "TEXT_MATCH(text, 'machine deep')"
const filter = "TEXT_MATCH(text, 'machine deep')";
export filter="\"TEXT_MATCH(text, 'machine deep')\""
또한 논리 연산자를 사용하여 여러 TEXT_MATCH 표현식을 결합해 AND 검색을 수행할 수도 있습니다.
'
text' 필드에서 'machine'과 'deep'을 모두 포함하는 문서를 검색하려면 다음 표현식을 사용하십시오:filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')"String filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')";filter := "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')"const filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')"export filter="\"TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')\""text필드에machine과learning이 모두 포함되어 있지만deep은 포함되지 않은 문서를 검색하려면 다음 표현식을 사용하십시오:filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')"String filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')";filter := "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')"const filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')";export filter="\"not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')\""
TEXT_MATCH_FUZZY 표현식 구문Compatible with Milvus 3.0.0+
TEXT_MATCH_FUZZY 을 사용하면 쿼리 토큰과 색인된 토큰 간의 철자 차이를 허용할 수 있습니다. Milvus는 필드의 분석기를 사용하여 쿼리 텍스트를 분석하고, 그 결과로 생성된 각 토큰에 퍼지 매칭을 적용합니다. 쿼리 결과로 여러 토큰이 생성된 경우, 설정된 편집 거리를 충족하는 토큰이 하나라도 있으면 해당 표현식이 엔티티와 일치합니다.
구문은 다음과 같습니다:
TEXT_MATCH_FUZZY(field_name, text, max_edit_distance = 1)
field_name: 검색할 매칭이 활성화된VARCHAR또는TEXT필드의 이름입니다.text: 분석하여 색인된 토큰과 일치시킬 쿼리 텍스트.max_edit_distance: 각 쿼리 토큰에 허용되는 최대 편집 거리입니다. 옵션 이름은 반드시max_edit_distance이어야 하며, 값은0,1또는2이어야 합니다.0값을 지정하면TEXT_MATCH과 동등한 정확한 토큰 일치를 수행합니다.
예를 들어, 다음 표현식은 machne 에서 한 글자 수정 범위 내의 토큰( machine 포함)과 일치합니다:
filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)"
String filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)";
filter := "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)"
const filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)";
export filter="\"TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)\""
TEXT_MATCH_FUZZY 는 필터 표현식 구문의 일부이므로, 클라이언트 SDK에는 별도의 퍼지 매칭 메서드가 필요하지 않습니다. 검색 또는 쿼리 작업에서 TEXT_MATCH 에 사용된 것과 동일한 filter 매개변수를 통해 이 표현식을 전달하십시오.
텍스트 일치 검색
텍스트 일치 기능을 벡터 유사도 검색과 함께 사용하면 검색 범위를 좁히고 검색 성능을 향상시킬 수 있습니다. 벡터 유사도 검색 전에 텍스트 일치를 사용하여 컬렉션을 필터링하면 검색해야 할 문서 수를 줄일 수 있어 쿼리 처리 시간이 단축됩니다.
이 예제에서 filter 표현식은 검색 결과를 필터링하여 지정된 용어인 keyword1 또는 keyword2 과 일치하는 문서만 포함하도록 합니다. 그런 다음 필터링된 이 문서 집합을 대상으로 벡터 유사도 검색이 수행됩니다.
텍스트 하이라이터를 구성하여 검색 결과에서 일치하는 용어를 강조 표시할 수 있습니다. 자세한 내용은 텍스트 하이라이터를 참조하십시오.
# Match entities with `keyword1` or `keyword2`
filter = "TEXT_MATCH(text, 'keyword1 keyword2')"

# Assuming 'embeddings' is the vector field and 'text' is the VARCHAR field
result = client.search(
    collection_name="my_collection", # Your collection name
    anns_field="embeddings", # Vector field name
    data=[query_vector], # Query vector
    filter=filter,
    search_params={"params": {"nprobe": 10}},
    limit=10, # Max. number of results to return
    output_fields=["id", "text"] # Fields to return
)
String filter = "TEXT_MATCH(text, 'keyword1 keyword2')";

SearchResp searchResp = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .annsField("embeddings")
        .data(Collections.singletonList(queryVector)))
        .filter(filter)
        .topK(10)
        .outputFields(Arrays.asList("id", "text"))
        .build());
filter := "TEXT_MATCH(text, 'keyword1 keyword2')"

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    10,               // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("embeddings").
    WithFilter(filter).
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
// Match entities with `keyword1` or `keyword2`
const filter = "TEXT_MATCH(text, 'keyword1 keyword2')";

// Assuming 'embeddings' is the vector field and 'text' is the VARCHAR field
const result = await client.search(
    collection_name: "my_collection", // Your collection name
    anns_field: "embeddings", // Vector field name
    data: [query_vector], // Query vector
    filter: filter,
    params: {"nprobe": 10},
    limit: 10, // Max. number of results to return
    output_fields: ["id", "text"] //Fields to return
);
export filter="\"TEXT_MATCH(text, 'keyword1 keyword2')\""

export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "annsField": "embeddings",
    "data": [[0.19886812562848388, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501, 0.838729485096104]],
    "filter": '"$filter"',
    "searchParams": {
        "params": {
            "nprobe": 10
        }
    },
    "limit": 10,
    "outputFields": ["text","id"]
}'
텍스트 일치 쿼리
텍스트 일치는 쿼리 작업에서 스칼라 필터링에도 사용할 수 있습니다. ` query() ` 메서드의 ` expr ` 매개변수에 ` TEXT_MATCH ` 표현식을 지정하면, 주어진 용어와 일치하는 문서를 검색할 수 있습니다.
아래 예제는 text 필드에 keyword1 및 keyword2 두 용어가 모두 포함된 문서를 검색합니다.
# Match entities with both `keyword1` and `keyword2`
filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')"

result = client.query(
    collection_name="my_collection",
    filter=filter,
    output_fields=["id", "text"]
)
String filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')";

QueryResp queryResp = client.query(QueryReq.builder()
        .collectionName("my_collection")
        .filter(filter)
        .outputFields(Arrays.asList("id", "text"))
        .build()
);
filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')"
resultSet, err := client.Query(ctx, milvusclient.NewQueryOption("my_collection").
    WithFilter(filter).
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
// Match entities with both `keyword1` and `keyword2`
const filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')";

const result = await client.query(
    collection_name: "my_collection",
    filter: filter,
    output_fields: ["id", "text"]
)
export filter="\"TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')\""

export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/query" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "filter": '"$filter"',
    "outputFields": ["id", "text"]
}'
고려 사항
필드에 용어 일치 기능을 활성화하면 역색인이 생성되며, 이로 인해 스토리지 리소스가 소모됩니다. 이 기능을 활성화할지 결정할 때는 텍스트 크기, 고유 토큰 수, 사용된 분석기에 따라 스토리지 영향이 달라질 수 있으므로 이를 고려해야 합니다.
스키마에서 분석기를 정의하면 해당 컬렉션에 대해 그 설정이 영구적으로 적용됩니다. 다른 분석기가 요구 사항에 더 적합하다고 판단되는 경우, 기존 컬렉션을 삭제하고 원하는 분석기 구성으로 새 컬렉션을 생성하는 것을 고려해 볼 수 있습니다.
filter표현식의 이스케이프 규칙:표현식 내에서 큰따옴표나 작은따옴표로 묶인 문자는 문자열 상수로 해석됩니다. 문자열 상수에 이스케이프 문자가 포함된 경우, 해당 이스케이프 문자는 이스케이프 시퀀스로 표현해야 합니다. 예를 들어,
\을 표현하려면\\을, 탭을 표현하려면\\t을,\t을, 개행 문자를 표현하려면\\n을 사용하십시오.문자열 상수가 작은따옴표로 묶여 있는 경우, 상수 내의 작은따옴표는
\\'로 표기해야 하며, 큰따옴표는"또는\\"로 표기할 수 있습니다. 예:'It\\'s milvus'.문자열 상수가 큰따옴표로 묶여 있는 경우, 상수 내의 큰따옴표는
\\"로 표기해야 하며, 작은따옴표는'또는\\'중 하나로 표기할 수 있습니다. 예:"He said \\"Hi\\"".
