

그룹화 검색
그룹화 검색을 사용하면 Milvus가 지정된 필드의 값을 기준으로 검색 결과를 그룹화하여 더 높은 수준에서 데이터를 집계할 수 있습니다. 예를 들어, 기본 ANN 검색을 사용하여 현재 보고 있는 책과 유사한 책을 찾을 수 있지만, 그룹화 검색을 사용하면 해당 책에서 다루는 주제와 관련된 도서 카테고리를 찾을 수 있습니다. 이 항목에서는 그룹화 검색 사용 방법과 주요 고려 사항을 설명합니다.
개요
검색 결과의 엔티티들이 스칼라 필드에서 동일한 값을 공유하는 경우, 이는 특정 속성에서 유사함을 나타내며, 이는 검색 결과에 부정적인 영향을 미칠 수 있습니다.
컬렉션에 여러 문서( docId로 표시)가 저장되어 있다고 가정해 보겠습니다. 문서를 벡터로 변환할 때 가능한 한 많은 의미 정보를 유지하기 위해, 각 문서는 관리하기 쉬운 작은 단락(또는 청크)으로 분할되어 별도의 엔티티로 저장됩니다. 문서가 더 작은 섹션으로 나뉘어 있더라도, 사용자는 여전히 자신의 요구와 가장 관련성이 높은 문서를 식별하는 데 관심이 있는 경우가 많습니다.
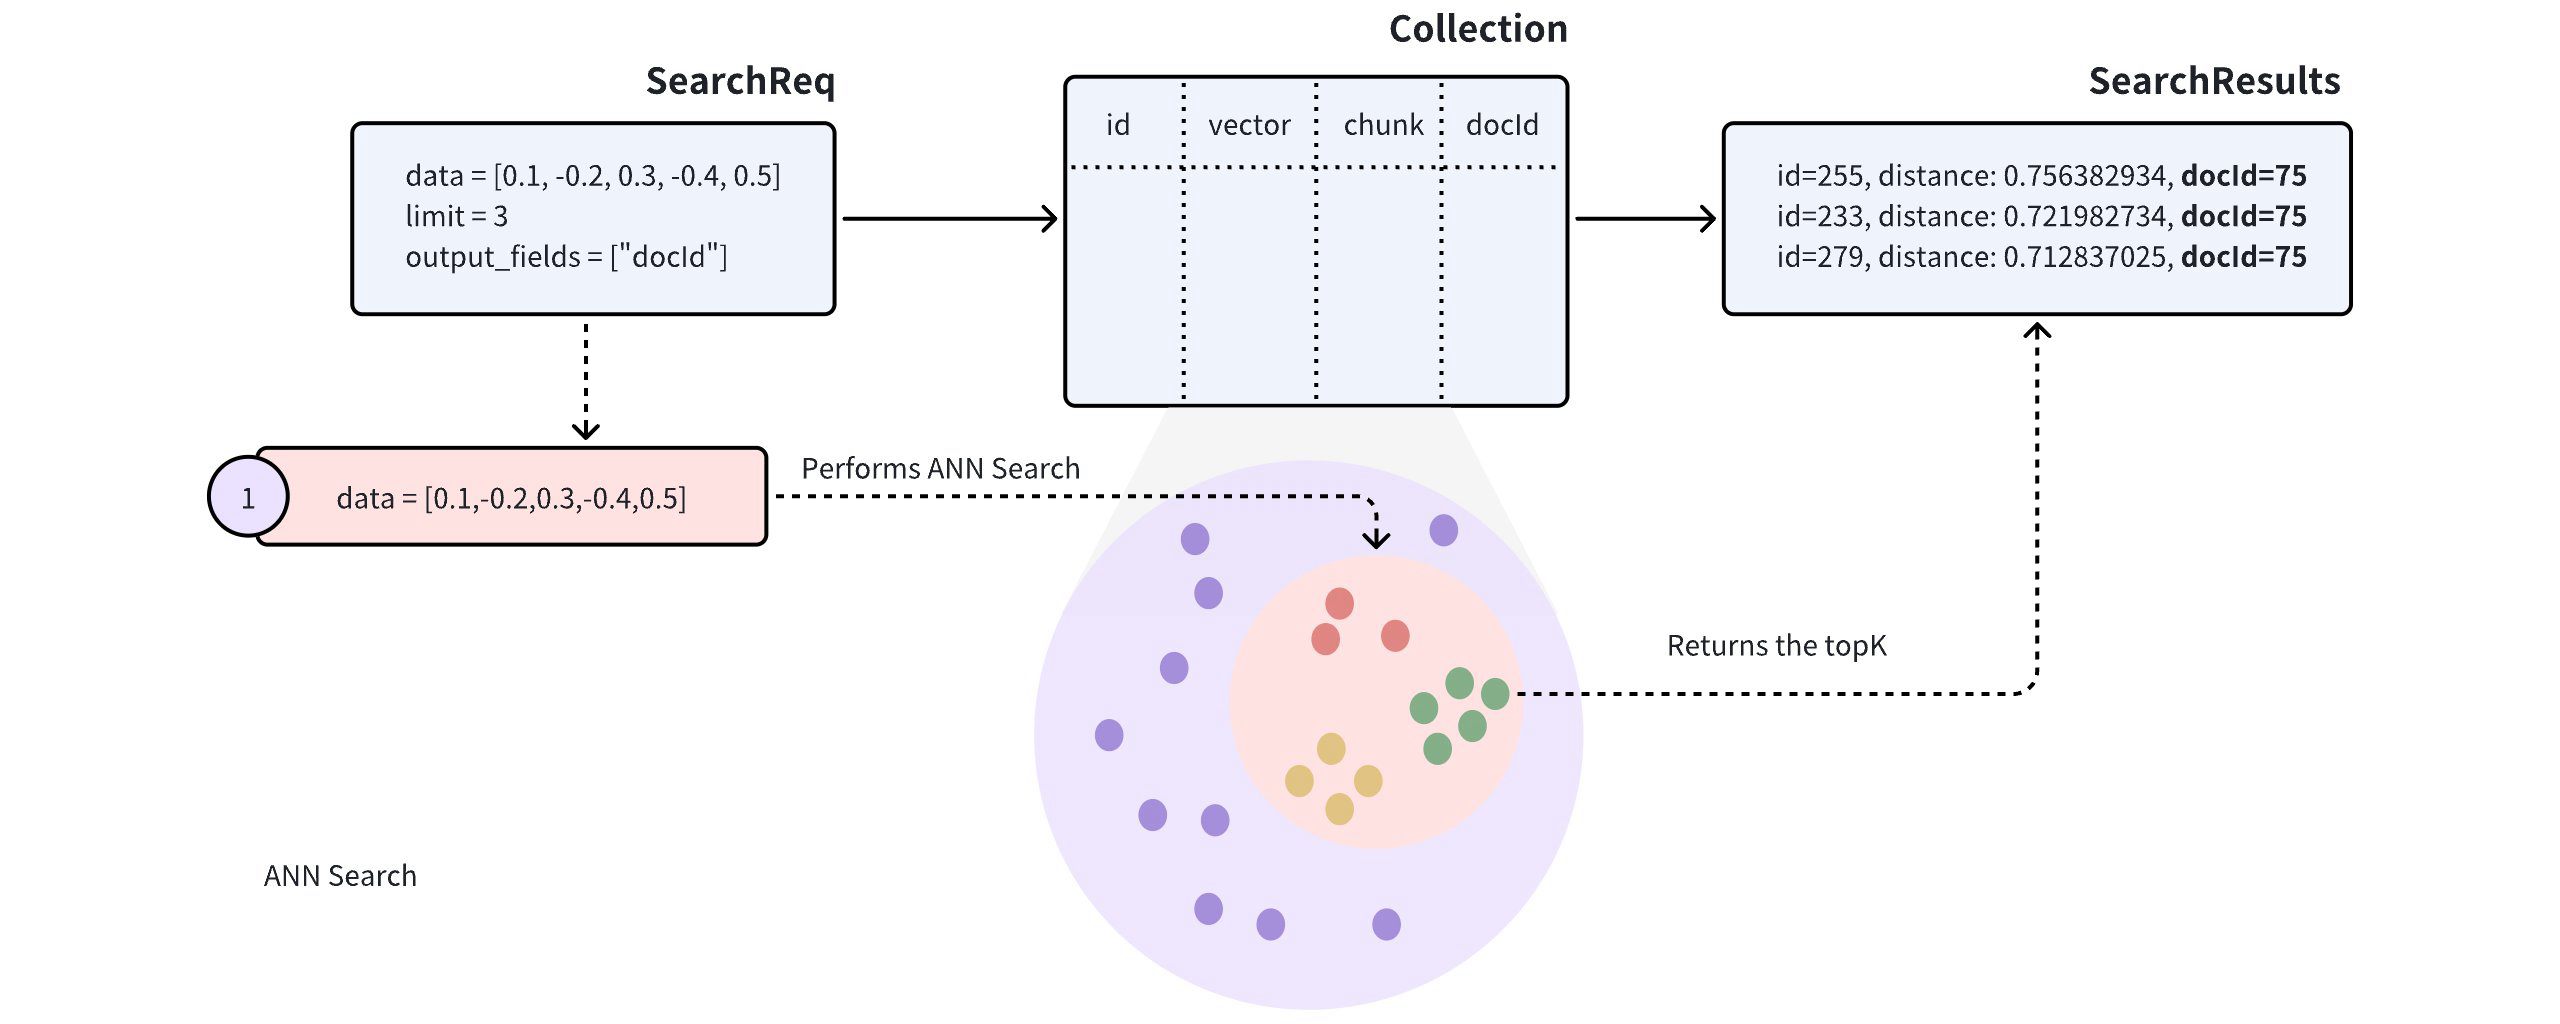 Ann 검색
이러한 컬렉션에서 근사 최인접 이웃(ANN) 검색을 수행할 때, 검색 결과에 동일한 문서의 여러 단락이 포함될 수 있으며, 이로 인해 다른 문서가 간과될 가능성이 있어 의도된 사용 사례와 부합하지 않을 수 있습니다.
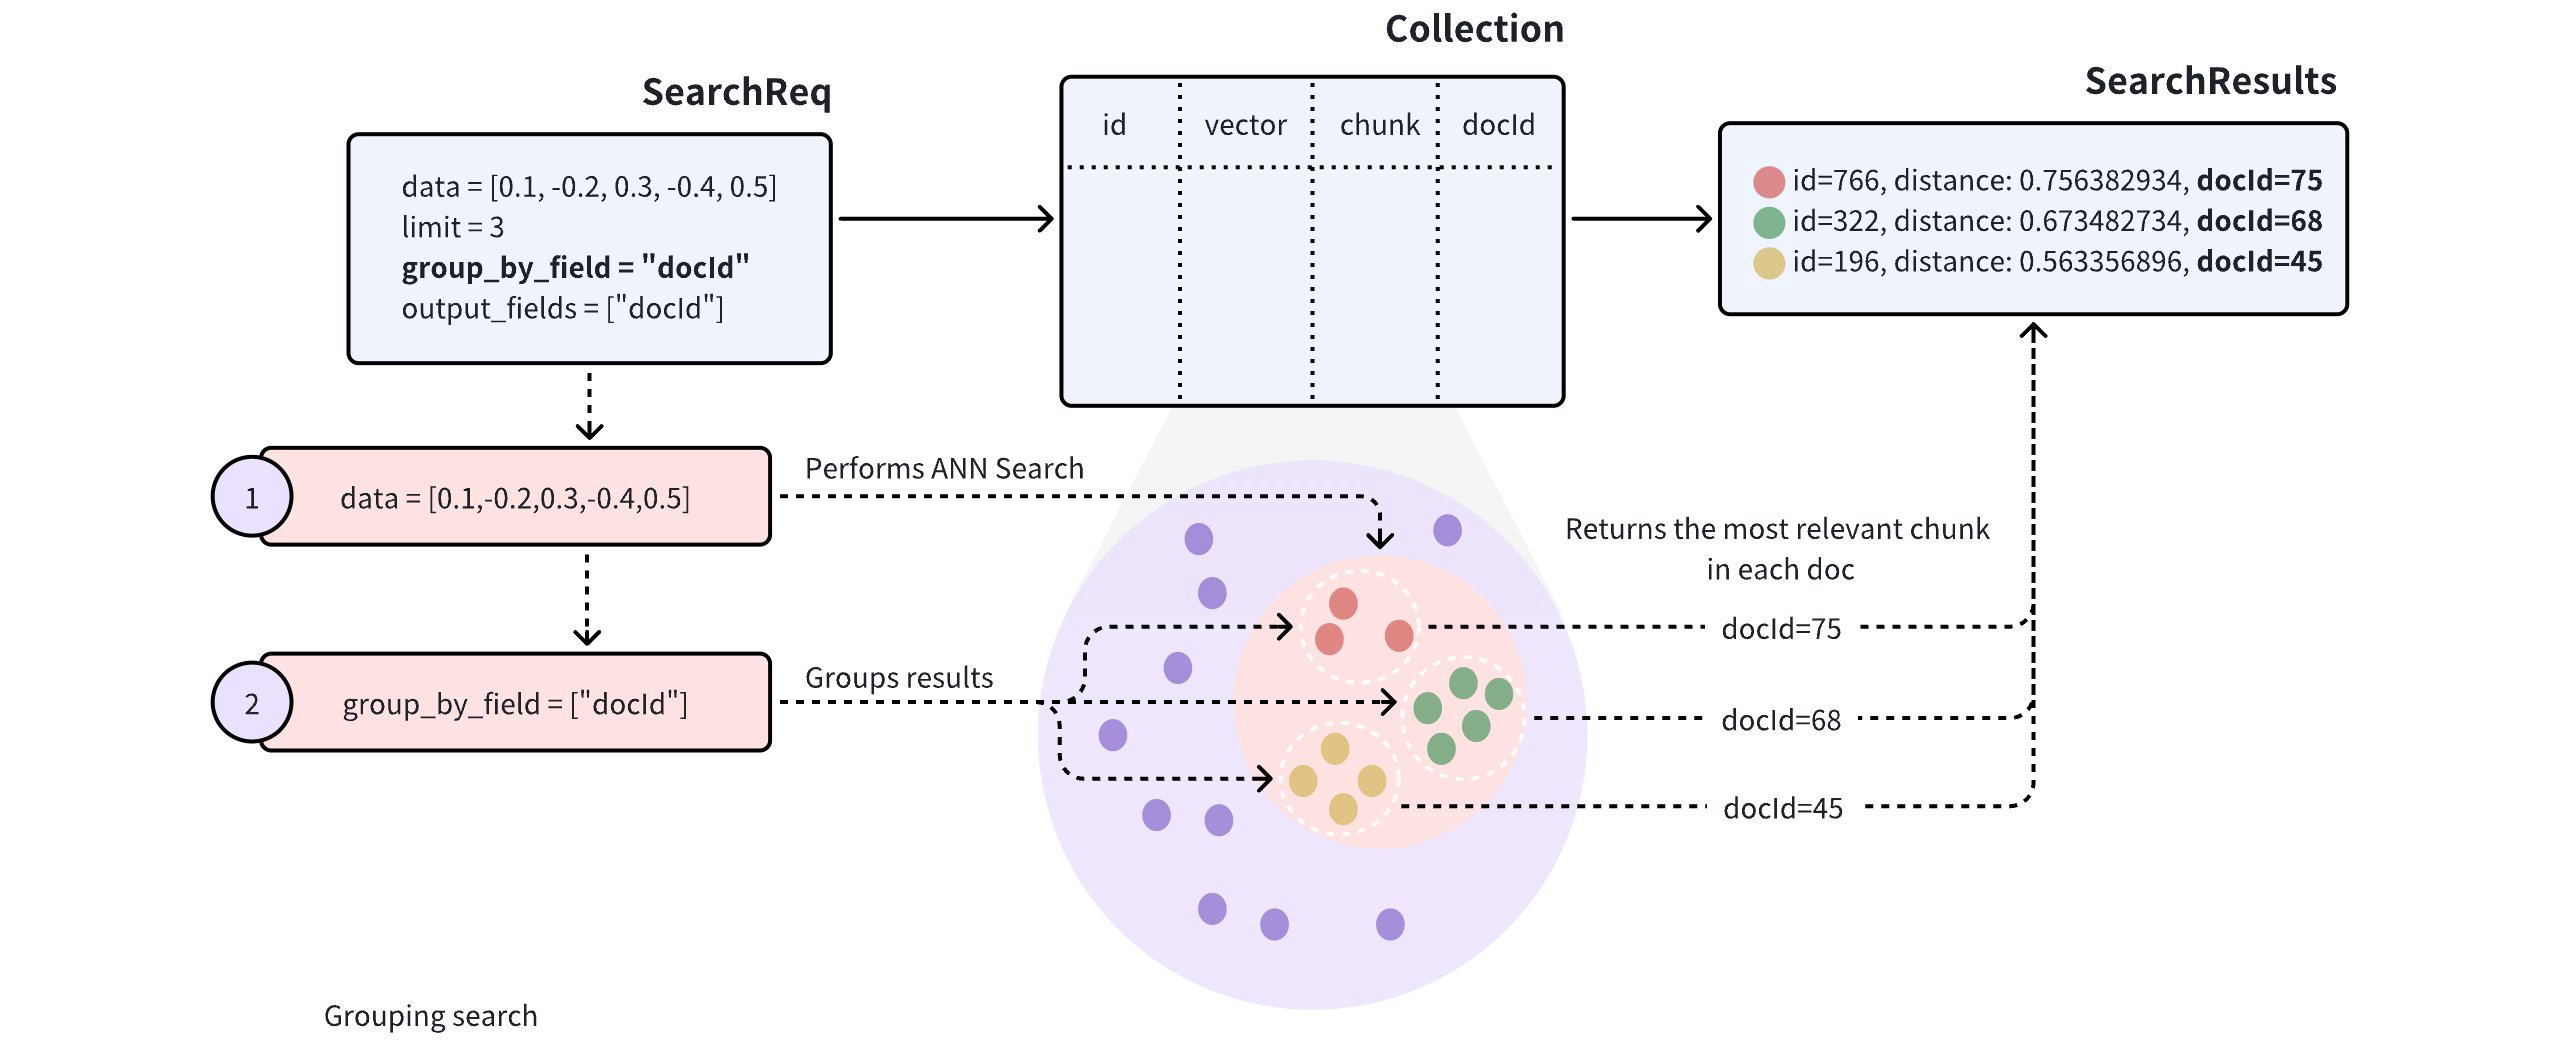 그룹화 검색
검색 결과의 다양성을 높이기 위해, 검색 요청에 ` group_by_field ` 매개변수를 추가하여 그룹화 검색(Grouping Search)을 활성화할 수 있습니다. 다이어그램에 표시된 대로, ` group_by_field `을 ` docId`로 설정할 수 있습니다. 이 요청을 수신하면 Milvus는 다음과 같은 작업을 수행합니다:
제공된 쿼리 벡터를 기반으로 ANN 검색을 수행하여 쿼리와 가장 유사한 모든 엔티티를 찾습니다.
docId과 같이 지정된group_by_field에 따라 검색 결과를 그룹화합니다.limit매개변수에 정의된 대로 각 그룹의 상위 결과를 반환하며, 각 그룹에서 가장 유사한 엔티티를 포함합니다.
기본적으로 그룹화 검색은 그룹당 하나의 엔티티만 반환합니다. 그룹당 반환할 결과 수를 늘리고 싶다면, ` group_size ` 및 ` strict_group_size ` 매개변수를 사용하여 이를 제어할 수 있습니다.
그룹화 검색 수행
이 섹션에서는 그룹화 검색의 사용법을 보여주는 예제 코드를 제공합니다. 다음 예제는 컬렉션에 id, vector, chunk 및 docId 필드가 포함되어 있다고 가정합니다.
[
        {"id": 0, "vector": [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592], "chunk": "pink_8682", "docId": 1},
        {"id": 1, "vector": [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501, 0.838729485096104], "chunk": "red_7025", "docId": 5},
        {"id": 2, "vector": [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, 0.7894058910881185, 0.20785793220625592], "chunk": "orange_6781", "docId": 2},
        {"id": 3, "vector": [0.3172005263489739, 0.9719044792798428, -0.36981146090600725, -0.4860894583077995, 0.95791889146345], "chunk": "pink_9298", "docId": 3},
        {"id": 4, "vector": [0.4452349528804562, -0.8757026943054742, 0.8220779437047674, 0.46406290649483184, 0.30337481143159106], "chunk": "red_4794", "docId": 3},
        {"id": 5, "vector": [0.985825131989184, -0.8144651566660419, 0.6299267002202009, 0.1206906911183383, -0.1446277761879955], "chunk": "yellow_4222", "docId": 4},
        {"id": 6, "vector": [0.8371977790571115, -0.015764369584852833, -0.31062937026679327, -0.562666951622192, -0.8984947637863987], "chunk": "red_9392", "docId": 1},
        {"id": 7, "vector": [-0.33445148015177995, -0.2567135004164067, 0.8987539745369246, 0.9402995886420709, 0.5378064918413052], "chunk": "grey_8510", "docId": 2},
        {"id": 8, "vector": [0.39524717779832685, 0.4000257286739164, -0.5890507376891594, -0.8650502298996872, -0.6140360785406336], "chunk": "white_9381", "docId": 5},
        {"id": 9, "vector": [0.5718280481994695, 0.24070317428066512, -0.3737913482606834, -0.06726932177492717, -0.6980531615588608], "chunk": "purple_4976", "docId": 3},
]
검색 요청에서 group_by_field 과 output_fields 을 모두 docId 으로 설정합니다. Milvus는 지정된 필드별로 결과를 그룹화하고, 각 그룹에서 가장 유사한 엔티티를 반환하며, 반환된 각 엔티티에 대한 docId 값도 함께 제공합니다.
from pymilvus import MilvusClient

client = MilvusClient(
    uri="http://localhost:19530",
    token="root:Milvus"
)

query_vectors = [
    [0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088]]

# Group search results
res = client.search(
    collection_name="my_collection",
    data=query_vectors,
    limit=3,
    group_by_field="docId",
    output_fields=["docId"]
)

# Retrieve the values in the `docId` column
doc_ids = [result['entity']['docId'] for result in res[0]]
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.vector.request.SearchReq
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.response.SearchResp

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .token("root:Milvus")
        .build());

FloatVec queryVector = new FloatVec(new float[]{0.14529211512077012f, 0.9147257273453546f, 0.7965055218724449f, 0.7009258593102812f, 0.5605206522382088f});
SearchReq searchReq = SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryVector))
        .topK(3)
        .groupByFieldName("docId")
        .outputFields(Collections.singletonList("docId"))
        .build();

SearchResp searchResp = client.search(searchReq);

List<List<SearchResp.SearchResult>> searchResults = searchResp.getSearchResults();
for (List<SearchResp.SearchResult> results : searchResults) {
    System.out.println("TopK results:");
    for (SearchResp.SearchResult result : results) {
        System.out.println(result);
    }
}

// Output
// TopK results:
// SearchResp.SearchResult(entity={docId=5}, score=0.74767184, id=1)
// SearchResp.SearchResult(entity={docId=2}, score=0.6254269, id=7)
// SearchResp.SearchResult(entity={docId=3}, score=0.3611898, id=3)
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

queryVector := []float32{0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592}

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    3,               // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("vector").
    WithGroupByField("docId").
    WithOutputFields("docId"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("docId: ", resultSet.GetColumn("docId").FieldData().GetScalars())
}
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const address = "http://localhost:19530";
const token = "root:Milvus";
const client = new MilvusClient({address, token});

var query_vector = [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]

res = await client.search({
    collection_name: "my_collection",
    data: [query_vector],
    limit: 3,
    group_by_field: "docId"
})

// Retrieve the values in the `docId` column
var docIds = res.results.map(result => result.entity.docId)
export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": [
        [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]
    ],
    "annsField": "vector",
    "limit": 3,
    "groupingField": "docId",
    "outputFields": ["docId"]
}'
#include "milvus/MilvusClientV2.h"
#include <iostream>
#include <stdexcept>
#include <vector>

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"http://localhost:19530", "root:Milvus"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    throw std::runtime_error(status.Message());
}

std::vector<float> query_vector = {0.3580376395471989f, -0.6023495712049978f, 0.18414012509913835f, -0.26286205330961354f, 0.9029438446296592f};
auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .AddFloatVector(query_vector)
                   .WithLimit(3)
                   .WithAnnsField("vector")
                   .WithGroupByField("docId")
                   .AddOutputField("docId");

milvus::SearchResponse response;
status = client->Search(request, response);
if (!status.IsOk()) {
    throw std::runtime_error(status.Message());
}

for (auto& result : response.Results().Results()) {
    std::cout << "TopK results:" << std::endl;
    milvus::EntityRows output_rows;
    status = result.OutputRows(output_rows);
    if (!status.IsOk()) {
        throw std::runtime_error(status.Message());
    }
    for (const auto& row : output_rows) {
        std::cout << "\t" << row << std::endl;
    }
}
위의 요청에서 ` limit=3 `는 시스템이 3개의 그룹에 대한 검색 결과를 반환하며, 각 그룹에는 쿼리 벡터와 가장 유사한 단일 엔티티가 포함됨을 나타냅니다.
그룹 크기 구성
기본적으로 그룹화 검색(Grouping Search)은 그룹당 하나의 엔티티만 반환합니다. 그룹당 여러 개의 결과를 원한다면 group_size 및 strict_group_size 매개변수를 조정하십시오.
# Group search results

res = client.search(
    collection_name="my_collection",
    data=query_vectors, # query vector
    limit=5, # number of groups to return
    group_by_field="docId", # grouping field
    group_size=2, # p to 2 entities to return from each group
    strict_group_size=True, # return exact 2 entities from each group
    output_fields=["docId"]
)
FloatVec queryVector = new FloatVec(new float[]{0.14529211512077012f, 0.9147257273453546f, 0.7965055218724449f, 0.7009258593102812f, 0.5605206522382088f});
SearchReq searchReq = SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryVector))
        .topK(5)
        .groupByFieldName("docId")
        .groupSize(2)
        .strictGroupSize(true)
        .outputFields(Collections.singletonList("docId"))
        .build();

SearchResp searchResp = client.search(searchReq);

List<List<SearchResp.SearchResult>> searchResults = searchResp.getSearchResults();
for (List<SearchResp.SearchResult> results : searchResults) {
    System.out.println("TopK results:");
    for (SearchResp.SearchResult result : results) {
        System.out.println(result);
    }
}

// Output
// TopK results:
// SearchResp.SearchResult(entity={docId=5}, score=0.74767184, id=1)
// SearchResp.SearchResult(entity={docId=5}, score=-0.49148706, id=8)
// SearchResp.SearchResult(entity={docId=2}, score=0.6254269, id=7)
// SearchResp.SearchResult(entity={docId=2}, score=0.38515577, id=2)
// SearchResp.SearchResult(entity={docId=3}, score=0.3611898, id=3)
// SearchResp.SearchResult(entity={docId=3}, score=0.19556211, id=4)
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

queryVector := []float32{0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592}

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    5,               // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("vector").
    WithGroupByField("docId").
    WithStrictGroupSize(true).
    WithGroupSize(2).
    WithOutputFields("docId"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("docId: ", resultSet.GetColumn("docId").FieldData().GetScalars())
}
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const address = "http://localhost:19530";
const token = "root:Milvus";
const client = new MilvusClient({address, token});

var query_vector = [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]

res = await client.search({
    collection_name: "my_collection",
    data: [query_vector],
    limit: 5,
    group_by_field: "docId",
    group_size: 2,
    strict_group_size: true
})

// Retrieve the values in the `docId` column
var docIds = res.results.map(result => result.entity.docId)
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": [
        [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]
    ],
    "annsField": "vector",
    "limit": 5,
    "groupingField": "docId",
    "groupSize":2,
    "strictGroupSize":true,
    "outputFields": ["docId"]
}'
#include "milvus/MilvusClientV2.h"
#include <iostream>
#include <stdexcept>
#include <vector>

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"http://localhost:19530", "root:Milvus"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    throw std::runtime_error(status.Message());
}

std::vector<float> query_vector = {0.3580376395471989f, -0.6023495712049978f, 0.18414012509913835f, -0.26286205330961354f, 0.9029438446296592f};
auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .AddFloatVector(query_vector)
                   .WithLimit(5)
                   .WithAnnsField("vector")
                   .WithGroupByField("docId")
                   .WithGroupSize(2)
                   .WithStrictGroupSize(true)
                   .AddOutputField("docId");

milvus::SearchResponse response;
status = client->Search(request, response);
if (!status.IsOk()) {
    throw std::runtime_error(status.Message());
}

for (auto& result : response.Results().Results()) {
    std::cout << "TopK results:" << std::endl;
    milvus::EntityRows output_rows;
    status = result.OutputRows(output_rows);
    if (!status.IsOk()) {
        throw std::runtime_error(status.Message());
    }
    for (const auto& row : output_rows) {
        std::cout << "\t" << row << std::endl;
    }
}
위의 예시에서:
group_size: 그룹당 반환할 엔티티의 수를 지정합니다. 예를 들어,group_size=2를 설정하면 각 그룹(또는 각docId)은 이상적으로 가장 유사한 단락(또는 청크) 두 개를 반환해야 합니다.group_size가 설정되지 않은 경우, 시스템은 기본적으로 그룹당 하나의 결과를 반환합니다.strict_group_size: 이 부울 매개변수는 시스템이group_size로 설정된 개수를 엄격하게 적용할지 여부를 제어합니다.strict_group_size=True인 경우, 해당 그룹에 충분한 데이터가 없는 경우를 제외하고 시스템은 각 그룹에group_size로 지정된 정확한 개수(예: 두 개의 단락)의 엔티티를 포함하도록 시도합니다. 기본값(strict_group_size=False)에서는 시스템이 각 그룹에group_size개체의 수를 보장하기보다는limit매개변수로 지정된 그룹 수를 충족하는 것을 우선시합니다. 이 방식은 데이터 분포가 고르지 않은 경우 일반적으로 더 효율적입니다.
매개변수에 대한 자세한 내용은 search를 참조하십시오.
스칼라 필드별로 그룹 정렬Compatible with Milvus 3.0.x
그룹화 검색(Grouping Search)을 그룹화 기준( order_by_fields )과 결합하여 스칼라 필드별로 그룹을 정렬할 수 있습니다. 이는 그룹 간에 다양한 결과를 원하지만, 그룹이 가격이나 평점과 같은 비즈니스 관련 순서를 따르도록 하고자 할 때 유용합니다.
다음 예제는 검색 결과를 ‘ category ’ 기준으로 그룹화하고, 그룹당 최대 3개의 엔티티를 반환하며, 반환된 그룹을 ‘ price ’ 순서대로 낮은 값에서 높은 값 순으로 정렬합니다.
res = client.search(
    collection_name="product_catalog",
    data=query_vectors,
    anns_field="embedding",
    limit=20,
    group_by_field="category",
    group_size=3,
    strict_group_size=True,
    output_fields=["category", "price", "rating"],
    order_by_fields=[
        {"field": "price", "order": "asc"}
    ],
)
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.request.aggregation.AggDirection;
import io.milvus.v2.service.vector.request.aggregation.OrderByField;
import io.milvus.v2.service.vector.response.SearchResp;
import java.util.List;

// Prerequisite: client is connected to Milvus and product_catalog is loaded.
FloatVec queryVector = new FloatVec(new float[]{0.14529211512077012f, 0.9147257273453546f, 0.7965055218724449f, 0.7009258593102812f, 0.5605206522382088f});
SearchReq request = SearchReq.builder()
    .collectionName("product_catalog")
    .data(List.of(queryVector))
    .annsField("embedding")
    .topK(20)
    .groupByFieldName("category")
    .groupSize(3)
    .strictGroupSize(true)
    .outputFields(List.of("category", "price", "rating"))
    .orderByFields(List.of(OrderByField.builder()
        .fieldName("price").direction(AggDirection.ASC).build()))
    .build();
SearchResp response = client.search(request);
System.out.println(response.getSearchResults());
// Prerequisite: client is connected to Milvus and product_catalog is loaded.
const queryVector = [0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088];
const response = await client.search({
  collection_name: "product_catalog",
  data: [queryVector],
  anns_field: "embedding",
  limit: 20,
  group_by_field: "category",
  group_size: 3,
  strict_group_size: true,
  output_fields: ["category", "price", "rating"],
  order_by_fields: [{ field: "price", order: "asc" }],
});
console.log(response.results);
import (
    "fmt"
    "github.com/milvus-io/milvus/client/v3/entity"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

// Prerequisite: client is connected to Milvus and product_catalog is loaded.
queryVector := []float32{0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088}
results, err := client.Search(ctx, milvusclient.NewSearchOption(
    "product_catalog", 20, []entity.Vector{entity.FloatVector(queryVector)},
).
    WithANNSField("embedding").
    WithGroupByField("category").
    WithGroupSize(3).
    WithStrictGroupSize(true).
    WithOutputFields("category", "price", "rating").
    WithSearchParam("order_by_fields", "price:asc"))
if err != nil {
    panic(err)
}
for _, result := range results {
    fmt.Println(result.IDs, result.Scores)
    fmt.Println(result.GetColumn("category"), result.GetColumn("price"), result.GetColumn("rating"))
}
# Prerequisite: set CLUSTER_ENDPOINT and TOKEN for your Milvus instance.
curl --request POST \
  --url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
  --header "Authorization: Bearer ${TOKEN}" \
  --header "Content-Type: application/json" \
  --data '{
    "collectionName": "product_catalog",
    "data": [[0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088]],
    "annsField": "embedding",
    "limit": 20,
    "groupingField": "category",
    "groupSize": 3,
    "strictGroupSize": true,
    "outputFields": ["category", "price", "rating"],
    "orderByFields": ["price:asc"]
  }'
#include "milvus/MilvusClientV2.h"
#include <iostream>
#include <stdexcept>

// Prerequisite: client is connected to Milvus and product_catalog is loaded.
std::vector<float> query_vector = {0.14529211512077012f, 0.9147257273453546f, 0.7965055218724449f, 0.7009258593102812f, 0.5605206522382088f};
auto request = milvus::SearchRequest()
    .WithCollectionName("product_catalog")
    .AddFloatVector(query_vector)
    .WithAnnsField("embedding")
    .WithLimit(20)
    .WithGroupByField("category")
    .WithGroupSize(3)
    .WithStrictGroupSize(true)
    .AddOutputField("category")
    .AddOutputField("price")
    .AddOutputField("rating")
    .AddOrderByField(milvus::OrderByField("price", milvus::AggregationDirection::ASC));
milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) { throw std::runtime_error(status.Message()); }
for (const auto& result : response.Results().Results()) {
    milvus::EntityRows rows;
    status = result.OutputRows(rows);
    if (!status.IsOk()) { throw std::runtime_error(status.Message()); }
    std::cout << rows << std::endl;
}
위의 요청에서 ` limit=20 `는 Milvus가 20개의 엔티티가 아닌 최대 20개의 그룹을 선택함을 의미합니다. ` group_size=3`이므로, 평면 결과 목록에는 총 60개의 엔티티가 포함될 수 있습니다.
order_by_fields 를 group_by_field 와 함께 사용할 경우, Milvus는 각 그룹의 최상위 엔티티에 지정된 스칼라 필드 값을 기준으로 그룹을 정렬합니다. 각 그룹 내에서는 엔티티가 쿼리 벡터와의 유사도 점수 순서대로 정렬됩니다.
고려 사항
인덱싱: 이 그룹화 기능은 FLAT, IVF_FLAT, IVF_SQ8, HNSW, HNSW_PQ, HNSW_PRQ, HNSW_SQ, DISKANN, SPARSE_INVERTED_INDEX 인덱스 유형으로 인덱싱된 컬렉션에서만 작동합니다.
그룹 수: `
limit` 매개변수는 각 그룹 내의 구체적인 엔티티 수보다는 검색 결과가 반환되는 그룹의 수를 제어합니다. 적절한 `limit` 값을 설정하면 검색의 다양성과 쿼리 성능을 조절하는 데 도움이 됩니다. 데이터가 밀집되어 있거나 성능이 중요한 경우, `limit` 값을 줄이면 계산 비용을 절감할 수 있습니다.그룹당 엔티티 수:
group_size매개변수는 그룹당 반환되는 엔티티의 수를 제어합니다. 사용 사례에 따라group_size를 조정하면 검색 결과의 풍부함을 높일 수 있습니다. 그러나 데이터가 고르지 않게 분포된 경우, 특히 데이터가 제한적인 시나리오에서는 일부 그룹이group_size에서 지정한 수보다 적은 엔티티를 반환할 수 있습니다.엄격한 그룹 크기: `
strict_group_size=True`로 설정된 경우, 해당 그룹에 충분한 데이터가 없는 경우를 제외하고 시스템은 각 그룹에 대해 지정된 개체 수(group_size)를 반환하려고 시도합니다. 이 설정은 그룹별 개체 수를 일관되게 유지해 주지만, 데이터 분포가 고르지 않거나 리소스가 제한적인 경우 성능 저하를 초래할 수 있습니다. 엄격한 개체 수 유지가 필요하지 않은 경우, `strict_group_size=False`를 설정하면 쿼리 속도를 향상시킬 수 있습니다.쿼리 벡터가 대상 컬렉션에 이미 존재하는 경우, 검색 전에 이를 다시 가져오는 대신
ids를 사용하는 것을 고려해 보십시오. 자세한 내용은 기본 키 검색을 참조하십시오.
