

グループ化検索
グループ化検索を使用すると、Milvusは指定されたフィールドの値に基づいて検索結果をグループ化し、より高いレベルでデータを集約することができます。 たとえば、基本的なANN検索を使用して手元の書籍と類似した書籍を検索することもできますが、グループ化検索を使用すれば、その書籍で取り上げられているトピックに関連する書籍のカテゴリを検索することも可能です。このトピックでは、グループ化検索の使用方法と、その際の重要な考慮事項について説明します。
概要
検索結果内のエンティティがスカラーフィールドで同じ値を共有している場合、それは特定の属性において類似していることを示しており、検索結果に悪影響を及ぼす可能性があります。
あるコレクションに複数のドキュメント(docId で表される)が格納されていると仮定します。 ドキュメントをベクトルに変換する際に、できるだけ多くの意味情報を保持するため、各ドキュメントは、扱いやすい小さな段落(またはチャンク)に分割され、個別のエンティティとして保存されます。ドキュメントが小さなセクションに分割されている場合でも、ユーザーは、自分のニーズに最も関連性の高いドキュメントを特定することに興味を持つことがよくあります。
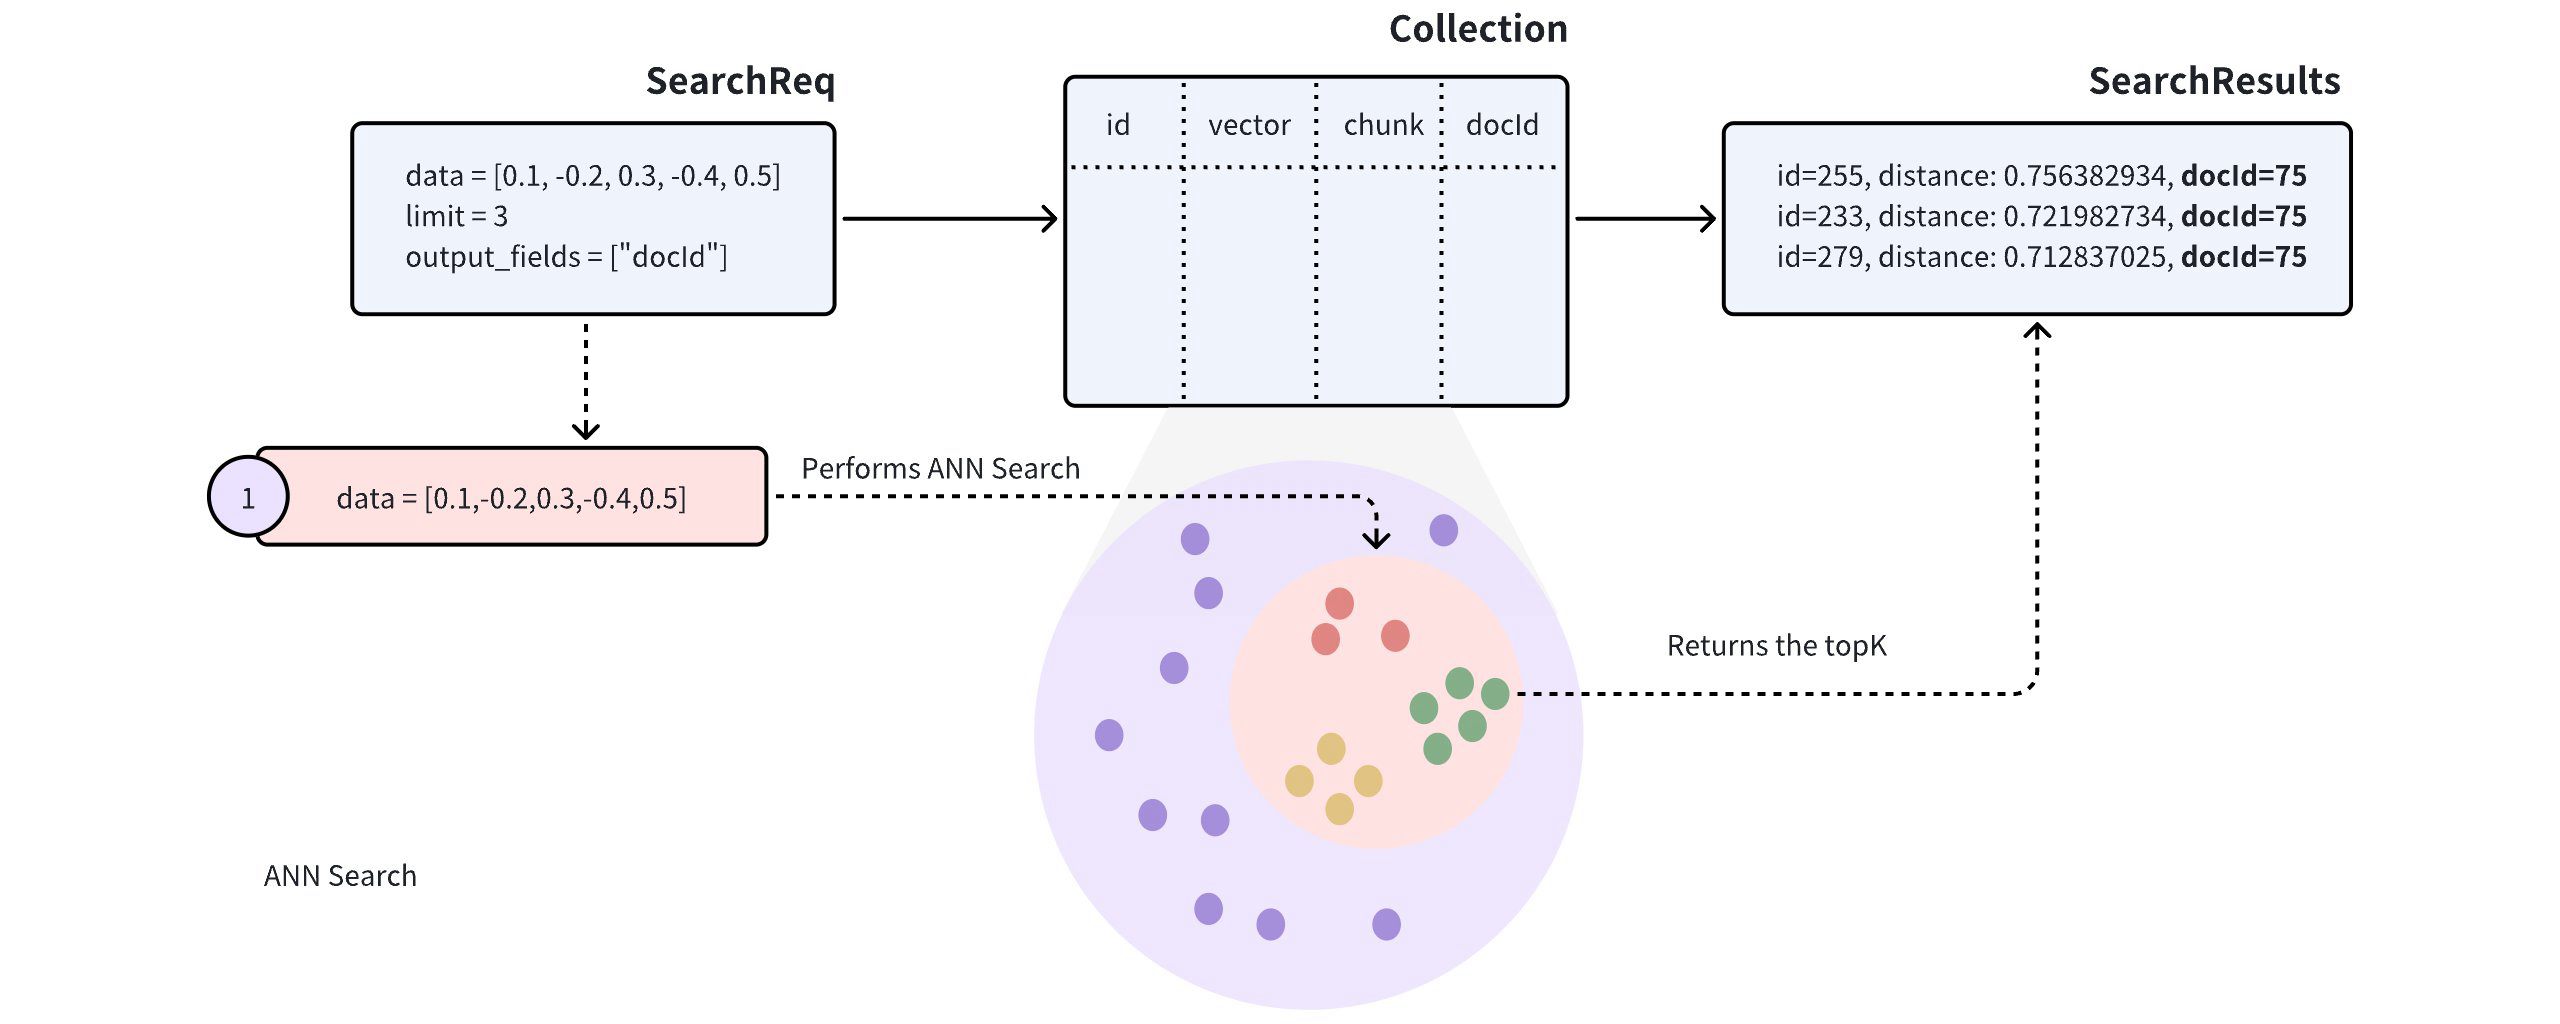 Ann 検索
このようなコレクションに対して近似最寄隣(ANN)検索を実行すると、検索結果に同じドキュメントの複数の段落が含まれる可能性があり、その結果、他のドキュメントが見落とされる恐れがあり、意図したユースケースに沿わない結果となる可能性があります。
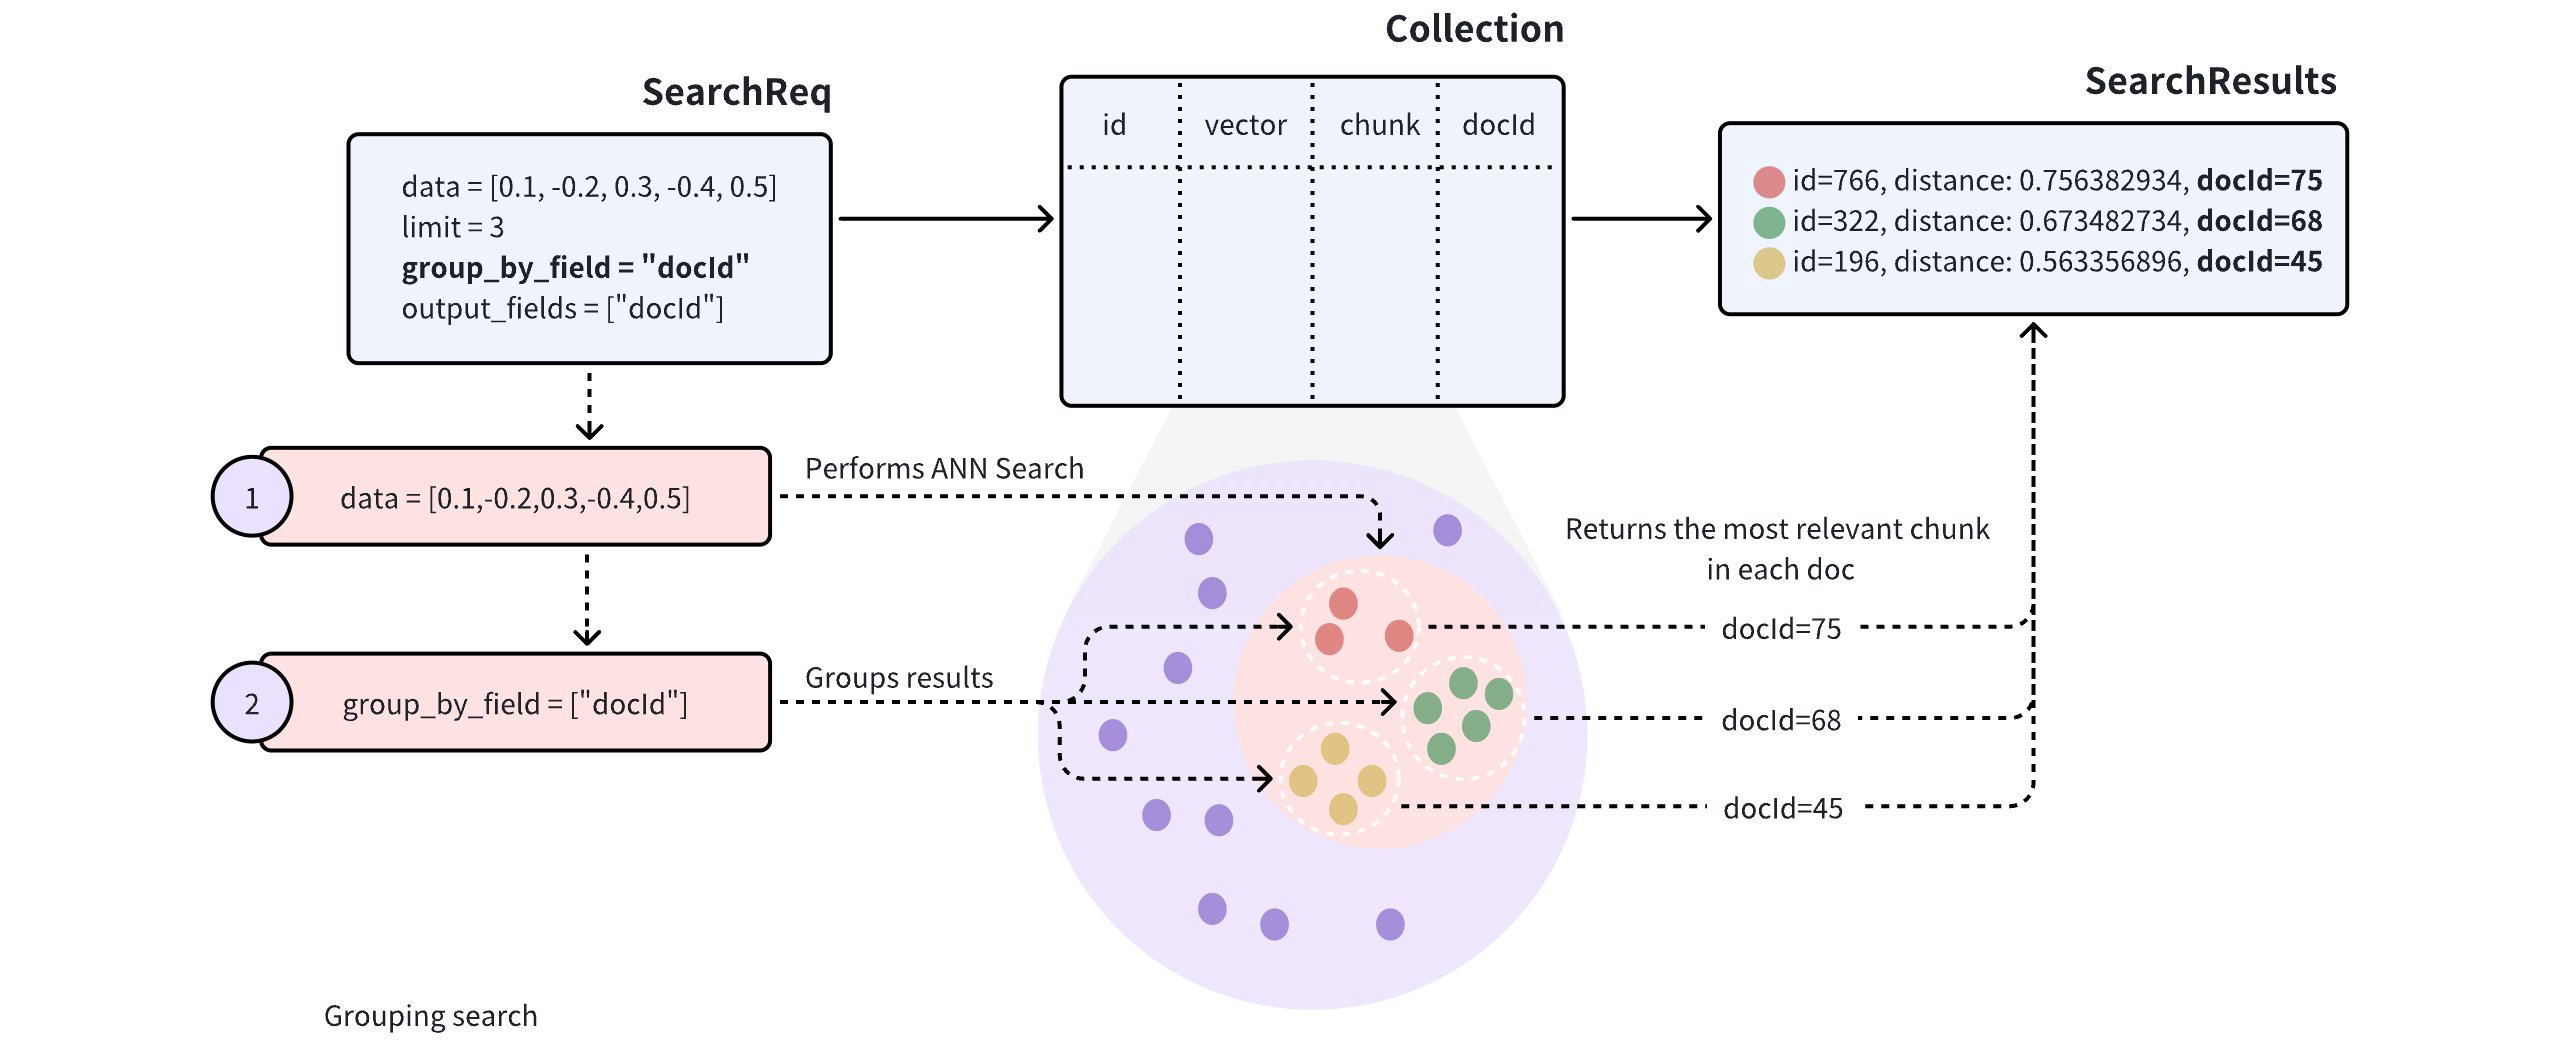 グループ化検索
検索結果の多様性を高めるために、検索リクエストにgroup_by_field パラメータを追加して、グループ化検索を有効にすることができます。図に示すように、group_by_field をdocId に設定できます。このリクエストを受信すると、Milvusは以下の処理を行います:
提供されたクエリベクトルに基づいてANN検索を実行し、クエリに最も類似したすべてのエンティティを検索します。
docIdなどの指定されたgroup_by_fieldに基づいて、検索結果をグループ化します。limitパラメータで定義された各グループについて、そのグループ内で最も類似性の高いエンティティを含む上位の結果を返します。
デフォルトでは、グループ化検索ではグループごとに 1 つのエンティティのみが返されます。グループごとに返す結果の数を増やしたい場合は、group_size およびstrict_group_size パラメータを使用してこれを制御できます。
グループ化検索の実行
このセクションでは、グループ化検索の使用方法を示すサンプルコードを紹介します。以下の例では、コレクションに `id`、`vector`、`chunk`、および `docId` の各フィールドが含まれていることを前提としています。
[
        {"id": 0, "vector": [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592], "chunk": "pink_8682", "docId": 1},
        {"id": 1, "vector": [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501, 0.838729485096104], "chunk": "red_7025", "docId": 5},
        {"id": 2, "vector": [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, 0.7894058910881185, 0.20785793220625592], "chunk": "orange_6781", "docId": 2},
        {"id": 3, "vector": [0.3172005263489739, 0.9719044792798428, -0.36981146090600725, -0.4860894583077995, 0.95791889146345], "chunk": "pink_9298", "docId": 3},
        {"id": 4, "vector": [0.4452349528804562, -0.8757026943054742, 0.8220779437047674, 0.46406290649483184, 0.30337481143159106], "chunk": "red_4794", "docId": 3},
        {"id": 5, "vector": [0.985825131989184, -0.8144651566660419, 0.6299267002202009, 0.1206906911183383, -0.1446277761879955], "chunk": "yellow_4222", "docId": 4},
        {"id": 6, "vector": [0.8371977790571115, -0.015764369584852833, -0.31062937026679327, -0.562666951622192, -0.8984947637863987], "chunk": "red_9392", "docId": 1},
        {"id": 7, "vector": [-0.33445148015177995, -0.2567135004164067, 0.8987539745369246, 0.9402995886420709, 0.5378064918413052], "chunk": "grey_8510", "docId": 2},
        {"id": 8, "vector": [0.39524717779832685, 0.4000257286739164, -0.5890507376891594, -0.8650502298996872, -0.6140360785406336], "chunk": "white_9381", "docId": 5},
        {"id": 9, "vector": [0.5718280481994695, 0.24070317428066512, -0.3737913482606834, -0.06726932177492717, -0.6980531615588608], "chunk": "purple_4976", "docId": 3},
]
検索リクエストでは、group_by_field とoutput_fields の両方をdocId に設定します。Milvusは指定されたフィールドごとに結果をグループ化し、各グループから最も類似度の高いエンティティを返します。返される各エンティティには、docId の値も含まれます。
from pymilvus import MilvusClient

client = MilvusClient(
    uri="http://localhost:19530",
    token="root:Milvus"
)

query_vectors = [
    [0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088]]

# Group search results
res = client.search(
    collection_name="my_collection",
    data=query_vectors,
    limit=3,
    group_by_field="docId",
    output_fields=["docId"]
)

# Retrieve the values in the `docId` column
doc_ids = [result['entity']['docId'] for result in res[0]]
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.vector.request.SearchReq
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.response.SearchResp

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .token("root:Milvus")
        .build());

FloatVec queryVector = new FloatVec(new float[]{0.14529211512077012f, 0.9147257273453546f, 0.7965055218724449f, 0.7009258593102812f, 0.5605206522382088f});
SearchReq searchReq = SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryVector))
        .topK(3)
        .groupByFieldName("docId")
        .outputFields(Collections.singletonList("docId"))
        .build();

SearchResp searchResp = client.search(searchReq);

List<List<SearchResp.SearchResult>> searchResults = searchResp.getSearchResults();
for (List<SearchResp.SearchResult> results : searchResults) {
    System.out.println("TopK results:");
    for (SearchResp.SearchResult result : results) {
        System.out.println(result);
    }
}

// Output
// TopK results:
// SearchResp.SearchResult(entity={docId=5}, score=0.74767184, id=1)
// SearchResp.SearchResult(entity={docId=2}, score=0.6254269, id=7)
// SearchResp.SearchResult(entity={docId=3}, score=0.3611898, id=3)
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

queryVector := []float32{0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592}

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    3,               // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("vector").
    WithGroupByField("docId").
    WithOutputFields("docId"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("docId: ", resultSet.GetColumn("docId").FieldData().GetScalars())
}
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const address = "http://localhost:19530";
const token = "root:Milvus";
const client = new MilvusClient({address, token});

var query_vector = [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]

res = await client.search({
    collection_name: "my_collection",
    data: [query_vector],
    limit: 3,
    group_by_field: "docId"
})

// Retrieve the values in the `docId` column
var docIds = res.results.map(result => result.entity.docId)
export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": [
        [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]
    ],
    "annsField": "vector",
    "limit": 3,
    "groupingField": "docId",
    "outputFields": ["docId"]
}'
#include "milvus/MilvusClientV2.h"
#include <iostream>
#include <stdexcept>
#include <vector>

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"http://localhost:19530", "root:Milvus"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    throw std::runtime_error(status.Message());
}

std::vector<float> query_vector = {0.3580376395471989f, -0.6023495712049978f, 0.18414012509913835f, -0.26286205330961354f, 0.9029438446296592f};
auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .AddFloatVector(query_vector)
                   .WithLimit(3)
                   .WithAnnsField("vector")
                   .WithGroupByField("docId")
                   .AddOutputField("docId");

milvus::SearchResponse response;
status = client->Search(request, response);
if (!status.IsOk()) {
    throw std::runtime_error(status.Message());
}

for (auto& result : response.Results().Results()) {
    std::cout << "TopK results:" << std::endl;
    milvus::EntityRows output_rows;
    status = result.OutputRows(output_rows);
    if (!status.IsOk()) {
        throw std::runtime_error(status.Message());
    }
    for (const auto& row : output_rows) {
        std::cout << "\t" << row << std::endl;
    }
}
上記のリクエストにおいて、limit=3 は、システムが3つのグループから検索結果を返すことを示しており、各グループにはクエリベクトルに最も類似したエンティティが1つずつ含まれます。
グループサイズの設定
デフォルトでは、Grouping Search はグループごとに 1 つのエンティティのみを返します。グループごとに複数の結果を返したい場合は、group_size およびstrict_group_size パラメータを調整してください。
# Group search results

res = client.search(
    collection_name="my_collection",
    data=query_vectors, # query vector
    limit=5, # number of groups to return
    group_by_field="docId", # grouping field
    group_size=2, # p to 2 entities to return from each group
    strict_group_size=True, # return exact 2 entities from each group
    output_fields=["docId"]
)
FloatVec queryVector = new FloatVec(new float[]{0.14529211512077012f, 0.9147257273453546f, 0.7965055218724449f, 0.7009258593102812f, 0.5605206522382088f});
SearchReq searchReq = SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryVector))
        .topK(5)
        .groupByFieldName("docId")
        .groupSize(2)
        .strictGroupSize(true)
        .outputFields(Collections.singletonList("docId"))
        .build();

SearchResp searchResp = client.search(searchReq);

List<List<SearchResp.SearchResult>> searchResults = searchResp.getSearchResults();
for (List<SearchResp.SearchResult> results : searchResults) {
    System.out.println("TopK results:");
    for (SearchResp.SearchResult result : results) {
        System.out.println(result);
    }
}

// Output
// TopK results:
// SearchResp.SearchResult(entity={docId=5}, score=0.74767184, id=1)
// SearchResp.SearchResult(entity={docId=5}, score=-0.49148706, id=8)
// SearchResp.SearchResult(entity={docId=2}, score=0.6254269, id=7)
// SearchResp.SearchResult(entity={docId=2}, score=0.38515577, id=2)
// SearchResp.SearchResult(entity={docId=3}, score=0.3611898, id=3)
// SearchResp.SearchResult(entity={docId=3}, score=0.19556211, id=4)
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

queryVector := []float32{0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592}

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    5,               // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("vector").
    WithGroupByField("docId").
    WithStrictGroupSize(true).
    WithGroupSize(2).
    WithOutputFields("docId"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("docId: ", resultSet.GetColumn("docId").FieldData().GetScalars())
}
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const address = "http://localhost:19530";
const token = "root:Milvus";
const client = new MilvusClient({address, token});

var query_vector = [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]

res = await client.search({
    collection_name: "my_collection",
    data: [query_vector],
    limit: 5,
    group_by_field: "docId",
    group_size: 2,
    strict_group_size: true
})

// Retrieve the values in the `docId` column
var docIds = res.results.map(result => result.entity.docId)
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": [
        [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]
    ],
    "annsField": "vector",
    "limit": 5,
    "groupingField": "docId",
    "groupSize":2,
    "strictGroupSize":true,
    "outputFields": ["docId"]
}'
#include "milvus/MilvusClientV2.h"
#include <iostream>
#include <stdexcept>
#include <vector>

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"http://localhost:19530", "root:Milvus"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    throw std::runtime_error(status.Message());
}

std::vector<float> query_vector = {0.3580376395471989f, -0.6023495712049978f, 0.18414012509913835f, -0.26286205330961354f, 0.9029438446296592f};
auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .AddFloatVector(query_vector)
                   .WithLimit(5)
                   .WithAnnsField("vector")
                   .WithGroupByField("docId")
                   .WithGroupSize(2)
                   .WithStrictGroupSize(true)
                   .AddOutputField("docId");

milvus::SearchResponse response;
status = client->Search(request, response);
if (!status.IsOk()) {
    throw std::runtime_error(status.Message());
}

for (auto& result : response.Results().Results()) {
    std::cout << "TopK results:" << std::endl;
    milvus::EntityRows output_rows;
    status = result.OutputRows(output_rows);
    if (!status.IsOk()) {
        throw std::runtime_error(status.Message());
    }
    for (const auto& row : output_rows) {
        std::cout << "\t" << row << std::endl;
    }
}
上記の例では:
group_size: グループごとに返すエンティティの希望数を指定します。たとえば、group_size=2に設定すると、各グループ(または各docId)は、理想的には最も類似度の高い段落(またはチャンク)を2つ返すことになります。group_sizeが設定されていない場合、システムはデフォルトでグループごとに1つの結果を返します。strict_group_size: このブール型パラメータは、システムがgroup_sizeで設定された数を厳密に適用するかどうかを制御します。strict_group_size=Trueの場合、そのグループに十分なデータがない場合を除き、システムは各グループにgroup_sizeで指定された正確な数のエンティティ(例:2つの段落)を含めるよう試みます。 デフォルト(strict_group_size=False)では、システムは、各グループにgroup_size個のエンティティが含まれることを保証するよりも、limitパラメータで指定されたグループ数を満たすことを優先します。このアプローチは、データの分布が不均一な場合、一般的により効率的です。
パラメータの詳細については、searchを参照してください。
スカラーフィールドによるグループの並べ替えCompatible with Milvus 3.0.x
「グループ化検索(Grouping Search)」と「グループ化検索の並べ替え(order_by_fields )」を組み合わせることで、スカラーフィールドに基づいてグループを並べ替えることができます。これは、グループ間で多様な結果を表示しつつ、価格や評価などビジネスに関連する順序でグループを並べたい場合に役立ちます。
次の例では、検索結果をcategory でグループ化し、グループごとに最大3つのエンティティを返し、返されたグループをprice の値が低い順に並べ替えています。
res = client.search(
    collection_name="product_catalog",
    data=query_vectors,
    anns_field="embedding",
    limit=20,
    group_by_field="category",
    group_size=3,
    strict_group_size=True,
    output_fields=["category", "price", "rating"],
    order_by_fields=[
        {"field": "price", "order": "asc"}
    ],
)
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.request.aggregation.AggDirection;
import io.milvus.v2.service.vector.request.aggregation.OrderByField;
import io.milvus.v2.service.vector.response.SearchResp;
import java.util.List;

// Prerequisite: client is connected to Milvus and product_catalog is loaded.
FloatVec queryVector = new FloatVec(new float[]{0.14529211512077012f, 0.9147257273453546f, 0.7965055218724449f, 0.7009258593102812f, 0.5605206522382088f});
SearchReq request = SearchReq.builder()
    .collectionName("product_catalog")
    .data(List.of(queryVector))
    .annsField("embedding")
    .topK(20)
    .groupByFieldName("category")
    .groupSize(3)
    .strictGroupSize(true)
    .outputFields(List.of("category", "price", "rating"))
    .orderByFields(List.of(OrderByField.builder()
        .fieldName("price").direction(AggDirection.ASC).build()))
    .build();
SearchResp response = client.search(request);
System.out.println(response.getSearchResults());
// Prerequisite: client is connected to Milvus and product_catalog is loaded.
const queryVector = [0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088];
const response = await client.search({
  collection_name: "product_catalog",
  data: [queryVector],
  anns_field: "embedding",
  limit: 20,
  group_by_field: "category",
  group_size: 3,
  strict_group_size: true,
  output_fields: ["category", "price", "rating"],
  order_by_fields: [{ field: "price", order: "asc" }],
});
console.log(response.results);
import (
    "fmt"
    "github.com/milvus-io/milvus/client/v3/entity"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

// Prerequisite: client is connected to Milvus and product_catalog is loaded.
queryVector := []float32{0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088}
results, err := client.Search(ctx, milvusclient.NewSearchOption(
    "product_catalog", 20, []entity.Vector{entity.FloatVector(queryVector)},
).
    WithANNSField("embedding").
    WithGroupByField("category").
    WithGroupSize(3).
    WithStrictGroupSize(true).
    WithOutputFields("category", "price", "rating").
    WithSearchParam("order_by_fields", "price:asc"))
if err != nil {
    panic(err)
}
for _, result := range results {
    fmt.Println(result.IDs, result.Scores)
    fmt.Println(result.GetColumn("category"), result.GetColumn("price"), result.GetColumn("rating"))
}
# Prerequisite: set CLUSTER_ENDPOINT and TOKEN for your Milvus instance.
curl --request POST \
  --url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
  --header "Authorization: Bearer ${TOKEN}" \
  --header "Content-Type: application/json" \
  --data '{
    "collectionName": "product_catalog",
    "data": [[0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088]],
    "annsField": "embedding",
    "limit": 20,
    "groupingField": "category",
    "groupSize": 3,
    "strictGroupSize": true,
    "outputFields": ["category", "price", "rating"],
    "orderByFields": ["price:asc"]
  }'
#include "milvus/MilvusClientV2.h"
#include <iostream>
#include <stdexcept>

// Prerequisite: client is connected to Milvus and product_catalog is loaded.
std::vector<float> query_vector = {0.14529211512077012f, 0.9147257273453546f, 0.7965055218724449f, 0.7009258593102812f, 0.5605206522382088f};
auto request = milvus::SearchRequest()
    .WithCollectionName("product_catalog")
    .AddFloatVector(query_vector)
    .WithAnnsField("embedding")
    .WithLimit(20)
    .WithGroupByField("category")
    .WithGroupSize(3)
    .WithStrictGroupSize(true)
    .AddOutputField("category")
    .AddOutputField("price")
    .AddOutputField("rating")
    .AddOrderByField(milvus::OrderByField("price", milvus::AggregationDirection::ASC));
milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) { throw std::runtime_error(status.Message()); }
for (const auto& result : response.Results().Results()) {
    milvus::EntityRows rows;
    status = result.OutputRows(rows);
    if (!status.IsOk()) { throw std::runtime_error(status.Message()); }
    std::cout << rows << std::endl;
}
上記のリクエストにおいて、limit=20 は、Milvus が 20 個のエンティティではなく、最大 20 個のグループを選択することを意味します。group_size=3 であるため、フラットな結果リストには合計で最大 60 個のエンティティが含まれる可能性があります。
order_by_fields をgroup_by_field と共に使用する場合、Milvus は各グループの最上位エンティティの指定されたスカラーフィールド値に基づいてグループを並べ替えます。各グループ内では、エンティティはクエリベクトルに対する類似度スコア順に並べ替えられたままになります。
考慮事項
インデックス作成: このグループ化機能は、FLAT、IVF_FLAT、IVF_SQ8、HNSW、HNSW_PQ、HNSW_PRQ、HNSW_SQ、DISKANN、SPARSE_INVERTED_INDEX の各インデックスタイプでインデックスが作成されたコレクションでのみ機能します。
グループ数:
limitパラメータは、各グループ内のエンティティの具体的な数ではなく、検索結果が返されるグループの数を制御します。適切なlimitを設定することで、検索の多様性とクエリのパフォーマンスを制御できます。データが密集して分布している場合やパフォーマンスが懸念される場合は、limitを減らすことで計算コストを削減できます。グループあたりのエンティティ数:
group_sizeパラメータは、グループごとに返されるエンティティの数を制御します。ユースケースに応じてgroup_sizeを調整することで、検索結果の豊富さを高めることができます。ただし、データの分布が不均一な場合、特にデータ量が限られているシナリオでは、一部のグループでgroup_sizeで指定された数よりも少ないエンティティが返される可能性があります。グループサイズの厳密設定: `
strict_group_size=True` に設定すると、システムはそのグループに十分なデータがない場合を除き、各グループについて指定されたエンティティ数(group_size)を返すよう試みます。この設定により、グループごとのエンティティ数は一貫して保たれますが、データの分布が不均一な場合やリソースが限られている場合には、パフォーマンスの低下を招く可能性があります。厳密なエンティティ数の指定が必要ない場合は、strict_group_size=Falseを設定することでクエリ速度を向上させることができます。クエリベクトルがターゲットコレクションにすでに存在する場合、検索前にそれらを取得する代わりに、
idsの使用を検討してください。詳細については、「主キー検索」を参照してください。
