

Corrispondenza testuale
La corrispondenza testuale in Milvus consente il recupero preciso dei documenti in base a termini specifici. Questa funzionalità viene utilizzata principalmente per la ricerca filtrata al fine di soddisfare condizioni specifiche e può incorporare il filtraggio scalare per affinare i risultati della query, consentendo ricerche di similarità all'interno di vettori che soddisfano criteri scalari.
TEXT_MATCH Trova i termini analizzati esatti, mentre la ricerca " TEXT_MATCH_FUZZY " può tollerare una piccola distanza di modifica tra i token della query e quelli indicizzati. Entrambe sono operazioni di filtraggio booleano e non valutano la rilevanza dei documenti trovati. Se desideri recuperare i documenti più rilevanti in base al significato semantico e all’importanza dei termini della query, ti consigliamo di utilizzare la ricerca a testo completo.
Panoramica
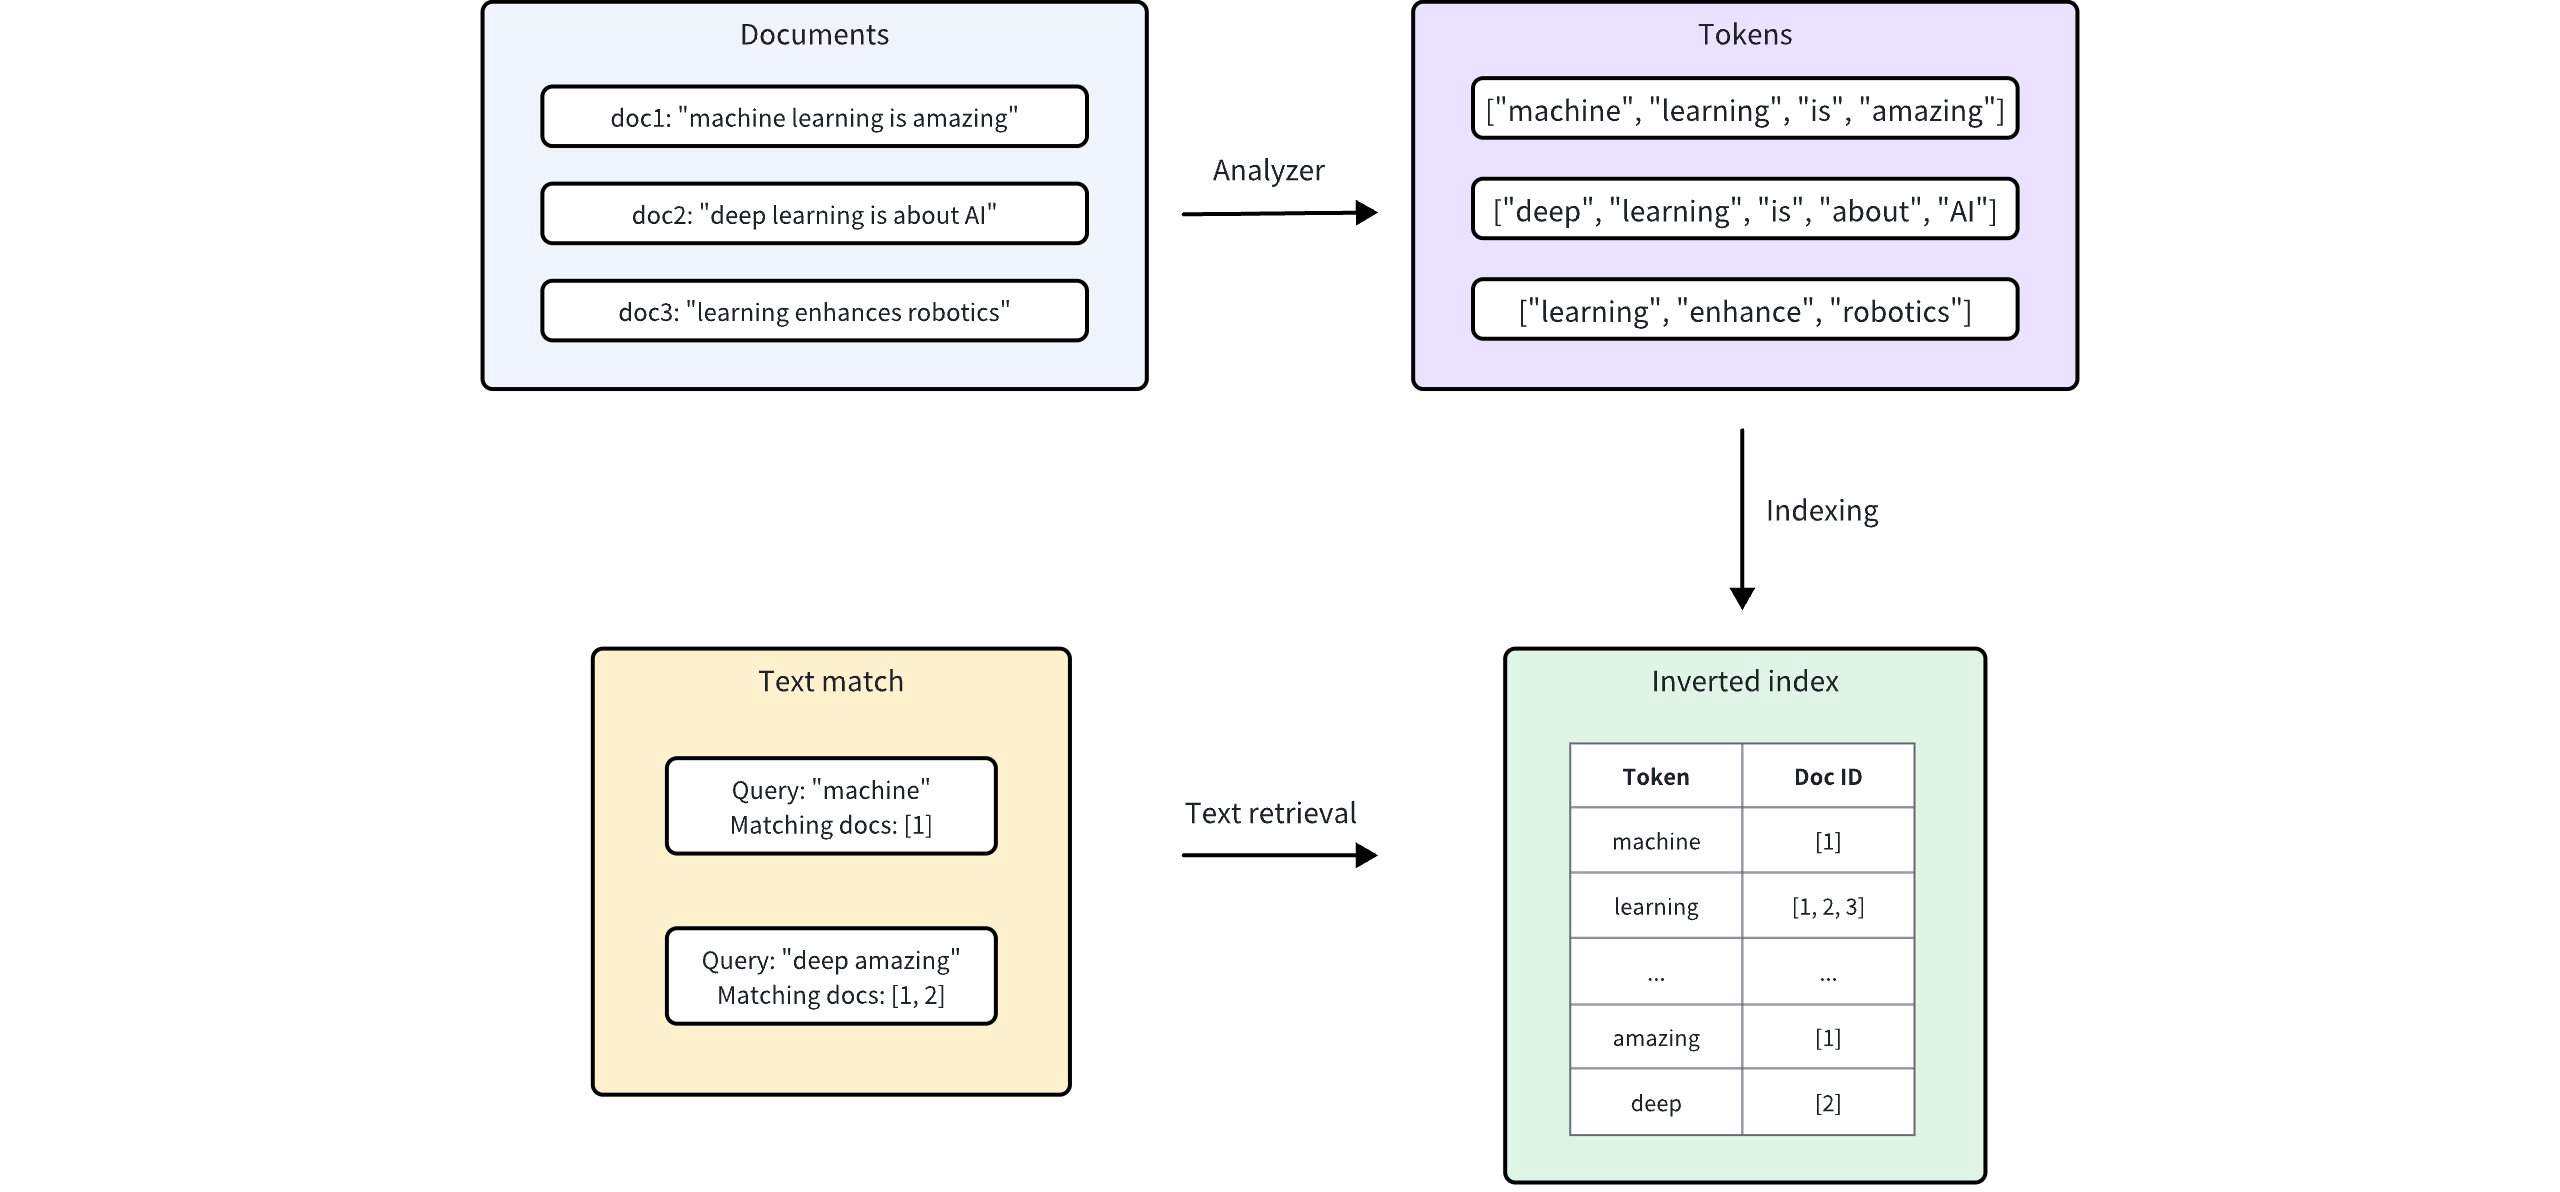
Milvus integra Tantivy per alimentare il proprio indice invertito sottostante e la ricerca testuale basata sui termini. Per ogni inserimento di testo, Milvus lo indicizza seguendo la procedura:
Analizzatore: l’analizzatore elabora il testo in ingresso tokenizzandolo in singole parole, o token, e applicando poi i filtri necessari. Ciò consente a Milvus di costruire un indice basato su questi token.
Indicizzazione: dopo l’analisi del testo, Milvus crea un indice invertito che associa ogni token univoco ai documenti che lo contengono.
Quando un utente esegue una ricerca testuale, l’indice invertito viene utilizzato per recuperare rapidamente tutti i documenti contenenti i termini. Questo processo è molto più veloce rispetto alla scansione individuale di ogni singolo documento.
 Corrispondenza per parola chiave
Abilita la corrispondenza testuale
La corrispondenza testuale funziona sui campi stringa in cui è abilitata la corrispondenza. Gli esempi in questa pagina utilizzano VARCHAR, che è supportato da tutti gli SDK client. In Milvus 3.0.x, TEXT i campi supportano la corrispondenza testuale anche quando Storage V3 è abilitato. Per entrambi i tipi di campo, impostare sia ` enable_analyzer ` che ` enable_match ` su ` True`, quindi, facoltativamente, configurare un analizzatore durante la definizione dello schema della collezione.
Impostare enable_analyzer e enable_match
Per abilitare la corrispondenza testuale per un campo specifico di tipo ` VARCHAR `, impostare entrambi i parametri ` enable_analyzer ` e ` enable_match ` su ` True ` durante la definizione dello schema del campo. Ciò indica a Milvus di tokenizzare il testo e creare un indice invertito per il campo specificato, consentendo corrispondenze testuali veloci ed efficienti.
from pymilvus import MilvusClient, DataType

schema = MilvusClient.create_schema(enable_dynamic_field=False)
schema.add_field(
    field_name="id",
    datatype=DataType.INT64,
    is_primary=True,
    auto_id=True
)
schema.add_field(
    field_name='text',
    datatype=DataType.VARCHAR,
    max_length=1000,
    enable_analyzer=True, # Whether to enable text analysis for this field
    enable_match=True # Whether to enable text match
)
schema.add_field(
    field_name="embeddings",
    datatype=DataType.FLOAT_VECTOR,
    dim=5
)
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .enableDynamicField(false)
        .build();
schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .enableMatch(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("embeddings")
        .dataType(DataType.FloatVector)
        .dimension(5)
        .build());
import "github.com/milvus-io/milvus/client/v2/entity"

schema := entity.NewSchema().WithDynamicFieldEnabled(false)
schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(true),
).WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithEnableMatch(true).
    WithMaxLength(1000),
).WithField(entity.NewField().
    WithName("embeddings").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(5),
)
const schema = [
  {
    name: "id",
    data_type: DataType.Int64,
    is_primary_key: true,
  },
  {
    name: "text",
    data_type: "VarChar",
    enable_analyzer: true,
    enable_match: true,
    max_length: 1000,
  },
  {
    name: "embeddings",
    data_type: DataType.FloatVector,
    dim: 5,
  },
];
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true,
                    "enable_match": true
                }
            },
            {
                "fieldName": "embeddings",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "5"
                }
            }
        ]
    }'
Opzionale: configurare un analizzatore
Le prestazioni e l’accuratezza della corrispondenza delle parole chiave dipendono dall’analizzatore selezionato. Analizzatori diversi sono ottimizzati per varie lingue e strutture di testo, pertanto la scelta di quello giusto può influire in modo significativo sui risultati di ricerca per il vostro caso d’uso specifico.
Per impostazione predefinita, Milvus utilizza l’analizzatore ` standard `, che tokenizza il testo in base agli spazi e alla punteggiatura, rimuove i token più lunghi di 40 caratteri e converte il testo in minuscolo. Non sono necessari parametri aggiuntivi per applicare questa impostazione predefinita. Per ulteriori informazioni, consultare la sezione Standard.
Nei casi in cui sia richiesto un analizzatore diverso, è possibile configurarne uno utilizzando il parametro ` analyzer_params `. Ad esempio, per applicare l’analizzatore ` english ` all’elaborazione di testo in inglese:
analyzer_params = {
    "type": "english"
}
schema.add_field(
    field_name='text',
    datatype=DataType.VARCHAR,
    max_length=200,
    enable_analyzer=True,
    analyzer_params = analyzer_params,
    enable_match = True,
)
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("type", "english");
schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(200)
        .enableAnalyzer(true)
        .analyzerParams(analyzerParams)
        .enableMatch(true)
        .build());
analyzerParams := map[string]any{"type": "english"}
schema.WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithEnableMatch(true).
    WithAnalyzerParams(analyzerParams).
    WithMaxLength(200),
)
const schema = [
  {
    name: "id",
    data_type: DataType.Int64,
    is_primary_key: true,
  },
  {
    name: "text",
    data_type: "VarChar",
    enable_analyzer: true,
    enable_match: true,
    max_length: 1000,
    analyzer_params: { type: 'english' },
  },
  {
    name: "embeddings",
    data_type: DataType.FloatVector,
    dim: 5,
  },
];
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 200,
                    "enable_analyzer": true,
                    "enable_match": true,
                    "analyzer_params": {"type": "english"}
                }
            },
            {
                "fieldName": "embeddings",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "5"
                }
            }
        ]
    }'
Milvus fornisce anche vari altri analizzatori adatti a diverse lingue e scenari. Per ulteriori dettagli, consultare Panoramica degli analizzatori.
Utilizzare la corrispondenza testuale
Una volta abilitata la corrispondenza testuale per un campo VARCHAR o TEXT nello schema della collezione, è possibile eseguire corrispondenze testuali utilizzando l’espressione TEXT_MATCH.
Sintassi dell’espressione TEXT_MATCH
L’espressione TEXT_MATCH viene utilizzata per specificare il campo e i termini da cercare. La sua sintassi è la seguente:
TEXT_MATCH(field_name, text)
field_name: Il nome del campoVARCHARoTEXTabilitato alla corrispondenza da cercare.text: I termini da cercare. È possibile specificare più termini separati da spazi o altri delimitatori appropriati in base alla lingua e all'analizzatore configurato.
Per impostazione predefinita, TEXT_MATCH utilizza la logica di corrispondenza OR, il che significa che restituirà i documenti che contengono uno qualsiasi dei termini specificati. Ad esempio, per cercare documenti contenenti il termine machine o deep nel campo text, utilizzare la seguente espressione:
filter = "TEXT_MATCH(text, 'machine deep')"
String filter = "TEXT_MATCH(text, 'machine deep')";
filter := "TEXT_MATCH(text, 'machine deep')"
const filter = "TEXT_MATCH(text, 'machine deep')";
export filter="\"TEXT_MATCH(text, 'machine deep')\""
È inoltre possibile combinare più espressioni TEXT_MATCH utilizzando operatori logici per eseguire una corrispondenza AND.
Per cercare documenti contenenti sia
machinechedeepnel campotext, utilizzare la seguente espressione:filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')"String filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')";filter := "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')"const filter = "TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')"export filter="\"TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'deep')\""Per cercare documenti che contengano sia
machinechelearningma senzadeepnel campotext, utilizzare le seguenti espressioni:filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')"String filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')";filter := "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')"const filter = "not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')";export filter="\"not TEXT_MATCH(text, 'deep') and TEXT_MATCH(text, 'machine') and TEXT_MATCH(text, 'learning')\""
Sintassi dell’espressione TEXT_MATCH_FUZZYCompatible with Milvus 3.0.0+
Utilizzare TEXT_MATCH_FUZZY per tollerare differenze ortografiche tra i token della query e quelli indicizzati. Milvus analizza il testo della query con l’analizzatore del campo e applica la corrispondenza approssimativa a ciascun token risultante. Se la query produce più token, l’espressione trova una corrispondenza con un’entità quando uno qualsiasi dei token soddisfa la distanza di modifica configurata.
La sintassi è la seguente:
TEXT_MATCH_FUZZY(field_name, text, max_edit_distance = 1)
field_name: Il nome del campoVARCHARoTEXTabilitato alla corrispondenza su cui effettuare la ricerca.text: Il testo della query da analizzare e da confrontare con i token indicizzati.max_edit_distance: La distanza di modifica massima consentita per ciascun token della query. Il nome dell’opzione deve essere esattamentemax_edit_distancee il suo valore deve essere0,1o2. Un valore pari a0esegue la corrispondenza esatta dei token, equivalente aTEXT_MATCH.
Ad esempio, l’espressione seguente individua i token che differiscono di un solo carattere da machne, incluso machine:
filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)"
String filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)";
filter := "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)"
const filter = "TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)";
export filter="\"TEXT_MATCH_FUZZY(text, 'machne', max_edit_distance = 1)\""
TEXT_MATCH_FUZZY fa parte della sintassi delle espressioni di filtro, pertanto gli SDK client non richiedono un metodo dedicato per la corrispondenza approssimativa. Passare l'espressione tramite lo stesso parametro filter utilizzato per TEXT_MATCH nelle operazioni di ricerca o di query.
Ricerca con corrispondenza testuale
La corrispondenza testuale può essere utilizzata in combinazione con la ricerca per similarità vettoriale per restringere l’ambito di ricerca e migliorare le prestazioni di ricerca. Filtrando la raccolta tramite la corrispondenza testuale prima della ricerca per similarità vettoriale, è possibile ridurre il numero di documenti da cercare, con conseguente riduzione dei tempi di query.
In questo esempio, l’espressione filter filtra i risultati della ricerca in modo da includere solo i documenti che corrispondono al termine specificato keyword1 o keyword2. La ricerca per somiglianza vettoriale viene quindi eseguita su questo sottoinsieme filtrato di documenti.
È possibile evidenziare i termini corrispondenti nei risultati di ricerca configurando un evidenziatore di testo. Per ulteriori dettagli, consultare la sezione Evidenziatore di testo.
# Match entities with `keyword1` or `keyword2`
filter = "TEXT_MATCH(text, 'keyword1 keyword2')"

# Assuming 'embeddings' is the vector field and 'text' is the VARCHAR field
result = client.search(
    collection_name="my_collection", # Your collection name
    anns_field="embeddings", # Vector field name
    data=[query_vector], # Query vector
    filter=filter,
    search_params={"params": {"nprobe": 10}},
    limit=10, # Max. number of results to return
    output_fields=["id", "text"] # Fields to return
)
String filter = "TEXT_MATCH(text, 'keyword1 keyword2')";

SearchResp searchResp = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .annsField("embeddings")
        .data(Collections.singletonList(queryVector)))
        .filter(filter)
        .topK(10)
        .outputFields(Arrays.asList("id", "text"))
        .build());
filter := "TEXT_MATCH(text, 'keyword1 keyword2')"

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    10,               // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("embeddings").
    WithFilter(filter).
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
// Match entities with `keyword1` or `keyword2`
const filter = "TEXT_MATCH(text, 'keyword1 keyword2')";

// Assuming 'embeddings' is the vector field and 'text' is the VARCHAR field
const result = await client.search(
    collection_name: "my_collection", // Your collection name
    anns_field: "embeddings", // Vector field name
    data: [query_vector], // Query vector
    filter: filter,
    params: {"nprobe": 10},
    limit: 10, // Max. number of results to return
    output_fields: ["id", "text"] //Fields to return
);
export filter="\"TEXT_MATCH(text, 'keyword1 keyword2')\""

export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "annsField": "embeddings",
    "data": [[0.19886812562848388, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501, 0.838729485096104]],
    "filter": '"$filter"',
    "searchParams": {
        "params": {
            "nprobe": 10
        }
    },
    "limit": 10,
    "outputFields": ["text","id"]
}'
Query con corrispondenza testuale
La corrispondenza testuale può essere utilizzata anche per il filtraggio scalare nelle operazioni di query. Specificando un’espressione TEXT_MATCH nel parametro expr del metodo query(), è possibile recuperare i documenti che corrispondono ai termini indicati.
L'esempio riportato di seguito recupera i documenti in cui il campo text contiene entrambi i termini keyword1 e keyword2.
# Match entities with both `keyword1` and `keyword2`
filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')"

result = client.query(
    collection_name="my_collection",
    filter=filter,
    output_fields=["id", "text"]
)
String filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')";

QueryResp queryResp = client.query(QueryReq.builder()
        .collectionName("my_collection")
        .filter(filter)
        .outputFields(Arrays.asList("id", "text"))
        .build()
);
filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')"
resultSet, err := client.Query(ctx, milvusclient.NewQueryOption("my_collection").
    WithFilter(filter).
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
// Match entities with both `keyword1` and `keyword2`
const filter = "TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')";

const result = await client.query(
    collection_name: "my_collection",
    filter: filter,
    output_fields: ["id", "text"]
)
export filter="\"TEXT_MATCH(text, 'keyword1') and TEXT_MATCH(text, 'keyword2')\""

export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/query" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "filter": '"$filter"',
    "outputFields": ["id", "text"]
}'
Considerazioni
L'abilitazione della corrispondenza dei termini per un campo comporta la creazione di un indice invertito, che consuma risorse di archiviazione. Quando si decide di abilitare questa funzionalità, è necessario considerare l'impatto sull'archiviazione, poiché varia in base alla dimensione del testo, ai token univoci e all'analizzatore utilizzato.
Una volta definito un analizzatore nello schema, le relative impostazioni diventano permanenti per quella raccolta. Se si ritiene che un analizzatore diverso sia più adatto alle proprie esigenze, è possibile eliminare la raccolta esistente e crearne una nuova con la configurazione dell’analizzatore desiderata.
Regole di escape nelle espressioni dell'
filter:I caratteri racchiusi tra virgolette doppie o singole all’interno delle espressioni vengono interpretati come costanti stringa. Se la costante stringa include caratteri di escape, questi devono essere rappresentati con una sequenza di escape. Ad esempio, utilizzare
\\per rappresentare\,\\tper rappresentare un tabulatore\te\\nper rappresentare un carattere di nuova riga.Se una costante stringa è racchiusa tra virgolette singole, una virgoletta singola all’interno della costante deve essere rappresentata come
\\', mentre una virgoletta doppia può essere rappresentata sia come"che come\\". Esempio:'It\\'s milvus'.Se una costante stringa è racchiusa tra virgolette doppie, una virgoletta doppia all’interno della costante deve essere rappresentata come
\\", mentre una virgoletta singola può essere rappresentata sia come'che come\\'. Esempio:"He said \\"Hi\\"".
