

HNSW
L'indice HNSW è un algoritmo di indicizzazione basato su grafi in grado di migliorare le prestazioni nella ricerca di vettori flottanti ad alta dimensionalità. Offre un'eccellente precisione di ricerca e una bassa latenza, ma richiede un elevato overhead di memoria per mantenere la propria struttura gerarchica a grafo.
Panoramica
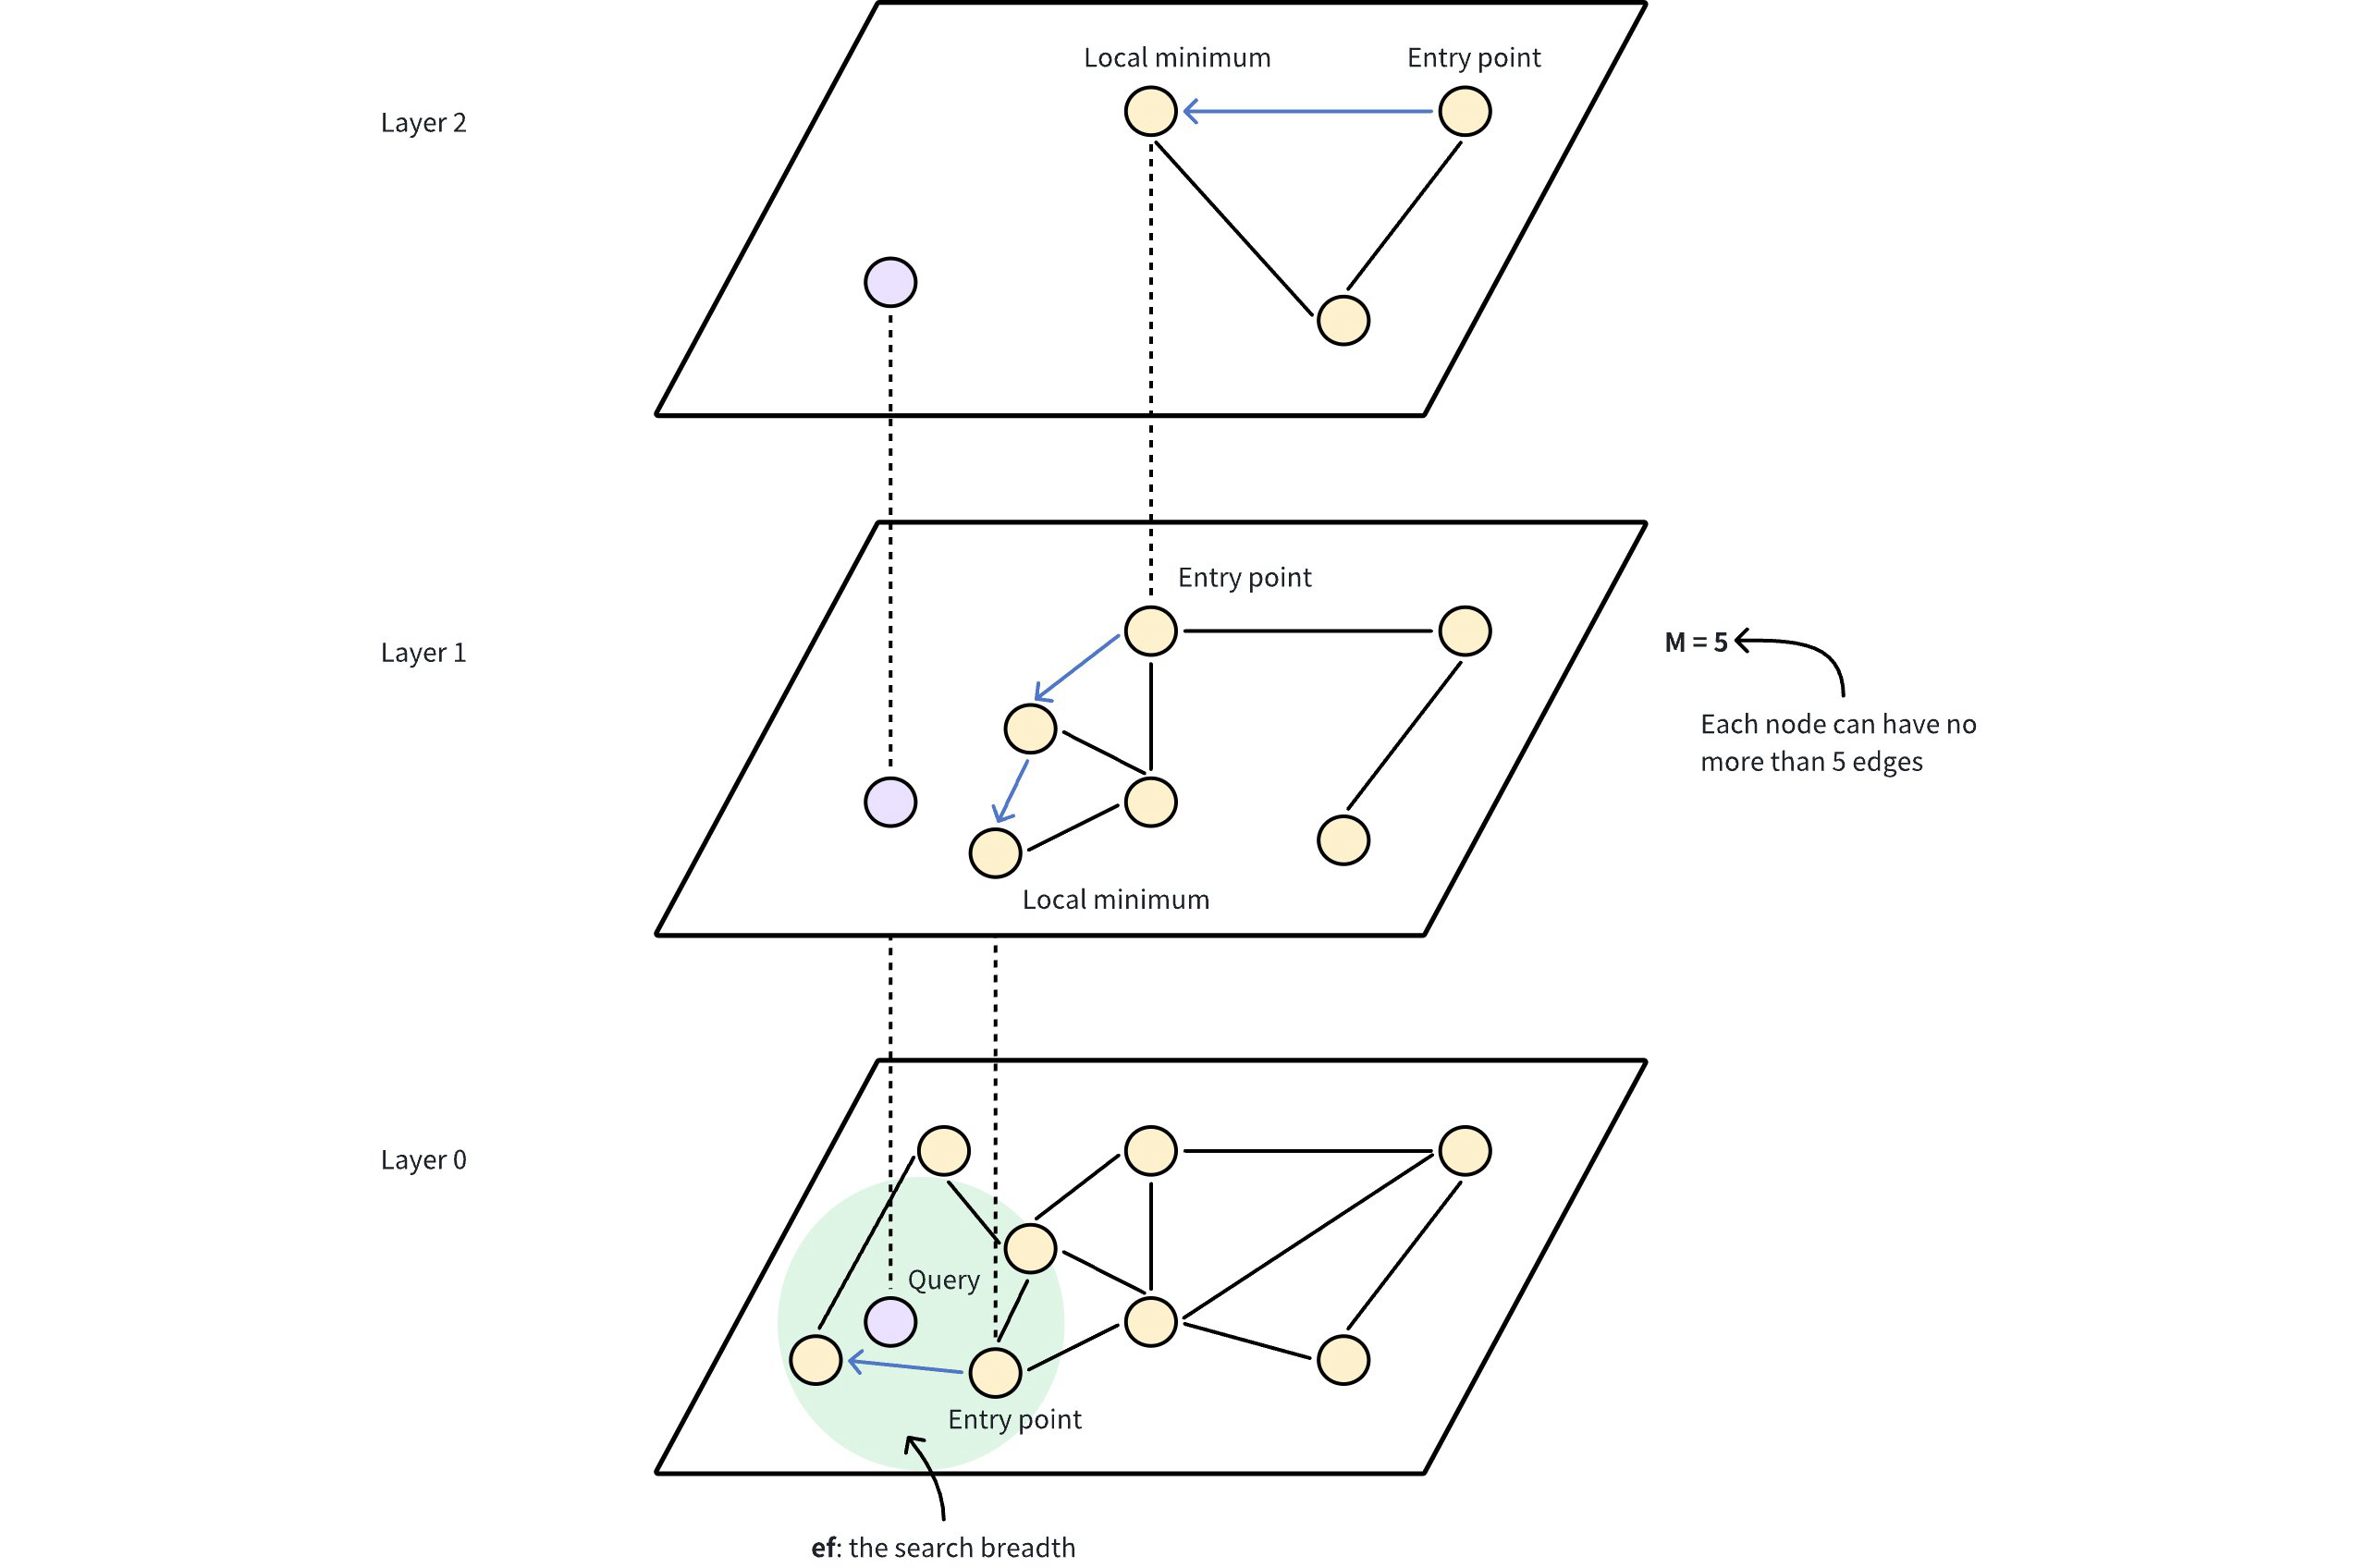
L'algoritmo Hierarchical Navigable Small World (HNSW) costruisce un grafo a più livelli, simile a una mappa con diversi livelli di zoom. Il livello inferiore contiene tutti i punti dati, mentre i livelli superiori sono costituiti da un sottoinsieme di punti dati campionati dal livello inferiore.
In questa gerarchia, ogni livello contiene nodi che rappresentano i punti dati, collegati da archi che indicano la loro vicinanza. I livelli superiori consentono salti a lunga distanza per avvicinarsi rapidamente all’obiettivo, mentre i livelli inferiori permettono una ricerca più dettagliata per ottenere i risultati più accurati.
Ecco come funziona:
Punto di ingresso: la ricerca inizia da un punto di ingresso fisso nel livello superiore, che è un nodo predeterminato nel grafico.
Ricerca avida: l’algoritmo si sposta in modo avido verso il vicino più prossimo nello strato corrente finché non può avvicinarsi ulteriormente al vettore di query. Gli strati superiori hanno una funzione di navigazione, agendo come un filtro grossolano per individuare potenziali punti di ingresso per la ricerca più dettagliata ai livelli inferiori.
Discesa tra i livelli: una volta raggiunto un minimo locale nel livello corrente, l’algoritmo salta al livello inferiore, utilizzando una connessione prestabilita, e ripete la ricerca avida.
Raffinamentofinale: questo processo continua fino al raggiungimento del livello più basso, dove una fase di raffinamento finale identifica i vicini più prossimi.
 HNSW
Le prestazioni di HNSW dipendono da diversi parametri chiave che controllano sia la struttura del grafo sia il comportamento di ricerca. Tra questi figurano:
M: Il numero massimo di spigoli o connessioni che ogni nodo può avere nel grafo a ciascun livello della gerarchia. Un valore più alto diMdetermina un grafo più denso e aumenta il richiamo e l’accuratezza, poiché la ricerca dispone di più percorsi da esplorare; ciò comporta però un maggiore consumo di memoria e un rallentamento dei tempi di inserimento a causa delle connessioni aggiuntive. Come mostrato nell’immagine sopra, M = 5 indica che ogni nodo nel grafo HNSW è collegato direttamente a un massimo di 5 altri nodi. Ciò crea una struttura del grafo moderatamente densa in cui i nodi dispongono di più percorsi per raggiungere altri nodi.efConstruction: Il numero di candidati presi in considerazione durante la costruzione dell’indice. Un valore più alto di “efConstruction” (numero di vicini) comporta generalmente un grafico di qualità migliore, ma richiede più tempo per la costruzione.ef: Il numero di vicini valutati durante una ricerca. Aumentando l’efe si migliora la probabilità di trovare i vicini più prossimi, ma si rallenta il processo di ricerca.
Per i dettagli su come regolare queste impostazioni in base alle proprie esigenze, consultare Parametri dell’indice.
Crea indice
Questo esempio utilizza un’ MilvusClient e connessa denominata client e una collezione esistente denominata your_collection_name. La collezione presenta un campo FLOAT_VECTOR a cinque dimensioni denominato your_vector_field_name. Consultare Installare l’SDK Python di Milvus per la compatibilità dell’SDK e Creare una collezione per lo schema e la configurazione della connessione. Sostituire il nome del campo e la dimensione della query insieme quando si adatta l’esempio ai propri embedding.
Definire i parametri dell’indice con ` add_index()`, quindi creare l’indice con ` create_index()`.
from pymilvus import MilvusClient

# Prepare index building params
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="your_vector_field_name", # Name of the vector field to be indexed
    index_type="HNSW", # Type of the index to create
    index_name="vector_index", # Name of the index to create
    metric_type="L2", # Metric type used to measure similarity
    params={
        "M": 64, # Maximum number of neighbors each node can connect to in the graph
        "efConstruction": 100 # Number of candidate neighbors considered for connection during index construction
    } # Index building params
)

client.create_index(
    collection_name="your_collection_name",
    index_params=index_params
)
In questa configurazione:
index_type: Il tipo di indice da creare. In questo esempio, impostare il valore suHNSW.metric_type: Il metodo utilizzato per calcolare la distanza tra i vettori. I valori supportati includonoCOSINE,L2eIP. Per ulteriori dettagli, consultare Tipi di metriche.params: Opzioni di configurazione aggiuntive per la creazione dell’indice.M: Numero massimo di vicini a cui ogni nodo può connettersi.efConstruction: Numero di vicini candidati presi in considerazione per la connessione durante la creazione dell’indice.
L’esempio imposta
M=64eefConstruction=100come valori di ottimizzazione. Per i valori predefiniti e gli intervalli consentiti, consultare Parametri di creazione dell’indice.
Per creare contemporaneamente una raccolta e il relativo indice, passare i parametri dell’indice a create_collection(). Per ulteriori dettagli, consultare Creazione di una raccolta.
Ricerca sull’indice
Dopo aver creato l'indice e inserito le entità, caricare la collezione ed eseguire la ricerca nel suo campo vettoriale. Per le normali ricerche kNN, impostare ` ef ` su un valore almeno pari a ` limit`.
search_params = {
    "params": {
        "ef": 10, # Number of neighbors to consider during the search
    }
}

client.load_collection(collection_name="your_collection_name")

res = client.search(
    collection_name="your_collection_name", # Collection name
    anns_field="your_vector_field_name", # Vector field name
    data=[[0.1, 0.2, 0.3, 0.4, 0.5]],  # Query vector
    limit=10,  # TopK results to return
    search_params=search_params
)
In questa configurazione:
params: Opzioni di configurazione aggiuntive per la ricerca sull’indice.ef: Numero di vicini da considerare durante una ricerca.
Per ulteriori informazioni sui parametri di ricerca disponibili per l'indice
HNSW, consultare Parametri di ricerca specifici dell'indice.
Parametri dell’indice
Le tabelle seguenti elencano i parametri per la creazione dell’indice e la ricerca. Le impostazioni del server possono sovrascrivere i valori predefiniti per i parametri omessi.
Parametri di creazione dell’indice
La tabella seguente elenca i parametri configurabili in params durante la creazione di un indice.
Parametro |
Descrizione |
Intervallo di valori |
Suggerimento di ottimizzazione |
|---|---|---|---|
|
Numero massimo di connessioni (o spigoli) che ogni nodo può avere nel grafo, inclusi sia gli spigoli in uscita che quelli in entrata. Questo parametro influisce direttamente sia sulla creazione dell’indice che sulla ricerca. |
Tipo: Intero Intervallo: [2, 2048] Valore predefinito: |
Un valore più elevato di " Si consiglia di ridurre il valore di ` Nella maggior parte dei casi, si consiglia di impostare un valore compreso in questo intervallo: [5, 100]. |
|
Numero di vicini candidati presi in considerazione per la connessione durante la creazione dell’indice. Per ogni nuovo elemento viene valutato un insieme più ampio di candidati, ma il numero massimo di connessioni effettivamente stabilite rimane comunque limitato da |
Tipo: Intero Intervallo: [1, int_max] Valore predefinito: |
Un valore più elevato di ` Si consiglia di ridurre il valore di ` Nella maggior parte dei casi, si consiglia di impostare un valore compreso in questo intervallo: [50, 500]. |
Parametri di ricerca specifici dell’indice
La tabella seguente elenca i parametri configurabili in search_params.params durante la ricerca nell’indice.
Parametro |
Descrizione |
Intervallo di valori |
Suggerimento di ottimizzazione |
|---|---|---|---|
|
Controlla l'ampiezza della ricerca durante il recupero del vicino più prossimo. Determina quanti nodi vengono visitati e valutati come potenziali vicini più prossimi. Questo parametro influisce solo sul processo di ricerca e si applica esclusivamente allo strato inferiore del grafico. |
Tipo: Intero Intervallo: [1, int_max] Valore predefinito: Per la ricerca kNN ordinaria, un valore esplicito di ` |
Un valore maggiore di Si consiglia di ridurre il valore di ` Nella maggior parte dei casi, si consiglia di impostare un valore compreso in questo intervallo: [K, 10K]. |
Valutare i compromessi
Utilizzate dati e query rappresentativi per scegliere i parametri, anziché considerare i valori di esempio come impostazioni predefinite di produzione:
- Fissare il modello di embedding, la metrica, l’
limite le eventuali condizioni di filtro. Calcolare i vicini più prossimi esatti per le stesse query e le entità idonee, ad esempio con un indice FLAT, per misurare il recall. - Varia l’
efe del tempo di ricerca alla concorrenza desiderata. Registra insieme il recall, il throughput e la latenza di coda. L’aumento dell’efe non richiede la ricostruzione dell’indice. - Se l’ottimizzazione in fase di ricerca non riesce a soddisfare l’obiettivo, confrontare gli indici ricostruiti con diversi valori di
MeefConstruction. Registrare il tempo di creazione dell’indice e l’utilizzo della memoria, oltre alle prestazioni delle query. - Includere nel test la strategia di caricamento e lo stato della cache. Quando si utilizza l’archiviazione a livelli (Tiered Storage), misurare separatamente le query che recuperano dati non memorizzati nella cache rispetto alle query con cache “warm”.
In caso di limitazioni di memoria o di obiettivi diversi per il recall e la latenza, confrontare le alternative descritte in "Index Explained".
