

Ricerca full-text
La ricerca full-text è una funzionalità che recupera i documenti contenenti termini o frasi specifici all'interno di set di dati testuali, classificando poi i risultati in base alla rilevanza. Questa funzionalità supera i limiti della ricerca semantica, che potrebbe trascurare termini precisi, garantendo risultati più accurati e contestualmente rilevanti. Inoltre, semplifica le ricerche vettoriali accettando l’input di testo grezzo, convertendo automaticamente i dati testuali in embedding sparsi senza la necessità di generare manualmente gli embedding vettoriali.
Utilizzando l’algoritmo BM25 per il punteggio di rilevanza, questa funzionalità è particolarmente utile negli scenari di generazione potenziata dal recupero (RAG), dove dà priorità ai documenti che corrispondono da vicino a termini di ricerca specifici.
Integrando la ricerca full-text con la ricerca vettoriale densa basata sulla semantica, è possibile migliorare l’accuratezza e la pertinenza dei risultati di ricerca. Per ulteriori informazioni, consultare Ricerca ibrida.
Implementazione di BM25
Milvus offre la ricerca full-text basata sull’algoritmo di rilevanza BM25, una funzione di valutazione ampiamente adottata nei sistemi di recupero delle informazioni, e la integra nel flusso di lavoro di ricerca per fornire risultati testuali accurati e ordinati per rilevanza.
La ricerca full-text in Milvus segue il flusso di lavoro riportato di seguito:
Inserimento del testo grezzo: si inseriscono documenti di testo o si effettua una query utilizzando testo semplice, senza bisogno di modelli di embedding.
Analisi del testo: Milvus utilizza un analizzatore per elaborare il testo in termini significativi che possono essere indicizzati e ricercati.
Elaborazione della funzione BM25: una funzione integrata trasforma questi termini in rappresentazioni vettoriali sparse ottimizzate per il punteggio BM25.
Archiviazione nella collezione: Milvus archivia gli embedding sparsi risultanti in una collezione per un recupero e un ordinamento rapidi.
Punteggio di rilevanza BM25: al momento della ricerca, Milvus applica la funzione di punteggio BM25 per calcolare la rilevanza dei documenti e restituire i risultati classificati che corrispondono meglio ai termini della query.
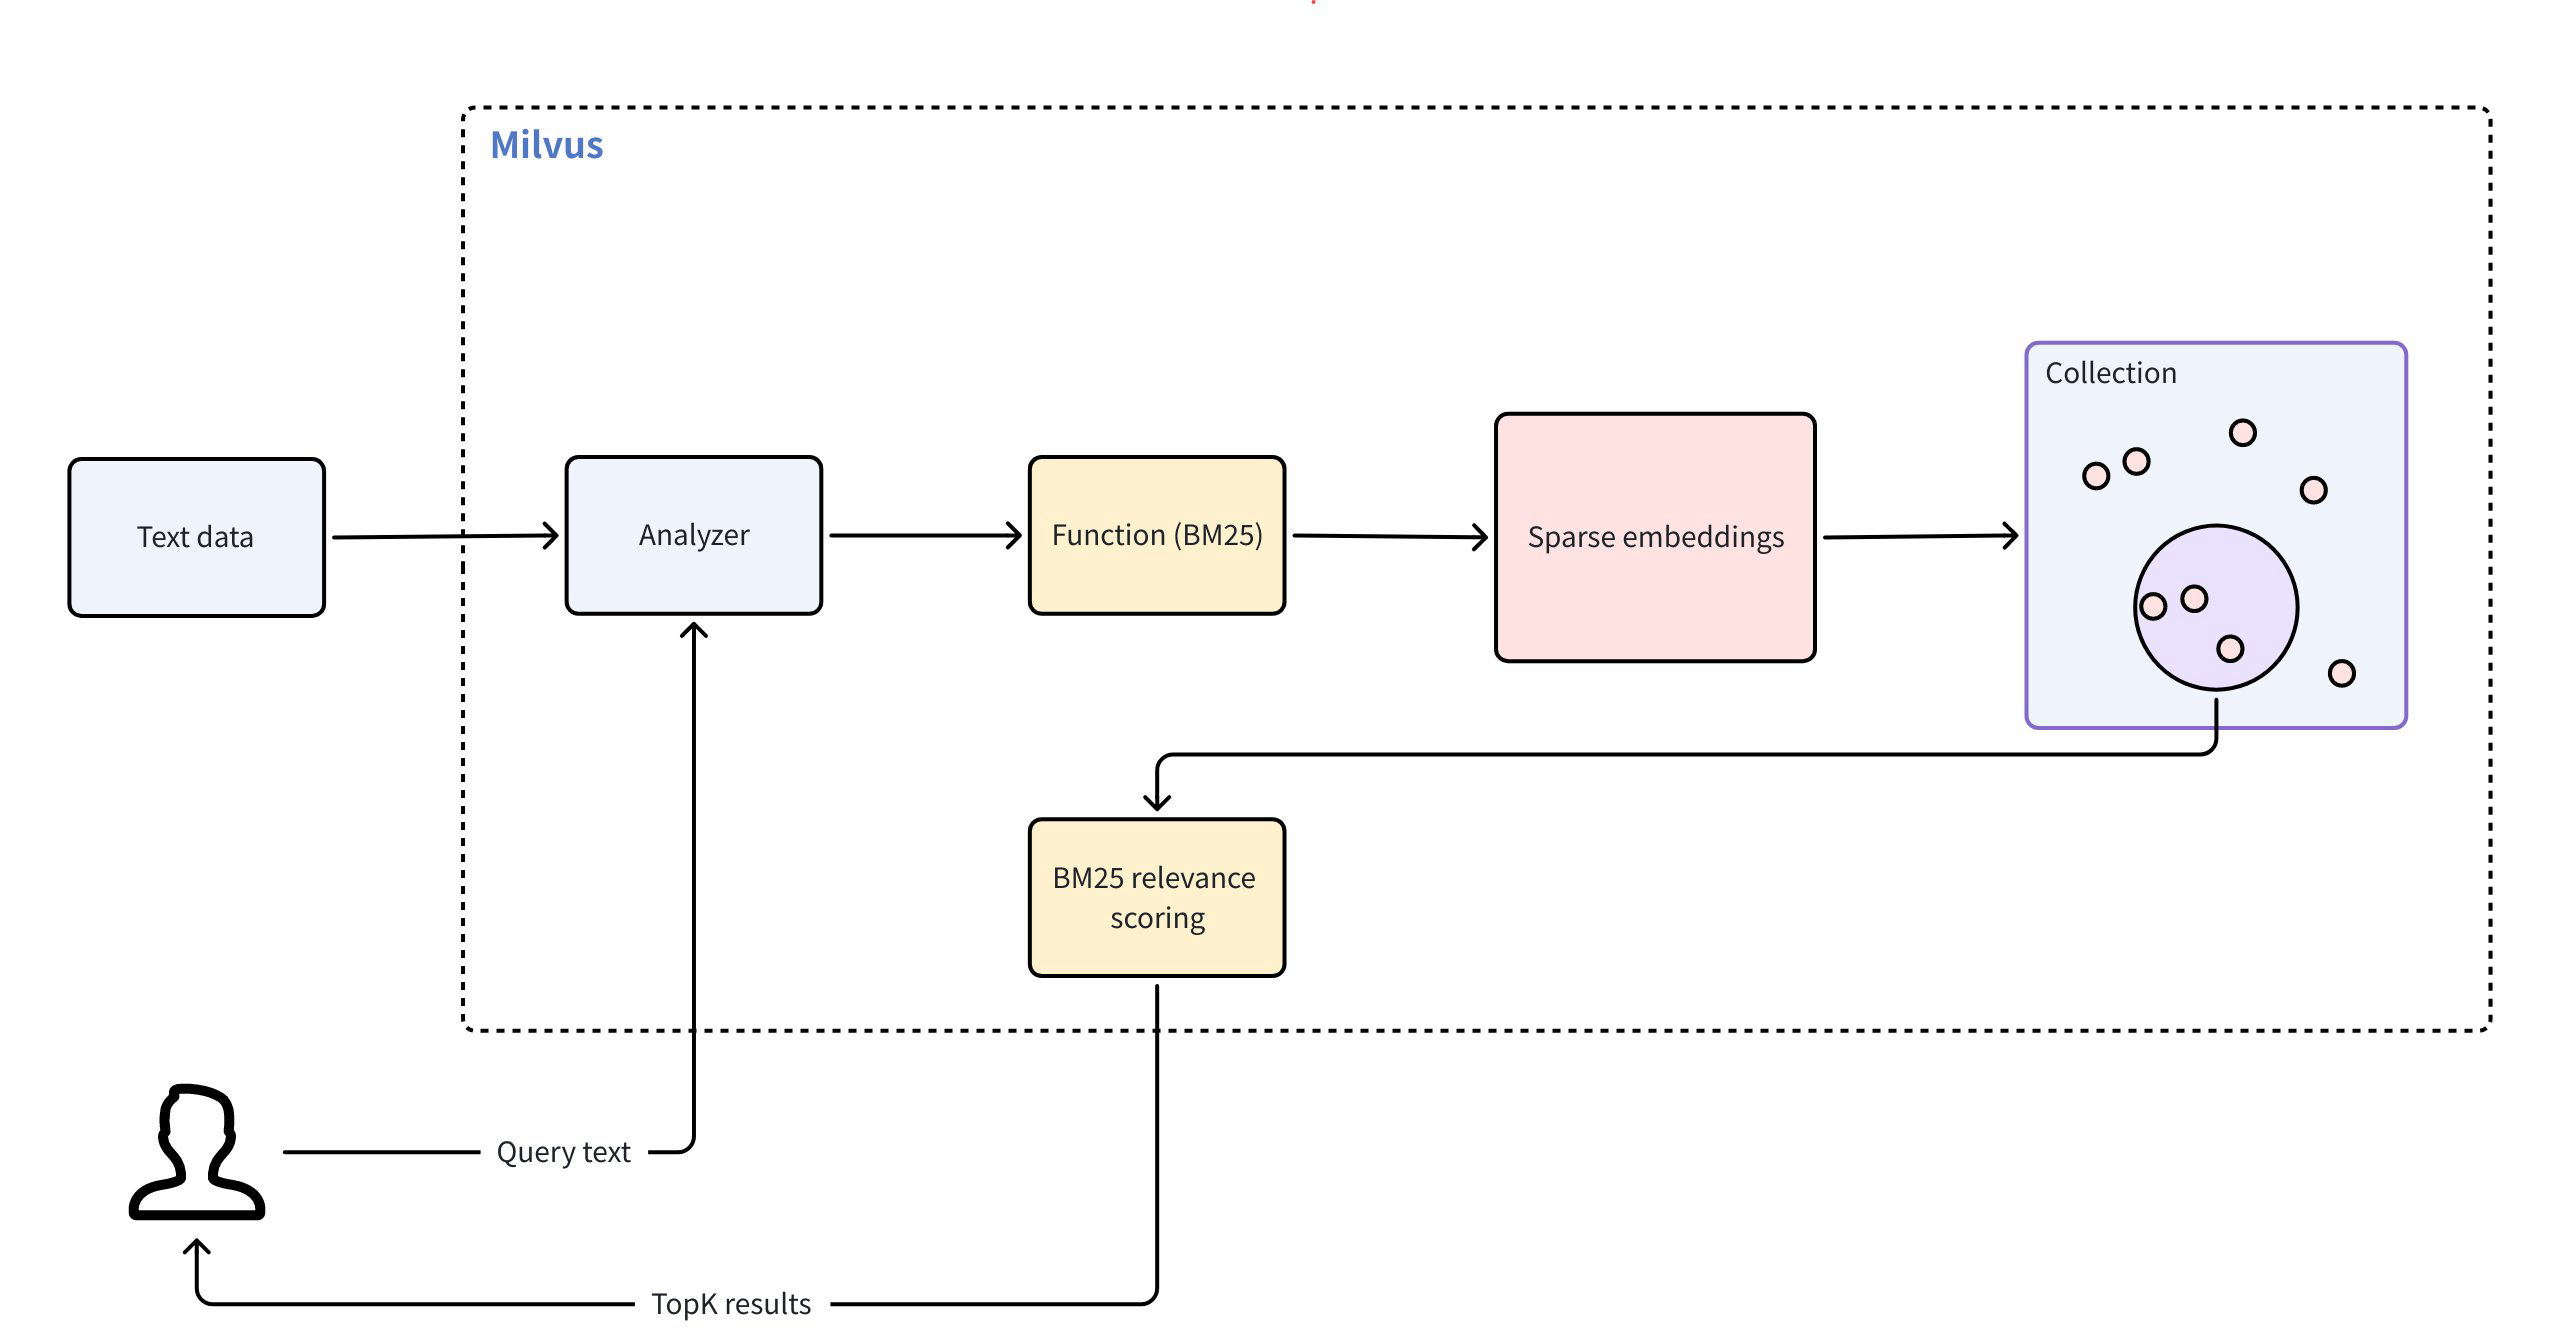 Ricerca full-text
Per utilizzare la ricerca full-text, segui questi passaggi principali:
Creazione di una collezione: configurare i campi richiesti e definire una funzione BM25 che converta il testo grezzo in embedding sparsi.
Inserire i dati: importare i documenti di testo grezzo nella collezione.
Eseguire ricerche: utilizzare query in linguaggio naturale per recuperare risultati ordinati in base alla rilevanza BM25.
Creazione di una raccolta per la ricerca full-text BM25
Per abilitare la ricerca full-text basata su BM25, è necessario preparare una collezione con i campi richiesti, definire una funzione BM25 per generare vettori sparsi, configurare un indice e quindi creare la collezione.
Definire i campi dello schema
Lo schema della raccolta deve includere almeno tre campi obbligatori:
Campo primario: identifica in modo univoco ogni entità nella raccolta.
Campo stringa (
VARCHARoTEXT): memorizza i documenti di testo grezzi. È necessario impostareenable_analyzer=Truein modo che Milvus possa elaborare il testo per il ranking di rilevanza BM25. Per impostazione predefinita, Milvus utilizza l’standardanalizzatore per l’analisi del testo. Per configurare un analizzatore diverso, consultare la Panoramica degli analizzatori. Gli esempi in questa pagina utilizzanoVARCHAR; per testi lunghi, è possibile definire il campo di input comeTEXTe ometteremax_length. Per un esempio completo, consultare Campo di testo.Campo vettoriale sparso (
SPARSE_FLOAT_VECTOR): memorizza gli embedding sparsi generati automaticamente dalla funzione BM25.
from pymilvus import MilvusClient, DataType, Function, FunctionType

client = MilvusClient(
    uri="http://localhost:19530",
    token="root:Milvus"
)

schema = client.create_schema()

schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True, auto_id=True) # Primary field
schema.add_field(field_name="text", datatype=DataType.VARCHAR, max_length=1000, enable_analyzer=True) # Text field
schema.add_field(field_name="sparse", datatype=DataType.SPARSE_FLOAT_VECTOR) # Sparse vector field; no dim required for sparse vectors
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .build();
schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("sparse")
        .dataType(DataType.SparseFloatVector)
        .build());
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

schema := entity.NewSchema()
schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(true),
).WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithMaxLength(1000),
).WithField(entity.NewField().
    WithName("sparse").
    WithDataType(entity.FieldTypeSparseVector),
)
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const address = "http://localhost:19530";
const token = "root:Milvus";
const client = new MilvusClient({address, token});
const schema = [
  {
    name: "id",
    data_type: DataType.Int64,
    is_primary_key: true,
  },
  {
    name: "text",
    data_type: "VarChar",
    enable_analyzer: true,
    enable_match: true,
    max_length: 1000,
  },
  {
    name: "sparse",
    data_type: DataType.SparseFloatVector,
  },
];

console.log(res.results)
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true
                }
            },
            {
                "fieldName": "sparse",
                "dataType": "SparseFloatVector"
            }
        ]
    }'
Nella configurazione precedente,
id: funge da chiave primaria e viene generato automaticamente conauto_id=True.text: memorizza i dati di testo grezzi per le operazioni di ricerca full-text. Il campo può utilizzareVARCHARper testi di dimensioni limitate oTEXTper contenuti di origine di grandi dimensioni.sparse: un campo vettoriale riservato alla memorizzazione di embedding sparsi generati internamente per le operazioni di ricerca full-text. Il tipo di dati deve essereSPARSE_FLOAT_VECTOR.
Definizione della funzione BM25
La funzione BM25 converte il testo tokenizzato in vettori sparsi che supportano il punteggio BM25.
Definire la funzione e aggiungerla allo schema:
bm25_function = Function(
    name="text_bm25_emb", # Function name
    input_field_names=["text"], # Name of the VARCHAR or TEXT field containing raw text data
    output_field_names=["sparse"], # Name of the SPARSE_FLOAT_VECTOR field reserved to store generated embeddings
    function_type=FunctionType.BM25, # Set to `BM25`
)

schema.add_function(bm25_function)
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.CreateCollectionReq.Function;

import java.util.*;

schema.addFunction(Function.builder()
        .functionType(FunctionType.BM25)
        .name("text_bm25_emb")
        .inputFieldNames(Collections.singletonList("text"))
        .outputFieldNames(Collections.singletonList("sparse"))
        .build());
function := entity.NewFunction().
    WithName("text_bm25_emb").
    WithInputFields("text").
    WithOutputFields("sparse").
    WithType(entity.FunctionTypeBM25)
schema.WithFunction(function)
const functions = [
    {
      name: 'text_bm25_emb',
      description: 'bm25 function',
      type: FunctionType.BM25,
      input_field_names: ['text'],
      output_field_names: ['sparse'],
      params: {},
    },
];
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true
                }
            },
            {
                "fieldName": "sparse",
                "dataType": "SparseFloatVector"
            }
        ],
        "functions": [
            {
                "name": "text_bm25_emb",
                "type": "BM25",
                "inputFieldNames": ["text"],
                "outputFieldNames": ["sparse"],
                "params": {}
            }
        ]
    }'
Parametro |
Descrizione |
|---|---|
|
Il nome della funzione. Questa funzione converte il testo grezzo dal campo " |
|
Il nome del campo |
|
Il nome del campo in cui verranno memorizzati i vettori sparsi generati internamente. Per |
|
Il tipo di funzione da utilizzare. Deve essere |
Se più campi di testo richiedono l’elaborazione BM25, definire una funzione BM25 per ogni campo, ciascuna con un nome e un campo di output univoci.
Configurare l’indice
Dopo aver definito lo schema con i campi necessari e la funzione integrata, configurare l’indice per la propria raccolta.
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="sparse",

    index_type="SPARSE_INVERTED_INDEX",
    metric_type="BM25",
    params={
        "inverted_index_algo": "DAAT_MAXSCORE",
        "bm25_k1": 1.2,
        "bm25_b": 0.75
    }

)
import io.milvus.v2.common.IndexParam;

Map<String,Object> params = new HashMap<>();
params.put("inverted_index_algo", "DAAT_MAXSCORE");
params.put("bm25_k1", 1.2);
params.put("bm25_b", 0.75);

List<IndexParam> indexes = new ArrayList<>();
indexes.add(IndexParam.builder()
        .fieldName("sparse")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.BM25)
        .extraParams(params)
        .build());
indexOption := milvusclient.NewCreateIndexOption("my_collection", "sparse",
    index.NewAutoIndex(entity.MetricType(entity.BM25)))
    .WithExtraParam("inverted_index_algo", "DAAT_MAXSCORE")
    .WithExtraParam("bm25_k1", 1.2)
    .WithExtraParam("bm25_b", 0.75)
const index_params = [
  {
    field_name: "sparse",
    metric_type: "BM25",
    index_type: "SPARSE_INVERTED_INDEX",
    params: {
        "inverted_index_algo": "DAAT_MAXSCORE",
        "bm25_k1": 1.2,
        "bm25_b": 0.75
    }
  },
];
export indexParams='[
        {
            "fieldName": "sparse",
            "metricType": "BM25",
            "indexType": "AUTOINDEX",
            "params":{
               "inverted_index_algo": "DAAT_MAXSCORE",
               "bm25_k1": 1.2,
               "bm25_b": 0.75
            }
        }
    ]'
Parametro |
Descrizione |
|---|---|
|
Il nome del campo vettoriale da indicizzare. Per la ricerca full-text, questo dovrebbe essere il campo che memorizza i vettori sparsi generati. In questo esempio, impostare il valore su |
|
Il tipo di indice da creare. Per la ricerca full-text BM25 in Milvus, impostare questo valore su |
|
Il valore di questo parametro deve essere impostato su |
|
Un dizionario di parametri aggiuntivi specifici per l’indice. |
|
L'algoritmo utilizzato per la creazione e l'interrogazione dell'indice invertito sparso BM25. Valori validi:
|
|
Controlla la saturazione della frequenza dei termini. Valori più elevati aumentano l’importanza delle frequenze dei termini nel ranking dei documenti. Intervallo consigliato: [1,2; 2,0]. Valore predefinito: 1,2. |
|
Controlla il grado di normalizzazione della lunghezza dei documenti. In genere si utilizzano valori compresi tra 0 e 1, con un valore predefinito di 0,75. Un valore pari a 0 indica l’assenza di normalizzazione della lunghezza, mentre un valore pari a 1 indica la normalizzazione completa della lunghezza. |
Creazione della raccolta
Ora crea la collezione utilizzando lo schema e i parametri di indicizzazione definiti.
client.create_collection(
    collection_name='my_collection',
    schema=schema,
    index_params=index_params
)
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
await client.create_collection(
    collection_name: 'my_collection',
    schema: schema,
    index_params: index_params,
    functions: functions
);
export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
Inserire dati di testo
Dopo aver configurato la collezione e l’indice, si è pronti per inserire i dati di testo. In questa fase, è sufficiente fornire il testo grezzo. La funzione integrata definita in precedenza genera automaticamente il vettore sparso corrispondente per ogni voce di testo.
client.insert('my_collection', [
    {'text': 'information retrieval is a field of study.'},
    {'text': 'information retrieval focuses on finding relevant information in large datasets.'},
    {'text': 'data mining and information retrieval overlap in research.'},
])
import com.google.gson.Gson;
import com.google.gson.JsonObject;

import io.milvus.v2.service.vector.request.InsertReq;

Gson gson = new Gson();
List<JsonObject> rows = Arrays.asList(
        gson.fromJson("{\"text\": \"information retrieval is a field of study.\"}", JsonObject.class),
        gson.fromJson("{\"text\": \"information retrieval focuses on finding relevant information in large datasets.\"}", JsonObject.class),
        gson.fromJson("{\"text\": \"data mining and information retrieval overlap in research.\"}", JsonObject.class)
);

client.insert(InsertReq.builder()
        .collectionName("my_collection")
        .data(rows)
        .build());
// go
await client.insert({
collection_name: 'my_collection',
data: [
    {'text': 'information retrieval is a field of study.'},
    {'text': 'information retrieval focuses on finding relevant information in large datasets.'},
    {'text': 'data mining and information retrieval overlap in research.'},
]);
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "data": [
        {"text": "information retrieval is a field of study."},
        {"text": "information retrieval focuses on finding relevant information in large datasets."},
        {"text": "data mining and information retrieval overlap in research."}
    ],
    "collectionName": "my_collection"
}'
Eseguire una ricerca full-text
Una volta inseriti i dati nella collezione, è possibile eseguire ricerche full-text utilizzando query di testo grezzo. Milvus converte automaticamente la query in un vettore sparso e ordina i risultati della ricerca corrispondenti utilizzando l’algoritmo BM25, per poi restituire i primi K (limit) risultati.
È possibile evidenziare i termini corrispondenti nei risultati di ricerca configurando un evidenziatore di testo. Per ulteriori dettagli, consultare la sezione Evidenziatore di testo.
res = client.search(
    collection_name='my_collection',
    data=['whats the focus of information retrieval?'],
    anns_field='sparse',
    output_fields=['text'], # Fields to return in search results; sparse field cannot be output
    limit=3,
)

print(res)
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.EmbeddedText;
import io.milvus.v2.service.vector.response.SearchResp;

Map<String,Object> searchParams = new HashMap<>();

SearchResp searchResp = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(new EmbeddedText("whats the focus of information retrieval?")))
        .annsField("sparse")
        .topK(3)
        .searchParams(searchParams)
        .outputFields(Collections.singletonList("text"))
        .build());
annSearchParams := index.NewCustomAnnParam()
resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    3,               // limit
    []entity.Vector{entity.Text("whats the focus of information retrieval?")},
).WithConsistencyLevel(entity.ClStrong).
    WithANNSField("sparse").
    WithAnnParam(annSearchParams).
    WithOutputFields("text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("text: ", resultSet.GetColumn("text").FieldData().GetScalars())
}
await client.search(
    collection_name: 'my_collection',
    data: ['whats the focus of information retrieval?'],
    anns_field: 'sparse',
    output_fields: ['text'],
    limit: 3,
)
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
--data-raw '{
    "collectionName": "my_collection",
    "data": [
        "whats the focus of information retrieval?"
    ],
    "annsField": "sparse",
    "limit": 3,
    "outputFields": [
        "text"
    ],
    "searchParams":{
        "params":{}
    }
}'
Parametro |
Descrizione |
|---|---|
|
Un dizionario contenente i parametri di ricerca. |
|
Proporzione di termini di bassa importanza da ignorare durante la ricerca. Il valore deve essere compreso nell'intervallo [0,0; 1,0). Per ulteriori dettagli, consultare la sezione " Vettore sparso". |
|
Testo grezzo della query in linguaggio naturale. Milvus converte automaticamente la query testuale in vettori sparsi utilizzando la funzione BM25: non fornire vettori precalcolati. |
|
Il nome del campo che contiene i vettori sparsi generati internamente. |
|
Elenco dei nomi dei campi da restituire nei risultati della ricerca. Supporta tutti i campi tranne il campo del vettore sparso contenente gli embedding generati da BM25. I campi di output comuni includono il campo della chiave primaria (ad es., |
|
Numero massimo di corrispondenze principali da restituire. |
Domande frequenti
È possibile visualizzare o accedere ai vettori sparsi generati dalla funzione BM25 nella ricerca full-text?
No, i vettori sparsi generati dalla funzione BM25 non sono direttamente accessibili né esportabili nella ricerca full-text. Ecco i dettagli:
La funzione BM25 genera internamente vettori sparsi per il ranking e il recupero
Questi vettori sono memorizzati nel campo sparso ma non possono essere inclusi in
output_fieldsÈ possibile esportare solo i campi di testo originali e i metadati (come
id,text)
Esempio:
# ❌ This throws an error - you cannot output the sparse field
client.search(
    collection_name='my_collection',
    data=['query text'],
    anns_field='sparse',
    output_fields=['text', 'sparse']  # 'sparse' causes an error
    limit=3,
    search_params=search_params
)

# ✅ This works - output text fields only
client.search(
    collection_name='my_collection',
    data=['query text'],
    anns_field='sparse',
    output_fields=['text']
    limit=3,
    search_params=search_params
)
Perché devo definire un campo vettore sparso se non posso accedervi?
Il campo vettore sparso funge da indice di ricerca interno, simile agli indici dei database con cui gli utenti non interagiscono direttamente.
Motivazioni progettuali:
Separazione dei livelli: l’utente si occupa del testo (input/output), mentre Milvus gestisce i vettori (elaborazione interna)
Prestazioni: i vettori sparsi precalcolati consentono un rapido ranking BM25 durante le query
Esperienza utente: nasconde le complesse operazioni vettoriali dietro una semplice interfaccia testuale
Se è necessario accedere ai vettori:
Utilizza operazioni manuali sui vettori sparsi invece della ricerca full-text
Crea raccolte separate per flussi di lavoro personalizzati con vettori sparsi
Per ulteriori dettagli, consultare la sezione " Vettori sparsi".
