

Pencocokan FrasaCompatible with Milvus 2.5.17+
Pencocokan frasa memungkinkan Anda mencari dokumen yang berisi istilah kueri Anda sebagai frasa yang persis sama. Secara default, kata-kata tersebut harus muncul dalam urutan yang sama dan bersebelahan satu sama lain. Misalnya, kueri untuk “robotics machine learning” akan cocok dengan teks seperti “…model pembelajaran mesin robotika yang umum…”, di mana kata-kata “robotics”, “machine”, dan “learning” muncul secara berurutan tanpa kata lain di antaranya.
Namun, dalam skenario dunia nyata, pencocokan frasa yang ketat bisa jadi terlalu kaku. Anda mungkin ingin mencocokkan teks seperti “…model machine learning yang banyak digunakan dalam robotika…”. Di sini, kata kunci yang sama ada tetapi tidak berdampingan atau dalam urutan aslinya. Untuk mengatasi hal ini, pencocokan frasa mendukung parameter “ slop ”, yang memberikan fleksibilitas. Nilai “ slop ” menentukan berapa banyak pergeseran posisi yang diizinkan di antara istilah-istilah dalam frasa. Misalnya, dengan “ slop ” sebesar 1, kueri untuk “machine learning” dapat mencocokkan teks seperti “…machine deep learning…”, di mana satu kata (“deep”) memisahkan istilah-istilah asli.
Gambaran Umum
Didukung oleh pustaka mesin pencari Tantivy, pencocokan frasa bekerja dengan menganalisis informasi posisi kata-kata dalam dokumen. Diagram di bawah ini mengilustrasikan proses tersebut:
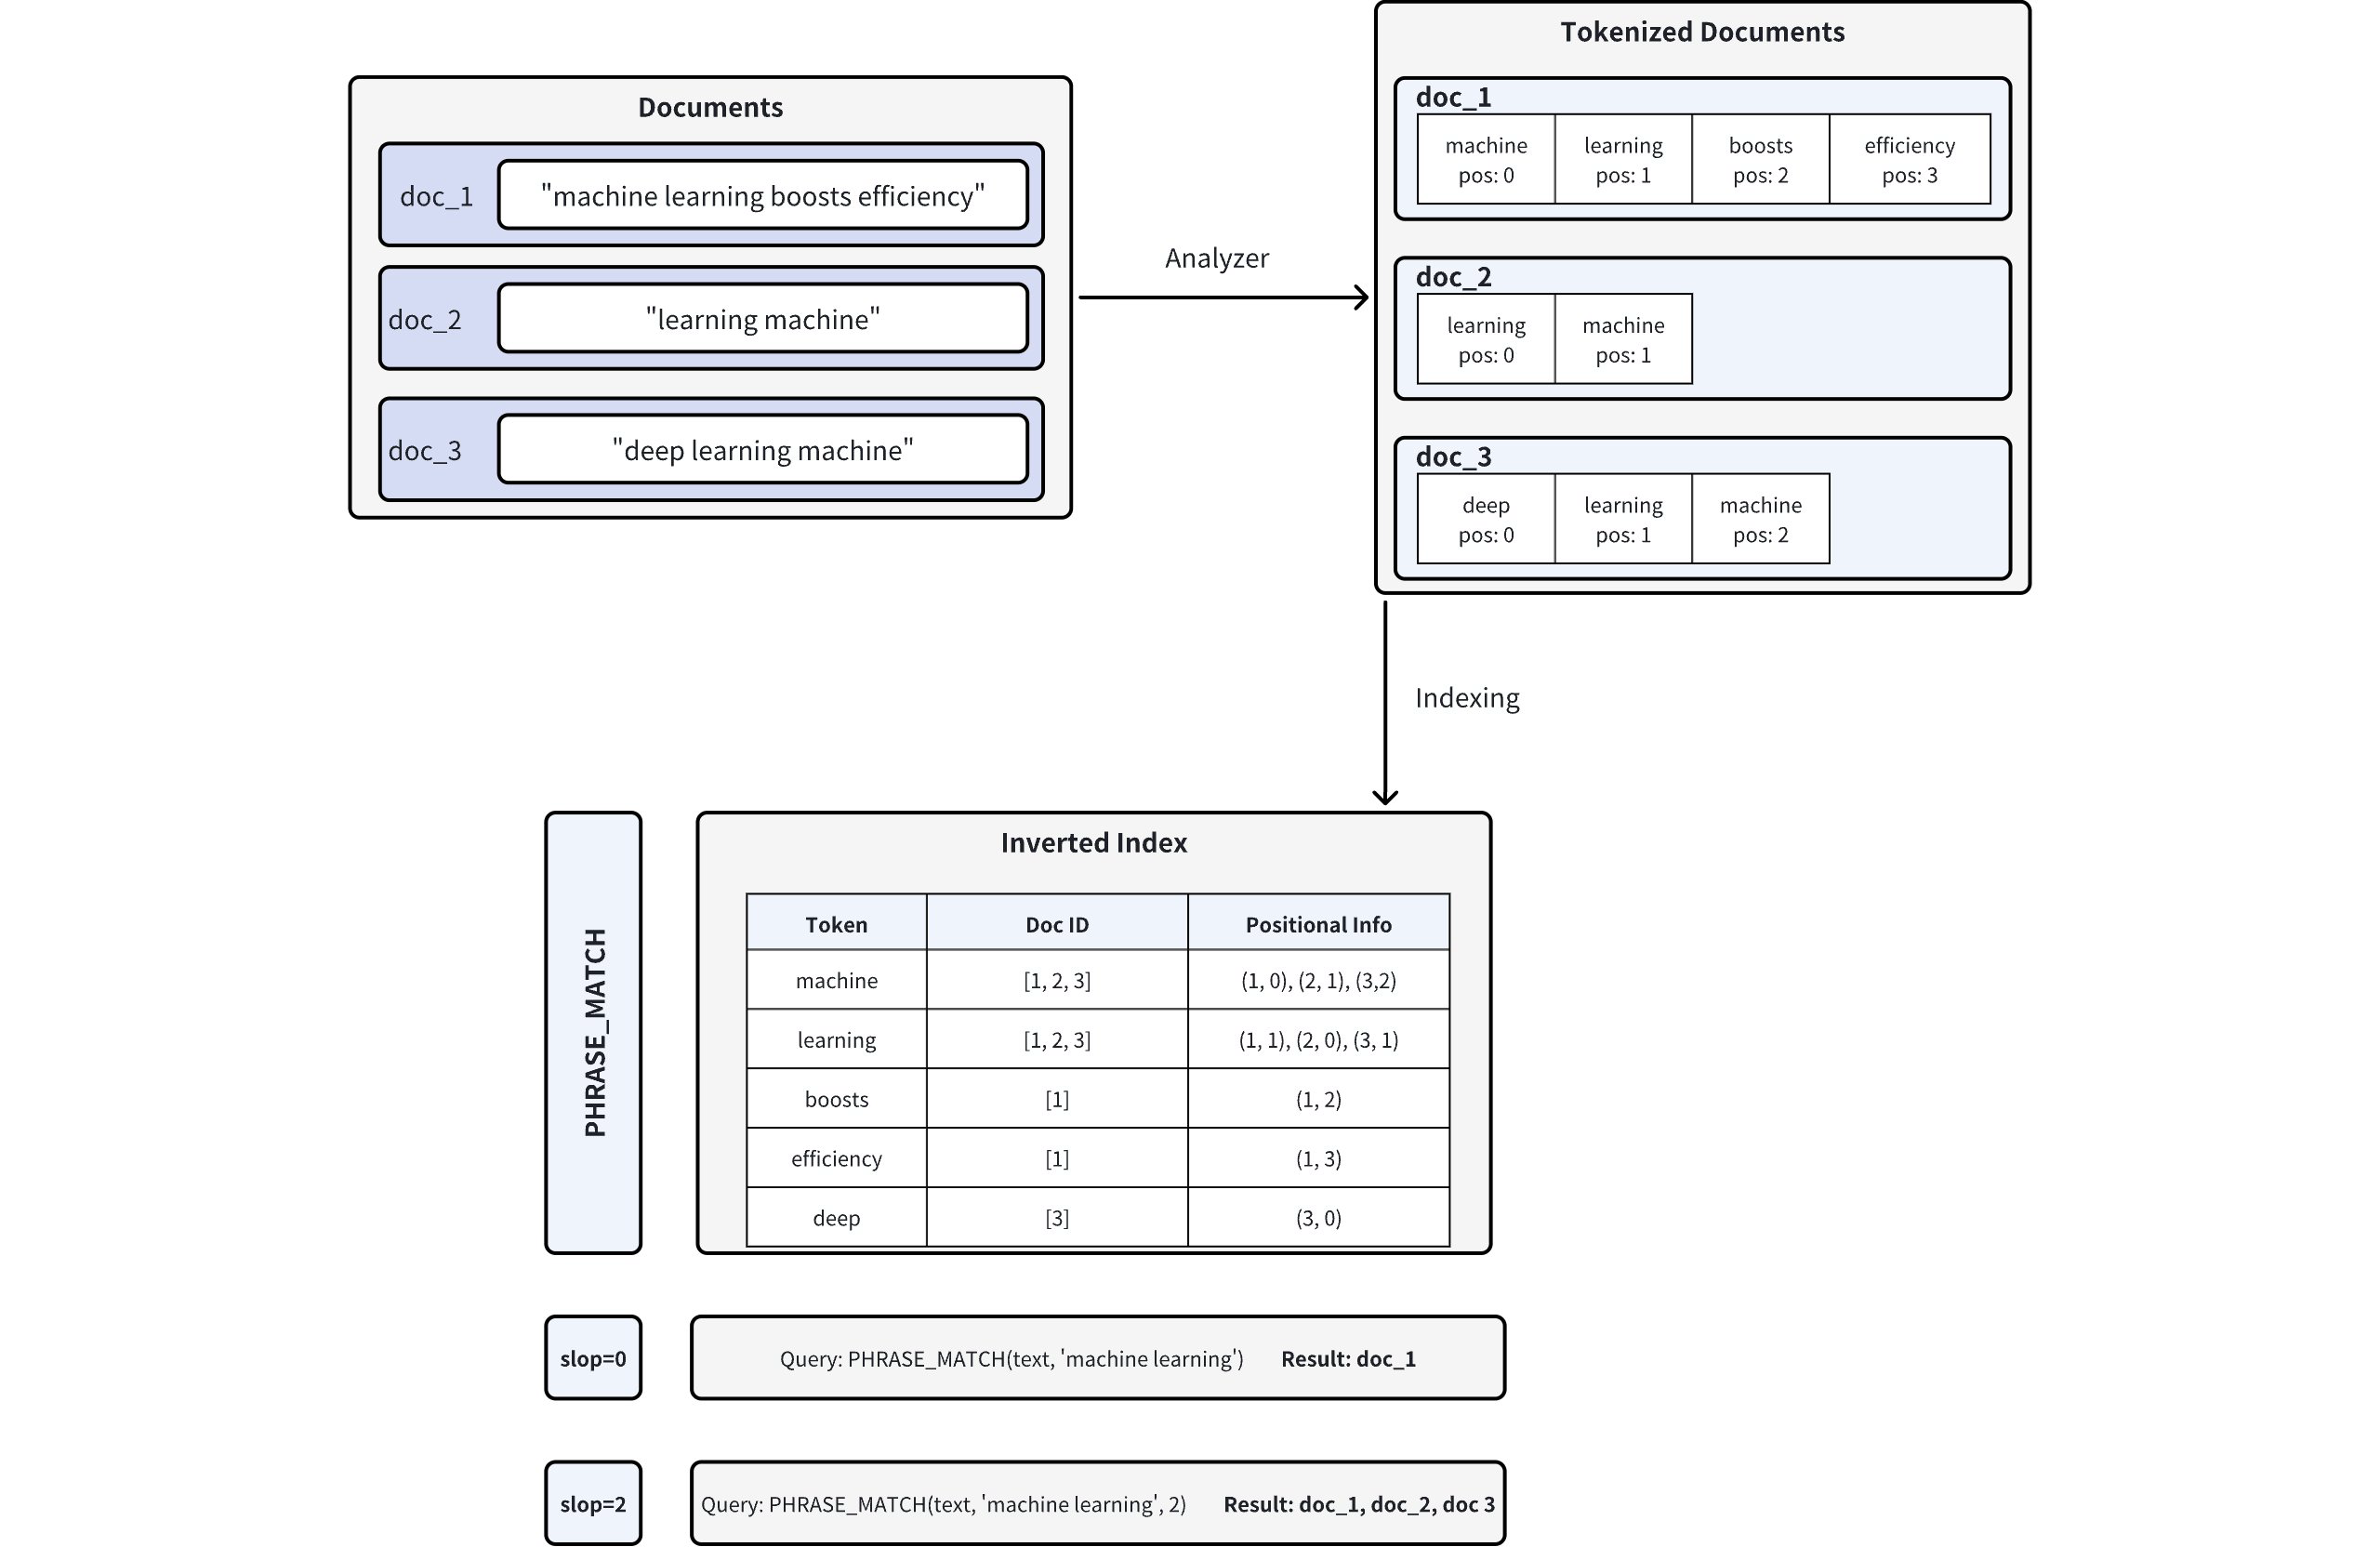 Alur Kerja Pencocokan Frasa
Tokenisasi Dokumen: Saat Anda memasukkan dokumen ke Milvus, teks tersebut dipisahkan menjadi token (kata atau istilah individual) menggunakan penganalisis, dengan informasi posisi yang dicatat untuk setiap token. Misalnya, doc_1 ditokenisasi menjadi [“machine” (pos=0), “learning” (pos=1), “boosts” (pos=2), “efficiency” (pos=3)]. Untuk informasi lebih lanjut tentang penganalisis, lihat Ikhtisar Penganalisis.
Pembuatan Indeks Terbalik: Milvus membangun indeks terbalik, memetakan setiap token ke dokumen tempat token tersebut muncul serta posisi token dalam dokumen-dokumen tersebut.
Pencocokan Frasa: Saat kueri frasa dijalankan, Milvus mencari setiap token dalam indeks terbalik dan memeriksa posisinya untuk menentukan apakah token tersebut muncul dalam urutan dan kedekatan yang benar. Parameter “
slop” mengontrol jumlah maksimum posisi yang diperbolehkan di antara token yang cocok:slop = 0 berarti token-token tersebut harus muncul dalam urutan yang persis sama dan berdekatan (yaitu, tidak ada kata tambahan di antaranya).
- Dalam contoh tersebut, hanya doc_1 (“machine” di pos=0, “learning” di pos=1) yang cocok persis.
slop = 2 memungkinkan fleksibilitas hingga dua posisi atau pengaturan ulang di antara token yang cocok.
Hal ini memungkinkan urutan terbalik (“learning machine”) atau jarak kecil di antara token.
Akibatnya, doc_1, doc_2 (“learning” di pos=0, “machine” di pos=1), dan doc_3 (“learning” di pos=1, “machine” di pos=2) semuanya cocok.
Aktifkan pencocokan frasa
Pencocokan frasa berfungsi dengan tipe bidang VARCHAR, yaitu tipe data string di Milvus. Untuk mengaktifkan pencocokan frasa, konfigurasikan skema koleksi Anda dengan mengatur parameter enable_analyzer dan enable_match menjadi True, serupa dengan pencocokan teks.
Atur ` enable_analyzer ` dan enable_match
Untuk mengaktifkan pencocokan frasa pada bidang VARCHAR tertentu, atur kedua parameter enable_analyzer dan enable_match menjadi True saat mendefinisikan skema bidang. Konfigurasi ini menginstruksikan Milvus untuk menokenisasi teks dan membuat indeks terbalik dengan informasi posisi yang diperlukan untuk pencocokan frasa yang efisien.
Berikut adalah contoh definisi skema untuk mengaktifkan pencocokan frasa:
from pymilvus import MilvusClient, DataType

# Create a schema for a new collection
schema = MilvusClient.create_schema(enable_dynamic_field=False)
schema.add_field(
    field_name="id",
    datatype=DataType.INT64,
    is_primary=True,
    auto_id=True
)
# Add a VARCHAR field configured for phrase matching
schema.add_field(
    field_name='text',                 # Name of the field
    datatype=DataType.VARCHAR,         # Field data type set as VARCHAR (string)
    max_length=1000,                   # Maximum length of the string
    enable_analyzer=True,              # Enables text analysis (tokenization)
    enable_match=True                  # Enables inverted indexing for phrase matching
)
schema.add_field(
    field_name="embeddings",
    datatype=DataType.FLOAT_VECTOR,
    dim=5
)
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

// Create a schema for a new collection
CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .enableDynamicField(false)
        .build();
schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());
// Add a VARCHAR field configured for phrase matching
schema.addField(AddFieldReq.builder()
        .fieldName("text")              // Name of the field
        .dataType(DataType.VarChar)     // Field data type set as VARCHAR (string)
        .maxLength(1000)                // Maximum length of the string
        .enableAnalyzer(true)           // Enables text analysis (tokenization)
        .enableMatch(true)              // Enables inverted indexing for phrase matching
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("embeddings")
        .dataType(DataType.FloatVector)
        .dimension(5)
        .build());
import "github.com/milvus-io/milvus/client/v2/entity"

// Create a schema for a new collection
schema := entity.NewSchema().WithDynamicFieldEnabled(false)
schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(true),
).WithField(entity.NewField().
    WithName("text").                      // Name of the field
    WithDataType(entity.FieldTypeVarChar). // Field data type set as VARCHAR (string)
    WithMaxLength(1000).                   // Maximum length of the string
    WithEnableAnalyzer(true).              // Enables text analysis (tokenization)
    WithEnableMatch(true),                 // Enables inverted indexing for phrase matching
).WithField(entity.NewField().
    WithName("embeddings").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(5),
)
import { DataType } from "@zilliz/milvus2-sdk-node";

// Create a schema for a new collection
const schema = [
  {
    name: "id",
    data_type: DataType.Int64,
    is_primary_key: true,
    autoID: true,
  },
  // Add a VARCHAR field configured for phrase matching
  {
    name: "text", // Name of the field
    data_type: DataType.VarChar, // Field data type set as VARCHAR (string)
    max_length: 1000, // Maximum length of the string
    enable_analyzer: true, // Enables text analysis (tokenization)
    enable_match: true, // Enables inverted indexing for phrase matching
  },
  {
    name: "embeddings",
    data_type: DataType.FloatVector,
    dim: 5,
  },
];
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true,
                    "enable_match": true
                }
            },
            {
                "fieldName": "embeddings",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "5"
                }
            }
        ]
    }'
#include "milvus/types/CollectionSchema.h"

// Create a schema for a new collection
milvus::CollectionSchema schema("tech_articles");
schema.SetEnableDynamicField(false);
schema.AddField(milvus::FieldSchema("id", milvus::DataType::INT64, "", true, true));
// Add a VARCHAR field configured for phrase matching
schema.AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR)  // Name of the field
                    .WithMaxLength(1000)    // Maximum length of the string
                    .EnableAnalyzer(true)   // Enables text analysis (tokenization)
                    .EnableMatch(true));    // Enables inverted indexing for phrase matching
schema.AddField(milvus::FieldSchema("embeddings", milvus::DataType::FLOAT_VECTOR)
                    .WithDimension(5));
Opsional: Konfigurasikan penganalisis
Akurasi pencocokan frasa sangat bergantung pada penganalisis yang digunakan untuk menokenisasi data teks Anda. Penganalisis yang berbeda cocok untuk bahasa dan format teks yang berbeda, yang memengaruhi akurasi tokenisasi dan posisi. Memilih penganalisis yang sesuai untuk kasus penggunaan spesifik Anda akan mengoptimalkan hasil pencocokan frasa Anda.
Secara default, Milvus menggunakan penganalisis standar, yang menokenisasi teks berdasarkan spasi dan tanda baca, menghapus token yang panjangnya lebih dari 40 karakter, dan mengubah teks menjadi huruf kecil. Tidak diperlukan parameter tambahan untuk penggunaan default. Lihat Penganalisis Standar untuk detailnya.
Jika aplikasi Anda memerlukan penganalisis tertentu, konfigurasikan menggunakan parameter ` analyzer_params `. Sebagai contoh, berikut cara mengonfigurasi penganalisis ` english ` untuk pencocokan frasa dalam teks bahasa Inggris:
# Define analyzer parameters for English-language tokenization
analyzer_params = {
    "type": "english"
}

# Add the VARCHAR field with the English analyzer enabled
schema.add_field(
    field_name='text',                 # Name of the field
    datatype=DataType.VARCHAR,         # Field data type set as VARCHAR
    max_length=1000,                   # Maximum length of the string
    enable_analyzer=True,              # Enables text analysis
    analyzer_params=analyzer_params,   # Specifies the analyzer configuration
    enable_match=True                  # Enables inverted indexing for phrase matching
)
// Define analyzer parameters for English-language tokenization
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("type", "english");

// Add the VARCHAR field with the English analyzer enabled
schema.addField(AddFieldReq.builder()
        .fieldName("text")              // Name of the field
        .dataType(DataType.VarChar)     // Field data type set as VARCHAR
        .maxLength(1000)                // Maximum length of the string
        .enableAnalyzer(true)           // Enables text analysis
        .analyzerParams(analyzerParams) // Specifies the analyzer configuration
        .enableMatch(true)              // Enables inverted indexing for phrase matching
        .build());
// Define analyzer parameters for English-language tokenization
analyzerParams := map[string]any{"type": "english"}

// Add the VARCHAR field with the English analyzer enabled
schema.WithField(entity.NewField().
    WithName("text").                      // Name of the field
    WithDataType(entity.FieldTypeVarChar). // Field data type set as VARCHAR
    WithMaxLength(1000).                   // Maximum length of the string
    WithEnableAnalyzer(true).              // Enables text analysis
    WithAnalyzerParams(analyzerParams).    // Specifies the analyzer configuration
    WithEnableMatch(true),                 // Enables inverted indexing for phrase matching
)
// Define analyzer parameters for English-language tokenization
const analyzer_params = { type: "english" };

// Add the VARCHAR field with the English analyzer enabled
const schema = [
  {
    name: "text", // Name of the field
    data_type: DataType.VarChar, // Field data type set as VARCHAR
    max_length: 1000, // Maximum length of the string
    enable_analyzer: true, // Enables text analysis
    analyzer_params: analyzer_params, // Specifies the analyzer configuration
    enable_match: true, // Enables inverted indexing for phrase matching
  },
];
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true,
                    "analyzer_params": {"type": "english"},
                    "enable_match": true
                }
            }
        ]
    }'
// Define analyzer parameters for English-language tokenization
nlohmann::json analyzer_params = {{"type", "english"}};

// Add the VARCHAR field with the English analyzer enabled
schema.AddField(milvus::FieldSchema("text", milvus::DataType::VARCHAR)  // Name of the field
                    .WithMaxLength(1000)                // Maximum length of the string
                    .EnableAnalyzer(true)               // Enables text analysis
                    .WithAnalyzerParams(analyzer_params) // Specifies the analyzer configuration
                    .EnableMatch(true));                // Enables inverted indexing for phrase matching
Milvus mendukung beberapa penganalisis yang disesuaikan untuk berbagai bahasa dan kasus penggunaan. Untuk informasi terperinci, lihat Ikhtisar Penganalisis.
Gunakan pencocokan frasa
Setelah Anda mengaktifkan pencocokan untuk bidang ` VARCHAR ` dalam skema koleksi Anda, Anda dapat melakukan pencocokan frasa menggunakan ekspresi ` PHRASE_MATCH `.
Ekspresi ` PHRASE_MATCH ` tidak membedakan huruf besar-kecil. Anda dapat menggunakan ` PHRASE_MATCH ` atau ` phrase_match`.
Sintaks ekspresi PHRASE_MATCH
Gunakan ekspresi " PHRASE_MATCH " untuk menentukan bidang, frasa, dan fleksibilitas opsional (slop) saat melakukan pencarian. Sintaksnya adalah:
PHRASE_MATCH(field_name, phrase, slop)
PHRASE_MATCH(field_name, phrase, slop)
PHRASE_MATCH(field_name, phrase, slop)
PHRASE_MATCH(field_name, phrase, slop)
PHRASE_MATCH(field_name, phrase, slop)
PHRASE_MATCH(field_name, phrase, slop)
field_name: Nama bidang "VARCHAR" yang akan digunakan untuk pencocokan frasa.phrase: Frasa tepat yang akan dicari.slop(opsional): Bilangan bulat yang menentukan jumlah posisi maksimum yang diperbolehkan dalam token yang cocok.0(default): Hanya mencocokkan frasa persis. Contoh: Filter untuk “machine learning” akan mencocokkan “machine learning” secara persis, tetapi tidak “machine boosts learning” atau “learning machine”.1: Memungkinkan variasi kecil, seperti satu istilah tambahan atau pergeseran posisi yang kecil. Contoh: Filter untuk “machine learning” akan mencocokkan “machine boosts learning” (satu token di antara “machine” dan “learning”) tetapi tidak “learning machine” (urutan istilah terbalik).2: Memungkinkan fleksibilitas yang lebih besar, termasuk urutan istilah yang terbalik atau hingga dua token di antaranya. Contoh: Filter untuk “machine learning” akan cocok dengan “learning machine” (urutan istilah terbalik) atau “machine quickly boosts learning” (dua token di antara “machine” dan “learning”).
Contoh kumpulan data
Misalkan Anda memiliki koleksi bernama tech_articles yang berisi lima entitas berikut:
|
|
|---|---|
1 |
"Machine learning meningkatkan efisiensi dalam analisis data berskala besar" |
2 |
"Mempelajari pendekatan berbasis mesin sangat penting bagi kemajuan AI modern" |
3 |
"Arsitektur deep learning mengoptimalkan beban komputasi" |
4 |
"Mesin dengan cepat meningkatkan kinerja model untuk pembelajaran berkelanjutan" |
5 |
"Pembelajaran algoritma mesin tingkat lanjut memperluas kemampuan AI" |
Pencarian dengan pencocokan frasa
Saat menggunakan metode query(), PHRASE_MATCH berfungsi sebagai filter skalar. Hanya dokumen yang mengandung frasa yang ditentukan (dengan toleransi yang diizinkan) yang akan dikembalikan.
Contoh: slop = 0 (kecocokan persis)
Contoh ini mengembalikan dokumen yang mengandung frasa persis “machine learning” tanpa token tambahan di antaranya.
# Match documents containing exactly "machine learning"
filter = "PHRASE_MATCH(text, 'machine learning')"

result = client.query(
    collection_name="tech_articles",
    filter=filter,
    output_fields=["id", "text"]
)
// Match documents containing exactly "machine learning"
String filter = "PHRASE_MATCH(text, 'machine learning')";

QueryResp queryResp = client.query(QueryReq.builder()
        .collectionName("tech_articles")
        .filter(filter)
        .outputFields(Arrays.asList("id", "text"))
        .build());
// Match documents containing exactly "machine learning"
filter := "PHRASE_MATCH(text, 'machine learning')"

resultSet, err := client.Query(ctx, milvusclient.NewQueryOption("tech_articles").
    WithFilter(filter).
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
// Match documents containing exactly "machine learning"
const filter = "PHRASE_MATCH(text, 'machine learning')";

const result = await client.query({
    collection_name: "tech_articles",
    filter: filter,
    output_fields: ["id", "text"],
});
export filter="\"PHRASE_MATCH(text, 'machine learning')\""

export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/query" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "tech_articles",
    "filter": '"$filter"',
    "outputFields": ["id", "text"]
}'
// Match documents containing exactly "machine learning"
milvus::QueryResponse response;
auto status = client->Query(milvus::QueryRequest()
                                .WithCollectionName("tech_articles")
                                .WithFilter("PHRASE_MATCH(text, 'machine learning')")
                                .AddOutputField("id")
                                .AddOutputField("text"),
                            response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
Hasil pencocokan yang diharapkan:
|
|
|---|---|
1 |
"Machine learning meningkatkan efisiensi dalam analisis data berskala besar" |
Hanya dokumen 1 yang mengandung frasa persis “machine learning” dalam urutan yang ditentukan tanpa token tambahan.
Pencarian dengan pencocokan frasa
Dalam operasi pencarian, PHRASE_MATCH digunakan untuk menyaring dokumen sebelum menerapkan peringkat kesamaan vektor. Pendekatan dua langkah ini pertama-tama mempersempit himpunan kandidat melalui pencocokan teks, lalu menyusun ulang peringkat kandidat tersebut berdasarkan embedding vektor.
Contoh: slop = 1
Di sini, kami mengizinkan toleransi sebesar 1. Filter diterapkan pada dokumen yang mengandung frasa “learning machine” dengan sedikit fleksibilitas.
# Example: Filter documents containing "learning machine" with slop=1
filter_slop1 = "PHRASE_MATCH(text, 'learning machine', 1)"

result_slop1 = client.search(
    collection_name="tech_articles",
    anns_field="embeddings",
    data=[query_vector],
    filter=filter_slop1,
    search_params={"params": {"nprobe": 10}},
    limit=10,
    output_fields=["id", "text"]
)
// Example: Filter documents containing "learning machine" with slop=1
String filter = "PHRASE_MATCH(text, 'learning machine', 1)";

Map<String, Object> searchParams = new HashMap<>();
searchParams.put("nprobe", 10);

SearchResp searchResp = client.search(SearchReq.builder()
        .collectionName("tech_articles")
        .annsField("embeddings")
        .data(Collections.singletonList(queryVector))
        .filter(filter)
        .searchParams(searchParams)
        .topK(10)
        .outputFields(Arrays.asList("id", "text"))
        .build());
// Example: Filter documents containing "learning machine" with slop=1
filter := "PHRASE_MATCH(text, 'learning machine', 1)"

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "tech_articles", // collectionName
    10,              // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("embeddings").
    WithFilter(filter).
    WithSearchParam("nprobe", "10").
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
// Example: Filter documents containing "learning machine" with slop=1
const filter = "PHRASE_MATCH(text, 'learning machine', 1)";

const result = await client.search({
    collection_name: "tech_articles",
    anns_field: "embeddings",
    data: [query_vector],
    filter: filter,
    params: { nprobe: 10 },
    limit: 10,
    output_fields: ["id", "text"],
});
export filter="\"PHRASE_MATCH(text, 'learning machine', 1)\""

export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "tech_articles",
    "annsField": "embeddings",
    "data": [[0.19886812562848388, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501, 0.838729485096104]],
    "filter": '"$filter"',
    "searchParams": {
        "params": {
            "nprobe": 10
        }
    },
    "limit": 10,
    "outputFields": ["id", "text"]
}'
// Example: Filter documents containing "learning machine" with slop=1
milvus::SearchResponse response;
auto status = client->Search(milvus::SearchRequest()
                                 .WithCollectionName("tech_articles")
                                 .WithAnnsField("embeddings")
                                 .AddFloatVector(query_vector)
                                 .WithFilter("PHRASE_MATCH(text, 'learning machine', 1)")
                                 .AddExtraParam("nprobe", "10")
                                 .WithLimit(10)
                                 .AddOutputField("id")
                                 .AddOutputField("text"),
                             response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
Hasil pencocokan:
|
|
|---|---|
2 |
"Mempelajari pendekatan berbasis mesin sangat penting bagi kemajuan AI modern" |
3 |
"Arsitektur mesin deep learning mengoptimalkan beban komputasi" |
5 |
"Pembelajaran algoritma mesin tingkat lanjut memperluas kemampuan AI" |
Contoh: slop = 2
Contoh ini mengizinkan slop sebesar 2, yang berarti diperbolehkan adanya hingga dua token tambahan (atau istilah terbalik) di antara kata “machine” dan “learning”.
# Example: Filter documents containing "machine learning" with slop=2
filter_slop2 = "PHRASE_MATCH(text, 'machine learning', 2)"

result_slop2 = client.search(
    collection_name="tech_articles",
    anns_field="embeddings",             # Vector field name
    data=[query_vector],                 # Query vector
    filter=filter_slop2,                 # Filter expression
    search_params={"params": {"nprobe": 10}},
    limit=10,                            # Maximum results to return
    output_fields=["id", "text"]
)
// Example: Filter documents containing "machine learning" with slop=2
String filter = "PHRASE_MATCH(text, 'machine learning', 2)";

Map<String, Object> searchParams = new HashMap<>();
searchParams.put("nprobe", 10);

SearchResp searchResp = client.search(SearchReq.builder()
        .collectionName("tech_articles")
        .annsField("embeddings")            // Vector field name
        .data(Collections.singletonList(queryVector)) // Query vector
        .filter(filter)                     // Filter expression
        .searchParams(searchParams)
        .topK(10)                           // Maximum results to return
        .outputFields(Arrays.asList("id", "text"))
        .build());
// Example: Filter documents containing "machine learning" with slop=2
filter := "PHRASE_MATCH(text, 'machine learning', 2)"

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "tech_articles", // collectionName
    10,              // limit, maximum results to return
    []entity.Vector{entity.FloatVector(queryVector)}, // query vector
).WithANNSField("embeddings"). // vector field name
    WithFilter(filter).        // filter expression
    WithSearchParam("nprobe", "10").
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
// Example: Filter documents containing "machine learning" with slop=2
const filter = "PHRASE_MATCH(text, 'machine learning', 2)";

const result = await client.search({
    collection_name: "tech_articles",
    anns_field: "embeddings", // Vector field name
    data: [query_vector], // Query vector
    filter: filter, // Filter expression
    params: { nprobe: 10 },
    limit: 10, // Maximum results to return
    output_fields: ["id", "text"],
});
export filter="\"PHRASE_MATCH(text, 'machine learning', 2)\""

export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "tech_articles",
    "annsField": "embeddings",
    "data": [[0.19886812562848388, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501, 0.838729485096104]],
    "filter": '"$filter"',
    "searchParams": {
        "params": {
            "nprobe": 10
        }
    },
    "limit": 10,
    "outputFields": ["id", "text"]
}'
// Example: Filter documents containing "machine learning" with slop=2
milvus::SearchResponse response;
auto status = client->Search(milvus::SearchRequest()
                                 .WithCollectionName("tech_articles")
                                 .WithAnnsField("embeddings") // Vector field name
                                 .AddFloatVector(query_vector) // Query vector
                                 .WithFilter("PHRASE_MATCH(text, 'machine learning', 2)") // Filter expression
                                 .AddExtraParam("nprobe", "10")
                                 .WithLimit(10) // Maximum results to return
                                 .AddOutputField("id")
                                 .AddOutputField("text"),
                             response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
Hasil pencocokan:
|
|
|---|---|
1 |
"Machine learning meningkatkan efisiensi dalam analisis data berskala besar" |
3 |
"Arsitektur mesin pembelajaran mendalam mengoptimalkan beban komputasi" |
Contoh: slop = 3
Dalam contoh ini, nilai slop sebesar 3 memberikan fleksibilitas yang lebih besar. Filter ini mencari frasa “machine learning” dengan jarak hingga tiga token yang diperbolehkan di antara kata-kata tersebut.
# Example: Filter documents containing "machine learning" with slop=3
filter_slop3 = "PHRASE_MATCH(text, 'machine learning', 3)"

result_slop2 = client.search(
    collection_name="tech_articles",
    anns_field="embeddings",             # Vector field name
    data=[query_vector],                 # Query vector
    filter=filter_slop3,                 # Filter expression
    search_params={"params": {"nprobe": 10}},
    limit=10,                            # Maximum results to return
    output_fields=["id", "text"]
)
// Example: Filter documents containing "machine learning" with slop=3
String filter = "PHRASE_MATCH(text, 'machine learning', 3)";

Map<String, Object> searchParams = new HashMap<>();
searchParams.put("nprobe", 10);

SearchResp searchResp = client.search(SearchReq.builder()
        .collectionName("tech_articles")
        .annsField("embeddings")            // Vector field name
        .data(Collections.singletonList(queryVector)) // Query vector
        .filter(filter)                     // Filter expression
        .searchParams(searchParams)
        .topK(10)                           // Maximum results to return
        .outputFields(Arrays.asList("id", "text"))
        .build());
// Example: Filter documents containing "machine learning" with slop=3
filter := "PHRASE_MATCH(text, 'machine learning', 3)"

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "tech_articles", // collectionName
    10,              // limit, maximum results to return
    []entity.Vector{entity.FloatVector(queryVector)}, // query vector
).WithANNSField("embeddings"). // vector field name
    WithFilter(filter).        // filter expression
    WithSearchParam("nprobe", "10").
    WithOutputFields("id", "text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
// Example: Filter documents containing "machine learning" with slop=3
const filter = "PHRASE_MATCH(text, 'machine learning', 3)";

const result = await client.search({
    collection_name: "tech_articles",
    anns_field: "embeddings", // Vector field name
    data: [query_vector], // Query vector
    filter: filter, // Filter expression
    params: { nprobe: 10 },
    limit: 10, // Maximum results to return
    output_fields: ["id", "text"],
});
export filter="\"PHRASE_MATCH(text, 'machine learning', 3)\""

export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "tech_articles",
    "annsField": "embeddings",
    "data": [[0.19886812562848388, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501, 0.838729485096104]],
    "filter": '"$filter"',
    "searchParams": {
        "params": {
            "nprobe": 10
        }
    },
    "limit": 10,
    "outputFields": ["id", "text"]
}'
// Example: Filter documents containing "machine learning" with slop=3
milvus::SearchResponse response;
auto status = client->Search(milvus::SearchRequest()
                                 .WithCollectionName("tech_articles")
                                 .WithAnnsField("embeddings") // Vector field name
                                 .AddFloatVector(query_vector) // Query vector
                                 .WithFilter("PHRASE_MATCH(text, 'machine learning', 3)") // Filter expression
                                 .AddExtraParam("nprobe", "10")
                                 .WithLimit(10) // Maximum results to return
                                 .AddOutputField("id")
                                 .AddOutputField("text"),
                             response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
Hasil pencocokan:
|
|
|---|---|
1 |
"Pembelajaran mesin meningkatkan efisiensi dalam analisis data berskala besar" |
2 |
"Mempelajari pendekatan berbasis mesin sangat penting bagi kemajuan AI modern" |
3 |
"Arsitektur deep learning mengoptimalkan beban komputasi" |
5 |
"Pembelajaran algoritma mesin tingkat lanjut memperluas kemampuan AI" |
Hal-hal yang perlu dipertimbangkan
Mengaktifkan pencocokan frasa untuk suatu bidang akan memicu pembuatan indeks terbalik, yang menghabiskan sumber daya penyimpanan. Pertimbangkan dampak penyimpanan saat memutuskan untuk mengaktifkan fitur ini, karena dampaknya bervariasi tergantung pada ukuran teks, token unik, dan penganalisis yang digunakan.
Setelah Anda mendefinisikan penganalisis dalam skema Anda, pengaturannya menjadi permanen untuk koleksi tersebut. Jika Anda memutuskan bahwa penganalisis lain lebih sesuai dengan kebutuhan Anda, Anda dapat mempertimbangkan untuk menghapus koleksi yang ada dan membuat yang baru dengan konfigurasi penganalisis yang diinginkan.
Kinerja pencocokan frasa bergantung pada cara teks ditokenisasi. Sebelum menerapkan penganalisis ke seluruh koleksi Anda, gunakan metode `
run_analyzer` untuk meninjau hasil tokenisasi. Untuk informasi lebih lanjut, lihat Ikhtisar Penganalisis.Aturan escape dalam ekspresi `
filter`:Karakter yang diapit tanda kutip ganda atau tanda kutip tunggal dalam ekspresi diartikan sebagai konstanta string. Jika konstanta string tersebut mengandung karakter escape, karakter escape tersebut harus direpresentasikan dengan urutan escape. Misalnya, gunakan `
\\` untuk merepresentasikan `\`, `\\t` untuk merepresentasikan tab `\t`, dan `\\n` untuk merepresentasikan baris baru.Jika konstanta string diapit oleh tanda kutip tunggal, tanda kutip tunggal di dalam konstanta harus direpresentasikan sebagai
\\'sedangkan tanda kutip ganda dapat direpresentasikan sebagai"atau\\". Contoh:'It\\'s milvus'.Jika konstanta string diapit oleh tanda kutip ganda, tanda kutip ganda di dalam konstanta tersebut harus ditulis sebagai
\\"sedangkan tanda kutip tunggal dapat ditulis sebagai'atau\\'. Contoh:"He said \\"Hi\\"".
