

Pencarian Berkelompok
Pencarian berkelompok memungkinkan Milvus untuk mengelompokkan hasil pencarian berdasarkan nilai-nilai dalam bidang yang ditentukan guna mengagregasi data pada tingkat yang lebih tinggi. Misalnya, Anda dapat menggunakan pencarian ANN dasar untuk menemukan buku-buku yang mirip dengan buku yang sedang dibahas, tetapi Anda dapat menggunakan pencarian berdasarkan pengelompokan untuk menemukan kategori buku yang mungkin mencakup topik-topik yang dibahas dalam buku tersebut. Topik ini menjelaskan cara menggunakan Pencarian berdasarkan Pengelompokan beserta pertimbangan utamanya.
Gambaran Umum
Ketika entitas dalam hasil pencarian memiliki nilai yang sama dalam bidang skalar, hal ini menunjukkan bahwa entitas tersebut serupa dalam atribut tertentu, yang dapat berdampak negatif terhadap hasil pencarian.
Asumsikan sebuah koleksi menyimpan beberapa dokumen (ditandai dengan docId). Untuk mempertahankan informasi semantik sebanyak mungkin saat mengonversi dokumen menjadi vektor, setiap dokumen dibagi menjadi paragraf (atau potongan) yang lebih kecil dan mudah dikelola, lalu disimpan sebagai entitas terpisah. Meskipun dokumen dibagi menjadi bagian-bagian yang lebih kecil, pengguna sering kali tetap tertarik untuk mengidentifikasi dokumen mana yang paling relevan dengan kebutuhan mereka.
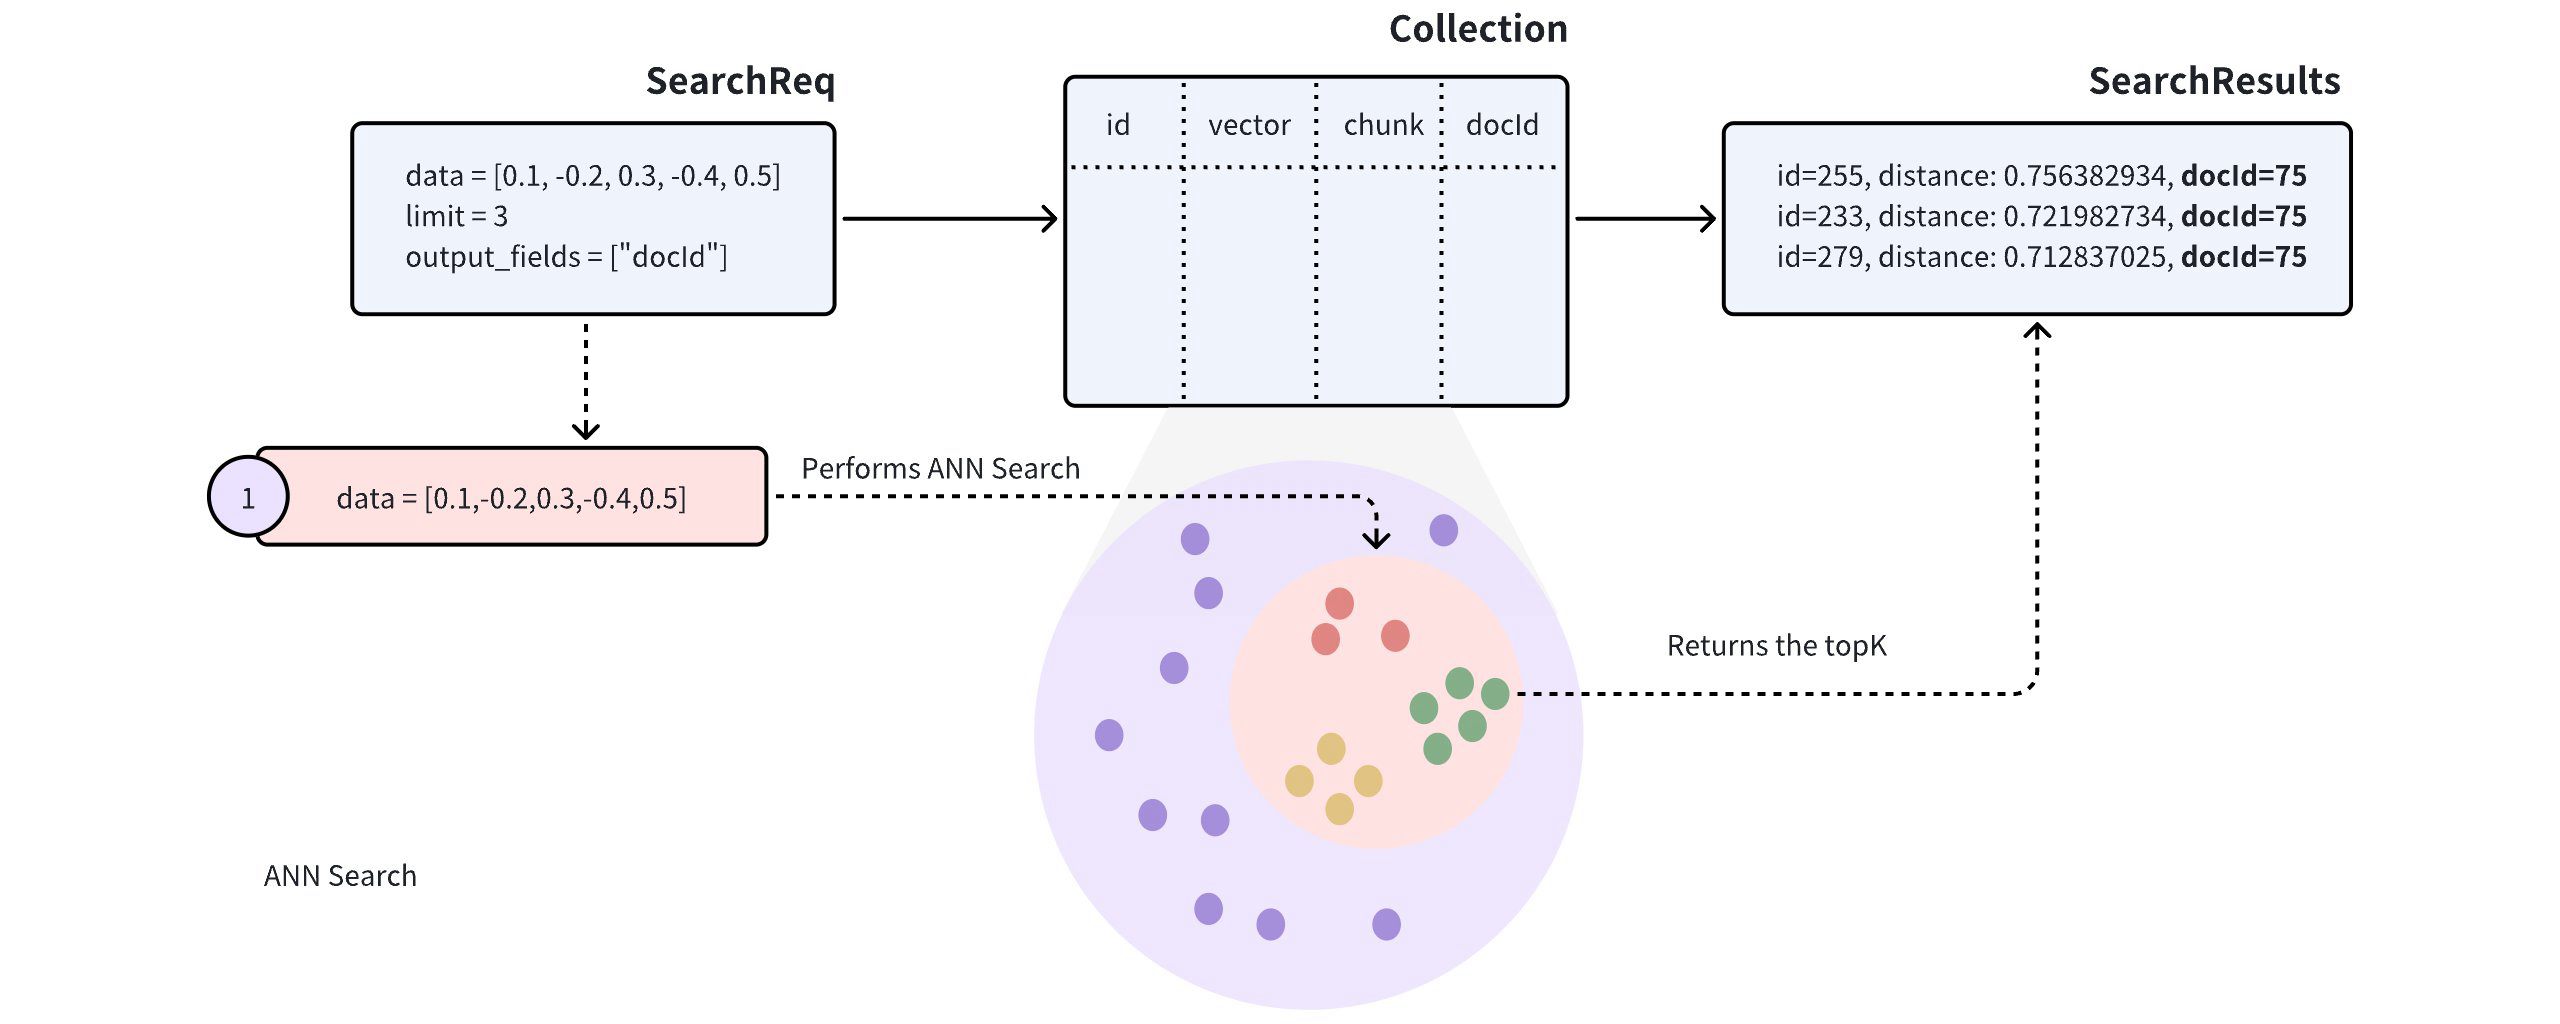 Pencarian Ann
Saat melakukan pencarian Approximate Nearest Neighbor (ANN) pada koleksi semacam itu, hasil pencarian mungkin mencakup beberapa paragraf dari dokumen yang sama, yang berpotensi menyebabkan dokumen lain terlewatkan, sehingga mungkin tidak sesuai dengan kasus penggunaan yang dimaksudkan.
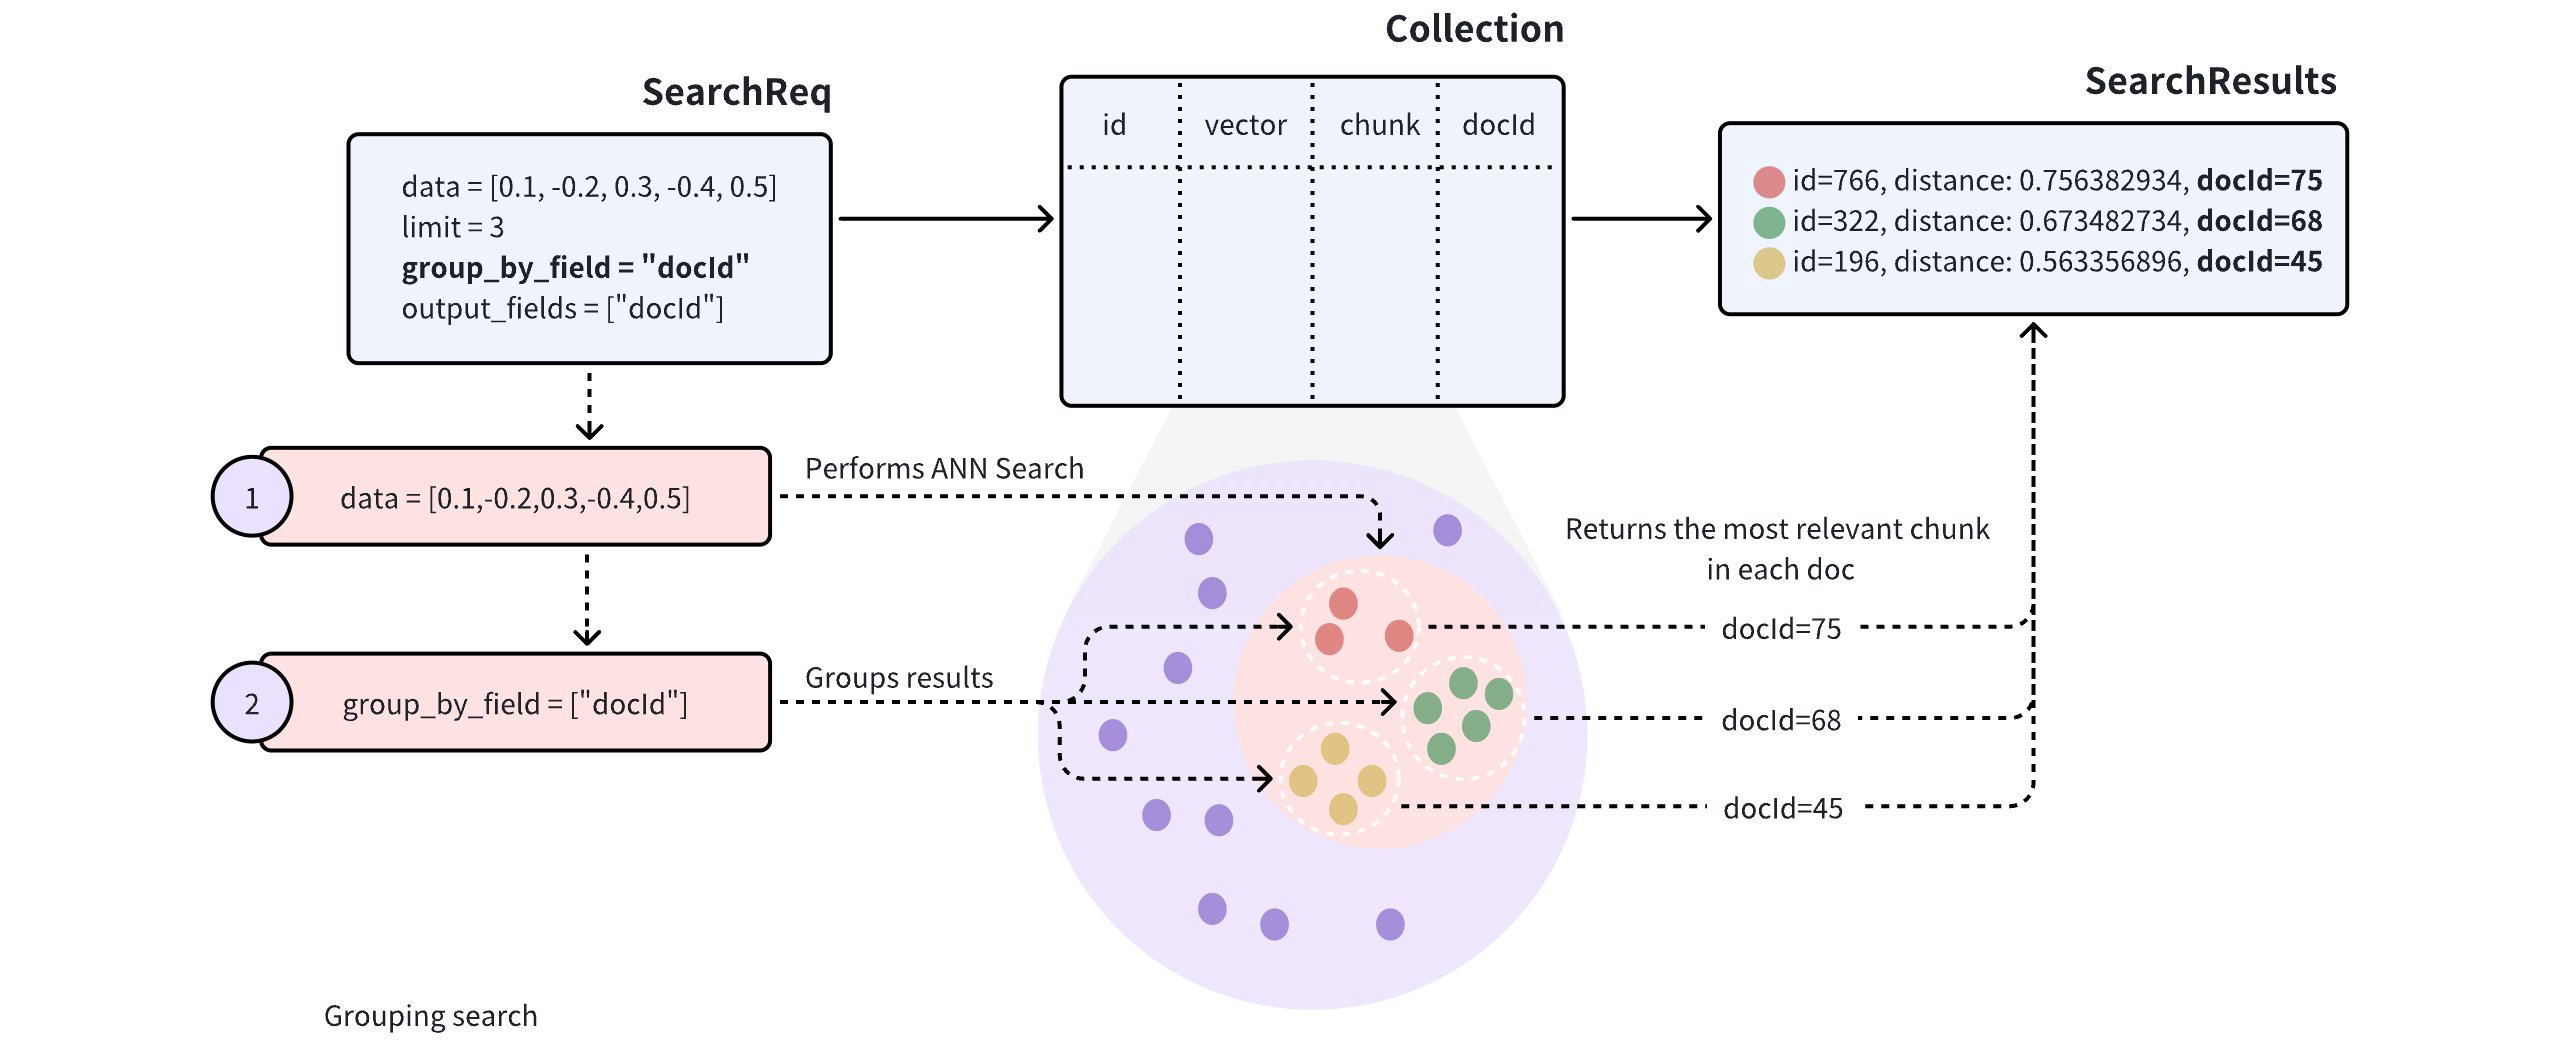 Pencarian Berkelompok
Untuk meningkatkan keragaman hasil pencarian, Anda dapat menambahkan parameter ` group_by_field ` dalam permintaan pencarian untuk mengaktifkan Pencarian Berkelompok. Seperti yang ditunjukkan pada diagram, Anda dapat mengatur ` group_by_field ` menjadi ` docId`. Setelah menerima permintaan ini, Milvus akan:
Melakukan pencarian ANN berdasarkan vektor kueri yang diberikan untuk menemukan semua entitas yang paling mirip dengan kueri tersebut.
Mengelompokkan hasil pencarian berdasarkan parameter `
group_by_field` yang ditentukan, seperti `docId`.Mengembalikan hasil teratas untuk setiap kelompok, sebagaimana ditentukan oleh parameter
limit, dengan entitas yang paling mirip dari setiap kelompok.
Secara default, Pencarian Pengelompokan hanya mengembalikan satu entitas per kelompok. Jika Anda ingin meningkatkan jumlah hasil yang akan dikembalikan per kelompok, Anda dapat mengontrolnya dengan parameter ` group_size ` dan ` strict_group_size `.
Melakukan Pencarian Berkelompok
Bagian ini menyediakan contoh kode untuk mendemonstrasikan penggunaan Pencarian Berkelompok. Contoh berikut mengasumsikan koleksi mencakup bidang untuk ` id`, ` vector`, ` chunk`, dan ` docId`.
[
        {"id": 0, "vector": [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592], "chunk": "pink_8682", "docId": 1},
        {"id": 1, "vector": [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501, 0.838729485096104], "chunk": "red_7025", "docId": 5},
        {"id": 2, "vector": [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, 0.7894058910881185, 0.20785793220625592], "chunk": "orange_6781", "docId": 2},
        {"id": 3, "vector": [0.3172005263489739, 0.9719044792798428, -0.36981146090600725, -0.4860894583077995, 0.95791889146345], "chunk": "pink_9298", "docId": 3},
        {"id": 4, "vector": [0.4452349528804562, -0.8757026943054742, 0.8220779437047674, 0.46406290649483184, 0.30337481143159106], "chunk": "red_4794", "docId": 3},
        {"id": 5, "vector": [0.985825131989184, -0.8144651566660419, 0.6299267002202009, 0.1206906911183383, -0.1446277761879955], "chunk": "yellow_4222", "docId": 4},
        {"id": 6, "vector": [0.8371977790571115, -0.015764369584852833, -0.31062937026679327, -0.562666951622192, -0.8984947637863987], "chunk": "red_9392", "docId": 1},
        {"id": 7, "vector": [-0.33445148015177995, -0.2567135004164067, 0.8987539745369246, 0.9402995886420709, 0.5378064918413052], "chunk": "grey_8510", "docId": 2},
        {"id": 8, "vector": [0.39524717779832685, 0.4000257286739164, -0.5890507376891594, -0.8650502298996872, -0.6140360785406336], "chunk": "white_9381", "docId": 5},
        {"id": 9, "vector": [0.5718280481994695, 0.24070317428066512, -0.3737913482606834, -0.06726932177492717, -0.6980531615588608], "chunk": "purple_4976", "docId": 3},
]
Dalam permintaan pencarian, atur baik group_by_field maupun output_fields menjadi docId. Milvus akan mengelompokkan hasil berdasarkan bidang yang ditentukan dan mengembalikan entitas yang paling mirip dari setiap kelompok, termasuk nilai docId untuk setiap entitas yang dikembalikan.
from pymilvus import MilvusClient

client = MilvusClient(
    uri="http://localhost:19530",
    token="root:Milvus"
)

query_vectors = [
    [0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088]]

# Group search results
res = client.search(
    collection_name="my_collection",
    data=query_vectors,
    limit=3,
    group_by_field="docId",
    output_fields=["docId"]
)

# Retrieve the values in the `docId` column
doc_ids = [result['entity']['docId'] for result in res[0]]
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.vector.request.SearchReq
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.response.SearchResp

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .token("root:Milvus")
        .build());

FloatVec queryVector = new FloatVec(new float[]{0.14529211512077012f, 0.9147257273453546f, 0.7965055218724449f, 0.7009258593102812f, 0.5605206522382088f});
SearchReq searchReq = SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryVector))
        .topK(3)
        .groupByFieldName("docId")
        .outputFields(Collections.singletonList("docId"))
        .build();

SearchResp searchResp = client.search(searchReq);

List<List<SearchResp.SearchResult>> searchResults = searchResp.getSearchResults();
for (List<SearchResp.SearchResult> results : searchResults) {
    System.out.println("TopK results:");
    for (SearchResp.SearchResult result : results) {
        System.out.println(result);
    }
}

// Output
// TopK results:
// SearchResp.SearchResult(entity={docId=5}, score=0.74767184, id=1)
// SearchResp.SearchResult(entity={docId=2}, score=0.6254269, id=7)
// SearchResp.SearchResult(entity={docId=3}, score=0.3611898, id=3)
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

queryVector := []float32{0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592}

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    3,               // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("vector").
    WithGroupByField("docId").
    WithOutputFields("docId"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("docId: ", resultSet.GetColumn("docId").FieldData().GetScalars())
}
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const address = "http://localhost:19530";
const token = "root:Milvus";
const client = new MilvusClient({address, token});

var query_vector = [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]

res = await client.search({
    collection_name: "my_collection",
    data: [query_vector],
    limit: 3,
    group_by_field: "docId"
})

// Retrieve the values in the `docId` column
var docIds = res.results.map(result => result.entity.docId)
export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": [
        [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]
    ],
    "annsField": "vector",
    "limit": 3,
    "groupingField": "docId",
    "outputFields": ["docId"]
}'
#include "milvus/MilvusClientV2.h"
#include <iostream>
#include <stdexcept>
#include <vector>

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"http://localhost:19530", "root:Milvus"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    throw std::runtime_error(status.Message());
}

std::vector<float> query_vector = {0.3580376395471989f, -0.6023495712049978f, 0.18414012509913835f, -0.26286205330961354f, 0.9029438446296592f};
auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .AddFloatVector(query_vector)
                   .WithLimit(3)
                   .WithAnnsField("vector")
                   .WithGroupByField("docId")
                   .AddOutputField("docId");

milvus::SearchResponse response;
status = client->Search(request, response);
if (!status.IsOk()) {
    throw std::runtime_error(status.Message());
}

for (auto& result : response.Results().Results()) {
    std::cout << "TopK results:" << std::endl;
    milvus::EntityRows output_rows;
    status = result.OutputRows(output_rows);
    if (!status.IsOk()) {
        throw std::runtime_error(status.Message());
    }
    for (const auto& row : output_rows) {
        std::cout << "\t" << row << std::endl;
    }
}
Dalam permintaan di atas, limit=3 menunjukkan bahwa sistem akan mengembalikan hasil pencarian dari tiga kelompok, dengan setiap kelompok berisi satu entitas yang paling mirip dengan vektor kueri.
Konfigurasi ukuran grup
Secara default, Pencarian Berkelompok hanya mengembalikan satu entitas per kelompok. Jika Anda ingin mendapatkan beberapa hasil per kelompok, sesuaikan parameter ` group_size ` dan ` strict_group_size `.
# Group search results

res = client.search(
    collection_name="my_collection",
    data=query_vectors, # query vector
    limit=5, # number of groups to return
    group_by_field="docId", # grouping field
    group_size=2, # p to 2 entities to return from each group
    strict_group_size=True, # return exact 2 entities from each group
    output_fields=["docId"]
)
FloatVec queryVector = new FloatVec(new float[]{0.14529211512077012f, 0.9147257273453546f, 0.7965055218724449f, 0.7009258593102812f, 0.5605206522382088f});
SearchReq searchReq = SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryVector))
        .topK(5)
        .groupByFieldName("docId")
        .groupSize(2)
        .strictGroupSize(true)
        .outputFields(Collections.singletonList("docId"))
        .build();

SearchResp searchResp = client.search(searchReq);

List<List<SearchResp.SearchResult>> searchResults = searchResp.getSearchResults();
for (List<SearchResp.SearchResult> results : searchResults) {
    System.out.println("TopK results:");
    for (SearchResp.SearchResult result : results) {
        System.out.println(result);
    }
}

// Output
// TopK results:
// SearchResp.SearchResult(entity={docId=5}, score=0.74767184, id=1)
// SearchResp.SearchResult(entity={docId=5}, score=-0.49148706, id=8)
// SearchResp.SearchResult(entity={docId=2}, score=0.6254269, id=7)
// SearchResp.SearchResult(entity={docId=2}, score=0.38515577, id=2)
// SearchResp.SearchResult(entity={docId=3}, score=0.3611898, id=3)
// SearchResp.SearchResult(entity={docId=3}, score=0.19556211, id=4)
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

queryVector := []float32{0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592}

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    5,               // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("vector").
    WithGroupByField("docId").
    WithStrictGroupSize(true).
    WithGroupSize(2).
    WithOutputFields("docId"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("docId: ", resultSet.GetColumn("docId").FieldData().GetScalars())
}
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const address = "http://localhost:19530";
const token = "root:Milvus";
const client = new MilvusClient({address, token});

var query_vector = [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]

res = await client.search({
    collection_name: "my_collection",
    data: [query_vector],
    limit: 5,
    group_by_field: "docId",
    group_size: 2,
    strict_group_size: true
})

// Retrieve the values in the `docId` column
var docIds = res.results.map(result => result.entity.docId)
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": [
        [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]
    ],
    "annsField": "vector",
    "limit": 5,
    "groupingField": "docId",
    "groupSize":2,
    "strictGroupSize":true,
    "outputFields": ["docId"]
}'
#include "milvus/MilvusClientV2.h"
#include <iostream>
#include <stdexcept>
#include <vector>

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"http://localhost:19530", "root:Milvus"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    throw std::runtime_error(status.Message());
}

std::vector<float> query_vector = {0.3580376395471989f, -0.6023495712049978f, 0.18414012509913835f, -0.26286205330961354f, 0.9029438446296592f};
auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .AddFloatVector(query_vector)
                   .WithLimit(5)
                   .WithAnnsField("vector")
                   .WithGroupByField("docId")
                   .WithGroupSize(2)
                   .WithStrictGroupSize(true)
                   .AddOutputField("docId");

milvus::SearchResponse response;
status = client->Search(request, response);
if (!status.IsOk()) {
    throw std::runtime_error(status.Message());
}

for (auto& result : response.Results().Results()) {
    std::cout << "TopK results:" << std::endl;
    milvus::EntityRows output_rows;
    status = result.OutputRows(output_rows);
    if (!status.IsOk()) {
        throw std::runtime_error(status.Message());
    }
    for (const auto& row : output_rows) {
        std::cout << "\t" << row << std::endl;
    }
}
Dalam contoh di atas:
group_size: Menentukan jumlah entitas yang diinginkan untuk dikembalikan per grup. Misalnya, mengatur `group_size=2` berarti setiap grup (atau setiap `docId`) idealnya harus mengembalikan dua paragraf (atau potongan) yang paling mirip. Jika `group_size` tidak diatur, sistem secara default akan mengembalikan satu hasil per grup.strict_group_size: Parameter boolean ini mengontrol apakah sistem harus secara ketat menerapkan jumlah yang ditetapkan olehgroup_size. Ketikastrict_group_size=True, sistem akan berusaha menyertakan jumlah entitas yang tepat sesuai dengan yang ditentukan olehgroup_sizedalam setiap grup (misalnya, dua paragraf), kecuali jika tidak ada cukup data dalam grup tersebut. Secara default (strict_group_size=False), sistem memprioritaskan pemenuhan jumlah grup yang ditentukan oleh parameterlimit, daripada memastikan setiap grup berisigroup_sizeentitas. Pendekatan ini umumnya lebih efisien dalam kasus di mana distribusi data tidak merata.
Untuk detail parameter lebih lanjut, lihat search.
Mengurutkan kelompok berdasarkan bidang skalarCompatible with Milvus 3.0.x
Anda dapat menggabungkan Pencarian Berkelompok (Grouping Search) dengan Pengelompokan Berbasis Bidang Skalar ( order_by_fields ) untuk mengurutkan kelompok berdasarkan bidang skalar. Hal ini berguna ketika Anda menginginkan hasil yang beragam di seluruh kelompok, namun tetap ingin kelompok-kelompok tersebut mengikuti urutan yang relevan secara bisnis, seperti harga atau peringkat.
Contoh berikut mengelompokkan hasil pencarian berdasarkan " category", mengembalikan hingga tiga entitas per kelompok, dan mengurutkan kelompok yang dikembalikan berdasarkan " price " dari yang terendah ke tertinggi.
res = client.search(
    collection_name="product_catalog",
    data=query_vectors,
    anns_field="embedding",
    limit=20,
    group_by_field="category",
    group_size=3,
    strict_group_size=True,
    output_fields=["category", "price", "rating"],
    order_by_fields=[
        {"field": "price", "order": "asc"}
    ],
)
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.request.aggregation.AggDirection;
import io.milvus.v2.service.vector.request.aggregation.OrderByField;
import io.milvus.v2.service.vector.response.SearchResp;
import java.util.List;

// Prerequisite: client is connected to Milvus and product_catalog is loaded.
FloatVec queryVector = new FloatVec(new float[]{0.14529211512077012f, 0.9147257273453546f, 0.7965055218724449f, 0.7009258593102812f, 0.5605206522382088f});
SearchReq request = SearchReq.builder()
    .collectionName("product_catalog")
    .data(List.of(queryVector))
    .annsField("embedding")
    .topK(20)
    .groupByFieldName("category")
    .groupSize(3)
    .strictGroupSize(true)
    .outputFields(List.of("category", "price", "rating"))
    .orderByFields(List.of(OrderByField.builder()
        .fieldName("price").direction(AggDirection.ASC).build()))
    .build();
SearchResp response = client.search(request);
System.out.println(response.getSearchResults());
// Prerequisite: client is connected to Milvus and product_catalog is loaded.
const queryVector = [0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088];
const response = await client.search({
  collection_name: "product_catalog",
  data: [queryVector],
  anns_field: "embedding",
  limit: 20,
  group_by_field: "category",
  group_size: 3,
  strict_group_size: true,
  output_fields: ["category", "price", "rating"],
  order_by_fields: [{ field: "price", order: "asc" }],
});
console.log(response.results);
import (
    "fmt"
    "github.com/milvus-io/milvus/client/v3/entity"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

// Prerequisite: client is connected to Milvus and product_catalog is loaded.
queryVector := []float32{0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088}
results, err := client.Search(ctx, milvusclient.NewSearchOption(
    "product_catalog", 20, []entity.Vector{entity.FloatVector(queryVector)},
).
    WithANNSField("embedding").
    WithGroupByField("category").
    WithGroupSize(3).
    WithStrictGroupSize(true).
    WithOutputFields("category", "price", "rating").
    WithSearchParam("order_by_fields", "price:asc"))
if err != nil {
    panic(err)
}
for _, result := range results {
    fmt.Println(result.IDs, result.Scores)
    fmt.Println(result.GetColumn("category"), result.GetColumn("price"), result.GetColumn("rating"))
}
# Prerequisite: set CLUSTER_ENDPOINT and TOKEN for your Milvus instance.
curl --request POST \
  --url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
  --header "Authorization: Bearer ${TOKEN}" \
  --header "Content-Type: application/json" \
  --data '{
    "collectionName": "product_catalog",
    "data": [[0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088]],
    "annsField": "embedding",
    "limit": 20,
    "groupingField": "category",
    "groupSize": 3,
    "strictGroupSize": true,
    "outputFields": ["category", "price", "rating"],
    "orderByFields": ["price:asc"]
  }'
#include "milvus/MilvusClientV2.h"
#include <iostream>
#include <stdexcept>

// Prerequisite: client is connected to Milvus and product_catalog is loaded.
std::vector<float> query_vector = {0.14529211512077012f, 0.9147257273453546f, 0.7965055218724449f, 0.7009258593102812f, 0.5605206522382088f};
auto request = milvus::SearchRequest()
    .WithCollectionName("product_catalog")
    .AddFloatVector(query_vector)
    .WithAnnsField("embedding")
    .WithLimit(20)
    .WithGroupByField("category")
    .WithGroupSize(3)
    .WithStrictGroupSize(true)
    .AddOutputField("category")
    .AddOutputField("price")
    .AddOutputField("rating")
    .AddOrderByField(milvus::OrderByField("price", milvus::AggregationDirection::ASC));
milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) { throw std::runtime_error(status.Message()); }
for (const auto& result : response.Results().Results()) {
    milvus::EntityRows rows;
    status = result.OutputRows(rows);
    if (!status.IsOk()) { throw std::runtime_error(status.Message()); }
    std::cout << rows << std::endl;
}
Dalam permintaan di atas, ` limit=20 ` berarti Milvus memilih hingga 20 kelompok, bukan 20 entitas. Karena ` group_size=3`, daftar hasil datar dapat berisi hingga 60 entitas secara total.
Saat Anda menggunakan ` order_by_fields ` dengan ` group_by_field`, Milvus mengurutkan grup berdasarkan nilai bidang skalar yang ditentukan dari entitas teratas di setiap grup. Di dalam setiap grup, entitas tetap diurutkan berdasarkan skor kemiripannya dengan vektor kueri.
Pertimbangan
Pengindeksan: Fitur pengelompokan ini hanya berfungsi untuk koleksi yang diindeks dengan jenis indeks berikut: FLAT, IVF_FLAT, IVF_SQ8, HNSW, HNSW_PQ, HNSW_PRQ, HNSW_SQ, DISKANN, SPARSE_INVERTED_INDEX.
Jumlah kelompok: Parameter `
limit` mengontrol jumlah kelompok yang digunakan untuk mengembalikan hasil pencarian, bukan jumlah entitas spesifik di dalam setiap kelompok. Menetapkan nilai `limit` yang tepat membantu mengontrol keragaman hasil pencarian dan kinerja kueri. Mengurangi `limit` dapat mengurangi biaya komputasi jika data tersebar secara padat atau kinerja menjadi pertimbangan.Entitas per kelompok: Parameter
group_sizemengontrol jumlah entitas yang ditampilkan per kelompok. Menyesuaikangroup_sizesesuai dengan kasus penggunaan Anda dapat meningkatkan kekayaan hasil pencarian. Namun, jika data terdistribusi secara tidak merata, beberapa kelompok mungkin menampilkan entitas lebih sedikit daripada yang ditentukan olehgroup_size, terutama dalam skenario data yang terbatas.Ukuran grup yang ketat: Saat
strict_group_size=True, sistem akan berusaha mengembalikan jumlah entitas yang ditentukan (group_size) untuk setiap grup, kecuali jika data di grup tersebut tidak mencukupi. Pengaturan ini memastikan jumlah entitas yang konsisten per grup, tetapi dapat menyebabkan penurunan kinerja jika distribusi data tidak merata atau sumber daya terbatas. Jika jumlah entitas yang ketat tidak diperlukan, mengaturstrict_group_size=Falsedapat meningkatkan kecepatan kueri.Jika vektor kueri sudah ada di koleksi tujuan, pertimbangkan untuk menggunakan `
ids` alih-alih mengambilnya sebelum melakukan pencarian. Untuk detailnya, lihat Pencarian Kunci Utama.
