

Recherche hybride multisectorielle
Dans de nombreuses applications, un objet peut être recherché à l'aide d'un ensemble riche d'informations telles que le titre et la description, ou à l'aide de modalités multiples telles que le texte, les images et l'audio. Par exemple, un tweet contenant un texte et une image sera recherché si le texte ou l'image correspond à la sémantique de la requête. La recherche hybride améliore l'expérience de recherche en combinant des recherches dans ces différents domaines. Milvus prend cela en charge en permettant la recherche sur plusieurs champs vectoriels, en effectuant plusieurs recherches par approximation du plus proche voisin (ANN) simultanément. La recherche hybride multi-vectorielle est particulièrement utile si vous souhaitez rechercher à la fois du texte et des images, plusieurs champs de texte décrivant le même objet, ou des vecteurs denses et peu denses afin d'améliorer la qualité de la recherche.
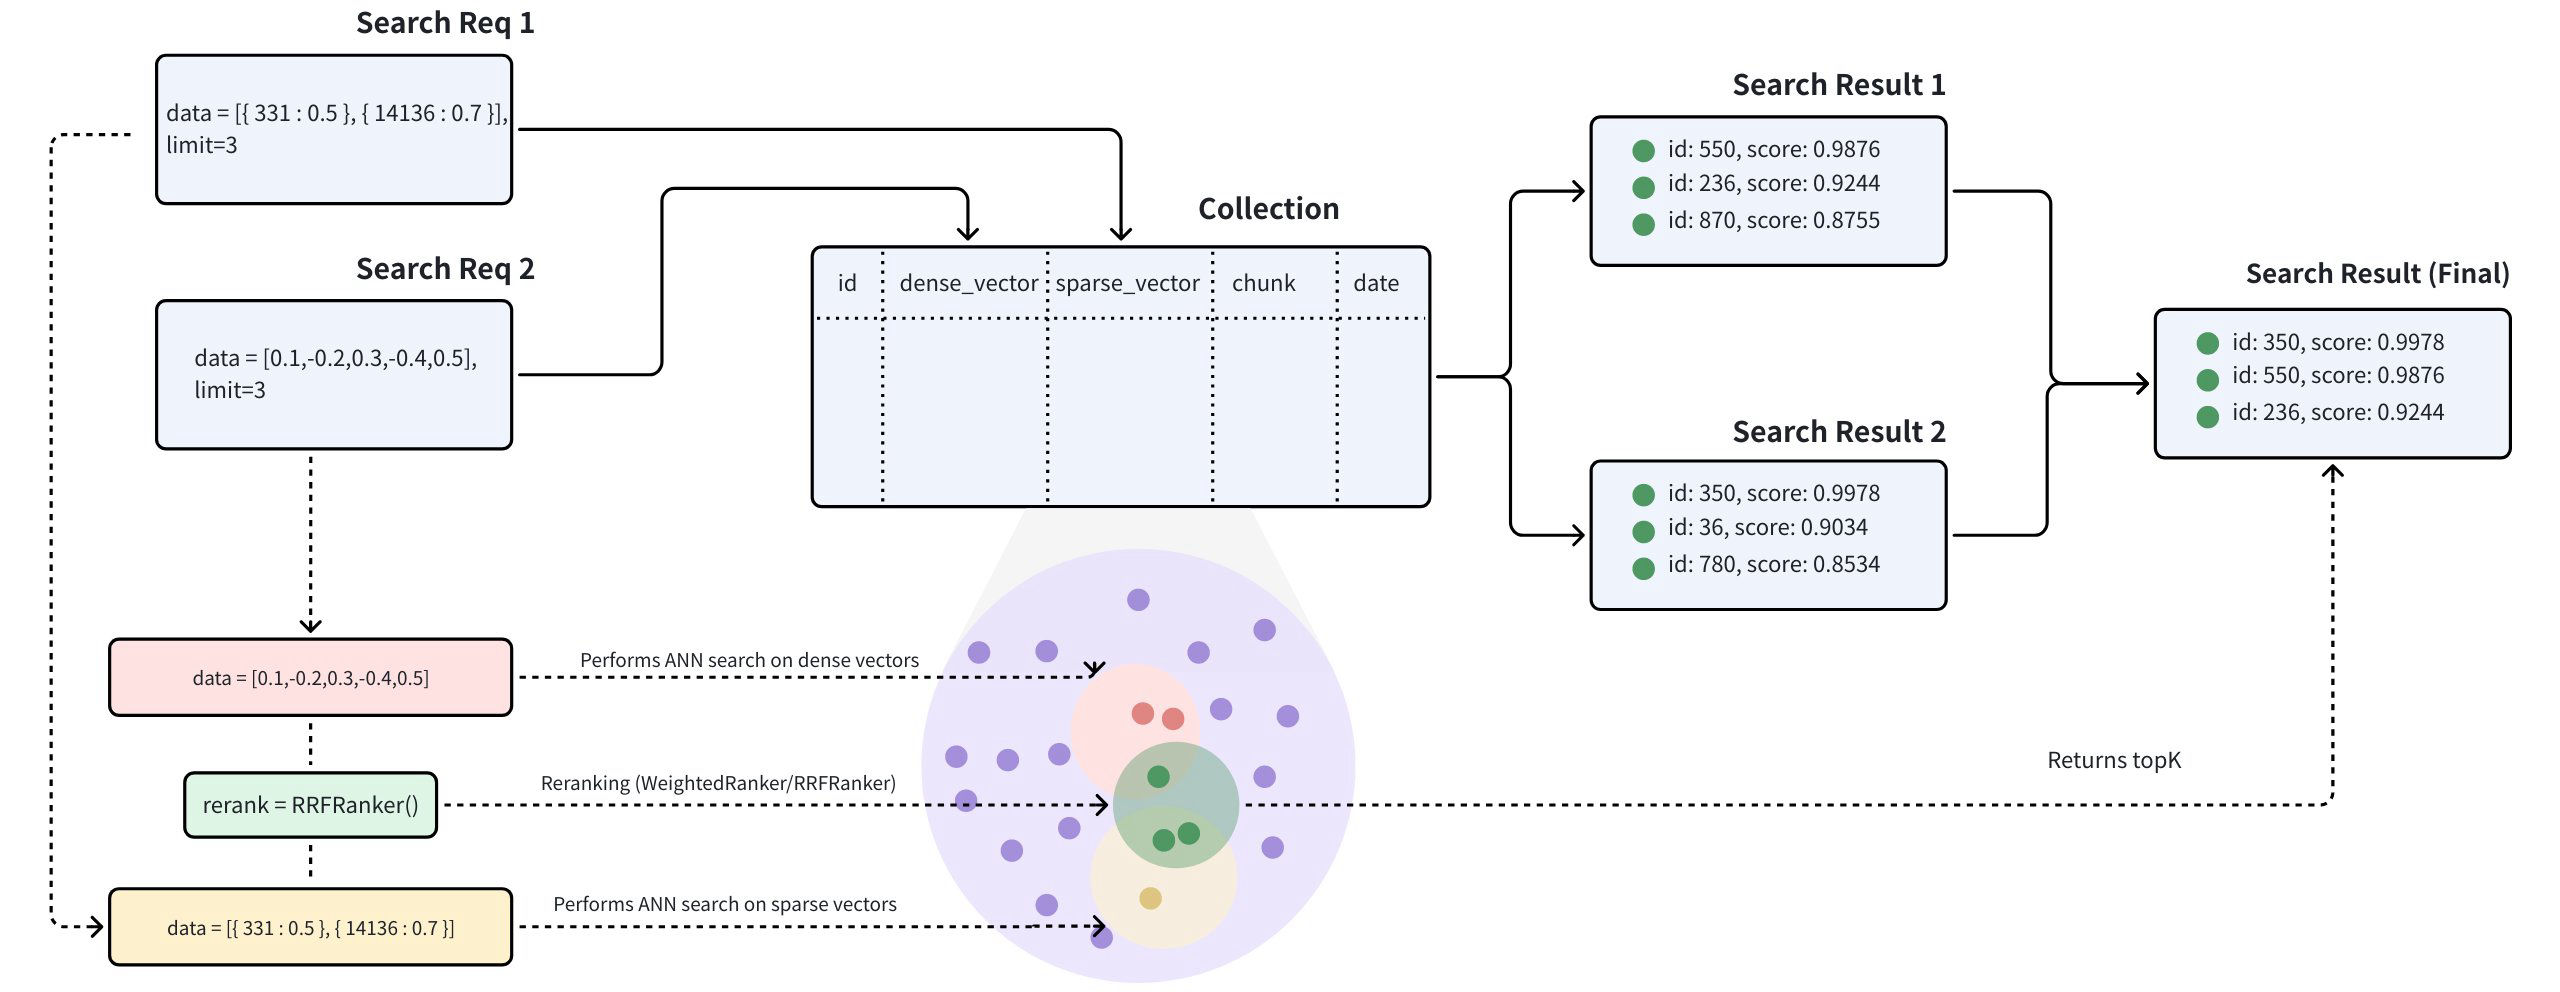 Flux de travail de la recherche hybride
La recherche hybride multi-vectorielle intègre différentes méthodes de recherche ou couvre des encastrements provenant de diverses modalités :
Recherche de vecteurs denses et épars: Les vecteurs denses sont excellents pour capturer les relations sémantiques, tandis que les vecteurs épars sont très efficaces pour la correspondance précise des mots-clés. La recherche hybride combine ces approches pour fournir à la fois une compréhension conceptuelle large et une pertinence exacte des termes, améliorant ainsi les résultats de la recherche. En tirant parti des points forts de chaque méthode, la recherche hybride surmonte les limites des approches individuelles et offre de meilleures performances pour les requêtes complexes. Voici un guide plus détaillé sur la recherche hybride qui combine la recherche sémantique et la recherche en texte intégral.
Recherche vectorielle multimodale: La recherche vectorielle multimodale est une technique puissante qui vous permet d'effectuer des recherches dans différents types de données, y compris le texte, les images, l'audio et d'autres. Le principal avantage de cette approche est sa capacité à unifier différentes modalités en une expérience de recherche homogène et cohérente. Par exemple, dans le cas d'une recherche de produits, un utilisateur peut saisir une requête textuelle pour trouver des produits décrits à la fois par du texte et des images. En combinant ces modalités au moyen d'une méthode de recherche hybride, vous pouvez améliorer la précision de la recherche ou enrichir les résultats de la recherche.
Exemple de recherche
Considérons un cas d'utilisation réel où chaque produit comprend une description textuelle et une image. Sur la base des données disponibles, nous pouvons effectuer trois types de recherche :
Recherche de texte sémantique : Il s'agit d'interroger la description textuelle du produit à l'aide de vecteurs denses. Les vecteurs denses peuvent être générés à l'aide de modèles tels que BERT et Transformers ou de services tels que OpenAI.
Recherche en texte intégral: Ici, nous interrogeons la description textuelle du produit à l'aide d'une correspondance de mots-clés avec des vecteurs peu denses. Des algorithmes tels que BM25 ou des modèles d'intégration peu dense tels que BGE-M3 ou SPLADE peuvent être utilisés à cette fin.
Recherche multimodale d'images : Cette méthode permet d'interroger l'image à l'aide d'une requête textuelle et de vecteurs denses. Les encastrements d'images peuvent être générés à l'aide de modèles tels que CLIP.
Ce guide présente un exemple de recherche hybride multimodale combinant les méthodes de recherche susmentionnées, à partir d'une description textuelle brute et d'incrustations d'images de produits. Nous montrerons comment stocker des données multi-vectorielles et effectuer des recherches hybrides avec une stratégie de reranking.
Créer une collection avec plusieurs champs vectoriels
Le processus de création d'une collection comporte trois étapes clés : la définition du schéma de la collection, la configuration des paramètres de l'index et la création de la collection.
Définir le schéma
Pour la recherche hybride multi-vectorielle, nous devons définir plusieurs champs vectoriels dans un schéma de collection. Par défaut, chaque collection peut contenir jusqu'à 4 champs vectoriels. Cependant, si nécessaire, vous pouvez ajuster le site proxy.maxVectorFieldNum pour inclure jusqu'à 10 champs vectoriels dans une collection.
Cet exemple incorpore les champs suivants dans le schéma :
id: sert de clé primaire pour le stockage des identifiants de texte. Ce champ est de typeINT64.text: Utilisé pour stocker le contenu textuel. Ce champ est de typeVARCHARet a une longueur maximale de 1000 octets. L'optionenable_analyzerest définie surTruepour faciliter la recherche en texte intégral.text_dense: Utilisé pour stocker les vecteurs denses des textes. Ce champ est de typeFLOAT_VECTORavec une dimension vectorielle de 768.text_sparse: Utilisé pour stocker les vecteurs peu denses des textes. Ce champ est du typeSPARSE_FLOAT_VECTOR.image_dense: Utilisé pour stocker les vecteurs denses des images de produits. Ce champ est du typeFLOAT_VECTORavec une dimension vectorielle de 512.
Étant donné que nous utiliserons l'algorithme BM25 intégré pour effectuer une recherche plein texte sur le champ texte, il est nécessaire d'ajouter le Milvus Function au schéma. Pour plus de détails, veuillez vous référer à la section Recherche en texte intégral.
from pymilvus import (
    MilvusClient, DataType, Function, FunctionType
)

client = MilvusClient(
    uri="http://localhost:19530",
    token="root:Milvus"
)

# Init schema with auto_id disabled
schema = MilvusClient.create_schema(auto_id=False)

# Add fields to schema
schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True, description="product id")
schema.add_field(field_name="text", datatype=DataType.VARCHAR, max_length=1000, enable_analyzer=True, description="raw text of product description")
schema.add_field(field_name="text_dense", datatype=DataType.FLOAT_VECTOR, dim=768, description="text dense embedding")
schema.add_field(field_name="text_sparse", datatype=DataType.SPARSE_FLOAT_VECTOR, description="text sparse embedding auto-generated by the built-in BM25 function")
schema.add_field(field_name="image_dense", datatype=DataType.FLOAT_VECTOR, dim=512, description="image dense embedding")

# Add function to schema
bm25_function = Function(
    name="text_bm25_emb",
    input_field_names=["text"],
    output_field_names=["text_sparse"],
    function_type=FunctionType.BM25,
)
schema.add_function(bm25_function)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq.Function;

import java.util.*;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .token("root:Milvus")
        .build());

CreateCollectionReq.CollectionSchema schema = client.createSchema();

schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(false)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("text_dense")
        .dataType(DataType.FloatVector)
        .dimension(768)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("text_sparse")
        .dataType(DataType.SparseFloatVector)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("image_dense")
        .dataType(DataType.FloatVector)
        .dimension(512)
        .build());

schema.addFunction(Function.builder()
        .functionType(FunctionType.BM25)
        .name("text_bm25_emb")
        .inputFieldNames(Collections.singletonList("text"))
        .outputFieldNames(Collections.singletonList("text_sparse"))
        .build());
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

function := entity.NewFunction().
    WithName("text_bm25_emb").
    WithInputFields("text").
    WithOutputFields("text_sparse").
    WithType(entity.FunctionTypeBM25)

schema := entity.NewSchema()

schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true),
).WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithMaxLength(1000),
).WithField(entity.NewField().
    WithName("text_dense").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(768),
).WithField(entity.NewField().
    WithName("text_sparse").
    WithDataType(entity.FieldTypeSparseVector),
).WithField(entity.NewField().
    WithName("image_dense").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(512),
).WithFunction(function)
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const address = "http://localhost:19530";
const token = "root:Milvus";
const client = new MilvusClient({address, token});

// Define fields
const fields = [
    {
        name: "id",
        data_type: DataType.Int64,
        is_primary_key: true,
        auto_id: false
    },
    {
        name: "text",
        data_type: DataType.VarChar,
        max_length: 1000,
        enable_match: true
    },
    {
        name: "text_dense",
        data_type: DataType.FloatVector,
        dim: 768
    },
    {
        name: "text_sparse",
        data_type: DataType.SPARSE_FLOAT_VECTOR
    },
    {
        name: "image_dense",
        data_type: DataType.FloatVector,
        dim: 512
    }
];

// define function
const functions = [
    {
      name: "text_bm25_emb",
      description: "text bm25 function",
      type: FunctionType.BM25,
      input_field_names: ["text"],
      output_field_names: ["text_sparse"],
      params: {},
    },
];
export bm25Function='{
    "name": "text_bm25_emb",
    "type": "BM25",
    "inputFieldNames": ["text"],
    "outputFieldNames": ["text_sparse"],
    "params": {}
}'

export schema='{
        "autoId": false,
        "functions": [$bm25Function],
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true
                }
            },
            {
                "fieldName": "text_dense",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "768"
                }
            },
            {
                "fieldName": "text_sparse",
                "dataType": "SparseFloatVector"
            },
            {
                "fieldName": "image_dense",
                "dataType": "FloatVector",
                "elementTypeParams": {
                    "dim": "512"
                }
            }
        ]
    }'
Créer un index
from pymilvus import MilvusClient

# Prepare index parameters
index_params = client.prepare_index_params()

# Add indexes
index_params.add_index(
    field_name="text_dense",
    index_name="text_dense_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)

index_params.add_index(
    field_name="text_sparse",
    index_name="text_sparse_index",
    index_type="SPARSE_INVERTED_INDEX",
    metric_type="BM25",
    params={"inverted_index_algo": "DAAT_MAXSCORE"}, # or "DAAT_WAND" or "TAAT_NAIVE"
)

index_params.add_index(
    field_name="image_dense",
    index_name="image_dense_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)
import io.milvus.v2.common.IndexParam;
import java.util.*;

Map<String, Object> denseParams = new HashMap<>();

IndexParam indexParamForTextDense = IndexParam.builder()
        .fieldName("text_dense")
        .indexName("text_dense_index")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build();

Map<String, Object> sparseParams = new HashMap<>();
sparseParams.put("inverted_index_algo": "DAAT_MAXSCORE");
IndexParam indexParamForTextSparse = IndexParam.builder()
        .fieldName("text_sparse")
        .indexName("text_sparse_index")
        .indexType(IndexParam.IndexType.SPARSE_INVERTED_INDEX)
        .metricType(IndexParam.MetricType.BM25)
        .extraParams(sparseParams)
        .build();

IndexParam indexParamForImageDense = IndexParam.builder()
        .fieldName("image_dense")
        .indexName("image_dense_index")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build();

List<IndexParam> indexParams = new ArrayList<>();
indexParams.add(indexParamForTextDense);
indexParams.add(indexParamForTextSparse);
indexParams.add(indexParamForImageDense);
indexOption1 := milvusclient.NewCreateIndexOption("my_collection", "text_dense",
    index.NewAutoIndex(index.MetricType(entity.IP)))
indexOption2 := milvusclient.NewCreateIndexOption("my_collection", "text_sparse",
    index.NewSparseInvertedIndex(entity.BM25, 0.2))
indexOption3 := milvusclient.NewCreateIndexOption("my_collection", "image_dense",
    index.NewAutoIndex(index.MetricType(entity.IP)))
)
const index_params = [{
    field_name: "text_dense",
    index_name: "text_dense_index",
    index_type: "AUTOINDEX",
    metric_type: "IP"
},{
    field_name: "text_sparse",
    index_name: "text_sparse_index",
    index_type: "IndexType.SPARSE_INVERTED_INDEX",
    metric_type: "BM25",
    params: {
      inverted_index_algo: "DAAT_MAXSCORE",
    }
},{
    field_name: "image_dense",
    index_name: "image_dense_index",
    index_type: "AUTOINDEX",
    metric_type: "IP"
}]
export indexParams='[
        {
            "fieldName": "text_dense",
            "metricType": "IP",
            "indexName": "text_dense_index",
            "indexType":"AUTOINDEX"
        },
        {
            "fieldName": "text_sparse",
            "metricType": "BM25",
            "indexName": "text_sparse_index",
            "indexType": "SPARSE_INVERTED_INDEX",
            "params":{"inverted_index_algo": "DAAT_MAXSCORE"}
        },
        {
            "fieldName": "image_dense",
            "metricType": "IP",
            "indexName": "image_dense_index",
            "indexType":"AUTOINDEX"
        }
    ]'
Créer une collection
Créez une collection nommée demo avec le schéma de collection et les index configurés dans les deux étapes précédentes.
from pymilvus import MilvusClient

client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
CreateCollectionReq createCollectionReq = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexParams)
        .build();
client.createCollection(createCollectionReq);
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption1, indexOption2))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
res = await client.createCollection({
    collection_name: "my_collection",
    fields: fields,
    index_params: index_params,
})
export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
Insérer des données
Cette section insère des données dans la collection my_collection sur la base du schéma défini précédemment. Lors de l'insertion, assurez-vous que tous les champs, à l'exception de ceux dont les valeurs sont générées automatiquement, contiennent des données au bon format. Dans cet exemple :
idun nombre entier représentant l'ID du produittextune chaîne de caractères contenant la description du produittext_denseune liste de 768 valeurs à virgule flottante représentant l'intégration dense de la description textuelleimage_denseune liste de 512 valeurs à virgule flottante représentant l'intégration dense de l'image du produit.
Vous pouvez utiliser le même modèle ou des modèles différents pour générer des encastrements denses pour chaque champ. Dans cet exemple, les deux denses embeddings ont des dimensions différentes, ce qui suggère qu'ils ont été générés par des modèles différents. Lors de la définition ultérieure de chaque recherche, veillez à utiliser le modèle correspondant pour générer l'intégration de requête appropriée.
Étant donné que cet exemple utilise la fonction BM25 intégrée pour générer des encastrements denses à partir du champ de texte, il n'est pas nécessaire de fournir des vecteurs denses manuellement. Toutefois, si vous choisissez de ne pas utiliser BM25, vous devez précalculer et fournir vous-même les vecteurs d'intégration épars.
from pymilvus import MilvusClient

data=[
    {
        "id": 0,
        "text": "Red cotton t-shirt with round neck",
        "text_dense": [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...],
        "image_dense": [0.6366019600530924, -0.09323198122475052, ...]
    },
    {
        "id": 1,
        "text": "Wireless noise-cancelling over-ear headphones",
        "text_dense": [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...],
        "image_dense": [0.6414180010301553, 0.8976979978567611, ...]
    },
    {
        "id": 2,
        "text": "Stainless steel water bottle, 500ml",
        "dense": [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...],
        "image_dense": [-0.6901259768402174, 0.6100500332193755, ...]
    }
]

res = client.insert(
    collection_name="my_collection",
    data=data
)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;

Gson gson = new Gson();
JsonObject row1 = new JsonObject();
row1.addProperty("id", 0);
row1.addProperty("text", "Red cotton t-shirt with round neck");
row1.add("text_dense", gson.toJsonTree(text_dense1));
row1.add("image_dense", gson.toJsonTree(image_dense));

JsonObject row2 = new JsonObject();
row2.addProperty("id", 1);
row2.addProperty("text", "Wireless noise-cancelling over-ear headphones");
row2.add("text_dense", gson.toJsonTree(text_dense2));
row2.add("image_dense", gson.toJsonTree(image_dense2));

JsonObject row3 = new JsonObject();
row3.addProperty("id", 2);
row3.addProperty("text", "Stainless steel water bottle, 500ml");
row3.add("text_dense", gson.toJsonTree(dense3));
row3.add("image_dense", gson.toJsonTree(sparse3));

List<JsonObject> data = Arrays.asList(row1, row2, row3);
InsertReq insertReq = InsertReq.builder()
        .collectionName("my_collection")
        .data(data)
        .build();

InsertResp insertResp = client.insert(insertReq);
_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("my_collection").
    WithInt64Column("id", []int64{0, 1, 2}).
    WithVarcharColumn("text", []string{
        "Red cotton t-shirt with round neck",
        "Wireless noise-cancelling over-ear headphones",
        "Stainless steel water bottle, 500ml",
    }).
    WithFloatVectorColumn("text_dense", 768, [][]float32{
        {0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...},
        {0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...},
        {0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...},
    }).
    WithFloatVectorColumn("image_dense", 512, [][]float32{
        {0.6366019600530924, -0.09323198122475052, ...},
        {0.6414180010301553, 0.8976979978567611, ...},
        {-0.6901259768402174, 0.6100500332193755, ...},
    }).
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
const { MilvusClient, DataType } = require("@zilliz/milvus2-sdk-node")

var data = [
    {id: 0, text: "Red cotton t-shirt with round neck" , text_dense: [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...], image_dense: [0.6366019600530924, -0.09323198122475052, ...]},
    {id: 1, text: "Wireless noise-cancelling over-ear headphones" , text_dense: [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...], image_dense: [0.6414180010301553, 0.8976979978567611, ...]},
    {id: 2, text: "Stainless steel water bottle, 500ml" , text_dense: [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...], image_dense: [-0.6901259768402174, 0.6100500332193755, ...]}
]

var res = await client.insert({
    collection_name: "my_collection",
    data: data,
})
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
-d '{
    "data": [
        {"id": 0, "text": "Red cotton t-shirt with round neck" , "text_dense": [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...], "image_dense": [0.6366019600530924, -0.09323198122475052, ...]},
        {"id": 1, "text": "Wireless noise-cancelling over-ear headphones" , "text_dense": [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, ...], "image_dense": [0.6414180010301553, 0.8976979978567611, ...]},
        {"id": 2, "text": "Stainless steel water bottle, 500ml" , "text_dense": [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, ...], "image_dense": [-0.6901259768402174, 0.6100500332193755, ...]}
    ],
    "collectionName": "my_collection"
}'
Effectuer une recherche hybride
Créer plusieurs instances AnnSearchRequest
La recherche hybride est mise en œuvre en créant plusieurs AnnSearchRequest dans la fonction hybrid_search(), où chaque AnnSearchRequest représente une demande de recherche ANN de base pour un champ vectoriel spécifique. Par conséquent, avant d'effectuer une recherche hybride, il est nécessaire de créer un site AnnSearchRequest pour chaque champ vectoriel.
En outre, en configurant le paramètre expr dans un AnnSearchRequest, vous pouvez définir les conditions de filtrage de votre recherche hybride. Veuillez vous référer aux sections Recherche filtrée et Filtrage.
Dans la recherche hybride, chaque site AnnSearchRequest ne prend en charge qu'une seule donnée d'interrogation.
Pour démontrer les capacités des différents champs de vecteurs de recherche, nous allons construire trois requêtes de recherche AnnSearchRequest à l'aide d'un exemple de requête. Nous utiliserons également ses vecteurs denses précalculés pour ce processus. Les requêtes de recherche cibleront les champs de vecteurs suivants :
text_densepour la recherche sémantique de texte, permettant une compréhension contextuelle et une recherche basée sur le sens plutôt que sur la correspondance directe des mots-clés.text_sparsepour la recherche en texte intégral ou la correspondance de mots-clés, en se concentrant sur les correspondances exactes de mots ou de phrases dans le texte.image_densepour la recherche multimodale texte-image, afin d'extraire des images de produits pertinentes sur la base du contenu sémantique de la requête.
from pymilvus import AnnSearchRequest

query_text = "white headphones, quiet and comfortable"
query_dense_vector = [0.3580376395471989, -0.6023495712049978, 0.5142999509918703, ...]
query_multimodal_vector = [0.015829865178701663, 0.5264158340734488, ...]

# text semantic search (dense)
search_param_1 = {
    "data": [query_dense_vector],
    "anns_field": "text_dense",
    "param": {"nprobe": 10},
    "limit": 2
}
request_1 = AnnSearchRequest(**search_param_1)

# full-text search (sparse)
search_param_2 = {
    "data": [query_text],
    "anns_field": "text_sparse",
    "limit": 2
}
request_2 = AnnSearchRequest(**search_param_2)

# text-to-image search (multimodal)
search_param_3 = {
    "data": [query_multimodal_vector],
    "anns_field": "image_dense",
    "param": {"nprobe": 10},
    "limit": 2
}
request_3 = AnnSearchRequest(**search_param_3)

reqs = [request_1, request_2, request_3]
import io.milvus.v2.service.vector.request.AnnSearchReq;
import io.milvus.v2.service.vector.request.data.BaseVector;
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.request.data.SparseFloatVec;
import io.milvus.v2.service.vector.request.data.EmbeddedText;

float[] queryDense = new float[]{-0.0475336798f,  0.0521207601f,  0.0904406682f, ...};
float[] queryMultimodal = new float[]{0.0158298651f, 0.5264158340f, ...}

List<BaseVector> queryTexts = Collections.singletonList(new EmbeddedText("white headphones, quiet and comfortable");)
List<BaseVector> queryDenseVectors = Collections.singletonList(new FloatVec(queryDense));
List<BaseVector> queryMultimodalVectors = Collections.singletonList(new FloatVec(queryMultimodal));

List<AnnSearchReq> searchRequests = new ArrayList<>();
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_dense")
        .vectors(queryDenseVectors)
        .params("{\"nprobe\": 10}")
        .topK(2)
        .build());
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("text_sparse")
        .vectors(queryTexts)
        .topK(2)
        .build());
searchRequests.add(AnnSearchReq.builder()
        .vectorFieldName("image_dense")
        .vectors(queryMultimodalVectors)
        .params("{\"nprobe\": 10}")
        .topK(2)
        .build());
queryText := entity.Text({"white headphones, quiet and comfortable"})
queryVector := []float32{0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...}
queryMultimodalVector := []float32{0.015829865178701663, 0.5264158340734488, ...}

request1 := milvusclient.NewAnnRequest("text_dense", 2, entity.FloatVector(queryVector)).
    WithAnnParam(index.NewIvfAnnParam(10))

annParam := index.NewSparseAnnParam()
annParam.WithDropRatio(0.2)
request2 := milvusclient.NewAnnRequest("text_sparse", 2, queryText).
    WithAnnParam(annParam)

request3 := milvusclient.NewAnnRequest("image_dense", 2, entity.FloatVector(queryMultimodalVector)).
    WithAnnParam(index.NewIvfAnnParam(10))
const query_text = "white headphones, quiet and comfortable"
const query_vector = [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...]
const query_multimodal_vector = [0.015829865178701663, 0.5264158340734488, ...]

const search_param_1 = {
    "data": query_vector,
    "anns_field": "text_dense",
    "param": {"nprobe": 10},
    "limit": 2
}

const search_param_2 = {
    "data": query_text,
    "anns_field": "text_sparse",
    "limit": 2
}

const search_param_3 = {
    "data": query_multimodal_vector,
    "anns_field": "image_dense",
    "param": {"nprobe": 10},
    "limit": 2
}
export req='[
    {
        "data": [[0.3580376395471989, -0.6023495712049978, 0.18414012509913835, ...]],
        "annsField": "text_dense",
        "params": {"nprobe": 10},
        "limit": 2
    },
    {
        "data": ["white headphones, quiet and comfortable"],
        "annsField": "text_sparse",
        "limit": 2
    },
    {
        "data": [[0.015829865178701663, 0.5264158340734488, ...]],
        "annsField": "image_dense",
        "params": {"nprobe": 10},
        "limit": 2
    }
 ]'
Étant donné que le paramètre limit est fixé à 2, chaque AnnSearchRequest renvoie 2 résultats de recherche. Dans cet exemple, 3 instances AnnSearchRequest sont créées, ce qui donne un total de 6 résultats de recherche.
Configurer une stratégie de reclassement
Pour fusionner et reclasser les ensembles de résultats de recherche ANN, il est essentiel de sélectionner une stratégie de reclassement appropriée. Milvus propose deux types de stratégies de reclassement :
WeightedRanker: Utilisez cette stratégie si les résultats doivent mettre l'accent sur un champ vectoriel particulier. WeightedRanker permet d'attribuer un poids plus important à certains champs vectoriels et de les mettre en évidence.
RRFRanker (Reciprocal Rank Fusion Ranker): Choisissez cette stratégie lorsqu'aucune importance particulière n'est requise. RRFRanker équilibre efficacement l'importance de chaque champ vectoriel.
Pour plus de détails sur ces mécanismes de reclassement, veuillez vous référer à la section Reranking.
Dans cet exemple, étant donné qu'il n'y a pas d'importance particulière à accorder à des requêtes de recherche spécifiques, nous utiliserons la stratégie RRFRanker.
from pymilvus import RRFRanker

ranker = RRFRanker(100)
import io.milvus.v2.service.vector.request.ranker.BaseRanker;
import io.milvus.v2.service.vector.request.ranker.RRFRanker;

BaseRanker reranker = new RRFRanker(100);
reranker := milvusclient.NewRRFReranker().WithK(100)
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const rerank = RRFRanker("100");
export rerank='{
        "strategy": "rrf",
        "params": { "k": 100}
    }'
Effectuer une recherche hybride
Avant de lancer une recherche hybride, il faut s'assurer que la collection est chargée. Si l'un des champs vectoriels de la collection n'a pas d'index ou n'est pas chargé en mémoire, une erreur se produira lors de l'exécution de la méthode de recherche hybride.
from pymilvus import MilvusClient

res = client.hybrid_search(
    collection_name="my_collection",
    reqs=reqs,
    ranker=ranker,
    limit=2
)
for hits in res:
    print("TopK results:")
    for hit in hits:
        print(hit)
import io.milvus.v2.common.ConsistencyLevel;
import io.milvus.v2.service.vector.request.HybridSearchReq;
import io.milvus.v2.service.vector.response.SearchResp;

HybridSearchReq hybridSearchReq = HybridSearchReq.builder()
        .collectionName("my_collection")
        .searchRequests(searchRequests)
        .ranker(reranker)
        .topK(2)
        .build();

SearchResp searchResp = client.hybridSearch(hybridSearchReq);
resultSets, err := client.HybridSearch(ctx, milvusclient.NewHybridSearchOption(
    "my_collection",
    2,
    request1,
    request2,
    request3,
).WithReranker(reranker))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
}
const { MilvusClient, DataType } = require("@zilliz/milvus2-sdk-node")

res = await client.loadCollection({
    collection_name: "my_collection"
})

import { MilvusClient, RRFRanker, WeightedRanker } from '@zilliz/milvus2-sdk-node';

const search = await client.search({
  collection_name: "my_collection",
  data: [search_param_1, search_param_2, search_param_3],
  limit: 2,
  rerank: rerank
});
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/advanced_search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
-d "{
    \"collectionName\": \"my_collection\",
    \"search\": ${req},
    \"rerank\": {
        \"strategy\":\"rrf\",
        \"params\": ${rerank}
    },
    \"limit\": 2
}"
Le résultat est le suivant :
["['id: 1, distance: 0.006047376897186041, entity: {}', 'id: 2, distance: 0.006422005593776703, entity: {}']"]
Avec le paramètre limit=2 spécifié pour la recherche hybride, Milvus classera les six résultats obtenus à partir des trois recherches. En fin de compte, seuls les deux résultats les plus similaires seront renvoyés.
