

Présentation de la fonction d'intégrationCompatible with Milvus 2.6.x
Le module « Function » de Milvus vous permet de transformer des données textuelles brutes en représentations vectorielles en appelant automatiquement des fournisseurs de services d’embedding externes (tels que OpenAI, AWS Bedrock, Google Vertex AI, etc.). Grâce au module « Function », vous n’avez plus besoin d’interagir manuellement avec les API d’embedding : Milvus gère l’intégralité du processus, depuis l’envoi des requêtes aux fournisseurs jusqu’à la réception des embeddings et leur stockage dans vos collections. Pour la recherche sémantique, il vous suffit de fournir les données brutes de la requête, et non un vecteur de requête. Milvus génère le vecteur de requête à l’aide du même modèle que celui utilisé pour l’ingestion, le compare aux vecteurs stockés et renvoie les résultats les plus pertinents.
Contraintes
Tout champ d’entrée que le module Function intègre doit toujours contenir une valeur ; si une valeur nulle est fournie, le module génère une erreur.
Le module Function traite uniquement les champs explicitement définis dans le schéma de la collection ; il ne génère pas d’embeddings pour les champs dynamiques.
Les champs d’entrée à encoder doivent être de type «
VARCHAR».Le module « Function » peut intégrer un champ d’entrée pour :
FLOAT_VECTORINT8_VECTOR
Les conversions vers les types «
BINARY_VECTOR», «FLOAT16_VECTOR» ou «BFLOAT16_VECTOR» ne sont pas prises en charge.
Fournisseurs de services d’intégration pris en charge
Fournisseur |
Modèles types |
Type d'intégration |
Méthode d'authentification |
|---|---|---|---|
text-embedding-3-* |
|
Clé API |
|
Basée sur le déploiement |
|
Clé API |
|
text-embedding-v3 |
|
Clé API |
|
Modèles de vectorisation de texte de Yandex Cloud AI Studio |
|
Clé API |
|
amazon.titan-embed-text-v2 |
|
Paire AK/SK |
|
text-embedding-005 |
|
Compte de service GCP – Identifiants JSON |
|
voyage-3, voyage-lite-02 |
|
Clé API |
|
embed-english-v3.0 |
|
Clé API |
|
BAAI/bge-large-zh-v1.5 |
|
Clé API |
|
Tout modèle pris en charge par TEI |
|
Clé API facultative |
|
Modèles hébergés sur |
|
Clé API |
Fonctionnement
Le diagramme suivant illustre le fonctionnement de la fonction dans Milvus.
Texte d'entrée: les utilisateurs insèrent des données brutes (par exemple, des documents) dans Milvus.
Génération d’embeddings: le module « Function » de Milvus appelle automatiquement le fournisseur de modèles configuré pour convertir les données brutes en embeddings vectoriels.
Stockage des représentations: les représentations obtenues sont stockées dans des champs vectoriels explicitement définis au sein des collections Milvus.
Texte de requête: les utilisateurs soumettent des requêtes textuelles à Milvus.
Recherche sémantique: Milvus convertit en interne les requêtes en représentations vectorielles, effectue des recherches de similarité par rapport aux représentations stockées et récupère les résultats pertinents.
Retour des résultats: Milvus renvoie les résultats les plus pertinents à l’application.
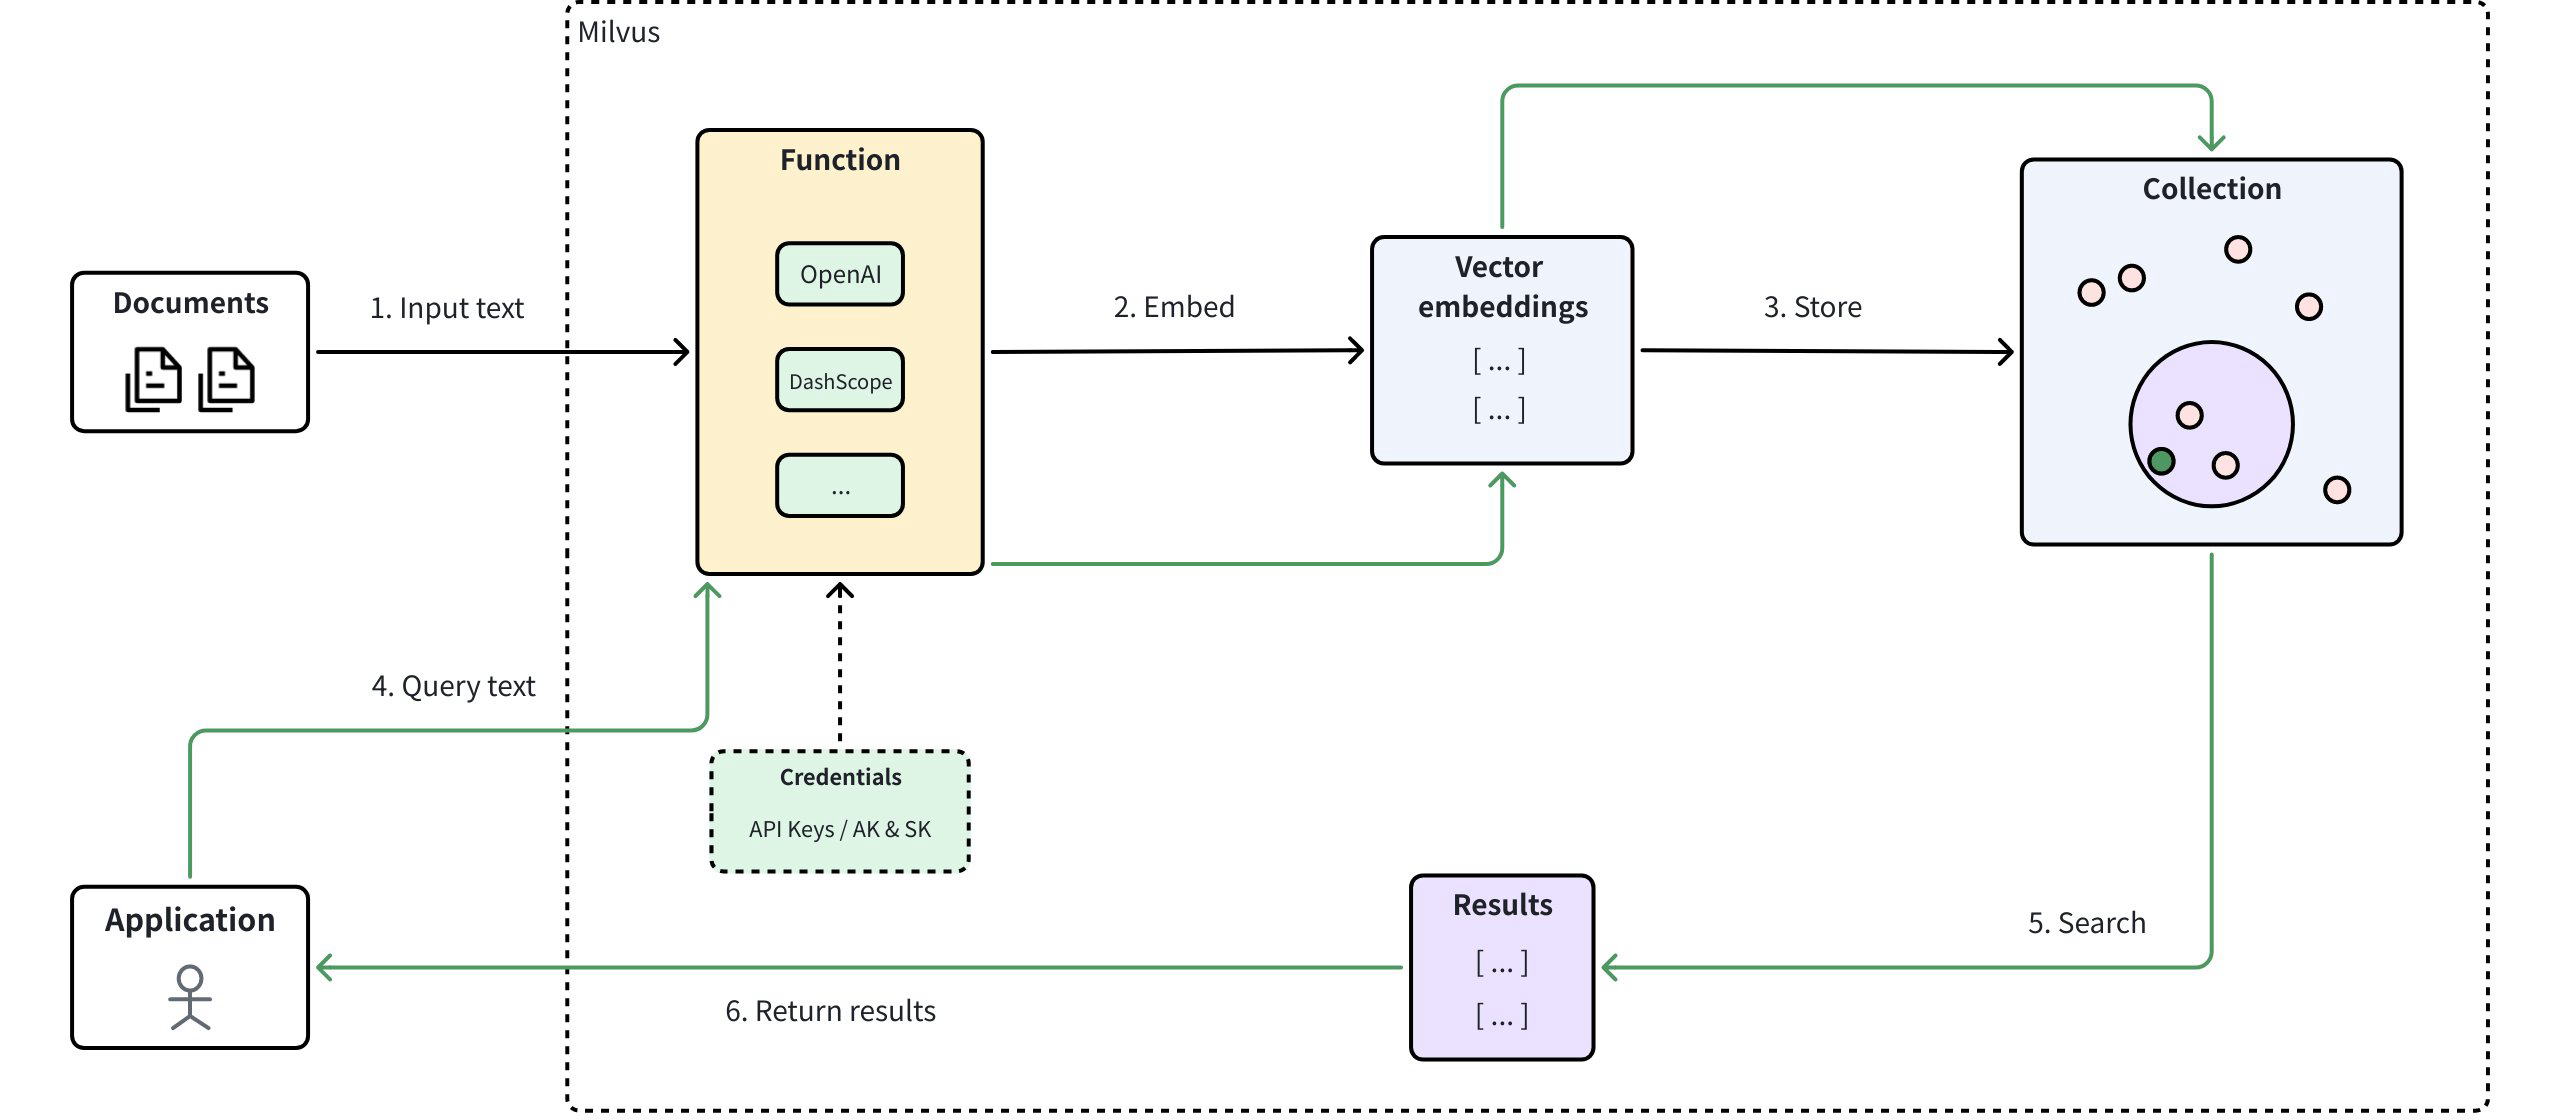 Présentation de la fonction d’embedding
Configurer les identifiants
Avant d'utiliser une fonction d'encodage avec Milvus, configurez les identifiants du service d'encodage pour permettre l'accès à Milvus.
Milvus vous permet de fournir les identifiants du service de représentation de deux manières :
Fichier de configuration (
milvus.yaml) :L'exemple présenté dans cette rubrique illustre la configuration recommandée à l'aide du fichier
milvus.yaml.Variables d’environnement:
Pour plus de détails sur la configuration des identifiants via des variables d’environnement, consultez la documentation du fournisseur de service d’intégration (par exemple, OpenAI ou Azure OpenAI).
Le schéma suivant illustre le processus de configuration des identifiants via le fichier de configuration Milvus (milvus.yaml), puis l'appel de la fonction au sein de Milvus.
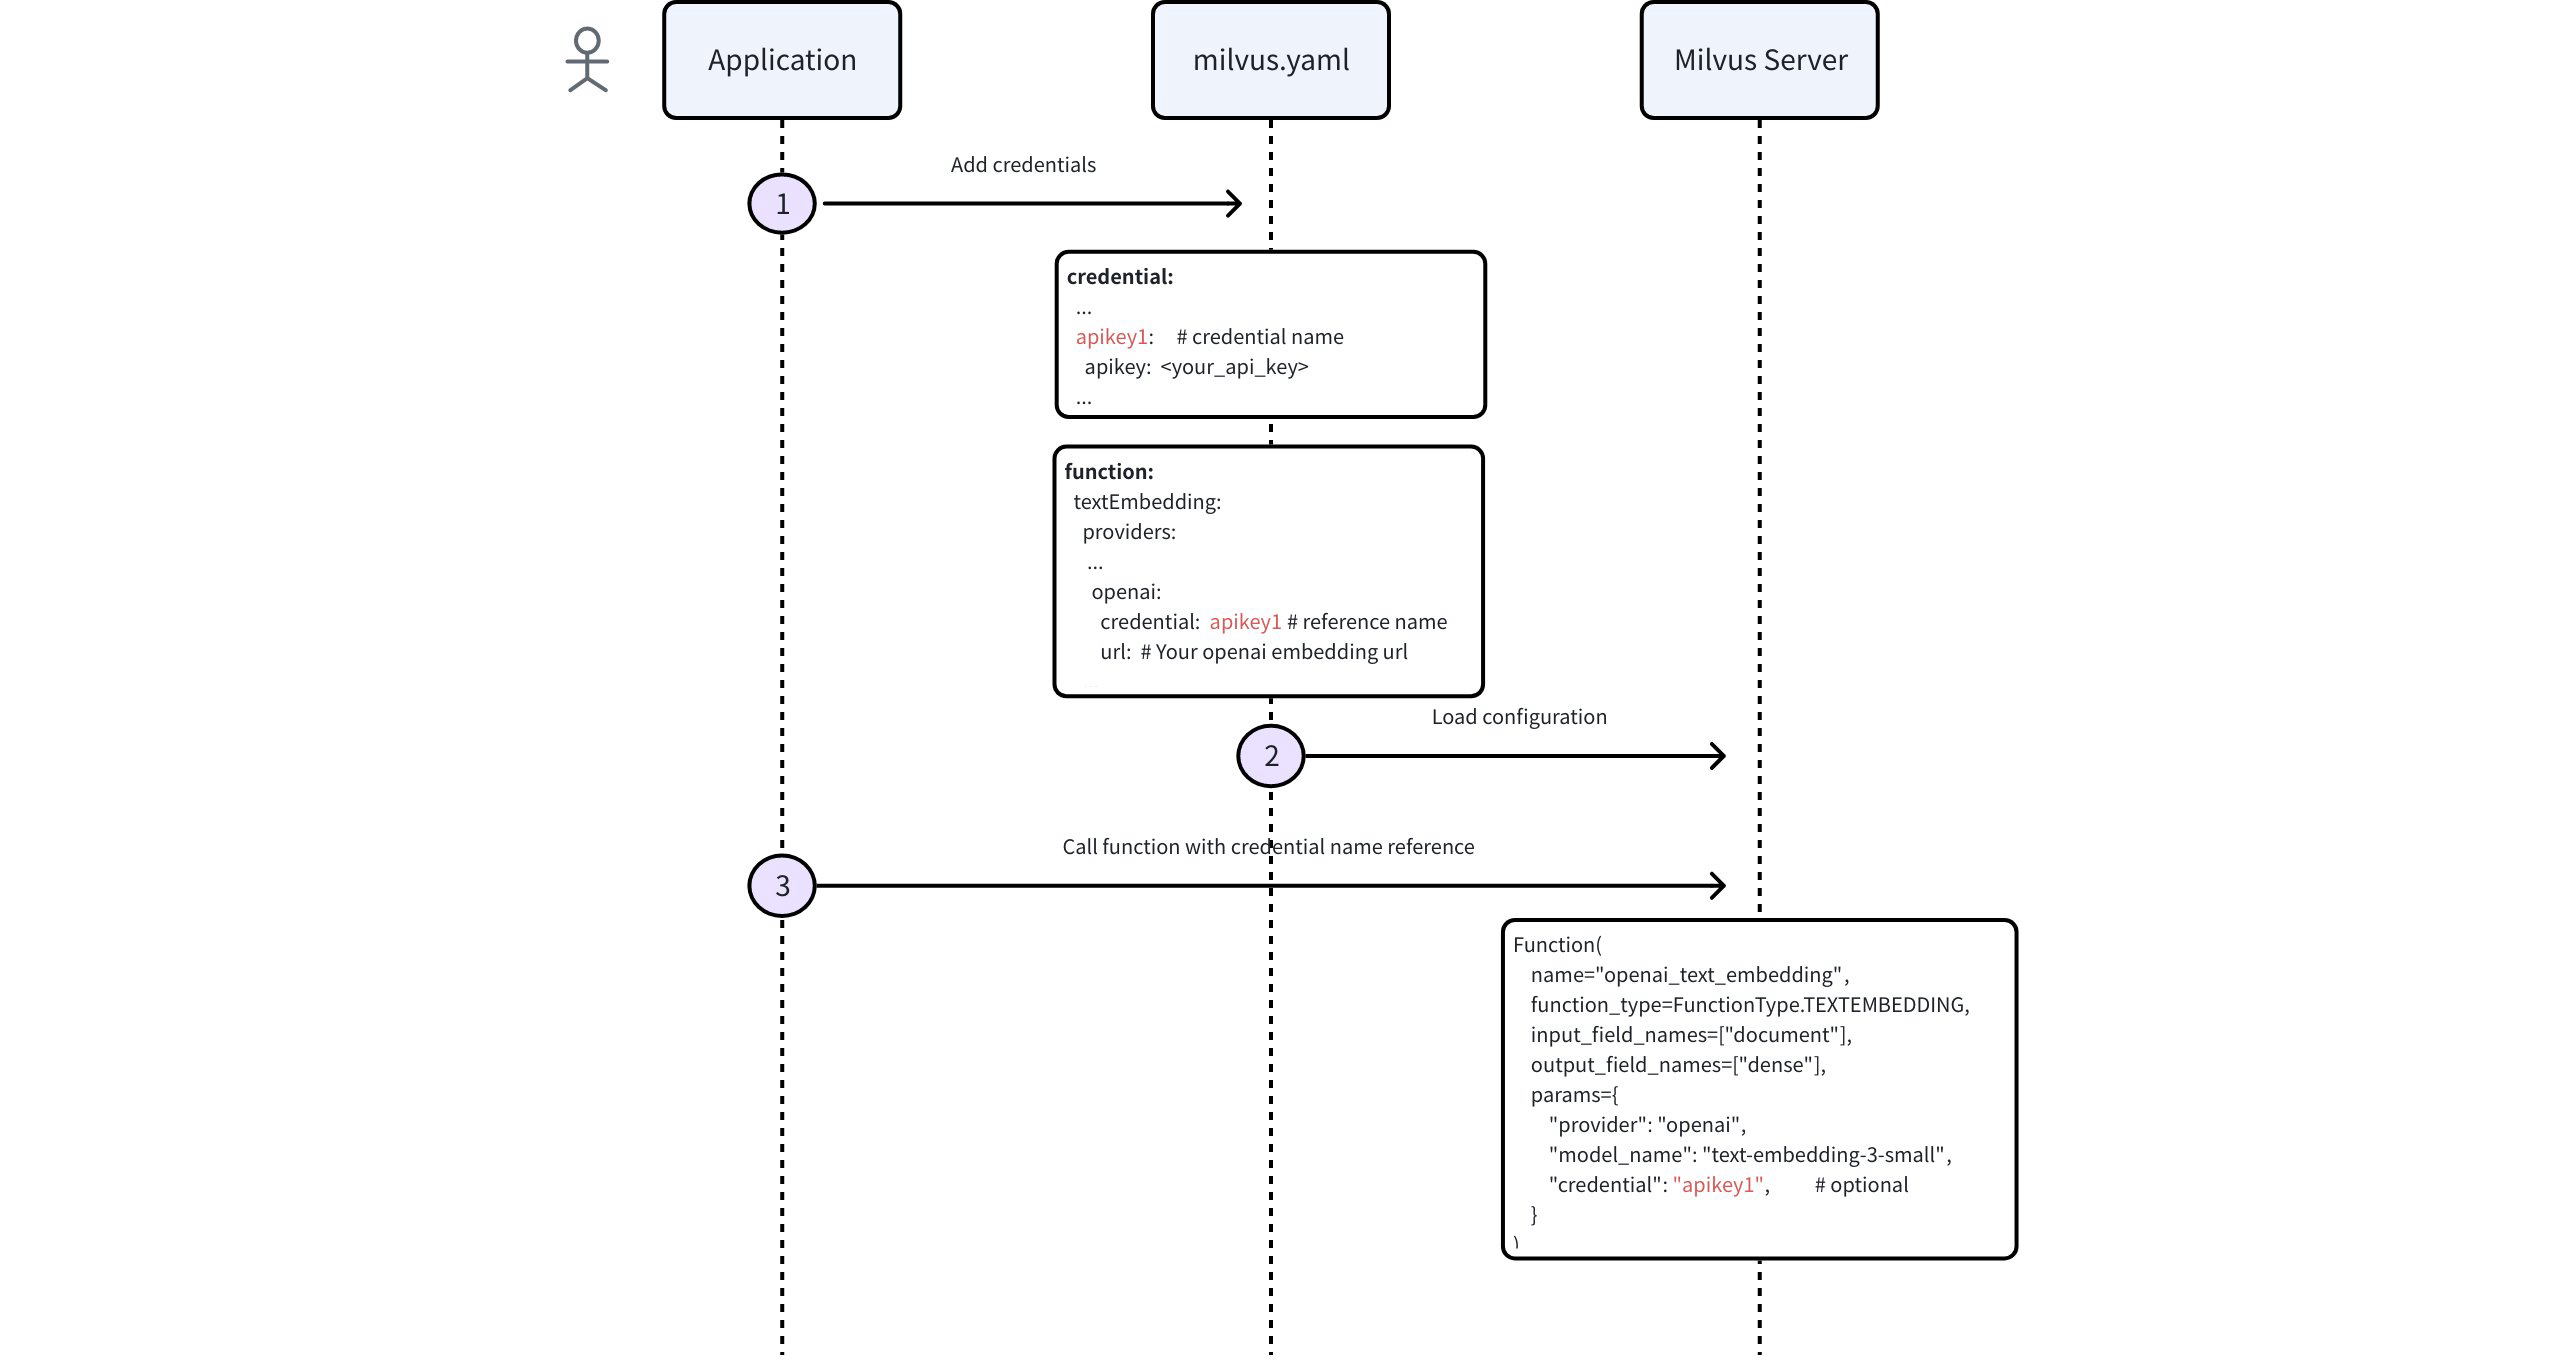 Configuration des identifiants dans Overflow
Étape 1 : Ajouter les informations d’authentification au fichier de configuration de Milvus
Dans votre fichier milvus.yaml, modifiez le bloc credential en y ajoutant les entrées correspondant à chaque fournisseur auquel vous devez accéder :
# milvus.yaml credential store section
# This section defines all your authentication credentials for external embedding providers
# Each credential gets a unique name (e.g., aksk1, apikey1) that you'll reference elsewhere
credential:
  # For AWS Bedrock or services using access/secret key pairs
  # 'aksk1' is just an example name - you can choose any meaningful identifier
  aksk1:
    access_key_id: <YOUR_AK>
    secret_access_key: <YOUR_SK>

  # For OpenAI, Voyage AI, or other API key-based services
  # 'apikey1' is a custom name you choose to identify this credential
  apikey1:
    apikey: <YOUR_API_KEY>

  # For Google Vertex AI using service account credentials
  # 'gcp1' is an example name for your Google Cloud credentials
  gcp1:
    credential_json: <BASE64_OF_JSON>
Étape 2 : Configurer les paramètres du fournisseur
Dans le même fichier de configuration (milvus.yaml), modifiez le bloc function pour indiquer à Milvus quelle clé utiliser pour l’intégration des appels de service :
function:
  textEmbedding:
    providers:
      openai:                         # calls OpenAI
        credential: apikey1           # Reference to the credential label
        # url:                        # (optional) custom url

      bedrock:                        # calls AWS Bedrock
        credential: aksk1             # Reference to the credential label
        region: us-east-2

      vertexai:                       # calls Google Vertex AI
        credential: gcp1              # Reference to the credential label
        # url:                        # (optional) custom url

      tei:                            # Built-in Tiny Embedding model
        enable: true                  # Whether to enable TEI model service
Pour plus d’informations sur la manière d’appliquer la configuration de Milvus, consultez la section « Configurer Milvus à la volée ».
Utiliser la fonction d’intégration
Une fois les identifiants configurés dans votre fichier de configuration Milvus, suivez ces étapes pour définir et utiliser les fonctions d’intégration.
Étape 1 : Définir les champs du schéma
Pour utiliser une fonction d’intégration, créez une collection avec un schéma spécifique. Ce schéma doit inclure au moins trois champs obligatoires :
Le champ principal qui identifie de manière unique chaque entité d’une collection.
Un champ scalaire qui stocke les données brutes à intégrer.
Un champ vectoriel réservé au stockage des représentations vectorielles que la fonction générera pour le champ scalaire.
L'exemple suivant définit un schéma comportant un champ scalaire "document" destiné à stocker des données textuelles et un champ vectoriel "dense" destiné à stocker les représentations qui seront générées par le module Function. N'oubliez pas de définir la dimension vectorielle (dim) afin qu'elle corresponde à la sortie du modèle de représentation que vous avez choisi.
from pymilvus import MilvusClient, DataType, Function, FunctionType

# Initialize Milvus client
client = MilvusClient(
    uri="http://localhost:19530",
)

# Create a new schema for the collection
schema = client.create_schema()

# Add primary field "id"
schema.add_field("id", DataType.INT64, is_primary=True, auto_id=False)

# Add scalar field "document" for storing textual data
schema.add_field("document", DataType.VARCHAR, max_length=9000)

# Add vector field "dense" for storing embeddings.
# IMPORTANT: Set dim to match the exact output dimension of the embedding model.
# For instance, OpenAI's text-embedding-3-small model outputs 1536-dimensional vectors.
# For dense vector, data type can be FLOAT_VECTOR or INT8_VECTOR
schema.add_field("dense", DataType.FLOAT_VECTOR, dim=1536)
// java
// nodejs
// go
# restful
Étape 2 : Ajouter la fonction d’embedding au schéma
Le module « Function » de Milvus convertit automatiquement les données brutes stockées dans un champ scalaire en représentations et les stocke dans le champ vectoriel explicitement défini.
L'exemple ci-dessous ajoute un module « Function » (openai_embedding) qui convertit le champ scalaire « "document" » en représentations, en stockant les vecteurs résultants dans le champ vectoriel « "dense" » défini précédemment.
# Define embedding function (example: OpenAI provider)
text_embedding_function = Function(
    name="openai_embedding",                  # Unique identifier for this embedding function
    function_type=FunctionType.TEXTEMBEDDING, # Type of embedding function
    input_field_names=["document"],           # Scalar field to embed
    output_field_names=["dense"],             # Vector field to store embeddings
    params={                                  # Provider-specific configuration (highest priority)
        "provider": "openai",                 # Embedding model provider
        "model_name": "text-embedding-3-small",     # Embedding model
        # "credential": "apikey1",            # Optional: Credential label
        # Optional parameters:
        # "dim": "1536",       # Optionally shorten the vector dimension
        # "user": "user123"    # Optional: identifier for API tracking
    }
)

# Add the embedding function to your schema
schema.add_function(text_embedding_function)
// java
// nodejs
// go
# restful
Paramètre |
Description |
Exemple de valeur |
|---|---|---|
|
Identifiant unique de la fonction d’embedding au sein de Milvus. |
|
|
Type de fonction utilisé. Pour l'embedding de texte, définissez la valeur sur Remarque: Milvus accepte les valeurs « |
|
|
Champ scalaire contenant les données brutes à vectoriser. Actuellement, ce paramètre n’accepte qu’un seul nom de champ. |
|
|
Champ vectoriel destiné au stockage des représentations générées. Actuellement, ce paramètre n’accepte qu’un seul nom de champ. |
|
|
Dictionnaire contenant les configurations d’encodage. Remarque : les paramètres de « |
|
|
Le fournisseur de modèle d’intégration. |
|
|
Spécifie le modèle d’intégration à utiliser. |
|
|
L'étiquette d'un identifiant défini dans la section de niveau supérieur «
|
|
|
Nombre de dimensions des représentations de sortie. Pour les modèles de troisième génération d’OpenAI, vous pouvez raccourcir le vecteur complet afin de réduire les coûts et la latence sans perte significative d’informations sémantiques. Pour plus d’informations, consultez l’article de blog d’OpenAI annonçant cette fonctionnalité. Remarque : si vous réduisez la dimension du vecteur, assurez-vous que la valeur « |
|
|
Identifiant au niveau de l’utilisateur permettant de suivre l’utilisation de l’API. |
|
Pour les collections comportant plusieurs champs scalaires nécessitant une conversion texte-vecteur, ajoutez des fonctions distinctes au schéma de la collection, en veillant à ce que chaque fonction possède un nom et une valeur « output_field_names » uniques.
Étape 3 : Configurer l’index
Après avoir défini le schéma avec les champs nécessaires et la fonction intégrée, configurez l’index de votre collection. Pour simplifier ce processus, utilisez l’option « AUTOINDEX » comme index_type, ce qui permet à Milvus de choisir et de configurer le type d’index le plus adapté en fonction de la structure de vos données.
# Prepare index parameters
index_params = client.prepare_index_params()

# Add AUTOINDEX to automatically select optimal indexing method
index_params.add_index(
    field_name="dense",
    index_type="AUTOINDEX",
    metric_type="COSINE"
)
// java
// nodejs
// go
# restful
Étape 4 : Créer une collection
Créez maintenant la collection à l’aide du schéma et des paramètres d’index définis.
# Create collection named "demo"
client.create_collection(
    collection_name='demo',
    schema=schema,
    index_params=index_params
)
// java
// nodejs
// go
# restful
Étape 5 : Insérer les données
Une fois votre collection et votre index configurés, vous êtes prêt à insérer vos données brutes. Au cours de ce processus, il vous suffit de fournir le texte brut. Le module Function que nous avons défini précédemment génère automatiquement le vecteur clairsemé correspondant à chaque entrée de texte.
# Insert sample documents
client.insert('demo', [
    {'id': 1, 'document': 'Milvus simplifies semantic search through embeddings.'},
    {'id': 2, 'document': 'Vector embeddings convert text into searchable numeric data.'},
    {'id': 3, 'document': 'Semantic search helps users find relevant information quickly.'},
])
// java
// nodejs
// go
# restful
Étape 6 : Effectuer une recherche vectorielle
Une fois les données insérées, effectuez une recherche sémantique à l’aide du texte brut de votre requête. Milvus convertit automatiquement votre requête en vecteur d’encodage, récupère les documents pertinents en fonction de leur similarité et renvoie les résultats les plus pertinents.
# Perform semantic search
results = client.search(
    collection_name='demo',
    data=['How does Milvus handle semantic search?'], # Use text query rather than query vector
    anns_field='dense',   # Use the vector field that stores embeddings
    limit=1,
    output_fields=['document'],
)

print(results)

# Example output:
# data: ["[{'id': 1, 'distance': 0.8821347951889038, 'entity': {'document': 'Milvus simplifies semantic search through embeddings.'}}]"]
// java
// nodejs
// go
# restful
Pour plus d’informations sur les opérations de recherche et de requête, consultez la section « Recherche vectorielle et requêtes de base ».
FAQ
Quelle est la différence entre la configuration des identifiants dans le fichier milvus.yaml et celle via des variables d’environnement ?
Les deux méthodes fonctionnent, mais l’utilisation d’ milvus.yaml est l’approche recommandée, car elle permet une gestion centralisée des identifiants et une nomenclature cohérente pour tous les fournisseurs. Lorsque vous utilisez des variables d’environnement, les noms de variables varient en fonction du fournisseur de service d’encodage ; consultez donc la page dédiée à chaque fournisseur pour connaître les noms de variables d’environnement spécifiques requis (par exemple, OpenAI ou Azure OpenAI).
Que se passe-t-il si je ne spécifie pas de paramètre d’identifiants dans la définition de la fonction ?
Milvus suit l’ordre de résolution des identifiants suivant :
- Tout d’abord, il recherche les identifiants par défaut configurés pour ce fournisseur dans le fichier `
milvus.yaml` - Si aucune information d’authentification par défaut n’existe dans milvus.yaml, il se rabat sur les variables d’environnement (si elles sont configurées)
- Si ni les identifiants du fichier `
milvus.yaml` ni les variables d’environnement ne sont configurés, Milvus génère une erreur
Comment puis-je vérifier que les représentations sont générées correctement ?
Vous pouvez vérifier cela en :
- Interroger votre collection après l’insertion pour voir si le champ vectoriel contient des données
- Vérifier que la longueur du champ vectoriel correspond aux dimensions attendues
- Effectuant une simple recherche de similarité pour vérifier que les représentations produisent des résultats pertinents
Lorsque j'effectue une recherche par similarité, puis-je utiliser un vecteur de requête plutôt que du texte brut ?
Oui, vous pouvez utiliser des vecteurs de requête précalculés à la place du texte brut pour la recherche par similarité. Bien que le module de fonction convertisse automatiquement les requêtes en texte brut en représentations vectorielles, vous pouvez également fournir directement des données vectorielles au paramètre « data » de votre opération de recherche. Remarque: la taille des dimensions de votre vecteur de requête fourni doit correspondre à celle des vecteurs d’embeddings générés par votre module de fonction.
Exemple:
# Using raw text (Function module converts automatically)
results = client.search(
    collection_name='demo',
    data=['How does Milvus handle semantic search?'],
    anns_field='dense',
    limit=1
)

# Using pre-computed query vector (must match stored vector dimensions)
query_vector = [0.1, 0.2, 0.3, ...]  # Must be same dimension as stored embeddings
results = client.search(
    collection_name='demo',
    data=[query_vector],
    anns_field='dense',
    limit=1
)
// java
// nodejs
// go
# restful
