

Was ist Milvus?
Milvus ist ein Raubvogel aus der Gattung Milvus der Familie der Habichtartigen (Accipitridae), der für seine Fluggeschwindigkeit, sein scharfes Sehvermögen und seine bemerkenswerte Anpassungsfähigkeit bekannt ist.
Zilliz wählt den Namen Milvus für seine leistungsstarke, hochskalierbare Open-Source-Vektordatenbank, die in einer Vielzahl von Umgebungen – vom Laptop bis hin zu groß angelegten verteilten Systemen – effizient läuft. Sie ist sowohl als Open-Source-Software als auch als Cloud-Dienst verfügbar.
Milvus wurde von Zilliz entwickelt und wird in Kürze an die LF AI & Data Foundation unter dem Dach der Linux Foundation gespendet. Damit hat sich Milvus zu einem der weltweit führenden Open-Source-Projekte für Vektordatenbanken entwickelt. Es wird unter der Apache-2.0-Lizenz vertrieben, und die meisten Mitwirkenden sind Experten aus der High-Performance-Computing-Community (HPC), die sich auf den Aufbau groß angelegter Systeme und die Optimierung hardwareorientierten Codes spezialisiert haben. Zu den wichtigsten Mitwirkenden zählen Fachleute von Zilliz, ARM, NVIDIA, AMD, Intel, Meta, IBM, Salesforce, Alibaba und Microsoft.
Interessanterweise ist jedes Open-Source-Projekt von Zilliz nach einem Vogel benannt – eine Namenskonvention, die Freiheit, Weitsicht und die agile Weiterentwicklung der Technologie symbolisiert.
Unstrukturierte Daten, Einbettungen und Milvus
Unstrukturierte Daten wie Text, Bilder und Audio variieren im Format und enthalten eine reichhaltige zugrunde liegende Semantik, was ihre Analyse zu einer Herausforderung macht. Um diese Komplexität zu bewältigen, werden Einbettungen verwendet, um unstrukturierte Daten in numerische Vektoren umzuwandeln, die ihre wesentlichen Merkmale erfassen. Diese Vektoren werden dann in einer Vektordatenbank gespeichert, was schnelle und skalierbare Such- und Analysevorgänge ermöglicht.
Milvus bietet robuste Funktionen zur Datenmodellierung, mit denen Sie Ihre unstrukturierten oder multimodalen Daten in strukturierte Sammlungen organisieren können. Es unterstützt eine breite Palette von Datentypen für unterschiedliche Attributmodellierungen, darunter gängige numerische und Zeichen-Typen, verschiedene Vektortypen, Arrays, Mengen und JSON, wodurch Ihnen der Aufwand für die Pflege mehrerer Datenbanksysteme erspart bleibt.
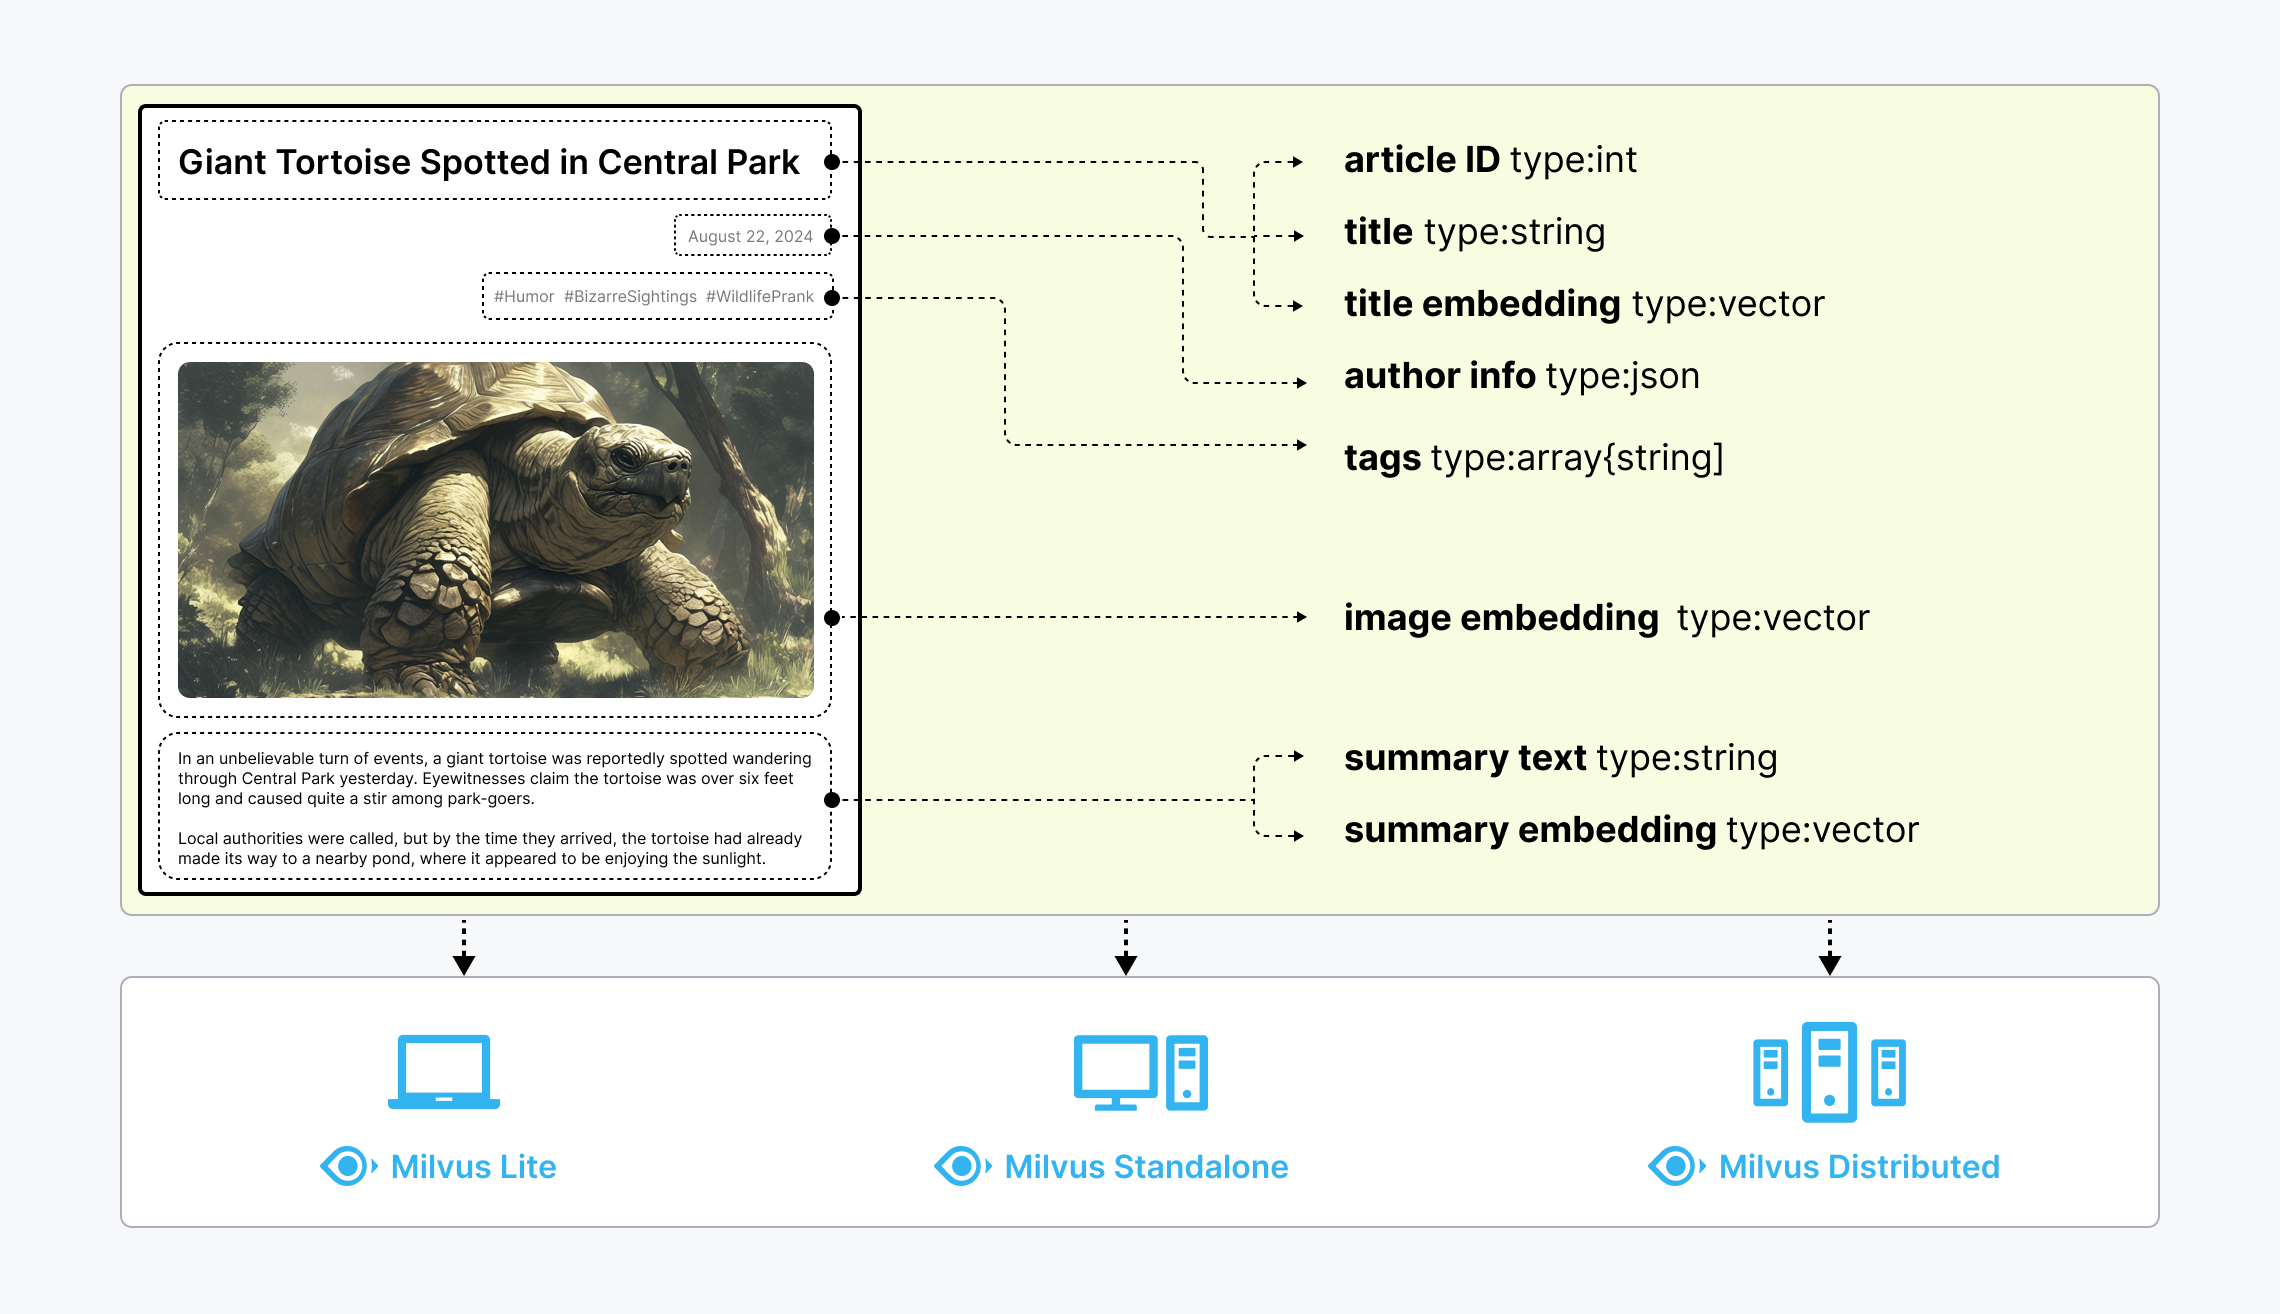 Unstrukturierte Daten, Einbettungen und Milvus
Milvus bietet drei Bereitstellungsmodi, die ein breites Spektrum an Datenumfängen abdecken – vom lokalen Prototyping in Jupyter-Notebooks bis hin zu riesigen Kubernetes-Clustern, die Dutzende Milliarden von Vektoren verwalten:
- Milvus Lite ist eine Python-Bibliothek, die sich problemlos in Ihre Anwendungen integrieren lässt. Als leichtgewichtige Version von Milvus eignet sie sich ideal für schnelles Prototyping in Jupyter-Notebooks oder für den Einsatz auf Edge-Geräten mit begrenzten Ressourcen. Erfahren Sie mehr.
- Milvus Standalone ist eine Serverbereitstellung auf einem einzelnen Rechner, bei der alle Komponenten in einem einzigen Docker-Image gebündelt sind, um die Bereitstellung zu vereinfachen. Erfahren Sie mehr.
- Milvus Distributed lässt sich auf Kubernetes-Clustern bereitstellen und verfügt über eine cloudnative Architektur, die für Szenarien im Milliardenbereich oder sogar darüber hinaus ausgelegt ist. Diese Architektur gewährleistet Redundanz bei kritischen Komponenten. Erfahren Sie mehr.
Was macht Milvus so schnell?
Milvus wurde von Anfang an als hocheffizientes Vektordatenbanksystem konzipiert. In den meisten Fällen übertrifft Milvus andere Vektordatenbanken um das 2- bis 5-Fache (siehe die Ergebnisse des VectorDBBench). Diese hohe Leistung ist das Ergebnis mehrerer wichtiger Designentscheidungen:
Hardware-orientierte Optimierung: Um Milvus in verschiedenen Hardwareumgebungen einsetzen zu können, haben wir seine Leistung speziell für zahlreiche Hardwarearchitekturen und Plattformen optimiert, darunter AVX512, SIMD, GPUs und NVMe-SSDs.
Fortschrittliche Suchalgorithmen: Milvus unterstützt eine breite Palette von In-Memory- und On-Disk-Indizierungs- und Suchalgorithmen, darunter IVF, HNSW, DiskANN und weitere, die alle umfassend optimiert wurden. Im Vergleich zu gängigen Implementierungen wie FAISS und HNSWLib liefert Milvus eine um 30–70 % bessere Leistung.
Suchmaschine in C++: Über 80 % der Leistung einer Vektordatenbank werden von ihrer Suchmaschine bestimmt. Milvus nutzt für diese entscheidende Komponente C++ aufgrund der hohen Leistung der Sprache, der Low-Level-Optimierung und der effizienten Ressourcenverwaltung. Vor allem integriert Milvus zahlreiche hardwareorientierte Code-Optimierungen, die von Vektorisierung auf Assembler-Ebene bis hin zu Multithread-Parallelisierung und -Scheduling reichen, um die Hardware-Fähigkeiten voll auszuschöpfen.
Spaltenorientiert: Milvus ist ein spaltenorientiertes Vektordatenbanksystem. Die Hauptvorteile ergeben sich aus den Datenzugriffsmustern. Bei der Ausführung von Abfragen liest eine spaltenorientierte Datenbank nur die spezifischen Felder, die an der Abfrage beteiligt sind, anstatt ganze Zeilen, was die Menge der abgerufenen Daten erheblich reduziert. Darüber hinaus lassen sich Operationen auf spaltenbasierten Daten leicht vektorisieren, sodass Operationen auf ganze Spalten auf einmal angewendet werden können, was die Leistung weiter steigert.
Was Milvus so skalierbar macht
Im Jahr 2022 unterstützte Milvus Vektoren im Milliardenbereich, und im Jahr 2023 skalierte es bei konstanter Stabilität auf mehrere zehn Milliarden, wodurch groß angelegte Szenarien für über 300 große Unternehmen ermöglicht wurden, darunter Salesforce, PayPal, Shopee, Airbnb, eBay, NVIDIA, IBM, AT&T, LINE, ROBLOX, Inflection usw.
Die cloudnative und stark entkoppelte Systemarchitektur von Milvus stellt sicher, dass das System mit dem Datenwachstum kontinuierlich erweitert werden kann:
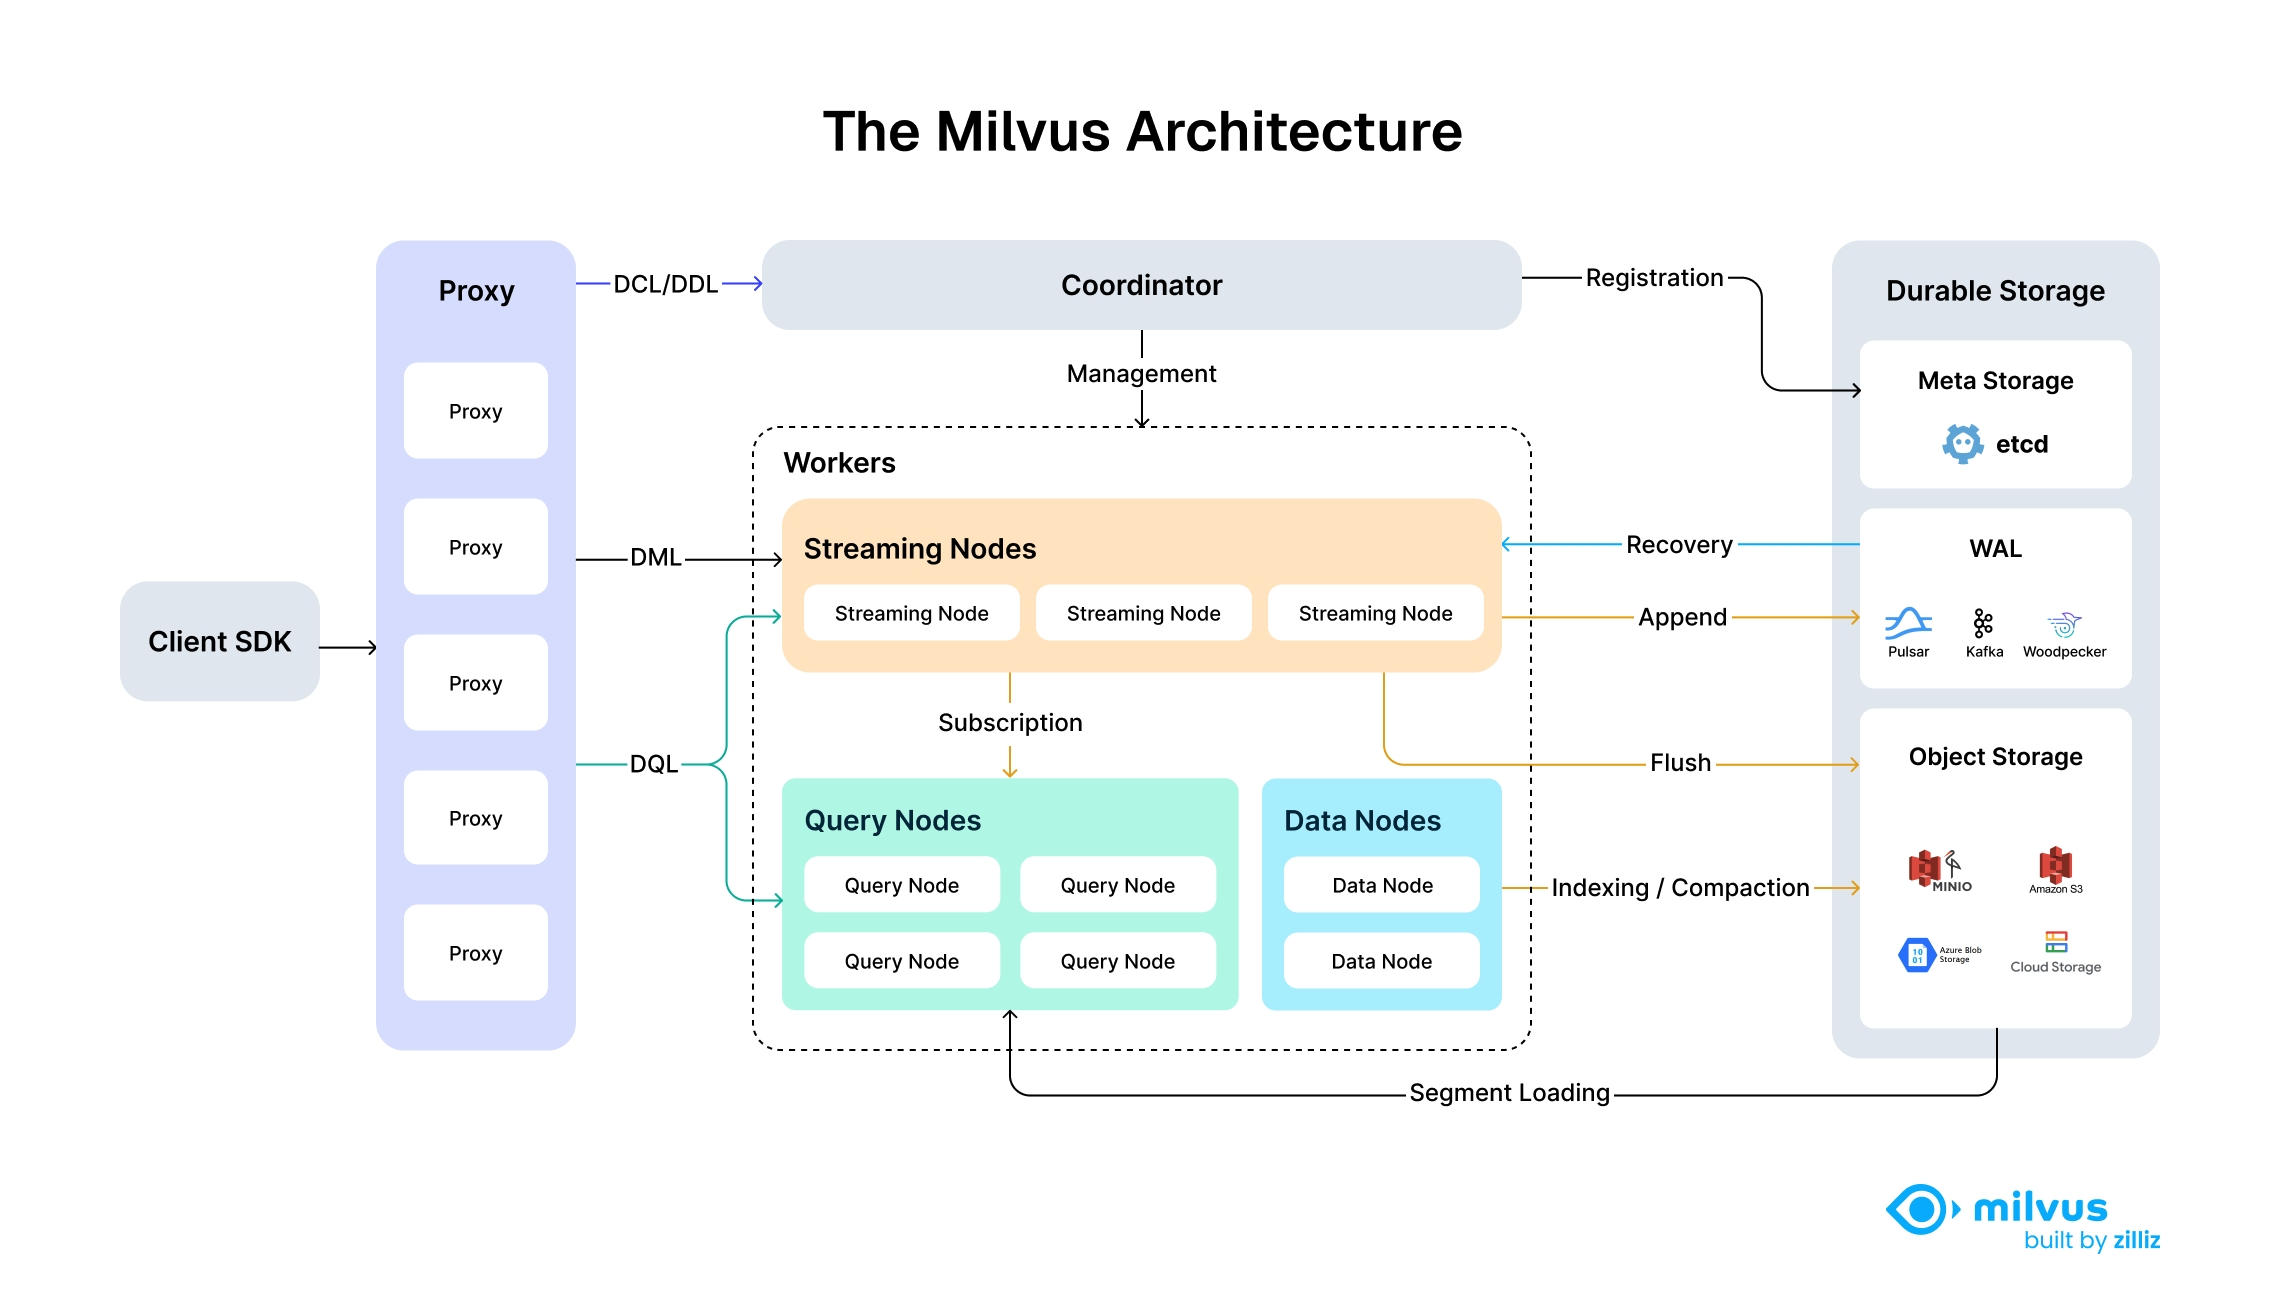 Stark entkoppelte Systemarchitektur von Milvus
Milvus selbst ist vollständig zustandslos und lässt sich daher mithilfe von Kubernetes oder öffentlichen Clouds problemlos skalieren. Darüber hinaus sind die Milvus-Komponenten gut entkoppelt: Die drei wichtigsten Aufgaben – Suche, Dateneinfügung sowie Indizierung/Kompaktierung – sind als leicht parallelisierbare Prozesse konzipiert, wobei komplexe Logik ausgegliedert wurde. Dies gewährleistet, dass die entsprechenden Abfrage-, Daten- und Indexknoten sowohl vertikal als auch horizontal unabhängig voneinander skaliert werden können, wodurch Leistung und Kosteneffizienz optimiert werden.
Von Milvus unterstützte Sucharten
Milvus unterstützt verschiedene Suchfunktionen, um den Anforderungen unterschiedlicher Anwendungsfälle gerecht zu werden:
- ANN-Suche: Findet die K Vektoren, die Ihrem Suchvektor am nächsten liegen.
- Filter-Suche: Führt eine ANN-Suche unter festgelegten Filterbedingungen durch.
- Bereichssuche: Findet Vektoren innerhalb eines festgelegten Radius um Ihren Suchvektor.
- Hybridsuche: Führt eine ANN-Suche auf der Grundlage mehrerer Vektorfelder durch.
- Volltextsuche: Volltextsuche auf Basis von BM25.
- Neurangierung: Passt die Reihenfolge der Suchergebnisse anhand zusätzlicher Kriterien oder eines sekundären Algorithmus an und verfeinert so die ursprünglichen ANN-Suchergebnisse.
- Abruf: Ruft Daten anhand ihrer Primärschlüssel ab.
- Abfrage: Ruft Daten anhand spezifischer Ausdrücke ab.
Umfassender Funktionsumfang
Zusätzlich zu den oben genannten zentralen Suchfunktionen bietet Milvus eine Reihe von Funktionen rund um die ANN-Suche, damit Sie deren Möglichkeiten voll ausschöpfen können.
API und SDK
- RESTful-API (offiziell)
- PyMilvus (Python-SDK) (offiziell)
- Go-SDK (offiziell)
- Java-SDK (offiziell)
- Node.js (JavaScript) SDK (offiziell)
- C# (von Microsoft bereitgestellt)
- C++ SDK (offiziell)
- Rust SDK (in Entwicklung)
Erweiterte Datentypen
Neben den primitiven Datentypen unterstützt Milvus verschiedene erweiterte Datentypen und die jeweils anwendbaren Abstandsmetriken.
- Sparse-Vektoren
- Binäre Vektoren
- JSON-Unterstützung
- Array-Unterstützung
- Geolokalisierung
- Text (in Entwicklung)
Warum Milvus?
Hohe Leistung bei Skalierbarkeit und hoher Verfügbarkeit
Milvus verfügt über eine verteilte Architektur, die Rechenleistung und Speicher voneinander trennt. Milvus lässt sich horizontal skalieren und an unterschiedliche Zugriffsmuster anpassen. So wird optimale Leistung erzielt, indem bei leseintensiven Workloads die Anzahl der Abfrageknoten und bei schreibintensiven Workloads die Anzahl der Datenknoten unabhängig voneinander erhöht wird. Die zustandslosen Microservices auf K8s ermöglichen eine schnelle Wiederherstellung nach Ausfällen und gewährleisten so eine hohe Verfügbarkeit. Die Unterstützung von Replikaten verbessert die Fehlertoleranz und den Durchsatz zusätzlich, indem Datensegmente auf mehrere Abfrageknoten verteilt werden. Siehe Benchmark für einen Leistungsvergleich.
Unterstützung verschiedener Vektorindex-Typen und Hardwarebeschleunigung
Milvus trennt das System von der zentralen Vektorsuchmaschine und unterstützt so alle wichtigen Vektorindextypen, die für unterschiedliche Szenarien optimiert sind, darunter HNSW, IVF, FLAT (Brute-Force), SCANN und DiskANN, einschließlich quantisierungsbasierter Varianten und mmap. Milvus optimiert die Vektorsuche für erweiterte Funktionen wie Metadatenfilterung und Bereichssuche. Darüber hinaus implementiert Milvus Hardwarebeschleunigung zur Steigerung der Vektorsuchleistung und unterstützt GPU-Indizierung, wie beispielsweise NVIDIA CAGRA.
Flexible Mandantenfähigkeit und Hot/Cold-Speicher
Milvus unterstützt Multi-Tenancy durch Isolation auf Datenbank-, Collection-, Partitions- oder Partitionsschlüsselebene. Die flexiblen Strategien ermöglichen es einem einzelnen Cluster, Hunderte bis Millionen von Mandanten zu verwalten, und gewährleisten zudem eine optimierte Suchleistung sowie eine flexible Zugriffskontrolle. Milvus steigert die Kosteneffizienz durch Hot-/Cold-Speicher. Häufig abgerufene „Hot“-Daten können zur Leistungssteigerung im Arbeitsspeicher oder auf SSDs gespeichert werden, während seltener abgerufene „Cold“-Daten auf langsameren, kostengünstigen Speichermedien aufbewahrt werden. Dieser Mechanismus kann die Kosten erheblich senken und gleichzeitig eine hohe Leistung für kritische Aufgaben gewährleisten.
Sparse-Vektoren für Volltextsuche und hybride Suche
Neben der semantischen Suche mittels „Dense Vector“ unterstützt Milvus nativ auch die Volltextsuche mit BM25 sowie trainierte „Sparse Embeddings“ wie SPLADE und BGE-M3. Benutzer können „Sparse Vectors“ und „Dense Vectors“ in derselben Sammlung speichern und Funktionen definieren, um die Ergebnisse aus mehreren Suchanfragen neu zu ordnen. Siehe Beispiele für die hybride Suche mit semantischer Suche + Volltextsuche.
Datensicherheit und fein abgestufte Zugriffskontrolle
Milvus gewährleistet Datensicherheit durch die Implementierung einer obligatorischen Benutzerauthentifizierung, TLS-Verschlüsselung und rollenbasierter Zugriffskontrolle (RBAC). Die Benutzerauthentifizierung stellt sicher, dass nur autorisierte Benutzer mit gültigen Anmeldedaten auf die Datenbank zugreifen können, während die TLS-Verschlüsselung die gesamte Kommunikation innerhalb des Netzwerks schützt. Darüber hinaus ermöglicht RBAC eine fein abgestufte Zugriffskontrolle, indem Benutzern je nach ihrer Rolle spezifische Berechtigungen zugewiesen werden. Diese Funktionen machen Milvus zu einer robusten und sicheren Wahl für Unternehmensanwendungen und schützen sensible Daten vor unbefugtem Zugriff und potenziellen Sicherheitsverletzungen.
KI-Integrationen
Integration von Einbettungsmodellen Einbettungsmodelle wandeln unstrukturierte Daten in ihre numerische Darstellung in einem hochdimensionalen Datenraum um, sodass Sie diese in Milvus speichern können. Derzeit integriert PyMilvus, das Python-SDK, mehrere Einbettungsmodelle, mit denen Sie Ihre Daten schnell in Vektoreinbettungen aufbereiten können. Weitere Informationen finden Sie unter „Übersicht über Einbettungsmodelle“.
Integration von Reranking-Modellen Im Bereich der Informationsgewinnung und der generativen KI ist ein Reranker ein unverzichtbares Werkzeug, das die Reihenfolge der Ergebnisse aus ersten Suchläufen optimiert. PyMilvus integriert ebenfalls mehrere Reranking-Modelle, um die Reihenfolge der aus ersten Suchläufen zurückgegebenen Ergebnisse zu optimieren. Weitere Informationen finden Sie unter „Übersicht über Reranker“.
Integration von LangChain und anderen KI-Tools Im Zeitalter der generativen KI (GenAI) finden Tools wie LangChain große Beachtung bei Anwendungsentwicklern. Als Kernkomponente dient Milvus in solchen Tools in der Regel als Vektorspeicher. Informationen zur Integration von Milvus in Ihre bevorzugten KI-Tools finden Sie unter „Integrationen und Tutorials“.
Tools und Ökosystem
Attu Attu ist eine intuitive All-in-One-GUI, die Ihnen bei der Verwaltung von Milvus und den darin gespeicherten Daten hilft. Weitere Informationen finden Sie im Attu-Repository.
Birdwatcher Birdwatcher ist ein Debugging-Tool für Milvus. Wenn Sie damit eine Verbindung zu etcd herstellen, können Sie den Status Ihres Milvus-Systems überprüfen oder es im laufenden Betrieb konfigurieren. Weitere Informationen finden Sie unter BirdWatcher.
Prometheus- und Grafana-Integrationen Prometheus ist ein Open-Source-Toolkit zur Systemüberwachung und Alarmierung für Kubernetes. Grafana ist ein Open-Source-Visualisierungsstack, der sich mit allen Datenquellen verbinden lässt. Sie können Prometheus und Grafana als Überwachungsdienstleister nutzen, um die Leistung des verteilten Milvus-Systems visuell zu überwachen. Weitere Informationen finden Sie unter „Bereitstellung von Überwachungsdiensten“.
Milvus Backup Milvus Backup ist ein Tool, mit dem Benutzer Milvus-Daten sichern und wiederherstellen können. Es bietet sowohl eine CLI als auch eine API, um sich an verschiedene Anwendungsszenarien anzupassen. Weitere Informationen finden Sie unter „Milvus Backup“.
Milvus Capture Data Change (CDC) Milvus CDC kann Datenänderungen von einem Milvus-Cluster in einen anderen replizieren und ermöglicht so eine Disaster Recovery im Primär-Standby-Modus. Weitere Informationen finden Sie unter „Milvus CDC“.
Milvus-Konnektoren Milvus bietet eine Reihe von Konnektoren, mit denen Sie Milvus nahtlos in Tools von Drittanbietern wie Apache Spark integrieren können. Derzeit können Sie unseren Spark-Konnektor nutzen, um Ihre Milvus-Daten zur Verarbeitung im Rahmen des maschinellen Lernens an Apache Spark zu übermitteln. Weitere Informationen finden Sie unter „Spark-Milvus-Konnektor“.
Vector Transmission Services (VTS) Milvus bietet eine Reihe von Tools, mit denen Sie Ihre Daten zwischen einer Milvus-Instanz und verschiedenen Datenquellen übertragen können, darunter Zilliz-Cluster, Elasticsearch, Postgres (PgVector) und eine andere Milvus-Instanz. Weitere Informationen finden Sie unter VTS.
