

Gruppierte Suche
Eine Gruppensuche ermöglicht es Milvus, die Suchergebnisse nach den Werten in einem bestimmten Feld zu gruppieren, um Daten auf einer höheren Ebene zusammenzufassen. Beispielsweise können Sie eine einfache ANN-Suche verwenden, um Bücher zu finden, die dem vorliegenden ähnlich sind, aber Sie können eine Gruppierungssuche nutzen, um die Buchkategorien zu finden, die möglicherweise die in diesem Buch behandelten Themen umfassen. In diesem Abschnitt wird beschrieben, wie Sie die Gruppierungssuche verwenden, sowie wichtige Überlegungen dazu dargelegt.
Übersicht
Wenn Entitäten in den Suchergebnissen denselben Wert in einem skalaren Feld aufweisen, deutet dies darauf hin, dass sie in einem bestimmten Attribut ähnlich sind, was sich negativ auf die Suchergebnisse auswirken kann.
Angenommen, eine Sammlung enthält mehrere Dokumente (bezeichnet als „docId“). Um bei der Umwandlung von Dokumenten in Vektoren so viele semantische Informationen wie möglich zu erhalten, wird jedes Dokument in kleinere, überschaubare Absätze (oder „Chunks“) aufgeteilt und als separate Entitäten gespeichert. Auch wenn das Dokument in kleinere Abschnitte unterteilt ist, sind Nutzer oft dennoch daran interessiert, herauszufinden, welche Dokumente für ihre Bedürfnisse am relevantesten sind.
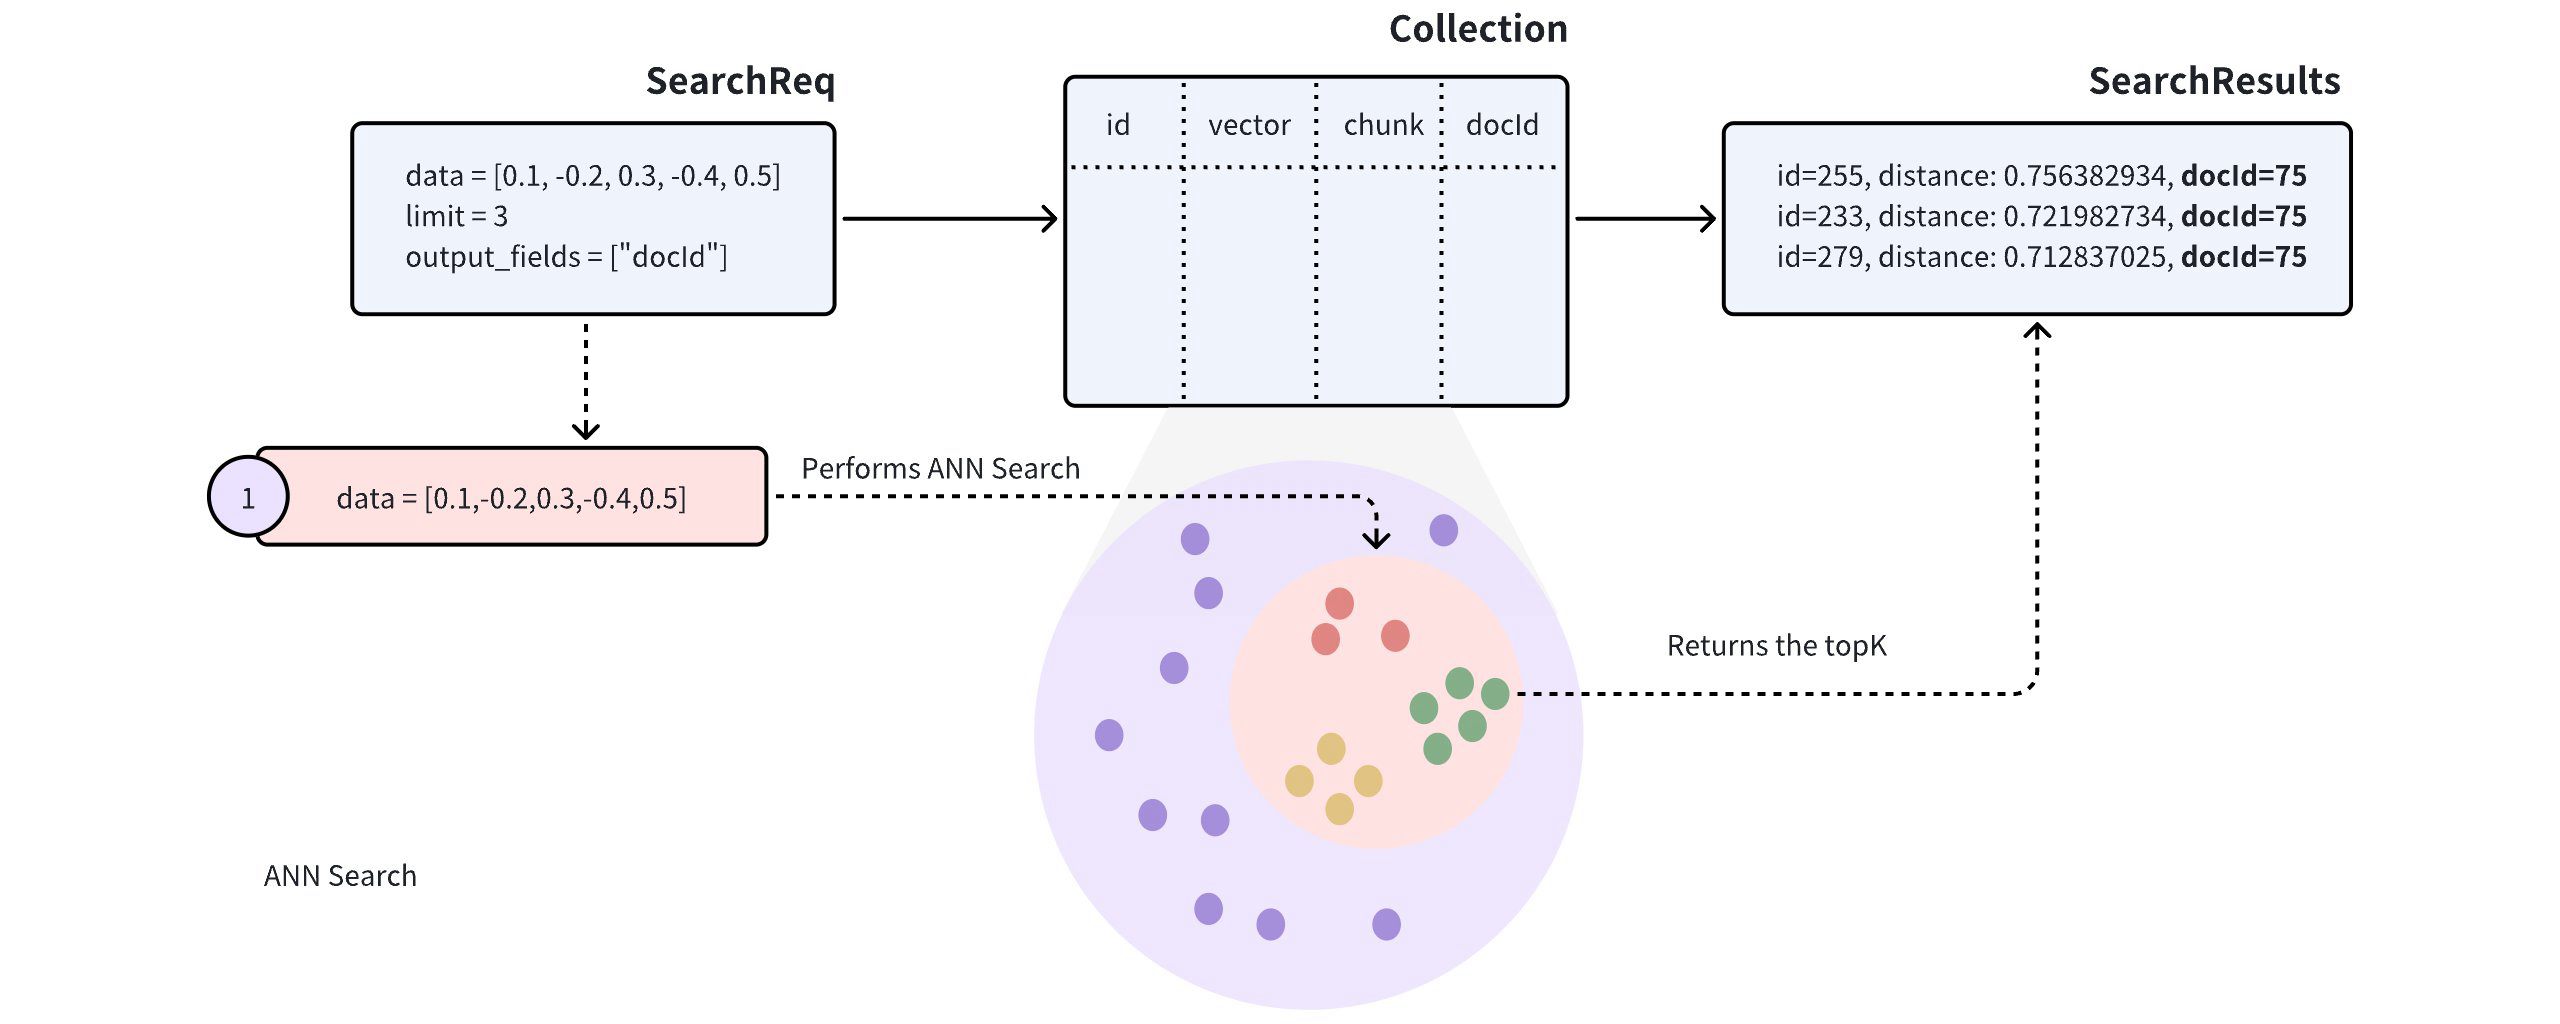 Ann-Suche
Bei der Durchführung einer „Approximate Nearest Neighbor“ (ANN)-Suche in einer solchen Sammlung können die Suchergebnisse mehrere Absätze aus demselben Dokument enthalten, was dazu führen kann, dass andere Dokumente übersehen werden, was möglicherweise nicht dem beabsichtigten Anwendungsfall entspricht.
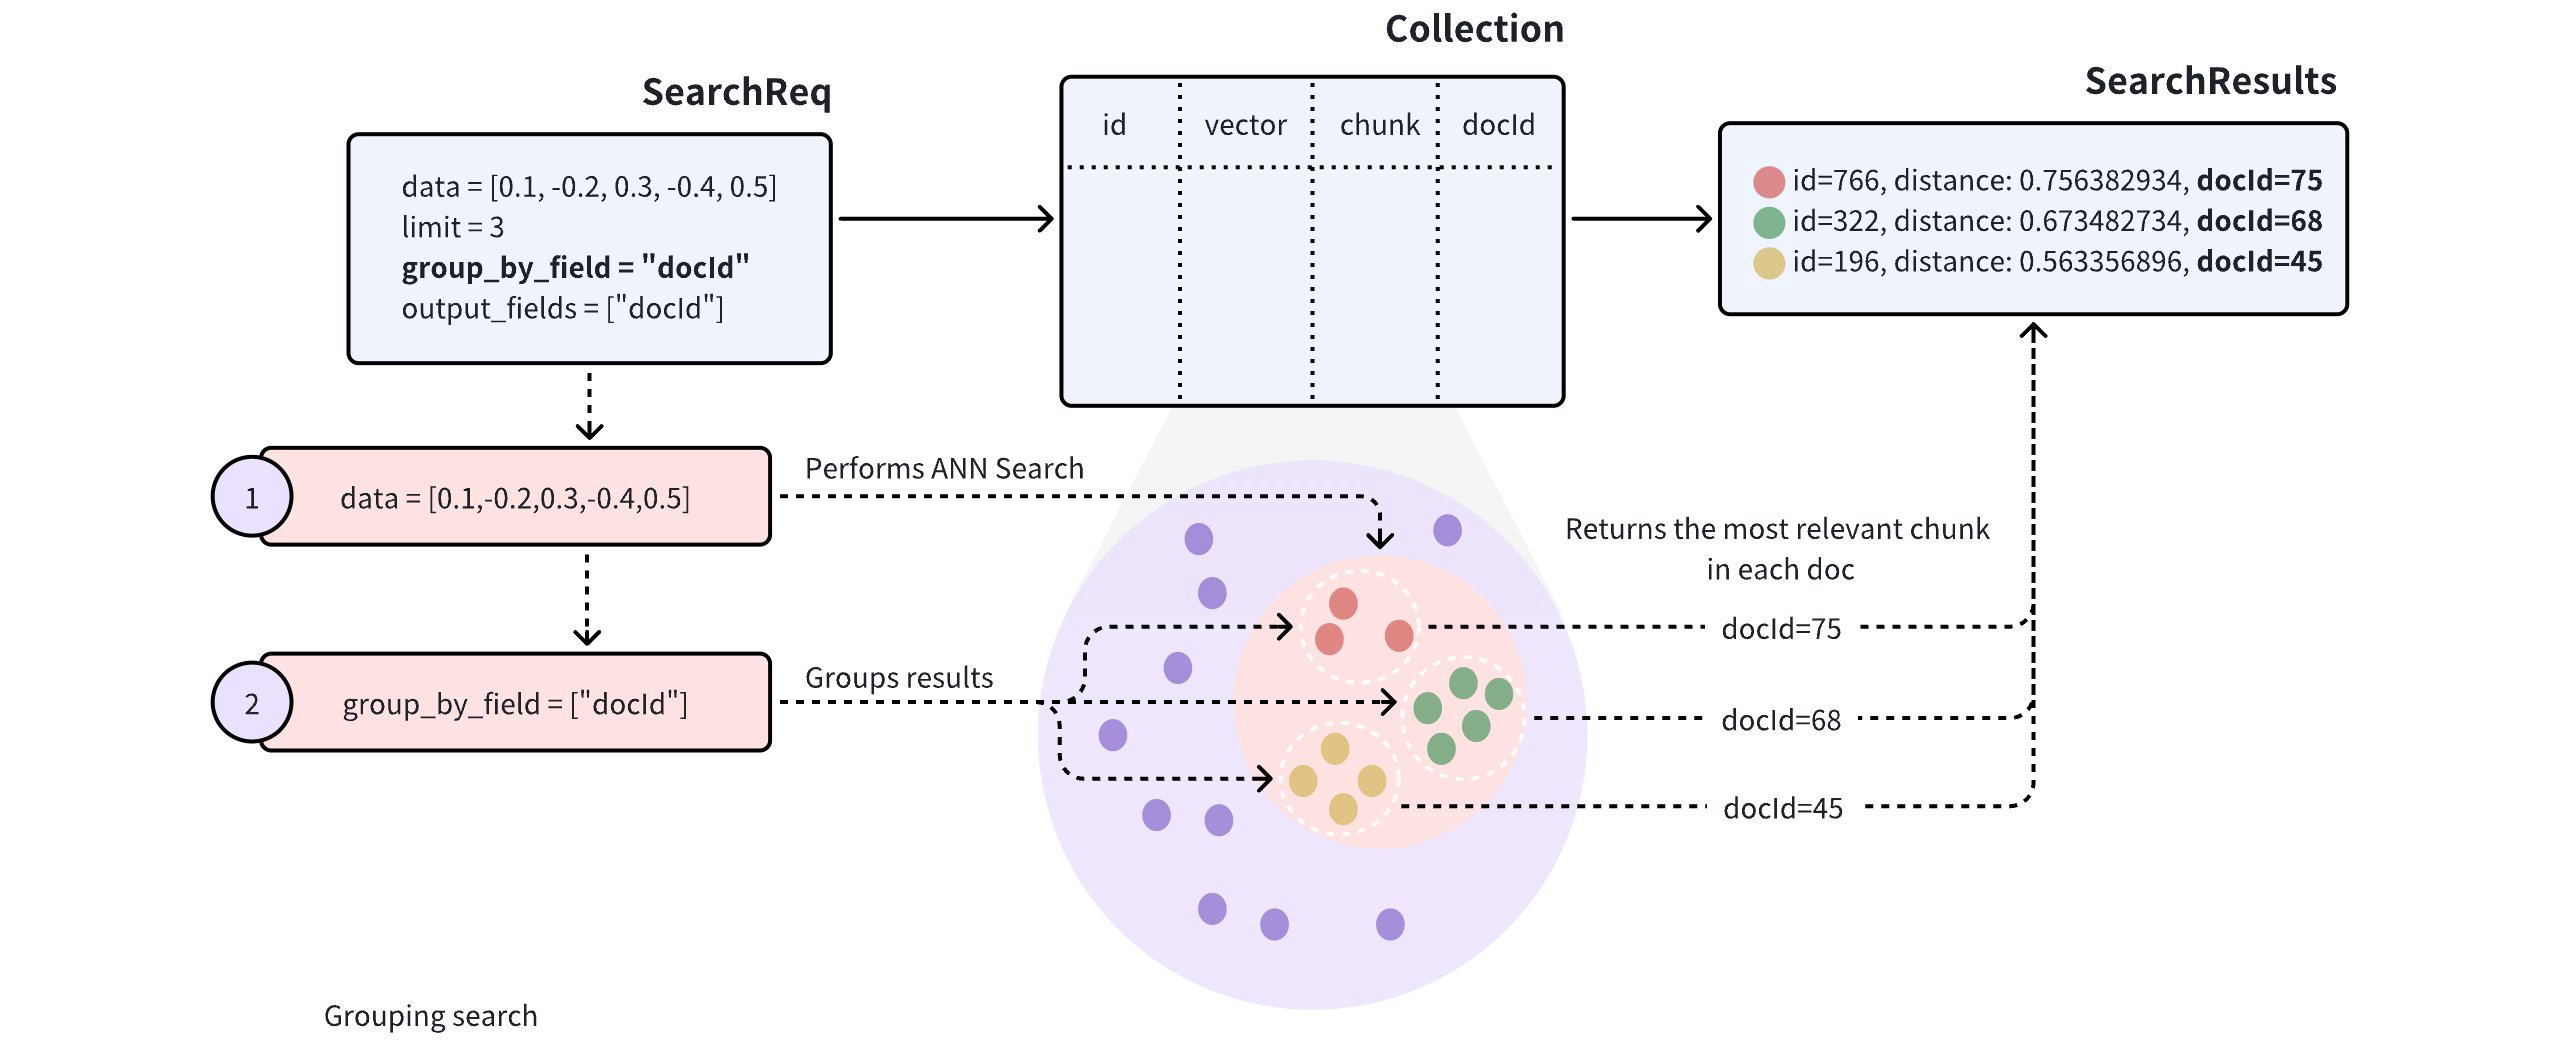 Gruppierte Suche
Um die Vielfalt der Suchergebnisse zu verbessern, können Sie den Parameter „ group_by_field “ in die Suchanfrage einfügen, um die gruppierte Suche zu aktivieren. Wie in der Abbildung dargestellt, können Sie „ group_by_field “ auf „ docId “ setzen. Nach Erhalt dieser Anfrage führt Milvus folgende Schritte durch:
Eine ANN-Suche auf der Grundlage des bereitgestellten Abfragevektors durchführen, um alle Entitäten zu finden, die der Abfrage am ähnlichsten sind.
Die Suchergebnisse nach dem angegebenen Parameter „
group_by_field“ gruppieren, z. B. „docId“.Die besten Ergebnisse für jede Gruppe zurückgeben, wie durch den Parameter „
limit“ definiert, wobei die ähnlichste Entität aus jeder Gruppe ausgewählt wird.
Standardmäßig gibt die Gruppierungssuche nur eine Entität pro Gruppe zurück. Wenn Sie die Anzahl der pro Gruppe zurückzugebenden Ergebnisse erhöhen möchten, können Sie dies über die Parameter „ group_size “ und „ strict_group_size “ steuern.
Gruppierte Suche durchführen
Dieser Abschnitt enthält Beispielcode zur Veranschaulichung der Verwendung der Gruppierungssuche. Das folgende Beispiel geht davon aus, dass die Sammlung Felder für „ id “, „ vector “, „ chunk “ und „ docId “ enthält.
[
        {"id": 0, "vector": [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592], "chunk": "pink_8682", "docId": 1},
        {"id": 1, "vector": [0.19886812562848388, 0.06023560599112088, 0.6976963061752597, 0.2614474506242501, 0.838729485096104], "chunk": "red_7025", "docId": 5},
        {"id": 2, "vector": [0.43742130801983836, -0.5597502546264526, 0.6457887650909682, 0.7894058910881185, 0.20785793220625592], "chunk": "orange_6781", "docId": 2},
        {"id": 3, "vector": [0.3172005263489739, 0.9719044792798428, -0.36981146090600725, -0.4860894583077995, 0.95791889146345], "chunk": "pink_9298", "docId": 3},
        {"id": 4, "vector": [0.4452349528804562, -0.8757026943054742, 0.8220779437047674, 0.46406290649483184, 0.30337481143159106], "chunk": "red_4794", "docId": 3},
        {"id": 5, "vector": [0.985825131989184, -0.8144651566660419, 0.6299267002202009, 0.1206906911183383, -0.1446277761879955], "chunk": "yellow_4222", "docId": 4},
        {"id": 6, "vector": [0.8371977790571115, -0.015764369584852833, -0.31062937026679327, -0.562666951622192, -0.8984947637863987], "chunk": "red_9392", "docId": 1},
        {"id": 7, "vector": [-0.33445148015177995, -0.2567135004164067, 0.8987539745369246, 0.9402995886420709, 0.5378064918413052], "chunk": "grey_8510", "docId": 2},
        {"id": 8, "vector": [0.39524717779832685, 0.4000257286739164, -0.5890507376891594, -0.8650502298996872, -0.6140360785406336], "chunk": "white_9381", "docId": 5},
        {"id": 9, "vector": [0.5718280481994695, 0.24070317428066512, -0.3737913482606834, -0.06726932177492717, -0.6980531615588608], "chunk": "purple_4976", "docId": 3},
]
Setzen Sie in der Suchanfrage sowohl „ group_by_field “ als auch „ output_fields “ auf „ docId “. Milvus gruppiert die Ergebnisse nach dem angegebenen Feld und gibt die ähnlichste Entität aus jeder Gruppe zurück, einschließlich des Werts von „ docId “ für jede zurückgegebene Entität.
from pymilvus import MilvusClient

client = MilvusClient(
    uri="http://localhost:19530",
    token="root:Milvus"
)

query_vectors = [
    [0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088]]

# Group search results
res = client.search(
    collection_name="my_collection",
    data=query_vectors,
    limit=3,
    group_by_field="docId",
    output_fields=["docId"]
)

# Retrieve the values in the `docId` column
doc_ids = [result['entity']['docId'] for result in res[0]]
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.vector.request.SearchReq
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.response.SearchResp

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .token("root:Milvus")
        .build());

FloatVec queryVector = new FloatVec(new float[]{0.14529211512077012f, 0.9147257273453546f, 0.7965055218724449f, 0.7009258593102812f, 0.5605206522382088f});
SearchReq searchReq = SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryVector))
        .topK(3)
        .groupByFieldName("docId")
        .outputFields(Collections.singletonList("docId"))
        .build();

SearchResp searchResp = client.search(searchReq);

List<List<SearchResp.SearchResult>> searchResults = searchResp.getSearchResults();
for (List<SearchResp.SearchResult> results : searchResults) {
    System.out.println("TopK results:");
    for (SearchResp.SearchResult result : results) {
        System.out.println(result);
    }
}

// Output
// TopK results:
// SearchResp.SearchResult(entity={docId=5}, score=0.74767184, id=1)
// SearchResp.SearchResult(entity={docId=2}, score=0.6254269, id=7)
// SearchResp.SearchResult(entity={docId=3}, score=0.3611898, id=3)
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

queryVector := []float32{0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592}

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    3,               // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("vector").
    WithGroupByField("docId").
    WithOutputFields("docId"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("docId: ", resultSet.GetColumn("docId").FieldData().GetScalars())
}
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const address = "http://localhost:19530";
const token = "root:Milvus";
const client = new MilvusClient({address, token});

var query_vector = [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]

res = await client.search({
    collection_name: "my_collection",
    data: [query_vector],
    limit: 3,
    group_by_field: "docId"
})

// Retrieve the values in the `docId` column
var docIds = res.results.map(result => result.entity.docId)
export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": [
        [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]
    ],
    "annsField": "vector",
    "limit": 3,
    "groupingField": "docId",
    "outputFields": ["docId"]
}'
#include "milvus/MilvusClientV2.h"
#include <iostream>
#include <stdexcept>
#include <vector>

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"http://localhost:19530", "root:Milvus"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    throw std::runtime_error(status.Message());
}

std::vector<float> query_vector = {0.3580376395471989f, -0.6023495712049978f, 0.18414012509913835f, -0.26286205330961354f, 0.9029438446296592f};
auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .AddFloatVector(query_vector)
                   .WithLimit(3)
                   .WithAnnsField("vector")
                   .WithGroupByField("docId")
                   .AddOutputField("docId");

milvus::SearchResponse response;
status = client->Search(request, response);
if (!status.IsOk()) {
    throw std::runtime_error(status.Message());
}

for (auto& result : response.Results().Results()) {
    std::cout << "TopK results:" << std::endl;
    milvus::EntityRows output_rows;
    status = result.OutputRows(output_rows);
    if (!status.IsOk()) {
        throw std::runtime_error(status.Message());
    }
    for (const auto& row : output_rows) {
        std::cout << "\t" << row << std::endl;
    }
}
In der obigen Anfrage gibt „ limit=3 “ an, dass das System Suchergebnisse aus drei Gruppen zurückgibt, wobei jede Gruppe die Entität enthält, die dem Abfragevektor am ähnlichsten ist.
Gruppengröße konfigurieren
Standardmäßig gibt die Gruppierungssuche nur eine Entität pro Gruppe zurück. Wenn Sie mehrere Ergebnisse pro Gruppe wünschen, passen Sie die Parameter ` group_size ` und ` strict_group_size ` an.
# Group search results

res = client.search(
    collection_name="my_collection",
    data=query_vectors, # query vector
    limit=5, # number of groups to return
    group_by_field="docId", # grouping field
    group_size=2, # p to 2 entities to return from each group
    strict_group_size=True, # return exact 2 entities from each group
    output_fields=["docId"]
)
FloatVec queryVector = new FloatVec(new float[]{0.14529211512077012f, 0.9147257273453546f, 0.7965055218724449f, 0.7009258593102812f, 0.5605206522382088f});
SearchReq searchReq = SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryVector))
        .topK(5)
        .groupByFieldName("docId")
        .groupSize(2)
        .strictGroupSize(true)
        .outputFields(Collections.singletonList("docId"))
        .build();

SearchResp searchResp = client.search(searchReq);

List<List<SearchResp.SearchResult>> searchResults = searchResp.getSearchResults();
for (List<SearchResp.SearchResult> results : searchResults) {
    System.out.println("TopK results:");
    for (SearchResp.SearchResult result : results) {
        System.out.println(result);
    }
}

// Output
// TopK results:
// SearchResp.SearchResult(entity={docId=5}, score=0.74767184, id=1)
// SearchResp.SearchResult(entity={docId=5}, score=-0.49148706, id=8)
// SearchResp.SearchResult(entity={docId=2}, score=0.6254269, id=7)
// SearchResp.SearchResult(entity={docId=2}, score=0.38515577, id=2)
// SearchResp.SearchResult(entity={docId=3}, score=0.3611898, id=3)
// SearchResp.SearchResult(entity={docId=3}, score=0.19556211, id=4)
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

queryVector := []float32{0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592}

resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    5,               // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("vector").
    WithGroupByField("docId").
    WithStrictGroupSize(true).
    WithGroupSize(2).
    WithOutputFields("docId"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("docId: ", resultSet.GetColumn("docId").FieldData().GetScalars())
}
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const address = "http://localhost:19530";
const token = "root:Milvus";
const client = new MilvusClient({address, token});

var query_vector = [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]

res = await client.search({
    collection_name: "my_collection",
    data: [query_vector],
    limit: 5,
    group_by_field: "docId",
    group_size: 2,
    strict_group_size: true
})

// Retrieve the values in the `docId` column
var docIds = res.results.map(result => result.entity.docId)
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": [
        [0.3580376395471989, -0.6023495712049978, 0.18414012509913835, -0.26286205330961354, 0.9029438446296592]
    ],
    "annsField": "vector",
    "limit": 5,
    "groupingField": "docId",
    "groupSize":2,
    "strictGroupSize":true,
    "outputFields": ["docId"]
}'
#include "milvus/MilvusClientV2.h"
#include <iostream>
#include <stdexcept>
#include <vector>

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"http://localhost:19530", "root:Milvus"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    throw std::runtime_error(status.Message());
}

std::vector<float> query_vector = {0.3580376395471989f, -0.6023495712049978f, 0.18414012509913835f, -0.26286205330961354f, 0.9029438446296592f};
auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .AddFloatVector(query_vector)
                   .WithLimit(5)
                   .WithAnnsField("vector")
                   .WithGroupByField("docId")
                   .WithGroupSize(2)
                   .WithStrictGroupSize(true)
                   .AddOutputField("docId");

milvus::SearchResponse response;
status = client->Search(request, response);
if (!status.IsOk()) {
    throw std::runtime_error(status.Message());
}

for (auto& result : response.Results().Results()) {
    std::cout << "TopK results:" << std::endl;
    milvus::EntityRows output_rows;
    status = result.OutputRows(output_rows);
    if (!status.IsOk()) {
        throw std::runtime_error(status.Message());
    }
    for (const auto& row : output_rows) {
        std::cout << "\t" << row << std::endl;
    }
}
Im obigen Beispiel:
group_size: Legt die gewünschte Anzahl von Entitäten fest, die pro Gruppe zurückgegeben werden sollen. Wenn Sie beispielsweise „group_size=2“ festlegen, bedeutet dies, dass jede Gruppe (bzw. jeder „docId“) idealerweise zwei der ähnlichsten Absätze (bzw. Chunks) zurückgeben sollte. Wenn „group_size“ nicht festgelegt ist, gibt das System standardmäßig ein Ergebnis pro Gruppe zurück.strict_group_size: Dieser boolesche Parameter steuert, ob das System die durchgroup_sizefestgelegte Anzahl strikt einhalten soll. Beistrict_group_size=Trueversucht das System, in jeder Gruppe genau die durchgroup_sizeangegebene Anzahl von Entitäten (z. B. zwei Absätze) einzubeziehen, es sei denn, es sind in dieser Gruppe nicht genügend Daten vorhanden. Standardmäßig (strict_group_size=False) legt das System mehr Wert darauf, die durch den Parameter „limit“ festgelegte Anzahl von Gruppen einzuhalten, als sicherzustellen, dass jede Gruppe „group_size“-Elemente enthält. Dieser Ansatz ist in der Regel effizienter, wenn die Datenverteilung ungleichmäßig ist.
Weitere Informationen zu den Parametern finden Sie unter „search“.
Gruppen nach einem Skalarfeld sortierenCompatible with Milvus 3.0.x
Sie können die gruppierte Suche mit „ order_by_fields “ kombinieren, um Gruppen nach einem Skalarfeld zu sortieren. Dies ist nützlich, wenn Sie vielfältige Ergebnisse über verschiedene Gruppen hinweg wünschen, die Gruppen aber dennoch einer geschäftsrelevanten Reihenfolge wie Preis oder Bewertung folgen sollen.
Das folgende Beispiel gruppiert Suchergebnisse nach „ category “, gibt bis zu drei Entitäten pro Gruppe zurück und sortiert die zurückgegebenen Gruppen nach „ price “ von niedrig nach hoch.
res = client.search(
    collection_name="product_catalog",
    data=query_vectors,
    anns_field="embedding",
    limit=20,
    group_by_field="category",
    group_size=3,
    strict_group_size=True,
    output_fields=["category", "price", "rating"],
    order_by_fields=[
        {"field": "price", "order": "asc"}
    ],
)
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.FloatVec;
import io.milvus.v2.service.vector.request.aggregation.AggDirection;
import io.milvus.v2.service.vector.request.aggregation.OrderByField;
import io.milvus.v2.service.vector.response.SearchResp;
import java.util.List;

// Prerequisite: client is connected to Milvus and product_catalog is loaded.
FloatVec queryVector = new FloatVec(new float[]{0.14529211512077012f, 0.9147257273453546f, 0.7965055218724449f, 0.7009258593102812f, 0.5605206522382088f});
SearchReq request = SearchReq.builder()
    .collectionName("product_catalog")
    .data(List.of(queryVector))
    .annsField("embedding")
    .topK(20)
    .groupByFieldName("category")
    .groupSize(3)
    .strictGroupSize(true)
    .outputFields(List.of("category", "price", "rating"))
    .orderByFields(List.of(OrderByField.builder()
        .fieldName("price").direction(AggDirection.ASC).build()))
    .build();
SearchResp response = client.search(request);
System.out.println(response.getSearchResults());
// Prerequisite: client is connected to Milvus and product_catalog is loaded.
const queryVector = [0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088];
const response = await client.search({
  collection_name: "product_catalog",
  data: [queryVector],
  anns_field: "embedding",
  limit: 20,
  group_by_field: "category",
  group_size: 3,
  strict_group_size: true,
  output_fields: ["category", "price", "rating"],
  order_by_fields: [{ field: "price", order: "asc" }],
});
console.log(response.results);
import (
    "fmt"
    "github.com/milvus-io/milvus/client/v3/entity"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

// Prerequisite: client is connected to Milvus and product_catalog is loaded.
queryVector := []float32{0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088}
results, err := client.Search(ctx, milvusclient.NewSearchOption(
    "product_catalog", 20, []entity.Vector{entity.FloatVector(queryVector)},
).
    WithANNSField("embedding").
    WithGroupByField("category").
    WithGroupSize(3).
    WithStrictGroupSize(true).
    WithOutputFields("category", "price", "rating").
    WithSearchParam("order_by_fields", "price:asc"))
if err != nil {
    panic(err)
}
for _, result := range results {
    fmt.Println(result.IDs, result.Scores)
    fmt.Println(result.GetColumn("category"), result.GetColumn("price"), result.GetColumn("rating"))
}
# Prerequisite: set CLUSTER_ENDPOINT and TOKEN for your Milvus instance.
curl --request POST \
  --url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
  --header "Authorization: Bearer ${TOKEN}" \
  --header "Content-Type: application/json" \
  --data '{
    "collectionName": "product_catalog",
    "data": [[0.14529211512077012, 0.9147257273453546, 0.7965055218724449, 0.7009258593102812, 0.5605206522382088]],
    "annsField": "embedding",
    "limit": 20,
    "groupingField": "category",
    "groupSize": 3,
    "strictGroupSize": true,
    "outputFields": ["category", "price", "rating"],
    "orderByFields": ["price:asc"]
  }'
#include "milvus/MilvusClientV2.h"
#include <iostream>
#include <stdexcept>

// Prerequisite: client is connected to Milvus and product_catalog is loaded.
std::vector<float> query_vector = {0.14529211512077012f, 0.9147257273453546f, 0.7965055218724449f, 0.7009258593102812f, 0.5605206522382088f};
auto request = milvus::SearchRequest()
    .WithCollectionName("product_catalog")
    .AddFloatVector(query_vector)
    .WithAnnsField("embedding")
    .WithLimit(20)
    .WithGroupByField("category")
    .WithGroupSize(3)
    .WithStrictGroupSize(true)
    .AddOutputField("category")
    .AddOutputField("price")
    .AddOutputField("rating")
    .AddOrderByField(milvus::OrderByField("price", milvus::AggregationDirection::ASC));
milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) { throw std::runtime_error(status.Message()); }
for (const auto& result : response.Results().Results()) {
    milvus::EntityRows rows;
    status = result.OutputRows(rows);
    if (!status.IsOk()) { throw std::runtime_error(status.Message()); }
    std::cout << rows << std::endl;
}
In der obigen Anfrage bedeutet „ limit=20 “, dass Milvus bis zu 20 Gruppen auswählt, nicht 20 Entitäten. Da „ group_size=3 “ gilt, kann die flache Ergebnisliste insgesamt bis zu 60 Entitäten enthalten.
Wenn Sie „ order_by_fields “ zusammen mit „ group_by_field “ verwenden, sortiert Milvus die Gruppen nach dem angegebenen Skalarfeldwert der obersten Entität jeder Gruppe. Innerhalb jeder Gruppe bleiben die Entitäten nach ihrem Ähnlichkeitswert zum Abfragevektor sortiert.
Zu beachtende Punkte
Indizierung: Diese Gruppierungsfunktion funktioniert nur für Sammlungen, die mit folgenden Indextypen indiziert sind: FLAT, IVF_FLAT, IVF_SQ8, HNSW, HNSW_PQ, HNSW_PRQ, HNSW_SQ, DISKANN, SPARSE_INVERTED_INDEX.
Anzahl der Gruppen: Der Parameter „
limit“ steuert die Anzahl der Gruppen, aus denen Suchergebnisse zurückgegeben werden, und nicht die spezifische Anzahl der Entitäten innerhalb jeder Gruppe. Die Einstellung eines geeigneten Werts für „limit“ hilft dabei, die Suchvielfalt und die Abfrageleistung zu steuern. Eine Verringerung von „limit“ kann den Rechenaufwand reduzieren, wenn die Daten dicht verteilt sind oder die Leistung ein kritischer Faktor ist.Entitäten pro Gruppe: Der Parameter „
group_size“ steuert die Anzahl der pro Gruppe zurückgegebenen Entitäten. Durch die Anpassung von „group_size“ an Ihren Anwendungsfall können Sie die Vielfalt der Suchergebnisse erhöhen. Sind die Daten jedoch ungleichmäßig verteilt, können einige Gruppen weniger Entitäten zurückgeben als durch „group_size“ festgelegt, insbesondere bei begrenzten Datenmengen.Strenge Gruppengröße: Bei der Einstellung „
strict_group_size=True“ versucht das System, für jede Gruppe die angegebene Anzahl von Entitäten (group_size) zurückzugeben, es sei denn, in dieser Gruppe sind nicht genügend Daten vorhanden. Diese Einstellung gewährleistet eine konsistente Entitätsanzahl pro Gruppe, kann jedoch bei ungleichmäßiger Datenverteilung oder begrenzten Ressourcen zu Leistungseinbußen führen. Wenn keine strenge Entitätsanzahl erforderlich ist, kann die Einstellung von „strict_group_size=False“ die Abfragegeschwindigkeit verbessern.Falls die Abfragevektoren bereits in der Zielsammlung vorhanden sind, sollten Sie die Verwendung von „
ids“ in Betracht ziehen, anstatt sie vor der Suche abzurufen. Weitere Informationen finden Sie unter „Primärschlüsselsuche“.
