

البحث عن النص الكامل
البحث عن النص الكامل هو ميزة تستخرج المستندات التي تحتوي على مصطلحات أو عبارات محددة في مجموعات البيانات النصية، ثم تصنف النتائج بناءً على مدى صلتها بالموضوع. تتغلب هذه الميزة على قيود البحث الدلالي، الذي قد يتجاهل مصطلحات دقيقة، مما يضمن حصولك على النتائج الأكثر دقة وذات الصلة بالسياق. بالإضافة إلى ذلك، فإنها تبسط عمليات البحث المتجهي من خلال قبول إدخال النص الخام، وتحويل بيانات النص تلقائيًا إلى تضمينات متفرقة دون الحاجة إلى إنشاء تضمينات متجهة يدويًّا.
باستخدام خوارزمية BM25 لتقييم الصلة، تُعد هذه الميزة ذات قيمة خاصة في سيناريوهات التوليد المعزز بالاسترجاع (RAG)، حيث تعطي الأولوية للمستندات التي تتطابق بشكل وثيق مع مصطلحات بحث محددة.
من خلال دمج البحث عن النص الكامل مع البحث المتجه الكثيف القائم على الدلالة، يمكنك تحسين دقة نتائج البحث ومدى ملاءمتها. لمزيد من المعلومات، راجع «البحث الهجين».
تنفيذ BM25
يوفر Milvus البحث عن النص الكامل المدعوم بخوارزمية الصلة BM25، وهي وظيفة تقييم معتمدة على نطاق واسع في أنظمة استرجاع المعلومات، ويقوم Milvus بدمجها في سير عمل البحث لتقديم نتائج نصية دقيقة ومصنفة حسب الصلة.
يتبع البحث عن النص الكامل في Milvus سير العمل التالي:
إدخال النص الخام: تقوم بإدراج مستندات نصية أو تقديم استعلام باستخدام نص عادي، دون الحاجة إلى نماذج تضمين.
تحليل النص: يستخدم Milvus أداة تحليل لمعالجة النص وتحويله إلى مصطلحات ذات معنى يمكن فهرستها والبحث عنها.
معالجة وظيفة BM25: تقوم وظيفة مدمجة بتحويل هذه المصطلحات إلى تمثيلات متجهة متفرقة مُحسّنة لتقييم BM25.
تخزين المجموعة: يقوم Milvus بتخزين التضمينات المتفرقة الناتجة في مجموعة من أجل الاسترجاع والترتيب السريعين.
تقييم مدى الصلة باستخدام BM25: عند إجراء البحث، يطبق Milvus دالة تقييم BM25 لحساب مدى صلة المستند وإرجاع النتائج المصنفة التي تتطابق بشكل أفضل مع مصطلحات الاستعلام.
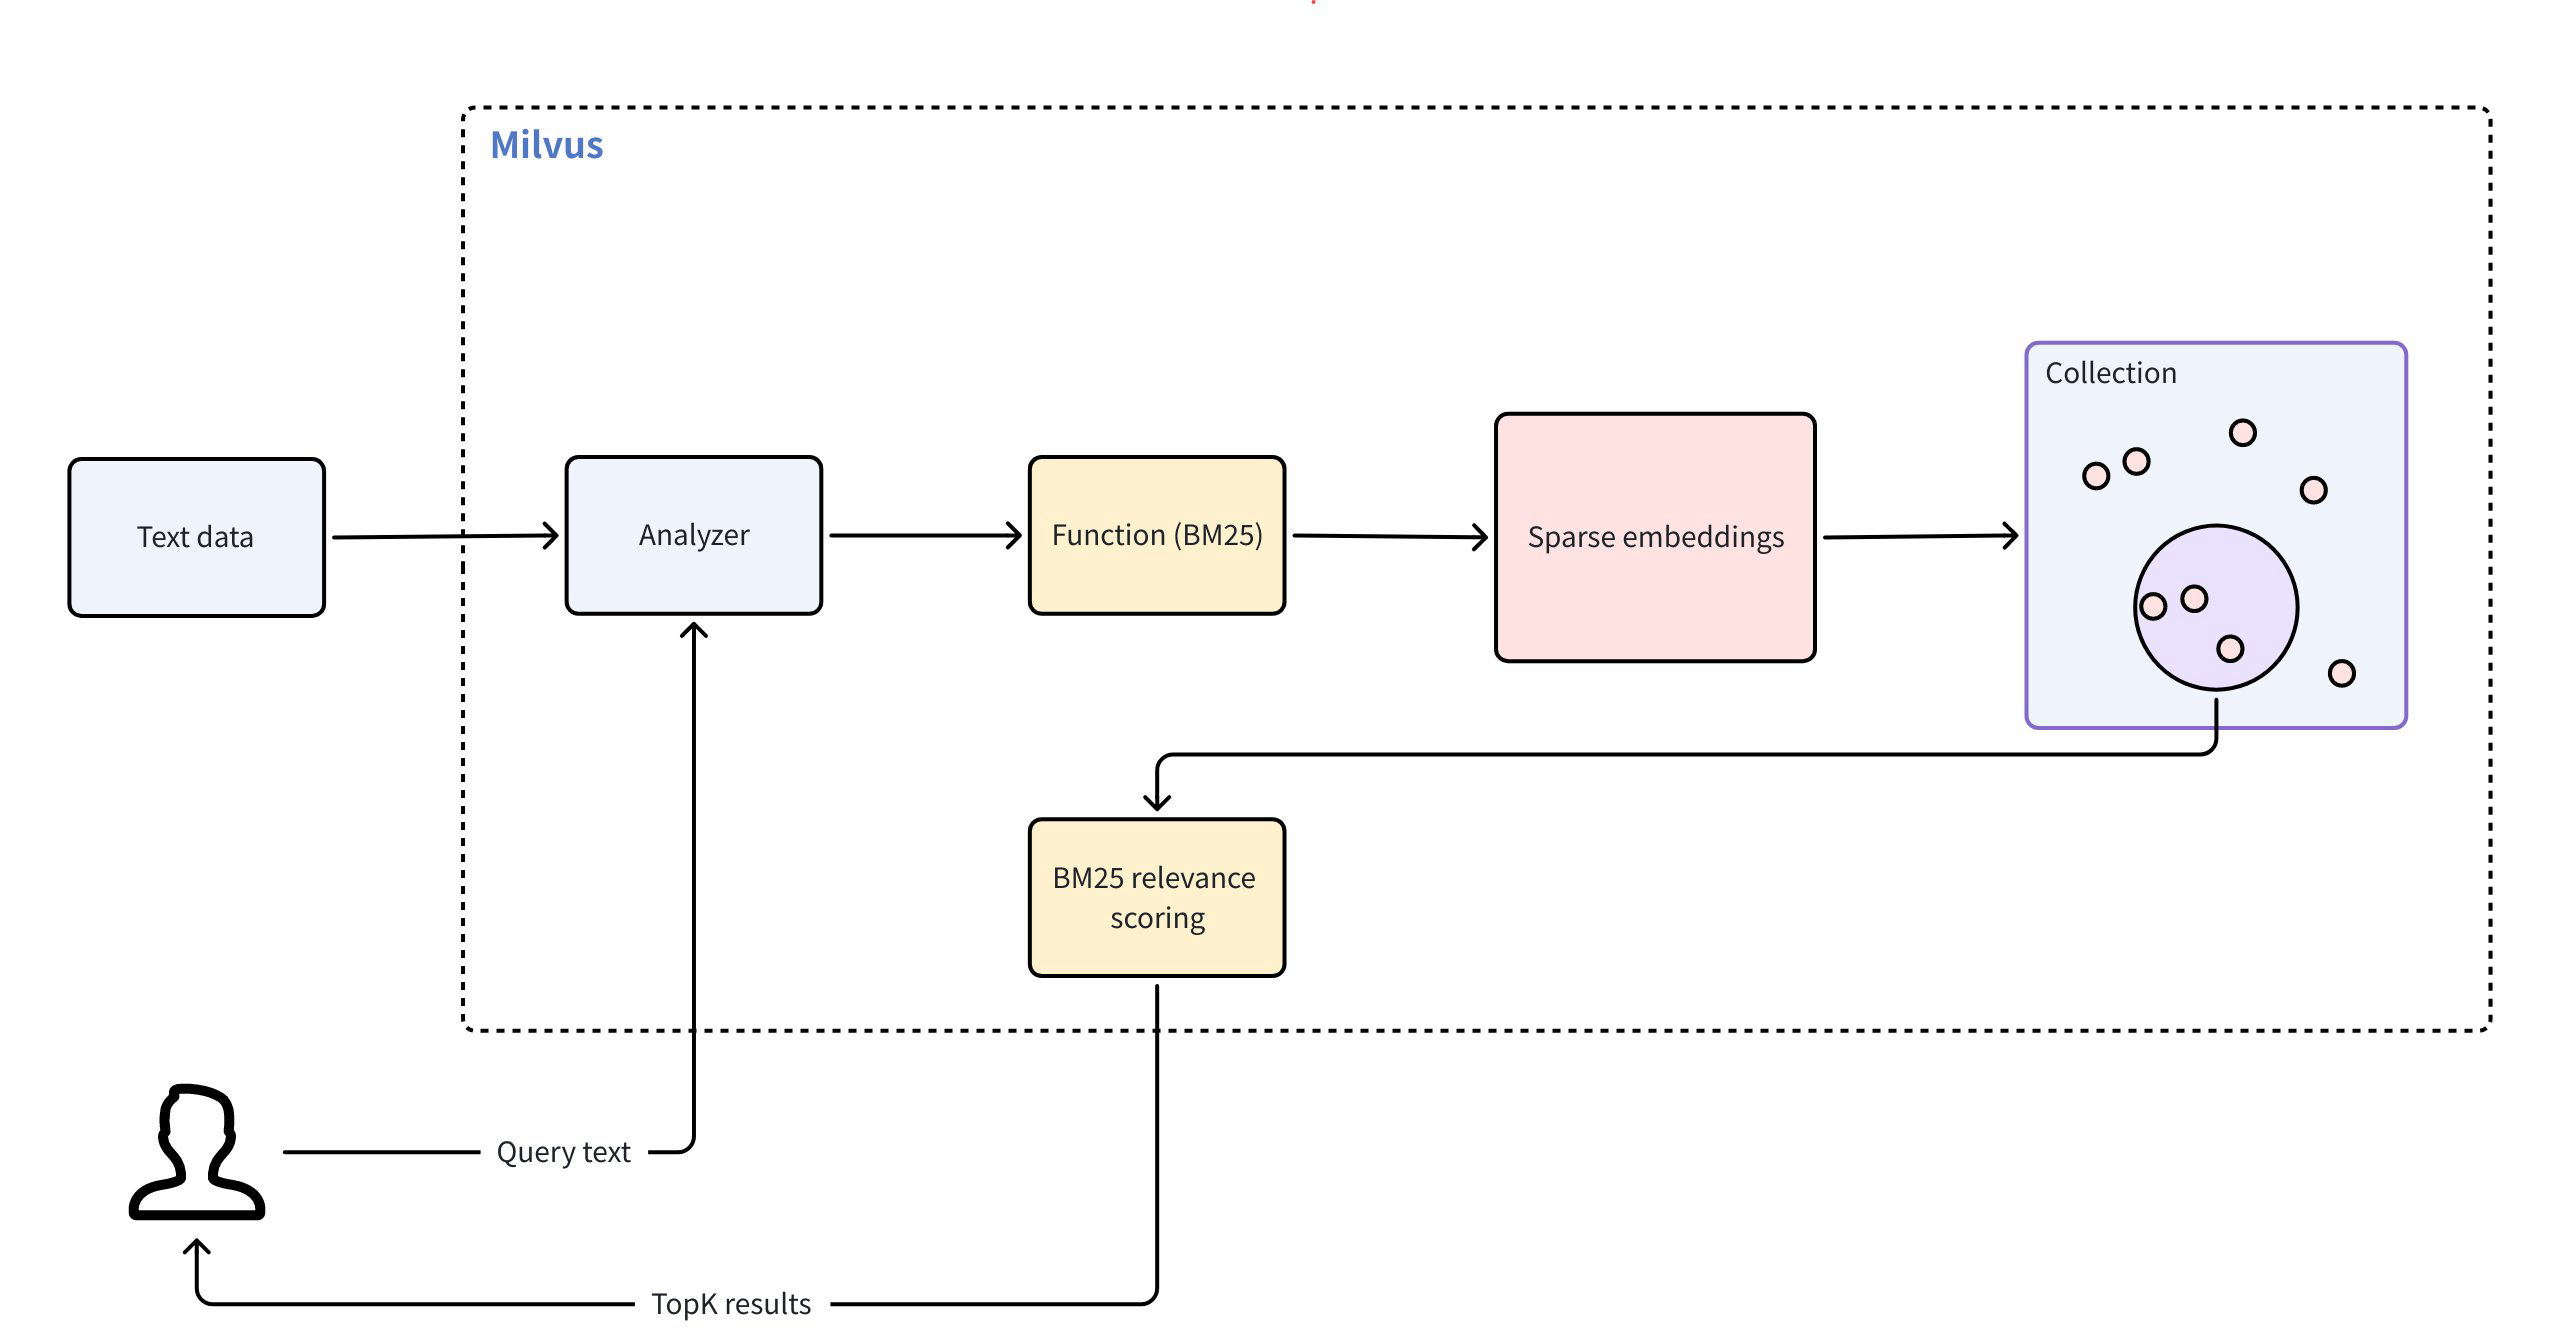 البحث عن النص الكامل
لاستخدام البحث عن النص الكامل، اتبع الخطوات الرئيسية التالية:
إنشاء مجموعة: قم بإعداد الحقول المطلوبة وحدد دالة BM25 التي تحول النص الخام إلى تمثيلات متفرقة.
إدراج البيانات: قم باستيعاب مستندات النص الخام في المجموعة.
إجراء عمليات البحث: استخدم نص استعلام باللغة الطبيعية لاسترداد نتائج مرتبة بناءً على ملاءمة BM25.
إنشاء مجموعة للبحث في النص الكامل باستخدام BM25
لتمكين البحث عن النص الكامل المدعوم بـ BM25، يجب عليك إعداد مجموعة تحتوي على الحقول المطلوبة، وتحديد دالة BM25 لتوليد متجهات متفرقة، وتكوين فهرس، ثم إنشاء المجموعة.
تحديد حقول المخطط
يجب أن يتضمن مخطط المجموعة الخاص بك ثلاثة حقول إلزامية على الأقل:
الحقل الأساسي: يحدد بشكل فريد كل كيان في المجموعة.
حقل السلسلة (
VARCHARأوTEXT): يخزن مستندات النص الخام. يجب تعيينenable_analyzer=Trueحتى يتمكن Milvus من معالجة النص لترتيب الصلة باستخدام BM25. بشكل افتراضي، يستخدم Milvusstandardالمحلل لتحليل النص. لتكوين محلل مختلف، راجع نظرة عامة على المحلل. تستخدم الأمثلة في هذه الصفحةVARCHAR؛ بالنسبة للنصوص الطويلة، يمكنك تعريف حقل الإدخال على أنهTEXTوتجاهلmax_length. للحصول على مثال كامل، راجع حقل النص.حقل المتجهات المتفرقة (
SPARSE_FLOAT_VECTOR): يخزن التضمينات المتفرقة التي تم إنشاؤها تلقائيًا بواسطة دالة BM25.
from pymilvus import MilvusClient, DataType, Function, FunctionType

client = MilvusClient(
    uri="http://localhost:19530",
    token="root:Milvus"
)

schema = client.create_schema()

schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True, auto_id=True) # Primary field
schema.add_field(field_name="text", datatype=DataType.VARCHAR, max_length=1000, enable_analyzer=True) # Text field
schema.add_field(field_name="sparse", datatype=DataType.SPARSE_FLOAT_VECTOR) # Sparse vector field; no dim required for sparse vectors
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .build();
schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("text")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("sparse")
        .dataType(DataType.SparseFloatVector)
        .build());
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

schema := entity.NewSchema()
schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(true),
).WithField(entity.NewField().
    WithName("text").
    WithDataType(entity.FieldTypeVarChar).
    WithEnableAnalyzer(true).
    WithMaxLength(1000),
).WithField(entity.NewField().
    WithName("sparse").
    WithDataType(entity.FieldTypeSparseVector),
)
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const address = "http://localhost:19530";
const token = "root:Milvus";
const client = new MilvusClient({address, token});
const schema = [
  {
    name: "id",
    data_type: DataType.Int64,
    is_primary_key: true,
  },
  {
    name: "text",
    data_type: "VarChar",
    enable_analyzer: true,
    enable_match: true,
    max_length: 1000,
  },
  {
    name: "sparse",
    data_type: DataType.SparseFloatVector,
  },
];

console.log(res.results)
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true
                }
            },
            {
                "fieldName": "sparse",
                "dataType": "SparseFloatVector"
            }
        ]
    }'
في التكوين السابق،
id: يُستخدم كمفتاح أساسي ويتم إنشاؤه تلقائيًا باستخدامauto_id=True.text: يخزن بيانات النص الخام الخاصة بك لعمليات البحث عن النص الكامل. يمكن للحقل استخدامVARCHARللنص المحدود أوTEXTللمحتوى المصدر الطويل.sparse: حقل متجه مخصص لتخزين التضمينات المتفرقة التي يتم إنشاؤها داخليًا لعمليات البحث عن النص الكامل. يجب أن يكون نوع البياناتSPARSE_FLOAT_VECTOR.
تعريف دالة BM25
تقوم دالة BM25 بتحويل النص المقسم إلى رموز إلى متجهات متفرقة تدعم نظام التقييم BM25.
قم بتعريف الدالة وإضافتها إلى مخططك:
bm25_function = Function(
    name="text_bm25_emb", # Function name
    input_field_names=["text"], # Name of the VARCHAR or TEXT field containing raw text data
    output_field_names=["sparse"], # Name of the SPARSE_FLOAT_VECTOR field reserved to store generated embeddings
    function_type=FunctionType.BM25, # Set to `BM25`
)

schema.add_function(bm25_function)
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.CreateCollectionReq.Function;

import java.util.*;

schema.addFunction(Function.builder()
        .functionType(FunctionType.BM25)
        .name("text_bm25_emb")
        .inputFieldNames(Collections.singletonList("text"))
        .outputFieldNames(Collections.singletonList("sparse"))
        .build());
function := entity.NewFunction().
    WithName("text_bm25_emb").
    WithInputFields("text").
    WithOutputFields("sparse").
    WithType(entity.FunctionTypeBM25)
schema.WithFunction(function)
const functions = [
    {
      name: 'text_bm25_emb',
      description: 'bm25 function',
      type: FunctionType.BM25,
      input_field_names: ['text'],
      output_field_names: ['sparse'],
      params: {},
    },
];
export schema='{
        "autoId": true,
        "enabledDynamicField": false,
        "fields": [
            {
                "fieldName": "id",
                "dataType": "Int64",
                "isPrimary": true
            },
            {
                "fieldName": "text",
                "dataType": "VarChar",
                "elementTypeParams": {
                    "max_length": 1000,
                    "enable_analyzer": true
                }
            },
            {
                "fieldName": "sparse",
                "dataType": "SparseFloatVector"
            }
        ],
        "functions": [
            {
                "name": "text_bm25_emb",
                "type": "BM25",
                "inputFieldNames": ["text"],
                "outputFieldNames": ["sparse"],
                "params": {}
            }
        ]
    }'
المعلمة |
الوصف |
|---|---|
|
اسم الدالة. تقوم هذه الدالة بتحويل النص الخام من حقل " |
|
اسم الحقل |
|
اسم الحقل الذي سيتم تخزين المتجهات المتفرقة التي تم إنشاؤها داخليًا فيه. بالنسبة لـ |
|
نوع الدالة المطلوب استخدامها. يجب أن يكون |
إذا كانت هناك حقول نصية متعددة تتطلب معالجة BM25، فقم بتعريف دالة BM25 واحدة لكل حقل، بحيث يكون لكل منها اسم وحقل إخراج فريدان.
تكوين الفهرس
بعد تعريف المخطط بالحقول الضرورية والدالة المدمجة، قم بإعداد الفهرس لمجموعتك.
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="sparse",

    index_type="SPARSE_INVERTED_INDEX",
    metric_type="BM25",
    params={
        "inverted_index_algo": "DAAT_MAXSCORE",
        "bm25_k1": 1.2,
        "bm25_b": 0.75
    }

)
import io.milvus.v2.common.IndexParam;

Map<String,Object> params = new HashMap<>();
params.put("inverted_index_algo", "DAAT_MAXSCORE");
params.put("bm25_k1", 1.2);
params.put("bm25_b", 0.75);

List<IndexParam> indexes = new ArrayList<>();
indexes.add(IndexParam.builder()
        .fieldName("sparse")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.BM25)
        .extraParams(params)
        .build());
indexOption := milvusclient.NewCreateIndexOption("my_collection", "sparse",
    index.NewAutoIndex(entity.MetricType(entity.BM25)))
    .WithExtraParam("inverted_index_algo", "DAAT_MAXSCORE")
    .WithExtraParam("bm25_k1", 1.2)
    .WithExtraParam("bm25_b", 0.75)
const index_params = [
  {
    field_name: "sparse",
    metric_type: "BM25",
    index_type: "SPARSE_INVERTED_INDEX",
    params: {
        "inverted_index_algo": "DAAT_MAXSCORE",
        "bm25_k1": 1.2,
        "bm25_b": 0.75
    }
  },
];
export indexParams='[
        {
            "fieldName": "sparse",
            "metricType": "BM25",
            "indexType": "AUTOINDEX",
            "params":{
               "inverted_index_algo": "DAAT_MAXSCORE",
               "bm25_k1": 1.2,
               "bm25_b": 0.75
            }
        }
    ]'
المعلمة |
الوصف |
|---|---|
|
اسم الحقل المتجه المراد فهرسته. بالنسبة للبحث عن النص الكامل، يجب أن يكون هذا هو الحقل الذي يخزن المتجهات المتفرقة التي تم إنشاؤها. في هذا المثال، اضبط القيمة على |
|
نوع الفهرس المراد إنشاؤه. للبحث عن النص الكامل باستخدام BM25 في Milvus، اضبط هذه القيمة على |
|
يجب تعيين قيمة هذه المعلمة على |
|
قاموس للمعلمات الإضافية الخاصة بالفهرس. |
|
الخوارزمية المستخدمة لإنشاء الفهرس المقلوب المتفرق BM25 والاستعلام عنه. القيم الصالحة:
|
|
يتحكم في تشبع تكرار المصطلحات. تؤدي القيم الأعلى إلى زيادة أهمية تكرار المصطلحات في ترتيب المستندات. النطاق الموصى به: [1.2، 2.0]. القيمة الافتراضية: 1.2. |
|
يتحكم في مدى تطبيع طول المستند. تُستخدم عادةً القيم بين 0 و1، مع قيمة افتراضية تبلغ 0.75. تعني القيمة 0 عدم وجود تطبيع للطول، بينما تعني القيمة 1 تطبيعًا كاملاً للطول. |
إنشاء المجموعة
الآن قم بإنشاء المجموعة باستخدام معلمات المخطط والفهرس المحددة.
client.create_collection(
    collection_name='my_collection',
    schema=schema,
    index_params=index_params
)
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
await client.create_collection(
    collection_name: 'my_collection',
    schema: schema,
    index_params: index_params,
    functions: functions
);
export CLUSTER_ENDPOINT="http://localhost:19530"
export TOKEN="root:Milvus"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
إدراج البيانات النصية
بعد إعداد المجموعة والفهرس، تكون جاهزًا لإدراج البيانات النصية. في هذه العملية، ما عليك سوى توفير النص الخام. تقوم الدالة المدمجة التي حددناها سابقًا بإنشاء المتجه المتفرق المقابل تلقائيًا لكل إدخال نصي.
client.insert('my_collection', [
    {'text': 'information retrieval is a field of study.'},
    {'text': 'information retrieval focuses on finding relevant information in large datasets.'},
    {'text': 'data mining and information retrieval overlap in research.'},
])
import com.google.gson.Gson;
import com.google.gson.JsonObject;

import io.milvus.v2.service.vector.request.InsertReq;

Gson gson = new Gson();
List<JsonObject> rows = Arrays.asList(
        gson.fromJson("{\"text\": \"information retrieval is a field of study.\"}", JsonObject.class),
        gson.fromJson("{\"text\": \"information retrieval focuses on finding relevant information in large datasets.\"}", JsonObject.class),
        gson.fromJson("{\"text\": \"data mining and information retrieval overlap in research.\"}", JsonObject.class)
);

client.insert(InsertReq.builder()
        .collectionName("my_collection")
        .data(rows)
        .build());
// go
await client.insert({
collection_name: 'my_collection',
data: [
    {'text': 'information retrieval is a field of study.'},
    {'text': 'information retrieval focuses on finding relevant information in large datasets.'},
    {'text': 'data mining and information retrieval overlap in research.'},
]);
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "data": [
        {"text": "information retrieval is a field of study."},
        {"text": "information retrieval focuses on finding relevant information in large datasets."},
        {"text": "data mining and information retrieval overlap in research."}
    ],
    "collectionName": "my_collection"
}'
إجراء بحث نصي كامل
بمجرد إدراج البيانات في مجموعتك، يمكنك إجراء عمليات بحث عن النص الكامل باستخدام استعلامات النص الخام. يقوم Milvus تلقائيًا بتحويل استعلامك إلى متجه متفرق وترتيب نتائج البحث المطابقة باستخدام خوارزمية BM25، ثم يعرض النتائج topK (limit).
يمكنك تمييز المصطلحات المطابقة في نتائج البحث عن طريق تكوين أداة تمييز النص. راجع أداة تمييز النص للحصول على التفاصيل.
res = client.search(
    collection_name='my_collection',
    data=['whats the focus of information retrieval?'],
    anns_field='sparse',
    output_fields=['text'], # Fields to return in search results; sparse field cannot be output
    limit=3,
)

print(res)
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.EmbeddedText;
import io.milvus.v2.service.vector.response.SearchResp;

Map<String,Object> searchParams = new HashMap<>();

SearchResp searchResp = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(new EmbeddedText("whats the focus of information retrieval?")))
        .annsField("sparse")
        .topK(3)
        .searchParams(searchParams)
        .outputFields(Collections.singletonList("text"))
        .build());
annSearchParams := index.NewCustomAnnParam()
resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    3,               // limit
    []entity.Vector{entity.Text("whats the focus of information retrieval?")},
).WithConsistencyLevel(entity.ClStrong).
    WithANNSField("sparse").
    WithAnnParam(annSearchParams).
    WithOutputFields("text"))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("text: ", resultSet.GetColumn("text").FieldData().GetScalars())
}
await client.search(
    collection_name: 'my_collection',
    data: ['whats the focus of information retrieval?'],
    anns_field: 'sparse',
    output_fields: ['text'],
    limit: 3,
)
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
--data-raw '{
    "collectionName": "my_collection",
    "data": [
        "whats the focus of information retrieval?"
    ],
    "annsField": "sparse",
    "limit": 3,
    "outputFields": [
        "text"
    ],
    "searchParams":{
        "params":{}
    }
}'
المعلمة |
الوصف |
|---|---|
|
قاموس يحتوي على معلمات البحث. |
|
نسبة المصطلحات ذات الأهمية المنخفضة التي يجب تجاهلها أثناء البحث. يجب أن تكون القيمة في النطاق [0.0، 1.0). لمزيد من التفاصيل، راجع " المتجه المتفرق". |
|
نص الاستعلام الخام باللغة الطبيعية. يقوم Milvus تلقائيًا بتحويل استعلامك النصي إلى متجهات متفرقة باستخدام دالة BM25 - لا تقدم متجهات محسوبة مسبقًا. |
|
اسم الحقل الذي يحتوي على المتجهات المتفرقة التي تم إنشاؤها داخليًا. |
|
قائمة بأسماء الحقول المراد إرجاعها في نتائج البحث. يدعم جميع الحقول باستثناء حقل المتجهات المتفرقة الذي يحتوي على التضمينات التي تم إنشاؤها بواسطة BM25. تشمل حقول الإخراج الشائعة حقل المفتاح الأساسي (على سبيل المثال، |
|
الحد الأقصى لعدد أفضل النتائج المراد إرجاعها. |
الأسئلة الشائعة
هل يمكنني إخراج أو الوصول إلى المتجهات المتفرقة التي تم إنشاؤها بواسطة دالة BM25 في البحث عن النص الكامل؟
لا، لا يمكن الوصول مباشرةً إلى المتجهات المتفرقة التي تم إنشاؤها بواسطة دالة BM25 أو إخراجها في البحث عن النص الكامل. وفيما يلي التفاصيل:
تقوم دالة BM25 بإنشاء متجهات متفرقة داخليًا لأغراض الترتيب والاسترجاع
يتم تخزين هذه المتجهات في الحقل المتفرق ولكن لا يمكن تضمينها في
output_fieldsيمكنك فقط إخراج حقول النص الأصلية والبيانات الوصفية (مثل
idوtext)
مثال:
# ❌ This throws an error - you cannot output the sparse field
client.search(
    collection_name='my_collection',
    data=['query text'],
    anns_field='sparse',
    output_fields=['text', 'sparse']  # 'sparse' causes an error
    limit=3,
    search_params=search_params
)

# ✅ This works - output text fields only
client.search(
    collection_name='my_collection',
    data=['query text'],
    anns_field='sparse',
    output_fields=['text']
    limit=3,
    search_params=search_params
)
لماذا أحتاج إلى تعريف حقل متجه متفرق إذا لم يكن بإمكاني الوصول إليه؟
يعمل حقل المتجهات المتفرقة كفهرس بحث داخلي، على غرار فهارس قواعد البيانات التي لا يتفاعل معها المستخدمون بشكل مباشر.
الأساس المنطقي للتصميم:
فصل الاهتمامات: أنت تعمل مع النص (الإدخال/الإخراج)، بينما يتولى Milvus معالجة المتجهات (المعالجة الداخلية)
الأداء: تتيح المتجهات المتفرقة المحسوبة مسبقًا ترتيبًا سريعًا باستخدام خوارزمية BM25 أثناء الاستعلامات
تجربة المستخدم: يخفي العمليات المتجهة المعقدة خلف واجهة نصية بسيطة
إذا كنت بحاجة إلى الوصول إلى المتجهات:
استخدم عمليات المتجهات المتفرقة يدويًا بدلاً من البحث عن النص الكامل
أنشئ مجموعات منفصلة لسير عمل المتجهات المتفرقة المخصصة
للحصول على التفاصيل، راجع «المتجهات المتفرقة».
