

ストレージ/コンピューティングの分離
データプレーンとコントロールプレーンの分離の原則に従い、Milvusはスケーラビリティとディザスタリカバリの点で相互に独立した4つのレイヤーで構成されている。
アクセス層
ステートレスプロキシで構成されるアクセスレイヤーは、システムのフロントレイヤーであり、ユーザーへのエンドポイントである。クライアントのリクエストを検証し、返された結果を縮小する:
- プロキシはそれ自体ステートレスである。Nginx、Kubernetes Ingress、NodePort、LVSなどのロードバランシングコンポーネントを使用して、統一されたサービスアドレスを提供する。
- Milvusは超並列処理(MPP)アーキテクチャを採用しているため、プロキシは最終結果をクライアントに返す前に中間結果を集約し、後処理を行う。
コーディネータサービス
コーディネータサービスはワーカーノードにタスクを割り当て、システムの頭脳として機能します。担当するタスクには、クラスタトポロジ管理、負荷分散、タイムスタンプ生成、データ宣言、データ管理などがある。
コーディネータには、ルートコーディネータ(root coordinator)、データコーディネータ(data coordinator)、クエリコーディネータ(query coordinator)の3種類がある。
ルート・コーディネーター(root coordinator)
ルート・コーディネータは、コレクション、パーティション、インデックスの作成または削除などのデータ定義言語 (DDL) およびデータ制御言語 (DCL) の要求を処理し、TSO (タイムスタンプ・オラクル) およびタイム・ティッカーの発行を管理します。
クエリコーディネータ(query coordinator)
クエリ・コーディネータはクエリ・ノードのトポロジーと負荷分散、成長セグメントから封印セグメントへのハンドオフを管理します。
データコーディネータ(data coordinator)
データノードとインデックスノードのトポロジーを管理し、メタデータを保持し、フラッシュ、コンパクト化、インデックス構築、その他のバックグラウンドデータ操作をトリガーする。
ワーカーノード
ワーカーノードは、コーディネータサービスからの指示に従い、プロキシからデータ操作言語(DML)コマンドを実行する「ダム」エクゼキュータです。ワーカーノードはストレージと計算を分離しているためステートレスであり、Kubernetesにデプロイするとシステムのスケールアウトやディザスタリカバリを促進できる。ワーカーノードには3つのタイプがある:
クエリノード
クエリノードは、インクリメンタルなログデータを取得し、ログブローカーにサブスクライブすることでそれらを成長セグメントに変換し、オブジェクトストレージから履歴データをロードし、ベクトルデータとスカラーデータの間でハイブリッド検索を実行する。
データノード
データノードはログブローカーにサブスクライブすることで増分ログデータを取得し、変異リクエストを処理し、ログデータをログスナップショットにパックしてオブジェクトストレージに保存する。
インデックスノード
インデックスノードはインデックスを構築します。メモリに常駐する必要はなく、サーバーレスフレームワークで実装できる。
ストレージ
ストレージはシステムの骨格であり、データの永続化を担う。メタ・ストレージ、ログ・ブローカー、オブジェクト・ストレージで構成される。
メタ・ストレージ
メタ・ストレージは、コレクション・スキーマやメッセージ消費チェックポイントなどのメタデータのスナップショットを保存する。メタデータの保存には極めて高い可用性、強力な一貫性、トランザクションサポートが要求されるため、Milvusはこの目的にetcdを選択した。Milvusはサービスの登録とヘルスチェックにもetcdを使用している。
オブジェクトストレージ
オブジェクトストレージは、ログのスナップショットファイル、スカラーデータとベクトルデータのインデックスファイル、中間クエリ結果を格納する。MilvusはオブジェクトストレージとしてMinIOを使用しており、AWS S3およびAzure Blobという世界で最も普及しているコスト効率の高いストレージサービスに容易に導入することができる。しかし、オブジェクトストレージはアクセスレイテンシーが高く、クエリー数によって課金される。milvusはパフォーマンスを向上させ、コストを削減するために、メモリまたはSSDベースのキャッシュプール上にコールド・ホット・データ分離を実装する予定である。
ログブローカー
ログブローカーは再生をサポートするパブサブシステムである。ストリーミングデータの永続化とイベント通知を担当する。また、ワーカー・ノードがシステム故障から回復する際、増分データの整合性を保証します。Milvus Distributedはログ・ブローカーとしてPulsarを使用し、Milvus StandaloneはRocksDBを使用する。ログ・ブローカーは、Kafkaのようなストリーミング・データ・ストレージ・プラットフォームに容易に置き換えることができる。
Milvusは「データとしてのログ」の原則に従っているため、Milvusは物理テーブルを保持せず、ログの永続性とスナップショットログによってデータの信頼性を保証している。
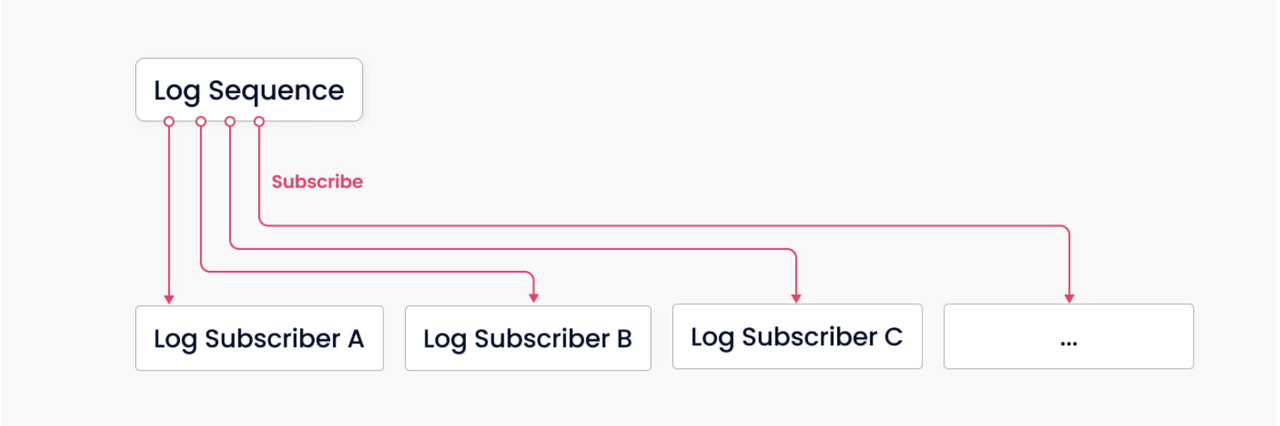 ログメカニズム
ログブローカーはMilvusのバックボーンである。生来のpub-subメカニズムにより、データの永続化と読み書き分解を担っています。上の図は、ログブローカー(ログシーケンスの維持)とログサブスクライバーの2つの役割にシステムが分割されているメカニズムを簡略化して示しています。後者は、ローカルデータを更新するためにログシーケンスを購読し、読み取り専用コピーの形でサービスを提供する。pub-subメカニズムは、変更データキャプチャ(CDC)とグローバルに分散された展開という点で、システムを拡張する余地もある。
次のページ
- Milvusアーキテクチャの詳細については、メインコンポーネントをお読みください。
