

نظرة عامة على المحلل
في معالجة النصوص، يُعد المحلل مكونًا أساسيًا يعمل على تحويل النص الخام إلى تنسيق منظم وقابل للبحث. يتكون كل محلل عادةً من عنصرين أساسيين: أداة التقطيع (tokenizer) والمرشح (filter). يعمل هذان العنصران معًا على تحويل النص المدخل إلى رموز (tokens)، وصقل هذه الرموز، وإعدادها من أجل الفهرسة والاسترجاع بكفاءة.
في Milvus، يتم تكوين المحللات أثناء إنشاء المجموعة عند إضافة حقول « VARCHAR » إلى مخطط المجموعة. يمكن استخدام الرموز التي ينتجها المحلل لإنشاء فهرس لمطابقة الكلمات الرئيسية أو تحويلها إلى تضمينات متفرقة للبحث عن النص الكامل. لمزيد من المعلومات، راجع «البحث عن النص الكامل» أو «مطابقة العبارات» أو «مطابقة النص».
قد يؤثر استخدام أدوات التحليل على الأداء:
البحث عن النص الكامل: بالنسبة للبحث عن النص الكامل، تستهلك قنوات DataNode وQueryNode البيانات ببطء أكبر لأنها يجب أن تنتظر اكتمال عملية التقطيع إلى رموز. ونتيجة لذلك، تستغرق البيانات التي تم استيعابها حديثًا وقتًا أطول حتى تصبح متاحة للبحث.
مطابقة الكلمات المفتاحية: بالنسبة لمطابقة الكلمات المفتاحية، يكون إنشاء الفهرس أبطأ أيضًا نظرًا لأن عملية التقطيع إلى رموز يجب أن تنتهي قبل أن يتم إنشاء الفهرس.
تركيب المحلل
يتكون المحلل في Milvus من مُجزئ واحد بالضبط وصفر أو أكثر من المرشحات.
أداة الترميز: تقوم أداة الترميز بتقسيم النص المدخل إلى وحدات منفصلة تسمى الرموز. قد تكون هذه الرموز كلمات أو عبارات، اعتمادًا على نوع أداة الترميز.
المرشحات: يمكن تطبيق المرشحات على الرموز لتحسينها بشكل أكبر، على سبيل المثال، عن طريق تحويلها إلى أحرف صغيرة أو إزالة الكلمات الشائعة.
تدعم أدوات الترميز تنسيق UTF-8 فقط. وسيتم إضافة دعم التنسيقات الأخرى في الإصدارات المستقبلية.
يوضح سير العمل أدناه كيفية معالجة المحلل للنص.
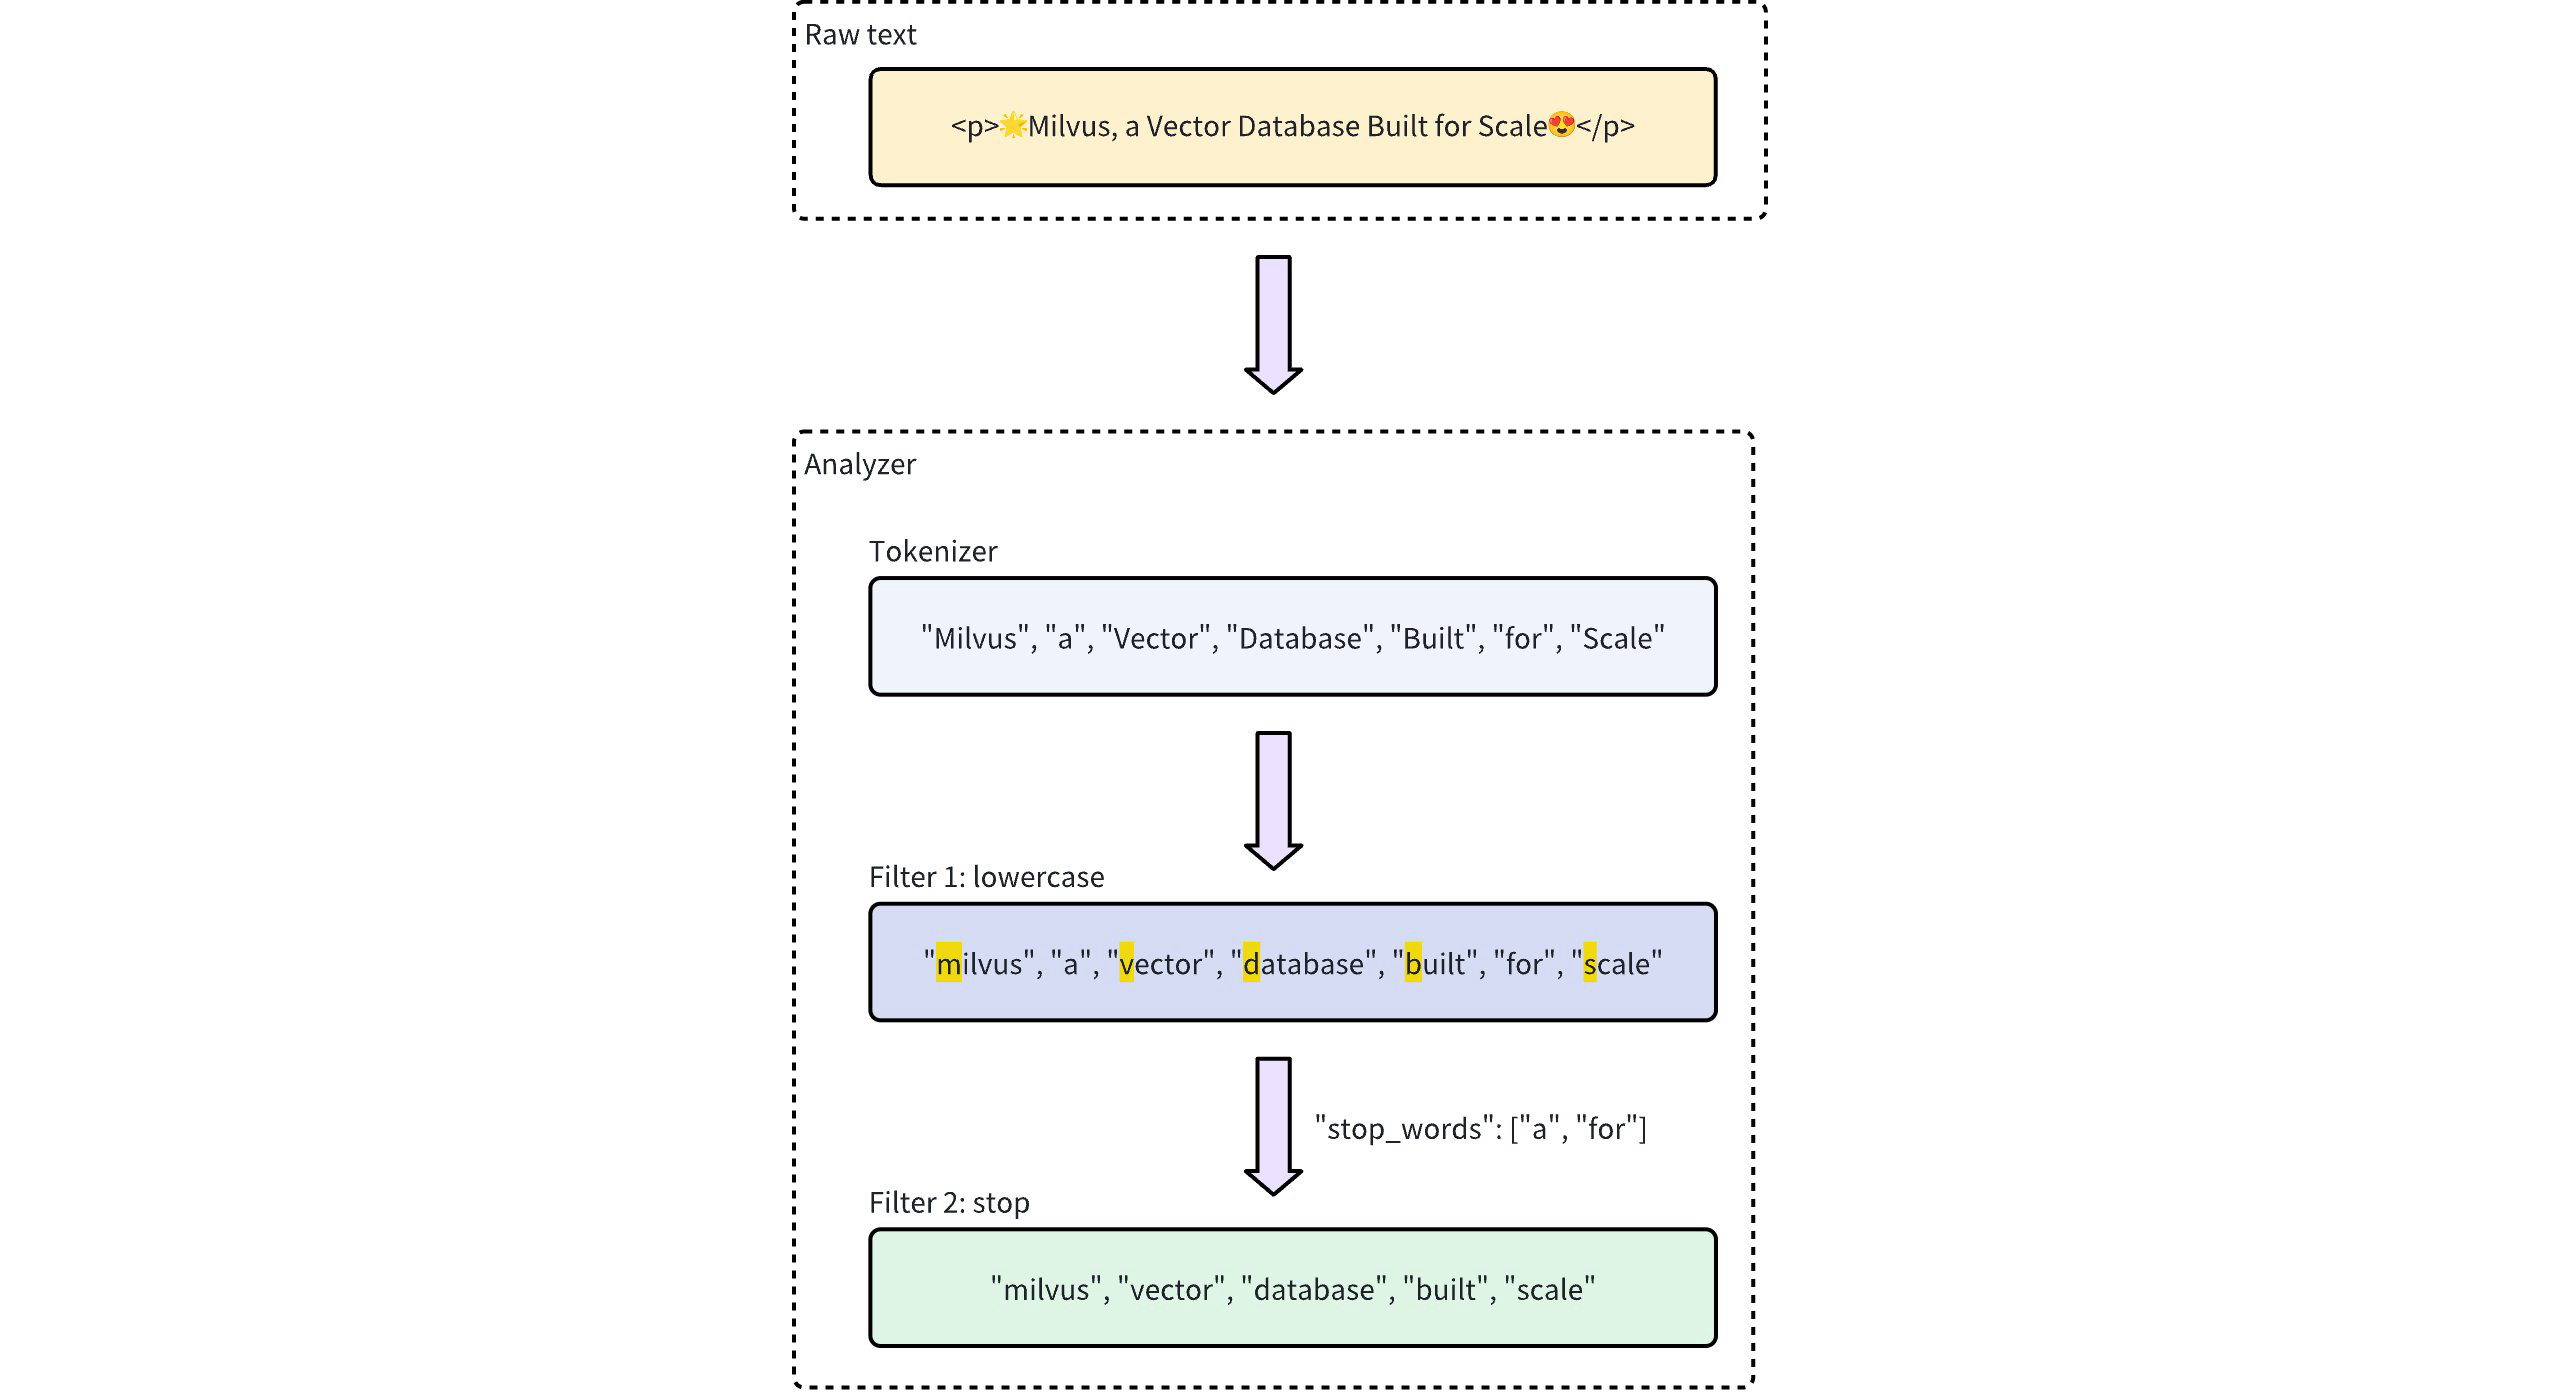 سير عمل عملية المحلل
أنواع المحللات
يوفر Milvus نوعين من المحللات لتلبية احتياجات معالجة النصوص المختلفة:
أداة التحليل المدمجة: وهي تكوينات محددة مسبقًا تغطي مهام معالجة النصوص الشائعة بأقل قدر من الإعداد. تعد أدوات التحليل المدمجة مثالية لعمليات البحث العامة، حيث إنها لا تتطلب أي تكوين معقد.
المحلل المخصص: بالنسبة للمتطلبات الأكثر تقدمًا، تتيح لك المحللات المخصصة تحديد التكوين الخاص بك عن طريق تحديد كل من أداة التقطيع (tokenizer) ومرشح واحد أو أكثر. ويُعد هذا المستوى من التخصيص مفيدًا بشكل خاص لحالات الاستخدام المتخصصة التي تتطلب تحكمًا دقيقًا في معالجة النصوص.
- إذا حذفت تكوينات المحلل أثناء إنشاء المجموعة، فسيستخدم Milvus محلل «
standard» لجميع عمليات معالجة النصوص بشكل افتراضي. لمزيد من التفاصيل، راجع «المحلل القياسي». - للحصول على أداء مثالي للبحث والاستعلام، اختر محللًا يتوافق مع لغة بياناتك النصية. على سبيل المثال، على الرغم من أن محلل «
standard» متعدد الاستخدامات، إلا أنه قد لا يكون الخيار الأفضل للغات ذات التراكيب النحوية الفريدة، مثل الصينية أو العربية أو التايلاندية أو اليابانية أو الكورية. في مثل هذه الحالات، استخدم محللًا خاصًا باللغة مثلchinese،arabic، أوthai، أو محللات مخصصة مع أدوات تجزئة متخصصة (مثلlindera،icu) ومرشحات يُوصى به بشدة لضمان تجزئة دقيقة ونتائج بحث أفضل.
المحلل المدمج
يتم تهيئة المحللات المدمجة في Milvus مسبقًا باستخدام أدوات تجزئة وفلاتر محددة، مما يتيح لك استخدامها على الفور دون الحاجة إلى تعريف هذه المكونات بنفسك. يعمل كل محلل مدمج كقالب يتضمن أداة تجزئة وفلاتر محددة مسبقًا، مع معلمات اختيارية للتخصيص.
على سبيل المثال، لاستخدام المحلل المدمج « standard »، ما عليك سوى تحديد اسمه « standard » كـ « type » (اسم المحلل)، وإدراج تكوينات إضافية اختيارية خاصة بنوع المحلل هذا، مثل « stop_words »:
analyzer_params = {
    "type": "standard", # Uses the standard built-in analyzer
    "stop_words": ["a", "an", "for"] # Defines a list of common words (stop words) to exclude from tokenization
}
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("type", "standard");
analyzerParams.put("stop_words", Arrays.asList("a", "an", "for"));
const analyzer_params = {
    "type": "standard", // Uses the standard built-in analyzer
    "stop_words": ["a", "an", "for"] // Defines a list of common words (stop words) to exclude from tokenization
};
analyzerParams := map[string]any{"type": "standard", "stop_words": []string{"a", "an", "for"}}
export analyzerParams='{
       "type": "standard",
       "stop_words": ["a", "an", "for"]
    }'
للتحقق من نتيجة تنفيذ المحلل، استخدم طريقة run_analyzer:
# Sample text to analyze
text = "An efficient system relies on a robust analyzer to correctly process text for various applications."

# Run analyzer
result = client.run_analyzer(
    text,
    analyzer_params
)
import io.milvus.v2.service.vector.request.RunAnalyzerReq;
import io.milvus.v2.service.vector.response.RunAnalyzerResp;

List<String> texts = new ArrayList<>();
texts.add("An efficient system relies on a robust analyzer to correctly process text for various applications.");

RunAnalyzerResp resp = client.runAnalyzer(RunAnalyzerReq.builder()
        .texts(texts)
        .analyzerParams(analyzerParams)
        .build());
List<RunAnalyzerResp.AnalyzerResult> results = resp.getResults();
// javascrip# Sample text to analyze
const text = "An efficient system relies on a robust analyzer to correctly process text for various applications."

// Run analyzer
const result = await client.run_analyzer({
    text,
    analyzer_params
});
import (
    "context"
    "encoding/json"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

bs, _ := json.Marshal(analyzerParams)
texts := []string{"An efficient system relies on a robust analyzer to correctly process text for various applications."}
option := milvusclient.NewRunAnalyzerOption(texts).
    WithAnalyzerParams(string(bs))

result, err := client.RunAnalyzer(ctx, option)
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
# restful
وستكون النتيجة كما يلي:
['efficient', 'system', 'relies', 'on', 'robust', 'analyzer', 'to', 'correctly', 'process', 'text', 'various', 'applications']
يوضح هذا أن المحلل يقوم بتجزئة النص المدخل بشكل صحيح عن طريق تصفية الكلمات الممنوعة "a" و "an" و "for" ، مع إرجاع الرموز ذات المعنى المتبقية.
إن تكوين المحلل المدمج standard أعلاه يعادل إعداد محلل مخصص بالمعلمات التالية، حيث تم تعريف الخيارين tokenizer و filter بشكل صريح لتحقيق وظيفة مماثلة:
analyzer_params = {
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stop",
            "stop_words": ["a", "an", "for"]
        }
    ]
}
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("tokenizer", "standard");
analyzerParams.put("filter",
        Arrays.asList("lowercase",
                new HashMap<String, Object>() {{
                    put("type", "stop");
                    put("stop_words", Arrays.asList("a", "an", "for"));
                }}));
const analyzer_params = {
    "tokenizer": "standard",
    "filter": [
        "lowercase",
        {
            "type": "stop",
            "stop_words": ["a", "an", "for"]
        }
    ]
};
analyzerParams = map[string]any{"tokenizer": "standard",
    "filter": []any{"lowercase", map[string]any{
        "type":       "stop",
        "stop_words": []string{"a", "an", "for"},
    }}}
export analyzerParams='{
       "type": "standard",
       "filter":  [
       "lowercase",
       {
            "type": "stop",
            "stop_words": ["a", "an", "for"]
       }
   ]
}'
يوفر Milvus المحللات المدمجة التالية، وقد صُمم كل منها لتلبية احتياجات معالجة نصية محددة:
standard: مناسب لمعالجة النصوص للأغراض العامة، مع تطبيق التقطيع القياسي وتصفية الأحرف الصغيرة.english: مُحسَّن للنصوص باللغة الإنجليزية، مع دعم الكلمات الممنوعة في اللغة الإنجليزية.chinese: متخصص في معالجة النصوص الصينية، بما في ذلك التقطيع المكيف ليتناسب مع هياكل اللغة الصينية.arabic: متخصص في النصوص العربية، مع توحيد النصوص العربية، وتوحيد الأرقام العشرية، واستخلاص الجذور العربية، وإزالة الكلمات الزائدة العربية.thai: متخصص في النصوص التايلاندية، مع تقطيع الكلمات التايلاندية، وتوحيد الأرقام العشرية، وإزالة الكلمات الزائدة التايلاندية.
المحلل المخصص
لمعالجة النصوص بشكل أكثر تقدمًا، تتيح لك أدوات التحليل المخصصة في Milvus إنشاء مسار معالجة نصوص مخصص من خلال تحديد كل من أداة التقطيع والمرشحات. يعد هذا الإعداد مثاليًّا لحالات الاستخدام المتخصصة التي تتطلب تحكمًا دقيقًا.
أداة تجزئة النص
أداة تجزئة النص هي مكون إلزامي للمحلل المخصص، حيث تبدأ مسار المحلل بتقسيم النص المدخل إلى وحدات منفصلة أو رموز. تتبع عملية تجزئة النص قواعد محددة، مثل التقسيم حسب المسافات البيضاء أو علامات الترقيم، اعتمادًا على نوع أداة تجزئة النص. تتيح هذه العملية معالجة أكثر دقة واستقلالية لكل كلمة أو عبارة.
على سبيل المثال، يقوم أداة التقطيع بتحويل النص "Vector Database Built for Scale" إلى رموز منفصلة:
["Vector", "Database", "Built", "for", "Scale"]
مثال على تحديد أداة تقسيم النص إلى رموز:
analyzer_params = {
    "tokenizer": "whitespace",
}
Map<String, Object> analyzerParams = new HashMap<>();
analyzerParams.put("tokenizer", "whitespace");
const analyzer_params = {
    "tokenizer": "whitespace",
};
analyzerParams = map[string]any{"tokenizer": "whitespace"}
export analyzerParams='{
       "type": "whitespace"
    }'
المرشح
تعدالمرشحات مكونات اختيارية تعمل على الرموز التي ينتجها أداة الترميز، حيث تقوم بتحويلها أو صقلها حسب الحاجة. على سبيل المثال، بعد تطبيق مرشح lowercase على المصطلحات التي تم ترميزها ["Vector", "Database", "Built", "for", "Scale"] ، قد تكون النتيجة:
["vector", "database", "built", "for", "scale"]
يمكن أن تكون المرشحات في المحلل المخصص إما مدمجة أو مخصصة، اعتمادًا على احتياجات التكوين.
المرشحات المدمجة: تم تكوينها مسبقًا بواسطة Milvus، ولا تتطلب سوى الحد الأدنى من الإعداد. يمكنك استخدام هذه المرشحات فورًا عن طريق تحديد أسمائها. المرشحات التالية مدمجة للاستخدام المباشر:
lowercase: يحول النص إلى أحرف صغيرة، مما يضمن مطابقة غير حساسة لحالة الأحرف. لمزيد من التفاصيل، راجع «الأحرف الصغيرة».asciifolding: يحول الأحرف غير التابعة لمعيار ASCII إلى ما يعادلها في معيار ASCII، مما يبسط معالجة النصوص متعددة اللغات. لمزيد من التفاصيل، راجع ASCII folding.alphanumonly: يحتفظ بالأحرف الأبجدية الرقمية فقط عن طريق إزالة الأحرف الأخرى. لمزيد من التفاصيل، راجع Alphanumonly.cnalphanumonly: يزيل الرموز التي تحتوي على أي أحرف بخلاف الأحرف الصينية أو الحروف الإنجليزية أو الأرقام. لمزيد من التفاصيل، راجع Cnalphanumonly.cncharonly: يزيل الرموز التي تحتوي على أي أحرف غير صينية. لمزيد من التفاصيل، راجع Cncharonly.pinyin: يضيف أشكال الرموز الصوتية (Pinyin) للرموز الصينية، مما يتيح المطابقة القائمة على نظام Pinyin للنص الصيني. لمزيد من التفاصيل، راجع Pinyin.
مثال على استخدام مرشح مدمج:
analyzer_params = {
    "tokenizer": "standard", # Mandatory: Specifies tokenizer
    "filter": ["lowercase"], # Optional: Built-in filter that converts text to lowercase
}
Map<String, Object> analyzerParams = new HashMap<>(); analyzerParams.put("tokenizer", "standard"); analyzerParams.put("filter", Collections.singletonList("lowercase"));const analyzer_params = { "tokenizer": "standard", // Mandatory: Specifies tokenizer "filter": ["lowercase"], // Optional: Built-in filter that converts text to lowercase }analyzerParams = map[string]any{"tokenizer": "standard", "filter": []any{"lowercase"}}export analyzerParams='{ "type": "standard", "filter": ["lowercase"] }'المرشحات المخصصة: تتيح المرشحات المخصصة إجراء تكوينات متخصصة. يمكنك تعريف مرشح مخصص عن طريق اختيار نوع مرشح صالح (
filter.type) وإضافة إعدادات محددة لكل نوع مرشح. أمثلة على أنواع المرشحات التي تدعم التخصيص:stop: يزيل الكلمات الشائعة المحددة عن طريق تعيين قائمة بالكلمات الممنوعة (على سبيل المثال،"stop_words": ["of", "to"]). لمزيد من التفاصيل، راجع «الكلمات الممنوعة».length: يستبعد الرموز بناءً على معايير الطول، مثل تعيين الحد الأقصى لطول الرمز. لمزيد من التفاصيل، راجع «الطول».stemmer: يحول الكلمات إلى صيغها الجذرية لمطابقة أكثر مرونة. لمزيد من التفاصيل، راجع «Stemmer».
مثال على تكوين مرشح مخصص:
analyzer_params = {
    "tokenizer": "standard", # Mandatory: Specifies tokenizer
    "filter": [
        {
            "type": "stop", # Specifies 'stop' as the filter type
            "stop_words": ["of", "to"], # Customizes stop words for this filter type
        }
    ]
}
Map<String, Object> analyzerParams = new HashMap<>(); analyzerParams.put("tokenizer", "standard"); analyzerParams.put("filter", Collections.singletonList(new HashMap<String, Object>() {{ put("type", "stop"); put("stop_words", Arrays.asList("a", "an", "for")); }}));const analyzer_params = { "tokenizer": "standard", // Mandatory: Specifies tokenizer "filter": [ { "type": "stop", // Specifies 'stop' as the filter type "stop_words": ["of", "to"], // Customizes stop words for this filter type } ] };analyzerParams = map[string]any{"tokenizer": "standard", "filter": []any{map[string]any{ "type": "stop", "stop_words": []string{"of", "to"}, }}}export analyzerParams='{ "type": "standard", "filter": [ { "type": "stop", "stop_words": ["a", "an", "for"] } ] }'
مثال على الاستخدام
في هذا المثال، ستقوم بإنشاء مخطط مجموعة يتضمن:
حقل متجه للتضمينات.
حقلين من نوع "
VARCHAR" لمعالجة النصوص:يستخدم أحد الحقول محللًا مدمجًا.
والآخر يستخدم محللًا مخصصًا.
قبل دمج هذه التكوينات في مجموعتك، ستتحقق من كل محلل باستخدام طريقة run_analyzer.
الخطوة 1: تهيئة MilvusClient وإنشاء مخطط
ابدأ بإعداد عميل Milvus وإنشاء مخطط جديد.
from pymilvus import MilvusClient, DataType

# Set up a Milvus client
client = MilvusClient(uri="http://localhost:19530")

# Create a new schema
schema = client.create_schema(auto_id=True, enable_dynamic_field=False)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.v2.common.IndexParam;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

// Set up a Milvus client
ConnectConfig config = ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build();
MilvusClientV2 client = new MilvusClientV2(config);

// Create schema
CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .enableDynamicField(false)
        .build();
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

// Set up a Milvus client
const client = new MilvusClient("http://localhost:19530");
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

cli, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: "localhost:19530",
})
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
defer client.Close(ctx)

schema := entity.NewSchema().WithAutoID(true).WithDynamicFieldEnabled(false)
# restful
الخطوة 2: تعريف تكوينات المحلل والتحقق منها
قم بتكوين وتحقق من محلل مدمج (
english):التكوين: حدد معلمات المحلل الخاص بالمحلل المدمج للغة الإنجليزية.
التحقق: استخدم
run_analyzerللتأكد من أن التكوين ينتج التقطيع إلى رموز (tokenization) المتوقع.
# Built-in analyzer configuration for English text processing
analyzer_params_built_in = {
    "type": "english"
}

# Verify built-in analyzer configuration
sample_text = "Milvus simplifies text analysis for search."
result = client.run_analyzer(sample_text, analyzer_params_built_in)
print("Built-in analyzer output:", result)

# Expected output:
# Built-in analyzer output: ['milvus', 'simplifi', 'text', 'analysi', 'search']
Map<String, Object> analyzerParamsBuiltin = new HashMap<>(); analyzerParamsBuiltin.put("type", "english"); List<String> texts = new ArrayList<>(); texts.add("Milvus simplifies text ana lysis for search."); RunAnalyzerResp resp = client.runAnalyzer(RunAnalyzerReq.builder() .texts(texts) .analyzerParams(analyzerParams) .build()); List<RunAnalyzerResp.AnalyzerResult> results = resp.getResults();// Use a built-in analyzer for VARCHAR field `title_en` const analyzerParamsBuiltIn = { type: "english", }; const sample_text = "Milvus simplifies text analysis for search."; const result = await client.run_analyzer({ text: sample_text, analyzer_params: analyzer_params_built_in });analyzerParams := map[string]any{"type": "english"} bs, _ := json.Marshal(analyzerParams) texts := []string{"Milvus simplifies text analysis for search."} option := milvusclient.NewRunAnalyzerOption(texts). WithAnalyzerParams(string(bs)) result, err := client.RunAnalyzer(ctx, option) if err != nil { fmt.Println(err.Error()) // handle error }# restfulتكوين وتحقق من محلل مخصص:
التكوين: حدد محللًا مخصصًا يستخدم أداة تجزئة قياسية إلى جانب مرشح مدمج لتحويل الأحرف إلى أحرف صغيرة ومرشحات مخصصة لطول الرموز والكلمات الممنوعة.
التحقق: استخدم
run_analyzerللتأكد من أن التكوين المخصص يعالج النص على النحو المقصود.
# Custom analyzer configuration with a standard tokenizer and custom filters
analyzer_params_custom = {
    "tokenizer": "standard",
    "filter": [
        "lowercase",  # Built-in filter: convert tokens to lowercase
        {
            "type": "length",  # Custom filter: restrict token length
            "max": 40
        },
        {
            "type": "stop",  # Custom filter: remove specified stop words
            "stop_words": ["of", "for"]
        }
    ]
}

# Verify custom analyzer configuration
sample_text = "Milvus provides flexible, customizable analyzers for robust text processing."
result = client.run_analyzer(sample_text, analyzer_params_custom)
print("Custom analyzer output:", result)

# Expected output:
# Custom analyzer output: ['milvus', 'provides', 'flexible', 'customizable', 'analyzers', 'robust', 'text', 'processing']
// Configure a custom analyzer Map<String, Object> analyzerParams = new HashMap<>(); analyzerParams.put("tokenizer", "standard"); analyzerParams.put("filter", Arrays.asList("lowercase", new HashMap<String, Object>() {{ put("type", "length"); put("max", 40); }}, new HashMap<String, Object>() {{ put("type", "stop"); put("stop_words", Arrays.asList("of", "for")); }} ) ); List<String> texts = new ArrayList<>(); texts.add("Milvus provides flexible, customizable analyzers for robust text processing."); RunAnalyzerResp resp = client.runAnalyzer(RunAnalyzerReq.builder() .texts(texts) .analyzerParams(analyzerParams) .build()); List<RunAnalyzerResp.AnalyzerResult> results = resp.getResults();// Configure a custom analyzer for VARCHAR field `title` const analyzerParamsCustom = { tokenizer: "standard", filter: [ "lowercase", { type: "length", max: 40, }, { type: "stop", stop_words: ["of", "to"], }, ], }; const sample_text = "Milvus provides flexible, customizable analyzers for robust text processing."; const result = await client.run_analyzer({ text: sample_text, analyzer_params: analyzer_params_built_in });analyzerParams = map[string]any{"tokenizer": "standard", "filter": []any{"lowercase", map[string]any{ "type": "length", "max": 40, map[string]any{ "type": "stop", "stop_words": []string{"of", "to"}, }}} bs, _ := json.Marshal(analyzerParams) texts := []string{"Milvus provides flexible, customizable analyzers for robust text processing."} option := milvusclient.NewRunAnalyzerOption(texts). WithAnalyzerParams(string(bs)) result, err := client.RunAnalyzer(ctx, option) if err != nil { fmt.Println(err.Error()) // handle error }# curl
الخطوة 3: إضافة حقول إلى المخطط
الآن بعد أن قمت بالتحقق من تكوينات أداة التحليل الخاصة بك، أضفها إلى حقول المخطط الخاص بك:
# Add VARCHAR field 'title_en' using the built-in analyzer configuration
schema.add_field(
    field_name='title_en',
    datatype=DataType.VARCHAR,
    max_length=1000,
    enable_analyzer=True,
    analyzer_params=analyzer_params_built_in,
    enable_match=True,
)

# Add VARCHAR field 'title' using the custom analyzer configuration
schema.add_field(
    field_name='title',
    datatype=DataType.VARCHAR,
    max_length=1000,
    enable_analyzer=True,
    analyzer_params=analyzer_params_custom,
    enable_match=True,
)

# Add a vector field for embeddings
schema.add_field(field_name="embedding", datatype=DataType.FLOAT_VECTOR, dim=3)

# Add a primary key field
schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True)
schema.addField(AddFieldReq.builder()
        .fieldName("title")
        .dataType(DataType.VarChar)
        .maxLength(1000)
        .enableAnalyzer(true)
        .analyzerParams(analyzerParams)
        .enableMatch(true) // must enable this if you use TextMatch
        .build());

// Add vector field
schema.addField(AddFieldReq.builder()
        .fieldName("embedding")
        .dataType(DataType.FloatVector)
        .dimension(3)
        .build());
// Add primary field
schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());
// Create schema
const schema = {
  auto_id: true,
  fields: [
    {
      name: "id",
      type: DataType.INT64,
      is_primary: true,
    },
    {
      name: "title_en",
      data_type: DataType.VARCHAR,
      max_length: 1000,
      enable_analyzer: true,
      analyzer_params: analyzerParamsBuiltIn,
      enable_match: true,
    },
    {
      name: "title",
      data_type: DataType.VARCHAR,
      max_length: 1000,
      enable_analyzer: true,
      analyzer_params: analyzerParamsCustom,
      enable_match: true,
    },
    {
      name: "embedding",
      data_type: DataType.FLOAT_VECTOR,
      dim: 4,
    },
  ],
};
schema.WithField(entity.NewField().
    WithName("id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(true),
).WithField(entity.NewField().
    WithName("embedding").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(3),
).WithField(entity.NewField().
    WithName("title").
    WithDataType(entity.FieldTypeVarChar).
    WithMaxLength(1000).
    WithEnableAnalyzer(true).
    WithAnalyzerParams(analyzerParams).
    WithEnableMatch(true),
)
# restful
الخطوة 4: إعداد معلمات الفهرس وإنشاء المجموعة
# Set up index parameters for the vector field
index_params = client.prepare_index_params()
index_params.add_index(field_name="embedding", metric_type="COSINE", index_type="AUTOINDEX")

# Create the collection with the defined schema and index parameters
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
// Set up index params for vector field
List<IndexParam> indexes = new ArrayList<>();
indexes.add(IndexParam.builder()
        .fieldName("embedding")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.COSINE)
        .build());

// Create collection with defined schema
CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
// Set up index params for vector field
const indexParams = [
  {
    name: "embedding",
    metric_type: "COSINE",
    index_type: "AUTOINDEX",
  },
];

// Create collection with defined schema
await client.createCollection({
  collection_name: "my_collection",
  schema: schema,
  index_params: indexParams,
});

console.log("Collection created successfully!");
idx := index.NewAutoIndex(index.MetricType(entity.COSINE))
indexOption := milvusclient.NewCreateIndexOption("my_collection", "embedding", idx)

err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
# restful
الخطوة التالية
بعد تكوين المحلل، يمكنك التكامل مع ميزات استرجاع النص التي يوفرها Milvus. لمزيد من التفاصيل:
