

المتجه الكثيف
المتجهات الكثيفة هي تمثيلات للبيانات العددية تُستخدم على نطاق واسع في التعلم الآلي وتحليل البيانات. وهي تتكون من مصفوفات تحتوي على أعداد حقيقية، حيث تكون معظم العناصر أو جميعها غير صفرية. وبالمقارنة مع المتجهات المتفرقة، تحتوي المتجهات الكثيفة على معلومات أكثر في نفس مستوى الأبعاد، حيث يحتوي كل بُعد على قيم ذات مغزى. يمكن لهذا التمثيل التقاط الأنماط والعلاقات المعقدة بفعالية، مما يجعل تحليل البيانات ومعالجتها أسهل في الفضاءات عالية الأبعاد. عادةً ما يكون للمتجهات الكثيفة عدد ثابت من الأبعاد، يتراوح بين بضع عشرات إلى عدة مئات أو حتى آلاف، اعتمادًا على التطبيق والمتطلبات المحددة.
تُستخدم المتجهات الكثيفة بشكل رئيسي في السيناريوهات التي تتطلب فهم دلالات البيانات، مثل البحث الدلالي وأنظمة التوصيات. في البحث الدلالي، تساعد المتجهات الكثيفة في التقاط الروابط الكامنة بين الاستعلامات والمستندات، مما يحسّن مدى صلة نتائج البحث. وفي أنظمة التوصيات، تساعد في تحديد أوجه التشابه بين المستخدمين والعناصر، مما يوفر اقتراحات أكثر تخصيصًا.
نظرة عامة
يتم تمثيل المتجهات الكثيفة عادةً كمصفوفات من الأعداد العائمة ذات الطول الثابت، مثل [0.2, 0.7, 0.1, 0.8, 0.3, ..., 0.5]. تتراوح أبعاد هذه المتجهات عادةً من المئات إلى الآلاف، مثل 128 أو 256 أو 768 أو 1024. يستوعب كل بُعد سمات دلالية محددة لكائن ما، مما يجعله قابلاً للتطبيق في سيناريوهات متنوعة من خلال حسابات التشابه.
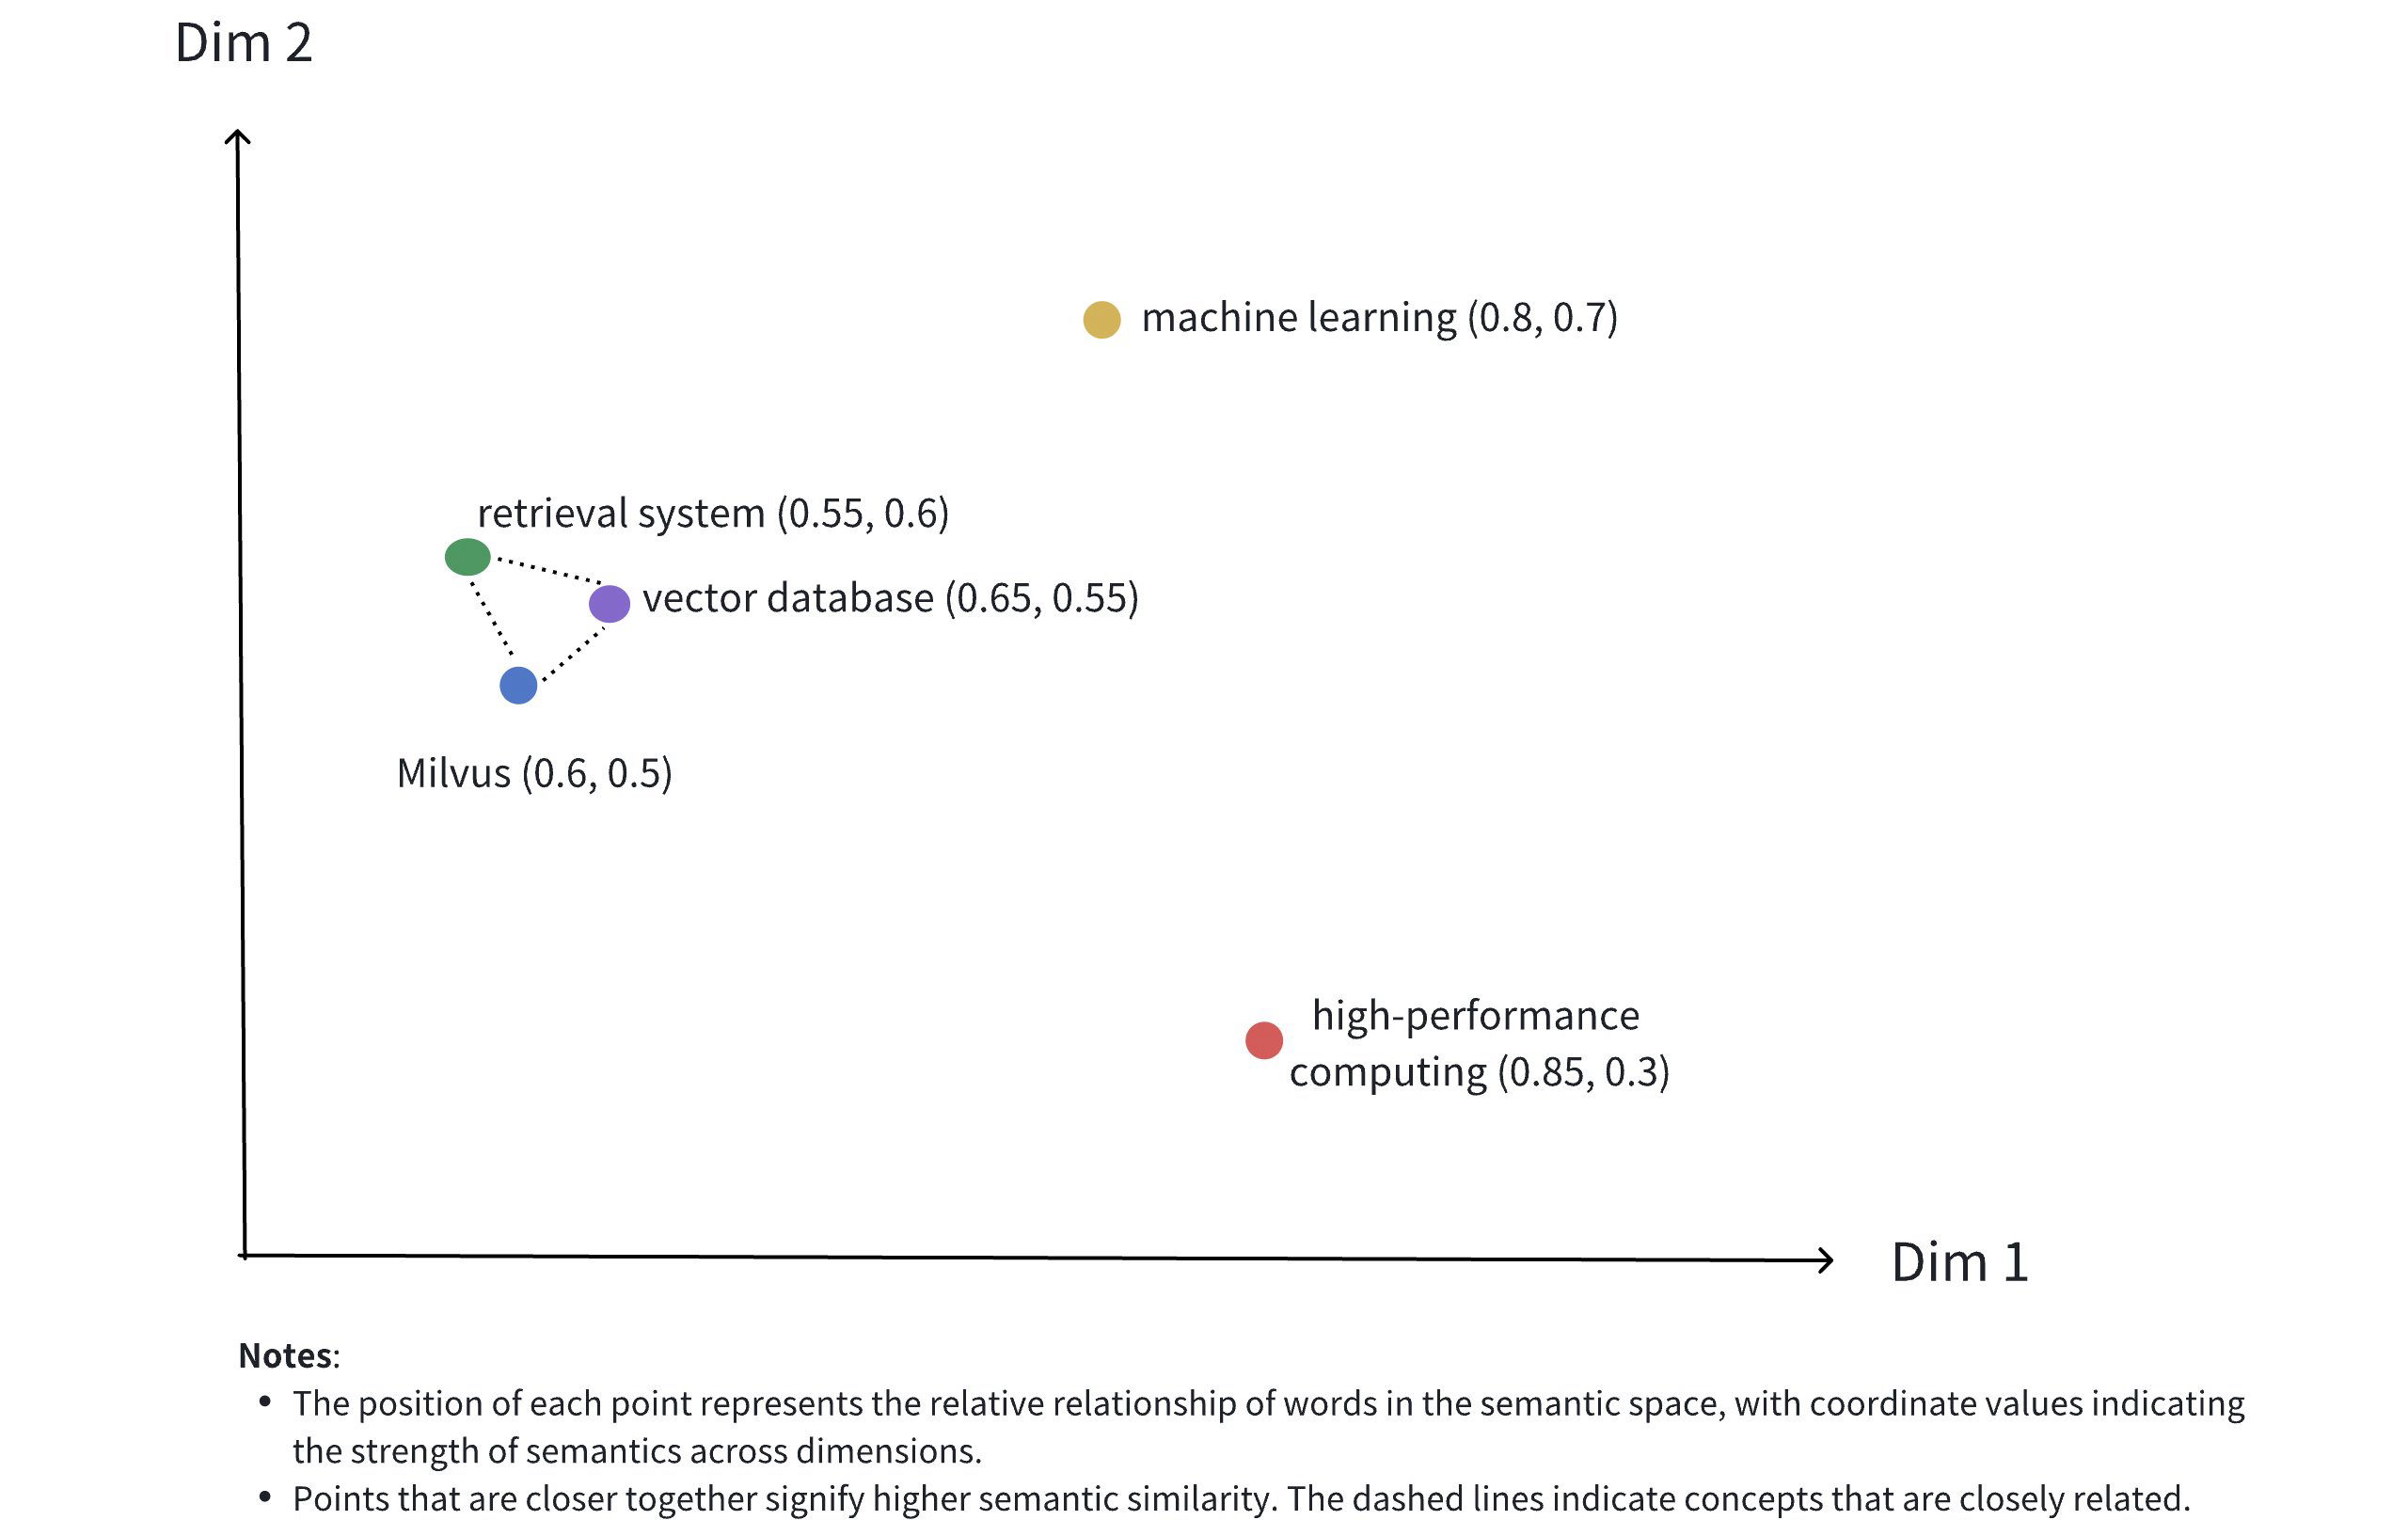 المتجه الكثيف
توضح الصورة أعلاه تمثيل المتجهات الكثيفة في فضاء ثنائي الأبعاد. على الرغم من أن المتجهات الكثيفة في التطبيقات الواقعية غالبًا ما تكون ذات أبعاد أعلى بكثير، فإن هذا التوضيح ثنائي الأبعاد ينقل بشكل فعال عدة مفاهيم أساسية:
التمثيل متعدد الأبعاد: تمثل كل نقطة كائنًا مفاهيميًّا (مثل Milvus، وقاعدة بيانات المتجهات، ونظام الاسترجاع، وما إلى ذلك)، حيث يتم تحديد موقعها من خلال قيم أبعادها.
العلاقات الدلالية: تعكس المسافات بين النقاط التشابه الدلالي بين المفاهيم. تشير النقاط الأقرب إلى مفاهيم أكثر ارتباطًا من الناحية الدلالية.
تأثير التجميع: تُوضع المفاهيم ذات الصلة (مثل Milvus وقاعدة البيانات المتجهة ونظام الاسترجاع) بالقرب من بعضها البعض في الفضاء، لتشكل مجموعة دلالية.
فيما يلي مثال على متجه كثيف حقيقي يمثل النص « "Milvus is an efficient vector database" »:
[
    -0.013052909,
    0.020387933,
    -0.007869,
    -0.11111383,
    -0.030188112,
    -0.0053388323,
    0.0010654867,
    0.072027855,
    // ... more dimensions
]
يمكن إنشاء المتجهات الكثيفة باستخدام نماذج تضمين متنوعة، مثل نماذج الشبكات العصبية التلافيفية (CNN) (مثل ResNet و VGG) للصور ونماذج اللغة (مثل BERT و Word2Vec) للنصوص. تعمل هذه النماذج على تحويل البيانات الأولية إلى نقاط في فضاء عالي الأبعاد، مما يتيح التقاط السمات الدلالية للبيانات. بالإضافة إلى ذلك، يوفر Milvus طرقًا ملائمة لمساعدة المستخدمين على إنشاء المتجهات الكثيفة ومعالجتها، كما هو موضح بالتفصيل في قسم «التضمينات».
بمجرد تحويل البيانات إلى متجهات، يمكن تخزينها في Milvus لإدارتها واسترجاع المتجهات. يوضح الرسم البياني أدناه العملية الأساسية.
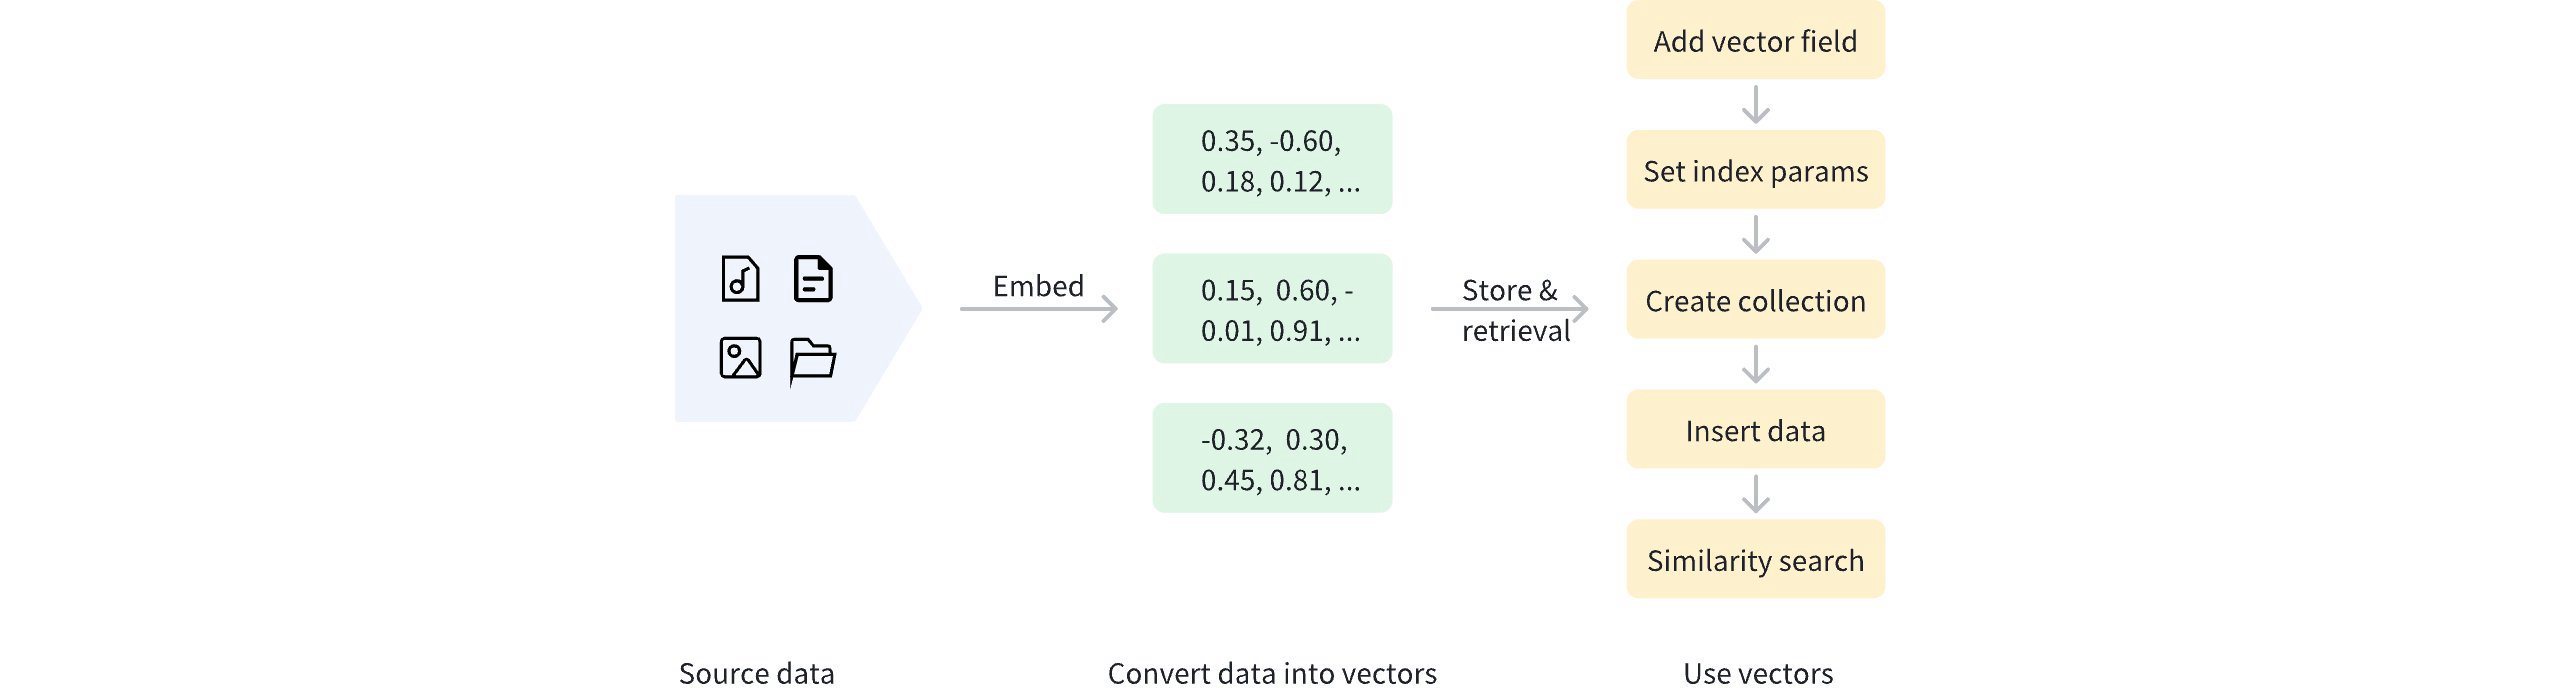 استخدام المتجهات الكثيفة
إلى جانب المتجهات الكثيفة، يدعم Milvus أيضًا المتجهات المتفرقة والمتجهات الثنائية. تعد المتجهات المتفرقة مناسبة للمطابقات الدقيقة بناءً على مصطلحات محددة، مثل البحث عن الكلمات المفتاحية ومطابقة المصطلحات، بينما تُستخدم المتجهات الثنائية عادةً للتعامل بكفاءة مع البيانات الثنائية، مثل مطابقة أنماط الصور وبعض تطبيقات التجزئة. لمزيد من المعلومات، راجع «المتجهات الثنائية» و«المتجهات المتفرقة».
استخدام المتجهات الكثيفة
إضافة حقل متجهات
لاستخدام المتجهات الكثيفة في Milvus، قم أولاً بتعريف حقل متجه لتخزين المتجهات الكثيفة عند إنشاء مجموعة. تتضمن هذه العملية ما يلي:
تعيين `
datatype` إلى نوع بيانات متجه كثيف مدعوم. للاطلاع على أنواع بيانات المتجهات الكثيفة المدعومة، راجع أنواع البيانات.تحديد أبعاد المتجه الكثيف باستخدام المعلمة
dim.
في المثال أدناه، نضيف حقل متجهًا باسم dense_vector لتخزين المتجهات الكثيفة. نوع بيانات الحقل هو FLOAT_VECTOR ، وبأبعاد 4.
from pymilvus import MilvusClient, DataType

client = MilvusClient(uri="http://localhost:19530")

schema = client.create_schema(
    auto_id=True,
    enable_dynamic_fields=True,
)

schema.add_field(field_name="pk", datatype=DataType.VARCHAR, is_primary=True, max_length=100)
schema.add_field(field_name="dense_vector", datatype=DataType.FLOAT_VECTOR, dim=4)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

CreateCollectionReq.CollectionSchema schema = client.createSchema();
schema.setEnableDynamicField(true);
schema.addField(AddFieldReq.builder()
        .fieldName("pk")
        .dataType(DataType.VarChar)
        .isPrimaryKey(true)
        .autoID(true)
        .maxLength(100)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("dense_vector")
        .dataType(DataType.FloatVector)
        .dimension(4)
        .build());
import { DataType } from "@zilliz/milvus2-sdk-node";

schema.push({
  name: "dense_vector",
  data_type: DataType.FloatVector,
  dim: 4,
});
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

schema := entity.NewSchema()
schema.WithField(entity.NewField().
    WithName("pk").
    WithDataType(entity.FieldTypeVarChar).
    WithIsPrimaryKey(true).
    WithIsAutoID(true).
    WithMaxLength(100),
).WithField(entity.NewField().
    WithName("dense_vector").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(4),
)
export primaryField='{
    "fieldName": "pk",
    "dataType": "VarChar",
    "isPrimary": true,
    "elementTypeParams": {
        "max_length": 100
    }
}'

export vectorField='{
    "fieldName": "dense_vector",
    "dataType": "FloatVector",
    "elementTypeParams": {
        "dim": 4
    }
}'

export schema="{
    \"autoID\": true,
    \"fields\": [
        $primaryField,
        $vectorField
    ]
}"
أنواع البيانات المدعومة لحقول المتجهات الكثيفة:
نوع البيانات |
الوصف |
|---|---|
|
يخزن أرقامًا عائمة ذات 32 بت، تُستخدم عادةً لتمثيل الأعداد الحقيقية في الحسابات العلمية والتعلم الآلي. مثالي للسيناريوهات التي تتطلب دقة عالية، مثل التمييز بين المتجهات المتشابهة. |
|
يخزن أرقامًا ذات 16 بت بنقطة عائمة نصف الدقة، وتُستخدم في التعلم العميق وحسابات وحدة معالجة الرسومات (GPU). يوفر مساحة تخزين في السيناريوهات التي تكون فيها الدقة أقل أهمية، مثل مرحلة الاسترجاع منخفضة الدقة في أنظمة التوصيات. |
|
يخزن أرقام Brain Floating Point (bfloat16) ذات 16 بت، ويوفر نفس نطاق الأسس مثل Float32 ولكن بدقة أقل. مناسب للسيناريوهات التي تحتاج إلى معالجة كميات كبيرة من المتجهات بسرعة، مثل استرجاع الصور على نطاق واسع. |
|
يخزن المتجهات التي تكون عناصرها الفردية في كل بُعد أعدادًا صحيحة ذات 8 بت (int8)، حيث يتراوح كل عنصر بين –128 و127. صُمم INT8_VECTOR لنماذج التعلم العميق المُكمَّنة (مثل ResNet و EfficientNet)، حيث يقلل من حجم النموذج ويسرع عملية الاستدلال مع الحد الأدنى من فقدان الدقة. |
تعيين معلمات الفهرس لحقل المتجهات
لتسريع عمليات البحث الدلالي، يجب إنشاء فهرس لحقل المتجهات. يمكن أن تؤدي الفهرسة إلى تحسين كفاءة استرجاع البيانات المتجهة واسعة النطاق بشكل كبير.
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="dense_vector",
    index_name="dense_vector_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)
import io.milvus.v2.common.IndexParam;
import java.util.*;

List<IndexParam> indexes = new ArrayList<>();

indexes.add(IndexParam.builder()
        .fieldName("dense_vector")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build());
import { MetricType, IndexType } from "@zilliz/milvus2-sdk-node";

const indexParams = {
    index_name: 'dense_vector_index',
    field_name: 'dense_vector',
    metric_type: MetricType.IP,
    index_type: IndexType.AUTOINDEX
};
idx := index.NewAutoIndex(index.MetricType(entity.IP))
indexOption := milvusclient.NewCreateIndexOption("my_collection", "dense_vector", idx)
export indexParams='[
        {
            "fieldName": "dense_vector",
            "metricType": "IP",
            "indexName": "dense_vector_index",
            "indexType": "AUTOINDEX"
        }
    ]'
في المثال أعلاه، تم إنشاء فهرس باسم dense_vector_index لحقل dense_vector باستخدام نوع الفهرس AUTOINDEX. تم تعيين metric_type على IP ، مما يشير إلى أنه سيتم استخدام حاصل الضرب الداخلي كمقياس للمسافة.
يوفر Milvus أنواعًا متنوعة من الفهارس لتجربة بحث متجهية أفضل. AUTOINDEX هو نوع فهرس خاص مصمم لتسهيل عملية تعلم البحث المتجهي. هناك العديد من أنواع الفهارس المتاحة لتختار منها. لمزيد من التفاصيل، راجع شرح الفهارس.
يدعم Milvus أنواعًا أخرى من المقاييس. لمزيد من المعلومات، راجع أنواع المقاييس.
إنشاء مجموعة
بمجرد اكتمال إعدادات المتجهات الكثيفة ومعلمات الفهرس، يمكنك إنشاء مجموعة تحتوي على متجهات كثيفة. يستخدم المثال أدناه طريقة ` create_collection ` لإنشاء مجموعة باسم ` my_collection`.
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
import { MilvusClient } from "@zilliz/milvus2-sdk-node";

const client = new MilvusClient({
    address: 'http://localhost:19530'
});

await client.createCollection({
    collection_name: 'my_collection',
    schema: schema,
    index_params: indexParams
});
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
إدراج البيانات
بعد إنشاء المجموعة، استخدم طريقة insert لإضافة بيانات تحتوي على متجهات كثيفة. تأكد من أن أبعاد المتجهات الكثيفة التي يتم إدراجها تتطابق مع قيمة dim المحددة عند إضافة حقل المتجهات الكثيفة.
data = [
    {"dense_vector": [0.1, 0.2, 0.3, 0.7]},
    {"dense_vector": [0.2, 0.3, 0.4, 0.8]},
]

client.insert(
    collection_name="my_collection",
    data=data
)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;
import io.milvus.v2.service.vector.response.InsertResp;

List<JsonObject> rows = new ArrayList<>();
Gson gson = new Gson();
rows.add(gson.fromJson("{\"dense_vector\": [0.1, 0.2, 0.3, 0.4]}", JsonObject.class));
rows.add(gson.fromJson("{\"dense_vector\": [0.2, 0.3, 0.4, 0.5]}", JsonObject.class));

InsertResp insertR = client.insert(InsertReq.builder()
        .collectionName("my_collection")
        .data(rows)
        .build());
const data = [
  { dense_vector: [0.1, 0.2, 0.3, 0.7] },
  { dense_vector: [0.2, 0.3, 0.4, 0.8] },
];

client.insert({
  collection_name: "my_collection",
  data: data,
});
_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("my_collection").
    WithFloatVectorColumn("dense_vector", 4, [][]float32{
        {0.1, 0.2, 0.3, 0.7},
        {0.2, 0.3, 0.4, 0.8},
    }),
)
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "data": [
        {"dense_vector": [0.1, 0.2, 0.3, 0.4]},
        {"dense_vector": [0.2, 0.3, 0.4, 0.5]}
    ],
    "collectionName": "my_collection"
}'

## {"code":0,"cost":0,"data":{"insertCount":2,"insertIds":["453577185629572531","453577185629572532"]}}
إجراء بحث التشابه
يعد البحث الدلالي القائم على المتجهات الكثيفة إحدى الميزات الأساسية لـ Milvus، حيث يتيح لك العثور بسرعة على البيانات الأكثر تشابهًا مع متجه الاستعلام استنادًا إلى المسافة بين المتجهات. لإجراء بحث التشابه، قم بإعداد متجه الاستعلام ومعلمات البحث، ثم استدعِ الطريقة search.
search_params = {
    "params": {"nprobe": 10}
}

query_vector = [0.1, 0.2, 0.3, 0.7]

res = client.search(
    collection_name="my_collection",
    data=[query_vector],
    anns_field="dense_vector",
    search_params=search_params,
    limit=5,
    output_fields=["pk"]
)

print(res)

# Output
# data: ["[{'id': '453718927992172271', 'distance': 0.7599999904632568, 'entity': {'pk': '453718927992172271'}}, {'id': '453718927992172270', 'distance': 0.6299999952316284, 'entity': {'pk': '453718927992172270'}}]"]
import io.milvus.v2.service.vector.request.data.FloatVec;

Map<String,Object> searchParams = new HashMap<>();
searchParams.put("nprobe",10);

FloatVec queryVector = new FloatVec(new float[]{0.1f, 0.3f, 0.3f, 0.4f});

SearchResp searchR = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryVector))
        .annsField("dense_vector")
        .searchParams(searchParams)
        .topK(5)
        .outputFields(Collections.singletonList("pk"))
        .build());

System.out.println(searchR.getSearchResults());

// Output
//
// [[SearchResp.SearchResult(entity={pk=453444327741536779}, score=0.65, id=453444327741536779), SearchResp.SearchResult(entity={pk=453444327741536778}, score=0.65, id=453444327741536778)]]
query_vector = [0.1, 0.2, 0.3, 0.7];

client.search({
    collection_name: 'my_collection',
    data: query_vector,
    limit: 5,
    output_fields: ['pk'],
    params: {
        nprobe: 10
    }
});
queryVector := []float32{0.1, 0.2, 0.3, 0.7}

annParam := index.NewCustomAnnParam()
annParam.WithExtraParam("nprobe", 10)
resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    5,                     // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("dense_vector").
    WithOutputFields("pk").
    WithAnnParam(annParam))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("Pks: ", resultSet.GetColumn("pk").FieldData().GetScalars())
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": [
        [0.1, 0.2, 0.3, 0.7]
    ],
    "annsField": "dense_vector",
    "limit": 5,
    "searchParams":{
        "params":{"nprobe":10}
    },
    "outputFields": ["pk"]
}'

## {"code":0,"cost":0,"data":[{"distance":0.55,"id":"453577185629572532","pk":"453577185629572532"},{"distance":0.42,"id":"453577185629572531","pk":"453577185629572531"}]}
لمزيد من المعلومات حول معلمات البحث عن التشابه، راجع " البحث الأساسي بشبكة ANN".
