

Schema详解
Schema定义了Collection的数据结构。在创建Collection之前,您需要先设计好其Schema。本页面将帮助您理解Collection Schema,并独立设计一个示例Schema。
概述
在 Milvus 中,Schema 相当于关系型数据库中的表,它定义了 Milvus 如何组织 Collection 中的数据。
设计良好的Schema至关重要,因为它抽象了数据模型,并决定了您能否通过搜索实现业务目标。此外,由于插入Collection的每一行数据都必须遵循Schema,因此它有助于维护数据的一致性和长期质量。 从技术角度来看,定义明确的Schema能带来井然有序的列数据存储和更简洁的索引结构,从而提升搜索性能。
Collection模式包含一个主键、至少一个向量字段以及多个标量字段。下图展示了如何将一篇文章映射到一组Schema字段。
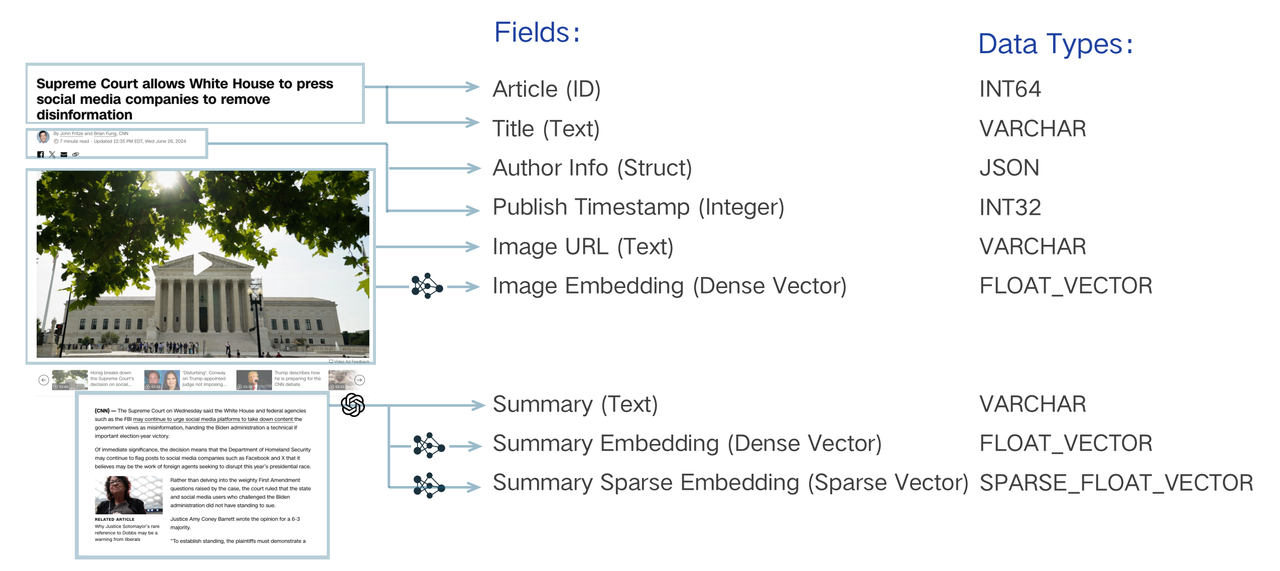 模式设计解析
搜索系统的数据模型设计涉及分析业务需求,并将信息抽象为以Schema表达的数据模型。例如,对一段文本进行搜索时,必须通过“嵌入”将字符串转换为向量,从而实现向量搜索。 除了这一基本要求外,可能还需要存储其他属性,例如发布时间戳和作者。这些元数据允许通过过滤来优化语义搜索,仅返回特定日期之后发布的文本或特定作者的文本。 您还可以将这些标量与正文一起检索,以便在应用程序中呈现搜索结果。应为每个元素分配一个唯一的标识符(以整数或字符串形式表示)来组织这些文本片段。这些元素对于实现复杂的搜索逻辑至关重要。
请参阅《Schema设计实践指南》,了解如何设计一个结构合理的Schema。
创建Schema
以下代码片段演示了如何创建Schema。
from pymilvus import MilvusClient, DataType

schema = MilvusClient.create_schema()
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq.CollectionSchema schema = client.createSchema();
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const schema = []
import "github.com/milvus-io/milvus/client/v2/entity"

schema := entity.NewSchema()
export schema='{
    "fields": []
}'
添加主键字段
Collection 中的主键字段用于唯一标识一个实体。它仅接受Int64或VARCHAR类型的值。以下代码片段演示了如何添加主键字段。
schema.add_field(
    field_name="my_id",
    datatype=DataType.INT64,
    is_primary=True,
    auto_id=False,
)
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;

schema.addField(AddFieldReq.builder()
        .fieldName("my_id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(false)
        .build());
schema.push({
    name: "my_id",
    data_type: DataType.Int64,
    is_primary_key: true,
    autoID: false
});
schema.WithField(entity.NewField().WithName("my_id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(false),
)
export primaryField='{
    "fieldName": "my_id",
    "dataType": "Int64",
    "isPrimary": true
}'

export schema='{
    \"autoID\": false,
    \"fields\": [
        $primaryField
    ]
}'
在添加字段时,您可以通过将字段的 `is_primary ` 属性设置为 `True` 来显式指定该字段为主键字段。主键字段默认接受`Int64`值。在此情况下,主键字段的值应为类似于 `12345` 的整数。如果您选择在主键字段中使用`VARCHAR`值,则该值应为类似于 `my_entity_1234` 的字符串。
您还可以将autoId 属性设置为True ,以便 Milvus 在插入数据时自动分配主字段值。
建议在所有情况下都依赖autoId ,除非手动设置主键更有益。
有关详细信息,请参阅“主字段与 AutoId”。
添加向量字段
向量字段支持各种稀疏和稠密向量嵌入。在 Milvus 上,您可以向 Collection 中添加四个向量字段。以下代码片段演示了如何添加向量字段。
schema.add_field(
    field_name="my_vector",
    datatype=DataType.FLOAT_VECTOR,
    dim=5
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_vector")
        .dataType(DataType.FloatVector)
        .dimension(5)
        .build());
schema.push({
    name: "my_vector",
    data_type: DataType.FloatVector,
    dim: 5
});
schema.WithField(entity.NewField().WithName("my_vector").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(5),
)
export vectorField='{
    "fieldName": "my_vector",
    "dataType": "FloatVector",
    "elementTypeParams": {
        "dim": 5
    }
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField
    ]
}"
上述代码片段中的dim 参数指定了向量字段中将要存储的向量嵌入的维度。FLOAT_VECTOR 值表示该向量字段包含一个 32 位浮点数的列表,这些数值通常用于表示反对数。此外,Milvus 还支持以下类型的向量嵌入:
FLOAT16_VECTOR此类向量字段包含一个 16 位半精度浮点数列表,通常适用于内存或带宽受限的深度学习或基于 GPU 的计算场景。
BFLOAT16_VECTOR此类向量字段包含一组 16 位浮点数,其精度虽有所降低,但指数范围与 Float32 相同。此类数据常用于深度学习场景,因为它能在不显著影响精度的同时减少内存占用。
INT8_VECTOR此类向量字段存储由 8 位有符号整数(int8)组成的向量,每个分量的取值范围为 –128 到 127。 该类型专为量化深度学习架构(如 ResNet 和 EfficientNet)量身定制,可在仅造成极小精度损失的同时,大幅缩减模型大小并提升推理速度。注意:此向量类型仅支持 HNSW 索引。
BINARY_VECTOR此类向量字段包含一组由 0 和 1 组成的列表。它们在图像处理和信息检索场景中作为紧凑特征来表示数据。
SPARSE_FLOAT_VECTOR此类向量字段包含一组非零数值及其序列号,用于表示稀疏向量Embeddings。
添加标量字段
在常见情况下,您可以使用标量字段存储保存在 Milvus 中的向量 Embeddings 的元数据,并通过元数据过滤进行人工神经网络(ANN)搜索,以提高搜索结果的准确性。Milvus 支持多种标量字段类型,包括VARCHAR、Boolean、Int、Float 和Double。
添加 VARCHAR 字段
在 Milvus 中,您可以使用 `VARCHAR ` 字段来存储字符串。有关 `VARCHAR ` 字段的更多信息,请参阅VarChar 字段。
schema.add_field(
    field_name="my_varchar",
    datatype=DataType.VARCHAR,
    max_length=512
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_varchar")
        .dataType(DataType.VarChar)
        .maxLength(512)
        .build());
schema.push({
    name: "my_varchar",
    data_type: DataType.VarChar,
    max_length: 512
});
schema.WithField(entity.NewField().WithName("my_varchar").
    WithDataType(entity.FieldTypeVarChar).
    WithMaxLength(512),
)
export varCharField='{
    "fieldName": "my_varchar",
    "dataType": "VarChar",
    "elementTypeParams": {
        "max_length": 512
    }
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField
    ]
}"
添加数值字段
Milvus 支持的数值类型包括Int8 、Int16 、Int32 、Int64 、Float 和Double 。有关数值字段的更多信息,请参阅《数值字段》。
schema.add_field(
    field_name="my_int64",
    datatype=DataType.INT64,
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_int64")
        .dataType(DataType.Int64)
        .build());
schema.push({
    name: "my_int64",
    data_type: DataType.Int64,
});
schema.WithField(entity.NewField().WithName("my_int64").
    WithDataType(entity.FieldTypeInt64),
)
export int64Field='{
    "fieldName": "my_int64",
    "dataType": "Int64"
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField,
        $int64Field
    ]
}"
添加布尔字段
Milvus 支持布尔字段。以下代码片段演示了如何添加布尔字段。
schema.add_field(
    field_name="my_bool",
    datatype=DataType.BOOL,
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_bool")
        .dataType(DataType.Bool)
        .build());
schema.push({
    name: "my_bool",
    data_type: DataType.Boolean,
});
schema.WithField(entity.NewField().WithName("my_bool").
    WithDataType(entity.FieldTypeBool),
)
export boolField='{
    "fieldName": "my_bool",
    "dataType": "Boolean"
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField,
        $int64Field,
        $boolField
    ]
}"
添加复合字段
在 Milvus 中,复合字段是指可以划分为更小子字段的字段,例如 JSON 字段中的键或数组字段中的索引。
添加 JSON 字段
JSON 字段通常用于存储半结构化 JSON 数据。有关 JSON 字段的更多信息,请参阅JSON 字段。
schema.add_field(
    field_name="my_json",
    datatype=DataType.JSON,
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_json")
        .dataType(DataType.JSON)
        .build());
schema.push({
    name: "my_json",
    data_type: DataType.JSON,
});
schema.WithField(entity.NewField().WithName("my_json").
    WithDataType(entity.FieldTypeJSON),
)
export jsonField='{
    "fieldName": "my_json",
    "dataType": "JSON"
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField,
        $int64Field,
        $boolField,
        $jsonField
    ]
}"
添加数组字段
数组字段用于存储一组元素。数组字段中所有元素的数据类型应保持一致。有关数组字段的更多信息,请参阅“数组字段”。
schema.add_field(
    field_name="my_array",
    datatype=DataType.ARRAY,
    element_type=DataType.VARCHAR,
    max_capacity=5,
    max_length=512,
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_array")
        .dataType(DataType.Array)
        .elementType(DataType.VarChar)
        .maxCapacity(5)
        .maxLength(512)
        .build());
schema.push({
    name: "my_array",
    data_type: DataType.Array,
    element_type: DataType.VarChar,
    max_capacity: 5,
    max_length: 512
});
schema.WithField(entity.NewField().WithName("my_array").
    WithDataType(entity.FieldTypeArray).
    WithElementType(entity.FieldTypeInt64).
    WithMaxLength(512).
    WithMaxCapacity(5),
)
export arrayField='{
    "fieldName": "my_array",
    "dataType": "Array",
    "elementDataType": "VarChar",
    "elementTypeParams": {
        "max_length": 512
    }
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField,
        $int64Field,
        $boolField,
        $jsonField,
        $arrayField
    ]
}"
