

稠密向量
稠密向量是机器学习和数据分析中广泛使用的数值数据表示形式。它们由实数数组组成,其中大部分或所有元素均不为零。与稀疏向量相比,在相同的维度水平上,稠密向量包含更多的信息,因为每个维度都包含有意义的值。 这种表示方式能够有效捕捉复杂的模式和关系,使数据在高维空间中更易于分析和处理。稠密向量通常具有固定的维度数,范围从几十到几百甚至几千,具体取决于应用场景和需求。
稠密向量主要应用于需要理解数据语义的场景,例如语义搜索和推荐系统。在语义搜索中,稠密向量有助于捕捉查询与文档之间的内在联系,从而提高搜索结果的相关性。在推荐系统中,它们有助于识别用户与项目之间的相似性,从而提供更个性化的建议。
概述
稠密向量通常表示为固定长度的浮点数数组,例如[0.2, 0.7, 0.1, 0.8, 0.3, ..., 0.5] 。这些向量的维度通常在数百到数千之间,例如 128、256、768 或 1024。 每个维度都捕捉了对象的特定语义特征,通过相似度计算使其适用于各种场景。
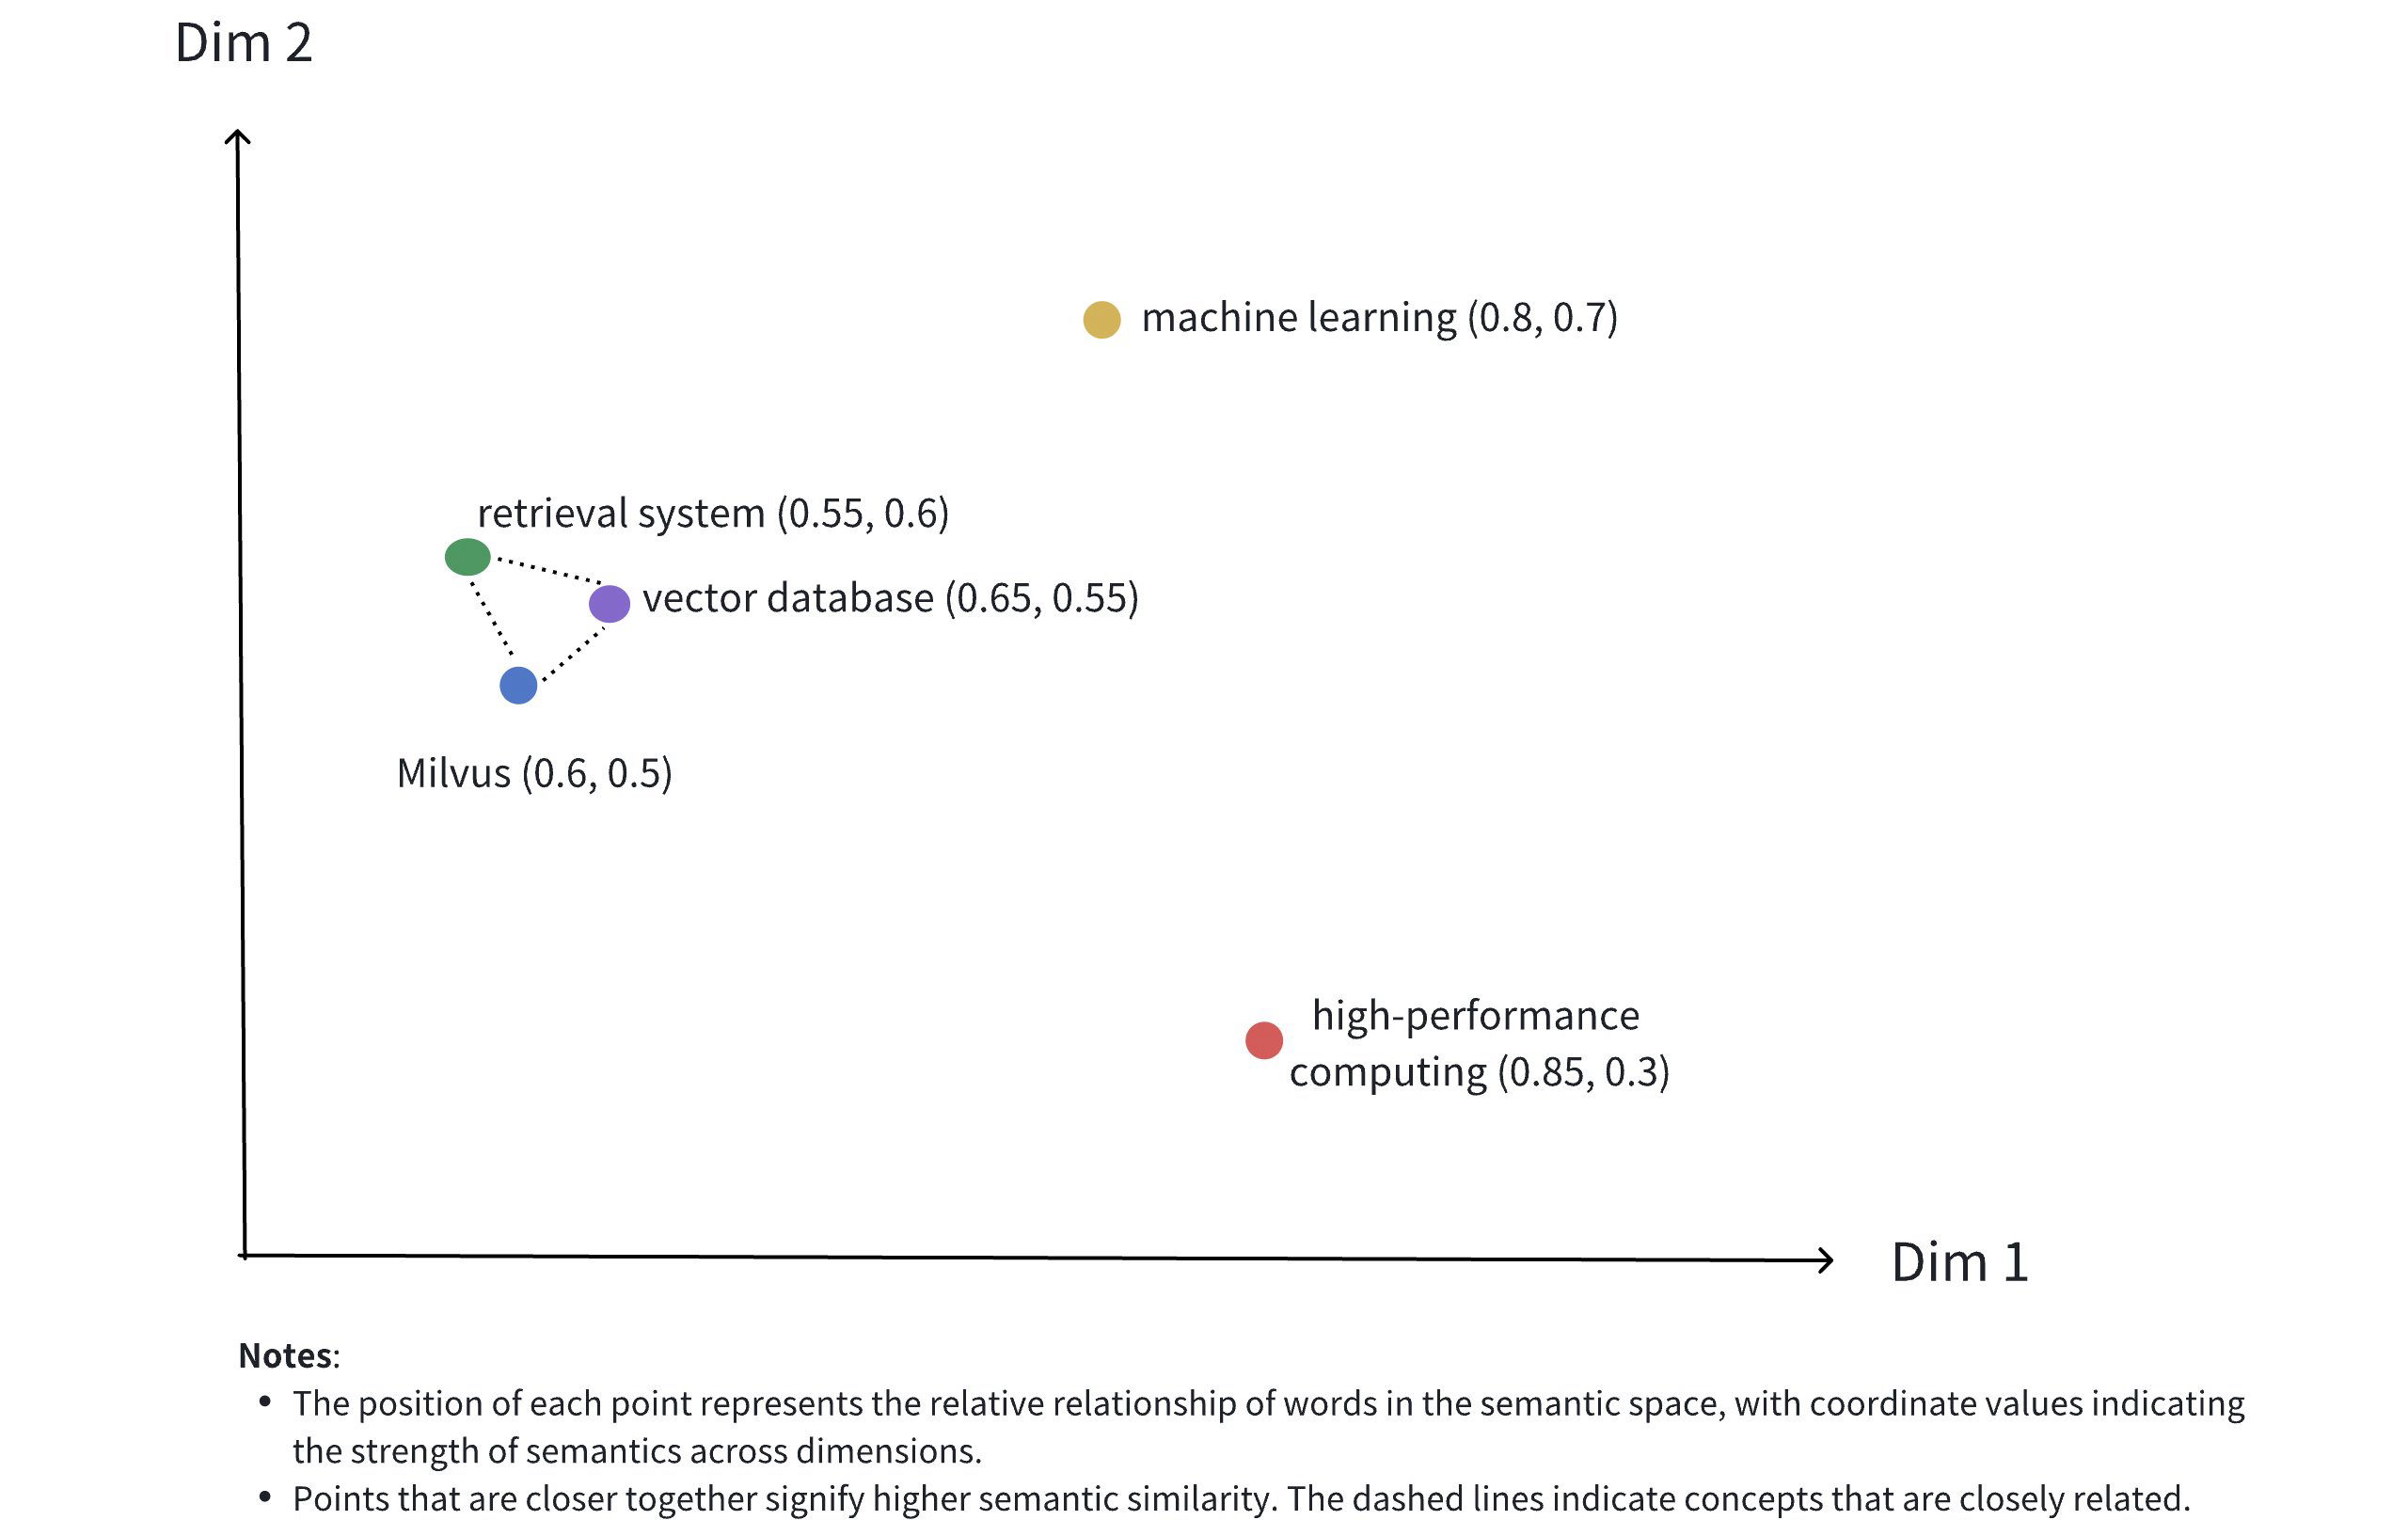 稠密向量
上图展示了稠密向量在二维空间中的表示形式。尽管现实应用中的稠密向量通常具有更高的维度,但这幅二维图示有效地传达了几个关键概念:
多维表示:每个点代表一个概念对象(如Milvus、向量数据库、检索系统等),其位置由各维度的数值决定。
语义关系:点与点之间的距离反映了概念之间的语义相似性。距离越近的点,表示语义关联越强的概念。
聚类效应:相关概念(如Milvus、向量数据库和检索系统)在空间中彼此靠近,形成语义聚类。
以下是一个表示文本“"Milvus is an efficient vector database" ”的真实密集向量示例:
[
    -0.013052909,
    0.020387933,
    -0.007869,
    -0.11111383,
    -0.030188112,
    -0.0053388323,
    0.0010654867,
    0.072027855,
    // ... more dimensions
]
密集向量可通过各种Embeddings模型生成,例如用于图像的卷积神经网络(如ResNet、VGG)以及用于文本的语言模型(如BERT、Word2Vec)。这些模型将原始数据转换为高维空间中的点,从而捕捉数据的语义特征。 此外,Milvus 提供了便捷的方法来帮助用户生成和处理稠密向量,具体细节请参见“Embeddings”章节。
数据向量化后,即可存储在 Milvus 中进行管理和向量检索。下图展示了基本流程。
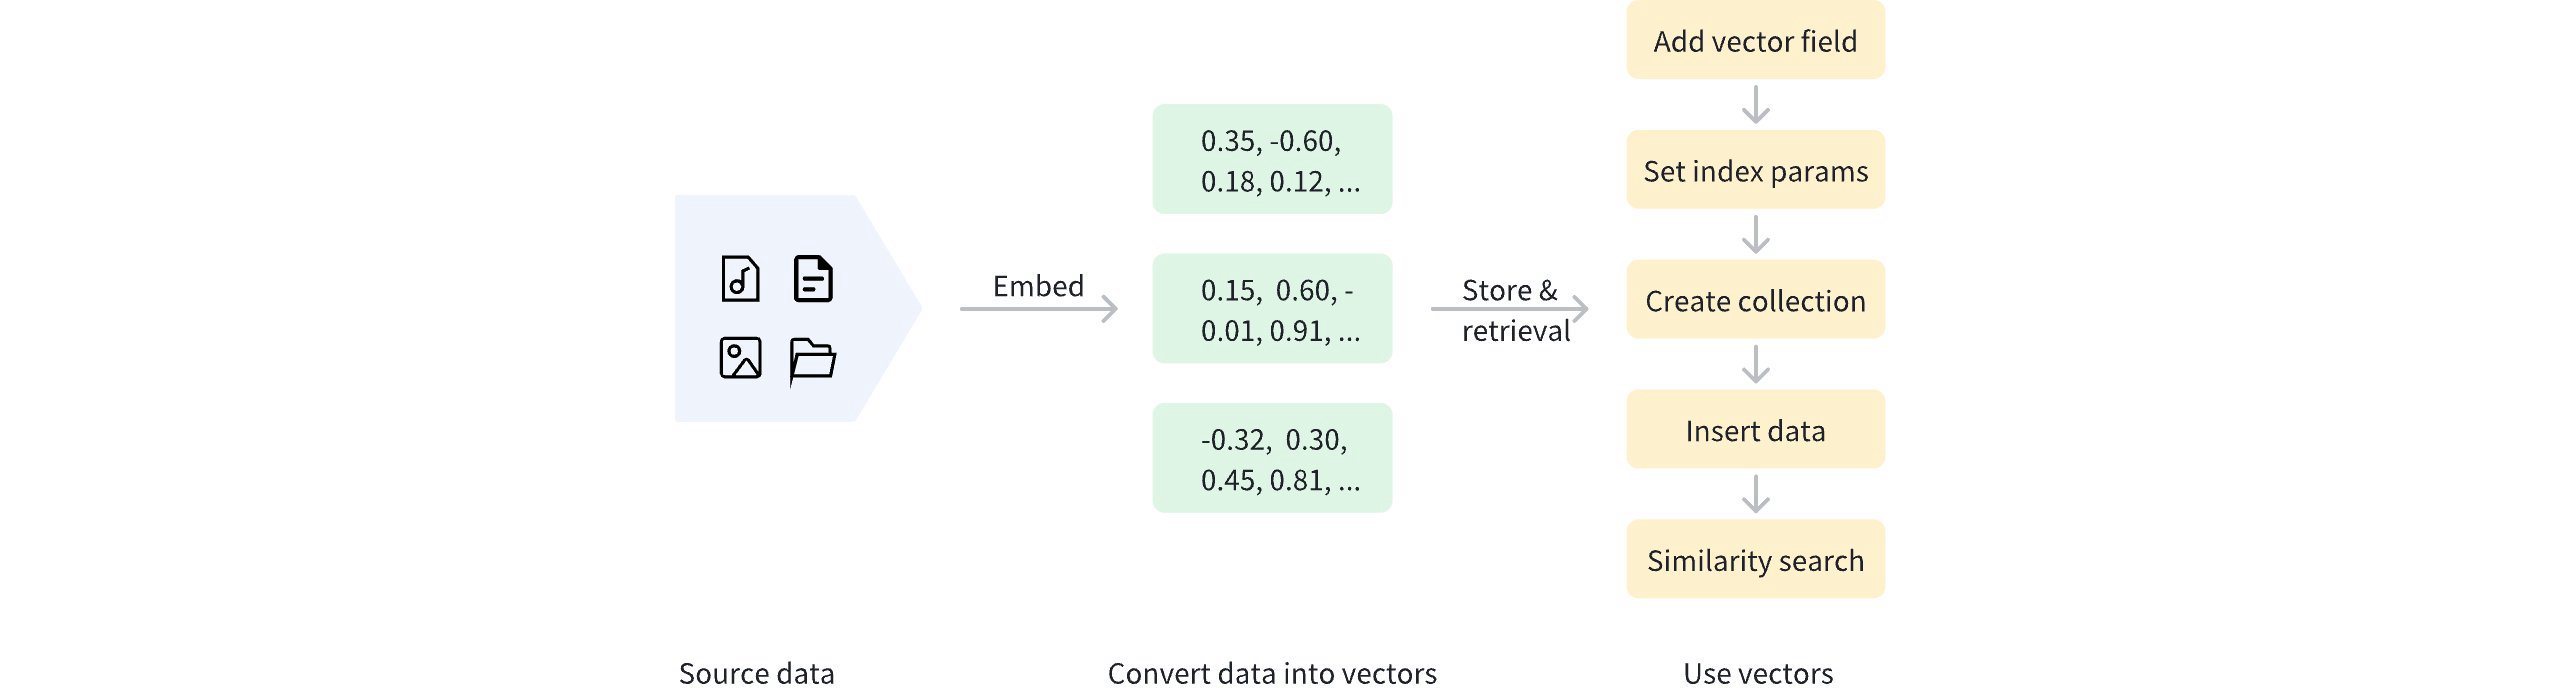 使用密集向量
除了稠密向量外,Milvus 还支持稀疏向量和二进制向量。稀疏向量适用于基于特定术语的精确匹配,例如关键词搜索和术语匹配;而二进制向量通常用于高效处理二值化数据,例如图像模式匹配和某些哈希应用。更多信息请参阅《二进制向量》和《稀疏向量》。
使用稠密向量
添加向量字段
要在 Milvus 中使用稠密向量,首先需在创建 Collection 时定义一个用于存储稠密向量的向量字段。该过程包括:
将 `
datatype` 设置为受支持的稠密向量数据类型。有关受支持的稠密向量数据类型,请参阅“数据类型”。使用
dim参数指定密集向量的维度。
在下面的示例中,我们添加了一个名为dense_vector 的向量字段来存储稠密向量。该字段的数据类型为FLOAT_VECTOR ,维度为4 。
from pymilvus import MilvusClient, DataType

client = MilvusClient(uri="http://localhost:19530")

schema = client.create_schema(
    auto_id=True,
    enable_dynamic_fields=True,
)

schema.add_field(field_name="pk", datatype=DataType.VARCHAR, is_primary=True, max_length=100)
schema.add_field(field_name="dense_vector", datatype=DataType.FLOAT_VECTOR, dim=4)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

CreateCollectionReq.CollectionSchema schema = client.createSchema();
schema.setEnableDynamicField(true);
schema.addField(AddFieldReq.builder()
        .fieldName("pk")
        .dataType(DataType.VarChar)
        .isPrimaryKey(true)
        .autoID(true)
        .maxLength(100)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("dense_vector")
        .dataType(DataType.FloatVector)
        .dimension(4)
        .build());
import { DataType } from "@zilliz/milvus2-sdk-node";

schema.push({
  name: "dense_vector",
  data_type: DataType.FloatVector,
  dim: 4,
});
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

schema := entity.NewSchema()
schema.WithField(entity.NewField().
    WithName("pk").
    WithDataType(entity.FieldTypeVarChar).
    WithIsPrimaryKey(true).
    WithIsAutoID(true).
    WithMaxLength(100),
).WithField(entity.NewField().
    WithName("dense_vector").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(4),
)
export primaryField='{
    "fieldName": "pk",
    "dataType": "VarChar",
    "isPrimary": true,
    "elementTypeParams": {
        "max_length": 100
    }
}'

export vectorField='{
    "fieldName": "dense_vector",
    "dataType": "FloatVector",
    "elementTypeParams": {
        "dim": 4
    }
}'

export schema="{
    \"autoID\": true,
    \"fields\": [
        $primaryField,
        $vectorField
    ]
}"
密集向量字段支持的数据类型:
数据类型 |
描述 |
|---|---|
|
存储 32 位浮点数,通常用于科学计算和机器学习中表示实数。非常适合需要高精度的场景,例如区分相似向量。 |
|
存储 16 位半精度浮点数,用于深度学习和 GPU 计算。在精度要求不高的场景中(例如推荐系统的低精度召回阶段),可节省存储空间。 |
|
存储 16 位 Brain 浮点数 (bfloat16),其指数范围与 Float32 相同,但精度较低。适用于需要快速处理大量向量的场景,例如大规模图像检索。 |
|
存储各维度元素均为 8 位整数(int8)的向量,每个元素的取值范围为 –128 到 127。 INT8_VECTOR 专为量化深度学习模型(例如 ResNet、EfficientNet)设计,可在最小化精度损失的同时缩减模型大小并加速推理。 |
设置向量字段的索引参数
为加速语义搜索,必须为向量字段创建索引。索引可显著提高大规模向量数据的检索效率。
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="dense_vector",
    index_name="dense_vector_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)
import io.milvus.v2.common.IndexParam;
import java.util.*;

List<IndexParam> indexes = new ArrayList<>();

indexes.add(IndexParam.builder()
        .fieldName("dense_vector")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build());
import { MetricType, IndexType } from "@zilliz/milvus2-sdk-node";

const indexParams = {
    index_name: 'dense_vector_index',
    field_name: 'dense_vector',
    metric_type: MetricType.IP,
    index_type: IndexType.AUTOINDEX
};
idx := index.NewAutoIndex(index.MetricType(entity.IP))
indexOption := milvusclient.NewCreateIndexOption("my_collection", "dense_vector", idx)
export indexParams='[
        {
            "fieldName": "dense_vector",
            "metricType": "IP",
            "indexName": "dense_vector_index",
            "indexType": "AUTOINDEX"
        }
    ]'
在上例中,使用AUTOINDEX 索引类型为dense_vector 字段创建了名为dense_vector_index 的索引。将metric_type 设置为IP ,表示将使用内积作为距离度量。
Milvus 提供了多种索引类型,以提供更好的向量搜索体验。AUTOINDEX 是一种专门设计的特殊索引类型,旨在降低向量搜索的学习门槛。您还可以从众多索引类型中进行选择。详情请参阅《索引详解》。
Milvus 还支持其他度量类型。有关更多信息,请参阅《度量类型》。
创建Collection
完成稠密向量和索引参数的配置后,即可创建一个包含稠密向量的Collection。下面的示例使用create_collection 方法创建了一个名为my_collection 的Collection。
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
import { MilvusClient } from "@zilliz/milvus2-sdk-node";

const client = new MilvusClient({
    address: 'http://localhost:19530'
});

await client.createCollection({
    collection_name: 'my_collection',
    schema: schema,
    index_params: indexParams
});
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
插入数据
创建Collection后,请使用insert 方法添加包含稠密向量的数据。请确保要插入的稠密向量的维度与添加稠密向量字段时定义的dim 值相匹配。
data = [
    {"dense_vector": [0.1, 0.2, 0.3, 0.7]},
    {"dense_vector": [0.2, 0.3, 0.4, 0.8]},
]

client.insert(
    collection_name="my_collection",
    data=data
)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;
import io.milvus.v2.service.vector.response.InsertResp;

List<JsonObject> rows = new ArrayList<>();
Gson gson = new Gson();
rows.add(gson.fromJson("{\"dense_vector\": [0.1, 0.2, 0.3, 0.4]}", JsonObject.class));
rows.add(gson.fromJson("{\"dense_vector\": [0.2, 0.3, 0.4, 0.5]}", JsonObject.class));

InsertResp insertR = client.insert(InsertReq.builder()
        .collectionName("my_collection")
        .data(rows)
        .build());
const data = [
  { dense_vector: [0.1, 0.2, 0.3, 0.7] },
  { dense_vector: [0.2, 0.3, 0.4, 0.8] },
];

client.insert({
  collection_name: "my_collection",
  data: data,
});
_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("my_collection").
    WithFloatVectorColumn("dense_vector", 4, [][]float32{
        {0.1, 0.2, 0.3, 0.7},
        {0.2, 0.3, 0.4, 0.8},
    }),
)
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "data": [
        {"dense_vector": [0.1, 0.2, 0.3, 0.4]},
        {"dense_vector": [0.2, 0.3, 0.4, 0.5]}
    ],
    "collectionName": "my_collection"
}'

## {"code":0,"cost":0,"data":{"insertCount":2,"insertIds":["453577185629572531","453577185629572532"]}}
执行相似度搜索
基于稠密向量的语义搜索是 Milvus 的核心功能之一,它允许您根据向量之间的距离,快速找到与查询向量最相似的数据。要执行相似度搜索,请准备好查询向量和搜索参数,然后调用search 方法。
search_params = {
    "params": {"nprobe": 10}
}

query_vector = [0.1, 0.2, 0.3, 0.7]

res = client.search(
    collection_name="my_collection",
    data=[query_vector],
    anns_field="dense_vector",
    search_params=search_params,
    limit=5,
    output_fields=["pk"]
)

print(res)

# Output
# data: ["[{'id': '453718927992172271', 'distance': 0.7599999904632568, 'entity': {'pk': '453718927992172271'}}, {'id': '453718927992172270', 'distance': 0.6299999952316284, 'entity': {'pk': '453718927992172270'}}]"]
import io.milvus.v2.service.vector.request.data.FloatVec;

Map<String,Object> searchParams = new HashMap<>();
searchParams.put("nprobe",10);

FloatVec queryVector = new FloatVec(new float[]{0.1f, 0.3f, 0.3f, 0.4f});

SearchResp searchR = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryVector))
        .annsField("dense_vector")
        .searchParams(searchParams)
        .topK(5)
        .outputFields(Collections.singletonList("pk"))
        .build());

System.out.println(searchR.getSearchResults());

// Output
//
// [[SearchResp.SearchResult(entity={pk=453444327741536779}, score=0.65, id=453444327741536779), SearchResp.SearchResult(entity={pk=453444327741536778}, score=0.65, id=453444327741536778)]]
query_vector = [0.1, 0.2, 0.3, 0.7];

client.search({
    collection_name: 'my_collection',
    data: query_vector,
    limit: 5,
    output_fields: ['pk'],
    params: {
        nprobe: 10
    }
});
queryVector := []float32{0.1, 0.2, 0.3, 0.7}

annParam := index.NewCustomAnnParam()
annParam.WithExtraParam("nprobe", 10)
resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    5,                     // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("dense_vector").
    WithOutputFields("pk").
    WithAnnParam(annParam))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("Pks: ", resultSet.GetColumn("pk").FieldData().GetScalars())
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": [
        [0.1, 0.2, 0.3, 0.7]
    ],
    "annsField": "dense_vector",
    "limit": 5,
    "searchParams":{
        "params":{"nprobe":10}
    },
    "outputFields": ["pk"]
}'

## {"code":0,"cost":0,"data":[{"distance":0.55,"id":"453577185629572532","pk":"453577185629572532"},{"distance":0.42,"id":"453577185629572531","pk":"453577185629572531"}]}
有关相似度搜索参数的更多信息,请参阅《基础 ANN 搜索》。
