

Плотный вектор
Плотные векторы — это представления числовых данных, широко используемые в машинном обучении и анализе данных. Они состоят из массивов действительных чисел, в которых большинство или все элементы отличны от нуля. По сравнению с разреженными векторами плотные векторы содержат больше информации при том же количестве измерений, поскольку каждое измерение содержит значимые значения. Такое представление позволяет эффективно отражать сложные закономерности и взаимосвязи, что упрощает анализ и обработку данных в высокомерных пространствах. Плотные векторы обычно имеют фиксированное количество измерений — от нескольких десятков до нескольких сотен или даже тысяч, в зависимости от конкретного применения и требований.
Плотные векторы в основном используются в сценариях, требующих понимания семантики данных, таких как семантический поиск и системы рекомендаций. В семантическом поиске плотные векторы помогают выявить скрытые связи между запросами и документами, повышая релевантность результатов поиска. В системах рекомендаций они помогают выявлять сходства между пользователями и объектами, предлагая более персонализированные рекомендации.
Обзор
Плотные векторы обычно представляются в виде массивов чисел с плавающей запятой фиксированной длины, например [0.2, 0.7, 0.1, 0.8, 0.3, ..., 0.5]. Количество измерений этих векторов обычно варьируется от сотен до тысяч, например 128, 256, 768 или 1024. Каждое измерение отражает определённые семантические особенности объекта, что позволяет применять их в различных сценариях посредством вычисления схожести.
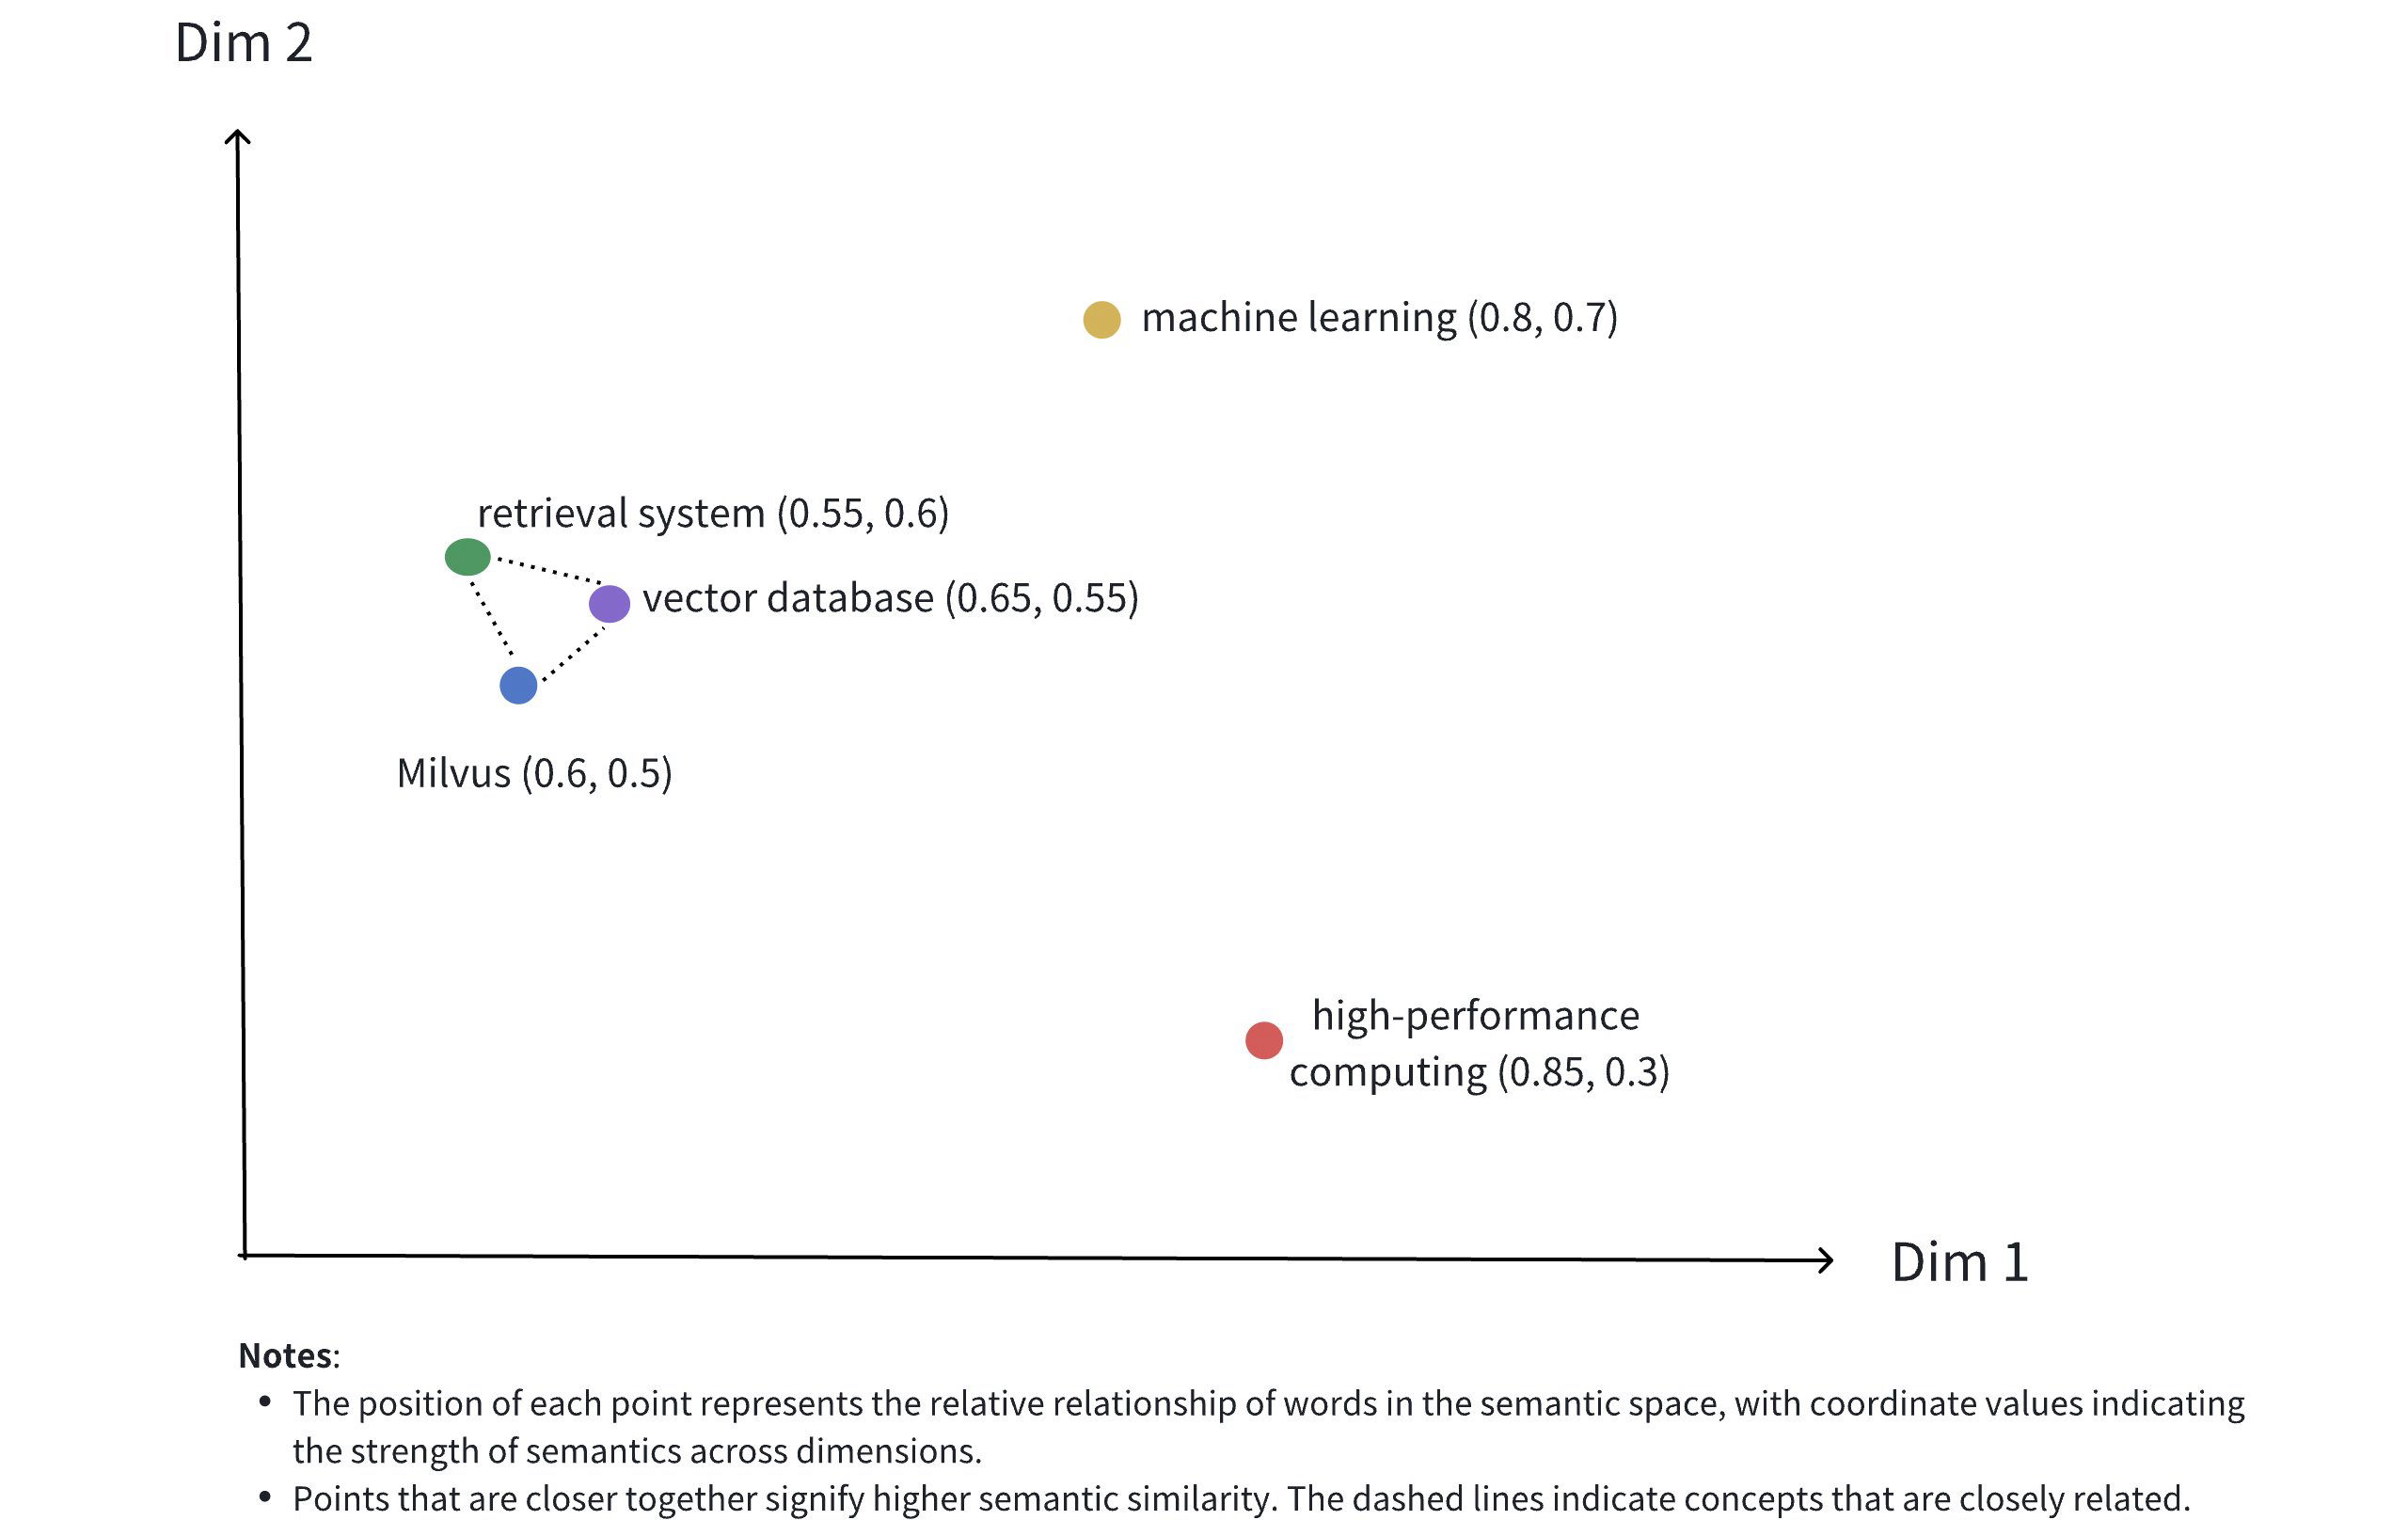 Плотный вектор
На изображении выше показано представление плотных векторов в двумерном пространстве. Хотя в реальных приложениях плотные векторы часто имеют гораздо большее количество измерений, эта двумерная иллюстрация наглядно демонстрирует несколько ключевых концепций:
Многомерное представление: каждая точка представляет концептуальный объект (такой как Milvus, векторная база данных, система поиска и т. д.), положение которого определяется значениями его измерений.
Семантические отношения: расстояния между точками отражают семантическое сходство между концепциями. Более близкие точки указывают на концепции, которые более тесно связаны с семантической точки зрения.
Эффект кластеризации: связанные концепции (такие как Milvus, векторная база данных и система поиска) расположены близко друг к другу в пространстве, образуя семантический кластер.
Ниже приведен пример реального плотного вектора, представляющего текст « "Milvus is an efficient vector database" »:
[
    -0.013052909,
    0.020387933,
    -0.007869,
    -0.11111383,
    -0.030188112,
    -0.0053388323,
    0.0010654867,
    0.072027855,
    // ... more dimensions
]
Плотные векторы можно генерировать с помощью различных моделей вложения, таких как модели CNN (например, ResNet, VGG) для изображений и языковые модели (например, BERT, Word2Vec) для текста. Эти модели преобразуют исходные данные в точки в многомерном пространстве, фиксируя семантические особенности данных. Кроме того, Milvus предлагает удобные методы, помогающие пользователям генерировать и обрабатывать плотные векторы, как подробно описано в разделе «Вложения».
После векторизации данные можно хранить в Milvus для управления и поиска векторов. На приведенной ниже схеме показан основной процесс.
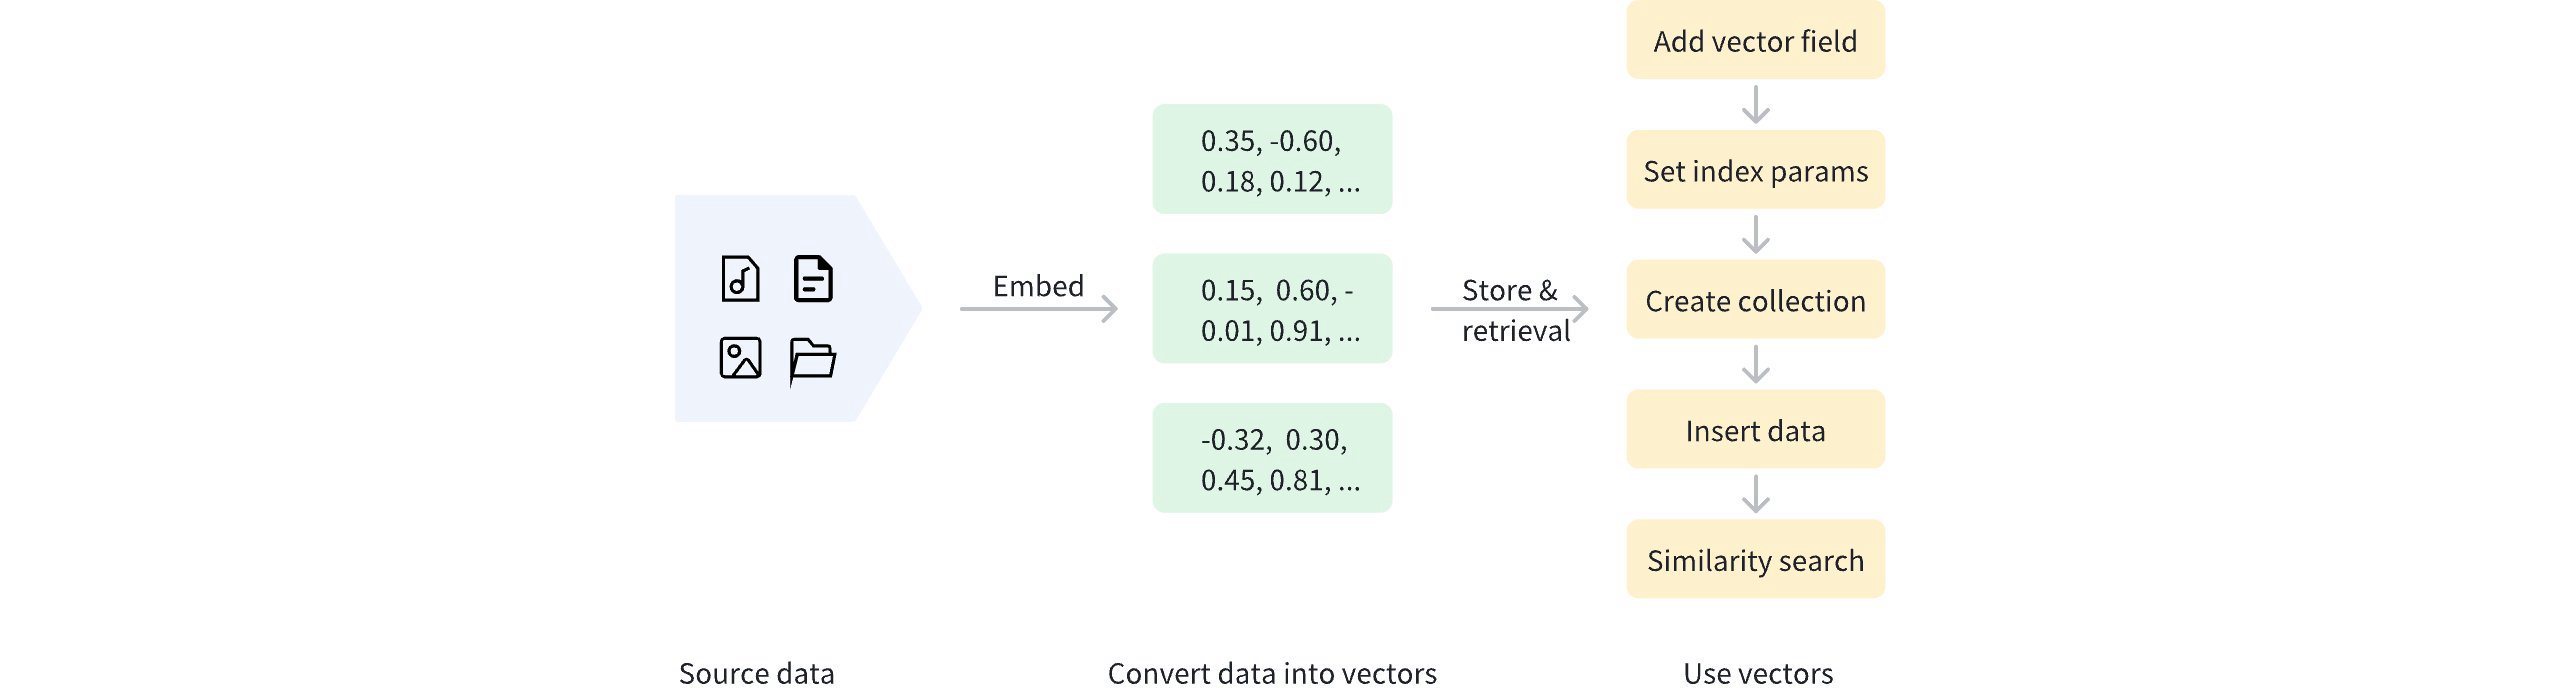 Использование плотных векторов
Помимо плотных векторов Milvus также поддерживает разреженные и бинарные векторы. Разреженные векторы подходят для точного сопоставления на основе конкретных терминов, например, для поиска по ключевым словам и сопоставления терминов, тогда как бинарные векторы обычно используются для эффективной обработки бинаризованных данных, таких как сопоставление образов и некоторые приложения хеширования. Дополнительную информацию см. в разделах «Бинарные векторы » и «Разреженные векторы».
Использование плотных векторов
Добавление векторного поля
Чтобы использовать плотные векторы в Milvus, сначала необходимо определить векторное поле для хранения плотных векторов при создании коллекции. Этот процесс включает:
Установку параметра `
datatype` в значение, соответствующее поддерживаемому типу данных плотного вектора. Поддерживаемые типы данных плотных векторов см. в разделе «Типы данных».Указание размеров плотного вектора с помощью параметра
dim.
В приведенном ниже примере мы добавляем векторное поле с именем ` dense_vector ` для хранения плотных векторов. Тип данных поля — ` FLOAT_VECTOR`, размерность — ` 4`.
from pymilvus import MilvusClient, DataType

client = MilvusClient(uri="http://localhost:19530")

schema = client.create_schema(
    auto_id=True,
    enable_dynamic_fields=True,
)

schema.add_field(field_name="pk", datatype=DataType.VARCHAR, is_primary=True, max_length=100)
schema.add_field(field_name="dense_vector", datatype=DataType.FLOAT_VECTOR, dim=4)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

CreateCollectionReq.CollectionSchema schema = client.createSchema();
schema.setEnableDynamicField(true);
schema.addField(AddFieldReq.builder()
        .fieldName("pk")
        .dataType(DataType.VarChar)
        .isPrimaryKey(true)
        .autoID(true)
        .maxLength(100)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("dense_vector")
        .dataType(DataType.FloatVector)
        .dimension(4)
        .build());
import { DataType } from "@zilliz/milvus2-sdk-node";

schema.push({
  name: "dense_vector",
  data_type: DataType.FloatVector,
  dim: 4,
});
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

schema := entity.NewSchema()
schema.WithField(entity.NewField().
    WithName("pk").
    WithDataType(entity.FieldTypeVarChar).
    WithIsPrimaryKey(true).
    WithIsAutoID(true).
    WithMaxLength(100),
).WithField(entity.NewField().
    WithName("dense_vector").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(4),
)
export primaryField='{
    "fieldName": "pk",
    "dataType": "VarChar",
    "isPrimary": true,
    "elementTypeParams": {
        "max_length": 100
    }
}'

export vectorField='{
    "fieldName": "dense_vector",
    "dataType": "FloatVector",
    "elementTypeParams": {
        "dim": 4
    }
}'

export schema="{
    \"autoID\": true,
    \"fields\": [
        $primaryField,
        $vectorField
    ]
}"
Поддерживаемые типы данных для плотных векторных полей:
Тип данных |
Описание |
|---|---|
|
Хранит 32-разрядные числа с плавающей запятой, обычно используемые для представления действительных чисел в научных вычислениях и машинном обучении. Идеально подходит для сценариев, требующих высокой точности, таких как различение похожих векторов. |
|
Хранит 16-битные числа с плавающей запятой половинной точности, используемые для глубокого обучения и вычислений на графическом процессоре. Это позволяет сэкономить место для хранения в сценариях, где точность не является критичной, например, на этапе отбора с низкой точностью в системах рекомендаций. |
|
Хранит 16-битные числа с плавающей запятой Brain (bfloat16), предлагая тот же диапазон экспонент, что и Float32, но с пониженной точностью. Подходит для сценариев, требующих быстрой обработки больших объемов векторов, например, при крупномасштабном поиске изображений. |
|
Хранит векторы, отдельные элементы которых в каждом измерении представляют собой 8-битные целые числа (int8), причем диапазон значений каждого элемента составляет от –128 до 127. Разработанный для квантованных моделей глубокого обучения (например, ResNet, EfficientNet), INT8_VECTOR уменьшает размер модели и ускоряет инференцию с минимальной потерей точности. |
Настройка параметров индекса для векторного поля
Для ускорения семантического поиска необходимо создать индекс для векторного поля. Индексирование может значительно повысить эффективность поиска в крупномасштабных векторных данных.
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="dense_vector",
    index_name="dense_vector_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)
import io.milvus.v2.common.IndexParam;
import java.util.*;

List<IndexParam> indexes = new ArrayList<>();

indexes.add(IndexParam.builder()
        .fieldName("dense_vector")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build());
import { MetricType, IndexType } from "@zilliz/milvus2-sdk-node";

const indexParams = {
    index_name: 'dense_vector_index',
    field_name: 'dense_vector',
    metric_type: MetricType.IP,
    index_type: IndexType.AUTOINDEX
};
idx := index.NewAutoIndex(index.MetricType(entity.IP))
indexOption := milvusclient.NewCreateIndexOption("my_collection", "dense_vector", idx)
export indexParams='[
        {
            "fieldName": "dense_vector",
            "metricType": "IP",
            "indexName": "dense_vector_index",
            "indexType": "AUTOINDEX"
        }
    ]'
В приведенном выше примере для поля dense_vector создается индекс с именем dense_vector_index с использованием типа индекса AUTOINDEX. Параметр metric_type установлен в значение IP, что указывает на использование внутреннего произведения в качестве метрики расстояния.
Milvus предоставляет различные типы индексов для более эффективного векторного поиска. AUTOINDEX — это специальный тип индекса, разработанный для облегчения освоения векторного поиска. Вам доступно множество типов индексов на выбор. Подробности см. в разделе «Объяснение индексов».
Milvus поддерживает и другие типы метрик. Дополнительную информацию см. в разделе «Типы метрик».
Создание коллекции
После завершения настройки параметров плотных векторов и индекса можно создать коллекцию, содержащую плотные векторы. В приведенном ниже примере с помощью метода ` create_collection ` создается коллекция с именем ` my_collection`.
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
import { MilvusClient } from "@zilliz/milvus2-sdk-node";

const client = new MilvusClient({
    address: 'http://localhost:19530'
});

await client.createCollection({
    collection_name: 'my_collection',
    schema: schema,
    index_params: indexParams
});
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
Вставка данных
После создания коллекции используйте метод ` insert ` для добавления данных, содержащих плотные векторы. Убедитесь, что размерность вставляемых плотных векторов соответствует значению ` dim `, заданному при добавлении поля плотных векторов.
data = [
    {"dense_vector": [0.1, 0.2, 0.3, 0.7]},
    {"dense_vector": [0.2, 0.3, 0.4, 0.8]},
]

client.insert(
    collection_name="my_collection",
    data=data
)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;
import io.milvus.v2.service.vector.response.InsertResp;

List<JsonObject> rows = new ArrayList<>();
Gson gson = new Gson();
rows.add(gson.fromJson("{\"dense_vector\": [0.1, 0.2, 0.3, 0.4]}", JsonObject.class));
rows.add(gson.fromJson("{\"dense_vector\": [0.2, 0.3, 0.4, 0.5]}", JsonObject.class));

InsertResp insertR = client.insert(InsertReq.builder()
        .collectionName("my_collection")
        .data(rows)
        .build());
const data = [
  { dense_vector: [0.1, 0.2, 0.3, 0.7] },
  { dense_vector: [0.2, 0.3, 0.4, 0.8] },
];

client.insert({
  collection_name: "my_collection",
  data: data,
});
_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("my_collection").
    WithFloatVectorColumn("dense_vector", 4, [][]float32{
        {0.1, 0.2, 0.3, 0.7},
        {0.2, 0.3, 0.4, 0.8},
    }),
)
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "data": [
        {"dense_vector": [0.1, 0.2, 0.3, 0.4]},
        {"dense_vector": [0.2, 0.3, 0.4, 0.5]}
    ],
    "collectionName": "my_collection"
}'

## {"code":0,"cost":0,"data":{"insertCount":2,"insertIds":["453577185629572531","453577185629572532"]}}
Выполнение поиска по схожести
Семантический поиск на основе плотных векторов — одна из ключевых функций Milvus, позволяющая быстро находить данные, наиболее похожие на вектор-запрос, на основе расстояния между векторами. Чтобы выполнить поиск по схожести, подготовьте вектор-запрос и параметры поиска, а затем вызовите метод ` search `.
search_params = {
    "params": {"nprobe": 10}
}

query_vector = [0.1, 0.2, 0.3, 0.7]

res = client.search(
    collection_name="my_collection",
    data=[query_vector],
    anns_field="dense_vector",
    search_params=search_params,
    limit=5,
    output_fields=["pk"]
)

print(res)

# Output
# data: ["[{'id': '453718927992172271', 'distance': 0.7599999904632568, 'entity': {'pk': '453718927992172271'}}, {'id': '453718927992172270', 'distance': 0.6299999952316284, 'entity': {'pk': '453718927992172270'}}]"]
import io.milvus.v2.service.vector.request.data.FloatVec;

Map<String,Object> searchParams = new HashMap<>();
searchParams.put("nprobe",10);

FloatVec queryVector = new FloatVec(new float[]{0.1f, 0.3f, 0.3f, 0.4f});

SearchResp searchR = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryVector))
        .annsField("dense_vector")
        .searchParams(searchParams)
        .topK(5)
        .outputFields(Collections.singletonList("pk"))
        .build());

System.out.println(searchR.getSearchResults());

// Output
//
// [[SearchResp.SearchResult(entity={pk=453444327741536779}, score=0.65, id=453444327741536779), SearchResp.SearchResult(entity={pk=453444327741536778}, score=0.65, id=453444327741536778)]]
query_vector = [0.1, 0.2, 0.3, 0.7];

client.search({
    collection_name: 'my_collection',
    data: query_vector,
    limit: 5,
    output_fields: ['pk'],
    params: {
        nprobe: 10
    }
});
queryVector := []float32{0.1, 0.2, 0.3, 0.7}

annParam := index.NewCustomAnnParam()
annParam.WithExtraParam("nprobe", 10)
resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    5,                     // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("dense_vector").
    WithOutputFields("pk").
    WithAnnParam(annParam))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("Pks: ", resultSet.GetColumn("pk").FieldData().GetScalars())
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": [
        [0.1, 0.2, 0.3, 0.7]
    ],
    "annsField": "dense_vector",
    "limit": 5,
    "searchParams":{
        "params":{"nprobe":10}
    },
    "outputFields": ["pk"]
}'

## {"code":0,"cost":0,"data":[{"distance":0.55,"id":"453577185629572532","pk":"453577185629572532"},{"distance":0.42,"id":"453577185629572531","pk":"453577185629572531"}]}
Дополнительную информацию о параметрах поиска по схожести см. в разделе «Базовый поиск с использованием нейронных сетей».
