

Vetor denso
Os vetores densos são representações de dados numéricos amplamente utilizadas na aprendizagem automática e na análise de dados. Consistem em matrizes com números reais, em que a maioria ou todos os elementos são diferentes de zero. Em comparação com os vetores esparsos, os vetores densos contêm mais informação ao mesmo nível dimensional, uma vez que cada dimensão contém valores significativos. Esta representação consegue captar eficazmente padrões e relações complexos, facilitando a análise e o processamento de dados em espaços de alta dimensão. Os vetores densos têm normalmente um número fixo de dimensões, variando entre algumas dezenas e várias centenas ou mesmo milhares, dependendo da aplicação e dos requisitos específicos.
Os vetores densos são utilizados principalmente em cenários que exigem a compreensão da semântica dos dados, tais como a pesquisa semântica e os sistemas de recomendação. Na pesquisa semântica, os vetores densos ajudam a captar as ligações subjacentes entre consultas e documentos, melhorando a relevância dos resultados da pesquisa. Nos sistemas de recomendação, ajudam a identificar semelhanças entre utilizadores e itens, oferecendo sugestões mais personalizadas.
Visão geral
Os vetores densos são normalmente representados como matrizes de números de ponto flutuante com um comprimento fixo, como [0.2, 0.7, 0.1, 0.8, 0.3, ..., 0.5]. A dimensionalidade destes vetores varia geralmente entre centenas e milhares, como 128, 256, 768 ou 1024. Cada dimensão capta características semânticas específicas de um objeto, tornando-a aplicável a vários cenários através de cálculos de semelhança.
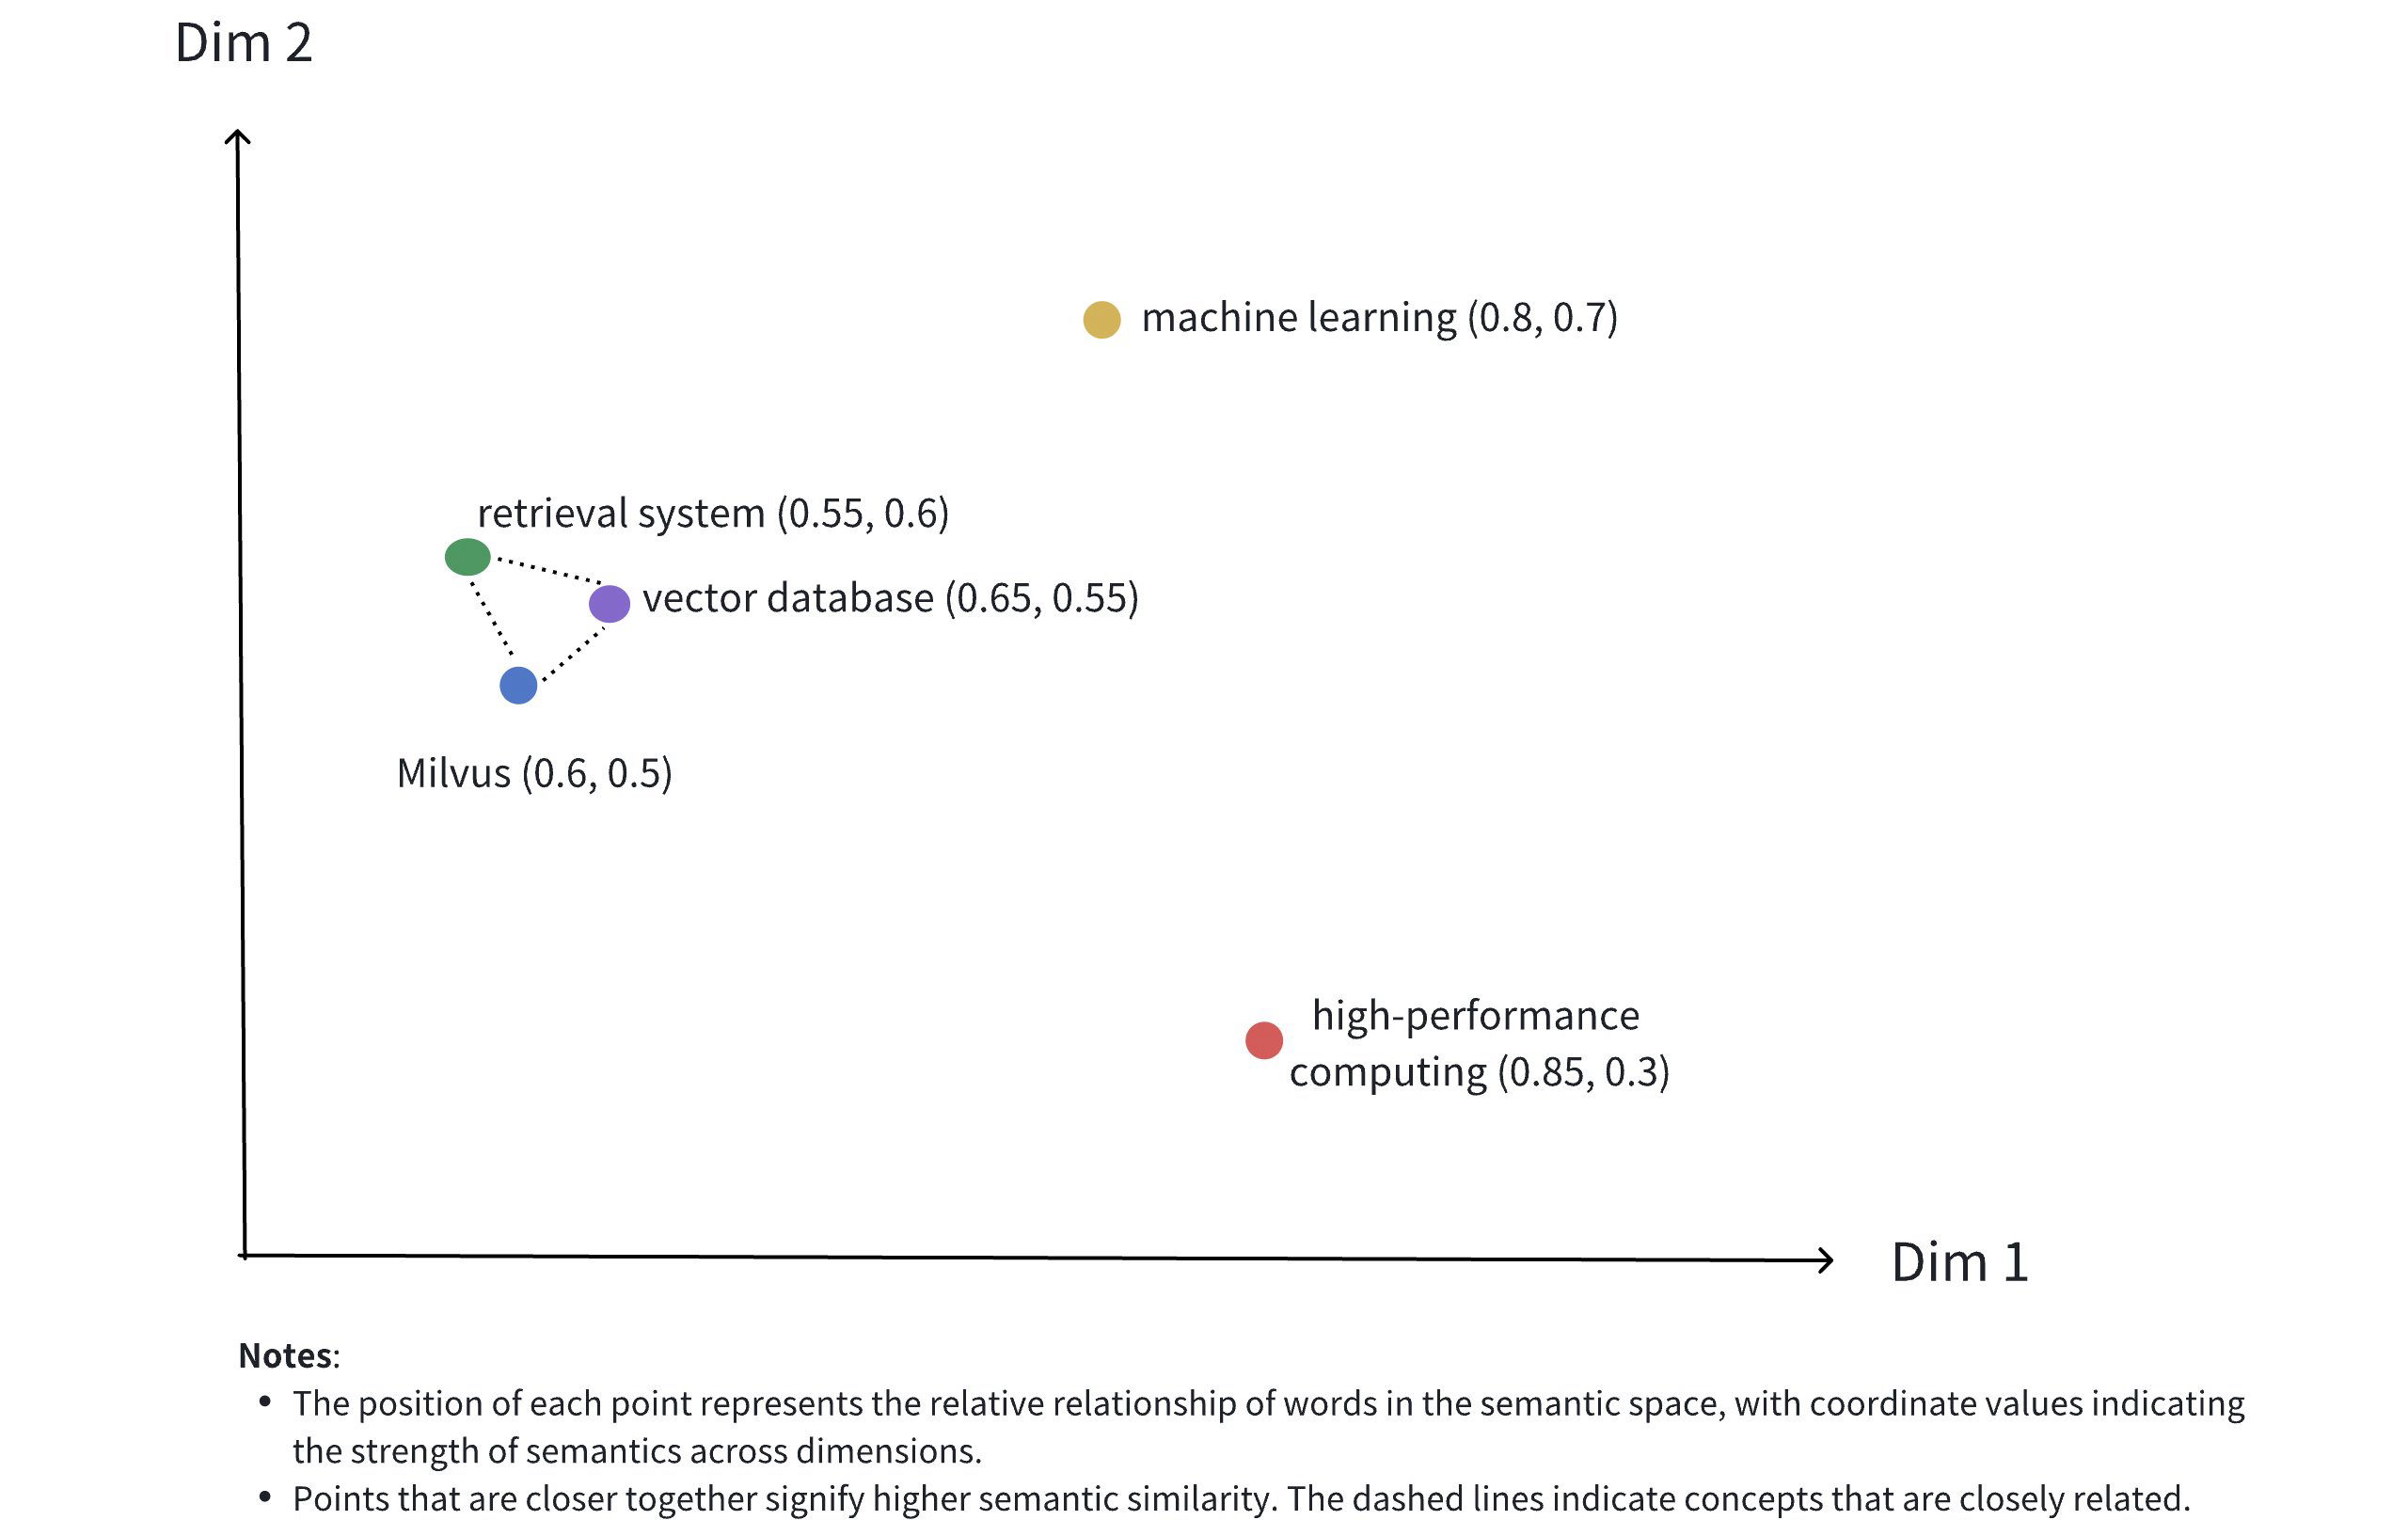 Vetor denso
A imagem acima ilustra a representação de vetores densos num espaço 2D. Embora os vetores densos em aplicações do mundo real tenham frequentemente dimensões muito superiores, esta ilustração 2D transmite eficazmente vários conceitos-chave:
Representação multidimensional: Cada ponto representa um objeto conceptual (como o Milvus, uma base de dados de vetores, um sistema de recuperação, etc.), cuja posição é determinada pelos valores das suas dimensões.
Relações semânticas: As distâncias entre os pontos refletem a semelhança semântica entre conceitos. Pontos mais próximos indicam conceitos que estão mais relacionados semanticamente.
Efeito de agrupamento: conceitos relacionados (tais como Milvus, base de dados vetorial e sistema de recuperação) estão posicionados próximos uns dos outros no espaço, formando um agrupamento semântico.
Segue-se um exemplo de um vetor denso real que representa o texto « "Milvus is an efficient vector database" »:
[
    -0.013052909,
    0.020387933,
    -0.007869,
    -0.11111383,
    -0.030188112,
    -0.0053388323,
    0.0010654867,
    0.072027855,
    // ... more dimensions
]
Os vetores densos podem ser gerados utilizando vários modelos de incorporação, tais como modelos CNN (como ResNet, VGG) para imagens e modelos linguísticos (como BERT, Word2Vec) para texto. Estes modelos transformam dados brutos em pontos num espaço de alta dimensão, captando as características semânticas dos dados. Além disso, o Milvus oferece métodos práticos para ajudar os utilizadores a gerar e processar vetores densos, conforme detalhado em «Embeddings».
Depois de os dados serem vetorizados, podem ser armazenados no Milvus para gestão e recuperação de vetores. O diagrama abaixo ilustra o processo básico.
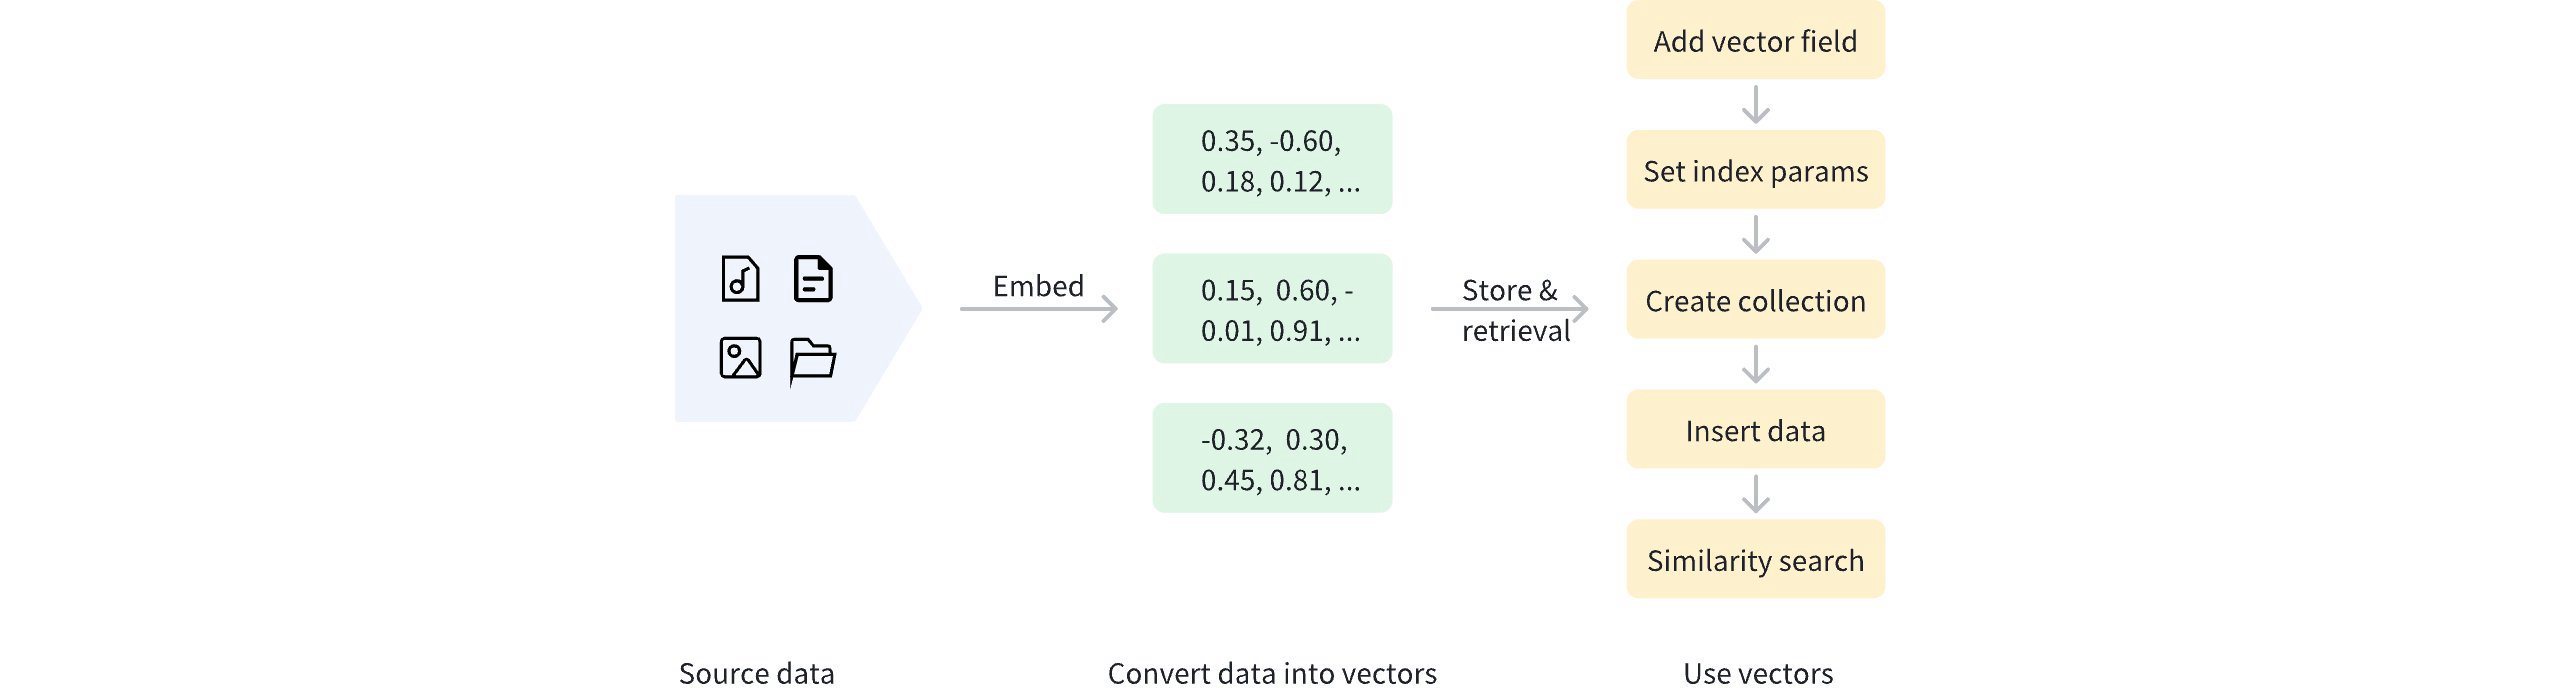 Utilizar vetores densos
Para além dos vetores densos, o Milvus também suporta vetores esparsos e vetores binários. Os vetores esparsos são adequados para correspondências precisas com base em termos específicos, tais como a pesquisa por palavras-chave e a correspondência de termos, enquanto os vetores binários são habitualmente utilizados para o tratamento eficiente de dados binarizados, como a correspondência de padrões de imagem e certas aplicações de hash. Para mais informações, consulte «Vetor Binário » e «Vetor Esparso».
Utilizar vetores densos
Adicionar campo de vetores
Para utilizar vetores densos no Milvus, defina primeiro um campo de vetores para armazenar vetores densos ao criar uma coleção. Este processo inclui:
Definir `
datatype` para um tipo de dados de vetor denso suportado. Para conhecer os tipos de dados de vetor denso suportados, consulte Tipos de dados.Especificar as dimensões do vetor denso utilizando o parâmetro «
dim».
No exemplo abaixo, adicionamos um campo vetorial denominado « dense_vector » para armazenar vetores densos. O tipo de dados do campo é « FLOAT_VECTOR », com uma dimensão de « 4 ».
from pymilvus import MilvusClient, DataType

client = MilvusClient(uri="http://localhost:19530")

schema = client.create_schema(
    auto_id=True,
    enable_dynamic_fields=True,
)

schema.add_field(field_name="pk", datatype=DataType.VARCHAR, is_primary=True, max_length=100)
schema.add_field(field_name="dense_vector", datatype=DataType.FLOAT_VECTOR, dim=4)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

CreateCollectionReq.CollectionSchema schema = client.createSchema();
schema.setEnableDynamicField(true);
schema.addField(AddFieldReq.builder()
        .fieldName("pk")
        .dataType(DataType.VarChar)
        .isPrimaryKey(true)
        .autoID(true)
        .maxLength(100)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("dense_vector")
        .dataType(DataType.FloatVector)
        .dimension(4)
        .build());
import { DataType } from "@zilliz/milvus2-sdk-node";

schema.push({
  name: "dense_vector",
  data_type: DataType.FloatVector,
  dim: 4,
});
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

schema := entity.NewSchema()
schema.WithField(entity.NewField().
    WithName("pk").
    WithDataType(entity.FieldTypeVarChar).
    WithIsPrimaryKey(true).
    WithIsAutoID(true).
    WithMaxLength(100),
).WithField(entity.NewField().
    WithName("dense_vector").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(4),
)
export primaryField='{
    "fieldName": "pk",
    "dataType": "VarChar",
    "isPrimary": true,
    "elementTypeParams": {
        "max_length": 100
    }
}'

export vectorField='{
    "fieldName": "dense_vector",
    "dataType": "FloatVector",
    "elementTypeParams": {
        "dim": 4
    }
}'

export schema="{
    \"autoID\": true,
    \"fields\": [
        $primaryField,
        $vectorField
    ]
}"
Tipos de dados suportados para campos vetoriais densos:
Tipo de dados |
Descrição |
|---|---|
|
Armazena números de ponto flutuante de 32 bits, normalmente utilizados para representar números reais em cálculos científicos e aprendizagem automática. Ideal para cenários que exigem alta precisão, como a distinção de vetores semelhantes. |
|
Armazena números de ponto flutuante de meia precisão de 16 bits, utilizados para aprendizagem profunda e cálculos em GPU. Permite poupar espaço de armazenamento em cenários em que a precisão é menos crítica, como na fase de recuperação de baixa precisão dos sistemas de recomendação. |
|
Armazena números de ponto flutuante Brain (bfloat16) de 16 bits, oferecendo o mesmo intervalo de expoentes que o Float32, mas com precisão reduzida. Adequado para cenários que necessitam de processar rapidamente grandes volumes de vetores, como a recuperação de imagens em grande escala. |
|
Armazena vetores cujos elementos individuais em cada dimensão são inteiros de 8 bits (int8), variando cada elemento entre –128 e 127. Concebido para modelos de aprendizagem profunda quantizados (por exemplo, ResNet, EfficientNet), o INT8_VECTOR reduz o tamanho do modelo e acelera a inferência com uma perda mínima de precisão. |
Definir parâmetros de índice para o campo vetorial
Para acelerar as pesquisas semânticas, é necessário criar um índice para o campo vetorial. A indexação pode melhorar significativamente a eficiência da recuperação de dados vetoriais em grande escala.
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="dense_vector",
    index_name="dense_vector_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)
import io.milvus.v2.common.IndexParam;
import java.util.*;

List<IndexParam> indexes = new ArrayList<>();

indexes.add(IndexParam.builder()
        .fieldName("dense_vector")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build());
import { MetricType, IndexType } from "@zilliz/milvus2-sdk-node";

const indexParams = {
    index_name: 'dense_vector_index',
    field_name: 'dense_vector',
    metric_type: MetricType.IP,
    index_type: IndexType.AUTOINDEX
};
idx := index.NewAutoIndex(index.MetricType(entity.IP))
indexOption := milvusclient.NewCreateIndexOption("my_collection", "dense_vector", idx)
export indexParams='[
        {
            "fieldName": "dense_vector",
            "metricType": "IP",
            "indexName": "dense_vector_index",
            "indexType": "AUTOINDEX"
        }
    ]'
No exemplo acima, é criado um índice denominado « dense_vector_index » para o campo « dense_vector » utilizando o tipo de índice « AUTOINDEX ». O parâmetro « metric_type » é definido como « IP », indicando que o produto escalar será utilizado como métrica de distância.
O Milvus disponibiliza vários tipos de índice para uma melhor experiência de pesquisa vetorial. O AUTOINDEX é um tipo de índice especial concebido para facilitar a aprendizagem da pesquisa vetorial. Existem muitos tipos de índice disponíveis à sua escolha. Para mais detalhes, consulte «Explicação dos índices».
O Milvus suporta outros tipos de métricas. Para mais informações, consulte «Tipos de métricas».
Criar coleção
Assim que as definições dos parâmetros do vetor denso e do índice estiverem concluídas, pode criar uma coleção que contenha vetores densos. O exemplo abaixo utiliza o método ` create_collection ` para criar uma coleção denominada ` my_collection`.
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
import { MilvusClient } from "@zilliz/milvus2-sdk-node";

const client = new MilvusClient({
    address: 'http://localhost:19530'
});

await client.createCollection({
    collection_name: 'my_collection',
    schema: schema,
    index_params: indexParams
});
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
Inserir dados
Após criar a coleção, utilize o método ` insert ` para adicionar dados que contenham vetores densos. Certifique-se de que a dimensionalidade dos vetores densos a serem inseridos corresponde ao valor de ` dim ` definido ao adicionar o campo de vetor denso.
data = [
    {"dense_vector": [0.1, 0.2, 0.3, 0.7]},
    {"dense_vector": [0.2, 0.3, 0.4, 0.8]},
]

client.insert(
    collection_name="my_collection",
    data=data
)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;
import io.milvus.v2.service.vector.response.InsertResp;

List<JsonObject> rows = new ArrayList<>();
Gson gson = new Gson();
rows.add(gson.fromJson("{\"dense_vector\": [0.1, 0.2, 0.3, 0.4]}", JsonObject.class));
rows.add(gson.fromJson("{\"dense_vector\": [0.2, 0.3, 0.4, 0.5]}", JsonObject.class));

InsertResp insertR = client.insert(InsertReq.builder()
        .collectionName("my_collection")
        .data(rows)
        .build());
const data = [
  { dense_vector: [0.1, 0.2, 0.3, 0.7] },
  { dense_vector: [0.2, 0.3, 0.4, 0.8] },
];

client.insert({
  collection_name: "my_collection",
  data: data,
});
_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("my_collection").
    WithFloatVectorColumn("dense_vector", 4, [][]float32{
        {0.1, 0.2, 0.3, 0.7},
        {0.2, 0.3, 0.4, 0.8},
    }),
)
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "data": [
        {"dense_vector": [0.1, 0.2, 0.3, 0.4]},
        {"dense_vector": [0.2, 0.3, 0.4, 0.5]}
    ],
    "collectionName": "my_collection"
}'

## {"code":0,"cost":0,"data":{"insertCount":2,"insertIds":["453577185629572531","453577185629572532"]}}
Efetuar pesquisa de similaridade
A pesquisa semântica baseada em vetores densos é uma das funcionalidades principais do Milvus, permitindo-lhe encontrar rapidamente os dados mais semelhantes a um vetor de consulta com base na distância entre vetores. Para efetuar uma pesquisa de similaridade, prepare o vetor de consulta e os parâmetros de pesquisa e, em seguida, chame o método search.
search_params = {
    "params": {"nprobe": 10}
}

query_vector = [0.1, 0.2, 0.3, 0.7]

res = client.search(
    collection_name="my_collection",
    data=[query_vector],
    anns_field="dense_vector",
    search_params=search_params,
    limit=5,
    output_fields=["pk"]
)

print(res)

# Output
# data: ["[{'id': '453718927992172271', 'distance': 0.7599999904632568, 'entity': {'pk': '453718927992172271'}}, {'id': '453718927992172270', 'distance': 0.6299999952316284, 'entity': {'pk': '453718927992172270'}}]"]
import io.milvus.v2.service.vector.request.data.FloatVec;

Map<String,Object> searchParams = new HashMap<>();
searchParams.put("nprobe",10);

FloatVec queryVector = new FloatVec(new float[]{0.1f, 0.3f, 0.3f, 0.4f});

SearchResp searchR = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryVector))
        .annsField("dense_vector")
        .searchParams(searchParams)
        .topK(5)
        .outputFields(Collections.singletonList("pk"))
        .build());

System.out.println(searchR.getSearchResults());

// Output
//
// [[SearchResp.SearchResult(entity={pk=453444327741536779}, score=0.65, id=453444327741536779), SearchResp.SearchResult(entity={pk=453444327741536778}, score=0.65, id=453444327741536778)]]
query_vector = [0.1, 0.2, 0.3, 0.7];

client.search({
    collection_name: 'my_collection',
    data: query_vector,
    limit: 5,
    output_fields: ['pk'],
    params: {
        nprobe: 10
    }
});
queryVector := []float32{0.1, 0.2, 0.3, 0.7}

annParam := index.NewCustomAnnParam()
annParam.WithExtraParam("nprobe", 10)
resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    5,                     // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("dense_vector").
    WithOutputFields("pk").
    WithAnnParam(annParam))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("Pks: ", resultSet.GetColumn("pk").FieldData().GetScalars())
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": [
        [0.1, 0.2, 0.3, 0.7]
    ],
    "annsField": "dense_vector",
    "limit": 5,
    "searchParams":{
        "params":{"nprobe":10}
    },
    "outputFields": ["pk"]
}'

## {"code":0,"cost":0,"data":[{"distance":0.55,"id":"453577185629572532","pk":"453577185629572532"},{"distance":0.42,"id":"453577185629572531","pk":"453577185629572531"}]}
Para mais informações sobre os parâmetros de pesquisa por semelhança, consulte «Pesquisa ANN básica».
