


Crie um RAG com o Milvus e o Gemini
A API do Gemini e o Google AI Studio ajudam-no a começar a trabalhar com os modelos mais recentes da Google e a transformar as suas ideias em aplicações escaláveis. O Gemini fornece acesso a modelos linguísticos poderosos, como o « Gemini-2.5-Flash » e o « Gemini-2.5-Pro », para tarefas como geração de texto, processamento de documentos, visão, análise de áudio e muito mais. Também oferece o « Gemini Embedding 2 », um modelo de incorporação multimodal que suporta texto, imagens, vídeo, áudio e documentos PDF com dimensões de saída flexíveis através do «Matryoshka Representation Learning». A API permite-lhe introduzir contextos longos com milhões de tokens, ajustar modelos para tarefas específicas, gerar saídas estruturadas como JSON e tirar partido de capacidades como a recuperação semântica e a execução de código.
Neste tutorial, iremos mostrar-lhe como construir um pipeline RAG (Retrieval-Augmented Generation) com o Milvus e o Gemini. Iremos utilizar o modelo Gemini para gerar respostas com base numa consulta específica, complementadas com informações relevantes recuperadas do Milvus.
Preparação
Dependências e ambiente
Primeiro, instale os pacotes necessários:
$ pip install --upgrade pymilvus milvus-lite google-genai requests tqdm
Se estiver a utilizar o Google Colab, para ativar as dependências que acabou de instalar, poderá ser necessário reiniciar o ambiente de execução (clique no menu «Runtime» na parte superior do ecrã e selecione «Restart session» no menu suspenso).
Deve, em primeiro lugar, iniciar sessão na plataforma Google AI Studio e preparar a chave API GEMINI_API_KEY como variável de ambiente.
import os

os.environ["GEMINI_API_KEY"] = "***********"
Preparar os dados
Utilizamos as páginas de perguntas frequentes da Documentação do Milvus 2.4.x como conhecimento privado no nosso RAG, o que constitui uma boa fonte de dados para um pipeline RAG simples.
Descarregue o ficheiro zip e extraia os documentos para a pasta milvus_docs.
$ wget https://github.com/milvus-io/milvus-docs/releases/download/v2.4.6-preview/milvus_docs_2.4.x_en.zip
$ unzip -q milvus_docs_2.4.x_en.zip -d milvus_docs
Carregamos todos os ficheiros Markdown da pasta milvus_docs/en/faq. Para cada documento, utilizamos simplesmente «# » para separar o conteúdo do ficheiro, o que permite separar, de forma aproximada, o conteúdo de cada parte principal do ficheiro Markdown.
from glob import glob

text_lines = []

for file_path in glob("milvus_docs/en/faq/*.md", recursive=True):
    with open(file_path, "r") as file:
        file_text = file.read()

    text_lines += file_text.split("# ")
Preparar o LLM e o modelo de embedding
Utilizamos o gemini-2.5-flash como LLM e o gemini-embedding-2-preview como modelo de embedding. O gemini-embedding-2-preview é o mais recente modelo de embedding multimodal da Google, que suporta texto, imagens, vídeo, áudio e documentos PDF com dimensões de saída flexíveis (128–3 072) através do Matryoshka Representation Learning.
Vamos tentar gerar uma resposta de teste a partir do LLM:
from google import genai

client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])

response = client.models.generate_content(
    model="gemini-2.5-flash", contents="who are you"
)
print(response.text)
I am a large language model, trained by Google.

I'm designed to process and generate human-like text based on the vast amount of data I was trained on. This allows me to:

*   Answer questions
*   Provide summaries
*   Generate creative content
*   Translate languages
*   And much more

I don't have personal experiences, feelings, or consciousness. I'm a tool designed to be helpful and informative.
Gerar uma incorporação de teste e apresentar a sua dimensão e os primeiros elementos.
test_embeddings = client.models.embed_content(
    model="gemini-embedding-2-preview", contents=["This is a test1", "This is a test2"]
)

embedding_dim = len(test_embeddings.embeddings[0].values)
print(embedding_dim)
print(test_embeddings.embeddings[0].values[:10])
3072
[-0.016769307, 0.013630492, 0.020277105, 0.0035285393, 0.003968259, -0.013498845, 0.028525498, 0.025498547, -0.021553498, 0.015233516]
Carregar dados no Milvus
Criar a coleção
Vamos inicializar o cliente Milvus e configurar a nossa coleção:
from pymilvus import MilvusClient

milvus_client = MilvusClient(uri="./milvus_demo.db")

collection_name = "my_rag_collection"
Quanto ao argumento de ` MilvusClient`:
- Definir o `
uri` como um ficheiro local, por exemplo, `./milvus.db`, é o método mais prático, uma vez que utiliza automaticamente o Milvus Lite para armazenar todos os dados neste ficheiro. - Se tiver uma grande quantidade de dados, pode configurar um servidor Milvus com melhor desempenho no Docker ou no Kubernetes. Nesta configuração, utilize o URI do servidor, por exemplo,
http://localhost:19530, como o seuuri. - Se pretender utilizar o Zilliz Cloud, o serviço de nuvem totalmente gerido para o Milvus, ajuste o
urie otoken, que correspondem ao «Public Endpoint» e à «API key» no Zilliz Cloud.
Verifique se a coleção já existe e, caso exista, elimine-a.
if milvus_client.has_collection(collection_name):
    milvus_client.drop_collection(collection_name)
Crie uma nova coleção com os parâmetros especificados.
Se não especificarmos qualquer informação de campo, o Milvus criará automaticamente um campo « id » predefinido para a chave primária e um campo « vector » para armazenar os dados vetoriais. É utilizado um campo JSON reservado para armazenar campos não definidos no esquema e os respetivos valores.
milvus_client.create_collection(
    collection_name=collection_name,
    dimension=embedding_dim,
    metric_type="IP",  # Inner product distance
    # Strong consistency waits for all loads to complete, adding latency with large datasets
    # consistency_level="Strong",  # Strong consistency level
)
Inserir dados
Percorra as linhas de texto, crie embeddings e, em seguida, insira os dados no Milvus.
Aqui está um novo campo text, que é um campo não definido no esquema da coleção. Será automaticamente adicionado ao campo dinâmico JSON reservado, que pode ser tratado como um campo normal a um nível elevado.
from tqdm import tqdm

data = []

doc = client.models.embed_content(model="gemini-embedding-2-preview", contents=text_lines)

for i, line in enumerate(tqdm(text_lines, desc="Creating embeddings")):
    data.append({"id": i, "vector": doc.embeddings[i].values, "text": line})

milvus_client.insert(collection_name=collection_name, data=data)
Creating embeddings: 100%|██████████| 72/72 [00:00<00:00, 337796.30it/s]


{'insert_count': 72, 'ids': [0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 19, 20, 21, 22, 23, 24, 25, 26, 27, 28, 29, 30, 31, 32, 33, 34, 35, 36, 37, 38, 39, 40, 41, 42, 43, 44, 45, 46, 47, 48, 49, 50, 51, 52, 53, 54, 55, 56, 57, 58, 59, 60, 61, 62, 63, 64, 65, 66, 67, 68, 69, 70, 71], 'cost': 0}
Criar RAG
Recuperar dados para uma consulta
Vamos especificar uma pergunta frequente sobre o Milvus.
question = "How is data stored in milvus?"
Pesquise a pergunta na coleção e recupere as três principais correspondências semânticas.
quest_embed = client.models.embed_content(model="gemini-embedding-2-preview", contents=question)

search_res = milvus_client.search(
    collection_name=collection_name,
    data=[quest_embed.embeddings[0].values],
    limit=3,  # Return top 3 results
    search_params={"metric_type": "IP", "params": {}},  # Inner product distance
    output_fields=["text"],  # Return the text field
)
Vamos dar uma vista de olhos aos resultados da pesquisa
import json

retrieved_lines_with_distances = [
    (res["entity"]["text"], res["distance"]) for res in search_res[0]
]
print(json.dumps(retrieved_lines_with_distances, indent=4))
[
    [
        " Where does Milvus store data?\n\nMilvus deals with two types of data, inserted data and metadata. \n\nInserted data, including vector data, scalar data, and collection-specific schema, are stored in persistent storage as incremental log. Milvus supports multiple object storage backends, including [MinIO](https://min.io/), [AWS S3](https://aws.amazon.com/s3/?nc1=h_ls), [Google Cloud Storage](https://cloud.google.com/storage?hl=en#object-storage-for-companies-of-all-sizes) (GCS), [Azure Blob Storage](https://azure.microsoft.com/en-us/products/storage/blobs), [Alibaba Cloud OSS](https://www.alibabacloud.com/product/object-storage-service), and [Tencent Cloud Object Storage](https://www.tencentcloud.com/products/cos) (COS).\n\nMetadata are generated within Milvus. Each Milvus module has its own metadata that are stored in etcd.\n\n###",
        0.864
    ],
    [
        "Why is there no vector data in etcd?\n\netcd stores Milvus module metadata; MinIO stores entities.",
        0.7923
    ],
    [
        "What is the maximum dataset size Milvus can handle?\n\n  \nTheoretically, the maximum dataset size Milvus can handle is determined by the hardware it is run on, specifically system memory and storage:\n\n- Milvus loads all specified collections and partitions into memory before running queries. Therefore, memory size determines the maximum amount of data Milvus can query.\n- When new entities and and collection-related schema (currently only MinIO is supported for data persistence) are added to Milvus, system storage determines the maximum allowable size of inserted data.\n\n###",
        0.7857
    ]
]
Utilizar o LLM para obter uma resposta RAG
Converta os documentos recuperados para um formato de cadeia de caracteres.
context = "\n".join(
    [line_with_distance[0] for line_with_distance in retrieved_lines_with_distances]
)
Definir prompts do sistema e do utilizador para o Modelo de Linguagem. Este prompt é montado com os documentos recuperados do Milvus.
from google.genai import types

SYSTEM_PROMPT = """
Human: You are an AI assistant. You are able to find answers to the questions from the contextual passage snippets provided.
"""
USER_PROMPT = f"""
Use the following pieces of information enclosed in <context> tags to provide an answer to the question enclosed in <question> tags.
<context>
{context}
</context>
<question>
{question}
</question>
"""
Utilize o Gemini para gerar uma resposta com base nos prompts.
response = client.models.generate_content(
    model="gemini-2.5-flash",
    config=types.GenerateContentConfig(system_instruction=SYSTEM_PROMPT),
    contents=USER_PROMPT,
)
print(response.text)
Milvus stores data in two main ways:

1.  **Inserted Data:** This includes vector data, scalar data, and collection-specific schema. This type of data is stored in persistent storage as an incremental log. Milvus supports various object storage backends for this, such as MinIO, AWS S3, Google Cloud Storage (GCS), Azure Blob Storage, Alibaba Cloud OSS, and Tencent Cloud Object Storage (COS).
2.  **Metadata:** Metadata is generated within Milvus by its various modules. Each module's metadata is stored in etcd.
Pesquisa multimodal
Uma vez que o « gemini-embedding-2-preview » mapeia texto, imagens e outras modalidades para o mesmo espaço de incorporação, podemos realizar uma pesquisa multimodal — por exemplo, utilizando uma consulta de texto para encontrar as imagens mais relevantes.
Preparar dados de imagem
Descarregamos um conjunto de diagramas da arquitetura RAG do repositório do Milvus Bootcamp para utilizar como o nosso conjunto de dados de imagens.
import urllib.request
from pathlib import Path

image_dir = Path("images")
image_dir.mkdir(exist_ok=True)

image_files = [
    "vanilla_rag.png",
    "hyde.png",
    "query_routing.png",
    "self_reflection.png",
    "hybrid_and_rerank.png",
    "hierarchical_index.png",
]

base_url = "https://raw.githubusercontent.com/milvus-io/bootcamp/master/pics/advanced_rag/"

for fname in image_files:
    path = image_dir / fname
    if not path.exists():
        urllib.request.urlretrieve(base_url + fname, path)
        print(f"Downloaded {fname}")
    else:
        print(f"Already exists {fname}")

print(f"\nTotal images: {len(image_files)}")
Downloaded vanilla_rag.png
Downloaded hyde.png
Downloaded query_routing.png
Downloaded self_reflection.png
Downloaded hybrid_and_rerank.png
Downloaded hierarchical_index.png

Total images: 6
Incorporar imagens e armazenar no Milvus
Lemos cada imagem como bytes e passamo-la para o gemini-embedding-2-preview para gerar representações, armazenando-as depois numa nova coleção do Milvus.
from google.genai import types

image_data = []

for fname in image_files:
    path = image_dir / fname
    with open(path, "rb") as f:
        image_bytes = f.read()

    result = client.models.embed_content(
        model="gemini-embedding-2-preview",
        contents=types.Part.from_bytes(data=image_bytes, mime_type="image/png"),
    )
    image_data.append(
        {
            "id": len(image_data),
            "vector": result.embeddings[0].values,
            "filename": fname,
        }
    )
    print(f"Embedded {fname}")

# Create a new collection for images
image_collection = "image_collection"
if milvus_client.has_collection(image_collection):
    milvus_client.drop_collection(image_collection)

milvus_client.create_collection(
    collection_name=image_collection,
    dimension=len(image_data[0]["vector"]),
    metric_type="IP",
)

milvus_client.insert(collection_name=image_collection, data=image_data)
print(f"\nInserted {len(image_data)} image embeddings (dim={len(image_data[0]['vector'])})")
Embedded vanilla_rag.png
Embedded hyde.png
Embedded query_routing.png
Embedded self_reflection.png
Embedded hybrid_and_rerank.png
Embedded hierarchical_index.png

Inserted 6 image embeddings (dim=3072)
Pesquisa multimodal: Consulta de texto → Resultados de imagem
Agora, vamos utilizar uma consulta de texto para pesquisar nas representações das imagens. Uma vez que tanto o texto como as imagens são mapeados para o mesmo espaço de representação, podemos compará-los diretamente.
from IPython.display import display, Image

text_queries = [
    "How does a basic RAG pipeline work?",
    "What is the hypothetical document embedding approach?",
    "How to combine hybrid search with reranking?",
]

for query in text_queries:
    query_embed = client.models.embed_content(
        model="gemini-embedding-2-preview", contents=query
    )

    results = milvus_client.search(
        collection_name=image_collection,
        data=[query_embed.embeddings[0].values],
        limit=1,
        search_params={"metric_type": "IP", "params": {}},
        output_fields=["filename"],
    )

    best = results[0][0]
    print(f"\nQuery: {query}")
    print(f"Match: {best['entity']['filename']} (score: {best['distance']:.4f})")
    display(Image(filename=str(image_dir / best["entity"]["filename"]), width=600))
Query: How does a basic RAG pipeline work?
Match: vanilla_rag.png (score: 0.5132)
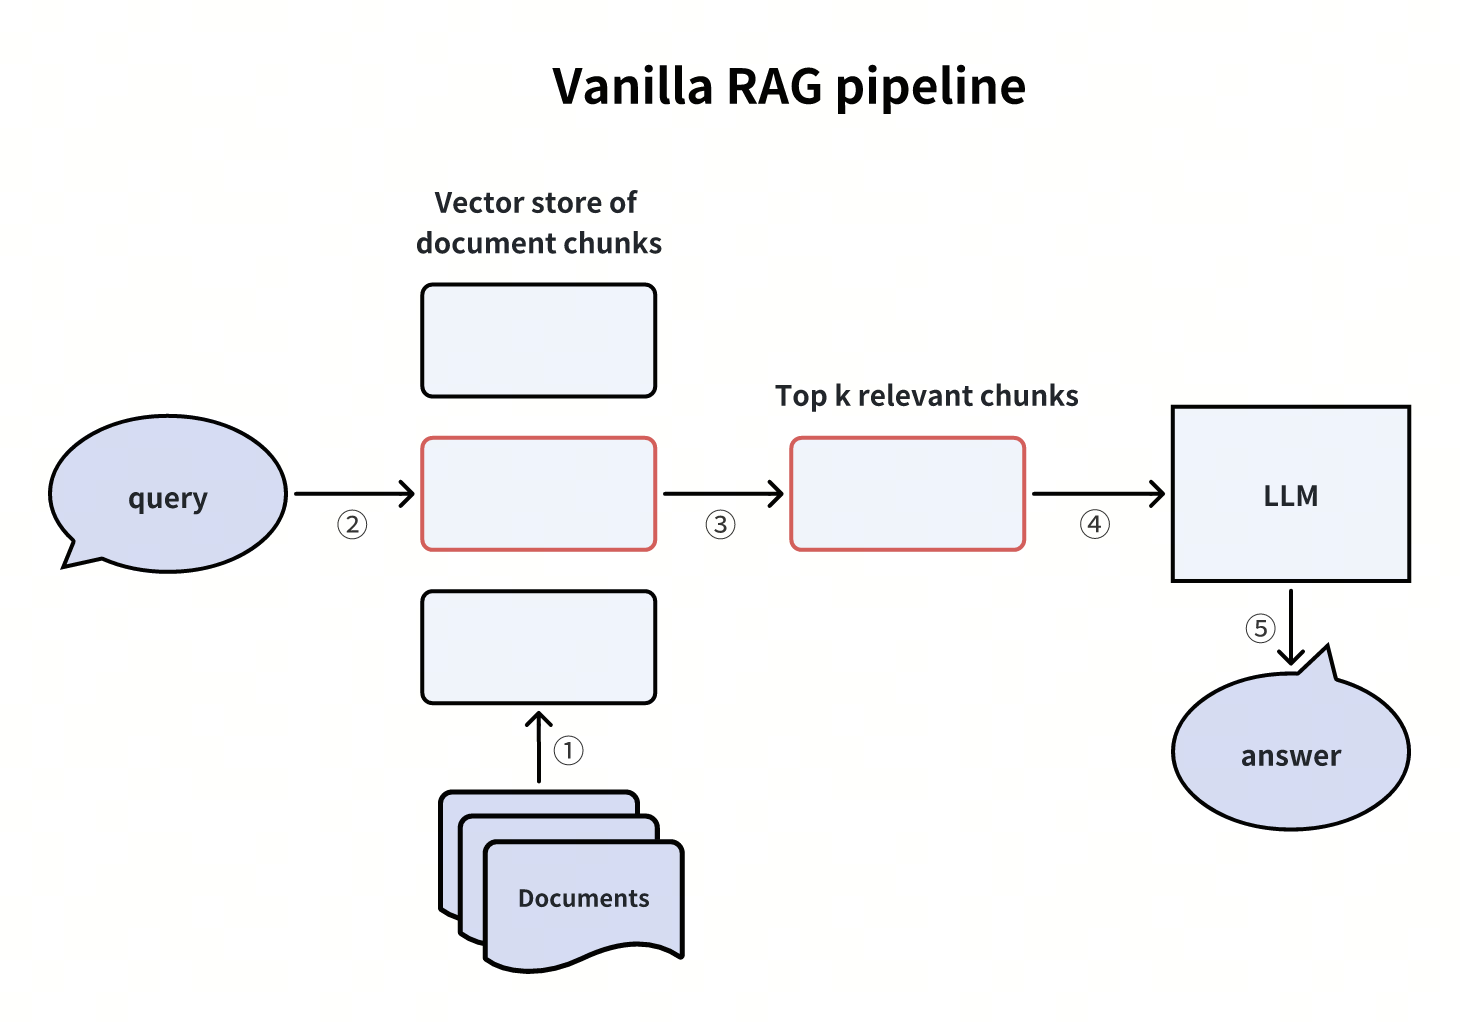 Pipeline RAG básico
Query: What is the hypothetical document embedding approach?
Match: hyde.png (score: 0.4756)
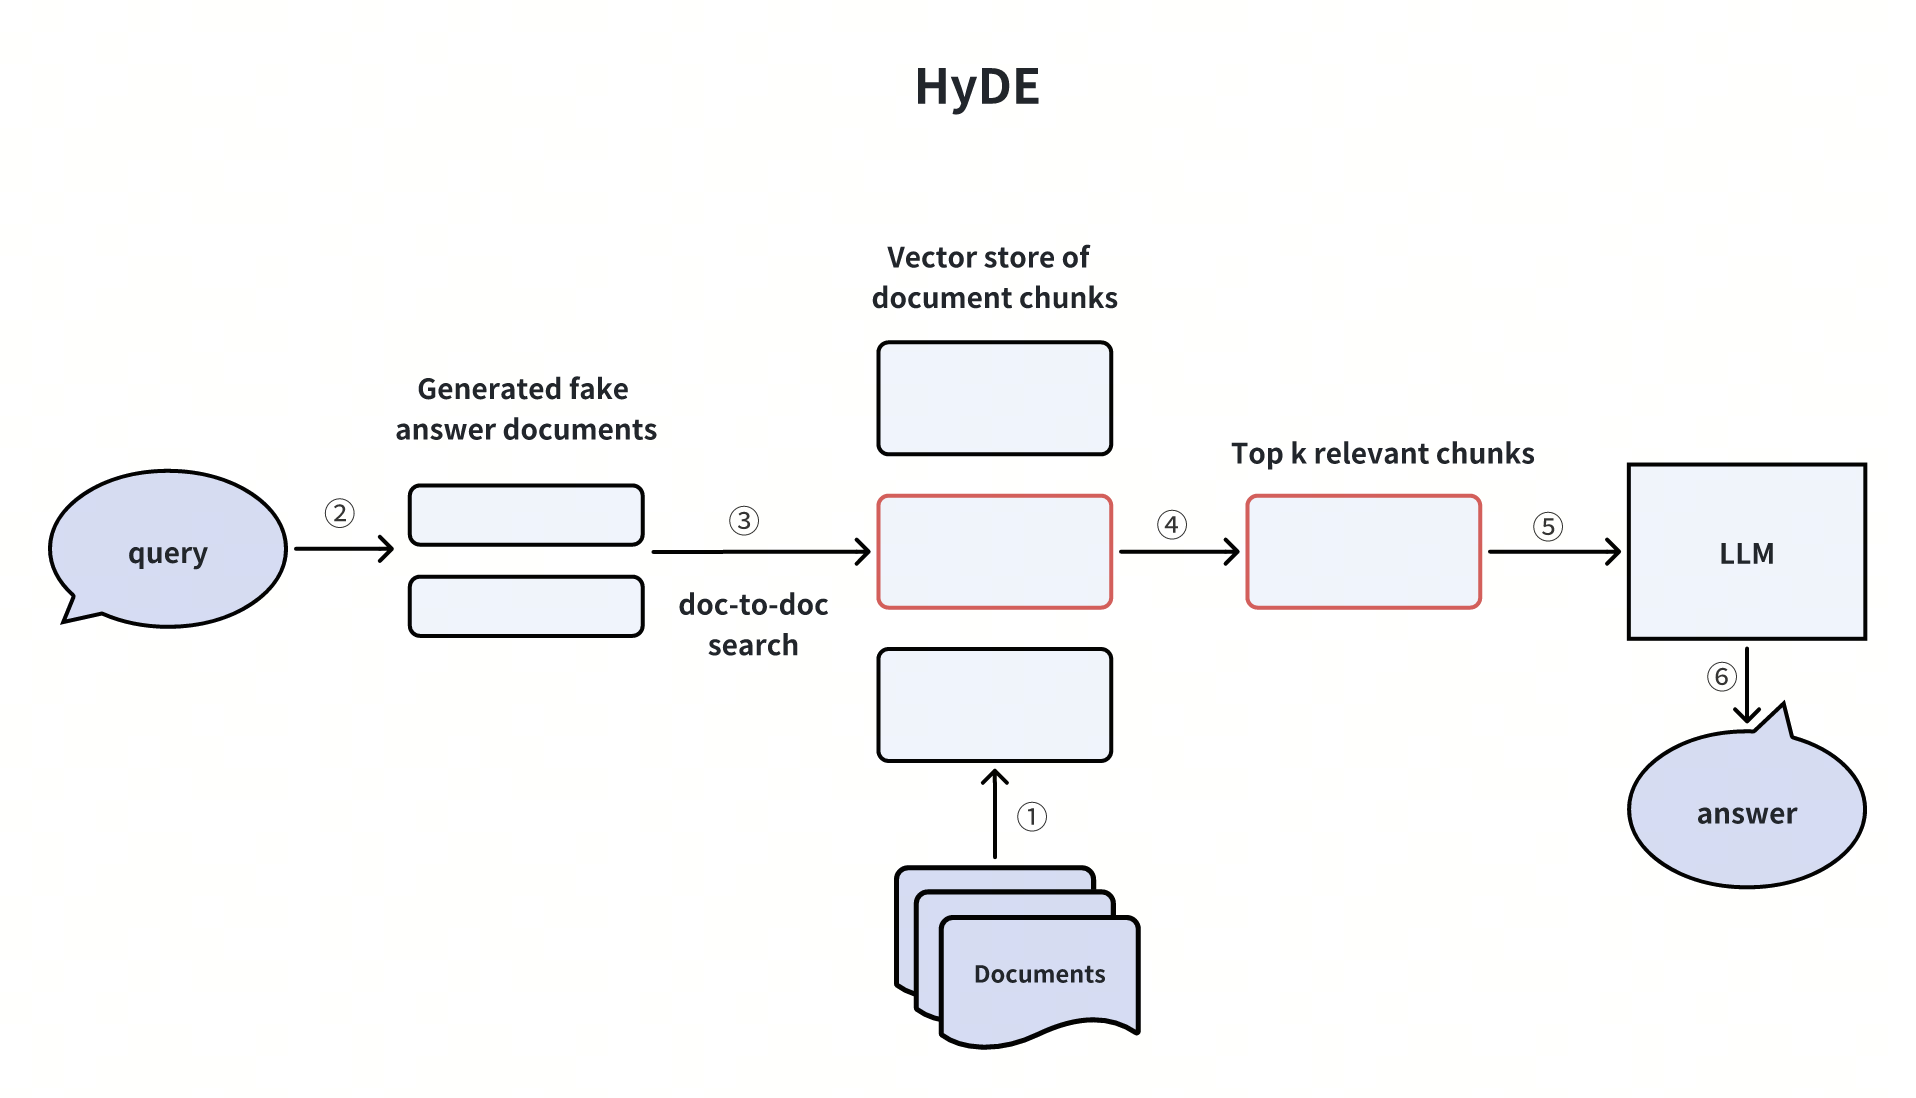 HyDE
Query: How to combine hybrid search with reranking?
Match: hybrid_and_rerank.png (score: 0.5271)
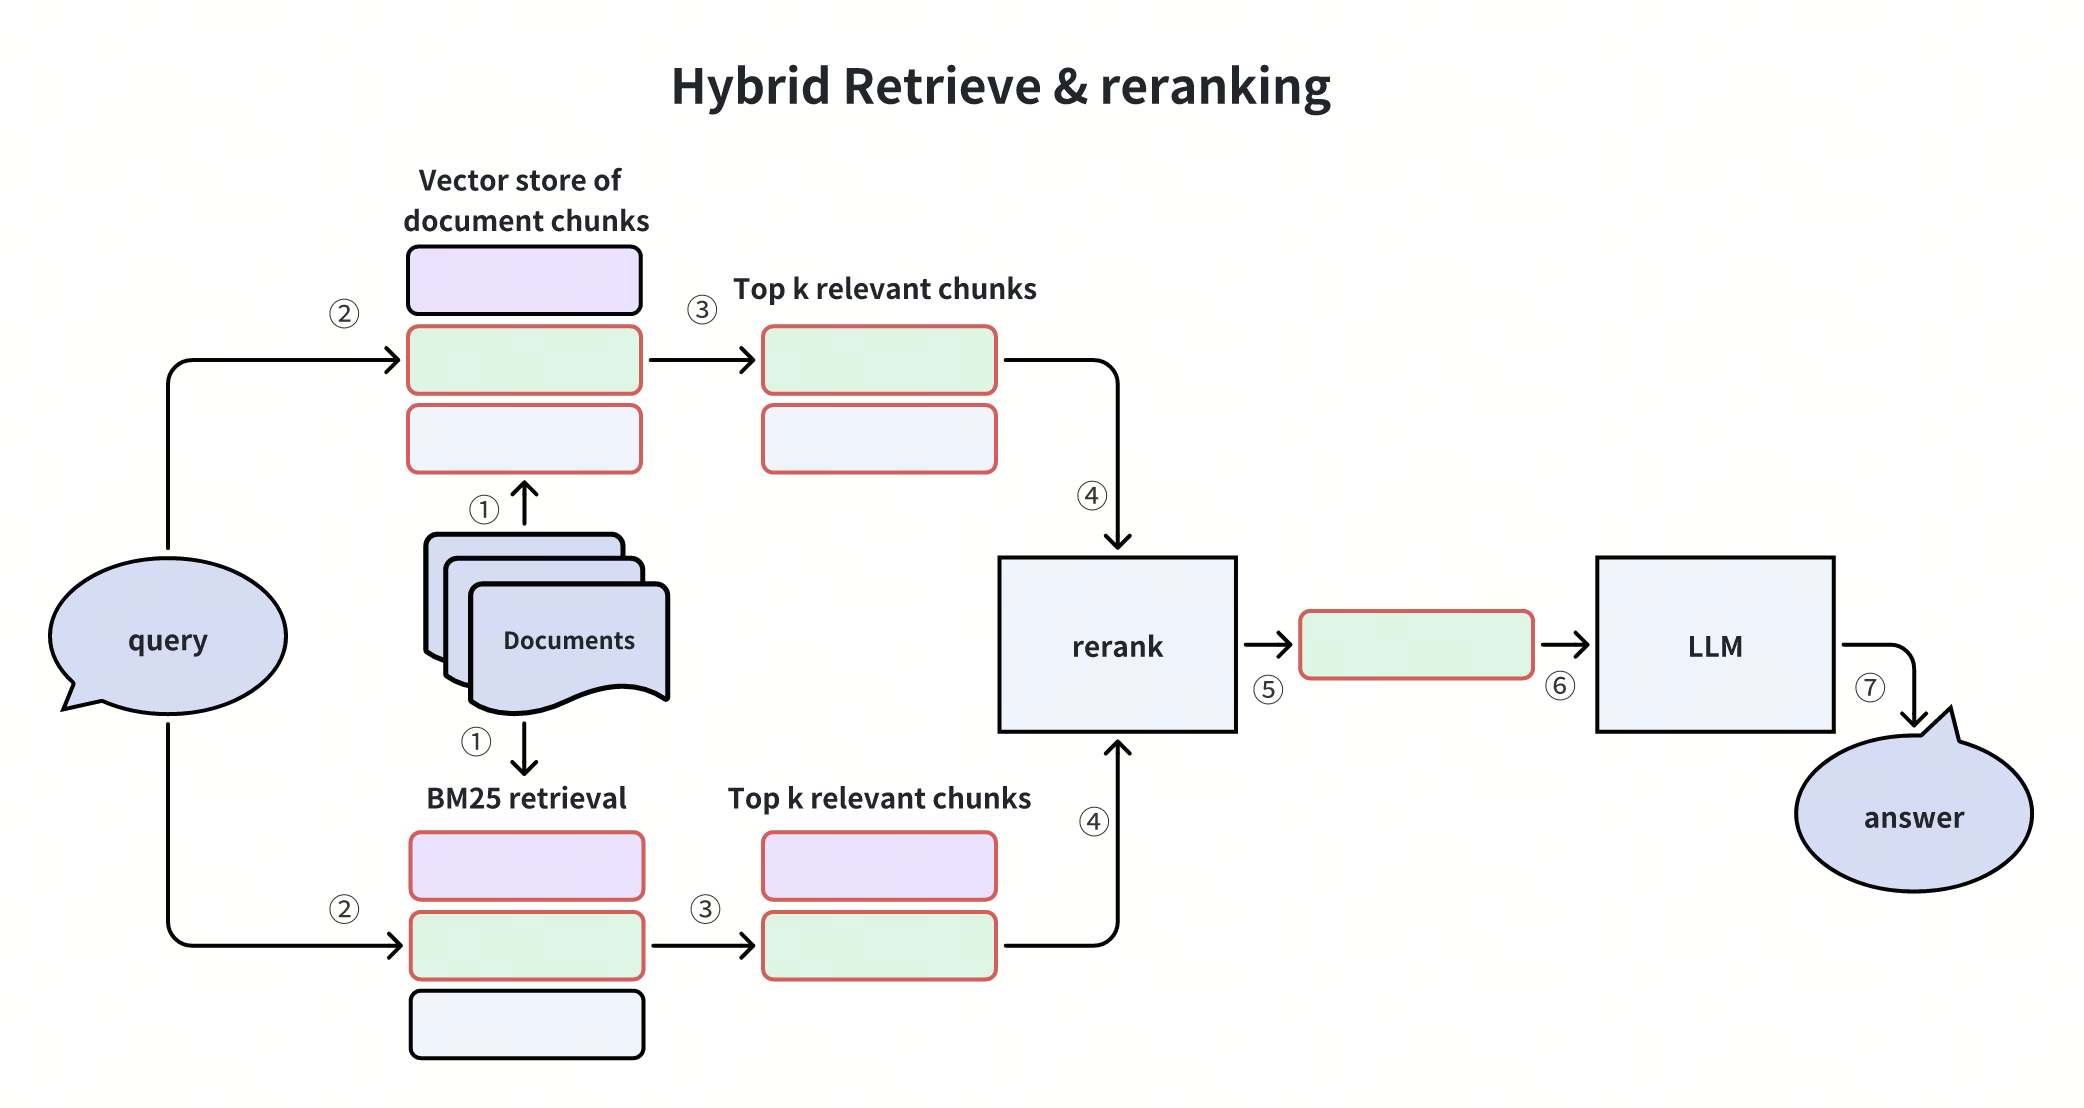 Recuperação e reclassificação híbridas
Ótimo! Conseguimos construir com sucesso um pipeline RAG com o Milvus e o Gemini e demonstrámos a pesquisa intermodal utilizando consultas de texto para recuperar imagens relevantes — tudo isto graças ao espaço de incorporação unificado do gemini-embedding-2-preview.
