

스키마 설명
스키마는 컬렉션의 데이터 구조를 정의합니다. 컬렉션을 생성하기 전에 해당 스키마의 설계를 수립해야 합니다. 이 페이지는 컬렉션 스키마를 이해하고 직접 예제 스키마를 설계하는 데 도움을 드립니다.
개요
Milvus에서 컬렉션 스키마는 관계형 데이터베이스의 테이블과 유사하며, Milvus가 컬렉션 내 데이터를 어떻게 구성할지 정의합니다.
잘 설계된 스키마는 데이터 모델을 추상화하고, 검색을 통해 비즈니스 목표를 달성할 수 있는지 여부를 결정하므로 필수적입니다. 또한, 컬렉션에 삽입되는 모든 데이터 행은 스키마를 따라야 하므로, 데이터의 일관성과 장기적인 품질을 유지하는 데 도움이 됩니다. 기술적인 관점에서 볼 때, 잘 정의된 스키마는 열 데이터가 체계적으로 저장되고 인덱스 구조가 간결해져 검색 성능을 향상시킵니다.
컬렉션 스키마에는 기본 키, 최소 하나의 벡터 필드, 그리고 여러 스칼라 필드가 포함됩니다. 다음 다이어그램은 기사를 스키마 필드 목록에 매핑하는 방법을 보여줍니다.
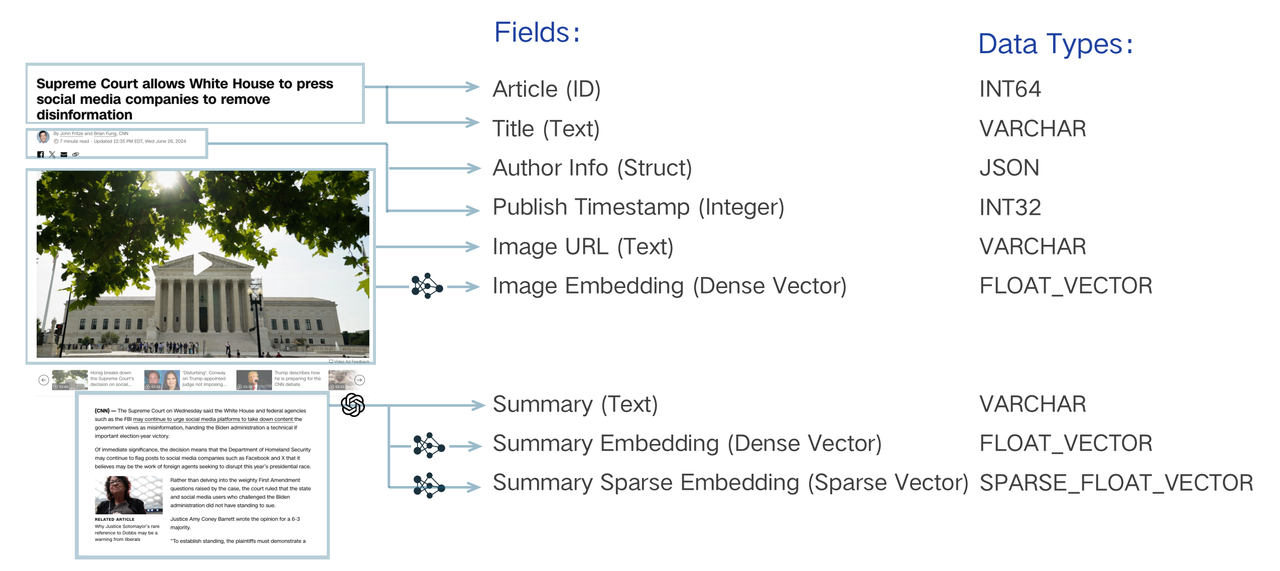 스키마 설계의 구조
검색 시스템의 데이터 모델 설계는 비즈니스 요구 사항을 분석하고 정보를 스키마로 표현된 데이터 모델로 추상화하는 과정을 포함합니다. 예를 들어, 텍스트를 검색하려면 리터럴 문자열을 “임베딩”을 통해 벡터로 변환하고 벡터 검색을 가능하게 함으로써 “색인”을 생성해야 합니다. 이러한 필수 요건 외에도, 게시 타임스탬프나 저자와 같은 다른 속성을 저장해야 할 수도 있습니다. 이러한 메타데이터를 활용하면 필터링을 통해 의미 기반 검색을 정교화하여, 특정 날짜 이후에 게시된 텍스트나 특정 저자가 작성한 텍스트만 반환할 수 있습니다. 또한 애플리케이션에서 검색 결과를 표시하기 위해 본문 텍스트와 함께 이러한 스칼라 값을 가져올 수도 있습니다. 각 텍스트 조각을 체계적으로 정리하기 위해 정수나 문자열 형태로 표현되는 고유 식별자를 할당해야 합니다. 이러한 요소들은 정교한 검색 논리를 구현하는 데 필수적입니다.
잘 설계된 스키마를 만드는 방법은 ‘스키마 설계 실습’을 참조하십시오.
스키마 생성
다음 코드 예제는 스키마를 생성하는 방법을 보여줍니다.
from pymilvus import MilvusClient, DataType

schema = MilvusClient.create_schema()
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq.CollectionSchema schema = client.createSchema();
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const schema = []
import "github.com/milvus-io/milvus/client/v2/entity"

schema := entity.NewSchema()
export schema='{
    "fields": []
}'
기본 필드 추가
컬렉션의 기본 키는 엔티티를 고유하게 식별합니다. 기본 키는 Int64 또는 VARCHAR 값만 허용합니다. 다음 코드 예제는 기본 키를 추가하는 방법을 보여줍니다.
schema.add_field(
    field_name="my_id",
    datatype=DataType.INT64,
    is_primary=True,
    auto_id=False,
)
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;

schema.addField(AddFieldReq.builder()
        .fieldName("my_id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(false)
        .build());
schema.push({
    name: "my_id",
    data_type: DataType.Int64,
    is_primary_key: true,
    autoID: false
});
schema.WithField(entity.NewField().WithName("my_id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(false),
)
export primaryField='{
    "fieldName": "my_id",
    "dataType": "Int64",
    "isPrimary": true
}'

export schema='{
    \"autoID\": false,
    \"fields\": [
        $primaryField
    ]
}'
필드를 추가할 때, 해당 필드의 ` is_primary ` 속성을 ` True`로 설정하여 해당 필드를 기본 키로 명시적으로 지정할 수 있습니다. 기본 키는 기본적으로 Int64 값을 허용합니다. 이 경우, 기본 키 값은 ` 12345`와 같은 정수여야 합니다. 기본 키에 VARCHAR 값을 사용하기로 선택한 경우, 값은 ` my_entity_1234`와 같은 문자열이어야 합니다.
또한 autoId 속성을 True 로 설정하여, 데이터 삽입 시 Milvus가 자동으로 기본 필드 값을 할당하도록 할 수 있습니다.
수동으로 기본 키를 설정하는 것이 유리한 경우가 아니라면, 모든 경우에 autoId 을 사용하는 것이 좋습니다.
자세한 내용은 ‘주 필드 및 AutoId’를 참조하십시오.
벡터 필드 추가
벡터 필드는 다양한 스파스 및 덴스 벡터 임베딩을 지원합니다. Milvus에서는 컬렉션에 최대 4개의 벡터 필드를 추가할 수 있습니다. 다음 코드 예제는 벡터 필드를 추가하는 방법을 보여줍니다.
schema.add_field(
    field_name="my_vector",
    datatype=DataType.FLOAT_VECTOR,
    dim=5
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_vector")
        .dataType(DataType.FloatVector)
        .dimension(5)
        .build());
schema.push({
    name: "my_vector",
    data_type: DataType.FloatVector,
    dim: 5
});
schema.WithField(entity.NewField().WithName("my_vector").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(5),
)
export vectorField='{
    "fieldName": "my_vector",
    "dataType": "FloatVector",
    "elementTypeParams": {
        "dim": 5
    }
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField
    ]
}"
위 코드 예시에서 dim 매개변수는 벡터 필드에 저장될 벡터 임베딩의 차원을 나타냅니다. FLOAT_VECTOR 값은 벡터 필드가 32비트 부동소수점 숫자 목록을 저장함을 의미하며, 이는 일반적으로 역로그를 표현하는 데 사용됩니다. 이 외에도 Milvus는 다음과 같은 유형의 벡터 임베딩을 지원합니다:
FLOAT16_VECTOR이 유형의 벡터 필드는 16비트 반정밀도 부동소수점 숫자의 리스트를 포함하며, 일반적으로 메모리나 대역폭이 제한된 딥러닝 또는 GPU 기반 컴퓨팅 시나리오에 적용됩니다.
BFLOAT16_VECTOR이 유형의 벡터 필드는 정밀도는 낮아졌지만 Float32와 동일한 지수 범위를 갖는 16비트 부동소수점 숫자의 리스트를 포함합니다. 이 유형의 데이터는 정확도에 큰 영향을 주지 않으면서 메모리 사용량을 줄여주기 때문에 딥러닝 시나리오에서 흔히 사용됩니다.
INT8_VECTOR이 유형의 벡터 필드는 8비트 부호 있는 정수(int8)로 구성된 벡터를 저장하며, 각 성분의 범위는 –128에서 127까지입니다. ResNet 및 EfficientNet과 같은 양자화된 딥 러닝 아키텍처에 최적화되어 있어, 정밀도 손실을 최소화하면서도 모델 크기를 대폭 줄이고 추론 속도를 향상시킵니다. 참고: 이 벡터 유형은 HNSW 인덱스에서만 지원됩니다.
BINARY_VECTOR이 유형의 벡터 필드는 0과 1로 구성된 목록을 포함합니다. 이는 이미지 처리 및 정보 검색 시나리오에서 데이터를 표현하기 위한 간결한 특징으로 사용됩니다.
SPARSE_FLOAT_VECTOR이 유형의 벡터 필드는 희소 벡터 임베딩을 표현하기 위해 0이 아닌 숫자와 해당 순서 번호의 목록을 포함합니다.
스칼라 필드 추가
일반적인 경우, 스칼라 필드를 사용하여 Milvus에 저장된 벡터 임베딩의 메타데이터를 저장하고, 메타데이터 필터링을 통해 ANN 검색을 수행하여 검색 결과의 정확도를 높일 수 있습니다. Milvus는 VARCHAR, Boolean, Int, Float 및 Double을 포함한 여러 스칼라 필드 유형을 지원합니다.
VARCHAR 필드 추가
Milvus에서는 VARCHAR 필드를 사용하여 문자열을 저장할 수 있습니다. VARCHAR 필드에 대한 자세한 내용은 VarChar 필드를 참조하십시오.
schema.add_field(
    field_name="my_varchar",
    datatype=DataType.VARCHAR,
    max_length=512
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_varchar")
        .dataType(DataType.VarChar)
        .maxLength(512)
        .build());
schema.push({
    name: "my_varchar",
    data_type: DataType.VarChar,
    max_length: 512
});
schema.WithField(entity.NewField().WithName("my_varchar").
    WithDataType(entity.FieldTypeVarChar).
    WithMaxLength(512),
)
export varCharField='{
    "fieldName": "my_varchar",
    "dataType": "VarChar",
    "elementTypeParams": {
        "max_length": 512
    }
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField
    ]
}"
숫자 필드 추가
Milvus에서 지원하는 숫자 유형은 Int8, Int16, Int32, Int64, Float 및 Double 입니다. 숫자 필드에 대한 자세한 내용은 ‘숫자 필드’를 참조하십시오.
schema.add_field(
    field_name="my_int64",
    datatype=DataType.INT64,
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_int64")
        .dataType(DataType.Int64)
        .build());
schema.push({
    name: "my_int64",
    data_type: DataType.Int64,
});
schema.WithField(entity.NewField().WithName("my_int64").
    WithDataType(entity.FieldTypeInt64),
)
export int64Field='{
    "fieldName": "my_int64",
    "dataType": "Int64"
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField,
        $int64Field
    ]
}"
부울 필드 추가
Milvus는 부울 필드를 지원합니다. 다음 코드 예제는 부울 필드를 추가하는 방법을 보여줍니다.
schema.add_field(
    field_name="my_bool",
    datatype=DataType.BOOL,
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_bool")
        .dataType(DataType.Bool)
        .build());
schema.push({
    name: "my_bool",
    data_type: DataType.Boolean,
});
schema.WithField(entity.NewField().WithName("my_bool").
    WithDataType(entity.FieldTypeBool),
)
export boolField='{
    "fieldName": "my_bool",
    "dataType": "Boolean"
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField,
        $int64Field,
        $boolField
    ]
}"
복합 필드 추가
Milvus에서 복합 필드란 JSON 필드의 키나 배열 필드의 인덱스와 같이 더 작은 하위 필드로 나눌 수 있는 필드를 말합니다.
JSON 필드 추가
JSON 필드는 일반적으로 반구조화된 JSON 데이터를 저장합니다. JSON 필드에 대한 자세한 내용은 JSON 필드를 참조하십시오.
schema.add_field(
    field_name="my_json",
    datatype=DataType.JSON,
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_json")
        .dataType(DataType.JSON)
        .build());
schema.push({
    name: "my_json",
    data_type: DataType.JSON,
});
schema.WithField(entity.NewField().WithName("my_json").
    WithDataType(entity.FieldTypeJSON),
)
export jsonField='{
    "fieldName": "my_json",
    "dataType": "JSON"
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField,
        $int64Field,
        $boolField,
        $jsonField
    ]
}"
배열 필드 추가
배열 필드는 요소 목록을 저장합니다. 배열 필드 내 모든 요소의 데이터 유형은 동일해야 합니다. 배열 필드에 대한 자세한 내용은 ‘배열 필드’를 참조하십시오.
schema.add_field(
    field_name="my_array",
    datatype=DataType.ARRAY,
    element_type=DataType.VARCHAR,
    max_capacity=5,
    max_length=512,
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_array")
        .dataType(DataType.Array)
        .elementType(DataType.VarChar)
        .maxCapacity(5)
        .maxLength(512)
        .build());
schema.push({
    name: "my_array",
    data_type: DataType.Array,
    element_type: DataType.VarChar,
    max_capacity: 5,
    max_length: 512
});
schema.WithField(entity.NewField().WithName("my_array").
    WithDataType(entity.FieldTypeArray).
    WithElementType(entity.FieldTypeInt64).
    WithMaxLength(512).
    WithMaxCapacity(5),
)
export arrayField='{
    "fieldName": "my_array",
    "dataType": "Array",
    "elementDataType": "VarChar",
    "elementTypeParams": {
        "max_length": 512
    }
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField,
        $int64Field,
        $boolField,
        $jsonField,
        $arrayField
    ]
}"
