

밀집 벡터
밀집 벡터는 기계 학습 및 데이터 분석 분야에서 널리 사용되는 수치 데이터 표현 방식입니다. 밀집 벡터는 실수로 구성된 배열로, 대부분의 요소 또는 모든 요소가 0이 아닙니다. 스파스 벡터와 비교할 때, 밀집 벡터는 각 차원이 의미 있는 값을 포함하고 있으므로 동일한 차원 수준에서 더 많은 정보를 담고 있습니다. 이러한 표현 방식은 복잡한 패턴과 관계를 효과적으로 포착할 수 있어, 고차원 공간에서 데이터를 더 쉽게 분석하고 처리할 수 있게 해줍니다. 밀집 벡터는 일반적으로 고정된 차원 수를 가지며, 구체적인 응용 분야와 요구 사항에 따라 수십 개에서 수백 개, 심지어 수천 개에 이르기까지 다양합니다.
밀집 벡터는 주로 시맨틱 검색이나 추천 시스템과 같이 데이터의 의미론을 이해해야 하는 상황에서 사용됩니다. 시맨틱 검색에서 밀집 벡터는 쿼리와 문서 간의 근본적인 연관성을 파악하는 데 도움을 주어 검색 결과의 관련성을 높입니다. 추천 시스템에서는 사용자와 항목 간의 유사성을 식별하는 데 기여하여, 더욱 개인화된 추천을 제공합니다.
개요
밀집 벡터는 일반적으로 [0.2, 0.7, 0.1, 0.8, 0.3, ..., 0.5] 과 같이 고정 길이의 부동 소수점 숫자 배열로 표현됩니다. 이러한 벡터의 차원은 대개 128, 256, 768, 1024와 같이 수백에서 수천에 이릅니다. 각 차원은 객체의 특정 의미적 특징을 포착하므로, 유사도 계산을 통해 다양한 시나리오에 적용될 수 있습니다.
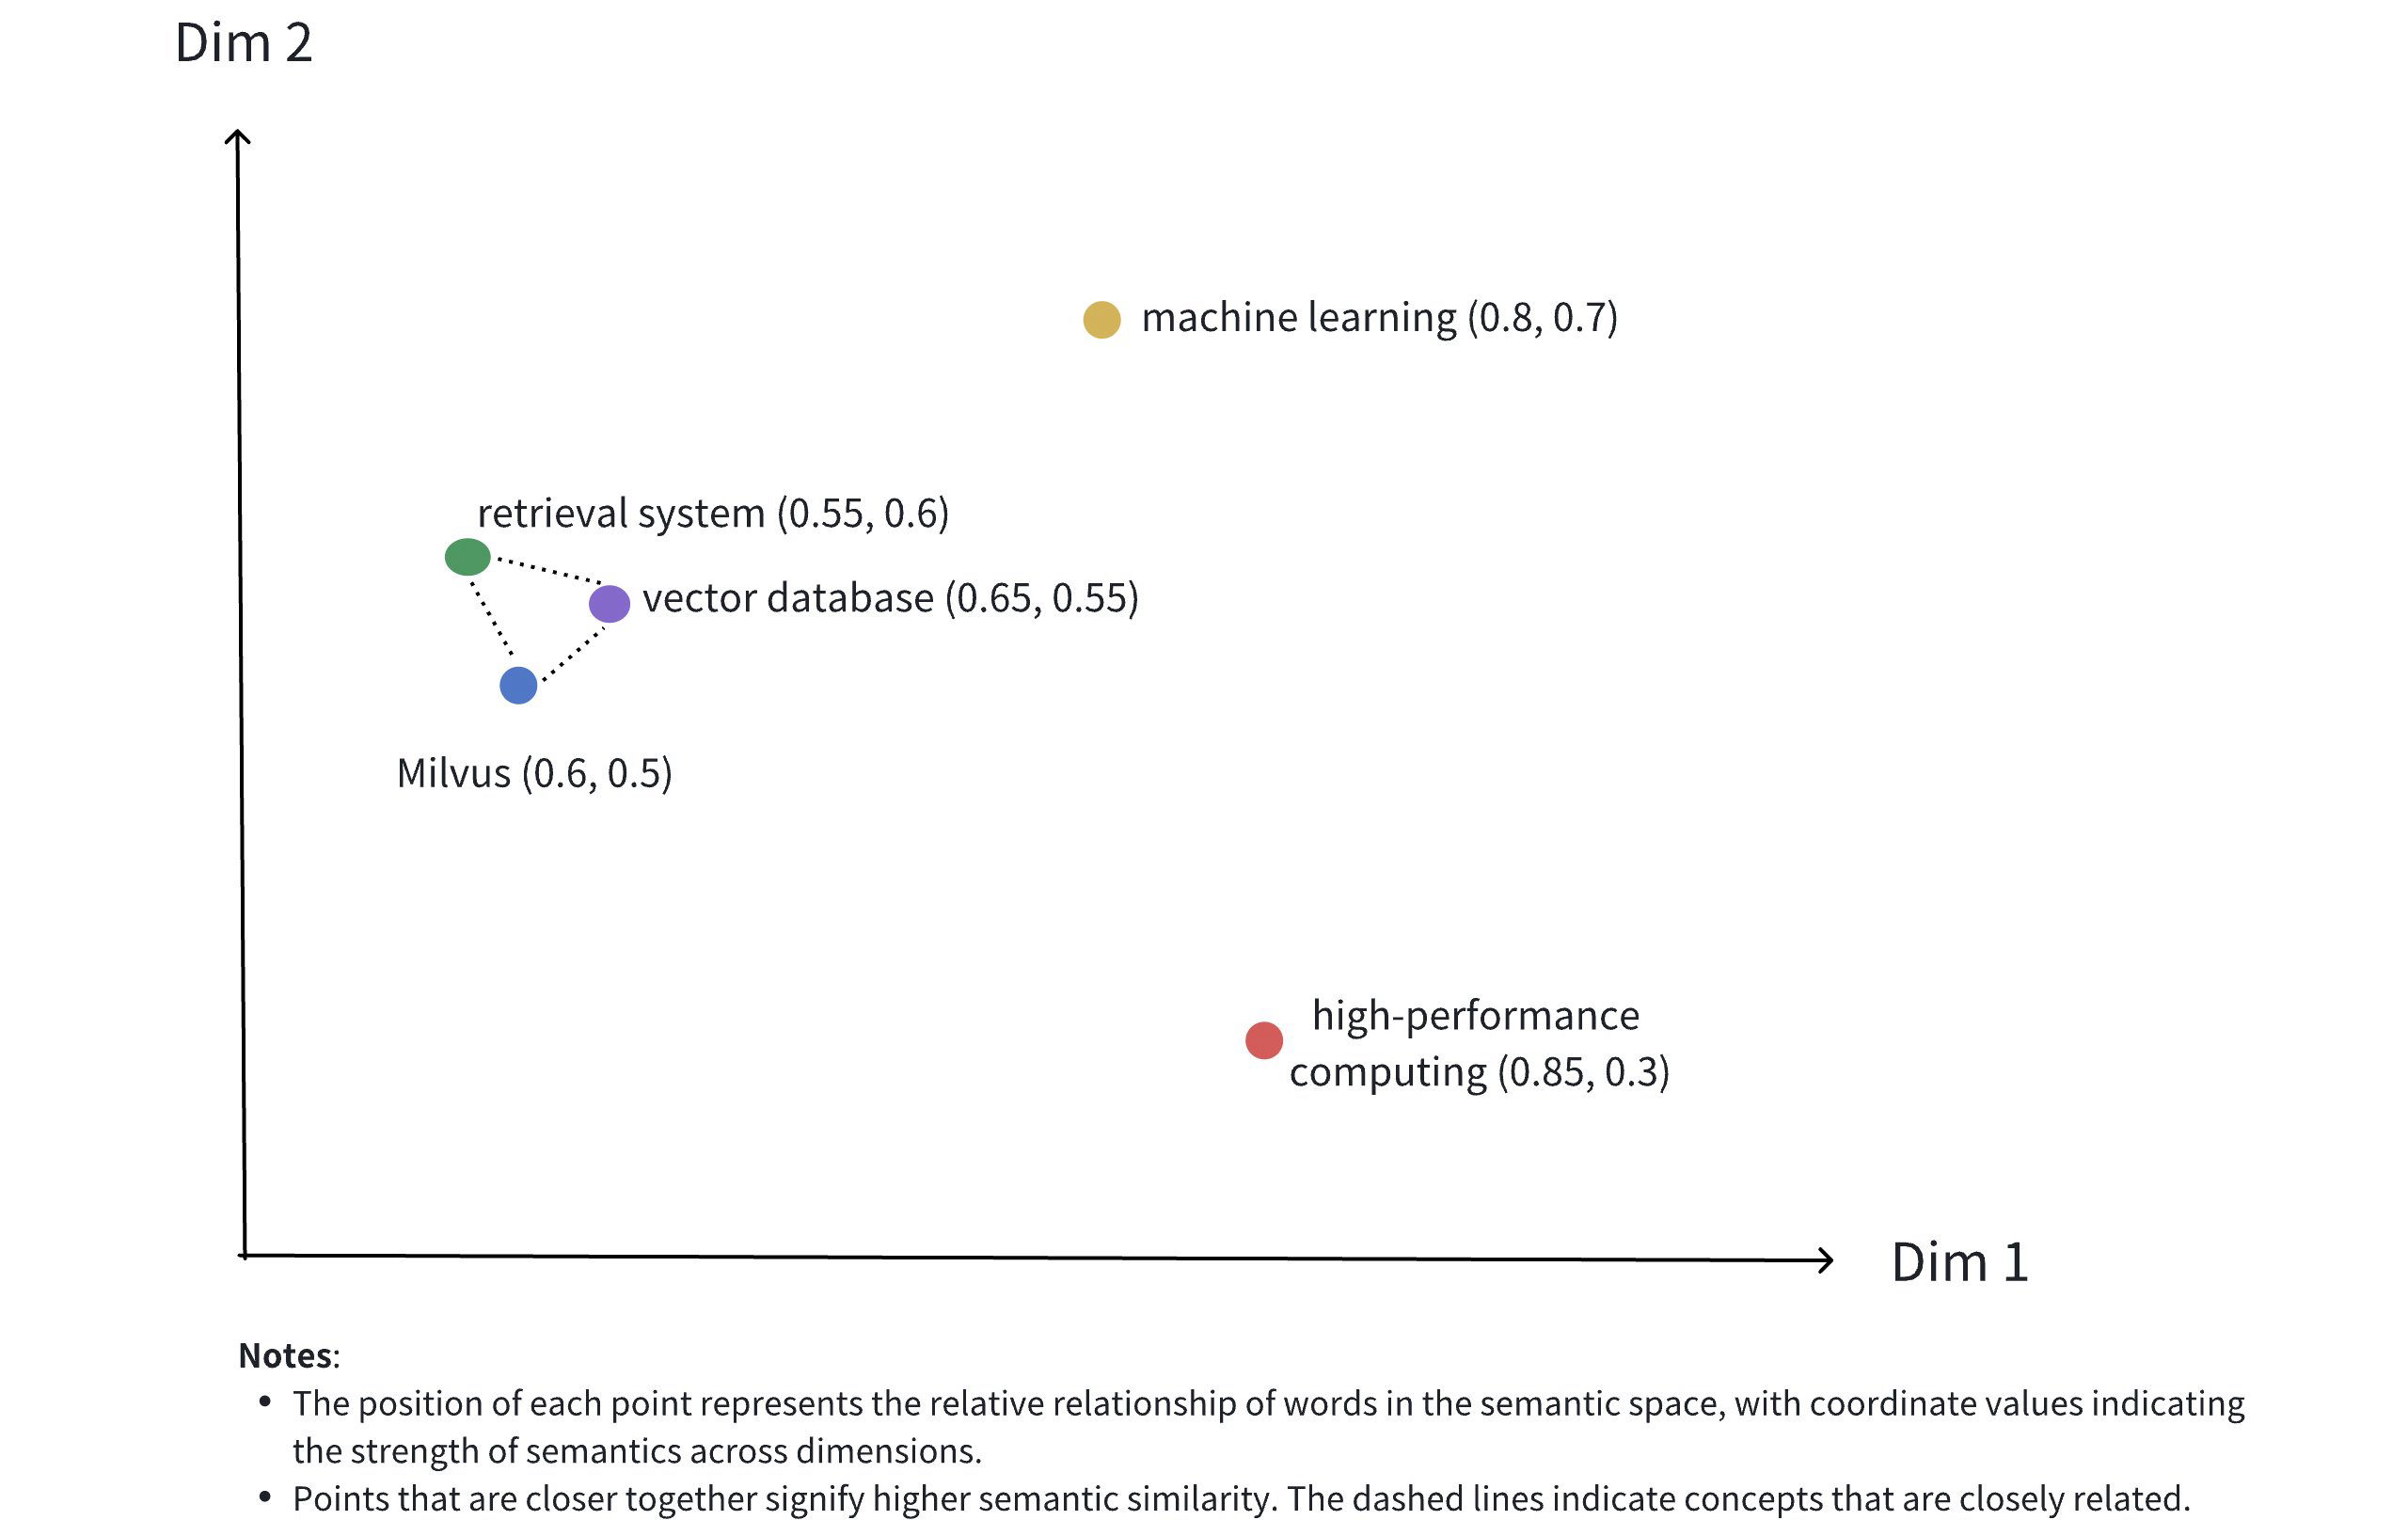 밀집 벡터
위 이미지는 2차원 공간에서 밀집 벡터의 표현을 보여줍니다. 실제 응용 분야에서 밀집 벡터는 종종 훨씬 더 높은 차원을 가지지만, 이 2차원 그림은 몇 가지 핵심 개념을 효과적으로 전달합니다:
다차원 표현: 각 점은 개념적 객체( Milvus, 벡터 데이터베이스, 검색 시스템 등)를 나타내며, 그 위치는 차원의 값에 의해 결정됩니다.
의미적 관계: 점들 간의 거리는 개념 간의 의미적 유사성을 반영합니다. 서로 가까운 점일수록 의미적으로 더 밀접하게 관련된 개념임을 나타냅니다.
클러스터링 효과: 관련 개념( Milvus, 벡터 데이터베이스, 검색 시스템 등)은 공간상에서 서로 가까이 배치되어 의미적 클러스터를 형성합니다.
다음은 “ "Milvus is an efficient vector database" ”라는 텍스트를 나타내는 실제 고밀도 벡터의 예시입니다:
[
    -0.013052909,
    0.020387933,
    -0.007869,
    -0.11111383,
    -0.030188112,
    -0.0053388323,
    0.0010654867,
    0.072027855,
    // ... more dimensions
]
밀도 벡터는 이미지의 경우 ResNet, VGG와 같은 CNN 모델이나 텍스트의 경우 BERT, Word2Vec과 같은 언어 모델 등 다양한 임베딩 모델을 사용하여 생성할 수 있습니다. 이러한 모델은 원시 데이터를 고차원 공간의 점으로 변환하여 데이터의 의미적 특징을 포착합니다. 또한 Milvus는 ‘임베딩’ 섹션에 자세히 설명된 대로, 사용자가 밀집 벡터를 생성하고 처리할 수 있도록 편리한 방법을 제공합니다.
데이터가 벡터화되면 Milvus에 저장하여 관리 및 벡터 검색이 가능합니다. 아래 다이어그램은 기본 프로세스를 보여줍니다.
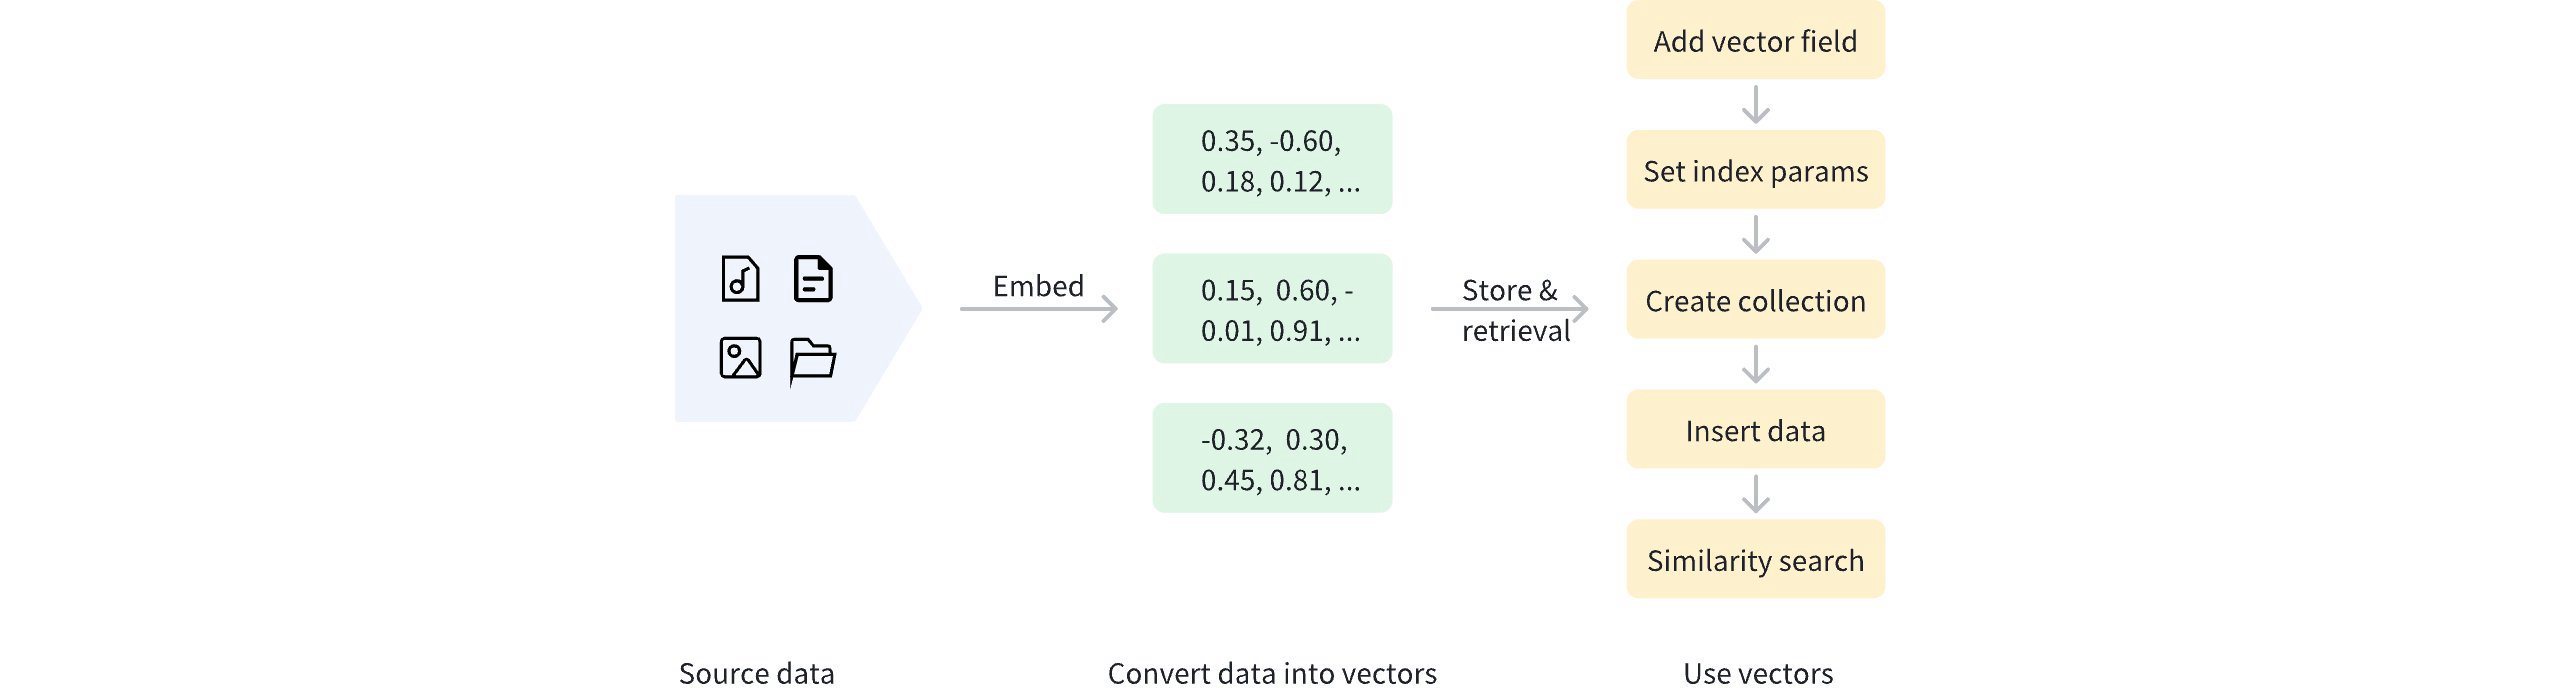 밀집 벡터 사용
밀집 벡터 외에도 Milvus는 스파스 벡터와 이진 벡터를 지원합니다. 스파스 벡터는 키워드 검색이나 용어 일치와 같이 특정 용어를 기반으로 한 정밀한 일치에 적합하며, 이진 벡터는 이미지 패턴 일치나 특정 해싱 응용 프로그램과 같이 이진화된 데이터를 효율적으로 처리하는 데 일반적으로 사용됩니다. 자세한 내용은 ‘이진 벡터’ 및 ‘스파스 벡터’를 참조하십시오.
밀집 벡터 사용
벡터 필드 추가
Milvus에서 밀집 벡터를 사용하려면, 컬렉션을 생성할 때 밀집 벡터를 저장할 벡터 필드를 먼저 정의해야 합니다. 이 과정은 다음을 포함합니다:
datatype를 지원되는 밀집 벡터 데이터 유형으로 설정합니다. 지원되는 밀집 벡터 데이터 유형에 대해서는 ‘데이터 유형’을 참조하십시오.dim매개변수를 사용하여 밀집 벡터의 차원을 지정합니다.
아래 예제에서는 밀집 벡터를 저장하기 위해 dense_vector 라는 이름의 벡터 필드를 추가합니다. 이 필드의 데이터 유형은 ` FLOAT_VECTOR`이며, 차원은 ` 4`입니다.
from pymilvus import MilvusClient, DataType

client = MilvusClient(uri="http://localhost:19530")

schema = client.create_schema(
    auto_id=True,
    enable_dynamic_fields=True,
)

schema.add_field(field_name="pk", datatype=DataType.VARCHAR, is_primary=True, max_length=100)
schema.add_field(field_name="dense_vector", datatype=DataType.FLOAT_VECTOR, dim=4)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

CreateCollectionReq.CollectionSchema schema = client.createSchema();
schema.setEnableDynamicField(true);
schema.addField(AddFieldReq.builder()
        .fieldName("pk")
        .dataType(DataType.VarChar)
        .isPrimaryKey(true)
        .autoID(true)
        .maxLength(100)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("dense_vector")
        .dataType(DataType.FloatVector)
        .dimension(4)
        .build());
import { DataType } from "@zilliz/milvus2-sdk-node";

schema.push({
  name: "dense_vector",
  data_type: DataType.FloatVector,
  dim: 4,
});
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v2/column"
    "github.com/milvus-io/milvus/client/v2/entity"
    "github.com/milvus-io/milvus/client/v2/index"
    "github.com/milvus-io/milvus/client/v2/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

milvusAddr := "localhost:19530"
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: milvusAddr,
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

schema := entity.NewSchema()
schema.WithField(entity.NewField().
    WithName("pk").
    WithDataType(entity.FieldTypeVarChar).
    WithIsPrimaryKey(true).
    WithIsAutoID(true).
    WithMaxLength(100),
).WithField(entity.NewField().
    WithName("dense_vector").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(4),
)
export primaryField='{
    "fieldName": "pk",
    "dataType": "VarChar",
    "isPrimary": true,
    "elementTypeParams": {
        "max_length": 100
    }
}'

export vectorField='{
    "fieldName": "dense_vector",
    "dataType": "FloatVector",
    "elementTypeParams": {
        "dim": 4
    }
}'

export schema="{
    \"autoID\": true,
    \"fields\": [
        $primaryField,
        $vectorField
    ]
}"
밀집 벡터 필드에 지원되는 데이터 유형:
데이터 유형 |
설명 |
|---|---|
|
32비트 부동소수점 숫자를 저장하며, 과학 계산 및 기계 학습에서 실수를 표현하는 데 일반적으로 사용됩니다. 유사한 벡터를 구별하는 등 높은 정밀도가 필요한 시나리오에 이상적입니다. |
|
16비트 반정밀도 부동소수점을 저장하며, 딥러닝 및 GPU 계산에 사용됩니다. 추천 시스템의 저정밀도 리콜 단계와 같이 정밀도가 그다지 중요하지 않은 상황에서 저장 공간을 절약해 줍니다. |
|
16비트 Brain Floating Point(bfloat16) 숫자를 저장하며, Float32와 동일한 지수 범위를 제공하지만 정밀도는 낮습니다. 대규모 이미지 검색과 같이 대량의 벡터를 빠르게 처리해야 하는 시나리오에 적합합니다. |
|
각 차원의 개별 요소가 8비트 정수(int8)인 벡터를 저장하며, 각 요소의 범위는 –128에서 127까지입니다. 양자화된 딥 러닝 모델(예: ResNet, EfficientNet)을 위해 설계된 INT8_VECTOR는 정밀도 손실을 최소화하면서 모델 크기를 줄이고 추론 속도를 높입니다. |
벡터 필드에 대한 인덱스 매개변수 설정
의미 기반 검색을 가속화하려면 벡터 필드에 대한 인덱스를 생성해야 합니다. 인덱싱을 통해 대규모 벡터 데이터의 검색 효율을 크게 향상시킬 수 있습니다.
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="dense_vector",
    index_name="dense_vector_index",
    index_type="AUTOINDEX",
    metric_type="IP"
)
import io.milvus.v2.common.IndexParam;
import java.util.*;

List<IndexParam> indexes = new ArrayList<>();

indexes.add(IndexParam.builder()
        .fieldName("dense_vector")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.IP)
        .build());
import { MetricType, IndexType } from "@zilliz/milvus2-sdk-node";

const indexParams = {
    index_name: 'dense_vector_index',
    field_name: 'dense_vector',
    metric_type: MetricType.IP,
    index_type: IndexType.AUTOINDEX
};
idx := index.NewAutoIndex(index.MetricType(entity.IP))
indexOption := milvusclient.NewCreateIndexOption("my_collection", "dense_vector", idx)
export indexParams='[
        {
            "fieldName": "dense_vector",
            "metricType": "IP",
            "indexName": "dense_vector_index",
            "indexType": "AUTOINDEX"
        }
    ]'
위의 예제에서는 AUTOINDEX 인덱스 유형을 사용하여 dense_vector 필드에 대해 dense_vector_index 라는 이름의 인덱스를 생성합니다. metric_type 는 IP 로 설정되어 있으며, 이는 내적(inner product)이 거리 측정 기준으로 사용됨을 나타냅니다.
Milvus는 더 나은 벡터 검색 경험을 위해 다양한 인덱스 유형을 제공합니다. AUTOINDEX는 벡터 검색의 학습 곡선을 완화하도록 설계된 특수한 인덱스 유형입니다. 선택할 수 있는 인덱스 유형은 매우 다양합니다. 자세한 내용은 ‘인덱스 설명’을 참조하십시오.
Milvus는 다른 메트릭 유형도 지원합니다. 자세한 내용은 ‘메트릭 유형’을 참조하십시오.
컬렉션 생성
밀집 벡터 및 인덱스 매개변수 설정이 완료되면, 밀집 벡터를 포함하는 컬렉션을 생성할 수 있습니다. 아래 예제에서는 ` create_collection ` 메서드를 사용하여 ` my_collection`라는 이름의 컬렉션을 생성합니다.
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("http://localhost:19530")
        .build());

CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexes)
        .build();
client.createCollection(requestCreate);
import { MilvusClient } from "@zilliz/milvus2-sdk-node";

const client = new MilvusClient({
    address: 'http://localhost:19530'
});

await client.createCollection({
    collection_name: 'my_collection',
    schema: schema,
    index_params: indexParams
});
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
데이터 삽입
컬렉션을 생성한 후, ` insert ` 메서드를 사용하여 밀집 벡터가 포함된 데이터를 추가합니다. 삽입되는 밀집 벡터의 차원이 밀집 벡터 필드를 추가할 때 정의된 ` dim ` 값과 일치하는지 확인하십시오.
data = [
    {"dense_vector": [0.1, 0.2, 0.3, 0.7]},
    {"dense_vector": [0.2, 0.3, 0.4, 0.8]},
]

client.insert(
    collection_name="my_collection",
    data=data
)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;
import io.milvus.v2.service.vector.response.InsertResp;

List<JsonObject> rows = new ArrayList<>();
Gson gson = new Gson();
rows.add(gson.fromJson("{\"dense_vector\": [0.1, 0.2, 0.3, 0.4]}", JsonObject.class));
rows.add(gson.fromJson("{\"dense_vector\": [0.2, 0.3, 0.4, 0.5]}", JsonObject.class));

InsertResp insertR = client.insert(InsertReq.builder()
        .collectionName("my_collection")
        .data(rows)
        .build());
const data = [
  { dense_vector: [0.1, 0.2, 0.3, 0.7] },
  { dense_vector: [0.2, 0.3, 0.4, 0.8] },
];

client.insert({
  collection_name: "my_collection",
  data: data,
});
_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("my_collection").
    WithFloatVectorColumn("dense_vector", 4, [][]float32{
        {0.1, 0.2, 0.3, 0.7},
        {0.2, 0.3, 0.4, 0.8},
    }),
)
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "data": [
        {"dense_vector": [0.1, 0.2, 0.3, 0.4]},
        {"dense_vector": [0.2, 0.3, 0.4, 0.5]}
    ],
    "collectionName": "my_collection"
}'

## {"code":0,"cost":0,"data":{"insertCount":2,"insertIds":["453577185629572531","453577185629572532"]}}
유사도 검색 수행
밀집 벡터를 기반으로 한 시맨틱 검색은 Milvus의 핵심 기능 중 하나로, 벡터 간의 거리를 기반으로 쿼리 벡터와 가장 유사한 데이터를 빠르게 찾을 수 있게 해줍니다. 유사도 검색을 수행하려면 쿼리 벡터와 검색 매개변수를 준비한 후 search 메서드를 호출하십시오.
search_params = {
    "params": {"nprobe": 10}
}

query_vector = [0.1, 0.2, 0.3, 0.7]

res = client.search(
    collection_name="my_collection",
    data=[query_vector],
    anns_field="dense_vector",
    search_params=search_params,
    limit=5,
    output_fields=["pk"]
)

print(res)

# Output
# data: ["[{'id': '453718927992172271', 'distance': 0.7599999904632568, 'entity': {'pk': '453718927992172271'}}, {'id': '453718927992172270', 'distance': 0.6299999952316284, 'entity': {'pk': '453718927992172270'}}]"]
import io.milvus.v2.service.vector.request.data.FloatVec;

Map<String,Object> searchParams = new HashMap<>();
searchParams.put("nprobe",10);

FloatVec queryVector = new FloatVec(new float[]{0.1f, 0.3f, 0.3f, 0.4f});

SearchResp searchR = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(queryVector))
        .annsField("dense_vector")
        .searchParams(searchParams)
        .topK(5)
        .outputFields(Collections.singletonList("pk"))
        .build());

System.out.println(searchR.getSearchResults());

// Output
//
// [[SearchResp.SearchResult(entity={pk=453444327741536779}, score=0.65, id=453444327741536779), SearchResp.SearchResult(entity={pk=453444327741536778}, score=0.65, id=453444327741536778)]]
query_vector = [0.1, 0.2, 0.3, 0.7];

client.search({
    collection_name: 'my_collection',
    data: query_vector,
    limit: 5,
    output_fields: ['pk'],
    params: {
        nprobe: 10
    }
});
queryVector := []float32{0.1, 0.2, 0.3, 0.7}

annParam := index.NewCustomAnnParam()
annParam.WithExtraParam("nprobe", 10)
resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    5,                     // limit
    []entity.Vector{entity.FloatVector(queryVector)},
).WithANNSField("dense_vector").
    WithOutputFields("pk").
    WithAnnParam(annParam))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("Pks: ", resultSet.GetColumn("pk").FieldData().GetScalars())
}
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d '{
    "collectionName": "my_collection",
    "data": [
        [0.1, 0.2, 0.3, 0.7]
    ],
    "annsField": "dense_vector",
    "limit": 5,
    "searchParams":{
        "params":{"nprobe":10}
    },
    "outputFields": ["pk"]
}'

## {"code":0,"cost":0,"data":[{"distance":0.55,"id":"453577185629572532","pk":"453577185629572532"},{"distance":0.42,"id":"453577185629572531","pk":"453577185629572531"}]}
유사도 검색 매개변수에 대한 자세한 내용은 기본 ANN 검색을 참조하십시오.
