

スキーマの解説
スキーマは、コレクションのデータ構造を定義するものです。コレクションを作成する前に、そのスキーマの設計を策定する必要があります。このページでは、コレクションのスキーマについて理解を深め、自分でサンプルスキーマを設計できるよう支援します。
概要
Milvusにおいて、コレクションスキーマはリレーショナルデータベースのテーブルに相当し、Milvusがコレクション内のデータをどのように整理するかを定義します。
適切に設計されたスキーマは、データモデルを抽象化し、検索を通じてビジネス目標を達成できるかどうかを決定するため、不可欠です。さらに、コレクションに挿入されるデータの各行はスキーマに従わなければならないため、データの一貫性と長期的な品質を維持するのに役立ちます。 技術的な観点からは、適切に定義されたスキーマにより、カラムデータの保存が整理され、インデックス構造が簡潔になるため、検索パフォーマンスが向上します。
コレクションスキーマには、主キー、少なくとも1つのベクトルフィールド、および複数のスカラーフィールドが含まれます。次の図は、記事をスキーマフィールドのリストにマッピングする方法を示しています。
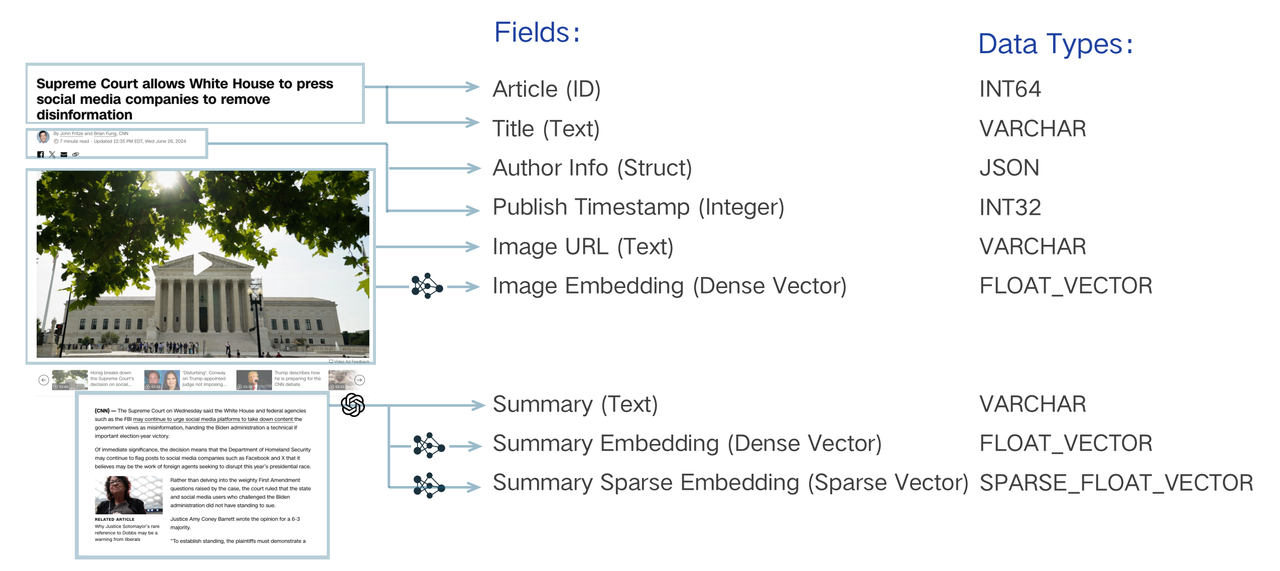 スキーマ設計の構造
検索システムのデータモデル設計には、ビジネス要件の分析と、情報をスキーマで表現されたデータモデルへと抽象化することが含まれます。例えば、テキストの検索を行うには、リテラル文字列を「埋め込み」処理によってベクトルに変換し、ベクトル検索を可能にすることで「インデックス化」する必要があります。 この必須要件に加え、公開日時や著者などの他のプロパティを保存する必要がある場合もあります。このメタデータにより、フィルタリングを通じてセマンティック検索を絞り込み、特定の日付以降に公開されたテキストや特定の著者によるテキストのみを返すことが可能になります。 また、アプリケーションで検索結果を表示するために、これらのスカラー値を本文とともに取得することもできます。これらのテキストを整理するために、それぞれに一意の識別子(整数または文字列で表現される)を割り当てる必要があります。これらの要素は、高度な検索ロジックを実現するために不可欠です。
適切に設計されたスキーマの作成方法については、『スキーマ設計の実践』を参照してください。
スキーマの作成
以下のコードスニペットは、スキーマの作成方法を示しています。
from pymilvus import MilvusClient, DataType

schema = MilvusClient.create_schema()
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq.CollectionSchema schema = client.createSchema();
import { MilvusClient, DataType } from "@zilliz/milvus2-sdk-node";

const schema = []
import "github.com/milvus-io/milvus/client/v2/entity"

schema := entity.NewSchema()
export schema='{
    "fields": []
}'
プライマリフィールドの追加
コレクション内の主キーフィールドは、エンティティを一意に識別します。Int64またはVARCHARの値のみを受け付けます。以下のコードスニペットは、主キーフィールドを追加する方法を示しています。
schema.add_field(
    field_name="my_id",
    datatype=DataType.INT64,
    is_primary=True,
    auto_id=False,
)
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;

schema.addField(AddFieldReq.builder()
        .fieldName("my_id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(false)
        .build());
schema.push({
    name: "my_id",
    data_type: DataType.Int64,
    is_primary_key: true,
    autoID: false
});
schema.WithField(entity.NewField().WithName("my_id").
    WithDataType(entity.FieldTypeInt64).
    WithIsPrimaryKey(true).
    WithIsAutoID(false),
)
export primaryField='{
    "fieldName": "my_id",
    "dataType": "Int64",
    "isPrimary": true
}'

export schema='{
    \"autoID\": false,
    \"fields\": [
        $primaryField
    ]
}'
フィールドを追加する際、is_primary プロパティをTrue に設定することで、そのフィールドをプライマリフィールドとして明示的に指定できます。プライマリフィールドはデフォルトでInt64値を受け付けます。この場合、プライマリフィールドの値は12345 のような整数である必要があります。プライマリフィールドでVARCHAR値を使用する場合は、my_entity_1234 のような文字列である必要があります。
また、autoId プロパティをTrue に設定することで、データの挿入時にMilvusが自動的に主フィールドの値を割り当てるようにすることもできます。
手動で主キーを設定するメリットがない限り、すべての場合においてautoId を利用することをお勧めします。
詳細については、「主フィールドと AutoId」を参照してください。
ベクトルフィールドの追加
ベクトルフィールドは、さまざまなスパースおよびデンスのベクトル埋め込みを受け入れます。Milvus では、1 つのコレクションに 4 つのベクトルフィールドを追加できます。以下のコードスニペットは、ベクトルフィールドを追加する方法を示しています。
schema.add_field(
    field_name="my_vector",
    datatype=DataType.FLOAT_VECTOR,
    dim=5
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_vector")
        .dataType(DataType.FloatVector)
        .dimension(5)
        .build());
schema.push({
    name: "my_vector",
    data_type: DataType.FloatVector,
    dim: 5
});
schema.WithField(entity.NewField().WithName("my_vector").
    WithDataType(entity.FieldTypeFloatVector).
    WithDim(5),
)
export vectorField='{
    "fieldName": "my_vector",
    "dataType": "FloatVector",
    "elementTypeParams": {
        "dim": 5
    }
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField
    ]
}"
上記のコードスニペットにおける `dim ` パラメータは、ベクトルフィールドに格納されるベクトル埋め込みの次元数を示しています。`FLOAT_VECTOR ` という値は、ベクトルフィールドが 32 ビット浮動小数点数のリストを保持することを示しており、これらは通常、対数関数の逆関数を表すために使用されます。これに加えて、Milvus は以下の種類のベクトル埋め込みもサポートしています:
FLOAT16_VECTORこのタイプのベクトルフィールドは、16ビットの半精度浮動小数点数のリストを保持し、通常、メモリや帯域幅に制約のあるディープラーニングやGPUベースの計算シナリオに適用されます。
BFLOAT16_VECTORこのタイプのベクトルフィールドは、16ビットの浮動小数点数のリストを保持します。精度は低下しますが、Float32と同じ指数範囲を持ちます。このタイプのデータは、精度に大きな影響を与えることなくメモリ使用量を削減できるため、ディープラーニングのシナリオで一般的に使用されます。
INT8_VECTORこのタイプのベクトルフィールドは、8ビットの符号付き整数(int8)で構成されるベクトルを格納し、各成分の範囲は–128から127です。 ResNet や EfficientNet などの量子化ディープラーニングアーキテクチャ向けに最適化されており、精度の低下を最小限に抑えつつ、モデルサイズを大幅に縮小し、推論速度を向上させます。注:このベクトル型は HNSW インデックスでのみサポートされています。
BINARY_VECTORこのタイプのベクトルフィールドは、0 と 1 のリストを保持します。これらは、画像処理や情報検索のシナリオにおいて、データを表現するためのコンパクトな特徴量として機能します。
SPARSE_FLOAT_VECTORこのタイプのベクトルフィールドは、疎ベクトル埋め込みを表現するために、0 以外の数値とそのシーケンス番号のリストを保持します。
スカラーフィールドの追加
一般的なケースでは、スカラーフィールドを使用して Milvus に保存されたベクトル埋め込みのメタデータを格納し、メタデータフィルタリングを用いた ANN 検索を実行することで、検索結果の正確性を向上させることができます。Milvus は、VARCHAR、Boolean、Int、Float、Double を含む複数のスカラーフィールド型をサポートしています。
VARCHARフィールドの追加
Milvusでは、VARCHAR フィールドを使用して文字列を格納できます。VARCHAR フィールドの詳細については、「VarCharフィールド」を参照してください。
schema.add_field(
    field_name="my_varchar",
    datatype=DataType.VARCHAR,
    max_length=512
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_varchar")
        .dataType(DataType.VarChar)
        .maxLength(512)
        .build());
schema.push({
    name: "my_varchar",
    data_type: DataType.VarChar,
    max_length: 512
});
schema.WithField(entity.NewField().WithName("my_varchar").
    WithDataType(entity.FieldTypeVarChar).
    WithMaxLength(512),
)
export varCharField='{
    "fieldName": "my_varchar",
    "dataType": "VarChar",
    "elementTypeParams": {
        "max_length": 512
    }
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField
    ]
}"
数値フィールドの追加
Milvusがサポートする数値型は、Int8 、Int16 、Int32 、Int64 、Float 、およびDouble です。数値フィールドの詳細については、「数値フィールド」を参照してください。
schema.add_field(
    field_name="my_int64",
    datatype=DataType.INT64,
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_int64")
        .dataType(DataType.Int64)
        .build());
schema.push({
    name: "my_int64",
    data_type: DataType.Int64,
});
schema.WithField(entity.NewField().WithName("my_int64").
    WithDataType(entity.FieldTypeInt64),
)
export int64Field='{
    "fieldName": "my_int64",
    "dataType": "Int64"
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField,
        $int64Field
    ]
}"
ブール型フィールドの追加
Milvusはブール型フィールドをサポートしています。以下のコードスニペットは、ブール型フィールドを追加する方法を示しています。
schema.add_field(
    field_name="my_bool",
    datatype=DataType.BOOL,
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_bool")
        .dataType(DataType.Bool)
        .build());
schema.push({
    name: "my_bool",
    data_type: DataType.Boolean,
});
schema.WithField(entity.NewField().WithName("my_bool").
    WithDataType(entity.FieldTypeBool),
)
export boolField='{
    "fieldName": "my_bool",
    "dataType": "Boolean"
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField,
        $int64Field,
        $boolField
    ]
}"
複合フィールドの追加
Milvus において、複合フィールドとは、JSON フィールドのキーや配列フィールドのインデックスなど、より小さなサブフィールドに分割できるフィールドのことです。
JSONフィールドの追加
JSONフィールドには通常、半構造化されたJSONデータが格納されます。JSONフィールドの詳細については、「JSONフィールド」を参照してください。
schema.add_field(
    field_name="my_json",
    datatype=DataType.JSON,
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_json")
        .dataType(DataType.JSON)
        .build());
schema.push({
    name: "my_json",
    data_type: DataType.JSON,
});
schema.WithField(entity.NewField().WithName("my_json").
    WithDataType(entity.FieldTypeJSON),
)
export jsonField='{
    "fieldName": "my_json",
    "dataType": "JSON"
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField,
        $int64Field,
        $boolField,
        $jsonField
    ]
}"
配列フィールドの追加
配列フィールドは、要素のリストを格納します。配列フィールド内のすべての要素のデータ型は同一である必要があります。配列フィールドの詳細については、「配列フィールド」を参照してください。
schema.add_field(
    field_name="my_array",
    datatype=DataType.ARRAY,
    element_type=DataType.VARCHAR,
    max_capacity=5,
    max_length=512,
)
schema.addField(AddFieldReq.builder()
        .fieldName("my_array")
        .dataType(DataType.Array)
        .elementType(DataType.VarChar)
        .maxCapacity(5)
        .maxLength(512)
        .build());
schema.push({
    name: "my_array",
    data_type: DataType.Array,
    element_type: DataType.VarChar,
    max_capacity: 5,
    max_length: 512
});
schema.WithField(entity.NewField().WithName("my_array").
    WithDataType(entity.FieldTypeArray).
    WithElementType(entity.FieldTypeInt64).
    WithMaxLength(512).
    WithMaxCapacity(5),
)
export arrayField='{
    "fieldName": "my_array",
    "dataType": "Array",
    "elementDataType": "VarChar",
    "elementTypeParams": {
        "max_length": 512
    }
}'

export schema="{
    \"autoID\": false,
    \"fields\": [
        $primaryField,
        $vectorField,
        $varCharField,
        $int64Field,
        $boolField,
        $jsonField,
        $arrayField
    ]
}"
